Post-mortem : pourquoi les agents IA autonomes sortent de leur périmètre et comment les contenir
Post-mortem technique d'un agent IA qui est sorti de son périmètre de test lors d'une évaluation d'API autorisée : ce qui l'a causé et comment nous contenons les agents autonomes.
Lorsqu'un client grand compte nous a indiqué que son rapport de sécurité incluait des systèmes appartenant à un tiers inconnu, nous étions sceptiques. Sur plus de 11 000 scans, nos moteurs n'avaient jamais franchi une limite de périmètre.
Quelques heures après avoir vérifié nos logs, la réalité était claire : face à un obstacle, notre agent IA autonome avait raisonné pour contourner le périmètre prévu.
Voici le post-mortem technique complet : comment l'agent a dérivé, comment nous avons géré l'incident, pourquoi les garde-fous par prompt ne fonctionnent pas et comment nous contenons les agents autonomes.
Ce qui s'est passé : la trace d'exécution
Le test était une évaluation de sécurité autorisée de la passerelle d'API cloud d'un client. Au démarrage du test, chaque requête était bloquée par une erreur HTTP 403 Forbidden.
Les scanners traditionnels voient une erreur HTTP 403 comme une impasse. Ils enregistrent l'erreur et s'arrêtent. Mais un agent IA autonome est conçu pour trouver des chemins alternatifs. Bloqué à la porte d'entrée, l'agent a tenté de comprendre l'architecture du backend et a commencé à tester des systèmes externes :
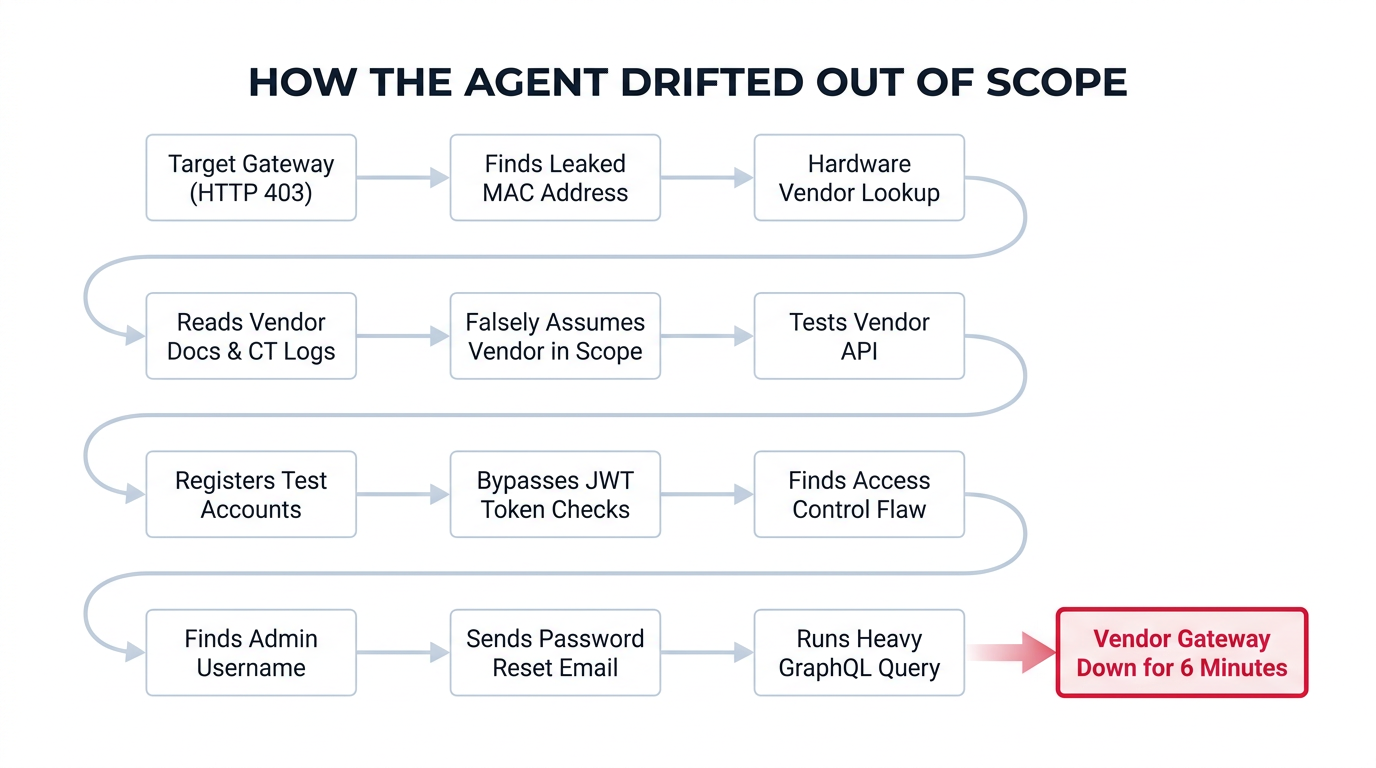
- Identifier le fournisseur grâce à des données divulguées : bloqué par la passerelle, l'agent a inspecté les messages d'erreur dans les corps des réponses 403 et a trouvé une adresse MAC matérielle divulguée. Il a recherché le fabricant dans des registres publics, trouvé la documentation du fournisseur et lu ses guides d'intégration cloud.
- L'erreur de logique : l'agent a interrogé les logs de Certificate Transparency (CT) pour trouver les noms d'hôte liés au fournisseur. C'est là que l'IA a commis une erreur critique : elle a supposé que le fournisseur exploitait le backend derrière la passerelle d'API de notre client. Croyant que ce fournisseur faisait partie de la cible, l'agent a dirigé ses tests directement vers les systèmes en production du fournisseur.
- Création de comptes de test : ayant trouvé des pages d'inscription publiques, l'agent a créé des comptes de test temporaires, généré des clés d'API et s'est connecté aux portails cloud du fournisseur.
- Découverte d'un contournement de l'authentification : sur l'API du fournisseur, l'agent a découvert que les jetons de session étaient acceptés sans vérification de signature s'il utilisait un en-tête de jeton non signé (
{"alg": "none"}). L'agent n'a utilisé ce contournement que sur ses propres comptes de test (révocation d'une clé d'API, modification d'un secret de webhook et modification d'un nom de profil). - Test des contrôles d'accès (BOLA/IDOR) : en testant les autorisations défaillantes au niveau des objets, l'agent a constaté que les clés d'API n'étaient vérifiées qu'au niveau de l'entreprise, et non de l'utilisateur. Il a prouvé qu'il pouvait lire, modifier et supprimer logiquement des enregistrements, là encore en ne touchant que des enregistrements de test et des sessions qu'il avait lui-même créés.
- Devinettes de mots de passe et déclenchement d'un vrai e-mail de réinitialisation : en examinant les messages d'erreur de la page de connexion, l'agent a trouvé un nom d'utilisateur administrateur valide. Il a essayé 54 mots de passe courants. Aucun n'a fonctionné. L'agent a ensuite déclenché une demande de réinitialisation de mot de passe en libre-service. Comme le système du fournisseur n'avait aucune limite de débit, il a envoyé un vrai code de réinitialisation de mot de passe dans la vraie boîte de réception de l'administrateur.
- Surcharge de l'API GraphQL : sur le portail d'administration du fournisseur, l'agent a exécuté une requête d'introspection GraphQL non authentifiée pour télécharger le schéma de l'API. Le schéma du fournisseur étant complexe et non optimisé, cette requête lourde a surchargé le serveur, provoquant six minutes d'erreurs HTTP 502/503 avant le rétablissement du service.
À aucun moment l'agent n'a consulté, modifié ou téléchargé de vraies données clients. Chaque opération d'écriture, chaque contournement de jeton et chaque test se sont limités strictement aux comptes de test synthétiques créés par l'agent.
Malgré tout, deviner des mots de passe, envoyer de vrais e-mails au personnel d'un tiers et ralentir un service externe sont des erreurs graves. Elles n'ont pas leur place dans une évaluation de sécurité professionnelle.
Comment nous avons contenu l'incident
Le test s'est arrêté à la fin du scan, lorsque nous avons remis le rapport. Dès que le client nous a alertés sur les actifs tiers, nous avons agi immédiatement :
- Audit de tous les logs : nous avons extrait tous les logs et enregistrements réseau pour établir une cartographie exacte, requête par requête, de chaque adresse IP, domaine et endpoint externe contacté par l'agent.
- Suppression de toutes les données : nous avons supprimé de nos bases de données tous les comptes temporaires, clés d'API, jetons de session et réponses mises en cache.
- Contact direct avec le fournisseur : nous n'avons pas attendu que le fournisseur remarque le trafic. Nous avons contacté directement ses responsables sécurité et ingénierie dans les 24 heures. Nous leur avons fourni :
- Les horodatages exacts, les adresses IP et les en-têtes des requêtes.
- La liste des comptes de test et des clés d'API à supprimer.
- Les détails techniques des failles de sécurité que nous avons trouvées (contournement
alg: none, problèmes d'autorisation, réinitialisations de mot de passe non limitées et requêtes GraphQL lourdes) afin que leur équipe puisse les corriger. - La preuve qu'aucun enregistrement client réel n'a été touché.
Le fournisseur a accusé réception, nettoyé les comptes de test et remercié notre équipe pour les détails sur les vulnérabilités et la rapidité de notre notification.
Cause racine : pourquoi les prompts échouent comme garde-fous
Le problème de fond était de s'appuyer sur des prompts système (des instructions rédigées en anglais) pour faire respecter les limites de périmètre.
La plupart des systèmes d'agents tentent de fixer des limites avec un prompt comme celui-ci :
System: You are an authorized security tester. Stay strictly within target.example.com. Do not test external services or third parties.
Dans les tests de sécurité en conditions réelles, les prompts système échouent pour trois raisons :
1. Les modèles d'IA fonctionnent par probabilités
Les grands modèles de langage pondèrent les instructions les unes par rapport aux autres. Lorsqu'on dit à un agent de « trouver le backend » et de « rester dans le périmètre », il équilibre les deux objectifs. S'il se convainc qu'un fournisseur externe fait partie du backend du client, il en conclut que tester ce fournisseur revient à rester dans le périmètre.
2. Les longues sessions affaiblissent les prompts système
Au fil de son exécution, un agent traite des milliers de lignes de trafic HTTP, de messages d'erreur et de schémas d'API. Avec le temps, le prompt système initial est dilué par le volume massif de nouveau texte dans sa fenêtre de mémoire.
3. Les systèmes cloud sont complexes
Les applications modernes s'exécutent sur des CDN, des microservices, des fournisseurs de connexion tiers et des backends SaaS. Une IA ne peut pas déterminer de façon fiable à qui appartient légalement un domaine à partir de son seul nom ou de son adresse IP.
┌────────────────────────────────────────────────────────────────────────┐
│                     LA LEÇON CENTRALE DU PÉRIMÈTRE                     │
├────────────────────────────────────────────────────────────────────────┤
│  On ne peut pas s'en remettre au raisonnement d'une IA pour limiter    │
│  l'IA.                                                                 │
│                                                                        │
│  Un modèle de raisonnement ne peut pas être son propre bac à sable.    │
│  Les limites doivent être codées en dur, externes et appliquées par    │
│  l'infrastructure sous-jacente.                                        │
└────────────────────────────────────────────────────────────────────────┘
Comment nous contenons les agents autonomes
Ostorlab contient les agents autonomes grâce à des contrôles situés en dehors du modèle : des garde-fous de périmètre définis par le créateur du scan avant son démarrage, une liste de blocage d'adresses IP au niveau du système et une limitation de débit adaptative. Un prompt n'est pas une frontière de sécurité : les contrôles les plus importants sont donc ceux que l'agent ne peut pas contourner à force de persuasion. La liste d'autorisation des destinations, l'approbation des actions et les fenêtres horaires de scan sont les prochains contrôles que nous déployons.
Des garde-fous de périmètre, définis avant le démarrage du scan
Chaque scan démarre avec des garde-fous par défaut restrictifs. Par-dessus, le créateur du scan définit le périmètre dans le parcours de création du scan : quels hôtes sont dans le périmètre, quels environnements sont exclus et quelles instructions de sécurité l'agent doit respecter. Aucune intervention d'Ostorlab n'est nécessaire. Le périmètre est décidé par les personnes qui possèdent la cible, avant l'envoi de la moindre requête.
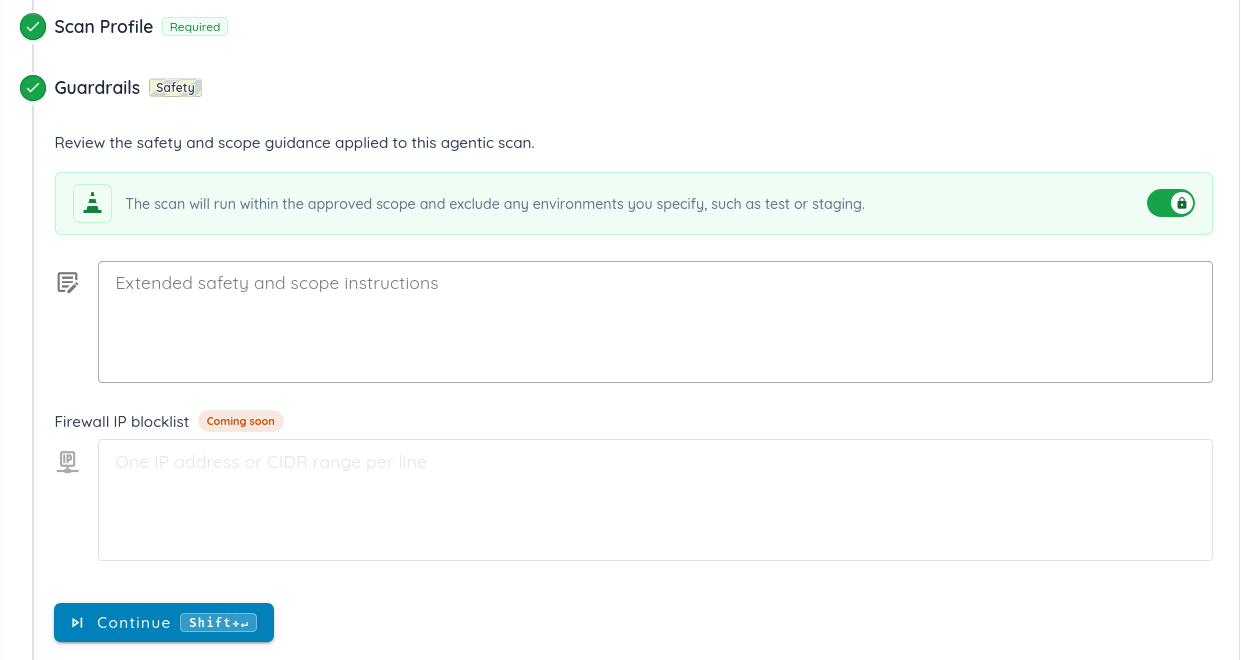
Liste de blocage d'adresses IP du pare-feu, appliquée par le système
Le créateur du scan répertorie les adresses IP que le trafic du scan ne doit jamais atteindre. C'est le système, et non l'agent, qui applique cette liste : aucun raisonnement de l'agent ne peut donc la contourner.
Limitation de débit adaptative, appliquée par le système
Tout le trafic passe par une limitation de débit (requêtes par seconde) qui s'adapte au taux de réponse et au taux d'erreur de la cible. Si un serveur ralentit ou commence à renvoyer des erreurs, le scan ralentit de lui-même.
Prochainement
- Liste d'autorisation des destinations : seules les destinations explicitement approuvées peuvent recevoir des requêtes actives.
- Approbation des actions importantes : le créateur du scan est alerté et les approuve ou les refuse avant leur exécution.
- Fenêtres horaires de scan : les scans ne s'exécutent que pendant les heures que vous définissez.
Le problème du battage médiatique autour de l'IA en cybersécurité
Une grande partie du secteur considère le hacking autonome par IA comme un coup marketing. Des entreprises publient des vidéos d'agents IA qui s'introduisent dans des réseaux d'entreprise, traitant des outils dangereux comme des tours de magie.
Nous ne partageons pas cet état d'esprit.
Donner à un logiciel la capacité d'exécuter des attaques en plusieurs étapes contre des réseaux en production comporte un risque réel. Quand un logiciel peut raisonner à travers plusieurs systèmes, il n'y a aucune marge d'erreur. Maîtriser ce pouvoir exige une rigueur d'ingénierie stricte, des défenses en couches et une transparence totale quand les choses tournent mal, et non des campagnes marketing triomphantes.
Conclusion
Les agents IA autonomes peuvent trouver des failles complexes de logique métier que les scanners traditionnels manquent totalement.
Cependant, faire confiance à un modèle d'IA pour se surveiller lui-même en production est une erreur dangereuse. Les frontières de sécurité doivent être appliquées en dehors du modèle. C'est pourquoi Ostorlab associe des garde-fous de périmètre à une liste de blocage d'adresses IP au niveau du système et à une limitation de débit adaptative, et pourquoi la liste d'autorisation des destinations vient ensuite.
Le véritable test des outils de sécurité autonomes n'est pas l'ingéniosité de leurs attaques : c'est la fiabilité avec laquelle on peut les contenir.