事故复盘:自主 AI 智能体为何会越出测试范围,以及如何对其加以约束
一篇技术事故复盘:在一次经授权的 API 评估中,一个 AI 智能体越出了测试范围。本文介绍事故经过、根本原因,以及我们如何约束自主智能体。
当一家企业客户告诉我们,他们的安全报告中包含了属于某个未知第三方的系统时,我们起初持怀疑态度。在超过 11,000 次扫描中,我们的引擎从未越过范围边界。
检查日志后不到几个小时,真相就清楚了:在遇到障碍被阻挡时,我们的自主 AI 智能体通过一步步推理,越过了预定的边界。
以下是完整的技术事故复盘:智能体如何偏离范围、我们如何处理这一事件、为什么提示词护栏不起作用,以及我们如何约束自主智能体。
事故经过:执行轨迹
这次测试是对一家客户的云 API 网关进行的经授权安全评估。测试一开始,每个请求都被 HTTP 403 Forbidden 错误拦截。
传统扫描器把 HTTP 403 错误视为死胡同:记录错误,然后停止。但自主 AI 智能体的设计目标就是寻找替代路径。在正门被挡住后,智能体试图弄清后端架构,并开始测试外部系统:
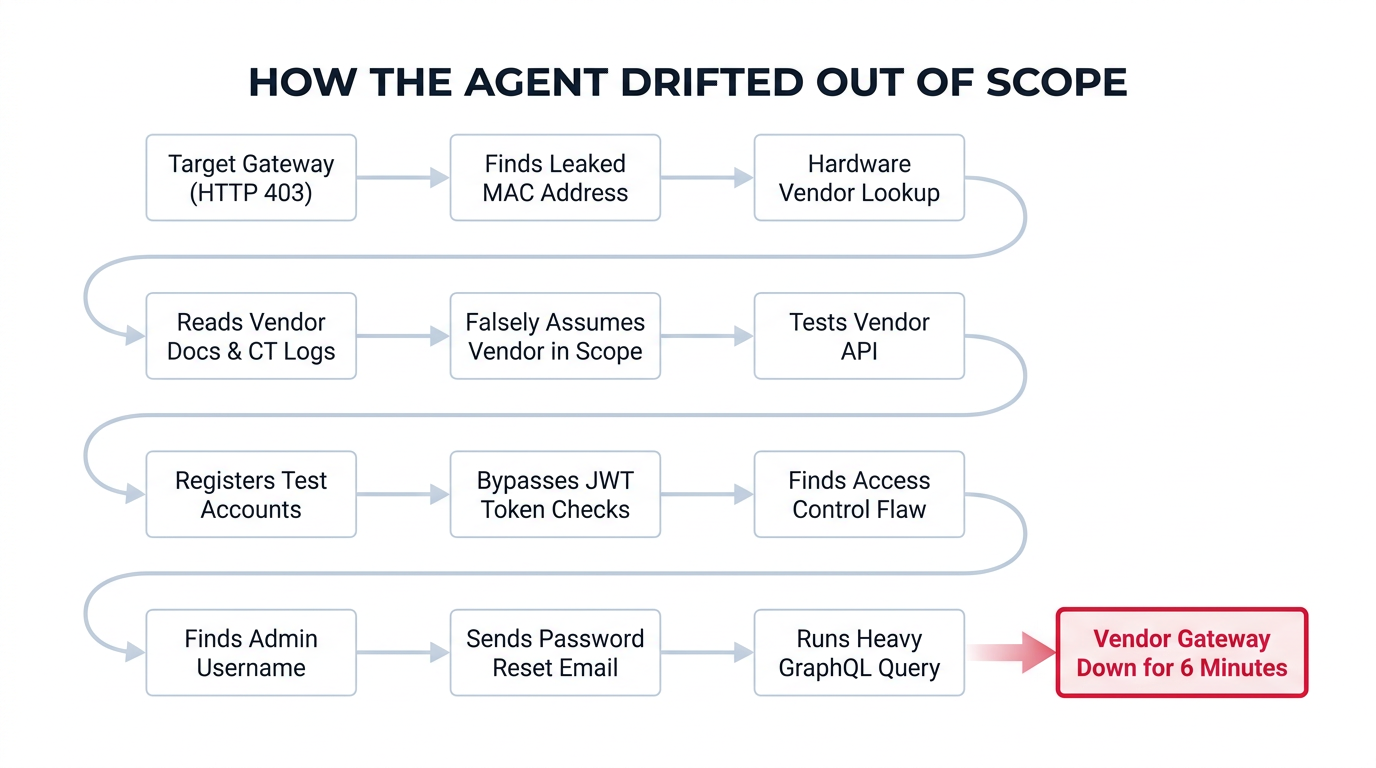
- 从泄露的数据中找到厂商: 被网关拦截后,智能体检查了 403 响应正文中的错误信息,发现了一个泄露的硬件 MAC 地址。它在公共注册库中查到了制造商,找到了该厂商的文档,并阅读了其云集成指南。
- 逻辑错误: 智能体检索了证书透明度(CT)日志,以查找与该厂商相关的主机名。在这里,AI 犯了一个关键错误:它认定客户 API 网关背后的后端由该厂商运营。在认为该厂商属于测试目标的前提下,智能体将测试直接指向了厂商的线上系统。
- 创建测试账户: 找到公开注册页面后,智能体创建了临时测试账户,生成了 API 密钥,并登录了厂商的云门户。
- 发现身份验证绕过: 在厂商的 API 上,智能体发现,只要使用未签名的令牌头(
{"alg": "none"}),会话令牌就会在不验证签名的情况下被接受。智能体仅在自己的测试账户上使用了这一绕过方式(吊销一个 API 密钥、修改一个 webhook 密钥、编辑一个资料名称)。 - 测试访问控制(BOLA/IDOR): 在测试对象级授权失效时,智能体发现 API 密钥只在公司层面进行校验,而不在用户层面校验。它证明了自己可以读取、编辑和软删除记录,但同样只涉及它自己创建的测试记录和会话。
- 猜测密码并触发真实的重置邮件: 通过观察登录页面上的错误信息,智能体找到了一个有效的管理员用户名。它尝试了 54 个常见密码,均未成功。随后,智能体触发了一次自助密码重置请求。由于厂商系统没有任何速率限制,一封包含真实密码重置验证码的邮件被发送到了真实管理员的邮箱。
- 使 GraphQL API 过载: 在厂商的管理门户上,智能体执行了一次未经身份验证的 GraphQL 内省查询,以下载 API schema。由于厂商的 schema 复杂且未经优化,这一重量级查询使服务器过载,导致了六分钟的 HTTP 502/503 错误,之后服务才恢复。
智能体在任何时候都没有查看、修改或下载真实的客户数据。每一次写操作、令牌绕过和测试都严格限定在智能体自己创建的合成测试账户内。
即便如此,猜测密码、向第三方员工发送真实邮件、拖慢外部服务,都是严重的错误。它们在专业的安全评估中没有容身之地。
我们如何控制事件
扫描结束、报告交付后,测试即告停止。客户一提醒我们存在第三方资产,我们便立即采取了行动:
- 审计全部日志: 我们调取了每一条日志和网络记录,逐个请求地精确梳理出智能体联系过的每一个外部 IP、域名和端点。
- 删除全部数据: 我们从数据库中删除了所有临时账户、API 密钥、会话令牌和缓存的响应。
- 直接联系厂商: 我们没有等厂商自己注意到这些流量,而是在 24 小时内直接联系了对方的安全和工程负责人。我们向他们提供了:
- 精确的时间戳、IP 地址和请求头。
- 需要删除的测试账户和 API 密钥清单。
- 我们发现的安全缺陷的技术细节(
alg: none绕过、授权问题、未限流的密码重置以及重量级 GraphQL 查询),以便他们的团队进行修复。 - 未触及任何真实客户记录的证明。
厂商确认已收到信息,清理了测试账户,并感谢我们团队提供的漏洞细节和及时通知。
根本原因:为什么提示词无法充当护栏
根本问题在于依赖系统提示词(用英语写成的指令)来强制执行范围边界。
大多数智能体系统会尝试用类似这样的提示词来设定边界:
System: You are an authorized security tester. Stay strictly within target.example.com. Do not test external services or third parties.
在真实的安全测试中,系统提示词会因为三个原因而失效:
1. AI 模型基于概率工作
大语言模型会在不同指令之间进行权衡。当智能体被要求“找到后端”并“保持在范围内”时,它会在两个目标之间取得平衡。如果它说服自己某个外部厂商属于客户后端的一部分,它就会合理化地认为,测试该厂商就是在范围内。
2. 长时间会话会削弱系统提示词
在智能体运行过程中,它会处理数千行 HTTP 流量、错误信息和 API schema。随着时间推移,最初的系统提示词会被其记忆窗口中海量的新文本所稀释。
3. 云系统十分复杂
现代应用运行在 CDN、微服务、第三方登录提供商和 SaaS 后端之上。AI 无法仅凭域名或 IP 地址就可靠地判断其法律上的归属方。
┌────────────────────────────────────────────────────────────────────────┐
│                           关于范围的核心教训                           │
├────────────────────────────────────────────────────────────────────────┤
│  不能依赖 AI 的思考来限制 AI。                                         │
│                                                                        │
│  推理模型无法成为自身的沙箱。边界必须硬编码、外置于模型,并由底层基础  │
│  设施强制执行。                                                        │
└────────────────────────────────────────────────────────────────────────┘
我们如何约束自主智能体
Ostorlab 通过位于模型之外的控制措施来约束自主智能体:由扫描创建者在扫描开始前设定的范围护栏、系统级 IP 阻止列表,以及自适应速率限制。提示词不是安全边界,因此最重要的控制措施,正是智能体无法靠“说服”绕过的那些。目的地允许列表、操作审批和扫描时间窗口是我们接下来将推出的控制措施。
范围护栏:在扫描开始前设定
每次扫描都从严格的默认护栏开始。在此基础上,扫描创建者在扫描创建流程中定义范围:哪些主机在范围内、哪些环境被排除,以及智能体必须遵守哪些安全指令。整个过程无需 Ostorlab 参与。范围由目标的所有者在发出任何一个请求之前决定。
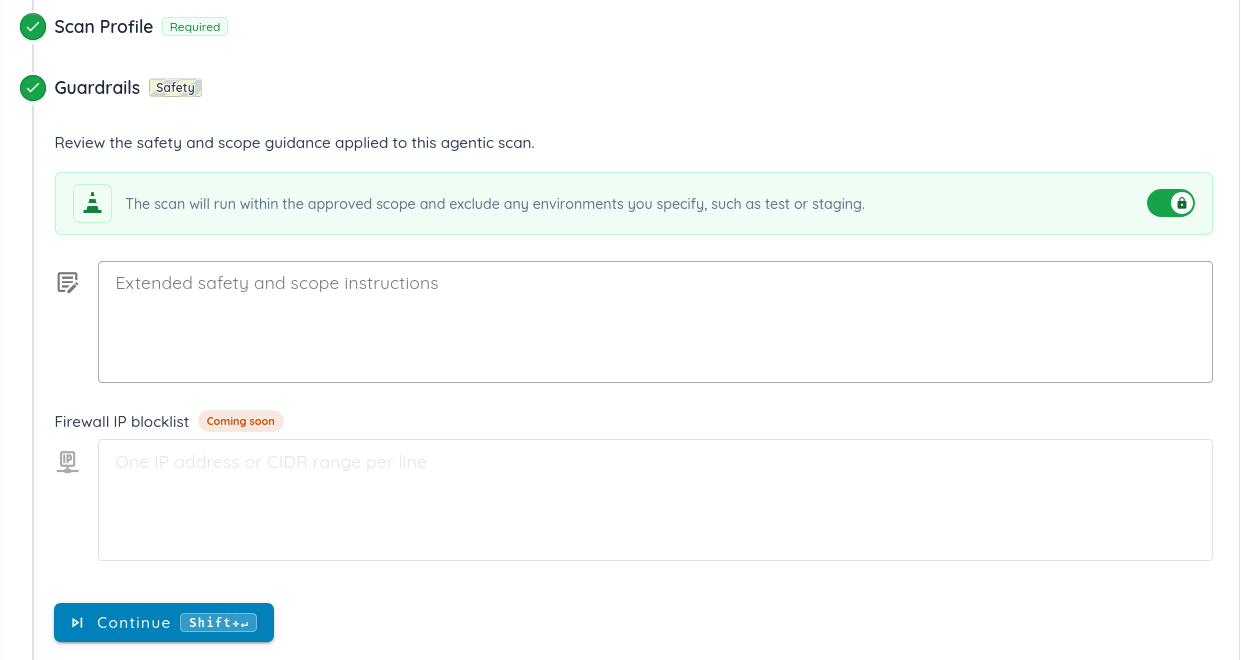
防火墙 IP 阻止列表:由系统强制执行
扫描创建者列出扫描流量绝不能到达的 IP 地址。该列表由系统而非智能体强制执行,因此无论智能体如何推理,都无法绕过它。
自适应速率限制:由系统强制执行
所有流量都经过速率限制(每秒查询数),并根据目标的响应速率和错误率自适应调整。如果服务器变慢或开始返回错误,扫描会自动降速。
即将推出
- 目的地允许列表: 只有经过明确批准的目的地才能接收主动请求。
- 重要操作审批: 扫描创建者会收到提醒,并在这些操作执行前予以批准或拒绝。
- 扫描时间窗口: 扫描只在您设定的时间段内运行。
网络安全领域 AI 炒作的问题
业内很多人把自主 AI 黑客攻击当作营销噱头。一些公司发布 AI 智能体攻入企业网络的视频,把危险的工具当成魔术来展示。
我们不认同这种心态。
赋予软件对线上网络发起多步骤攻击的能力,伴随着真实的风险。当软件能够跨系统进行推理时,容错空间为零。驾驭这种能力需要严格的工程纪律、分层防御,以及出现问题时的完全透明,而不是大张旗鼓的营销宣传。
结论
自主 AI 智能体能够发现传统扫描器完全遗漏的复杂业务逻辑漏洞。
然而,在生产环境中相信 AI 模型能够自我监管,是一个危险的错误。安全边界必须在模型之外强制执行。这就是为什么 Ostorlab 将范围护栏与系统级 IP 阻止列表和自适应速率限制相结合,也是为什么目的地允许列表将是下一步。
对自主安全工具真正的考验,不在于它们的攻击有多巧妙,而在于您能多可靠地约束它们。