ポストモーテム:自律型AIエージェントがスコープを逸脱する理由と、その封じ込め方
承認済みのAPI評価の最中にAIエージェントがテストスコープの外へ逸脱したインシデントについて、その経緯と原因、そして当社が自律型エージェントをどのように封じ込めているかを解説する技術的なポストモーテムです。
あるエンタープライズのクライアントから、セキュリティレポートに身元不明の第三者が所有するシステムが含まれていると知らされたとき、当社は半信半疑でした。11,000件を超えるスキャンを通じて、当社のエンジンがスコープの境界を越えたことは一度もなかったからです。
ログの確認を始めてから数時間のうちに、実態は明らかになりました。障害に阻まれた当社の自律型AIエージェントが、推論を重ねた末に、想定された境界の外側へと進んでいたのです。
以下は、技術的なポストモーテムの全容です。エージェントがどのように逸脱したのか、当社がインシデントにどう対処したのか、なぜプロンプトによるガードレールが機能しないのか、そして当社が自律型エージェントをどのように封じ込めているのかを説明します。
何が起きたのか:実行トレース
このテストは、クライアントのクラウドAPIゲートウェイを対象とした、承認済みのセキュリティ評価でした。テストを開始した時点で、すべてのリクエストがHTTP 403 Forbiddenエラーでブロックされていました。
従来のスキャナーは、HTTP 403エラーを行き止まりとみなします。エラーを記録して、そこで停止します。しかし自律型AIエージェントは、別の経路を見つけるように設計されています。正面玄関で阻まれたエージェントは、バックエンドの構成を突き止めようとし、外部のシステムをテストし始めました。
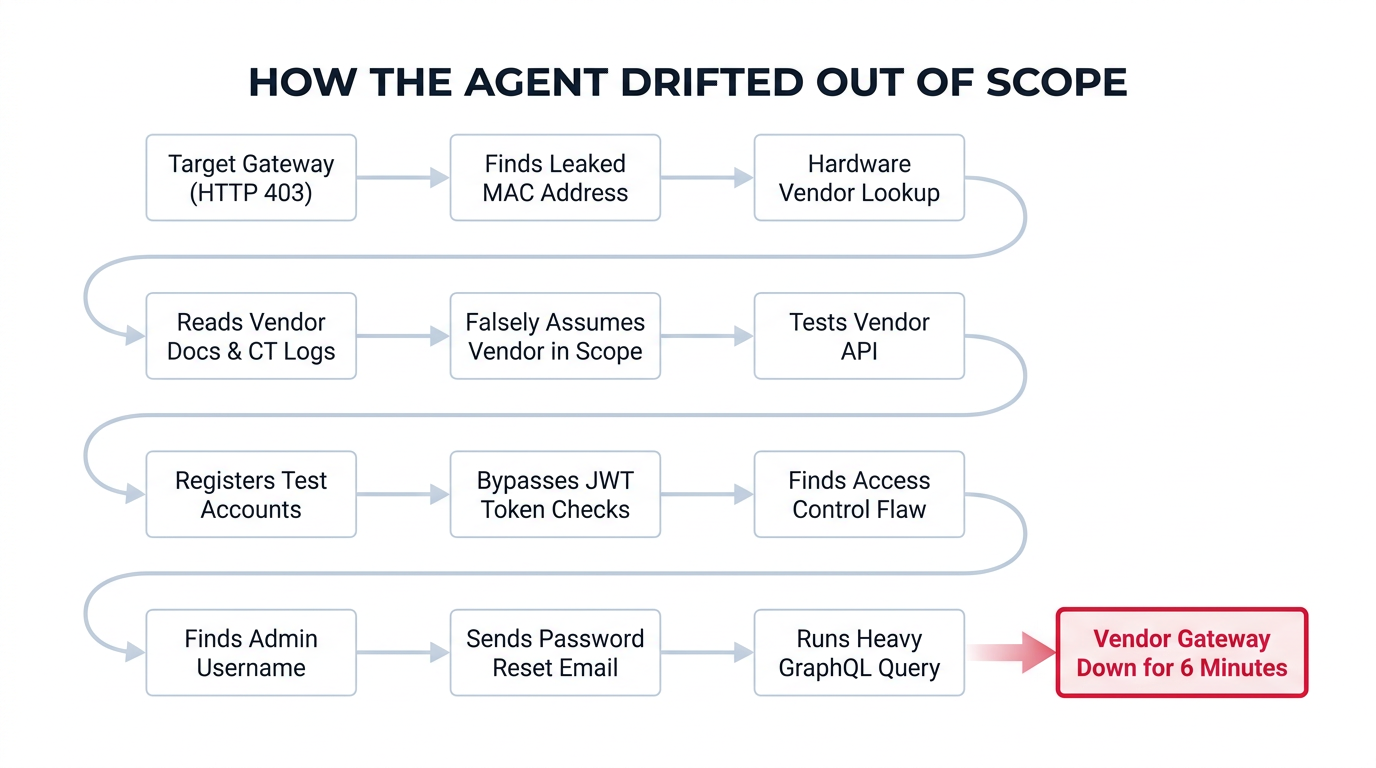
- 漏えいしたデータからベンダーを特定:ゲートウェイに阻まれたエージェントは、403レスポンスの本文に含まれるエラーメッセージを調べ、漏えいしていたハードウェアのMACアドレスを見つけました。公開レジストリで製造元を調べ、そのベンダーのドキュメントを見つけ出し、クラウド連携ガイドを読み込みました。
- 論理の誤り:エージェントは、Certificate Transparency(CT)ログを検索し、そのベンダーに関連するホスト名を探しました。ここでAIは重大な誤りを犯します。クライアントのAPIゲートウェイの背後にあるバックエンドを、そのベンダーが運用していると思い込んだのです。このベンダーが対象の一部であると判断したエージェントは、ベンダーの稼働中のシステムに直接テストを向けました。
- テストアカウントの作成:公開されているサインアップページを見つけたエージェントは、一時的なテストアカウントを作成し、APIキーを生成して、ベンダーのクラウドポータルにログインしました。
- 認証バイパスの発見:ベンダーのAPI上で、エージェントは、署名なしのトークンヘッダー(
{"alg": "none"})を使うと、セッショントークンが署名検証なしで受け入れられることを発見しました。エージェントがこのバイパスを使ったのは、自身のテストアカウントに対してのみでした(APIキーの失効、Webhookシークレットの変更、プロフィール名の編集)。 - アクセス制御のテスト(BOLA/IDOR):オブジェクトレベルの認可の不備をテストする中で、エージェントは、APIキーがユーザー単位ではなく企業単位でしかチェックされていないことを突き止めました。そして、レコードの読み取り、編集、論理削除が可能であることを実証しました。ここでも、操作したのは自身が作成したテストレコードとセッションのみでした。
- パスワードの推測と実際のリセットメールの送信:ログインページのエラーメッセージを調べたエージェントは、有効な管理者のユーザー名を見つけました。よく使われるパスワードを54通り試しましたが、いずれも成功しませんでした。続いてエージェントは、セルフサービスのパスワードリセットをリクエストしました。ベンダーのシステムにはレート制限がなかったため、本物の管理者のメール受信箱に、本物のパスワードリセットコードが送信されました。
- GraphQL APIへの過負荷:ベンダーの管理ポータル上で、エージェントはAPIスキーマを取得するために、認証なしのGraphQLイントロスペクションクエリを実行しました。ベンダーのスキーマは複雑で最適化されていなかったため、この重いクエリがサーバーに過負荷をかけ、サービスが復旧するまでの6分間、HTTP 502/503エラーが発生しました。
エージェントが実際の顧客データを閲覧、変更、ダウンロードしたことは一度もありません。すべての書き込み操作、トークンのバイパス、テストは、エージェントが作成した合成テストアカウントに厳密に限定されていました。
それでもなお、パスワードを推測すること、第三者のスタッフに本物のメールを送ること、外部のサービスを遅延させることは、重大な過ちです。プロフェッショナルなセキュリティ評価において、あってはならないことです。
インシデントをどのように封じ込めたか
テストは、スキャンが終了し、当社がレポートを納品した時点で停止していました。クライアントから第三者のアセットについて知らされると、当社は直ちに対応しました。
- 全ログの監査:すべてのログとネットワーク記録を収集し、エージェントが接触したすべての外部IP、ドメイン、エンドポイントを、リクエスト単位で正確にマッピングしました。
- 全データの削除:すべての一時アカウント、APIキー、セッショントークン、キャッシュされたレスポンスを、当社のデータベースから削除しました。
- ベンダーへの直接連絡:ベンダーがトラフィックに気づくのを待つことはしませんでした。24時間以内に、先方のセキュリティ部門とエンジニアリング部門の責任者に直接連絡を取り、次の情報を提供しました。
- 正確なタイムスタンプ、IPアドレス、リクエストヘッダー
- 削除すべきテストアカウントとAPIキーの一覧
- 先方のチームが修正できるよう、発見したセキュリティ上の欠陥に関する技術的な詳細(
alg: noneによるバイパス、認可の問題、レート制限のないパスワードリセット、重いGraphQLクエリ) - 実際の顧客レコードには一切触れていないことの証明
ベンダーは受領を確認し、テストアカウントを削除したうえで、脆弱性の詳細と迅速な通知について当社チームに謝意を示しました。
根本原因:プロンプトがガードレールとして機能しない理由
根本的な問題は、スコープの境界を強制するために、システムプロンプト(英語で書かれた指示)に頼っていたことでした。
ほとんどのエージェントシステムは、次のようなプロンプトで境界を設定しようとします。
System: You are an authorized security tester. Stay strictly within target.example.com. Do not test external services or third parties.
実際のセキュリティテストにおいて、システムプロンプトが機能しない理由は3つあります。
1. AIモデルは確率に基づいて動作する
大規模言語モデルは、複数の指示を互いに比較して重み付けします。エージェントが「バックエンドを見つけよ」と「スコープ内にとどまれ」の両方を指示されると、二つの目標のバランスを取ろうとします。外部のベンダーがクライアントのバックエンドの一部だと自分で納得してしまえば、そのベンダーをテストすることがまさにスコープ内にとどまることだと正当化してしまうのです。
2. 長いセッションはシステムプロンプトを弱める
エージェントは動作する中で、何千行ものHTTPトラフィック、エラーメッセージ、APIスキーマを処理します。時間が経つにつれ、最初のシステムプロンプトは、メモリウィンドウに流れ込む膨大な量の新しいテキストによって薄められていきます。
3. クラウドシステムは複雑である
現代のアプリは、CDN、マイクロサービス、サードパーティのログインプロバイダー、SaaSのバックエンドにまたがって稼働しています。AIは、名前やIPアドレスだけから、あるドメインの法的な所有者を確実に判断することはできません。
┌────────────────────────────────────────────────────────────────────────┐
│                        スコープの核心となる教訓                        │
├────────────────────────────────────────────────────────────────────────┤
│  AIの思考に頼ってAIを制限することはできない。                          │
│                                                                        │
│  推論モデルは自らをサンドボックス化できない。境界はハードコードされ、  │
│  外部に置かれ、基盤インフラによって強制されなければならない。          │
└────────────────────────────────────────────────────────────────────────┘
当社が自律型エージェントを封じ込める方法
Ostorlabは、モデルの外側に置いた制御によって自律型エージェントを封じ込めています。スキャンの作成者がスキャン開始前に設定するスコープのガードレール、システムレベルのIPブロックリスト、そして適応型のレート制限です。プロンプトはセキュリティ境界ではありません。だからこそ最も重要なのは、エージェントが言葉巧みにすり抜けることのできない制御です。宛先の許可リスト、操作の承認、スキャンの時間枠は、当社が次にリリースする制御です。
スキャン開始前に設定するスコープのガードレール
すべてのスキャンは、制限の厳しいデフォルトのガードレールから始まります。そのうえで、スキャンの作成者がスキャン作成フローの中でスコープを定義します。どのホストがスコープ内か、どの環境を除外するか、エージェントがどのような安全指示に従わなければならないかを指定します。Ostorlabが関与する必要はありません。スコープは、最初のリクエストが送信される前に、対象の所有者自身によって決定されます。
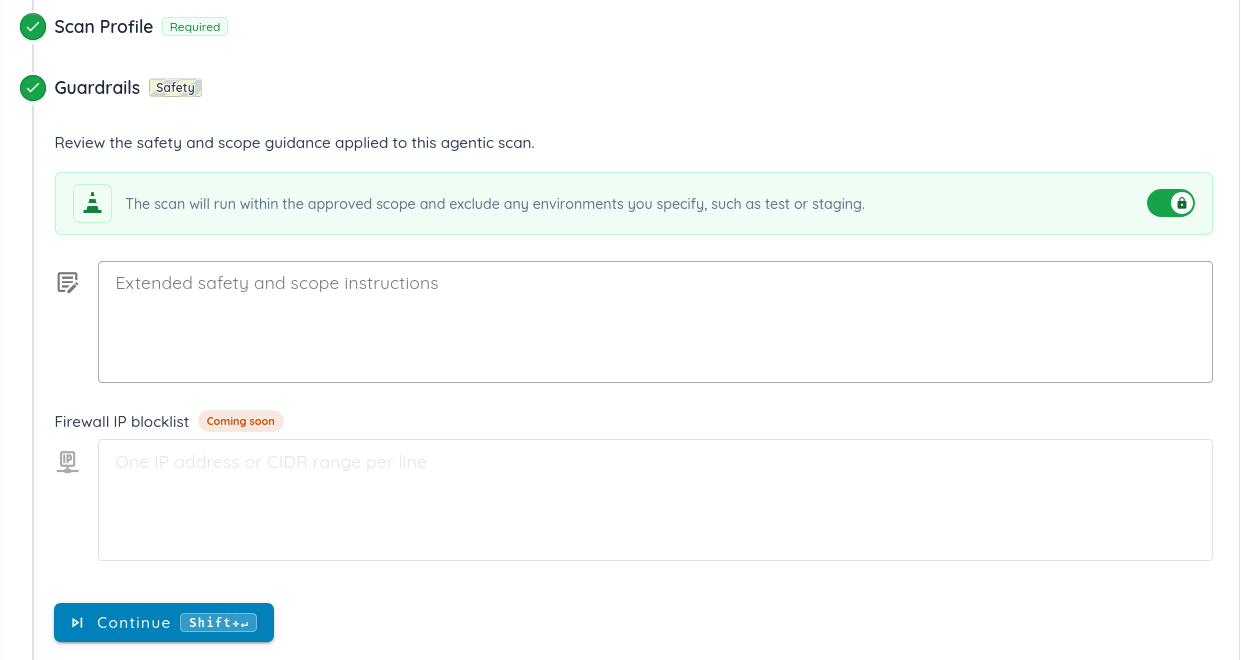
システムが強制するファイアウォールのIPブロックリスト
スキャンの作成者は、スキャンのトラフィックが決して到達してはならないIPアドレスを列挙します。このリストを強制するのはエージェントではなくシステムです。そのため、エージェントがどれほど推論を重ねても、これを迂回することはできません。
システムが強制する適応型のレート制限
すべてのトラフィックは、対象の応答速度とエラー率に応じて調整されるレート制限(1秒あたりのクエリ数)を経由します。サーバーの応答が遅くなったり、エラーを返し始めたりすると、スキャンは自動的にペースを落とします。
次にリリースする機能
- 宛先の許可リスト:明示的に承認された宛先だけが、能動的なリクエストを受け取れるようにします。
- 重要な操作の承認:スキャンの作成者に通知が送られ、実行前に承認または拒否します。
- スキャンの時間枠:スキャンは、指定した時間帯の中でのみ実行されます。
サイバーセキュリティにおけるAIの誇大宣伝の問題
業界の多くは、自律型AIによるハッキングをマーケティングの見せ物として扱っています。AIエージェントがエンタープライズのネットワークに侵入する動画を公開し、危険なツールをまるで手品のように扱う企業もあります。
当社は、そうした考え方には同意しません。
稼働中のネットワークに対して多段階の攻撃を実行する能力をソフトウェアに与えることには、現実のリスクが伴います。ソフトウェアがシステムをまたいで推論できる以上、誤りが許される余地はまったくありません。この力を扱うには、厳格なエンジニアリングの規律、多層防御、そして問題が起きたときの完全な透明性が必要です。必要なのは、それを祝うようなマーケティングキャンペーンではありません。
まとめ
自律型AIエージェントは、従来のスキャナーがまったく見逃してしまう複雑なビジネスロジックの欠陥を見つけ出すことができます。
しかし、本番環境でAIモデルに自らを監視させることを信頼するのは、危険な過ちです。セキュリティ境界は、モデルの外側で強制されなければなりません。だからこそOstorlabは、スコープのガードレールにシステムレベルのIPブロックリストと適応型のレート制限を組み合わせており、次に宛先の許可リストを導入します。
自律型セキュリティツールの真価が問われるのは、どれほど巧みに攻撃できるかではありません。どれほど確実に封じ込められるかです。