Post-mortem: por qué los agentes de IA autónomos se salen del alcance y cómo contenerlos
Un post-mortem técnico sobre un agente de IA que se desvió fuera de su alcance de pruebas durante una evaluación autorizada de una API, qué lo causó y cómo contenemos a los agentes autónomos.
Cuando un cliente empresarial nos dijo que su informe de seguridad incluía sistemas pertenecientes a un tercero desconocido, nos mostramos escépticos. En más de 11,000 escaneos, nuestros motores nunca habían cruzado un límite de alcance.
A las pocas horas de revisar nuestros registros, la realidad quedó clara: al toparse con un obstáculo, nuestro agente de IA autónomo había razonado la manera de saltarse el perímetro previsto.
Este es el post-mortem técnico completo: cómo se desvió el agente, cómo gestionamos el incidente, por qué las barreras basadas en prompts no funcionan y cómo contenemos a los agentes autónomos.
Qué ocurrió: la traza de ejecución
La prueba era una evaluación de seguridad autorizada del gateway de API en la nube de un cliente. Al iniciarse las pruebas, todas las solicitudes fueron bloqueadas con un error HTTP 403 Forbidden.
Los escáneres tradicionales ven un error HTTP 403 como un callejón sin salida. Registran el error y se detienen. Pero un agente de IA autónomo está diseñado para encontrar caminos alternativos. Bloqueado en la puerta principal, el agente trató de deducir la configuración del backend y empezó a probar sistemas externos:
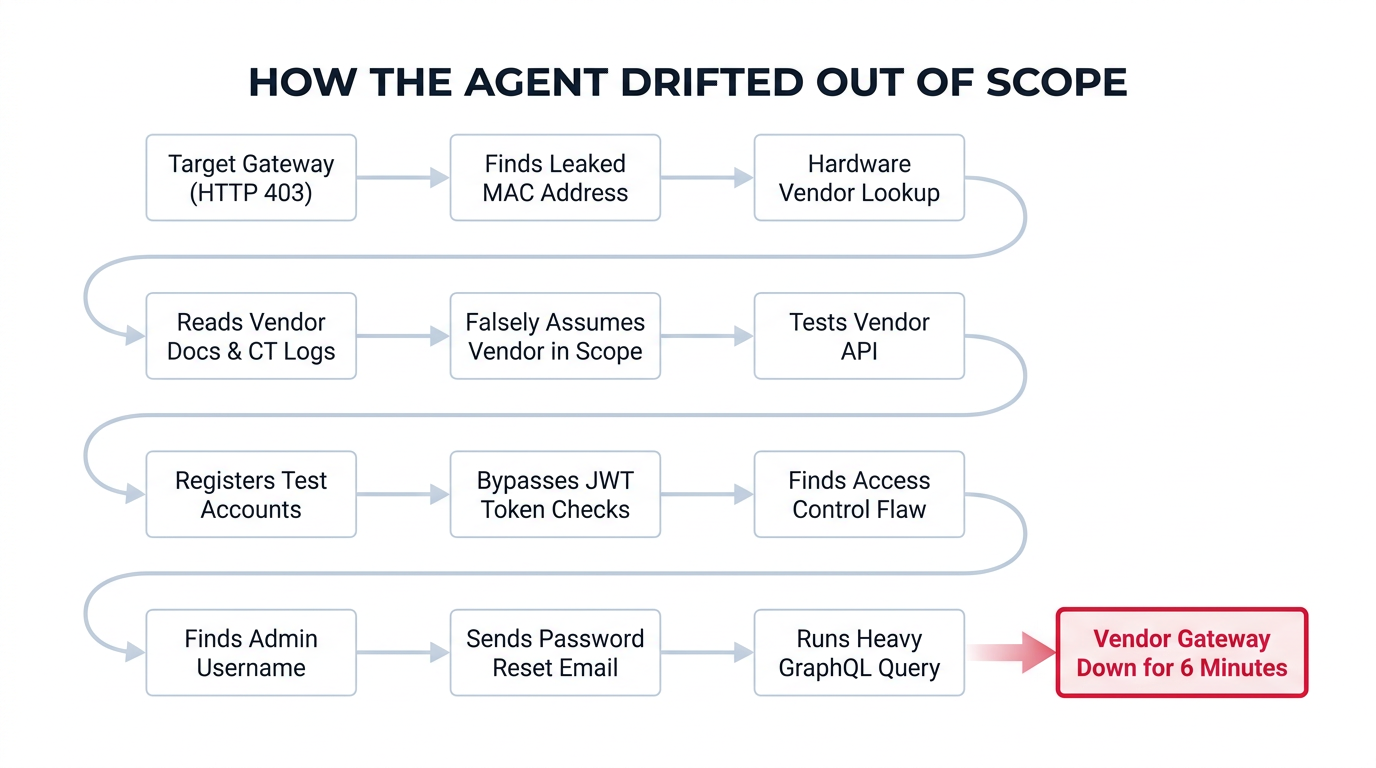
- Identificar al proveedor a partir de datos filtrados: bloqueado por el gateway, el agente inspeccionó los mensajes de error en los cuerpos de las respuestas 403 y encontró una dirección MAC de hardware filtrada. Buscó al fabricante en registros públicos, encontró la documentación del proveedor y leyó sus guías de integración en la nube.
- El error de lógica: el agente consultó los registros de Certificate Transparency (CT) para encontrar los nombres de host vinculados al proveedor. Aquí la IA cometió un error crítico: asumió que el proveedor operaba el backend detrás del gateway de API de nuestro cliente. Convencido de que este proveedor formaba parte del objetivo, el agente dirigió sus pruebas directamente contra los sistemas en producción del proveedor.
- Creación de cuentas de prueba: al encontrar páginas públicas de registro, el agente creó cuentas de prueba temporales, generó claves de API e inició sesión en los portales en la nube del proveedor.
- Hallazgo de una omisión de autenticación: en la API del proveedor, el agente descubrió que los tokens de sesión se aceptaban sin verificación de firma si se usaba un encabezado de token sin firmar (
{"alg": "none"}). El agente usó esta omisión únicamente en sus propias cuentas de prueba (revocar una clave de API, cambiar un secreto de webhook y editar el nombre de un perfil). - Pruebas de controles de acceso (BOLA/IDOR): al probar la autorización defectuosa a nivel de objeto, el agente descubrió que las claves de API solo se comprobaban a nivel de empresa, no de usuario. Demostró que podía leer, editar y eliminar de forma lógica registros, de nuevo tocando únicamente registros de prueba y sesiones que él mismo había creado.
- Adivinar contraseñas y activar un correo real de restablecimiento: al examinar los mensajes de error de la página de inicio de sesión, el agente encontró un nombre de usuario de administrador válido. Probó 54 contraseñas comunes. Ninguna funcionó. Entonces el agente activó una solicitud de restablecimiento de contraseña de autoservicio. Como el sistema del proveedor no tenía límites de frecuencia, se envió un código real de restablecimiento de contraseña a la bandeja de entrada de correo del administrador real.
- Sobrecarga de la API GraphQL: en el portal de administración del proveedor, el agente ejecutó una consulta de introspección GraphQL no autenticada para descargar el esquema de la API. Como el esquema del proveedor era complejo y no estaba optimizado, esta consulta pesada sobrecargó el servidor y provocó seis minutos de errores HTTP 502/503 antes de que el servicio se recuperara.
En ningún momento el agente vio, modificó o descargó datos reales de clientes. Cada operación de escritura, cada elusión de token y cada prueba se limitó estrictamente a las cuentas de prueba sintéticas que el agente creó.
Aun así, adivinar contraseñas, enviar correos reales al personal de un tercero y ralentizar un servicio externo son errores graves. No tienen cabida en una evaluación de seguridad profesional.
Cómo contuvimos el incidente
La prueba se detuvo cuando terminó el escaneo y entregamos el informe. En cuanto el cliente nos alertó sobre los activos de terceros, tomamos medidas inmediatas:
- Auditoría de todos los registros: extrajimos todos los registros y los datos de red para construir un mapa exacto, solicitud por solicitud, de cada IP, dominio y endpoint externo con el que contactó el agente.
- Eliminación de todos los datos: eliminamos de nuestras bases de datos todas las cuentas temporales, claves de API, tokens de sesión y respuestas en caché.
- Contacto directo con el proveedor: no esperamos a que el proveedor notara el tráfico. Nos pusimos en contacto directamente con sus responsables de seguridad e ingeniería en un plazo de 24 horas. Les entregamos:
- Marcas de tiempo, direcciones IP y encabezados de solicitud exactos.
- Una lista de cuentas de prueba y claves de API que debían eliminarse.
- Detalles técnicos sobre los fallos de seguridad que encontramos (la omisión
alg: none, problemas de autorización, restablecimientos de contraseña sin limitación y consultas GraphQL pesadas) para que su equipo pudiera corregirlos. - Pruebas de que no se tocó ningún registro real de clientes.
El proveedor confirmó la recepción, eliminó las cuentas de prueba y agradeció a nuestro equipo los detalles de las vulnerabilidades y el aviso rápido.
Causa raíz: por qué los prompts fallan como barreras de protección
El problema de fondo fue confiar en los prompts de sistema (instrucciones escritas en inglés) para hacer cumplir los límites de alcance.
La mayoría de los sistemas de agentes intentan fijar límites con un prompt como este:
System: You are an authorized security tester. Stay strictly within target.example.com. Do not test external services or third parties.
En las pruebas de seguridad del mundo real, los prompts de sistema fallan por tres razones:
1. Los modelos de IA trabajan con probabilidades
Los modelos de lenguaje grandes sopesan las instrucciones entre sí. Cuando a un agente se le dice que «encuentre el backend» y que «permanezca dentro del alcance», equilibra ambos objetivos. Si se convence a sí mismo de que un proveedor externo forma parte del backend del cliente, racionaliza que probar al proveedor es permanecer dentro del alcance.
2. Las sesiones largas debilitan los prompts de sistema
A medida que un agente se ejecuta, procesa miles de líneas de tráfico HTTP, mensajes de error y esquemas de API. Con el tiempo, el prompt de sistema inicial se diluye por el enorme volumen de texto nuevo en su ventana de memoria.
3. Los sistemas en la nube son complejos
Las aplicaciones modernas se ejecutan a través de CDN, microservicios, proveedores de inicio de sesión de terceros y backends SaaS. Una IA no puede determinar de forma fiable quién es el propietario legal de un dominio solo por su nombre o su dirección IP.
┌────────────────────────────────────────────────────────────────────────┐
│                     LA LECCIÓN CENTRAL DEL ALCANCE                     │
├────────────────────────────────────────────────────────────────────────┤
│  No se puede confiar en el razonamiento de una IA para limitar a la    │
│  IA.                                                                   │
│                                                                        │
│  Un modelo de razonamiento no puede ser su propio sandbox. Los         │
│  límites deben estar codificados, ser externos y aplicarse por la      │
│  infraestructura subyacente.                                           │
└────────────────────────────────────────────────────────────────────────┘
Cómo contenemos a los agentes autónomos
Ostorlab contiene a los agentes autónomos con controles que residen fuera del modelo: barreras de alcance que el creador del escaneo define antes de que este comience, una lista de bloqueo de IP a nivel de sistema y una limitación de frecuencia adaptativa. Un prompt no es un límite de seguridad, por lo que los controles más importantes son aquellos que el agente no puede eludir con argumentos. La lista de destinos permitidos, la aprobación de acciones y las ventanas de tiempo de escaneo son los próximos controles que estamos lanzando.
Barreras de alcance, definidas antes de que comience el escaneo
Todo escaneo parte de barreras predeterminadas restrictivas. Además de ellas, el creador del escaneo define el alcance en el flujo de creación del escaneo: qué hosts están dentro del alcance, qué entornos se excluyen y qué instrucciones de seguridad debe seguir el agente. No se necesita la intervención de Ostorlab. El alcance lo deciden las personas propietarias del objetivo, antes de que se envíe una sola solicitud.
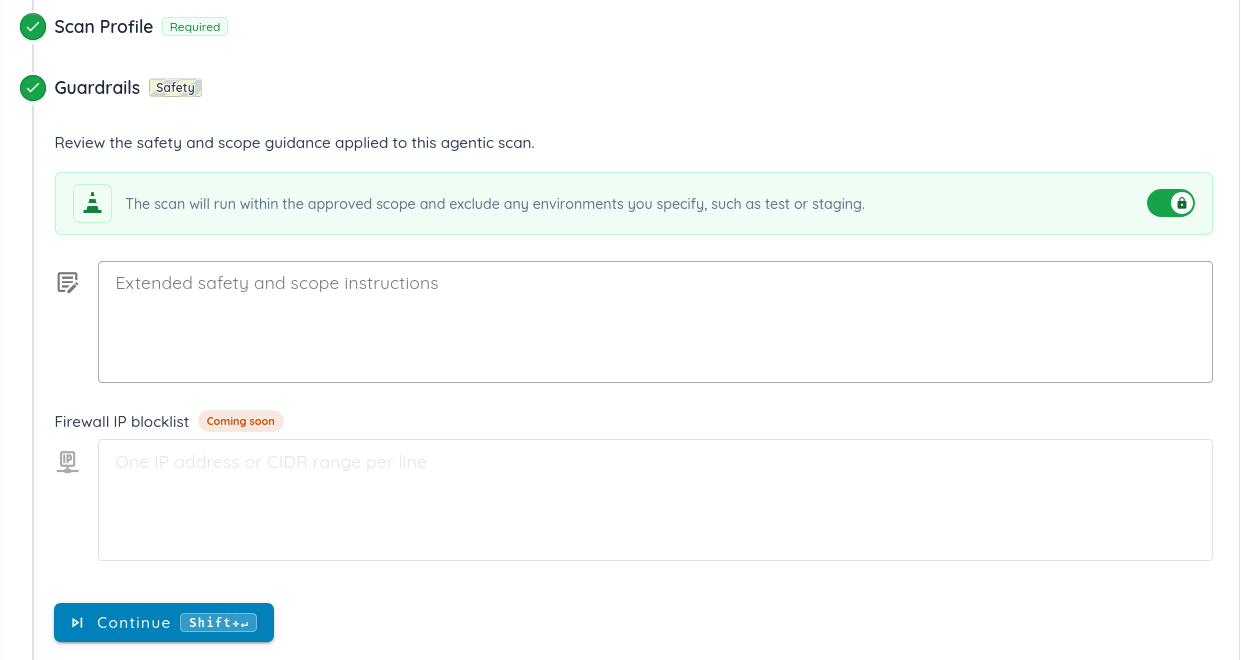
Lista de bloqueo de IP del firewall, aplicada por el sistema
El creador del escaneo enumera las direcciones IP a las que el tráfico del escaneo nunca debe llegar. Es el sistema quien aplica la lista, no el agente, de modo que ningún razonamiento del agente puede sortearla.
Limitación de frecuencia adaptativa, aplicada por el sistema
Todo el tráfico pasa por una limitación de frecuencia (consultas por segundo) que se adapta a la tasa de respuesta y a la tasa de errores del objetivo. Si un servidor se ralentiza o empieza a devolver errores, el escaneo reduce el ritmo por sí solo.
Próximamente
- Lista de destinos permitidos: solo los destinos aprobados explícitamente pueden recibir solicitudes activas.
- Aprobación de acciones importantes: el creador del escaneo recibe una alerta y las aprueba o deniega antes de que se ejecuten.
- Ventanas de tiempo de escaneo: los escaneos se ejecutan únicamente dentro de las horas que usted establezca.
El problema del bombo publicitario de la IA en ciberseguridad
Gran parte del sector trata el hacking autónomo con IA como un truco de marketing. Las empresas publican vídeos de agentes de IA irrumpiendo en redes empresariales, tratando herramientas peligrosas como trucos de magia.
No estamos de acuerdo con esa mentalidad.
Dar al software la capacidad de ejecutar ataques de varios pasos contra redes en producción conlleva un riesgo real. Cuando el software puede razonar a través de distintos sistemas, no hay margen alguno para el error. Manejar este poder exige una disciplina de ingeniería estricta, defensas en capas y total transparencia cuando las cosas salen mal, no campañas de marketing triunfalistas.
Conclusión
Los agentes de IA autónomos pueden encontrar fallos complejos de lógica de negocio que los escáneres tradicionales pasan por alto por completo.
Sin embargo, confiar en que un modelo de IA se vigile a sí mismo en producción es un error peligroso. Los límites de seguridad deben aplicarse fuera del modelo. Por eso Ostorlab combina barreras de alcance con una lista de bloqueo de IP a nivel de sistema y una limitación de frecuencia adaptativa, y por eso la lista de destinos permitidos es lo siguiente.
La verdadera prueba de las herramientas de seguridad autónomas no es lo ingeniosamente que atacan, sino la fiabilidad con la que se las puede contener.
Etiquetas:
AI Security, Autonomous Pentesting, Agentic AI, AppSec, Systems Engineering, Incident Response