
Octobre 2026 : des résultats de sécurité aux correctifs testés
Nous avons ajouté des approbations pour contrôler les actions dangereuses, introduit Ticket Agent pour le tri autonome et l’automatisation de la conformité, et étendu les workflows des résultats avec Verify Fix et le nouveau test des builds non publiés.
Regarder la mise à jour d’octobre
Choisissez l’anglais, le français, l’espagnol, le japonais ou le chinois simplifié pour la présentation de 72 secondes. Chaque version comporte des textes à l’écran et des sous-titres localisés ; l’interface du produit montrée est en anglais.
Download this video · Read the transcript · Download captions
Nous avons ajouté des approbations humaines pour contrôler les actions dangereuses pendant une évaluation et introduit Ticket Agent, une nouvelle façon de construire des automatisations autonomes pour le tri et les tâches de conformité complexes. Nous avons aussi étendu la configuration des scans, les outils d’investigation et les actions sur les résultats, afin que les équipes puissent suivre un problème depuis le test jusqu’à la remédiation et au nouveau test.
Cette version couvre les ajouts depuis le journal des modifications de septembre.
Nous avons ajouté des approbations pour contrôler les actions dangereuses
Un agent trouve une possible injection SQL et demande : « Dois-je poursuivre l’exploitation de cette injection SQL ? » Nous avons ajouté des approbations humaines pour que vous décidiez comment une action potentiellement dangereuse doit se poursuivre. Dans le nouvel onglet Approvals, vous pouvez Approve, Deny ou fournir des instructions personnalisées, par exemple « Utilisez une preuve en lecture seule sur l’environnement de préproduction ; n’extrayez aucune donnée client. »
Un indicateur d’attente met en évidence les demandes sans réponse. Tant qu’une approbation est en attente, les autres tests continuent. Seule l’action qui attend cette décision est bloquée. La même conversation peut aussi donner à l’agent du contexte pour une étape propre à l’application.
Choisir comment traiter les demandes d’approbation sans réponse
Nous avons ajouté des modes d’approbation pour que vous choisissiez ce qui se passe lorsqu’un agent demande une décision et qu’aucun relecteur ne répond :
| Si les relecteurs… | Choisissez… | Lorsqu’un agent demande une décision… |
|---|---|---|
| Doivent répondre avant que l’action demandée ne se poursuive | Ask and block without an answer | Seule l’action demandée reste bloquée si aucune réponse n’arrive à temps ; les autres tests continuent. |
| Peuvent donner des consignes mais ont besoin que le scan continue lorsqu’ils sont indisponibles | Ask and proceed without an answer | L’agent peut poursuivre cette action si aucune réponse n’arrive à temps. |
| Veulent que l’agent travaille sans demander d’avis | Run without asking | L’agent ne demande aucune intervention humaine. |
Ces modes régissent les décisions demandées par un agent ; ils ne mettent pas automatiquement en pause chaque appel d’outil pour relecture. Nous avons ajouté ces contrôles aux profils pris en charge d’Agentic Deep Scan, de Mobile Shielding et de Single Vulnerability Assessment, et étendu Dig Deeper pour reporter le mode sélectionné dans une évaluation de suivi.

Voir le workflow d’approbation en taille réelle.
Nous avons étendu la configuration des scans avec des contrôles de périmètre et de trafic
Nous avons étendu la configuration des scans pour que vous puissiez donner à une évaluation agentique un cahier des charges de test plus complet : quelle application tester, quels comptes utiliser, quels réseaux exclure et quel volume de trafic est approprié.
| Question dans le cahier des charges | Où l’exprimer |
|---|---|
| Où les tests doivent-ils se concentrer ? | Scope whitelist : domaines autorisés, domaines avec caractères génériques et adresses IP. |
| Quels réseaux ne doivent jamais être contactés ? | Outgoing IP/CIDR blocklist : exclusions de pare-feu pour ces adresses et ces réseaux. |
| Que doit savoir d’autre le testeur ? | Additional instructions : contexte de l’application, comptes de test, exigences supplémentaires, et actions ou environnements à éviter. |
| Quel volume de trafic est approprié ? | QPS (requêtes par seconde) dans les Advanced Settings du profil pris en charge. Définissez la limite de débit de requêtes séparément des instructions écrites. |
| Que doit-il se passer avant une action risquée ? | Approval of actions : exécuter sans demander, demander et bloquer sans réponse, ou demander et poursuivre sans réponse. |
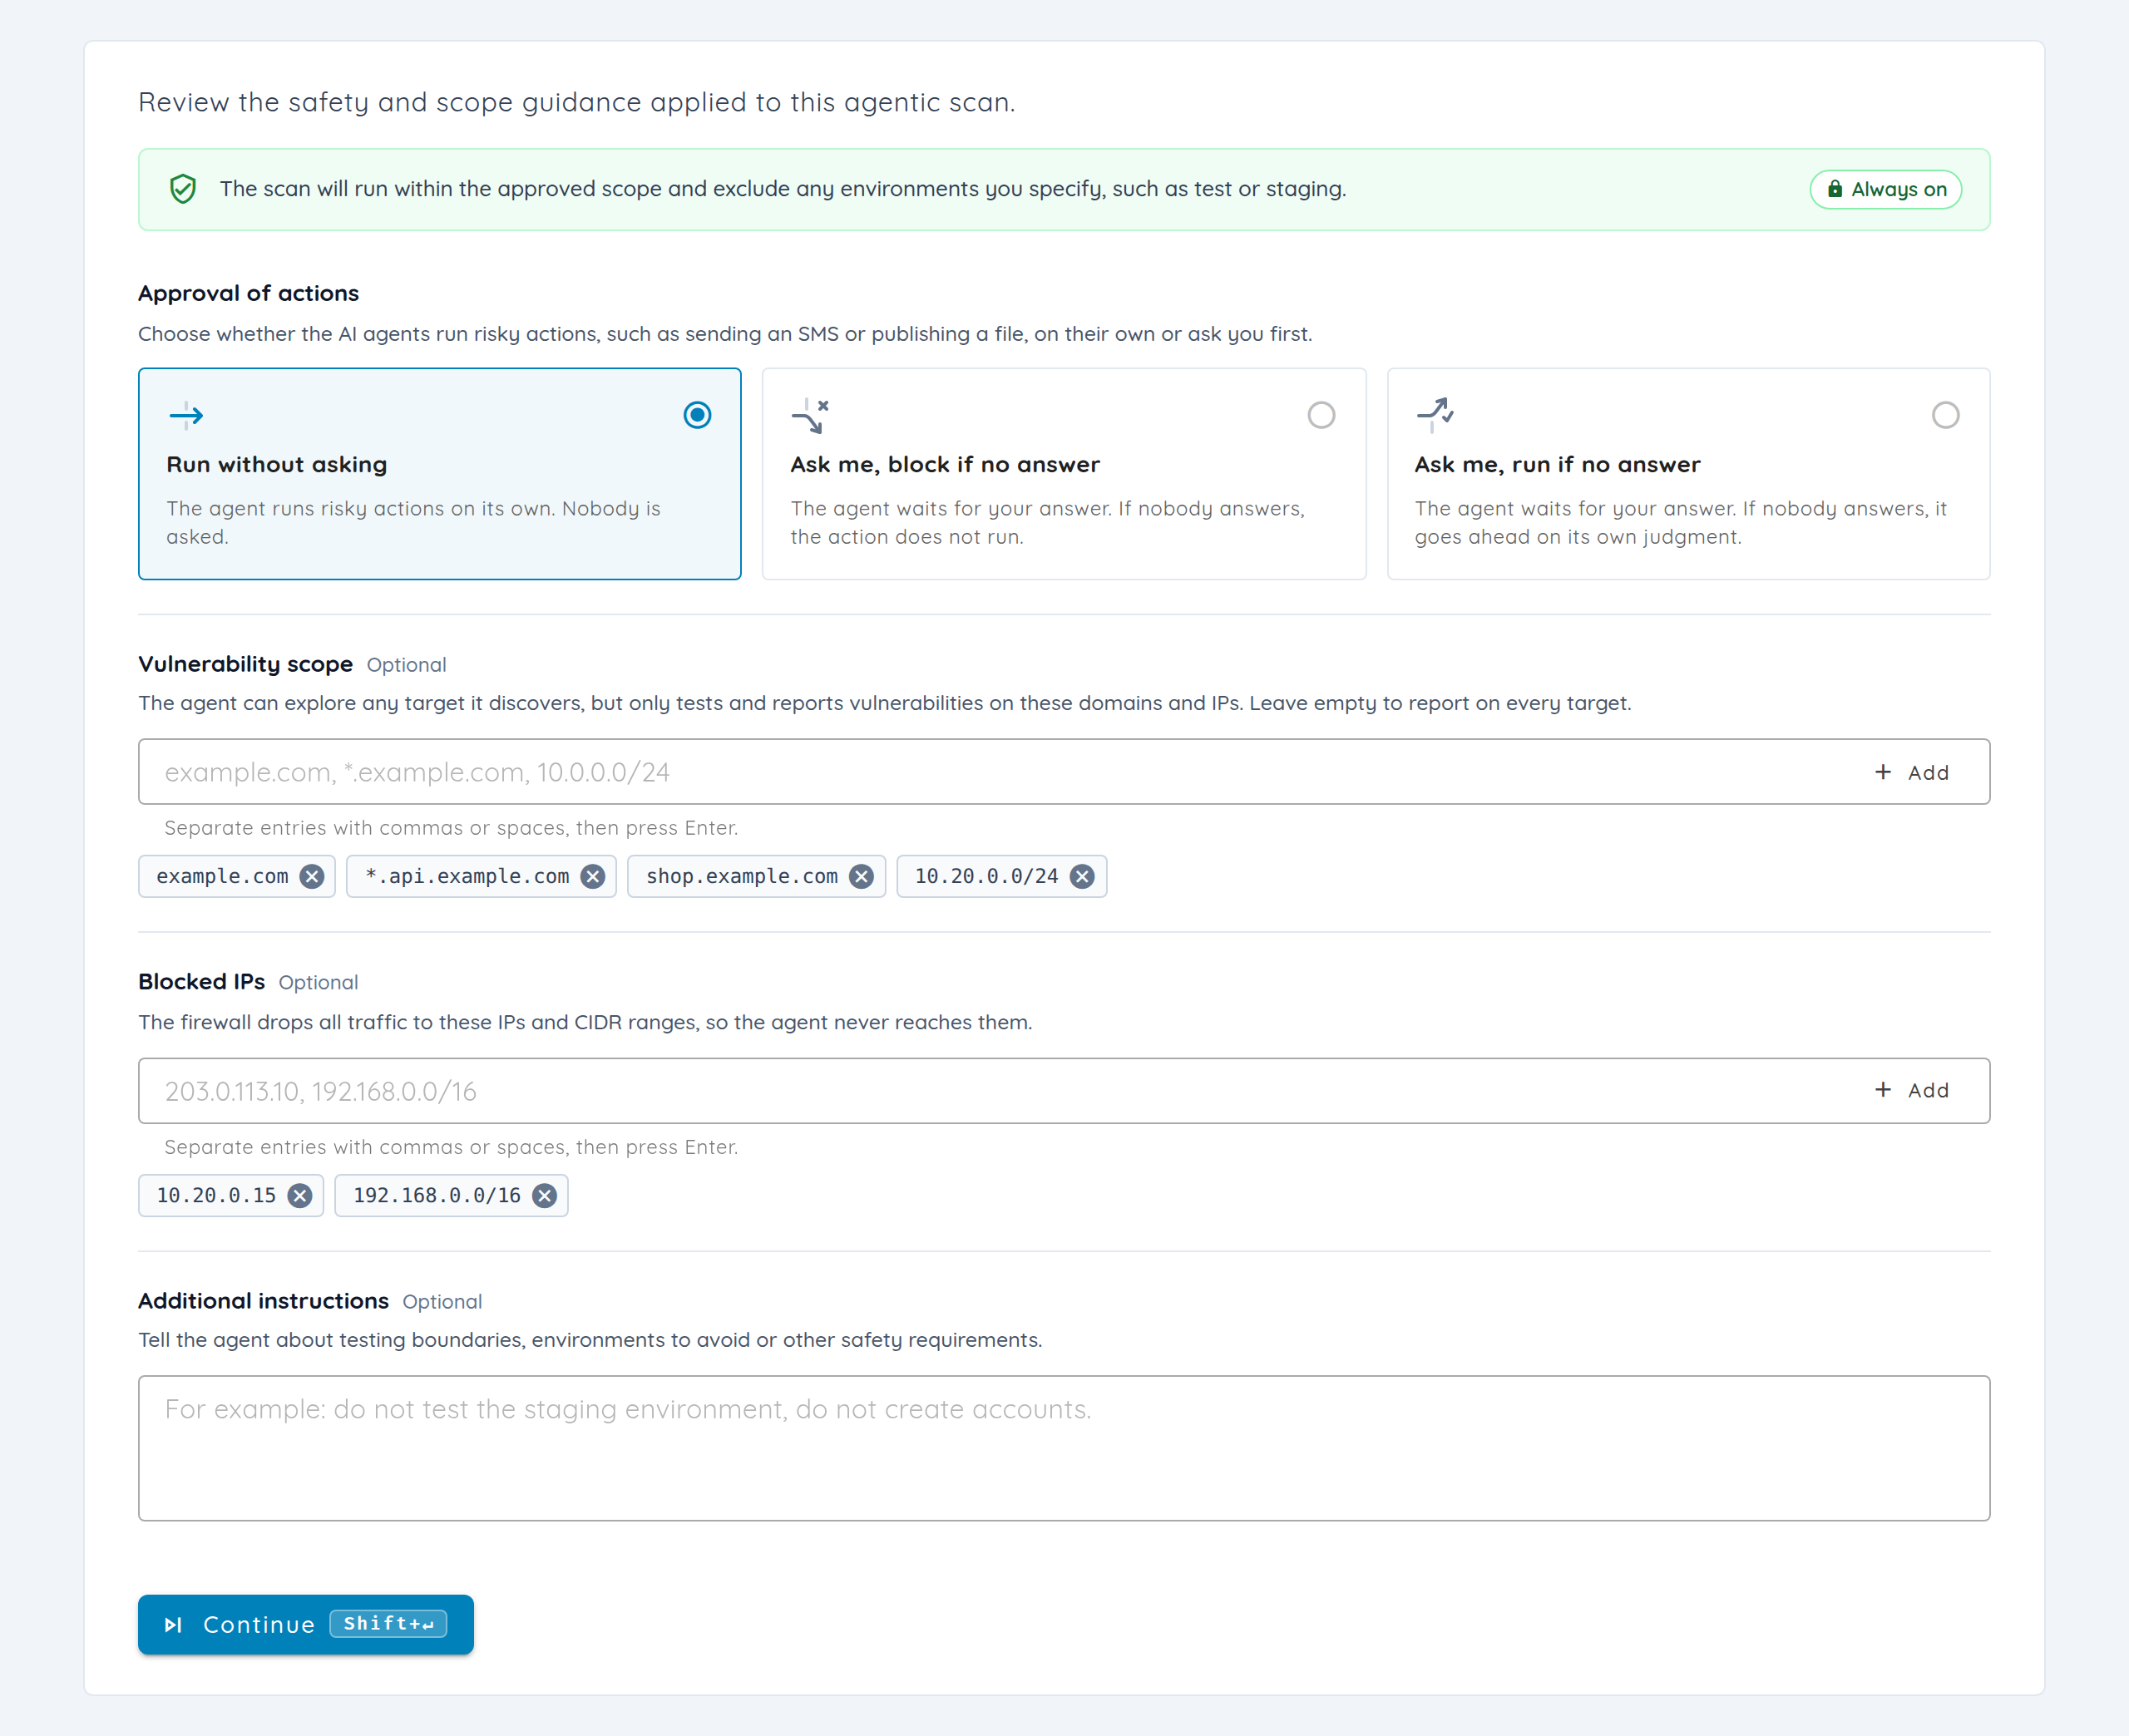
Ces contrôles agissent à différents niveaux. La whitelist guide l’agent par des prompts ; la blocklist IP/CIDR applique des règles de pare-feu. La surveillance du périmètre évalue séparément la sortie de l’agent pour détecter une dérive et lève des alertes, avec un arrêt optionnel de l’agent offensif. Les paramètres de garde-fous sont réinitialisés entre les nouveaux scans. Nous avons étendu la prise en charge des instructions de périmètre aux flux de scan de dépôts, multi-actifs et réseau concernés.
Nous avons ajouté des contrôles de préparation mobile et étendu les outils d’investigation
Nous avons ajouté des contrôles de préparation mobile pour faire apparaître les problèmes d’installation, d’accès à l’interface et d’authentification avant que vous n’interprétiez la couverture d’une évaluation. Si un build ne peut pas passer l’installation ou la connexion, vous pouvez d’abord investiguer le problème de configuration. Les défaillances d’infrastructure peuvent être relancées sur de nouveaux appareils, tandis que les échecs d’installation causés par l’application sont distingués des problèmes d’appareil. Les échecs de préparation ne bloquent pas automatiquement tous les scans.
Nous avons étendu la récupération de session d’appareil pour que les agents puissent revisiter des points d’entrée et remettre l’application cible au premier plan lorsqu’une session se rompt pendant l’exploration. Les opérations d’appareil authentifiées par session relient la préparation à la collecte de preuves. Des émulateurs Android rootés à la demande et des outils élargis de trace, de journaux, de code déchiffré et de données d’application pour Android/iOS soutiennent une investigation plus poussée ; des correctifs Flutter et JDWP traitent les données d’instrumentation incomplètes et les reconnexions.
L’application peut aussi contenir du code qui demande une autre approche de test : un composant Rust ou du code source Swift. Nous avons étendu le raisonnement structuré sur le code source à C++, Rust et Swift, avec une planification tenant compte des dépendances et une exécution spécialisée de preuves de concept natives. Des contrôles d’exposition en lecture seule plus larges couvrent davantage de produits d’entreprise, SMB, WebLogic T3 et SMTP ; un signal d’exposition reste distinct d’une exploitation confirmée.
Nous avons introduit Ticket Agent pour l’automatisation autonome
Nous avons introduit Ticket Agent, une nouvelle approche avancée pour mettre en œuvre l’automatisation autonome, du tri des vulnérabilités à l’exécution de workflows de conformité complexes. Donnez à un agent vos instructions, des compétences réutilisables, des outils connectés et des règles d’événements pour qu’il puisse traiter les étapes qui exigeraient sinon une coordination manuelle répétée.
Pour le tri, cela peut consister à examiner les résultats selon les critères de votre équipe, à rassembler leurs preuves d’origine et à préparer l’action suivante. Pour la conformité, un agent peut suivre une liste de contrôle, rassembler les preuves à l’appui, identifier les écarts et préparer une sortie à relire.
Quelques exemples de workflows que vous pouvez configurer :
| La tâche répétitive | Un agent que vous pourriez écrire |
|---|---|
| Chaque scan terminé nécessite l’application des règles de tri de votre équipe. | Se déclenche à la fin du scan ; examine les résultats concernés selon vos critères de sévérité et de responsabilité, puis prépare un résumé de tri. |
| Quelqu’un signale un possible faux positif. | Utilisez un événement de commentaire et une condition de tag ou de statut correspondante pour lancer une revue des preuves. Avec les outils d’évaluation nécessaires connectés, demandez une validation et écrivez le résultat dans votre format de reporting pour relecture. |
| Les preuves d’audit doivent avoir chaque fois la même structure. | Partez du modèle Compliance, ajoutez une liste de contrôle comme compétence, rassemblez les preuves via les outils connectés, identifiez les écarts et préparez la sortie de conformité pour relecture. |
| Des tickets hautement prioritaires approchent ou dépassent leur SLO. | Utilisez une règle de dépassement de SLO ou planifiée pour rassembler le contexte le plus récent et préparer un résumé d’escalade. |
| Un ticket rouvert nécessite une nouvelle investigation. | Se déclenche à la réouverture ; compare les preuves actuelles avec la discussion précédente et explique ce qui mérite un nouvel examen. |
Ce sont des exemples à configurer avec vos prompts, vos conditions et vos outils connectés. Le signalement d’un faux positif est une raison d’investiguer ; l’agent doit consigner les preuves de validation avant de recommander un changement de statut.
Nous avons ajouté la configuration de Ticket Agent à l’espace AI Agents, où vous pouvez choisir le modèle, les instructions, les compétences réutilisables, la mémoire optionnelle adossée à Git et les outils MCP pour chaque tâche. Les modèles Vulnerability Triage et Compliance fournissent des points de départ ; leurs règles sont désactivées au départ pour relecture.
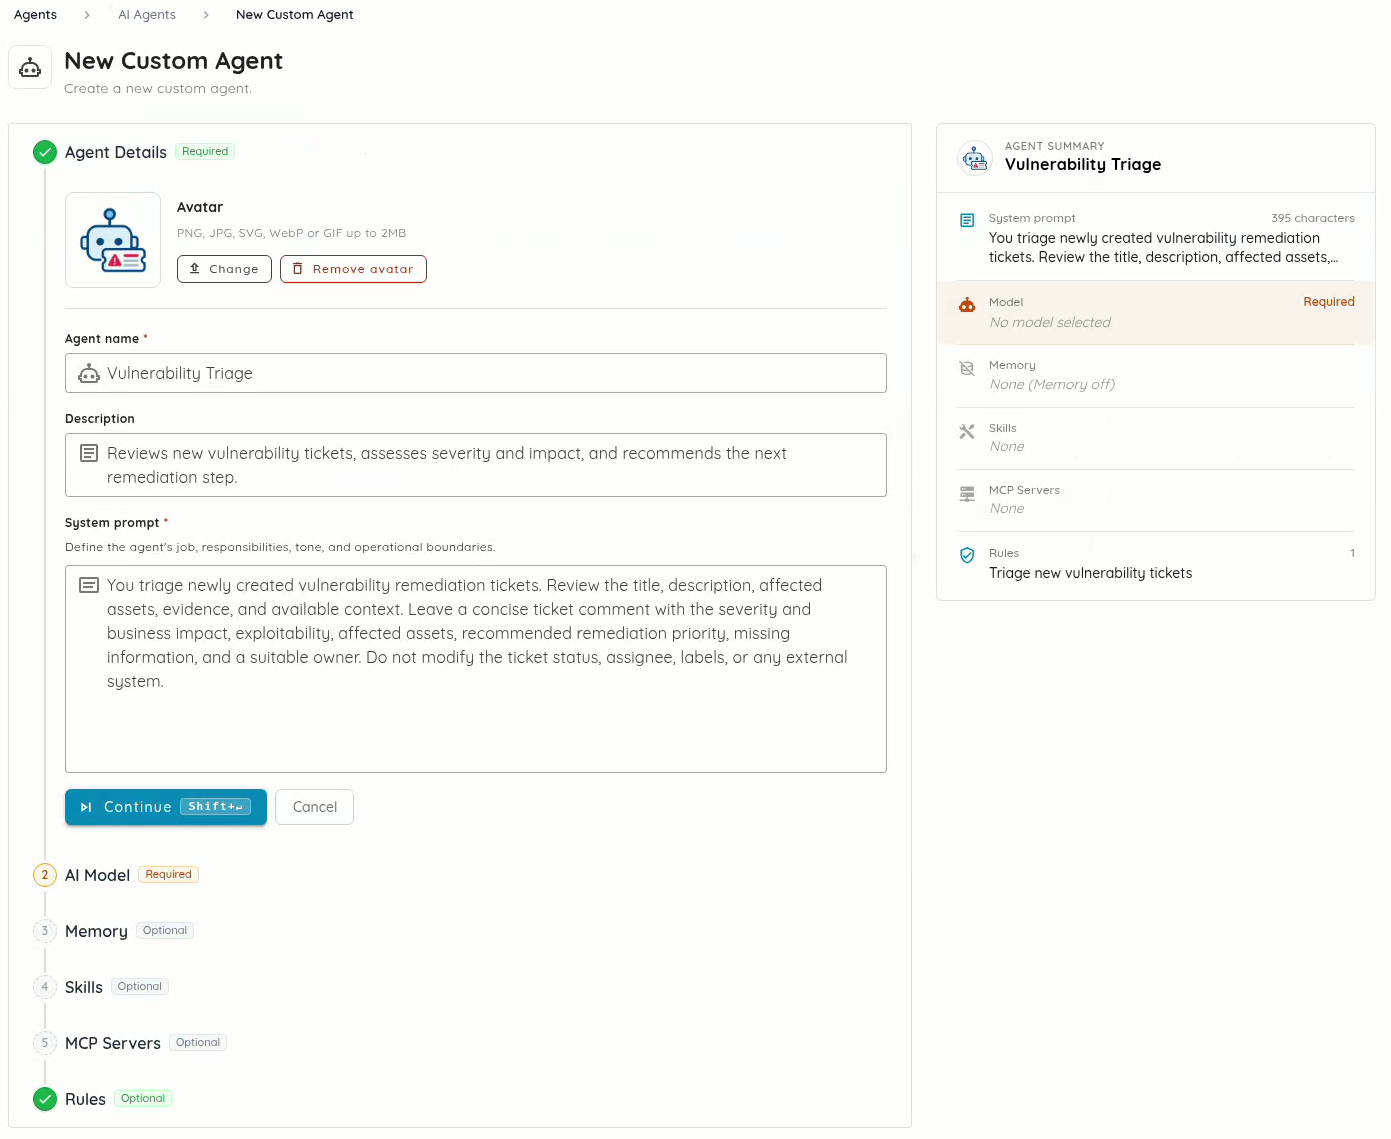
Pour essayer ce workflow, commencez par une règle Assigned conditionnée par Assignee is This agent. Assignez un ticket de test, examinez le résultat et ajustez le prompt avant d’élargir la règle. Un agent peut travailler aux côtés d’une personne assignée, de sorte que l’ingénieur responsable du problème reste visible pendant que l’agent aide à l’investigation.
D’autres règles peuvent réagir à la création d’un ticket, à sa réouverture, aux commentaires, aux dépassements de SLO, à la fin d’un scan ou à une planification. Les conditions restreignent le travail par priorité, statut, stream, tag, personne assignée, profil de scan ou cible. Les compétences réutilisables peuvent inclure des instructions écrites, des dossiers GitHub ou des archives importées ; les outils peuvent provenir de serveurs MCP distants, de processus locaux ou d’OXO. Consultez le guide de configuration de Ticket Agent pour la configuration et des exemples de règles.

Voir le workflow de remédiation en taille réelle.
Lors d’une réunion de tri, plusieurs tickets peuvent nécessiter une mise à jour groupée des données de leur stream. Si votre équipe utilise déjà Remediation Streams, nous avons étendu l’édition de type tableur avec la sélection multi-cellules et le copier-coller par lot. La pagination de la chronologie aide à naviguer dans de plus grandes collections de streams. Le guide des Streams couvre la configuration.
Nous avons étendu l’investigation et le tri des résultats
Un résultat arrive dans un rapport mobile. Les premières questions de votre ingénieur sont pratiques : « Comment les tests sont-ils arrivés à cet écran ? Puis-je suivre la reproduction ? Le code concerné est-il le nôtre, ou appartient-il à un SDK ? » Nous avons ajouté des contrôles de relecture et de responsabilité, et étendu le contexte des résultats dans Copilot, pour répondre à ces questions avant de confier le problème à une équipe.
Remonter des preuves jusqu’à l’application
Nous avons ajouté la relecture de la couverture d’appels (call-coverage replay) à la carte d’exploration existante pour que vous puissiez suivre le parcours dans l’application. Des captures d’écran, des légendes et une chronologie arborescente montrent la séquence de navigation enregistrée. Pour un résultat situé derrière une connexion, vous pouvez inspecter le chemin qui mène à cet écran. La recherche et les filtres de statut permettent de localiser les interactions ; une chronologie redimensionnable et la vue en carte existante vous permettent de passer de la séquence à l’exploration plus large.
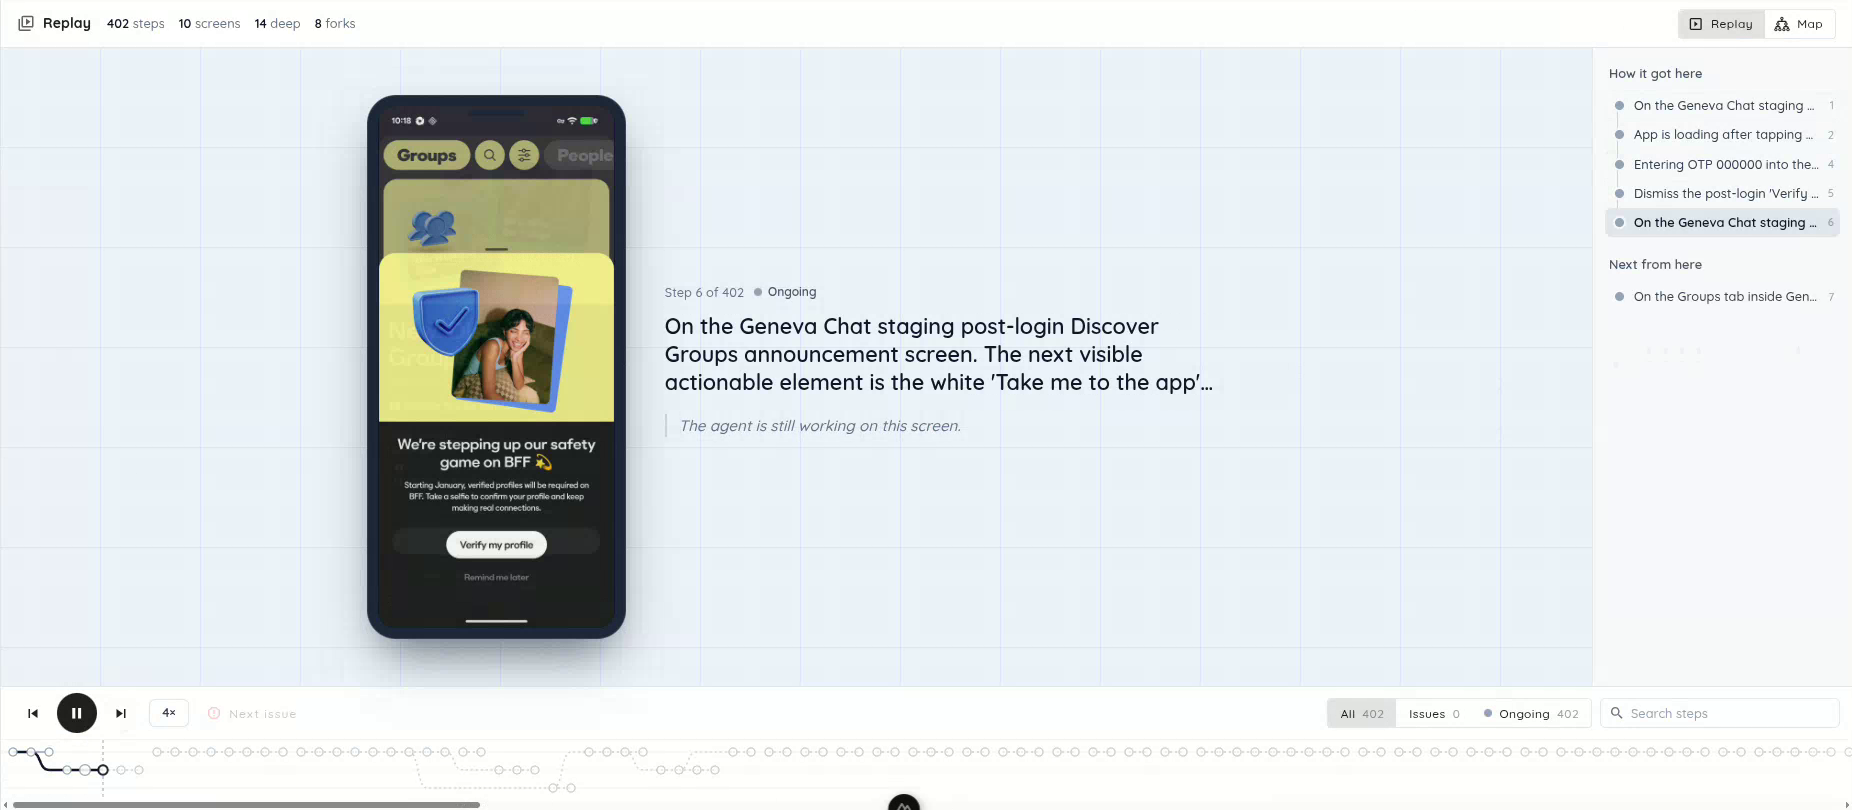
Rejouez le parcours dans l’application, lisez le contexte de chaque étape et parcourez la chronologie arborescente.
Pour la question suivante, « Explique cette trace et les étapes nécessaires pour la reproduire », nous avons étendu Ask Copilot afin qu’il reporte le résultat sélectionné dans la conversation. Vous pouvez partir du problème affiché à l’écran sans copier ses détails dans une nouvelle discussion. Copilot diffuse en continu sa progression, l’exécution des outils et l’activité du terminal, de sorte que vous pouvez suivre l’investigation, mettre une autre question en file d’attente ou annuler une requête. Des outils de vulnérabilités élargis, des compétences, de la mémoire et des sorties d’outils plus longues lui donnent plus de contexte.
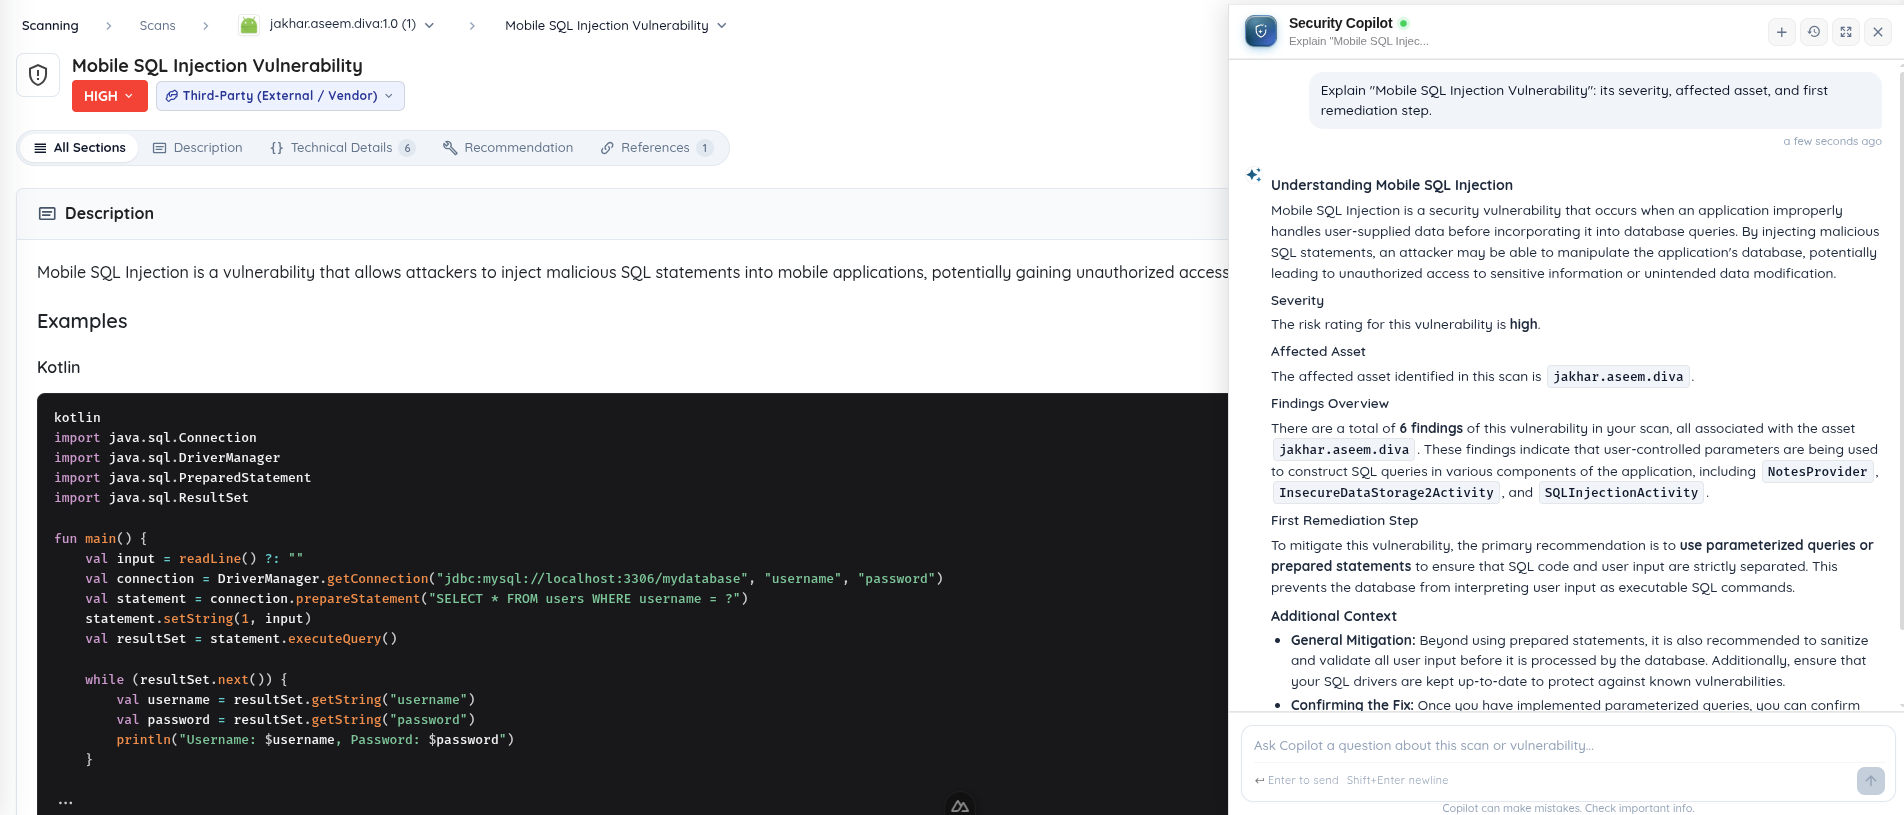
Ask Copilot ouvre une conversation avec le résultat sélectionné déjà en contexte. Illustré ici avec l’application de démonstration DIVA.
Séparer les résultats exploitables du bruit
Si la trace mène à un SDK intégré, votre équipe applicative devra peut-être signaler le problème à son éditeur. Nous avons ajouté une classification et des filtres first-party ou third-party, avec des analyses détaillées par emplacement et des traces d’appels de SDK pour aider à décider de la responsabilité. Vous pouvez corriger la classification et demander à Ostorlab de signaler un résultat tiers. Le guide de revue des résultats explique le workflow associé.
Le contrôle de responsabilité distingue les résultats de l’application de ceux des tiers.
Écarter sans cesse le même identifiant factice ou relire des avis de dépendances en double complique le tri. Nous avons étendu l’analyse des secrets pour filtrer davantage de valeurs factices et de valeurs de configuration client. Les avis de dépendances sont dédupliqués et incluent des informations sur la version corrigée ; les dépendances non épinglées sont ignorées plutôt que de se voir attribuer une version inventée. L’analyse mobile reconnaît aussi l’état propre aux Fragments et les fragments Android obfusqués, supprime les alertes de chiffrement factice d’AndroidX Biometric, et exclut les paramètres ATS des bundles de framework ainsi que les exceptions de trafic en clair limitées au loopback ou à l’émulateur.
Un ingénieur qui examine un résultat de stockage doit savoir si un identifiant a réellement été écrit en clair. L’analyse du stockage à l’exécution détecte ces écritures dans les SharedPreferences d’Android, masque les valeurs et exclut les valeurs factices et chiffrées. Pour les équipes qui examinent les exigences TLS, des contrôles élargis des protocoles, des suites de chiffrement et de CRYPTREC/IPA disposent d’explications individuelles, la non-conformité au profil étant signalée séparément de l’exploitabilité prouvée.
Nous avons ajouté des actions sur les résultats et étendu la vérification des correctifs
Nous avons ajouté des actions sur un résultat pour lancer la vérification d’un correctif, demander un signalement à un tiers ou commencer une correction dans un dépôt connecté. Nous avons étendu le nouveau test pour qu’il accepte une version mobile candidate non publiée, afin qu’un correctif puisse être évalué avant d’arriver sur un store d’applications.
Lancer l’action suivante depuis le résultat
Vous avez un résultat ouvert. L’étape suivante peut être de vérifier votre correctif, de demander à Ostorlab de gérer une divulgation à un éditeur, ou de mettre en œuvre une correction dans un dépôt connecté. Ces tâches devraient démarrer là où se trouvent déjà les preuves.
- Un correctif est prêt ? Cliquez sur Verify Fix. Lancez le nouveau test depuis le résultat au lieu de reconstituer le cahier des charges. Pour une application mobile, importez la version candidate corrigée même si l’évaluation d’origine portait sur la version du store.
- Le problème relève d’un SDK ? Cliquez sur Ask Ostorlab to Report. Demandez à Ostorlab de se charger du signalement du résultat tiers ; votre équipe n’a pas à reconstituer le problème de zéro pour l’éditeur.
- Votre dépôt est intégré ? Lancez l’action de correction depuis le résultat. Demandez qu’une correction soit mise en œuvre à partir du code connecté et du contexte du résultat, puis examinez les modifications obtenues selon votre processus d’ingénierie habituel.
« Un clic » est le point de départ du travail : la sélection du scanner ou de la cible, une confirmation et une relecture peuvent encore suivre. L’objectif est de sortir de votre liste de tâches manuelles la collecte de contexte, l’investigation et la préparation de l’étape suivante.
Par exemple, votre ingénieur Android a un correctif candidat, mais la version du store contient encore le problème. Dans une mission traditionnelle, vous enverriez le nouveau build au pentesteur en lui demandant de revenir sur la preuve de concept d’origine et de chercher des contournements. Verify Fix donne à ce transfert un point de départ dans le résultat.
Nous avons ajouté Verify Fix pour lancer un Single Vulnerability Assessment avec l’emplacement et la classification de la faiblesse du résultat, ainsi que des instructions pour rejouer la preuve de concept d’origine et rechercher d’éventuels contournements. Importez directement le build mobile candidat, y compris lorsque le scan d’origine portait sur une version du store. Vous pouvez évaluer le correctif avant de le publier et sélectionner un scanner capable d’atteindre la cible mise à jour.
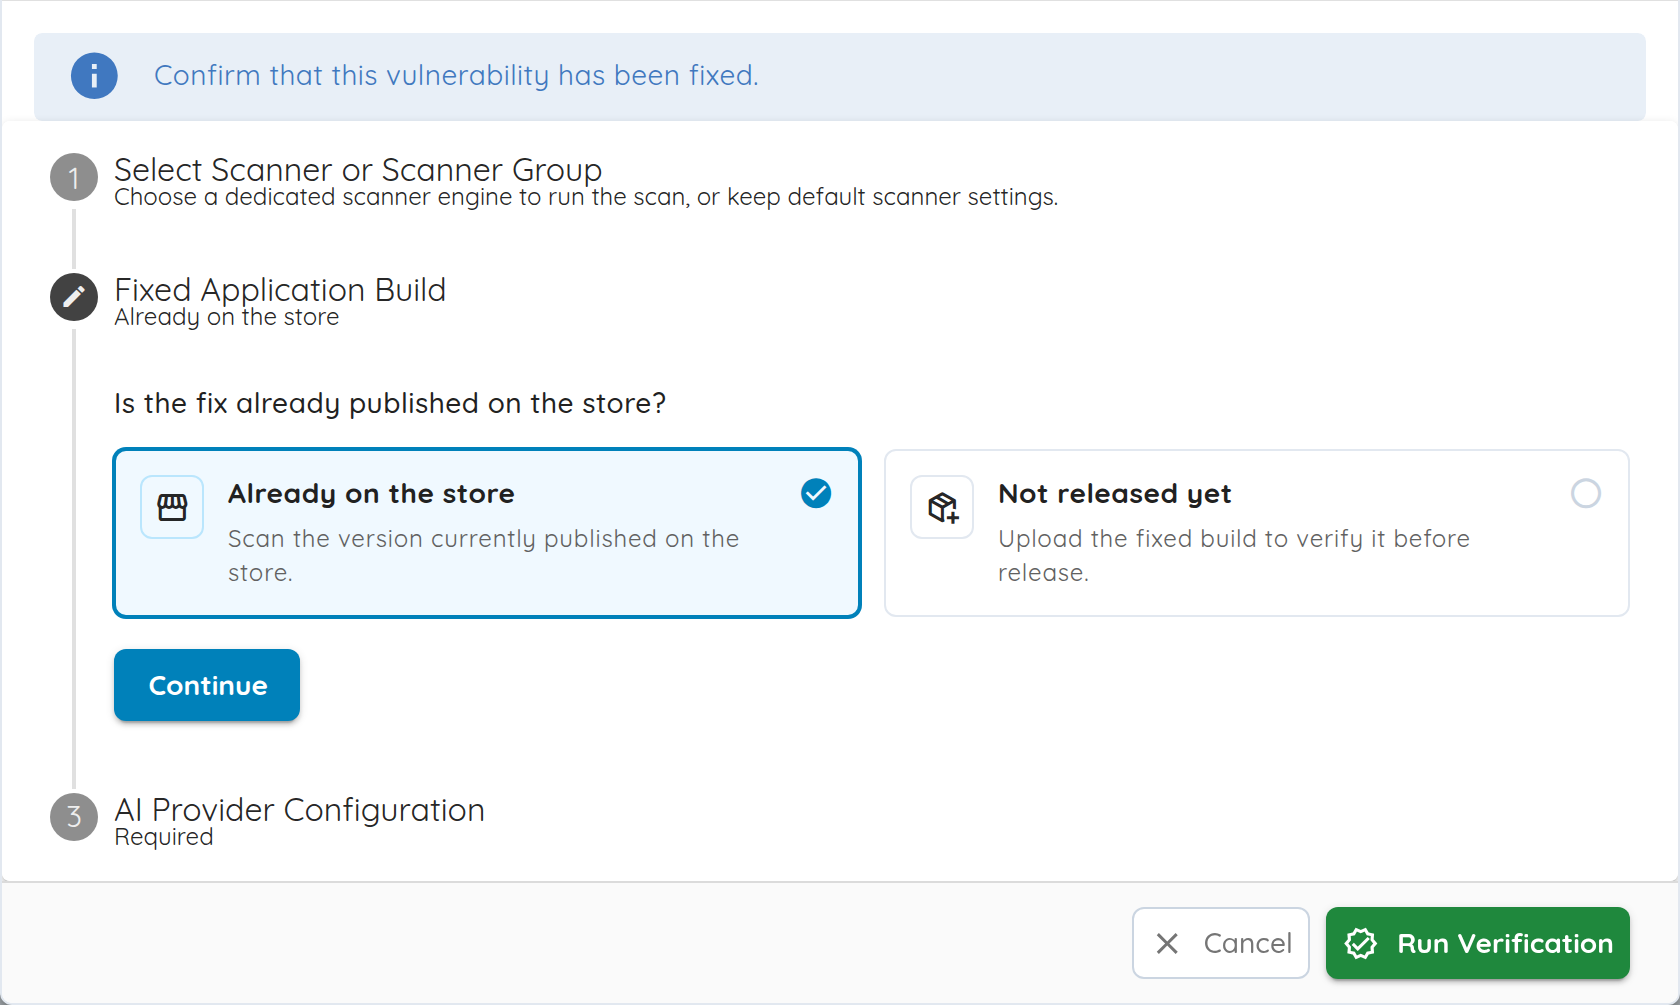
Ouvrez le résultat, choisissez Verify Fix, sélectionnez un scanner et fournissez la cible ou le build mis à jour. Le workflow prend en charge les résultats mobiles, web et réseau. Son verdict est une évaluation au mieux : examinez les preuves obtenues avant de décider de clore le problème.
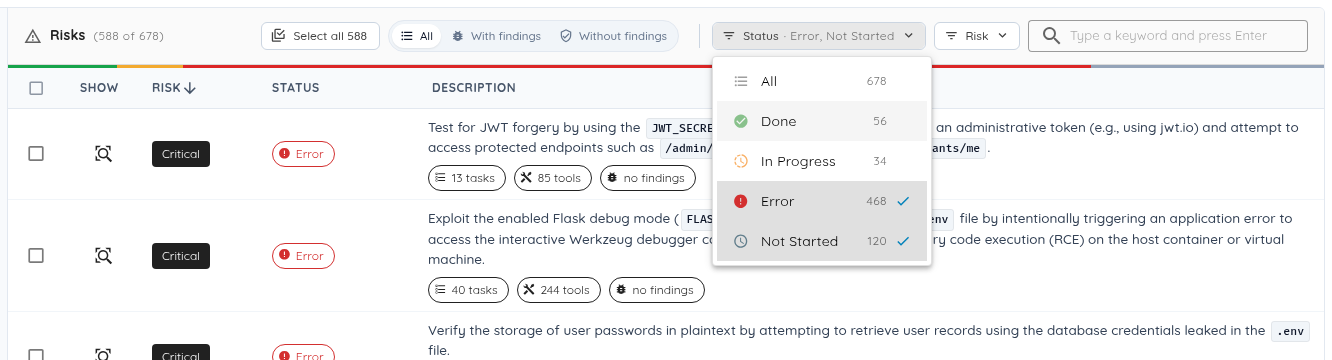
Si la mise à jour d’une dépendance partagée corrige des résultats dans plusieurs applications, vous avez peut-être un ensemble de risques à revoir. Nous avons ajouté la recherche, le tri et les filtres de statut côté serveur pour trouver cet ensemble, ainsi que la sélection entre pages et les relances de risques par lot (batch risk reruns) pour lancer ensemble les évaluations de suivi. Les suivis multi-actifs conservent aussi mieux l’actif concerné d’origine.
Nous avons étendu les contrôles MCP et d’intégration
Un ingénieur ouvre un ticket dans son assistant de codage et demande de l’aide pour le corriger. Une description collée peut omettre l’échange HTTP ou la stack trace qui explique le problème. Pendant ce temps, l’équipe sécurité a besoin que les mises à jour de scan soient livrées dans ses propres systèmes. Nous avons étendu les connexions qui amènent les preuves et les workflows de scan dans ces outils.
Permettre aux assistants de codage d’inspecter les preuves et d’agir
Nous avons étendu le Ostorlab Platform MCP Server introduit en septembre pour qu’un assistant de codage connecté puisse récupérer davantage de preuves derrière un résultat : trafic HTTP, captures de paquets, stack traces, source, journaux, nœuds de couverture d’appels et détails des actifs. L’investigation a ainsi accès au matériel d’origine pendant que l’ingénieur travaille sur une correction.
Les clients connectés peuvent aussi créer des scans pris en charge pour le mobile, TestFlight, les dépôts, les archives de source, la découverte et le multi-actifs, préparer les fichiers importés et configurer des budgets. Pour les équipes qui automatisent déjà leurs workflows de scan, MCP expose désormais les exports CSV, SARIF et d’archives de scan pris en charge, la configuration et le test des intégrations, ainsi que la gestion des groupes de scanners, des planifications de surveillance et des ressources d’agents de remédiation. Les outils disponibles dépendent des autorisations de la clé d’API et de la configuration du produit. Le guide de configuration MCP couvre les clients, les imports et la pagination.
Adapter la livraison et l’accès aux dépôts à votre organisation
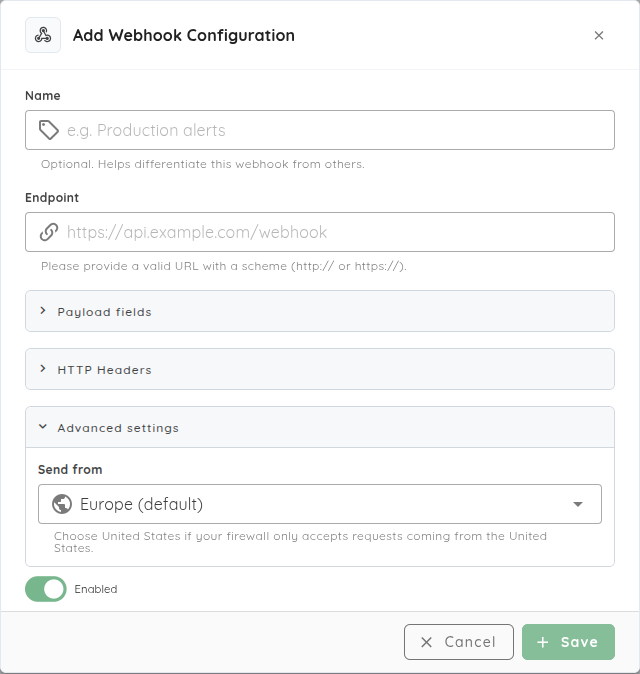
Supposons que vos notifications de scan alimentent un service interne qui n’accepte le trafic que depuis des origines approuvées et n’a besoin que de quelques champs de payload. Nous avons étendu les webhooks pour que vous puissiez choisir les champs de scan envoyés à ce récepteur, donner un nom reconnaissable à la destination et sélectionner une sortie depuis l’Europe ou les États-Unis. Les tests utilisent la tâche d’arrière-plan de la région sélectionnée, ce qui vous permet de vérifier le chemin de livraison par rapport à la liste d’autorisation du récepteur pendant la configuration.
Si votre équipe plateforme gère déjà les identités des GitHub Apps et la rotation des identifiants, elle peut désormais utiliser des GitHub Apps appartenant au client pour l’intégration des dépôts. Configurez les installations, renommez les apps, effectuez la rotation des identifiants, et désactivez ou supprimez des installations grâce à ce cycle de vie familier. Les installations personnalisées sont vérifiées avec les identifiants de l’App ; la connexion à l’App Ostorlab vérifie l’accès de l’utilisateur via GitHub OAuth. Les installations prises en charge peuvent se connecter à plusieurs organisations Ostorlab autorisées. Consultez le guide de l’intégration GitHub.
Nous avons étendu les évaluations récurrentes et les connexions aux modèles
L’évaluation du mois prochain démarre après que l’application a changé : le flux de connexion est différent, un autre service a rejoint le périmètre, et l’équipe a besoin de savoir ce qui s’est passé lors de la dernière exécution planifiée. Les pentesteurs qui reviennent ont besoin d’un cahier des charges à jour. Les évaluations récurrentes ont besoin de connaissances entretenues et d’une trace claire de leurs exécutions, pour la même raison.
Garder les connaissances à jour et voir quand les tests échouent
Si une entrée de connaissance conservée décrit encore l’ancien flux de connexion, vous pouvez désormais la modifier au lieu de traîner ce contexte obsolète dans les travaux suivants. La connaissance de scan persistante (Persistent scan knowledge) permet d’ajouter, de modifier et de supprimer des entrées. La navigation incrémentale dans les dossiers aide à inspecter de plus grands espaces de connaissance sans charger toute l’arborescence.
Lorsque votre évaluation hebdomadaire inclut une application mobile, son backend et d’autres actifs, les évaluations multi-actifs récurrentes peuvent planifier des collections hétérogènes et des contrôles de la surface d’attaque. Si une exécution planifiée échoue, l’historique de surveillance affiche désormais son statut d’exécution et des détails d’échec dépliables, ce qui vous donne un point de départ pour investiguer. Consultez le guide de surveillance.
Pour la prochaine réunion de suivi, Cockpit fait ressortir les actions en attente et un résumé quotidien des changements. Les rapports ajoutent des résumés plus clairs des scénarios d’attaque, des logos d’organisation dans les PDF et une prise en charge élargie des langues dans les tâches, les rapports et les messages transactionnels, ce qui aide à partager l’évaluation avec les personnes responsables de l’étape suivante.
Planifier la consommation et choisir où s’exécute l’inférence du modèle
Avant de commander une nouvelle évaluation, une équipe doit planifier son périmètre et sa consommation. Les estimations de consommation de scan et les budgets de tokens et de risques pris en charge aident à cette planification. Les cartes d’estimation de Copilot préremplissent les cibles et le profil actuels pour relecture. Les tokens du portefeuille peuvent être achetés par quantité ; les modèles d’agents de remédiation prépayés utilisent le même portefeuille d’organisation, avec en plus la possibilité d’utiliser votre propre clé de fournisseur.
Si votre équipe sert déjà des modèles via Ollama ou un serveur compatible OpenAI, BYOK peut désormais se connecter à ce service, y compris aux déploiements vLLM, LM Studio et llama.cpp. Configurez l’URL du endpoint, le nom du modèle et une clé d’API si nécessaire ; le serveur doit être joignable depuis le scanner. Les agents de test autonome et d’exploration mobile pris en charge, ainsi qu’OXO, peuvent utiliser ces connexions.
Une connexion d’inférence détermine où s’exécute l’inférence du modèle ; elle ne déplace pas l’orchestration de la plateforme, les résultats ni le reporting. Le guide BYOK explique la configuration en plus de celle du scanner.
Un échec temporaire d’envoi peut aussi laisser une équipe dans l’attente des résultats alors que les tests ont eu lieu. De meilleures nouvelles tentatives d’envoi des résultats et la reprise des lots échoués traitent ce transfert. Le travail de fiabilité couvre aussi le crawling authentifié, les connexions d’API pendant les déploiements, le nettoyage des scanners et la surveillance de l’état des appareils. Un masquage des secrets élargi dans Copilot, des opérations sur les actifs et les connaissances limitées à l’organisation, et des autorisations d’intégration plus strictes soutiennent ces workflows.
Nous avons ajouté des améliorations d’interface au quotidien
Vous passez d’un onglet de scan à l’autre, triez un lot de résultats, collez les mêmes valeurs de stream dans plusieurs tickets, puis reprenez votre travail après une interruption. Nous avons ajouté les contrôles suivants et étendu des vues existantes pour rendre ces tâches familières moins fastidieuses :
| Lorsque vous… | Ce qui est plus facile maintenant |
|---|---|
| Parcourez une longue liste de risques | Recherche, tri, pagination et filtres multi-statuts côté serveur, sélection entre pages et relances par lot. |
| Naviguez dans un résultat | Onglets de section fixes, champ de recherche plus large, menu de tri adapté à la sélection, et note de risque et description dans le panneau latéral. |
| Partagez un scan ou y revenez | L’onglet de scan ouvert reste dans son URL. |
| Modifiez des tickets dans un tableur | Sélection multi-cellules, copier-coller par lot, création et modification de streams, effacement avec Suppr/Retour arrière, et persistance et récupération des brouillons. |
| Retrouvez le travail qui vous est assigné | Un raccourci My tickets et des filtres conservés pendant la modification. |
| Naviguez dans un grand espace de travail | Les dossiers de connaissances se chargent de façon incrémentale ; les arborescences de fichiers dépliées défilent ; le nom du fichier sélectionné est visible et les aperçus d’images conservent leurs proportions. |
| Changez de contexte | L’élément courant apparaît en premier dans les sélecteurs du fil d’Ariane ; le comportement des listes déroulantes est plus cohérent. |
| Créez un scan | Étapes obligatoires, recommandées et facultatives plus claires ; paramètres propres à chaque profil ; badges de plateforme et identifiants de cible plus clairs. |
| Suivez l’exploration | Recherche dans la relecture, filtres de statut et chronologie redimensionnable à côté de la carte existante. |
| Configurez les notifications | Webhooks nommés, champs de payload sélectionnables, livraison régionale et tests de webhooks enregistrés plus clairs. |
| Suivez le travail de Copilot | Progression et activité du terminal diffusées en continu, questions de suivi mises en file d’attente et annulation. |
| Lisez un rapport pendant le chargement des sections | Le chargement en arrière-plan garde la navigation entre onglets réactive. |
Dans les coulisses : un meilleur contexte, et la suite
Une mémoire qui conserve le contexte utile de l’investigation
Une évaluation ultérieure doit pouvoir reprendre les notes utiles et les fichiers de preuve de concept issus des travaux précédents. Les agents d’une même évaluation ont aussi besoin d’une vue partagée de l’investigation, au lieu de redécouvrir sans cesse le contexte.
Nous avons étendu la mémoire de l’espace de travail (workspace memory) autour de ce problème : restauration des fichiers enregistrés dans l’espace de travail partagé, enregistrement des fichiers nouveaux et modifiés, nouvelle tentative en cas d’échec de synchronisation récupérable, et finalisation de la synchronisation avant la fin d’une évaluation. Les transferts directs vers le stockage d’objets et l’enregistrement des fichiers par lots réduisent le coût de la conservation de ce contexte. Le déploiement par profil de scan se fait par étapes ; il s’agit d’un travail en cours sur les fondations de la mémoire, en plus de l’édition des connaissances et de la mémoire optionnelle de Ticket Agent décrites plus haut.
Bientôt : Active Directory et RASP
Une mission interne commence souvent par un compte de domaine et la question : « Où cette identité peut-elle mener un attaquant ? » Nous préparons le test Active Directory pour ce workflow : raisonnement sur Kerberos et les services de certificats, analyse des permissions et des relations d’approbation, et planification de chemins entre machines. Le travail comprend aussi des outils AD dédiés et des contrôles de password spraying tenant compte du verrouillage de compte. Bientôt décrit cette expérience de test ; ces changements d’ingénierie sous-jacents ne signifient pas que le workflow complet est généralement disponible aujourd’hui.
Nous développons aussi la Runtime Application Self-Protection (RASP) pour les applications mobiles, qui étend la sécurité de l’évaluation à la protection pendant l’exécution de l’application. Ce travail réunit le durcissement des applications, les contrôles à l’exécution et la visibilité sur les signaux de protection. Le workflow de protection de bout en bout arrive bientôt et reste en cours de développement.
Pour un problème existant, commencez par Verify Fix sur son résultat dans Ostorlab. Pour un goulot d’étranglement de tri récurrent, configurez un Ticket Agent sur un petit ensemble de tickets et examinez sa sortie avant d’élargir ses règles.