
Octubre de 2026: de los hallazgos de seguridad a las correcciones probadas
Hemos añadido aprobaciones para controlar las acciones peligrosas, hemos incorporado Ticket Agent para el triaje autónomo y la automatización del cumplimiento normativo, y hemos ampliado los flujos de trabajo de los hallazgos con Verify Fix y la repetición de pruebas sobre compilaciones no publicadas.
Vea la actualización de octubre
Elija inglés, francés, español, japonés o chino simplificado para ver el resumen de 72 segundos. Cada versión incluye el texto en pantalla y los subtítulos localizados; la interfaz del producto que se muestra está en inglés.
Download this video · Read the transcript · Download captions
Hemos añadido aprobaciones humanas para controlar las acciones peligrosas durante una evaluación y hemos incorporado Ticket Agent, una nueva forma de crear automatizaciones autónomas para el triaje y para trabajos complejos de cumplimiento normativo. También hemos ampliado la configuración de escaneos, las herramientas de investigación y las acciones sobre los hallazgos, para que los equipos puedan llevar un problema desde las pruebas hasta la corrección y la repetición de las pruebas.
Esta versión recoge las novedades añadidas desde el registro de cambios de septiembre.
Hemos añadido aprobaciones para controlar las acciones peligrosas
Un agente encuentra una posible inyección SQL y pregunta: «¿Debo proceder a explotar esta inyección SQL?». Hemos añadido aprobaciones humanas para que usted decida cómo debe continuar una acción potencialmente peligrosa. En la nueva pestaña Approvals, puede Approve, Deny o proporcionar instrucciones personalizadas, como «Use una prueba de solo lectura en el entorno de preproducción; no extraiga datos de clientes».
Un indicador de espera resalta las solicitudes sin respuesta. Mientras una aprobación está pendiente, las demás pruebas continúan. Solo se bloquea la acción que espera esa decisión. La misma conversación también puede dar al agente contexto para un paso específico de la aplicación.
Elija cómo se gestionan las solicitudes de aprobación sin respuesta
Hemos añadido modos de aprobación para que pueda elegir qué ocurre cuando un agente solicita una decisión y ningún revisor responde:
| Si los revisores… | Elija… | Cuando un agente solicita una decisión… |
|---|---|---|
| Necesitan responder antes de que la acción solicitada continúe | Ask and block without an answer | Solo la acción solicitada permanece bloqueada si no llega una respuesta a tiempo; las demás pruebas continúan. |
| Pueden dar orientación, pero necesitan que el escaneo continúe cuando no están disponibles | Ask and proceed without an answer | El agente puede continuar con esa acción si no llega una respuesta a tiempo. |
| Quieren que el agente trabaje sin solicitar intervención | Run without asking | El agente no solicita la intervención humana. |
Estos modos rigen las decisiones solicitadas por un agente; no pausan automáticamente cada llamada a una herramienta para su revisión. Hemos añadido estos controles a los perfiles compatibles de Agentic Deep Scan, Mobile Shielding y Single Vulnerability Assessment, y hemos ampliado Dig Deeper para trasladar el modo seleccionado a una evaluación de seguimiento.

Ver el flujo de aprobación en tamaño completo.
Hemos ampliado la configuración de escaneos con controles de alcance y de tráfico
Hemos ampliado la configuración de escaneos para que pueda dar a una evaluación agéntica un briefing de pruebas más completo: qué aplicación probar, qué cuentas usar, qué redes excluir y cuánto tráfico es apropiado.
| Pregunta del briefing | Dónde expresarla |
|---|---|
| ¿Dónde deben centrarse las pruebas? | Scope whitelist: dominios permitidos, dominios con comodines y direcciones IP. |
| ¿Con qué redes no se debe contactar nunca? | Outgoing IP/CIDR blocklist: exclusiones de firewall para esas direcciones y redes. |
| ¿Qué más debe saber el evaluador? | Additional instructions: contexto de la aplicación, cuentas de prueba, requisitos adicionales, y acciones o entornos que se deben evitar. |
| ¿Cuánto tráfico es apropiado? | QPS (consultas por segundo) en Advanced Settings del perfil compatible. Defina el límite de frecuencia de solicitudes por separado de las instrucciones escritas. |
| ¿Qué debe ocurrir antes de una acción arriesgada? | Approval of actions: ejecutar sin preguntar, preguntar y bloquear sin respuesta, o preguntar y continuar sin respuesta. |
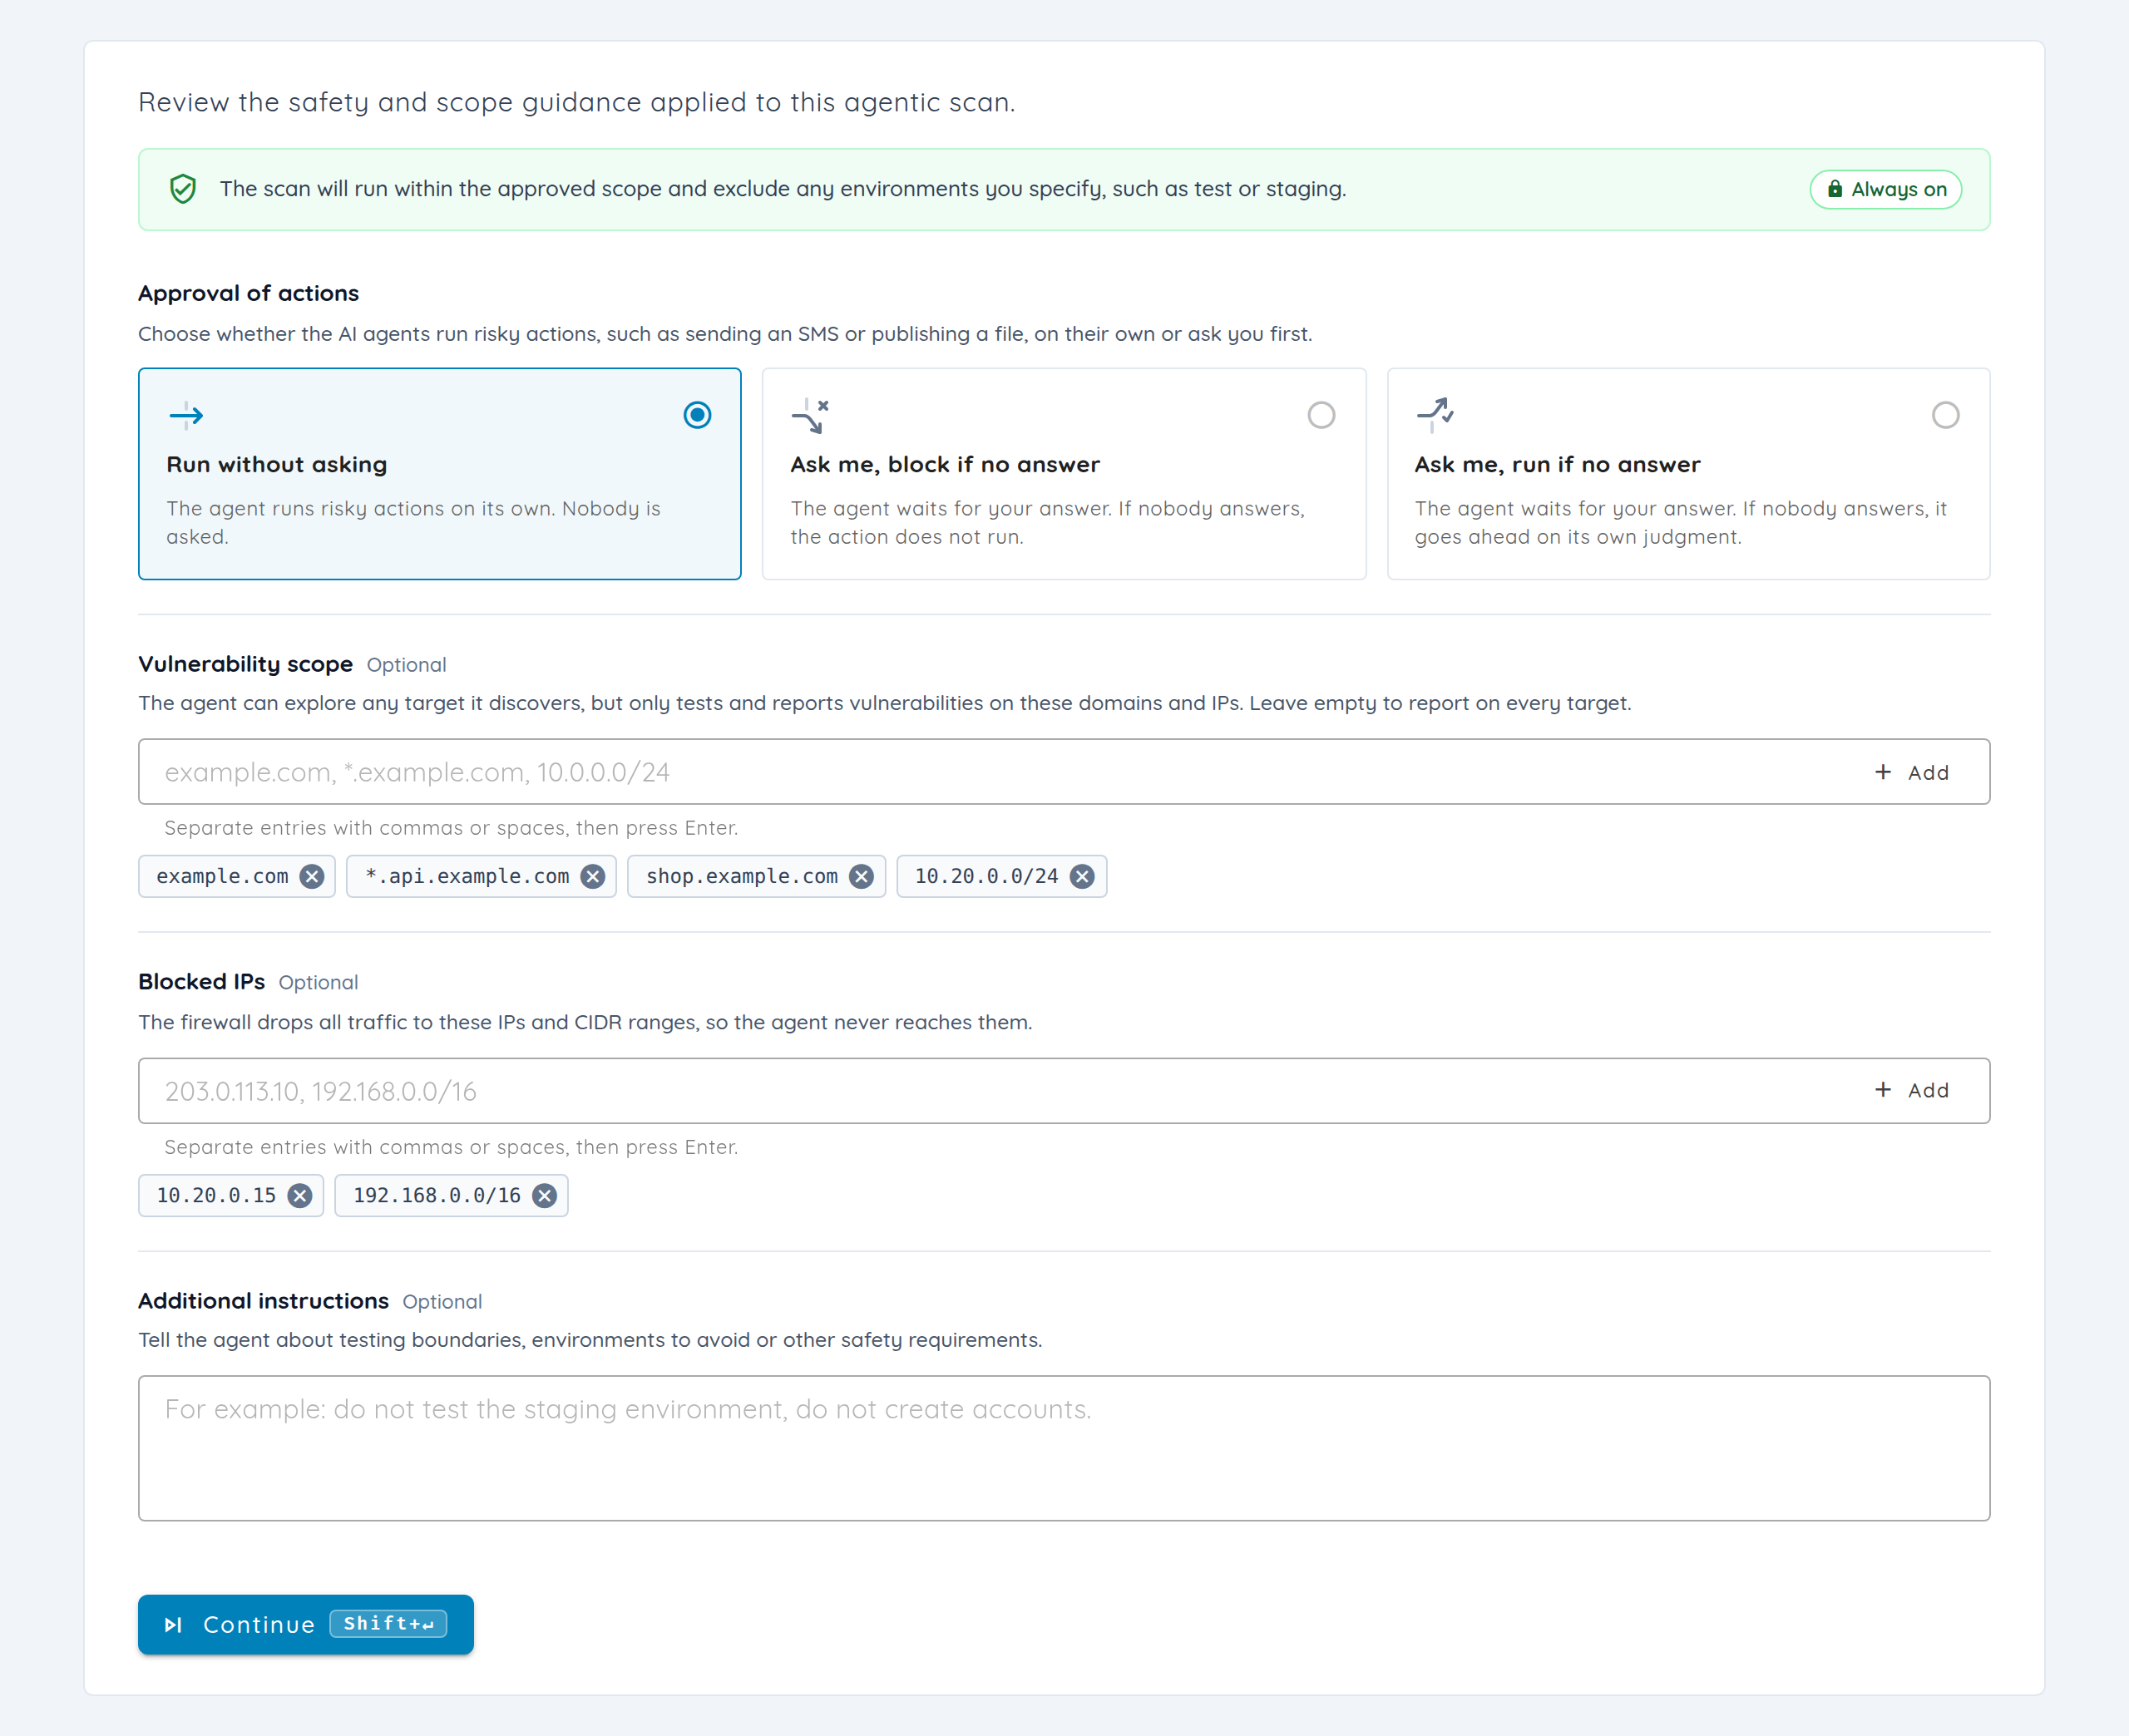
Estos controles actúan en niveles distintos. La lista de permitidos guía al agente mediante prompts; la lista de bloqueo de IP/CIDR aplica reglas de firewall. La supervisión del alcance evalúa por separado la salida del agente para detectar desviaciones y genera alertas, con apagado opcional del agente ofensivo. Los ajustes de las barreras de protección se restablecen entre los escaneos nuevos. Hemos ampliado la compatibilidad con las instrucciones de alcance a los flujos de escaneo de repositorios, de múltiples activos y de red que corresponden.
Hemos añadido comprobaciones de preparación móvil y hemos ampliado las herramientas de investigación
Hemos añadido comprobaciones de preparación móvil para detectar problemas de instalación, de acceso a la interfaz y de autenticación antes de interpretar la cobertura de una evaluación. Si una compilación no puede superar la instalación o el inicio de sesión, puede investigar primero el problema de configuración. Los fallos de infraestructura pueden reintentarse en dispositivos nuevos, y los fallos de instalación causados por la aplicación se distinguen de los problemas del dispositivo. Los fallos de preparación no bloquean automáticamente todos los escaneos.
Hemos ampliado la recuperación de sesiones de dispositivo para que los agentes puedan volver a visitar los puntos de entrada y devolver la aplicación objetivo al primer plano cuando una sesión se interrumpe durante la exploración. Las operaciones de dispositivo autenticadas por sesión conectan la preparación con la recopilación de evidencias. Los emuladores Android con root bajo demanda y las herramientas ampliadas de trazas, registros, código descifrado y datos de aplicación para Android/iOS permiten una investigación más profunda; las correcciones de Flutter y JDWP resuelven los datos de instrumentación incompletos y las reconexiones.
La aplicación también puede incluir código que requiere un enfoque de pruebas diferente: un componente en Rust o código fuente en Swift. Hemos ampliado el razonamiento estructurado sobre código fuente a C++, Rust y Swift, con una planificación que tiene en cuenta las dependencias y una ejecución especializada de pruebas de concepto nativas. Las comprobaciones de exposición de solo lectura más amplias cubren más productos empresariales, SMB, WebLogic T3 y SMTP; una señal de exposición sigue siendo distinta de una explotación confirmada.
Hemos incorporado Ticket Agent para la automatización autónoma
Hemos incorporado Ticket Agent, una nueva forma avanzada de implementar la automatización autónoma, desde el triaje de vulnerabilidades hasta la ejecución de flujos de trabajo complejos de cumplimiento normativo. Dé a un agente sus instrucciones, habilidades reutilizables, herramientas conectadas y reglas de eventos para que pueda recorrer los pasos que, de otro modo, exigirían una coordinación manual repetida.
Para el triaje, eso puede significar revisar los hallazgos según los criterios de su equipo, reunir sus evidencias originales y preparar la siguiente acción. Para el cumplimiento normativo, un agente puede seguir una lista de comprobación de controles, reunir las evidencias de respaldo, identificar las brechas y preparar el resultado para su revisión.
Algunos ejemplos de flujos de trabajo que puede configurar:
| La tarea repetitiva | Un agente que podría escribir |
|---|---|
| Hay que aplicar las reglas de triaje de su equipo a cada escaneo completado. | Se activa con la finalización del escaneo; revisa los hallazgos pertinentes según sus criterios de severidad y de responsables, y luego prepara un resumen de triaje. |
| Alguien informa de un posible falso positivo. | Use un evento de comentario y una condición de tag o de estado coincidente para iniciar una revisión de evidencias. Con las herramientas de evaluación necesarias conectadas, solicite la validación y escriba el resultado en su formato de informe para su revisión. |
| Las evidencias de auditoría necesitan la misma estructura cada vez. | Parta de la plantilla Compliance, añada una lista de comprobación de controles como habilidad, reúna las evidencias mediante las herramientas conectadas, identifique las brechas y prepare el resultado de cumplimiento normativo para su revisión. |
| Los tickets de alta prioridad están cerca de incumplir su SLO o ya lo incumplen. | Use una regla de incumplimiento de SLO o programada para reunir el contexto más reciente y preparar un resumen de escalado. |
| Un ticket reabierto necesita otra investigación. | Se activa con la reapertura; compara las evidencias actuales con la conversación anterior y explica qué necesita otra revisión. |
Son ejemplos que se configuran con sus prompts, condiciones y herramientas conectadas. Un informe de falso positivo es un motivo para investigar; el agente debe registrar las evidencias de validación antes de recomendar un cambio de estado.
Hemos añadido la configuración de Ticket Agent al espacio de trabajo AI Agents, donde puede elegir el modelo, las instrucciones, las habilidades reutilizables, la memoria opcional respaldada por Git y las herramientas MCP para cada tarea. Las plantillas Vulnerability Triage y Compliance ofrecen puntos de partida; sus reglas comienzan deshabilitadas para su revisión.
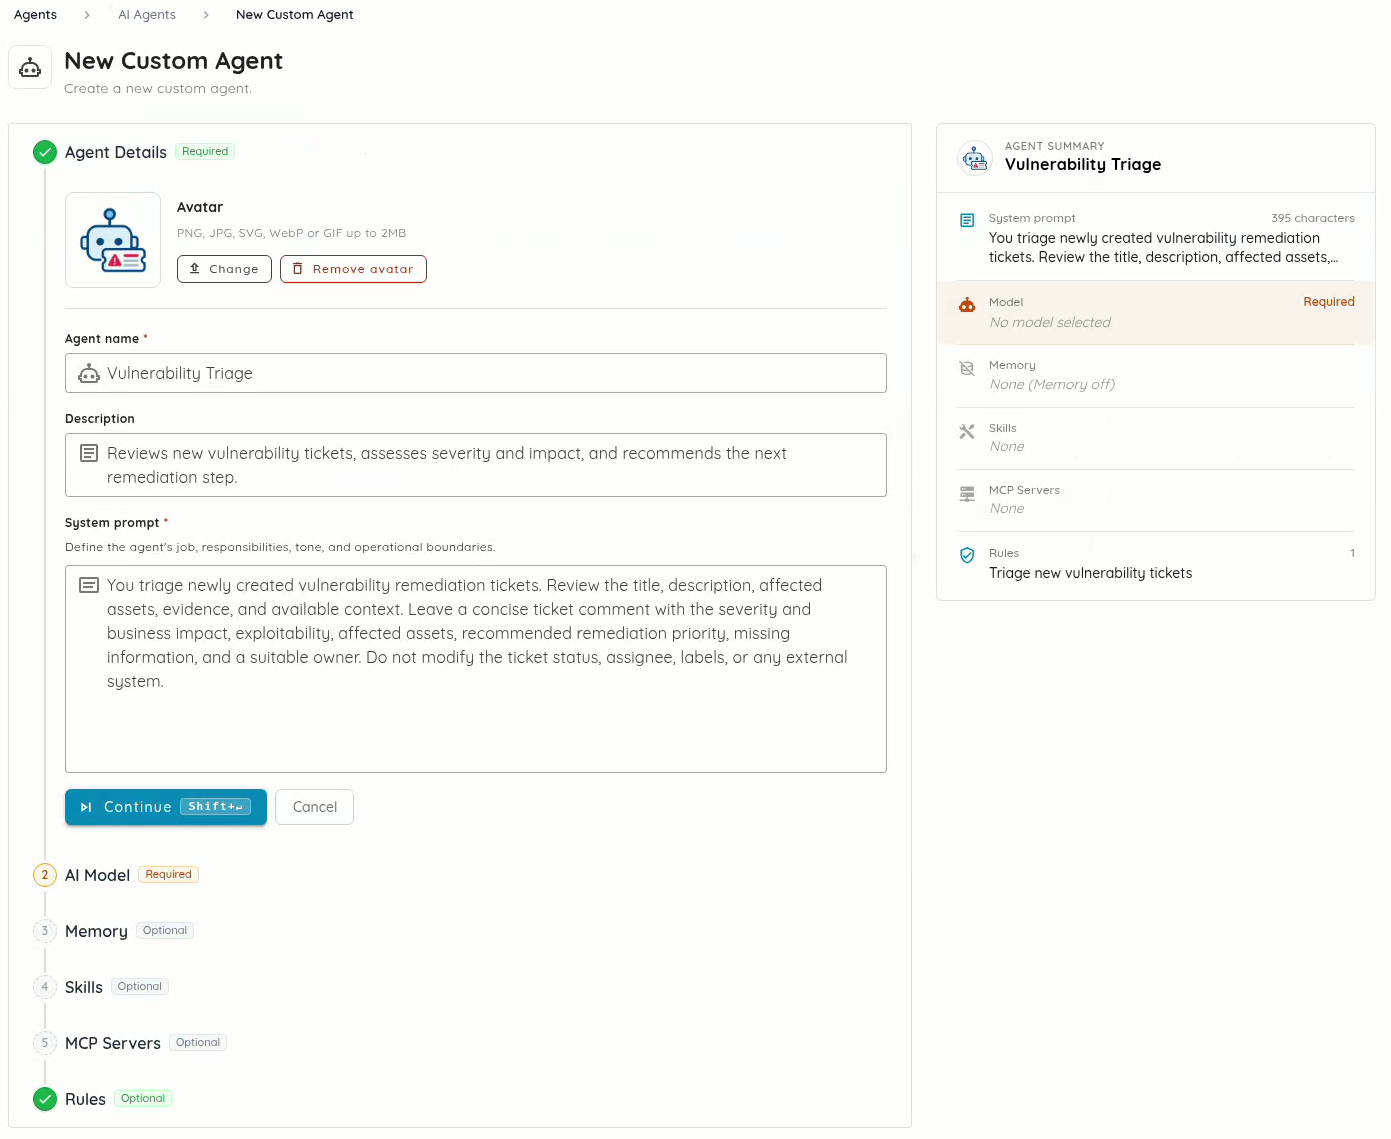
Para probar ese flujo de trabajo, empiece con una regla Assigned condicionada a Assignee is This agent. Asigne un ticket de prueba, revise el resultado y ajuste el prompt antes de ampliar la regla. Un agente puede trabajar junto con una persona asignada, de modo que el ingeniero responsable del problema sigue siendo visible mientras el agente ayuda con la investigación.
Otras reglas pueden reaccionar a la creación de tickets, la reapertura, los comentarios, los incumplimientos de SLO, la finalización de escaneos o una programación. Las condiciones acotan el trabajo por prioridad, estado, stream, tag, persona asignada, perfil de escaneo u objetivo. Las habilidades reutilizables pueden incluir instrucciones escritas, carpetas de GitHub o archivos subidos; las herramientas pueden provenir de servidores MCP remotos, procesos locales u OXO. Consulte la guía de configuración de Ticket Agent para ver ejemplos de configuración y de reglas.

Ver el flujo de corrección en tamaño completo.
Durante una reunión de triaje, puede ser necesario actualizar a la vez los datos de stream de varios tickets. Si su equipo ya usa Remediation Streams, hemos ampliado la edición en hoja de cálculo con selección de varias celdas y copiado y pegado por lotes. La paginación de la línea de tiempo ayuda a navegar por colecciones de streams más grandes. La guía de Streams explica la configuración.
Hemos ampliado la investigación y el triaje de hallazgos
Llega un hallazgo en un informe móvil. Las primeras preguntas de su ingeniero son prácticas: «¿Cómo llegaron las pruebas a esa pantalla? ¿Puedo seguir la reproducción? ¿El código afectado es nuestro o pertenece a un SDK?». Hemos añadido controles de repetición y de titularidad, y hemos ampliado el contexto de los hallazgos en Copilot, para responder a esas preguntas antes de pasar el problema a un equipo.
Siga las evidencias hasta la aplicación
Hemos añadido la repetición de la cobertura de llamadas al mapa de exploración existente para que pueda seguir el recorrido por la aplicación. Las capturas de pantalla, los pies de imagen y una línea de tiempo con ramificaciones muestran la secuencia de navegación registrada. Para un hallazgo detrás del inicio de sesión, puede inspeccionar la ruta que conduce a esa pantalla. La búsqueda y los filtros de estado localizan las interacciones; una línea de tiempo de tamaño ajustable y la vista de mapa existente le permiten moverse entre la secuencia y la exploración más amplia.
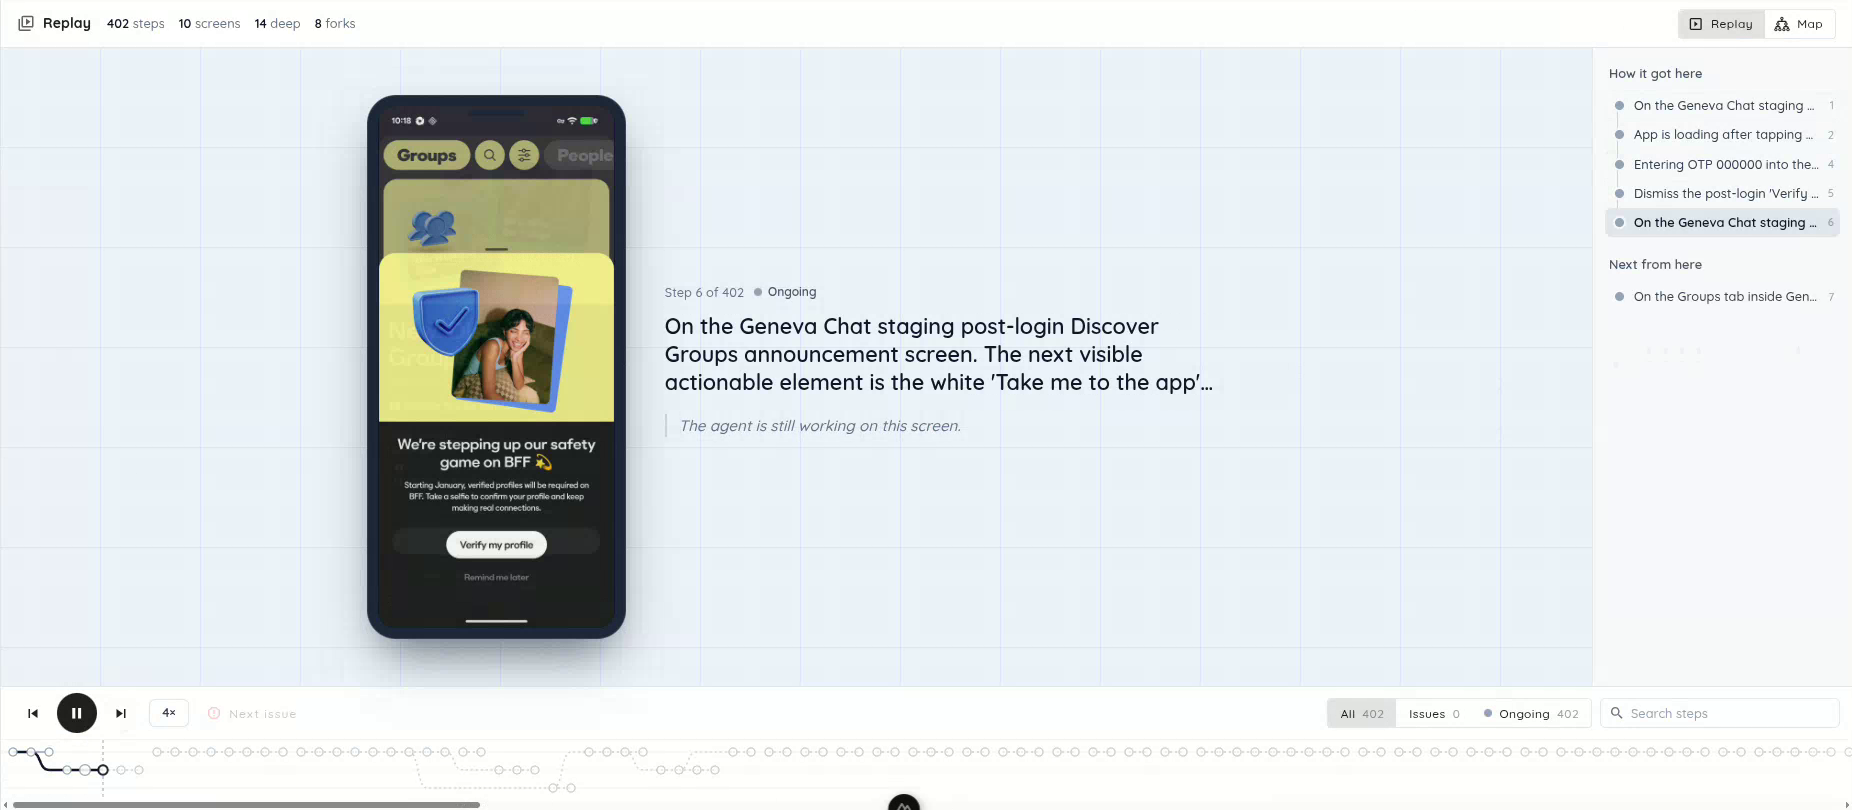
Reproduzca el recorrido por la aplicación, lea el contexto del paso y desplácese por la línea de tiempo con ramificaciones.
Para la siguiente pregunta («Explica esta traza y los pasos que necesito para reproducirla»), hemos ampliado Ask Copilot para que lleve el hallazgo seleccionado a la conversación. Puede empezar desde el problema que tiene en pantalla sin copiar sus detalles en un chat nuevo. Copilot muestra en tiempo real el progreso, la ejecución de herramientas y la actividad del terminal, de modo que puede seguir la investigación, poner en cola otra pregunta o cancelar una solicitud. Las herramientas de vulnerabilidades ampliadas, las habilidades, la memoria y las salidas de herramientas más largas le dan más contexto con el que trabajar.
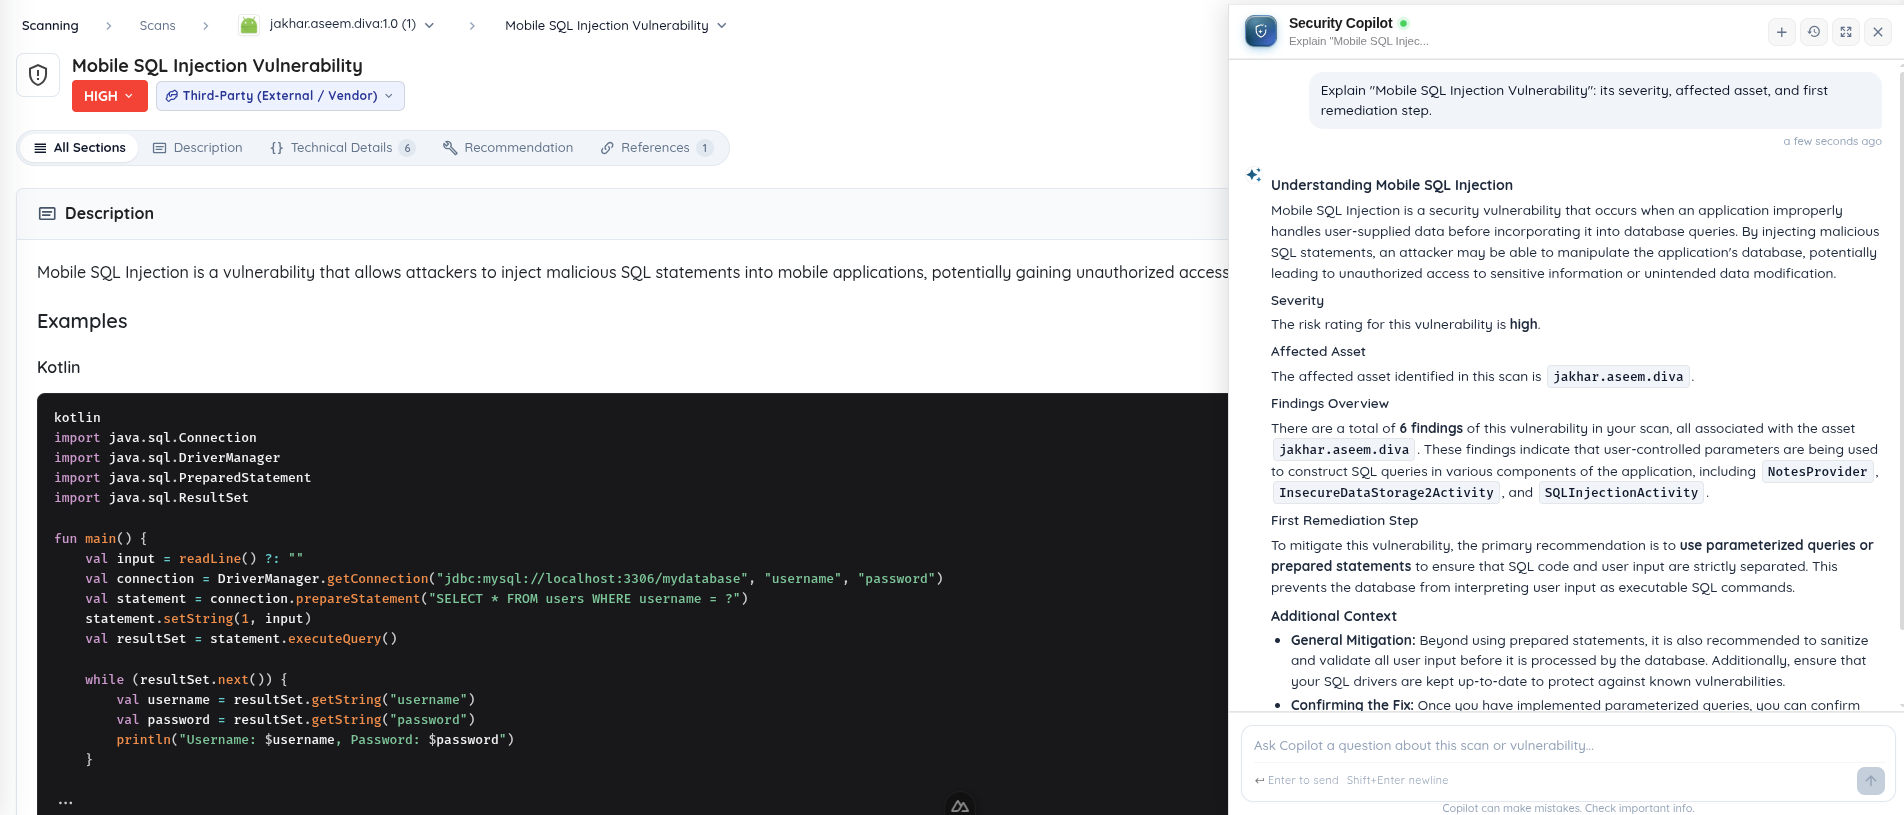
Ask Copilot abre una conversación con el hallazgo seleccionado ya en contexto. Se muestra con la aplicación de demostración DIVA.
Separe los hallazgos accionables del ruido
Si la traza conduce a un SDK incluido en la aplicación, es posible que su equipo de aplicación deba plantear el problema a su proveedor. Hemos añadido la clasificación y los filtros de propio o de terceros, con desgloses de ubicación y trazas de llamadas del SDK para ayudar a tomar esa decisión de titularidad. Puede corregir la clasificación y solicitar que Ostorlab informe de un hallazgo de terceros. La guía de revisión de hallazgos explica el flujo de trabajo asociado.
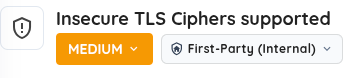
El control de titularidad distingue los hallazgos de la aplicación de los hallazgos de terceros.
Descartar una y otra vez la misma credencial de marcador de posición o revisar avisos de dependencias duplicados dificulta el triaje. Hemos ampliado el análisis de secretos para filtrar más marcadores de posición y valores de configuración del cliente. Los avisos de dependencias se deduplican e incluyen información de la versión corregida; las dependencias sin versión fijada se omiten en lugar de asignarles una versión inventada. El análisis móvil también reconoce el estado propiedad de los Fragment y los fragmentos de Android ofuscados, suprime las alertas de cifrado ficticio de AndroidX Biometric y excluye los ajustes de ATS de los paquetes de frameworks y las excepciones de texto sin cifrar solo de loopback o de emulador.
Un ingeniero que revisa un hallazgo de almacenamiento necesita saber si una credencial se escribió realmente en texto sin cifrar. El análisis de almacenamiento en tiempo de ejecución detecta esas escrituras en SharedPreferences de Android, enmascara los valores y excluye los marcadores de posición y los valores cifrados. Para los equipos que revisan los requisitos de TLS, las comprobaciones ampliadas de protocolos, cifrados y CRYPTREC/IPA tienen explicaciones individuales, y el incumplimiento del perfil se informa por separado de la explotabilidad demostrada.
Hemos añadido acciones sobre los hallazgos y hemos ampliado la verificación de correcciones
Hemos añadido acciones sobre un hallazgo para iniciar la verificación de la corrección, solicitar el informe a terceros o comenzar una corrección en un repositorio conectado. Hemos ampliado la repetición de pruebas para aceptar un candidato móvil no publicado, de modo que un parche pueda evaluarse antes de que llegue a una tienda de aplicaciones.
Inicie la siguiente acción desde el hallazgo
Tiene un hallazgo abierto. El siguiente paso podría ser verificar su parche, pedir a Ostorlab que gestione una divulgación al proveedor o implementar una corrección en un repositorio conectado. Esas tareas deberían empezar donde ya están las evidencias.
- ¿Tiene un parche listo? Haga clic en Verify Fix. Inicie la repetición de la prueba desde el hallazgo en lugar de reconstruir el briefing. Para una aplicación móvil, suba el candidato con el parche aunque la evaluación original usara la versión de la tienda de aplicaciones.
- ¿El problema pertenece a un SDK? Haga clic en Ask Ostorlab to Report. Solicite que Ostorlab se encargue de informar del hallazgo de terceros; su equipo no tiene que reconstruir el problema desde cero para el proveedor.
- ¿Su repositorio está integrado? Inicie la acción de corrección desde el hallazgo. Pida que se implemente una corrección usando el código conectado y el contexto del hallazgo, y luego revise los cambios resultantes mediante su proceso de ingeniería habitual.
«Un clic» es el punto de partida del trabajo: la selección del escáner o del objetivo, una confirmación y una revisión pueden seguir siendo necesarias. El objetivo es sacar de su lista manual de tareas la recopilación de contexto, la investigación y la preparación del siguiente paso.
Por ejemplo, su ingeniero de Android tiene un parche candidato, pero la versión de la tienda de aplicaciones sigue conteniendo el problema. En un encargo tradicional, enviaría la nueva compilación al pentester y le pediría que volviera a la prueba de concepto original y buscara evasiones. Verify Fix ofrece a ese traspaso un punto de partida dentro del hallazgo.
Hemos añadido Verify Fix para iniciar un Single Vulnerability Assessment con la ubicación del hallazgo y su clasificación de debilidad, además de instrucciones para repetir la prueba de concepto original e investigar posibles evasiones. Suba directamente la compilación móvil candidata, incluso cuando el escaneo original usó una versión de la tienda de aplicaciones. Puede evaluar el parche antes de publicarlo y seleccionar un escáner que pueda llegar al objetivo actualizado.
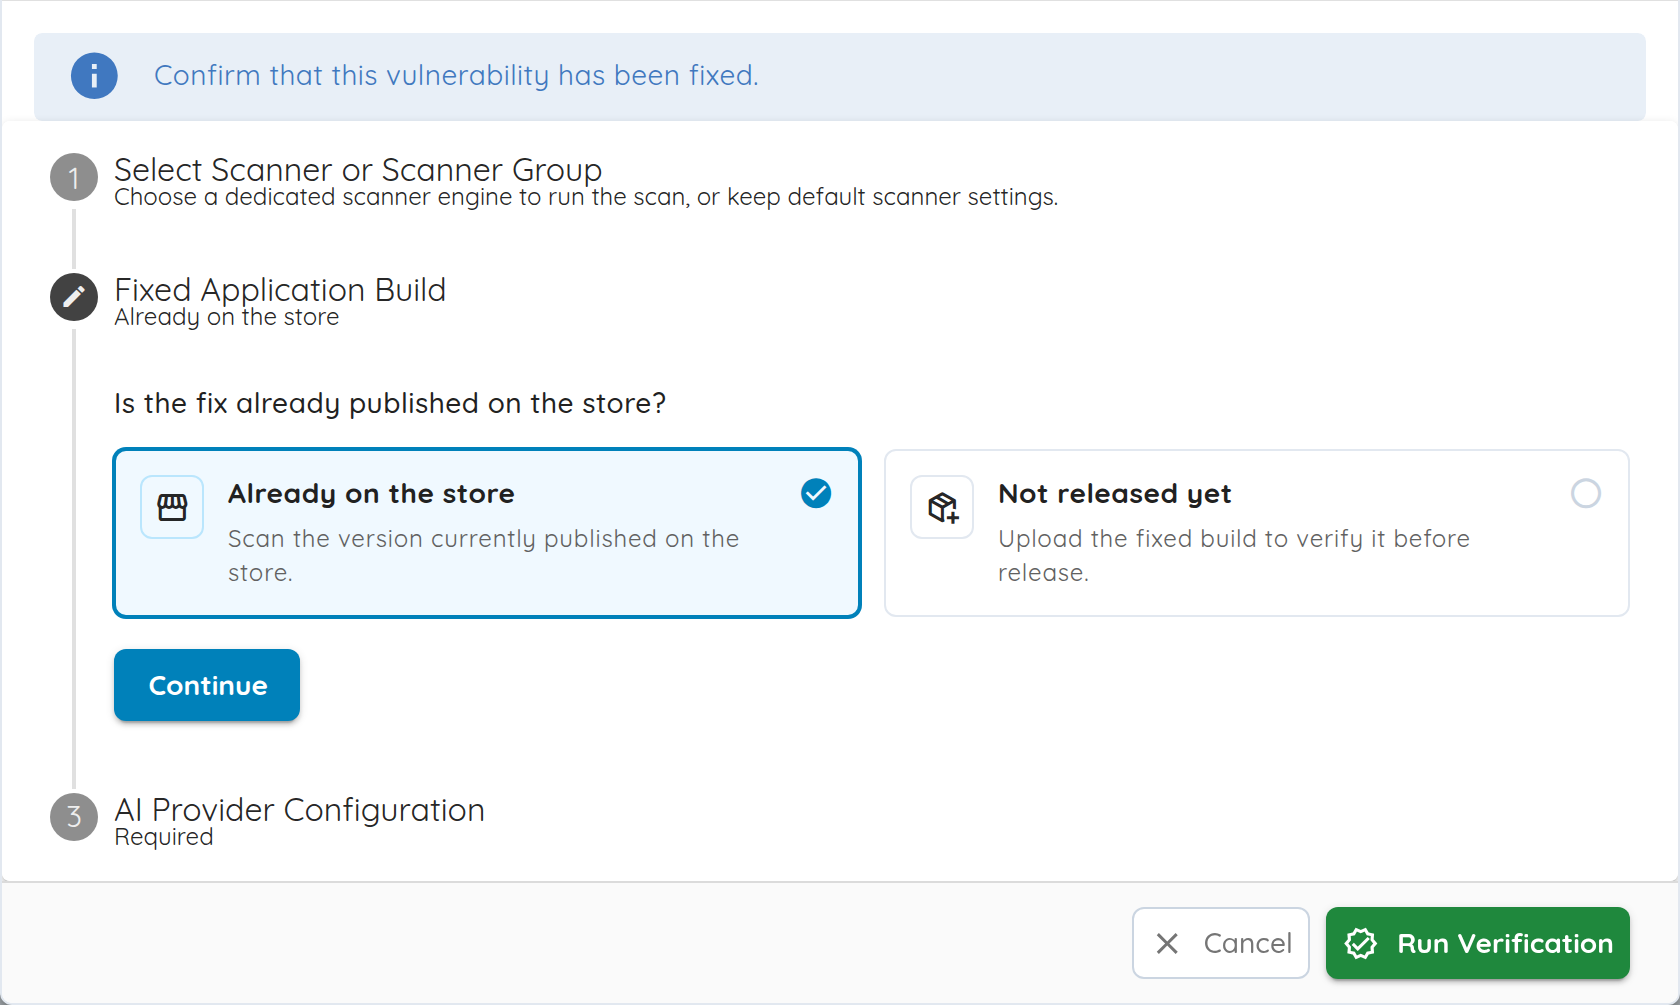
Abra el hallazgo, elija Verify Fix, seleccione un escáner y proporcione el objetivo o la compilación actualizados. El flujo de trabajo admite hallazgos móviles, web y de red. Su veredicto es una evaluación de mejor esfuerzo: revise las evidencias resultantes antes de decidir si cierra el problema.
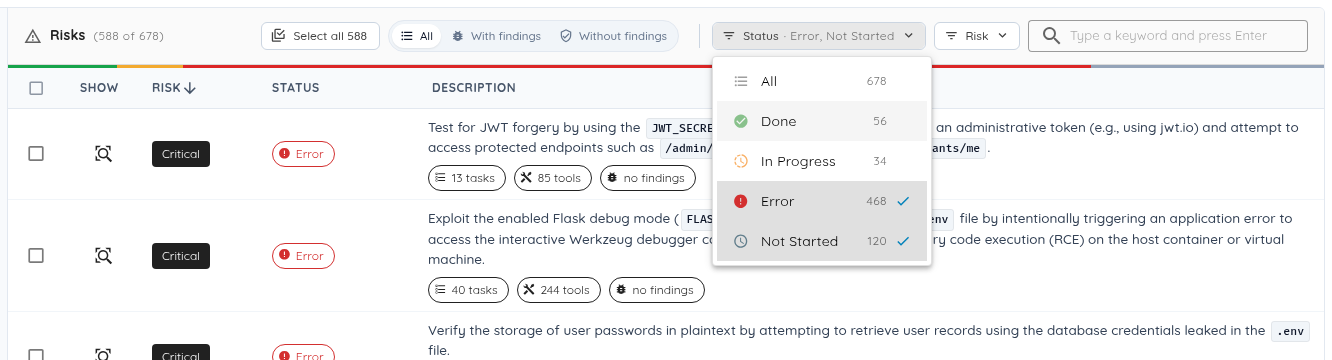
Si la actualización de una dependencia compartida corrige hallazgos en varias aplicaciones, puede haber un conjunto de riesgos que revisar de nuevo. Hemos añadido búsqueda, ordenación y filtros de estado en el servidor para encontrar ese conjunto, además de selección entre páginas y repeticiones de riesgos por lotes para lanzar juntas las evaluaciones de seguimiento. Los seguimientos de múltiples activos también conservan mejor el activo afectado original.
Hemos ampliado los controles de MCP y de integraciones
Un ingeniero abre un ticket en su asistente de programación y pide ayuda para corregirlo. Una descripción pegada puede omitir el intercambio HTTP o la traza de pila que explica el problema. Mientras tanto, el equipo de seguridad necesita que las actualizaciones de los escaneos se entreguen en sus propios sistemas. Hemos ampliado las conexiones que llevan las evidencias y los flujos de trabajo de escaneo a esas herramientas.
Permita que los asistentes de programación inspeccionen las evidencias y actúen sobre ellas
Hemos ampliado el Ostorlab Platform MCP Server presentado en septiembre para que un asistente de programación conectado pueda recuperar más evidencias de un hallazgo: tráfico HTTP, capturas de paquetes, trazas de pila, código fuente, registros, nodos de cobertura de llamadas y detalles de los activos. Así, una investigación tiene acceso al material original mientras el ingeniero trabaja en una corrección.
Los clientes conectados también pueden crear escaneos compatibles de aplicaciones móviles, TestFlight, repositorios, archivos de código fuente, descubrimiento y múltiples activos, preparar archivos subidos y configurar presupuestos. Para los equipos que ya automatizan flujos de trabajo de escaneo, MCP expone ahora las exportaciones compatibles de CSV, SARIF y archivos de escaneo, la configuración y las pruebas de integraciones, y la gestión de grupos de escáneres, programaciones de supervisión y recursos de agentes de corrección. Las herramientas disponibles dependen de los permisos de la clave de API y de la configuración del producto. La guía de configuración de MCP explica los clientes, las subidas y la paginación.
Adapte la entrega y el acceso a los repositorios a su organización
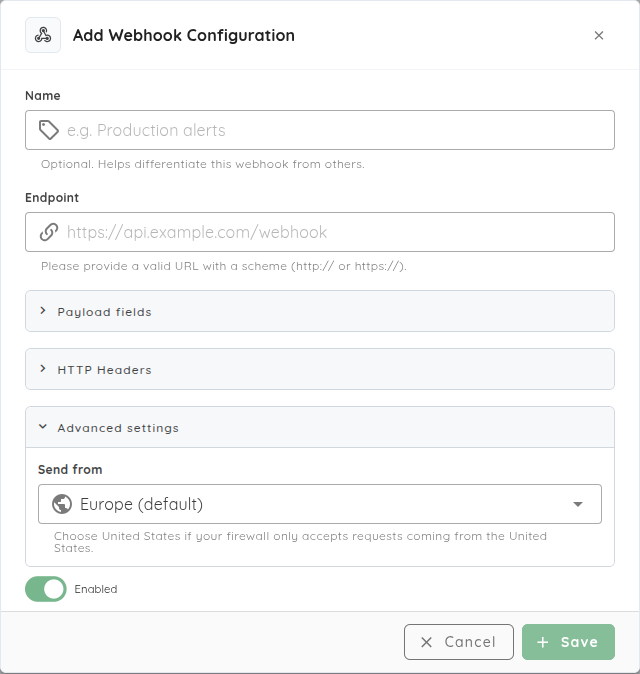
Supongamos que las notificaciones de sus escaneos alimentan un servicio interno que solo acepta tráfico de orígenes aprobados y necesita solo unos pocos campos del payload. Hemos ampliado los webhooks para que pueda elegir los campos del escaneo que se envían a ese receptor, dar al destino un nombre reconocible y seleccionar la salida desde Europa o Estados Unidos. Las pruebas usan el trabajo en segundo plano de la región seleccionada, de modo que durante la configuración puede comprobar la ruta de entrega frente a la lista de permitidos del receptor.
Si su equipo de plataforma ya gestiona identidades de GitHub App y la rotación de credenciales, ahora puede usar GitHub Apps propiedad del cliente para la integración con repositorios. Configure instalaciones, cambie el nombre de las aplicaciones, rote las credenciales y deshabilite o elimine instalaciones mediante ese ciclo de vida conocido. Las instalaciones personalizadas se verifican con las credenciales de la App; la conexión de la App de Ostorlab verifica el acceso de los usuarios mediante GitHub OAuth. Las instalaciones compatibles pueden conectarse a varias organizaciones de Ostorlab autorizadas. Consulte la guía de la integración con GitHub.
Hemos ampliado las evaluaciones recurrentes y las conexiones de modelos
La evaluación del próximo mes empieza después de que la aplicación haya cambiado: el flujo de inicio de sesión es distinto, otro servicio se ha incorporado al alcance y el equipo necesita saber qué ocurrió en la última ejecución programada. Los pentesters que regresan necesitan un briefing actualizado. Las evaluaciones recurrentes necesitan un conocimiento mantenido y un registro claro de sus ejecuciones por el mismo motivo.
Mantenga el conocimiento al día y vea cuándo fallan las pruebas
Si una entrada de conocimiento retenida sigue describiendo el flujo de inicio de sesión antiguo, ahora puede editarla en lugar de arrastrar ese contexto obsoleto a trabajos posteriores. El conocimiento de escaneo persistente permite añadir, editar y eliminar entradas. La exploración incremental de carpetas ayuda a inspeccionar espacios de trabajo de conocimiento más grandes sin cargar todo el árbol.
Cuando su evaluación semanal incluye una aplicación móvil, su backend y otros activos, las evaluaciones recurrentes de múltiples activos pueden programar colecciones heterogéneas y comprobaciones de la superficie de ataque. Si una ejecución programada falla, el historial de supervisión muestra ahora su estado de ejecución y detalles del fallo desplegables, lo que le da un lugar por donde empezar a investigar. Consulte la guía de supervisión.
Para la próxima reunión de seguimiento, Cockpit muestra las acciones pendientes y un resumen diario de cambios. Los informes añaden resúmenes más claros de los escenarios de ataque, logotipos de la organización en los PDF y una mayor compatibilidad de idiomas en tareas, informes y mensajes transaccionales, lo que ayuda a compartir la evaluación con las personas responsables del siguiente paso.
Planifique el consumo y elija dónde se ejecuta la inferencia de los modelos
Antes de encargar otra evaluación, un equipo necesita planificar su alcance y su consumo. Las estimaciones de consumo de escaneos y los presupuestos compatibles de tokens y de riesgos ayudan con esa planificación. Las tarjetas de estimación de Copilot rellenan previamente los objetivos y el perfil actuales para su revisión. Los tokens de la cartera pueden comprarse por cantidad; los modelos prepagados de los agentes de corrección usan la misma cartera de la organización, junto con la opción de usar su propia clave de proveedor.
Si su equipo ya sirve modelos mediante Ollama o un servidor compatible con OpenAI, BYOK puede conectarse ahora a ese servicio, incluidos los despliegues de vLLM, LM Studio y llama.cpp. Configure la URL del endpoint, el nombre del modelo y una clave de API si hace falta; el servidor debe ser accesible desde el escáner. Los agentes compatibles de pruebas autónomas y de exploración móvil, así como OXO, pueden usar estas conexiones.
Una conexión de inferencia determina dónde se ejecuta la inferencia del modelo; no traslada la orquestación de la plataforma, los hallazgos ni los informes. La guía de BYOK explica la configuración junto con la del escáner.
Un fallo temporal de subida también puede dejar a un equipo esperando los hallazgos después de que las pruebas se hayan ejecutado. La mejora de los reintentos de subida de hallazgos y la recuperación de lotes fallidos resuelven ese traspaso. El trabajo de fiabilidad abarca también el rastreo autenticado, las conexiones de API durante los despliegues, la limpieza de escáneres y la supervisión del estado de los dispositivos. La ocultación ampliada de secretos en Copilot, las operaciones de activos y de conocimiento limitadas a la organización y los permisos de integración más estrictos respaldan estos flujos de trabajo.
Hemos añadido mejoras cotidianas de la interfaz
Cambia entre pestañas de escaneo, hace el triaje de un lote de hallazgos, pega los mismos valores de stream en varios tickets y luego vuelve a su trabajo tras una interrupción. Hemos añadido los siguientes controles y hemos ampliado las vistas existentes para que esas tareas habituales resulten menos engorrosas:
| Cuando… | Qué es más fácil ahora |
|---|---|
| Trabaja con una lista de riesgos grande | Búsqueda, ordenación, paginación y filtros de varios estados en el servidor, selección entre páginas y repeticiones por lotes. |
| Navega por un hallazgo | Pestañas de sección fijas, un campo de búsqueda más ancho, un menú de triaje que tiene en cuenta la selección, y la calificación de riesgo y la descripción en el panel lateral. |
| Comparte un escaneo o vuelve a él | La pestaña de escaneo abierta se mantiene en su URL. |
| Edita tickets en una hoja de cálculo | Selección de varias celdas, copiado y pegado por lotes, creación y edición de streams, borrado con Delete/Backspace, y persistencia y recuperación de borradores. |
| Vuelve a su trabajo asignado | Un acceso directo My tickets y filtros que se conservan durante la edición. |
| Navega por un espacio de trabajo grande | Las carpetas de conocimiento se cargan de forma incremental; los árboles de archivos expandidos se desplazan; el nombre del archivo seleccionado es visible y las vistas previas de imágenes mantienen sus proporciones. |
| Cambia de contexto | El elemento actual aparece primero en los selectores de migas de pan; el comportamiento de los desplegables es más coherente. |
| Crea un escaneo | Pasos obligatorios, recomendados y opcionales más claros; ajustes específicos del perfil; insignias de plataforma e identificadores de objetivo más claros. |
| Sigue la exploración | Búsqueda en la repetición, filtros de estado y una línea de tiempo de tamaño ajustable junto al mapa existente. |
| Configura notificaciones | Webhooks con nombre, campos del payload seleccionables, entrega regional y pruebas más claras de los webhooks guardados. |
| Sigue el trabajo de Copilot | Progreso y actividad del terminal en tiempo real, preguntas de seguimiento en cola y cancelación. |
| Lee un informe mientras se cargan las secciones | La carga en segundo plano mantiene ágil la navegación por las pestañas. |
Entre bastidores: mejor contexto y lo que viene
Memoria que conserva el contexto útil de la investigación
Una evaluación posterior debería poder recoger notas útiles y archivos de prueba de concepto de trabajos anteriores. Los agentes de la misma evaluación también necesitan una visión compartida de la investigación en lugar de redescubrir el contexto una y otra vez.
Hemos ampliado la memoria del espacio de trabajo en torno a ese problema: restaurar los archivos guardados en el espacio de trabajo compartido, guardar archivos nuevos y modificados, reintentar los fallos de sincronización recuperables y terminar la sincronización final antes de que acabe una evaluación. Las transferencias directas al almacenamiento de objetos y el registro de archivos por lotes reducen la sobrecarga de conservar ese contexto. El despliegue por perfiles de escaneo se está realizando por fases; es un trabajo en curso sobre la base de la memoria, junto con la edición del conocimiento y la memoria opcional de Ticket Agent descritas más arriba.
Próximamente: Active Directory y RASP
Un encargo interno suele empezar con una cuenta de dominio y la pregunta: «¿Adónde puede llevar a un atacante esta identidad?». Estamos preparando las pruebas de Active Directory para ese flujo de trabajo: razonamiento sobre Kerberos y los servicios de certificados, análisis de permisos y de confianza, y planificación de rutas entre equipos. El trabajo incluye también herramientas específicas de AD y controles de password spraying que tienen en cuenta los bloqueos de cuentas. Próximamente describe esta experiencia de pruebas; estos cambios de ingeniería subyacentes no significan que el flujo de trabajo completo esté disponible de forma general hoy.
También estamos desarrollando Runtime Application Self-Protection (RASP) para aplicaciones móviles, que extiende la seguridad de la evaluación a la protección mientras una aplicación se ejecuta. El trabajo reúne el bastionado de aplicaciones, las comprobaciones en tiempo de ejecución y la visibilidad de las señales de protección. El flujo de trabajo de protección de extremo a extremo llegará próximamente y sigue en desarrollo.
Para un problema existente, empiece con Verify Fix en su hallazgo en Ostorlab. Para un cuello de botella recurrente de triaje, configure un Ticket Agent sobre un pequeño conjunto de tickets y revise su resultado antes de ampliar sus reglas.