Creamos un agente de IA para nuestro propio backlog. Ahora es suyo.
Cómo un pequeño agente que convertía tickets de errores en pull requests se transformó en el ticket agent de Ostorlab: un compañero de IA al que usted asigna una tarea, un modelo y reglas sobre cuándo se ejecuta.
El problema
En Ostorlab creamos herramientas que encuentran problemas, ya sea en aplicaciones móviles, aplicaciones web, API o código. Ese es nuestro trabajo, y tiene un coste: cada problema que encontramos se convierte en un ticket.
Nuestra propia plataforma no es distinta. Aparecen errores en los registros, se reportan bugs, los escaneos detectan problemas, y cada uno se convierte en un ticket. Y los tickets seguían llegando.
Muchos de ellos no eran difíciles. Un stack trace señalaba la línea exacta, el mensaje de error indicaba qué había fallado y la corrección solían ser unas pocas líneas de código. Aun así, alguien tenía que dejar lo que estaba haciendo: abrir el ticket, leerlo, encontrar el código, escribir la corrección, probarla y abrir un pull request.
Así que los tickets sencillos esperaban, no porque fueran difíciles, sino porque todos estaban ocupados con tareas más complejas. Una corrección pequeña podía quedarse días sin atender, y el backlog crecía. No con problemas difíciles, sino con otros fáciles para los que nadie tenía tiempo.
La oportunidad
Al examinar más de cerca esos tickets, nos dimos cuenta de algo. Muchos de ellos no los había escrito ninguna persona. Se generaban automáticamente a partir de registros de errores y resultados de escaneos, y esas fuentes ya recogen los detalles: el mensaje de error, el stack trace, el archivo, la línea. Los tickets ya decían qué se había roto, dónde se había roto y, a menudo, por qué.
Habíamos diseñado esos tickets para dar a nuestros ingenieros todo lo necesario para empezar una corrección. Y comprendimos que lo que necesita un ingeniero para empezar una corrección es también lo que necesita un agente de IA. La información estaba ahí. Lo que faltaba era tiempo.
Eso nos llevó a plantearnos una pregunta sencilla: ¿y si un agente pudiera tomar el ticket y empezar la corrección?
Los agentes de programación ya sabían leer código, seguir un error y escribir una corrección. Pero la mayoría seguía esperando a que un desarrollador los abriera y escribiera un prompt. Queríamos algo distinto. No queríamos otra herramienta que los ingenieros tuvieran que acordarse de usar; queríamos que el trabajo empezara donde ya vivía: en el ticket.
Llega un ticket, un agente lo toma, sale un pull request y un ingeniero lo revisa. El ingeniero mantiene el control y simplemente se salta la parte repetitiva. Y, como cada ticket va a su propio agente, el trabajo escala con el backlog: se ejecutan en paralelo tantos agentes como tickets haya que atender.
La primera versión
Empezamos en pequeño, a propósito. Creamos un agente con una sola tarea: leer un ticket de error y abrir un pull request que lo corrija.
Lo llamamos Rubberduck. A no todos en el equipo les encanta el nombre. Pero se quedó.
El flujo era sencillo. Un ingeniero asignaba un ticket a Rubberduck, igual que se lo asignaría a un compañero. Después, el agente se encargaba:
- Leía el ticket y sus comentarios.
- Encontraba el código correcto.
- Averiguaba qué había fallado.
- Escribía una corrección y abría un pull request.
- Dejaba un comentario en el ticket con un enlace a ese pull request.
Si un revisor pedía un cambio, no necesitaba ninguna herramienta nueva. Dejaba un comentario, como haría con cualquier colega, y Rubberduck lo leía y actualizaba su trabajo.
Eso era todo. Sin panel, sin ajustes: un agente, una tarea. No era perfecto, pero era lo bastante bueno para ponerlo a trabajar con tickets reales.
Usarlo nosotros mismos
Dimos a Rubberduck tickets reales de nuestro propio backlog, y empezó a abrir pull requests. Algunos eran buenos, otros no, y cada error nos enseñó algo.
Encontrar la causa, no el síntoma. Las primeras correcciones a veces ocultaban el error en lugar de resolverlo. Por eso enseñamos al agente a trabajar como un ingeniero cuidadoso: leer el error, rastrearlo hasta su causa real, reproducirlo y, solo entonces, corregirlo.
Escribir para personas. Los primeros títulos de los pull requests eran, a menudo, simplemente el mensaje de error copiado del ticket. Difíciles de leer en una lista larga. Ahora el agente escribe un título breve que dice qué ha corregido.
Decir cuándo no se sabe. A veces un ticket no tenía suficiente información. El agente improvisaba, y las conjeturas dan malas correcciones. Le enseñamos a detenerse y preguntar. Ahora puede informar de que un ticket está corregido, corregido parcialmente, bloqueado o necesita más contexto.
Terminar el trabajo. Un pull request con pruebas fallidas no es una corrección. Por eso el agente ahora espera a que pasen las comprobaciones y corrige lo que falla.
Seguir nuestras reglas. Cada equipo tiene su propia forma de escribir código. Dimos al agente nuestras guías de estilo. También le dimos una memoria, para que una lección aprendida en un ticket ayude en el siguiente.
Mantener los secretos fuera de su alcance. El agente necesita acceso a nuestro código, pero nunca debe ver nuestras contraseñas ni secretos. Por eso los sacamos por completo de su alcance: se inyectan en tiempo de ejecución, de modo que el agente puede usarlos pero nunca leerlos.
Dejamos de pensar en Rubberduck como un experimento cuando sus pull requests empezaron a aparecer en nuestra cola de revisión junto a los de todos los demás. Los revisábamos de la misma manera. Se había convertido en parte del equipo.
La gran revelación
Una vez que Rubberduck funcionó, las personas del equipo empezaron a pedir más:
«¿Puede ordenar los tickets nuevos por urgencia?» «¿Puede comprobar nuestros hallazgos frente a nuestras reglas de cumplimiento normativo?» «¿Puede revisar los tickets abiertos todos los lunes?»
Eran buenas ideas, pero Rubberduck no podía hacerlas. Su tarea venía incorporada: corregía código y nada más. Ya habíamos creado un segundo agente, uno que planificaba el trabajo en lugar de escribir código, y tenía el mismo problema: su tarea también venía incorporada. Podíamos seguir creando un agente nuevo para cada tarea nueva, pero eso no acabaría nunca.
Usar Rubberduck no requería ninguna configuración. Crear cada nuevo agente sí: había que escribir a mano un largo archivo de configuración en el que cada nombre tenía que ser exacto. Funcionaba, pero teníamos la sensación de que había una forma mejor.
Fue entonces cuando vimos la verdadera oportunidad. El problema nunca fue «necesitamos un agente que corrija código». El problema era «tenemos trabajo en nuestros tickets para el que nadie tiene tiempo», y corregir código era solo un tipo de ese trabajo.
Así que un agente no debería tener una tarea fija. Debería asumir la tarea que un equipo le encomiende, y configurarlo debería parecerse a rellenar un formulario, no a escribir un archivo de configuración. Se describe la tarea con palabras sencillas, se elige un modelo y se decide cuándo se ejecuta.
Lo que construimos
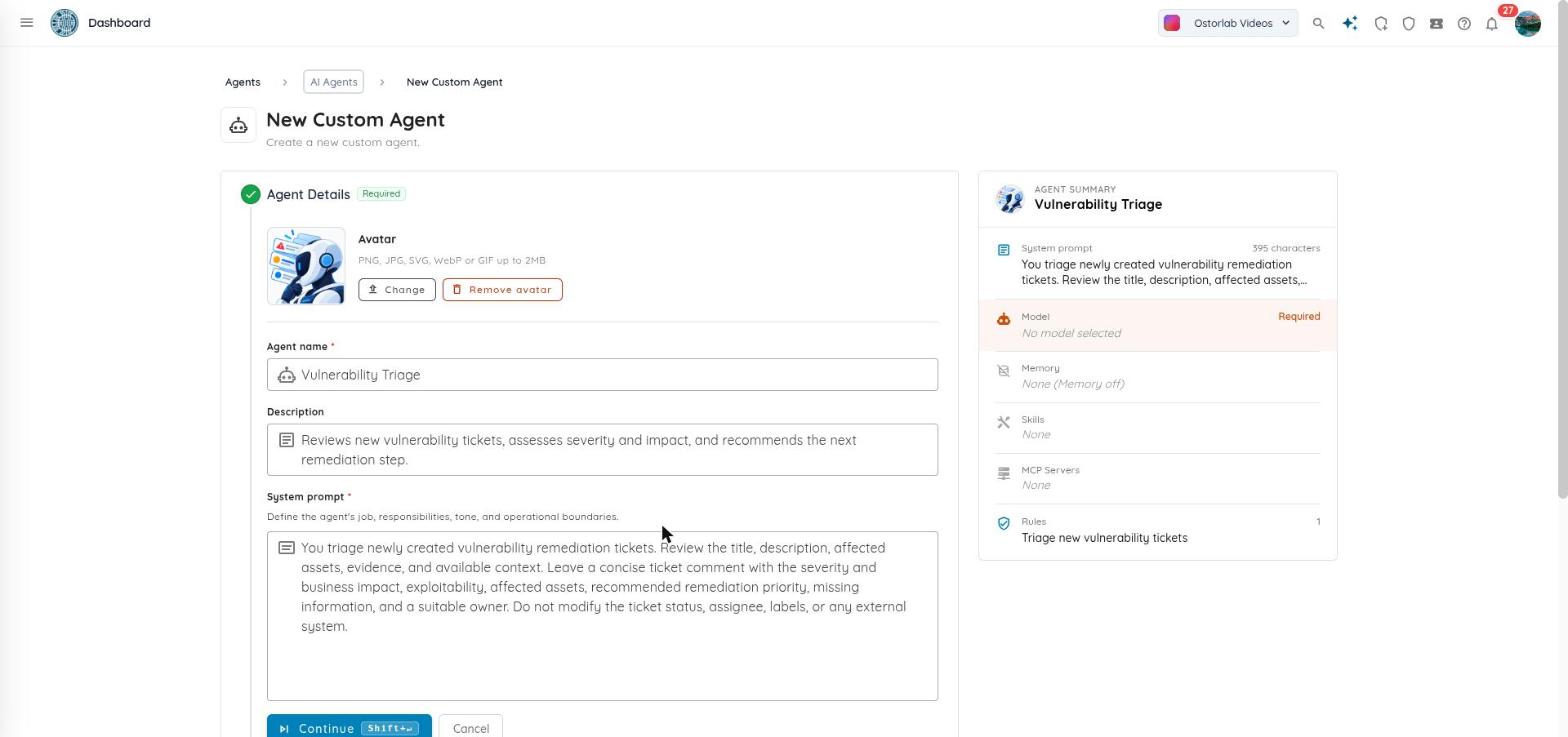
Reconstruimos el ticket agent en torno a esa idea. Ahora hay un único tipo de agente, y no tiene ninguna tarea hasta que usted se la da. Se configura en un formulario, en unos pocos pasos.
Póngale un nombre. El que quiera. Elija con cuidado: los nombres se quedan. Lo sabemos bien.
Asígnele una tarea. Usted escribe lo que debe hacer el agente, con palabras sencillas. ¿No sabe por dónde empezar? Nuestra guía de configuración le acompaña paso a paso, con las lecciones que aprendimos por el camino.
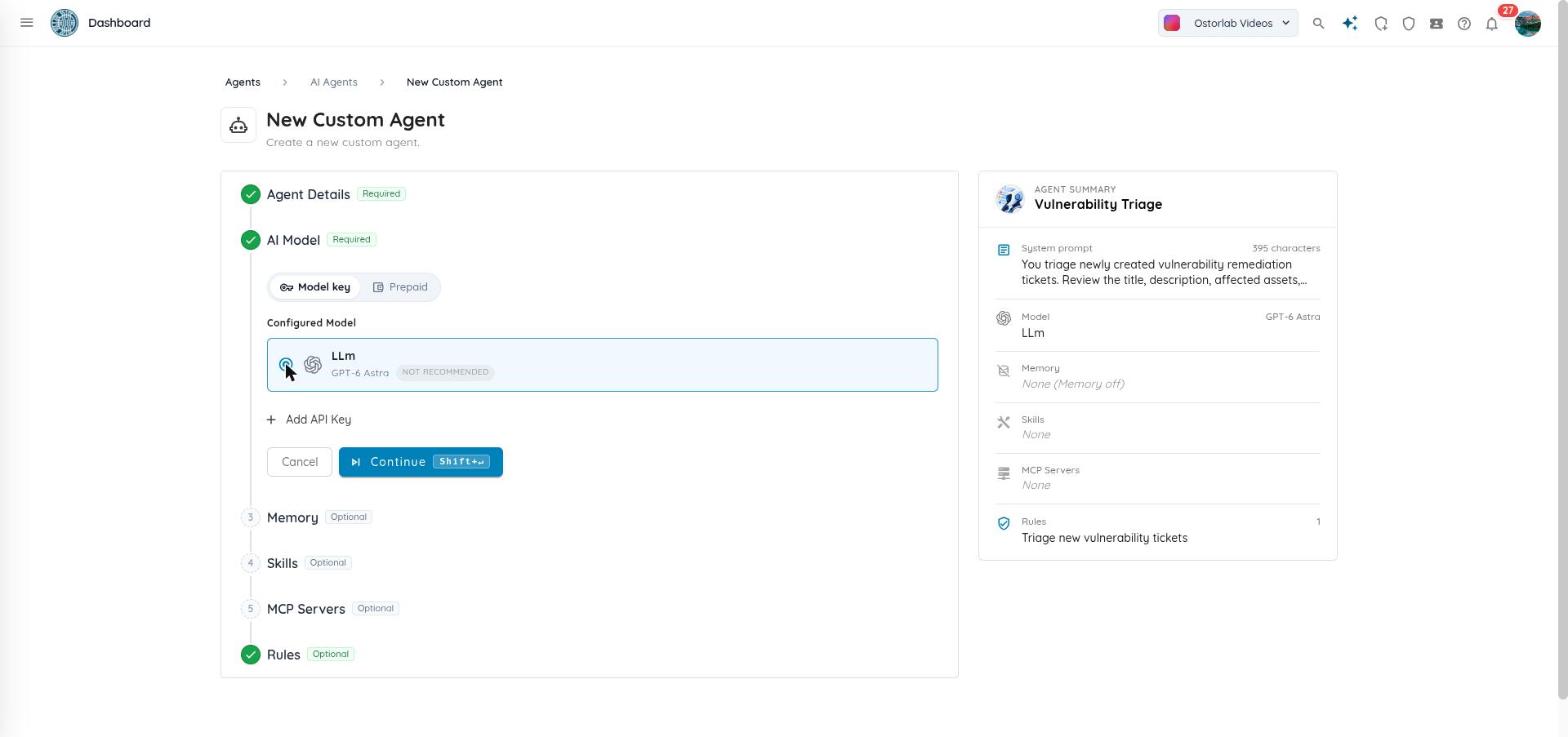
Elija un modelo. Puede usar su propia clave de proveedor de IA, o bien ejecutarlo con los modelos que proporciona Ostorlab y pagar con su saldo de créditos. Cada ejecución reserva créditos al iniciarse, y los créditos que no utiliza se le devuelven.
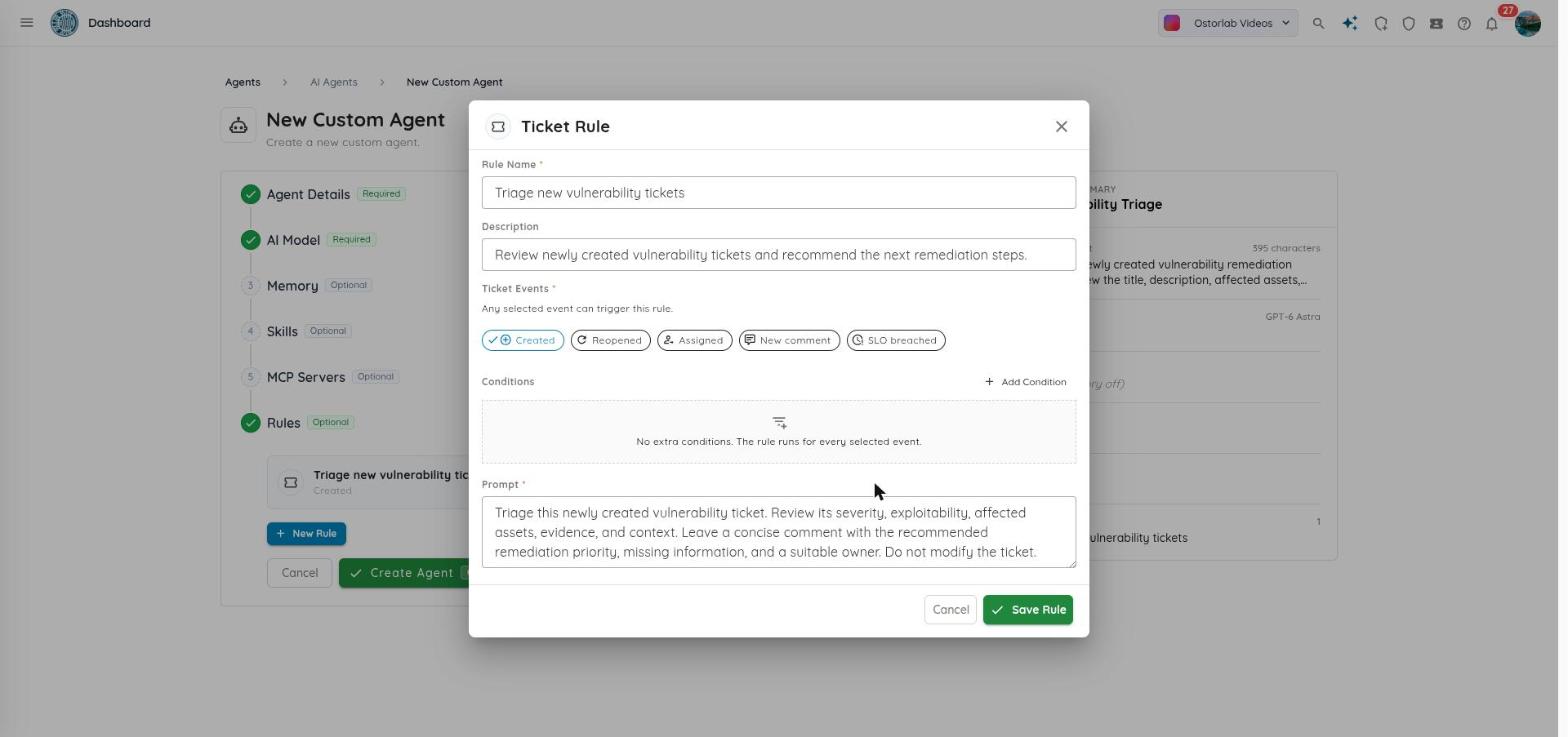
Decida cuándo se ejecuta. Usted añade reglas. Una regla puede activarse:
- cuando ocurre algo en un ticket: se crea, se asigna, se reabre, recibe un comentario nuevo o incumple su plazo,
- cuando termina un escaneo,
- o según una programación, por ejemplo todos los lunes por la mañana.
Puede acotar cada regla. Por ejemplo, solo a los tickets críticos o solo a los escaneos de una aplicación.
Enséñele cómo trabaja usted. Puede darle skills: guías breves que explican cómo hace las cosas su equipo. También puede darle una memoria, para que lo que aprenda en un ticket ayude en el siguiente.
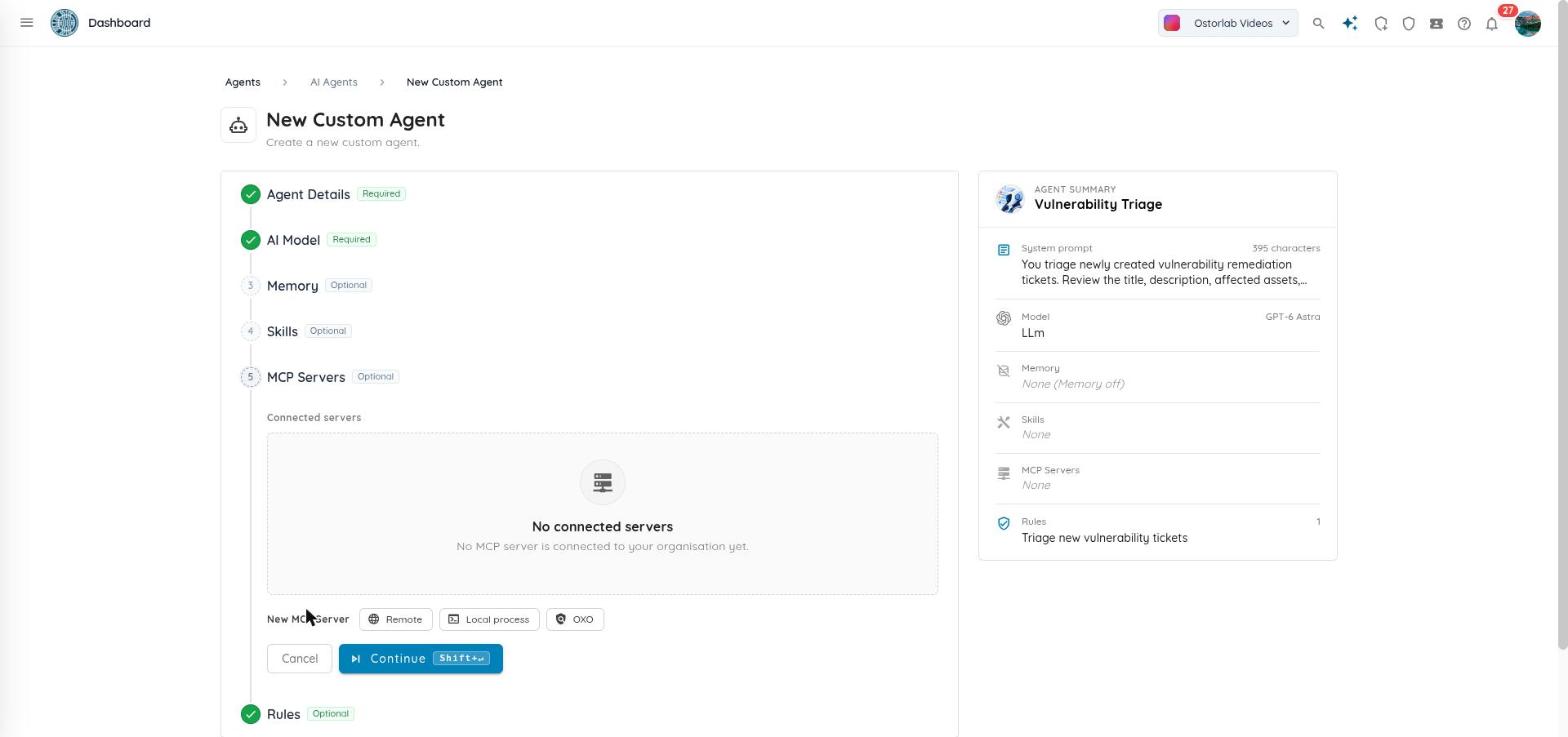
Conéctelo a sus herramientas. El agente puede usar servidores MCP (Model Context Protocol), de modo que puede trabajar con las herramientas que su equipo ya utiliza, no solo con las propias de Ostorlab.
Trabaje junto a las personas. Usted asigna un ticket a un agente igual que se lo asigna a un compañero. Un ticket puede tener ambos. El agente hace su parte y la persona sigue al mando.
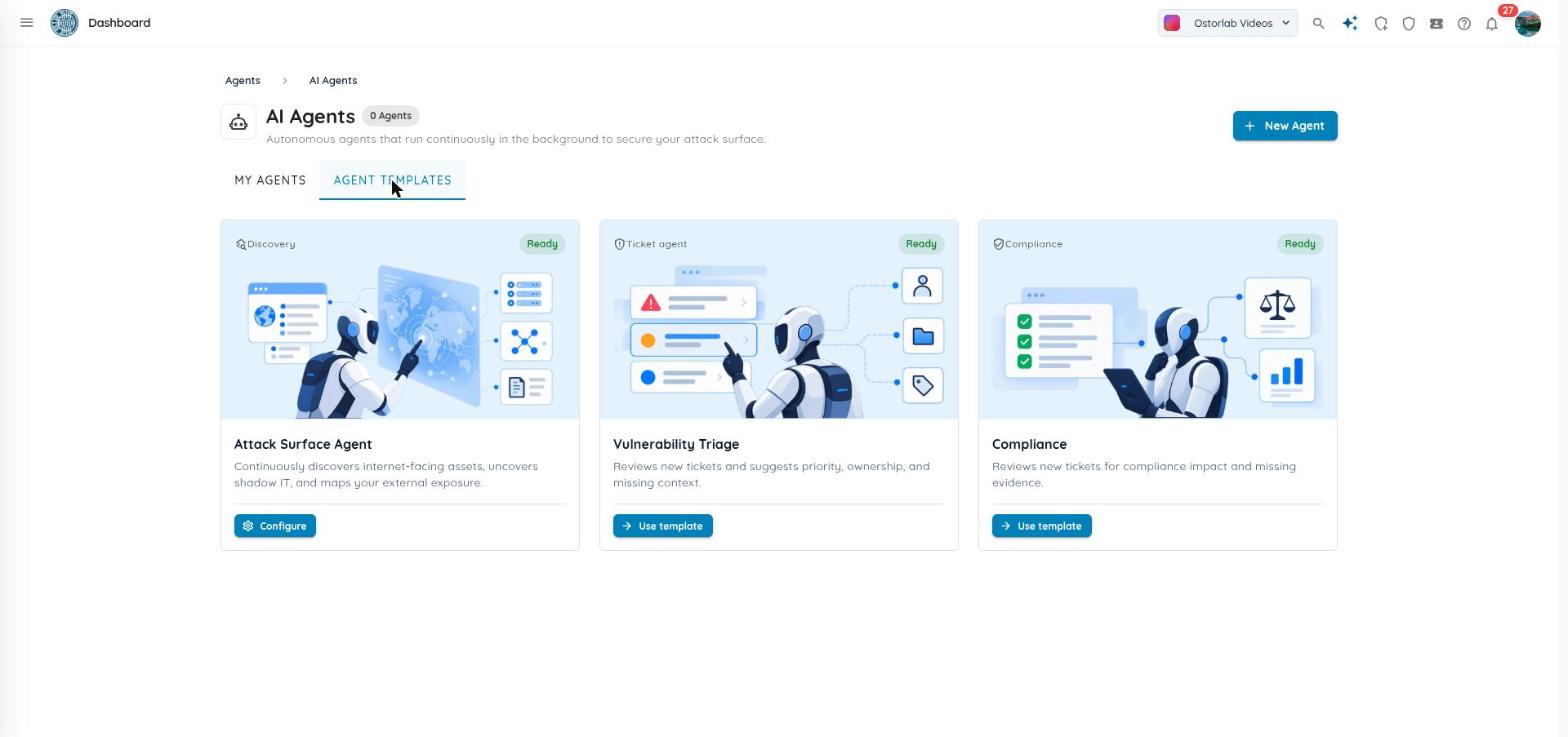
Empiece desde una plantilla. Si no quiere empezar de cero, puede usar un agente ya preparado para el triaje de vulnerabilidades o la revisión de cumplimiento normativo.
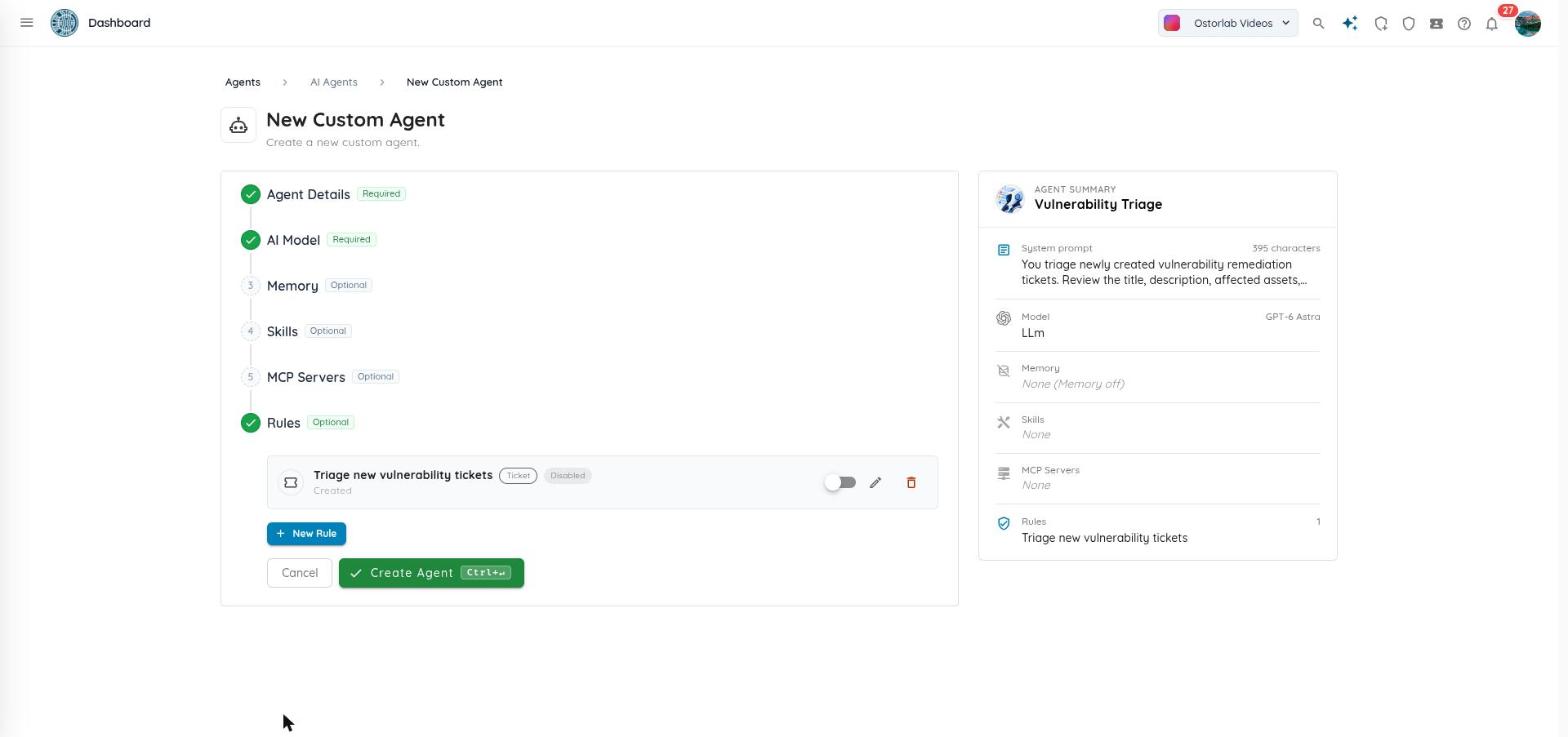
Sus reglas empiezan desactivadas, así que no se ejecuta nada hasta que usted lo indique.
Lo que el ticket agent puede hacer por su equipo
Lo creamos primero para nosotros. Ahora está listo para su equipo.
Su agente puede corregir bugs, ordenar tickets nuevos, revisar el cumplimiento normativo o hacer un seguimiento cada lunes. Usted decide su tarea, cuándo se ejecuta y qué puede tocar, y siempre es una persona quien tiene la última palabra.
Si su backlog se parece al nuestro, el ticket agent puede despejar los tickets fáciles para que su equipo se concentre en los difíciles.
Empiece en pequeño, como hicimos nosotros. Elija una plantilla, asígnele un ticket de prueba, lea lo que dice y luego decida qué darle a continuación.
Encontrará los ticket agents en Agents → AI Agents en la plataforma, y la guía completa de configuración del ticket agent cubre la configuración de principio a fin.
Preguntas frecuentes
¿Qué es el ticket agent de Ostorlab? Es un agente de IA que trabaja su backlog de tickets. Usted le asigna una tarea con palabras sencillas, elige un modelo y define reglas sobre cuándo se ejecuta. Puede corregir bugs y abrir pull requests, hacer el triaje de tickets nuevos, revisar el cumplimiento normativo o ejecutarse según una programación, y una persona siempre revisa su trabajo.
¿Cómo sabe el agente cuándo ejecutarse? Usted añade reglas. Una regla puede activarse cuando ocurre algo en un ticket (se crea, se asigna, se reabre, recibe un comentario o incumple su plazo), cuando termina un escaneo o según una programación, como todos los lunes por la mañana. Puede acotar cada regla, por ejemplo, solo a los tickets críticos o solo a los escaneos de una aplicación.
¿Puedo usar mi propio modelo de IA? Sí. Puede aportar su propia clave de proveedor de IA, o bien ejecutarlo con los modelos que proporciona Ostorlab y pagar con su saldo de créditos. Cada ejecución reserva créditos al iniciarse, y los que no utiliza se le devuelven.
¿Sustituye el agente a mis ingenieros? No. Usted asigna un ticket a un agente igual que se lo asigna a un compañero, y un ticket puede tener ambos. El agente hace la parte repetitiva y abre un pull request; una persona lo revisa y tiene la última palabra.
¿Puede conectarse a herramientas ajenas a Ostorlab? Sí. El agente puede usar servidores MCP (Model Context Protocol), ya sean remotos, locales o de Ostorlab OXO, de modo que funciona con las herramientas que su equipo ya utiliza.
¿Cómo empiezo? Elija una plantilla como Vulnerability Triage o Compliance Review, asígnele un ticket de prueba y lea lo que informa. Sus reglas empiezan desactivadas, así que no se ejecuta nada hasta que usted las active. La guía de configuración completa cubre la configuración de principio a fin.
¿Necesita ayuda para configurar su primer agente? Escriba a support@ostorlab.dev.