Nous avons créé un agent IA pour notre propre backlog. Il est maintenant à vous.
Comment un petit agent qui transformait des tickets de bug en pull requests est devenu le ticket agent d'Ostorlab : un coéquipier IA à qui vous confiez une mission, un modèle et des règles de déclenchement.
Le problème
Chez Ostorlab, nous construisons des outils qui trouvent des problèmes, dans les applications mobiles, les applications web, les API et le code. C'est notre métier, et il a un coût : chaque problème que nous trouvons devient un ticket.
Notre propre plateforme n'y échappe pas. Des erreurs apparaissent dans nos logs, des bugs sont signalés, des scans détectent des problèmes, et chacun devient un ticket. Et les tickets continuaient d'arriver.
Beaucoup n'étaient pas difficiles. Une stack trace indiquait la ligne exacte, le message d'erreur disait ce qui s'était passé, et le correctif tenait souvent en quelques lignes de code. Mais quelqu'un devait quand même interrompre ce qu'il faisait : ouvrir le ticket, le lire, trouver le code, écrire le correctif, le tester et ouvrir une pull request.
Les tickets simples attendaient donc, non parce qu'ils étaient difficiles, mais parce que tout le monde était occupé par un travail plus difficile. Un petit correctif pouvait rester des jours en attente, et le backlog grossissait. Pas à cause de problèmes difficiles, mais de problèmes faciles pour lesquels personne n'avait le temps.
L'opportunité
En regardant ces tickets de plus près, nous avons remarqué quelque chose. Beaucoup d'entre eux n'avaient pas du tout été écrits par des personnes. Ils étaient générés automatiquement à partir des logs d'erreurs et des résultats de scans, et ces sources capturent déjà les détails : le message d'erreur, la stack trace, le fichier, la ligne. Les tickets disaient déjà ce qui était cassé, où, et souvent pourquoi.
Nous avions conçu ces tickets pour donner à nos ingénieurs tout ce dont ils ont besoin pour commencer un correctif. Et ce dont un ingénieur a besoin pour commencer un correctif, nous l'avons compris, c'est aussi ce dont un agent IA a besoin. L'information était là. Ce qui manquait, c'était le temps.
Cela nous a conduits à poser une question simple : et si un agent pouvait prendre le ticket et commencer le correctif ?
Les agents de code savaient déjà lire du code, suivre une erreur et écrire un correctif. La plupart attendaient encore qu'un développeur les ouvre et saisisse un prompt. Nous voulions autre chose. Nous ne voulions pas d'un outil de plus que les ingénieurs doivent penser à utiliser ; nous voulions que le travail démarre là où il vivait déjà, dans le ticket.
Un ticket arrive, un agent le prend en charge, une pull request en ressort, et un ingénieur la relit. L'ingénieur garde le contrôle et évite simplement la partie répétitive. Et comme chaque ticket est confié à son propre agent, le travail évolue avec le backlog : autant d'agents s'exécutent en parallèle qu'il y a de tickets à traiter.
La première version
Nous avons commencé petit, volontairement. Nous avons construit un agent avec une seule mission : lire un ticket de bug et ouvrir une pull request qui le corrige.
Nous l'avons appelé Rubberduck. Tout le monde dans l'équipe n'aime pas ce nom. Il est resté quand même.
Le fonctionnement était simple. Un ingénieur assignait un ticket à Rubberduck, comme il l'aurait assigné à un coéquipier. Puis l'agent prenait le relais :
- Il lisait le ticket et ses commentaires.
- Il trouvait le bon code.
- Il déterminait ce qui n'allait pas.
- Il écrivait un correctif et ouvrait une pull request.
- Il laissait un commentaire sur le ticket avec un lien vers cette pull request.
Si un relecteur demandait une modification, il n'avait pas besoin d'un nouvel outil. Il laissait un commentaire, comme pour n'importe quel collègue, et Rubberduck le lisait et mettait son travail à jour.
C'était tout. Pas de tableau de bord, pas de paramètres : un agent, une mission. Il n'était pas parfait, mais il était suffisamment bon pour que nous le mettions au travail sur de vrais tickets.
Son utilisation en interne
Nous avons confié à Rubberduck de vrais tickets de notre propre backlog, et il a commencé à ouvrir des pull requests. Certaines étaient bonnes, d'autres non, et chaque erreur nous a appris quelque chose.
Trouver la cause, pas le symptôme. Les premiers correctifs masquaient parfois l'erreur au lieu de la résoudre. Nous avons donc appris à l'agent à travailler comme un ingénieur rigoureux : lire l'erreur, remonter à sa vraie cause, la reproduire, puis la corriger.
Écrire pour des humains. Les premiers titres de pull requests étaient souvent le simple message d'erreur copié depuis le ticket. Difficile à lire dans une longue liste. Désormais, l'agent écrit un titre court qui dit ce qu'il a corrigé.
Dire quand on ne sait pas. Parfois, un ticket ne contenait pas assez d'informations. L'agent devinait, et les suppositions donnent de mauvais correctifs. Nous lui avons appris à s'arrêter et à demander. Il peut désormais indiquer qu'un ticket est corrigé, partiellement corrigé, bloqué, ou qu'il faut plus de contexte.
Terminer le travail. Une pull request avec des tests en échec n'est pas un correctif. L'agent attend donc désormais que les vérifications passent, et corrige ce qui casse.
Suivre nos règles. Chaque équipe a sa manière d'écrire du code. Nous avons donné à l'agent nos guides de style. Nous lui avons aussi donné une mémoire, pour qu'une leçon apprise sur un ticket serve au suivant.
Garder les secrets hors de portée. L'agent a besoin d'accéder à notre code, mais il ne doit jamais voir nos mots de passe ni nos secrets. Nous les avons donc complètement sortis de sa portée : ils sont injectés à l'exécution, de sorte que l'agent peut les utiliser mais jamais les lire.
Nous avons cessé de considérer Rubberduck comme une expérience quand ses pull requests ont commencé à apparaître dans notre file de relecture à côté de celles de tout le monde. Nous les relisions de la même façon. Il était devenu un membre de l'équipe.
Une prise de conscience plus large
Une fois que Rubberduck a fonctionné, des membres de l'équipe ont commencé à en demander plus :
« Peut-il trier les nouveaux tickets selon leur urgence ? » « Peut-il vérifier nos résultats par rapport à nos règles de conformité ? » « Peut-il passer en revue les tickets ouverts chaque lundi ? »
Ces idées étaient bonnes, mais Rubberduck ne pouvait pas les réaliser. Sa mission était intégrée à sa conception : il corrigeait du code, et rien d'autre. Nous avions déjà construit un deuxième agent, qui planifiait le travail au lieu d'écrire du code, et il avait le même problème : sa mission était, elle aussi, intégrée. Nous pouvions continuer à construire un nouvel agent pour chaque nouvelle mission, mais cela n'aurait jamais de fin.
Utiliser Rubberduck ne demandait aucune configuration. Construire chaque nouvel agent, si : il fallait écrire à la main un long fichier de configuration où chaque nom devait être exact. Cela fonctionnait, mais nous sentions qu'il existait une meilleure façon de faire.
C'est alors que nous avons vu la vraie opportunité. Le problème n'a jamais été « nous avons besoin d'un agent qui corrige du code ». Le problème était « nous avons dans nos tickets du travail pour lequel personne n'a le temps », et corriger du code n'était qu'un type de ce travail.
Un agent ne devrait donc pas avoir de mission figée. Il devrait accepter la mission que lui confie une équipe, et le configurer devrait ressembler à remplir un formulaire, pas à écrire un fichier de configuration. Vous décrivez la mission avec des mots simples, vous choisissez un modèle et vous décidez quand il s'exécute.
Ce que nous avons construit
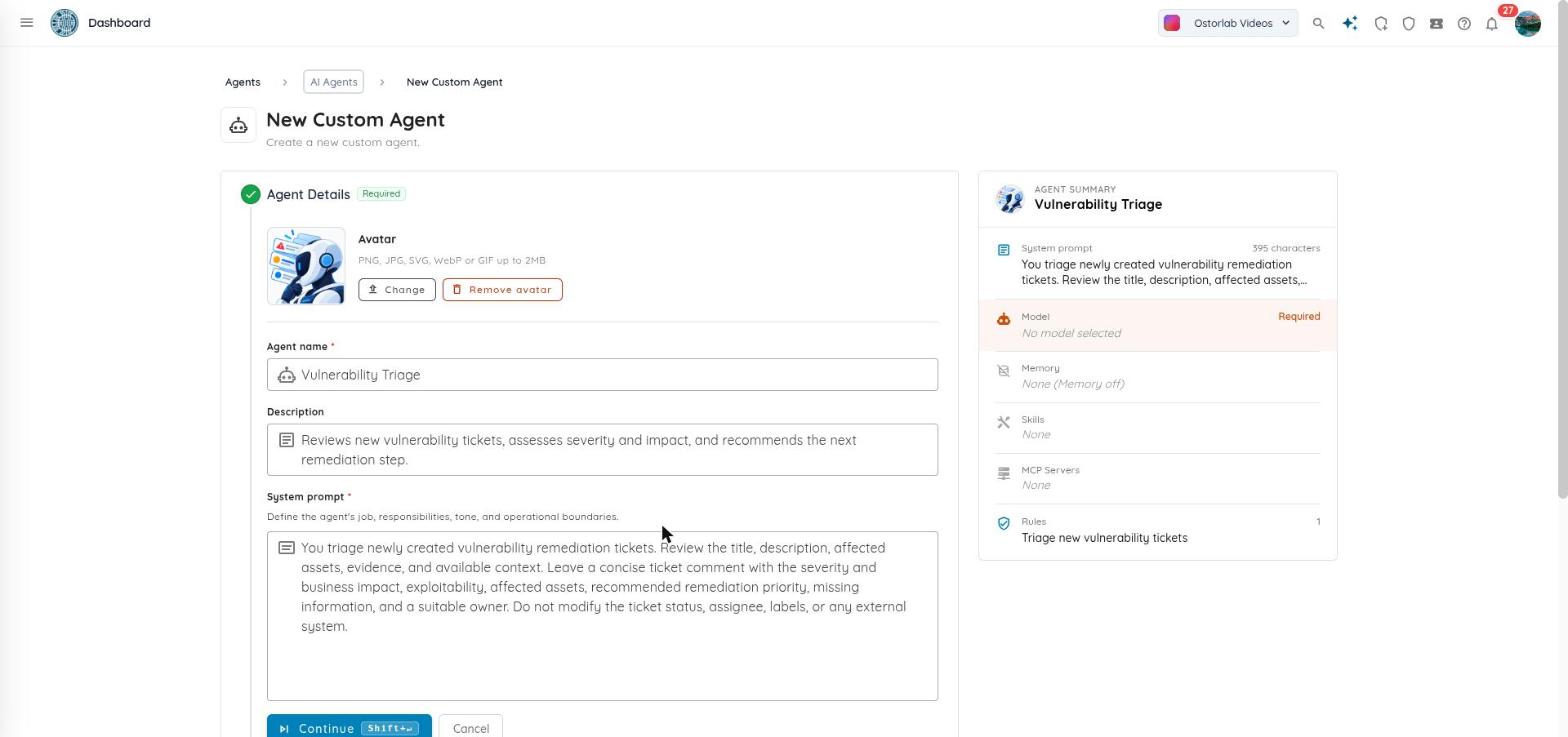
Nous avons reconstruit le ticket agent autour de cette idée. Il n'existe désormais qu'un seul type d'agent, et il n'a aucune mission tant que vous ne lui en donnez pas une. Vous le configurez dans un formulaire, en quelques étapes.
Donnez-lui un nom. Le nom que vous voulez. Choisissez bien : les noms restent. Nous le savons.
Donnez-lui une mission. Vous écrivez ce que l'agent doit faire, avec des mots simples. Vous ne savez pas par où commencer ? Notre guide de configuration vous accompagne pas à pas, avec les leçons que nous avons apprises en chemin.
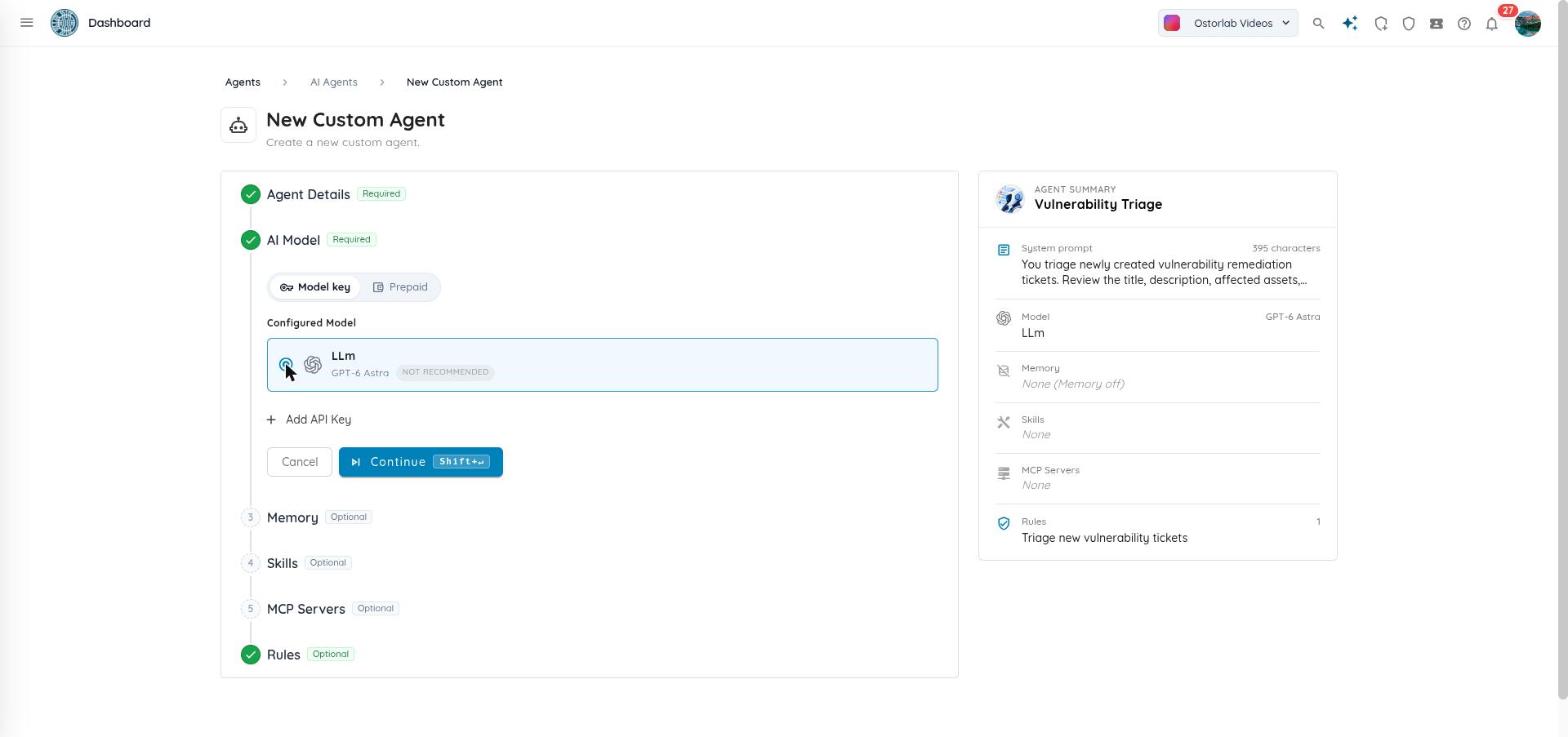
Choisissez un modèle. Vous pouvez utiliser votre propre clé de fournisseur d'IA, ou utiliser les modèles fournis par Ostorlab et payer avec votre solde de crédits. Chaque exécution réserve des crédits à son démarrage, et les crédits non utilisés vous sont restitués.
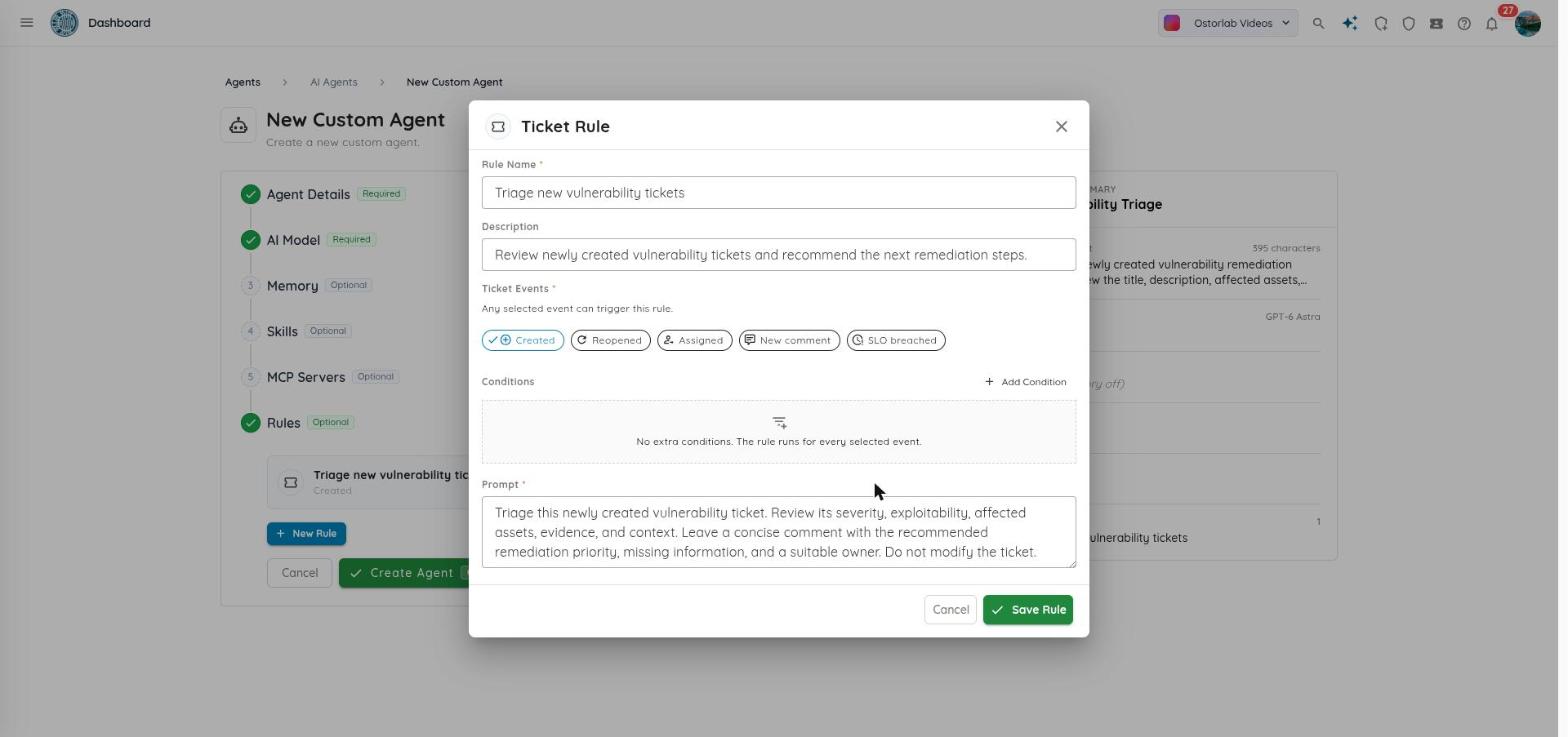
Choisissez quand il s'exécute. Vous ajoutez des règles. Une règle peut se déclencher :
- lorsqu'il se passe quelque chose sur un ticket : il est créé, assigné, rouvert, reçoit un nouveau commentaire ou dépasse son échéance,
- lorsqu'un scan se termine,
- ou selon un calendrier, par exemple chaque lundi matin.
Vous pouvez affiner chaque règle. Par exemple, uniquement les tickets critiques, ou uniquement les scans d'une application.
Apprenez-lui votre façon de travailler. Vous pouvez lui donner des skills : de courts guides qui expliquent comment votre équipe procède. Vous pouvez aussi lui donner une mémoire, pour que ce qu'il apprend sur un ticket serve au suivant.
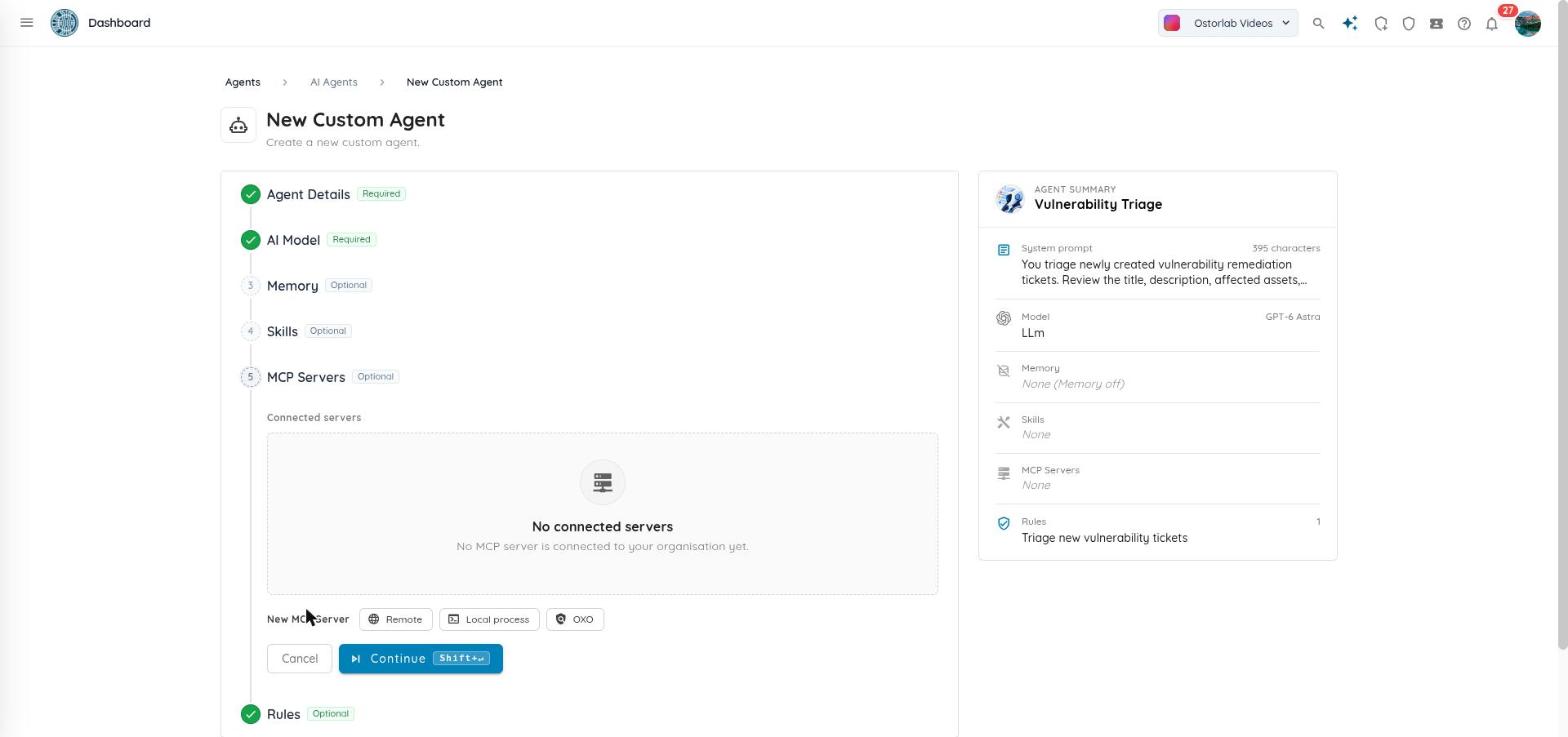
Connectez-le à vos outils. L'agent peut utiliser des serveurs MCP (Model Context Protocol), ce qui lui permet de travailler avec les outils que votre équipe utilise déjà, et pas seulement ceux d'Ostorlab.
Travaillez à côté des personnes. Vous assignez un ticket à un agent comme vous l'assigneriez à un coéquipier. Un ticket peut avoir les deux. L'agent fait sa part, et la personne garde la main.
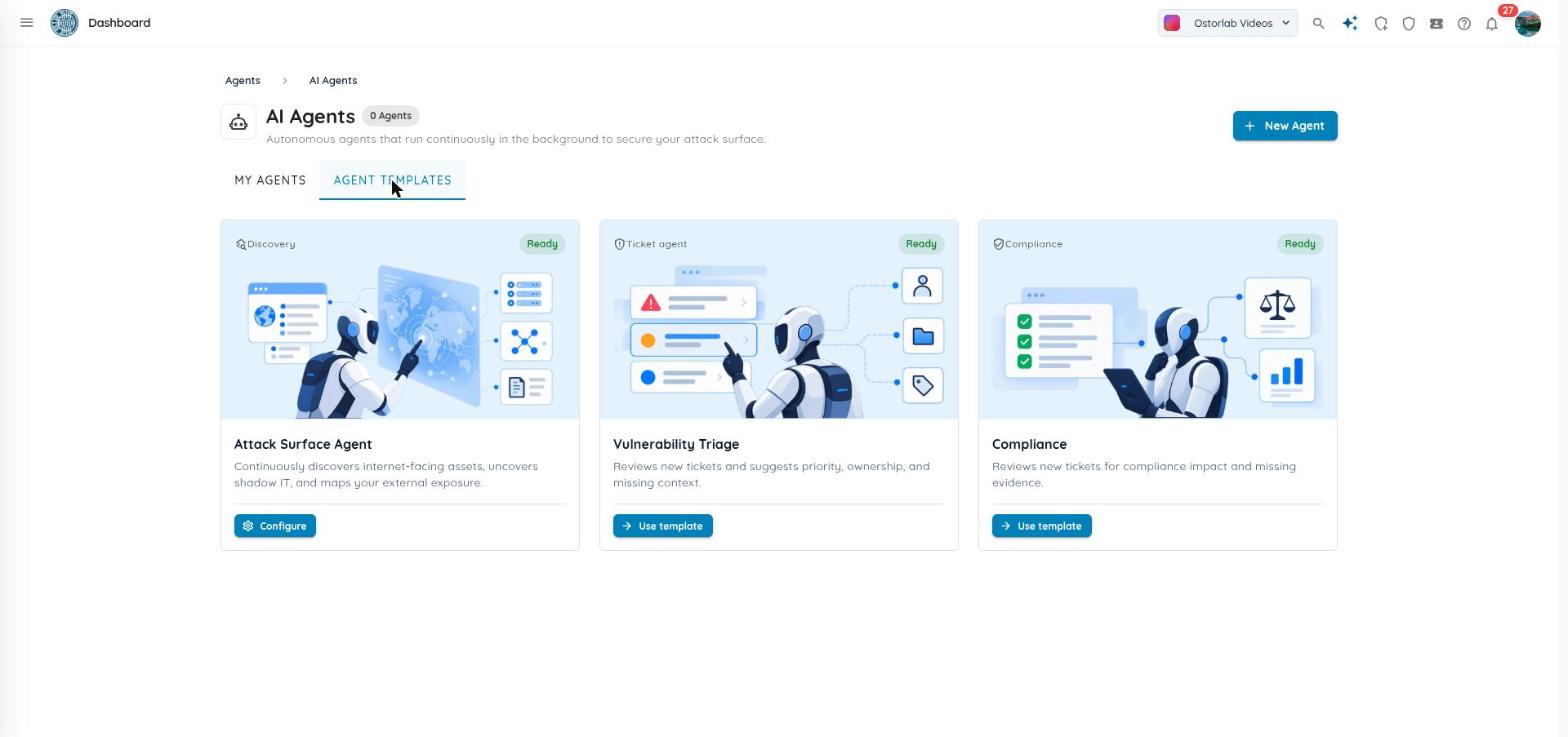
Partez d'un template. Si vous ne voulez pas partir de zéro, vous pouvez utiliser un agent prêt à l'emploi pour le tri des vulnérabilités ou la revue de conformité.
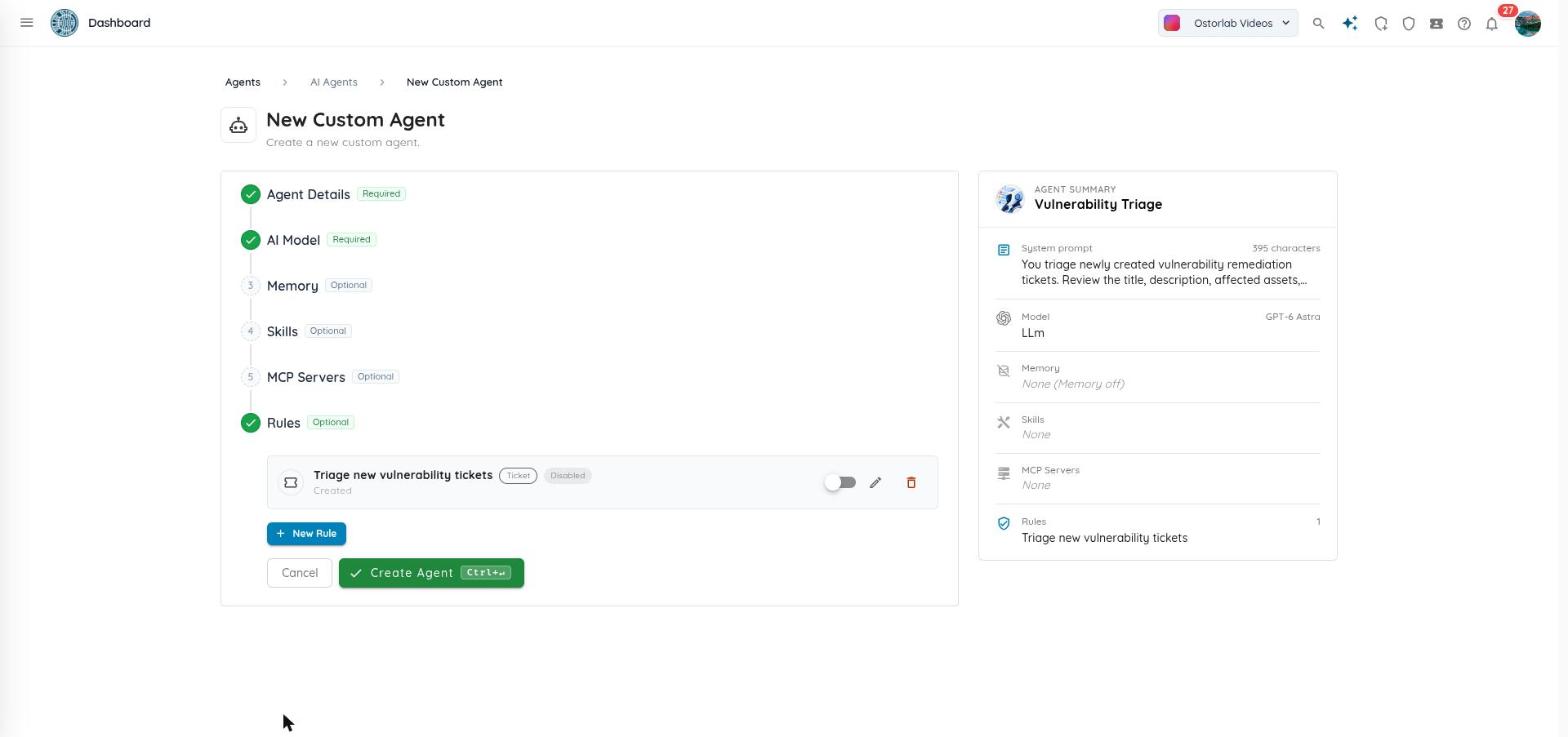
Ses règles sont désactivées au départ, donc rien ne s'exécute tant que vous ne le décidez pas.
Ce que le ticket agent peut faire pour votre équipe
Nous l'avons d'abord construit pour nous-mêmes. Il est maintenant prêt pour votre équipe.
Votre agent peut corriger des bugs, trier de nouveaux tickets, revoir la conformité ou faire le point chaque lundi. Vous décidez de sa mission, de son moment d'exécution et de ce qu'il a le droit de toucher, et une personne a toujours le dernier mot.
Si votre backlog ressemble à ce qu'était le nôtre, le ticket agent peut régler les tickets faciles pour que votre équipe reste concentrée sur les difficiles.
Commencez petit, comme nous. Choisissez un template, assignez-lui un ticket de test, lisez ce qu'il dit, puis décidez de ce que vous lui confierez ensuite.
Vous trouverez les ticket agents sous Agents → AI Agents sur la plateforme, et le guide complet de configuration du ticket agent couvre la configuration de bout en bout.
Questions fréquentes
Qu'est-ce que le ticket agent d'Ostorlab ? C'est un agent IA qui traite votre backlog de tickets. Vous lui donnez une mission avec des mots simples, vous choisissez un modèle et vous définissez des règles de déclenchement. Il peut corriger des bugs et ouvrir des pull requests, trier de nouveaux tickets, revoir la conformité ou s'exécuter selon un calendrier, et une personne relit toujours son travail.
Comment l'agent sait-il quand s'exécuter ? Vous ajoutez des règles. Une règle peut se déclencher lorsqu'il se passe quelque chose sur un ticket (il est créé, assigné, rouvert, commenté ou dépasse son échéance), lorsqu'un scan se termine, ou selon un calendrier, par exemple chaque lundi matin. Vous pouvez affiner chaque règle, par exemple pour ne viser que les tickets critiques ou que les scans d'une application.
Puis-je utiliser mon propre modèle d'IA ? Oui. Vous pouvez apporter votre propre clé de fournisseur d'IA, ou utiliser les modèles fournis par Ostorlab et payer avec votre solde de crédits. Chaque exécution réserve des crédits à son démarrage, et ceux qui ne sont pas utilisés vous sont restitués.
L'agent remplace-t-il mes ingénieurs ? Non. Vous assignez un ticket à un agent comme vous l'assigneriez à un coéquipier, et un ticket peut avoir les deux. L'agent s'occupe de la partie répétitive et ouvre une pull request ; une personne la relit et a le dernier mot.
Peut-il se connecter à des outils extérieurs à Ostorlab ? Oui. L'agent peut utiliser des serveurs MCP (Model Context Protocol), qu'ils soient distants, locaux ou Ostorlab OXO, afin de travailler avec les outils que votre équipe utilise déjà.
Comment démarrer ? Choisissez un template comme Vulnerability Triage ou Compliance Review, assignez-lui un ticket de test et lisez ce qu'il rapporte. Ses règles sont désactivées au départ, donc rien ne s'exécute tant que vous ne les activez pas. Le guide de configuration complet couvre la configuration de bout en bout.
Besoin d'aide pour configurer votre premier agent ? Écrivez à support@ostorlab.dev.