ムーンショットから本番環境へ:Ostorlab Copilotの開発
Ostorlab Copilotの実装に至るまでの当社の歩み、直面した課題、そしてその過程で得た教訓を紹介します。
ムーンショットから本番環境へ:Ostorlab Copilotの開発
エージェント型AIとは:インテリジェントな支援の新時代
エージェント型AIは、人工知能における大きな転換点です。受動的に応答するだけでなく、自律的な行動、継続的な学習、情報に基づく意思決定へと踏み出しています。こうしたAIエージェントは、構造化されたツール、コンテキストの認識、推論能力を活用し、インテリジェントで適応的な、タスクに特化した支援を提供します。
Ostorlabは早い段階からエージェント型AIの可能性に着目し、セキュリティ運用とユーザー体験を向上させるため、当社プラットフォームへの組み込みを進めてきました。
当社の目標は、AIによる自動化、ガイド付きの意思決定、対話型のサポートを実現することです。
GitHub CopilotやMicrosoft Copilotといったツールは、直感的なUI操作を通じて、AIが生産性を高めワークフローを効率化できることを示しています。これらに触発され、当社は流れるように使いやすいインターフェースを保ちながら、シームレスでインテリジェントな支援を提供するAIエージェントを開発しました。
たとえば、Ostorlabのアタックサーフェス管理を利用する組織は、数百、場合によっては数千もの潜在的なアセットを分析しなければならないことがよくあります。各アセットを手作業で確認し、所有を確定するか除外するかを判断するのは、時間がかかり骨の折れる作業です。大規模言語モデル(LLM)を活用すれば、このプロセスを自動化し、何時間もかかっていた手作業をゼロにできます。
アセットを一つずつ確認する代わりに、ユーザーは特定の条件を満たすすべてのアセットを確定するようLLMに指示するだけで済み、検証はより速く、より効率的に、そして完全に自動化されます。
Ostorlabのビジョン:AIを活用したセキュリティ支援
Ostorlab Copilotは、セキュリティやプラットフォームに関する質問に答え、組織の管理を支援し、スキャンの作成やチケットの管理といったタスクをユーザーに代わって実行する、AIを活用したアシスタントです。
大規模言語モデルと統合されたツールを活用することで、Copilotは日々の運用を処理するための効率的で使いやすいソリューションを提供し、最終的にワークフローを効率化・強化します。
この記事では、この機能を実装するまでの当社の歩み、直面した課題、そしてその過程で得た教訓を紹介します。
Moonshot Week:Copilotの誕生
Moonshot Weekは、大胆で野心的なアイデア、つまり現実離れしている、難しい、あるいは実装不可能にさえ思えるコンセプトの探求に丸1週間を充てる社内イベントです。
そうした週の一つで、複数のチームメンバーからOstorlab Copilotのアイデアが最初に提案され、彼らは協力して動作するプロトタイプを構築することにしました。
それ以前から、当社のチームはCrewAIやLangChainといったエージェント型AIフレームワークの経験を積んでいたため、この実験ではそれらを活用することを目指しました。
驚いたことに、わずか数日のうちに概念実証(PoC)が稼働しました。完全に機能するUIを構築しただけでなく、AIがドキュメントに基づいて質問に答え、プラットフォームとやり取りできるようにもなりました。Moonshotは明らかな成功でした。
有望な結果を受けて、当社はこのアイデアを推し進めることを決めました。最初のPoCは破棄され、新しい実装が一から設計されました。しかし、その先に待ち受ける課題を当社はまだ知りませんでした。管理された環境で単一の単純なタスクに対して機能したものを、効率的にスケールし、はるかに多くのユースケースをカバーできるよう再構想しなければならなかったのです。旅はまだ始まったばかりでした。
技術スタックと課題
フレームワーク:CrewAI vs. PydanticAI vs. LangChain
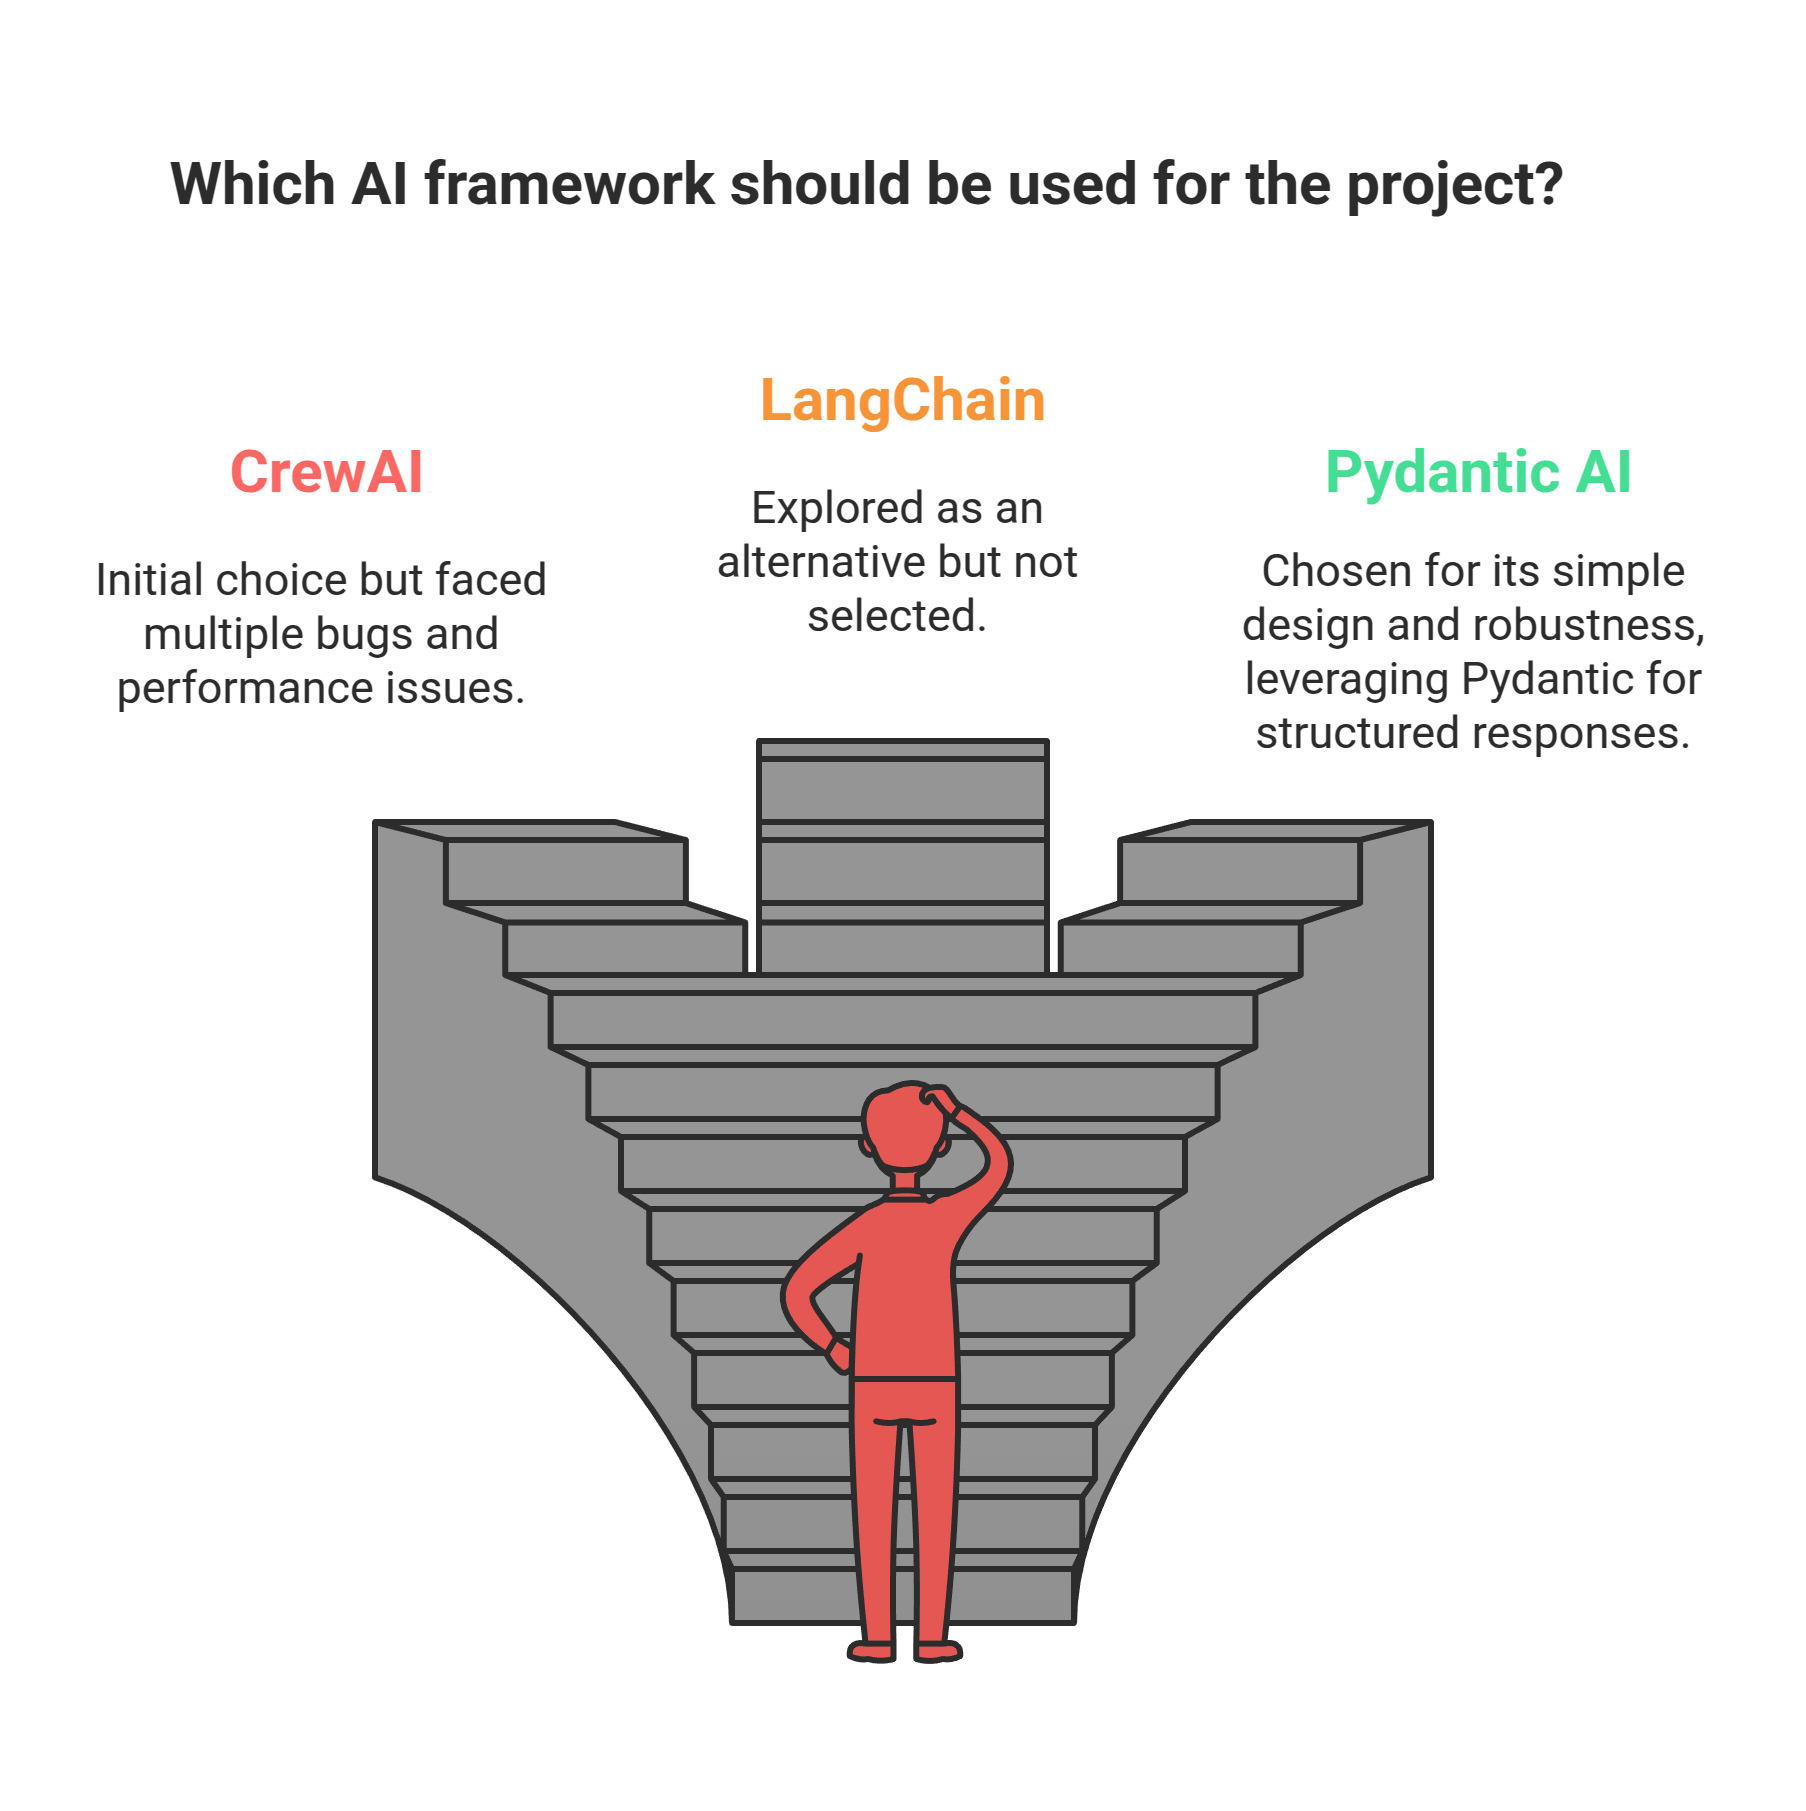
Moonshot Weekの間、最初の概念実証(PoC)はCrewAIを使って構築しました。しかし、複数のバグとパフォーマンスの問題に直面しました。そこで代替としてLangChainを検討しましたが、最終的にはシンプルさと堅牢さからPydanticAIを選びました。
PydanticAIは、当社のユースケースにとって最適な選択肢として際立っていました。LLMとやり取りする際にPydanticを活用して構造化され型付けされたレスポンスを生成し、より信頼性が高く効率的な体験を実現します。
エージェント宣言の例
from pydantic_ai import Agent

security_agent = Agent(
    'openai:gpt-4o',
    deps_type=int,
    result_type=str,
    system_prompt='Provides security insights and best practices.'
)
構造化され型付けされたレスポンスの強制
PydanticAIの大きな強みは、構造化され整形されたレスポンスを強制できることです。Pydanticのバリデーションを利用することで、エージェントは出力があらかじめ定義されたデータ型に従うことを保証し、アプリケーションでの解析や統合を容易にします。
例:Pydanticによる構造化出力
from pydantic import BaseModel
from pydantic_ai import Agent

class CityLocation(BaseModel):
    city: str
    country: str

agent = Agent('google-gla:gemini-1.5-flash', result_type=CityLocation)
result = agent.run_sync('Where were the Olympics held in 2012?')
print(result.data)
#> city='London' country='United Kingdom'
PydanticAIでのツール連携
PydanticAIの最も強力な機能の一つは、エージェントが呼び出して利用できるシンプルなPython関数であるツールを組み込めることです。ただし、この機能はモデルがツールの使用に対応しているかどうかに依存し、すべてのLLMがこの機能を備えているわけではありません。
例:ツールの定義
@security_agent.tool
def fetch_vulnerability_data(vuln_name: str) -> str:
    return f"Details for vulnerability {vuln_name}: ..."

result = security_agent.run_sync('What is SQL injection?', deps=success_number)
print(result.data)
構造化出力とツール連携を組み合わせることで、PydanticAIは、より高い信頼性と制御性を備えたAI駆動アプリケーションを構築するための堅牢なフレームワークとなります。
LLMモデルのベンチマーク
プロジェクトに取り組む間、当社は複数のLLMのベンチマークとテストを続け、何ができて何ができないかを見極めました。目指したのは、速度、品質、コストの最適なバランスを見つけることです。判断におけるもう一つの重要な要素は、LLMがJSONレスポンスとツール呼び出しの機能に対応しているかどうかでした。
1. シナリオの定義
各テストシナリオは、次の項目で綿密に定義されています。
- 一意の識別子
- 対象モデル(例:
gemini-2.0-flash-001やgpt-4o-mini) - システムプロンプト(技術的、シンプル、またはセキュリティ重視)
- ユーザープロンプト
- 期待される出力
- 評価のための類似度のしきい値
2. 実行エンジン
テストシナリオの実行、応答時間の計測、トークン使用量の追跡、そして意味的類似度の指標を用いたレスポンス品質の評価を担います。
3. 分析システム
次のような詳細な分析を提供します。
- レスポンスの正確さを測るための意味的類似度の計算
- リソース使用量を最適化するためのトークン消費量の追跡
- パフォーマンスを把握するための包括的なレポート
包括的なテスト結果
| システムプロンプト | モデル | ユーザープロンプト | 類似度 | トークン数 | コスト(USD) | 時間 |
|---|---|---|---|---|---|---|
| Ostorlabプラットフォームに特化したAIアシスタント | gemini-2.0-flash-001 | how to do an android store scan? | 0.80 | 10,904 | $0.0027 | 13.06s |
| Ostorlabプラットフォームに特化したAIアシスタント | gpt-4o-mini | how to do an IOS store scan? | 0.77 | 12,245 | $0.0046 | 14.80s |
| 的確なガイダンスを提供する技術スペシャリスト | gemini-2.0-flash-001 | how to do a web application scan? | 0.87 | 2,967 | $0.0007 | 3.33s |
| 的確なガイダンスを提供する技術スペシャリスト | gpt-4o-mini | how to do a web application scan? | 0.86 | 3,108 | $0.0012 | 16.31s |
| 平易な言葉を重視する親切なアシスタント | gemini-2.0-flash-001 | how to scan multiple websites at once? | 0.38 | 2,810 | $0.0007 | 1.96s |
| 平易な言葉を重視する親切なアシスタント | gpt-4o-mini | how to scan multiple websites at once? | 0.81 | 5,047 | $0.0019 | 10.47s |
| ベストプラクティスを重視するセキュリティ重視のアドバイザー | gemini-2.0-flash-001 | how to do an authenticated web scan? | 0.86 | 3,837 | $0.0010 | 10.24s |
| ベストプラクティスを重視するセキュリティ重視のアドバイザー | gpt-4o-mini | how to do an authenticated web scan? | 0.78 | 13,199 | $0.0050 | 24.94s |
| 的確なガイダンスを提供する技術スペシャリスト | gemini-2.0-flash-001 | list open tickets with their details | 0.72 | 6,927 | $0.0017 | 7.68s |
| 的確なガイダンスを提供する技術スペシャリスト | gpt-4o-mini | list open tickets with their details | 0.79 | 10,518 | $0.0040 | 13.65s |
| 平易な言葉を重視する親切なアシスタント | gemini-2.0-flash-001 | show me p0 tickets | 0.69 | 5,898 | $0.0015 | 4.60s |
| 平易な言葉を重視する親切なアシスタント | gpt-4o-mini | show me my P0 tickets | 0.72 | 9,602 | $0.0037 | 7.84s |
結果の分析
モデルごとのパフォーマンス特性
Gemini 2.0 Flash
- 平均応答時間:6.52s
- 平均トークン使用量:4,724
- 総コスト(USD):$0.0083
- 類似度スコアの範囲:0.38-0.87
- 最も良い結果:技術的なWebスキャン(0.87)
- 最も弱い結果:複数Webサイトのスキャンに関するシンプルなシナリオ(0.38)
GPT-4o Mini
- 平均応答時間:13.58s
- 平均トークン使用量:10,633
- 総コスト(USD):$0.0201
- 類似度スコアの範囲:0.72-0.86
- 最も良い結果:技術的なWebスキャン(0.86)
- 最も安定していた結果:ユーザーフレンドリーなシナリオ(0.72-0.81)
Gemini Flash 2.0 (Google)
Gemini Flash 2.0の使用を試みましたが、レスポンスの品質は満足のいくものではありませんでした。
Gemini Pro 2.0 Experimental (Google)
同様に、Gemini Pro 2.0 Experimental(無料)は良い結果を示しましたが、クォータの制限があり、利用が制約されます。
Mistral: Ministral 8B
Mistral: Ministral 8Bモデルは、ツールと組み合わせて使用した際にエラーが発生し、正常に実行できませんでした。
Mistral: Ministral 3B
より大きなモデルと同様に、Mistral: Ministral 3Bもツール関連の問題によりエラーが発生しました。
その他のGPTモデル
o1とo1-mini、DeepSeek、Groq LLAMA 3.3 R1 Distillも検討しましたが、これらのモデルは高価すぎる、遅すぎる、あるいはツール呼び出しや構造化されたレスポンスに対応していない、のいずれかでした。
モデル選定の方針
Geminiを使う場面
- 技術ドキュメントに関する問い合わせ:Geminiは、技術的なWebスキャンやドキュメント関連の問い合わせを素早く処理し、高い類似度スコアを示しますが、より複雑なタスクは苦手です。Pro版ははるかに優れた能力を示しましたが、まだ本番環境での利用はできません。
- 素早い応答が求められるアプリケーション:平均応答時間がより短い(6.52s)ため、Geminiは迅速な応答が重要なアプリケーションに適しています。
- リソースが限られたシナリオ:トークン使用量が少なくコスト効率が高いため、Geminiはシステムリソースや予算が限られている場合に最適です。
- セキュリティ関連のドキュメント:技術的なシナリオで最も良い結果を示したことから、Geminiは正確さが求められるセキュリティ関連のタスクやドキュメントに適しています。
GPT-4oを使う場面
- ユーザー向けのやり取り:ユーザーフレンドリーなシナリオ全体で安定しているGPT-4oは、チャットボット、カスタマーサービス、対話型AIに最適な選択肢です。
- 複雑な多段階のワークフロー:大量のトークンを扱いつつ高い類似度スコアを維持できるため、GPT-4oは複雑な多段階のタスクを確実に処理できます。
- 一貫性が求められるシナリオ:類似度スコアの範囲がより狭い(0.72-0.86)GPT-4oは、より予測しやすい出力を提供するため、一貫性が鍵となるタスクに最適です。
- 自然言語を多用するやり取り:GPT-4oは、ストーリー生成、レポート作成、詳細なユーザー向け説明など、流暢さと明快さが不可欠な自然言語処理タスクに適しています。
シンプルに始める:UIとAPIの開発
基本的な構成要素であるユーザーインターフェース(UI)とAPIに取りかかった時点で、APIの実装方法にはWebSockets、GraphQL、RESTなど、いくつかの選択肢がありました。
ストリーミングやリアルタイムメッセージングの速さから、WebSocketsが最適な選択肢に思えるかもしれません。しかし最終的に当社はGraphQLを選びました。当社プラットフォームで広く採用されており、プラットフォームや既存のインフラストラクチャに大きな変更を加えることなく、より速くリリースできたからです。
[UIのスクリーンショット]
構造化コンポーネントによるUI
視覚的に豊かでインタラクティブなレスポンスを提供するAIの能力を高めるため、構造化コンポーネントの活用を試しました。
構造化コンポーネントのコンセプトは、AIがプレーンテキストやMarkdownの回答だけでなく、表、画像、インタラクティブなコンポーネントといった構造化されたUI要素も返すというものです。当社の目標は、AIのレスポンスの明快さと使いやすさを向上させることでした。
想定していた構造化コンポーネントの例は次のとおりです。
エージェントの回答形式:
"message": {
  "components": [
    {
      "type": "Text",
      "content": "Step 1: Click the scans menu"
    },
    {
      "type": "Image",
      "url": "https://placehold.co/600x400/EEE/31343C"
    },
    {
      "type": "Text",
      "content": "Step 2: Click on 'Create a Scan'"
    },
    {
      "type": "Table",
      "data": {
        "headers": ["Name", "ID"],
        "rows": [...]
      }
    }
  ]
}
このアプローチは、グラフ、表、カスタムカードなど、AIのレスポンスに含まれる複雑な情報を表示するうえで非常に役立つはずでした。
残念ながら、gpt-4o-miniは構造化コンポーネントを返す代わりに、すべてをMarkdown形式で含んだ単一のテキストコンポーネントを使うことに一貫して落ち着いてしまいました。たとえば、次のようになります。
"message": {
"components": [
{
"type": "Text",
"content": "Step 1: Click the scans menu \n ...."
}
]
}
この制約を受けて、当社はUIの表示方法を見直し、可能な場合には構造化されたレスポンスを維持するよう努めながら、選択したモデルとの互換性を高めました。
プラットフォームとのやり取りとツール呼び出し
エージェントがプラットフォームとやり取りできるように、つまりデータを読み取ったり操作を実行したりできるように、いくつかのアプローチを検討しました。
- SQLクエリの直接実行:セキュリティと安定性への懸念から、この選択肢はすぐに却下しました。
- 既存APIの利用:妥当な選択肢ではありましたが、パフォーマンスのオーバーヘッドが生じ、当社のニーズには理想的ではありませんでした。
- カスタムツール:最終的に最善のアプローチは、既存のインフラストラクチャを活用するカスタムツールを開発することでした。この方法により、プラットフォームと効率的にやり取りでき、認可を完全に制御したまま、クエリや操作をできる限り速く実行できます。
チケットを一覧表示するツールの例:
@security_agent.tool
def list_tickets(ctx,status: str):
    return fetch_tickets_from_db(status)
ツールの戻り値の型
ツールを開発する際、出力の型にはプレーンな文字列、
辞書、Pydanticモデルといういくつかの選択肢がありました。プレーンな文字列を返すのは魅力的に思えるかもしれませんが、保守性がありません。
辞書は型付けされておらず、言語モデルはツールの出力としての辞書を理解する能力が低いことがわかっています。そのため、Pydanticモデルを使うことが明白な選択でした。
さらに、ツールを扱う際には、docstringが、そのツールが何であり、どのように機能するかをAIエージェントが理解するうえで極めて重要な役割を果たします。
非常に明確なdocstringを備え、Pydanticモデルを返すツールの例を次に示します。
class TicketType(pydantic.BaseModel):
    """Model for a single ticket"""

    id: int = pydantic.Field(None, description="Ticket identifier")
    key: str = pydantic.Field(None, description="Ticket key in org-id format")
    ...

@security_agent.tool
def list_tickets(ctx,status: str) -> list[Ticket]:
 """List tickets based on the provided filters and context.

    Retrieves ticket records matching the specified criteria. All filter parameters are optional
    and can be combined to create complex queries.

    Args:
    ...
"""
    return fetch_tickets_from_db(status)
エラーの扱い
ツールを扱う際、LLM(大規模言語モデル)が誤った引数でツールを呼び出したことをLLMに伝えたいと考えました。例外を発生させるのは現実的な解決策ではありませんでした。ワークフロー全体が失敗してしまうからです。
代わりに、文字列を使ってLLMにエラーを示し、誤りを修正するよう導くことにしました。
class TicketType(pydantic.BaseModel):
    """Model for a single ticket"""

    id: int = pydantic.Field(None, description="Ticket identifier")
    key: str = pydantic.Field(None, description="Ticket key in org-id format")
    ...

@security_agent.tool
def list_tickets(ctx,status: str) -> list[Ticket]:
 """List tickets based on the provided filters and context.

    Retrieves ticket records matching the specified criteria. All filter parameters are optional
    and can be combined to create complex queries.

    Args:
    ...
"""
    if status in ALLOWED_STATUS:
        return fetch_tickets_from_db(status)
    else:
        return f"Error: invalid status was provided, status should be one off {ALLOWED_STATUS}"
大規模なデータセットの扱い
アタックサーフェスにおける潜在的なノードのような大規模なデータセットを扱う場合、AIが関連情報を効率的に処理・取得できるようにする必要がありました。当社は、コンテキスト長を最適化し、ページネーションの仕組みを実装することでこれに対処し、モデルの上限を超えることなく膨大な量の情報を扱えるようにしました。
class TicketsType(pydantic.BaseModel):
    """Paginated tickets response type."""

    total: int
    page: int
    tickets: list[TicketType]

@security_agent.tool
def list_tickets(ctx,status: str,page:int,count:int=10) -> TicketsType:
    return fetch_tickets_from_db(status=status,count=count,page=page)
これにより、過剰なデータや不要なデータをAIエージェントに渡すことを避け、使用するLLMモデルのコンテキストウィンドウに負荷をかけすぎないようにできました。
質問に答えるためのデータ取得
プラットフォームに関するユーザーの質問に答えるCopilotの能力を高めるには、プラットフォームとそこで利用できる機能についての情報に、エージェントが何らかの形でアクセスできるようにする必要があります。幸い当社では、すべての機能とその使い方を文書化する作業がすでに済んでいました。それが当社のドキュメントです。
FAISSを使ってドキュメント全体をインデックス化し、ユーザーの質問に関連する詳細をエージェントが検索するためのツールとして提供しました。
当初は、モデルが視覚的に豊かなレスポンスを生成できるよう、Markdownのドキュメントと一緒に画像や動画もインデックス化することにしました。このアプローチは一部のケースではうまく機能しましたが、ハルシネーションも引き起こしました。さらに調査したところ、画像や動画には十分なテキストのコンテキストが欠けており、それがエージェントを混乱させ、不正確なレスポンスにつながっていることがわかりました。最終的に、テキストベースのインデックス化のみを優先し、必要な場合に限って視覚的な要素を選択的に取り入れることにしました。
コンテキストを認識するエージェント
ユーザーがプラットフォームを操作しているとき、エージェントはユーザーがどのデータを見ているのか、そしてユーザーが何を見ているのかを正確に把握する必要があります。たとえば、ユーザーがチケットのページにいる場合、AIエージェントはユーザーがどこにいて何を見ているのかを認識している必要があります。
当社はUIを更新し、エージェントにメッセージを送信するたびに、ユーザーのPOCを表すコンテキストオブジェクトを付加するようにしました。
{
  "question": "What this ticket is about?",
  "context": {
    "page": "/remediation/tickets/os-11638",
    "ticketKey": "os-11638"
  }
}
セキュリティ上の影響
AIエージェントがユーザーの権限の範囲内で動作するよう、すべてのツールに厳格な認可制御を実装しました。各ツールは、リクエストしたユーザーと同じレベルのアクセス権と権限で実行され、認可されていない操作を防ぎます。
Pythonのデコレーターを使い、必要な権限を持つユーザーだけがツールを呼び出せるようにしました。
@permissions.require_permission(PermissionAction.READ)
@security_agent.tool
def list_tickets(ctx, status: str) -> list:
    return fetch_tickets_from_db(status)
エージェントのツールは、まったく新しいカテゴリの入力インジェクションベクトルも生み出します。これらはテストと自動化が必要でしたが、その話はまた別の機会に 🙂。
まとめ
Ostorlab Copilot AIエージェントの実装は、刺激的でやりがいのある道のりでした。ただし、これで終わりではありません。改善されたUI、推論、高度なバックグラウンドでのやり取りなど、すでに数多くの新しい機能の追加に取り組んでいます。
フレームワーク、モデル、連携方法を慎重に選ぶことで、当社はユーザー体験を向上させる、強力で効率的なアシスタントを作り上げました。
構造化UIによるレスポンスやモデルの一貫性のなさといった課題は残っていますが、反復的なアプローチによって、Copilotの能力を継続的に改善していくことができます。
謝辞
Ostorlab Copilotプロジェクトに精力的に取り組んでくれた、以下の貢献者の皆さんに心から感謝します。
- Adnane Serrar
- Anas Zouiten
- Mohamed El Yousfi
- Mouhcine Narhmouche
- Othmane Hachim
- Rabson Phiri
彼らの献身と専門知識は、このプロジェクトを実現するうえでかけがえのないものでした。