Du moonshot à la production : construire Ostorlab Copilot
Cet article retrace notre parcours dans la mise en œuvre d'Ostorlab Copilot, les défis rencontrés et les leçons que nous en avons tirées.
Du moonshot à la production : construire Ostorlab Copilot
Qu'est-ce que l'IA agentique ? Une nouvelle ère d'assistance intelligente
L'IA agentique marque une transformation majeure de l'intelligence artificielle : elle dépasse les réponses passives pour passer à l'action autonome, à l'apprentissage continu et à la prise de décision éclairée. Ces agents IA s'appuient sur des outils structurés, la connaissance du contexte et des capacités de raisonnement pour fournir une assistance intelligente, adaptative et spécifique à chaque tâche.
Chez Ostorlab, nous avons reconnu très tôt le potentiel de l'IA agentique et nous l'intégrons à notre plateforme pour améliorer les opérations de sécurité et l'expérience utilisateur.
Notre objectif est de permettre l'automatisation pilotée par l'IA, la prise de décision guidée et une assistance interactive.
Inspirés par des outils comme GitHub Copilot et Microsoft Copilot, qui montrent tous deux comment l'IA peut accroître la productivité et fluidifier les workflows grâce à des interactions intuitives dans l'interface, nous avons développé des agents IA qui offrent une assistance fluide et intelligente tout en conservant une interface agréable et conviviale.
Par exemple, avec la gestion de la surface d'attaque d'Ostorlab, les organisations doivent souvent analyser des centaines, voire des milliers d'actifs potentiels. Vérifier manuellement chaque actif pour confirmer ou écarter sa propriété est long et fastidieux. En s'appuyant sur un grand modèle de langage (LLM), nous pouvons automatiser ce processus et ramener des heures de travail manuel à zéro.
Au lieu d'examiner les actifs un par un, les utilisateurs peuvent simplement demander au LLM de confirmer tous les actifs qui répondent à des critères précis, ce qui rend la validation plus rapide, plus efficace et entièrement automatisée.
La vision d'Ostorlab : une assistance à la sécurité propulsée par l'IA
Ostorlab Copilot est un assistant piloté par l'IA, conçu pour répondre aux questions de sécurité et à celles relatives à la plateforme, aider à gérer votre organisation et exécuter des tâches en votre nom, comme créer des scans et gérer des tickets.
En s'appuyant sur de grands modèles de langage et des outils intégrés, Copilot offre une solution efficace et conviviale pour gérer les opérations quotidiennes, ce qui simplifie et améliore au final votre workflow.
Cet article retrace notre parcours dans la mise en œuvre de cette fonctionnalité, les défis rencontrés et les leçons que nous en avons tirées.
Moonshot Week : la genèse de Copilot
La Moonshot Week est un événement interne durant lequel nous consacrons une semaine entière à explorer des idées audacieuses et ambitieuses, des concepts qui peuvent sembler farfelus, difficiles, voire impossibles à réaliser.
Au cours de l'une de ces semaines, l'idée d'Ostorlab Copilot a d'abord été suggérée par plusieurs membres de l'équipe, qui ont décidé de collaborer pour construire un prototype fonctionnel.
Auparavant, notre équipe avait déjà acquis de l'expérience avec des frameworks d'IA agentique comme CrewAI et LangChain, et nous avons donc décidé de les utiliser pour cette expérimentation.
À notre grande surprise, en quelques jours seulement, nous disposions d'une preuve de concept (PoC) opérationnelle. Non seulement nous avions construit une interface entièrement fonctionnelle, mais nous avions aussi permis à l'IA de répondre à des questions à partir de la documentation et d'interagir avec la plateforme. Le Moonshot était un succès évident.
Face à ces résultats prometteurs, nous avons décidé de poursuivre l'idée. La PoC initiale a été abandonnée et une nouvelle implémentation a été conçue de zéro. Mais nous étions loin de nous douter des défis qui nous attendaient : ce qui fonctionnait pour une tâche unique et simple dans un environnement contrôlé devait être repensé pour passer à l'échelle efficacement et couvrir bien plus de cas d'usage. Le voyage ne faisait que commencer.
Stack technique et défis
Frameworks : CrewAI vs. PydanticAI vs. LangChain
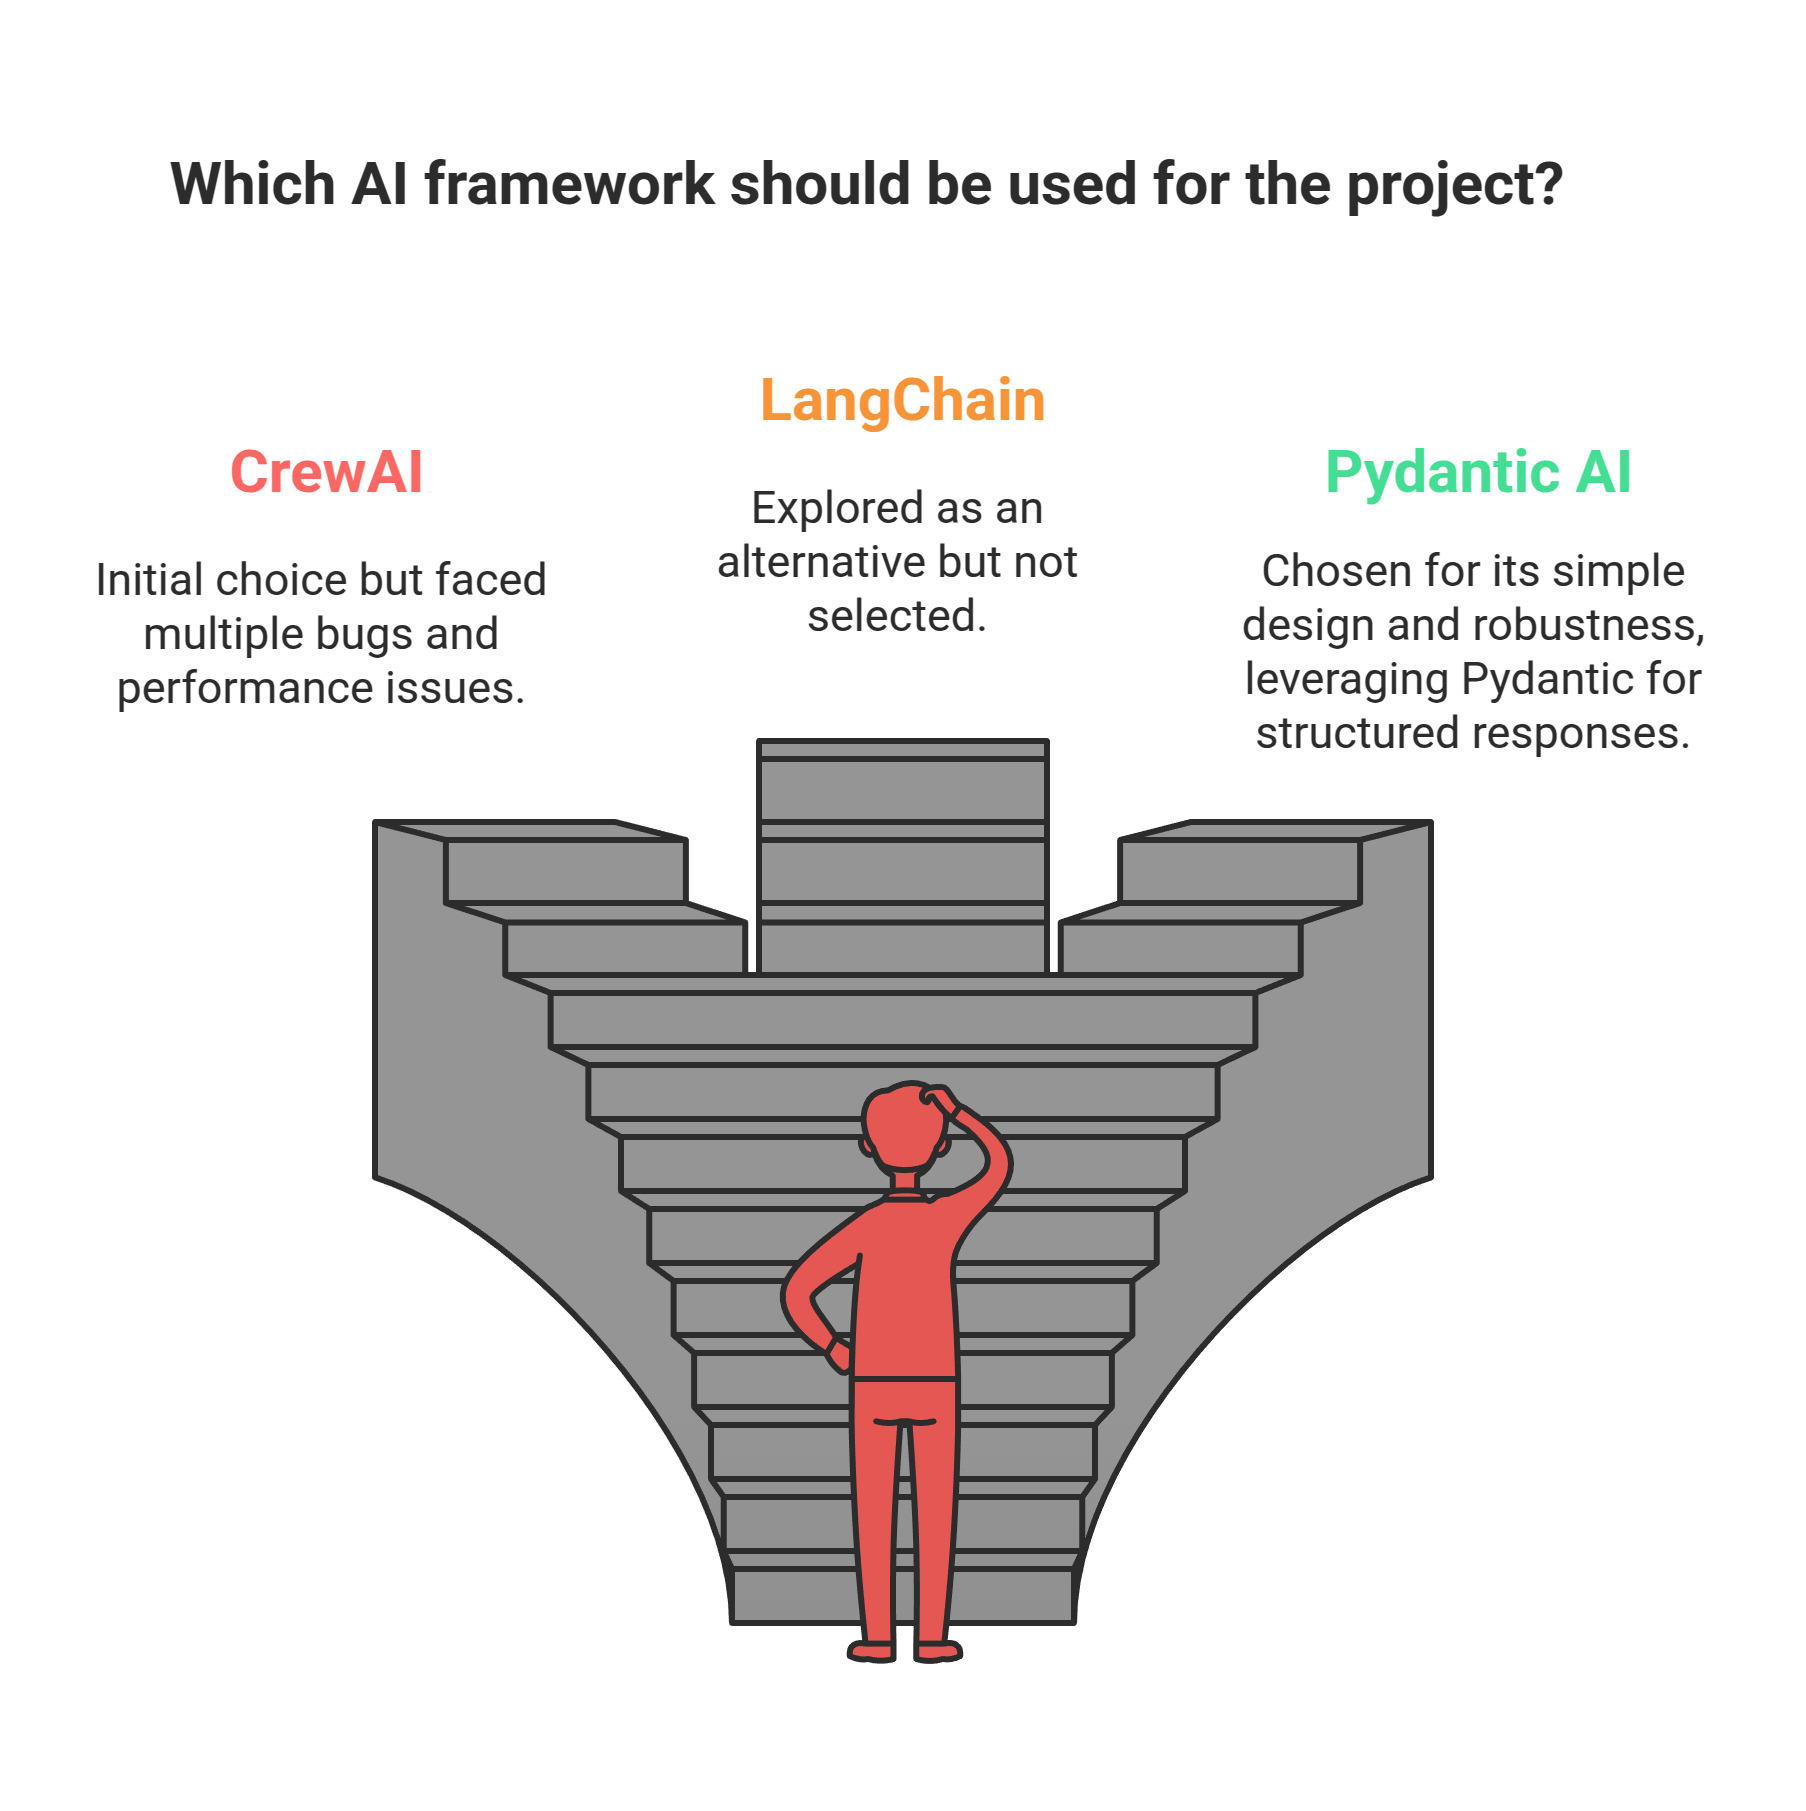
Pendant la Moonshot Week, notre preuve de concept (PoC) initiale a été construite avec CrewAI. Nous avons toutefois rencontré de nombreux bugs et problèmes de performance. Nous avons ensuite exploré LangChain comme alternative, mais avons finalement choisi PydanticAI pour sa simplicité et sa robustesse.
PydanticAI s'est imposé comme le meilleur choix pour notre cas d'usage. Il s'appuie sur Pydantic pour générer des réponses structurées et typées lors de l'interaction avec le LLM, ce qui garantit une expérience plus fiable et plus efficace.
Exemple de déclaration d'agent
from pydantic_ai import Agent

security_agent = Agent(
    'openai:gpt-4o',
    deps_type=int,
    result_type=str,
    system_prompt='Provides security insights and best practices.'
)
Imposer des réponses structurées et typées
Un point fort de PydanticAI est sa capacité à imposer des réponses structurées et formatées. En utilisant la validation de Pydantic, l'agent garantit que les sorties respectent des types de données prédéfinis, ce qui les rend plus faciles à analyser et à intégrer dans des applications.
Exemple : sortie structurée avec Pydantic
from pydantic import BaseModel
from pydantic_ai import Agent

class CityLocation(BaseModel):
    city: str
    country: str

agent = Agent('google-gla:gemini-1.5-flash', result_type=CityLocation)
result = agent.run_sync('Where were the Olympics held in 2012?')
print(result.data)
#> city='London' country='United Kingdom'
Intégration d'outils dans PydanticAI
L'une des fonctionnalités les plus puissantes de PydanticAI est sa capacité à intégrer des outils, de simples fonctions Python que l'agent peut appeler et utiliser. Toutefois, cette fonctionnalité dépend de la capacité du modèle à prendre en charge l'utilisation d'outils, et tous les LLM ne proposent pas cette fonction.
Exemple : définir un outil
@security_agent.tool
def fetch_vulnerability_data(vuln_name: str) -> str:
    return f"Details for vulnerability {vuln_name}: ..."

result = security_agent.run_sync('What is SQL injection?', deps=success_number)
print(result.data)
En combinant sorties structurées et intégration d'outils, PydanticAI offre un framework robuste pour construire des applications pilotées par l'IA avec plus de fiabilité et de contrôle.
Benchmark des modèles LLM
Tout au long du projet, nous avons continué à comparer et tester plusieurs LLM pour déterminer ce que nous pouvions et ne pouvions pas faire. Nous cherchions le meilleur équilibre entre vitesse, qualité et coût. Un autre facteur clé de notre décision était la capacité d'un LLM à prendre en charge les réponses JSON et l'appel d'outils.
1. Définition des scénarios
Chaque scénario de test est défini avec soin par :
- Un identifiant unique
- Le modèle cible (par exemple
gemini-2.0-flash-001ougpt-4o-mini) - Le prompt système (technique, simple ou axé sur la sécurité)
- Le prompt utilisateur
- La sortie attendue
- Un seuil de similarité pour l'évaluation
2. Moteur d'exécution
Il est chargé d'exécuter les scénarios de test, de mesurer le temps de réponse, de suivre l'utilisation des tokens et d'évaluer la qualité des réponses à l'aide de métriques de similarité sémantique.
3. Système d'analyse
Il fournit une analyse approfondie, notamment :
- Des calculs de similarité sémantique pour évaluer l'exactitude des réponses
- Un suivi de la consommation de tokens pour optimiser l'utilisation des ressources
- Des rapports complets pour mesurer les performances
Résultats complets des tests
| Prompt système | Modèle | Prompt utilisateur | Similarité | Nombre de tokens | Coût (USD) | Durée |
|---|---|---|---|---|---|---|
| Assistant IA spécialisé dans la plateforme Ostorlab | gemini-2.0-flash-001 | how to do an android store scan? | 0.80 | 10,904 | $0.0027 | 13.06s |
| Assistant IA spécialisé dans la plateforme Ostorlab | gpt-4o-mini | how to do an IOS store scan? | 0.77 | 12,245 | $0.0046 | 14.80s |
| Spécialiste technique fournissant des conseils précis | gemini-2.0-flash-001 | how to do a web application scan? | 0.87 | 2,967 | $0.0007 | 3.33s |
| Spécialiste technique fournissant des conseils précis | gpt-4o-mini | how to do a web application scan? | 0.86 | 3,108 | $0.0012 | 16.31s |
| Assistant serviable axé sur un langage simple | gemini-2.0-flash-001 | how to scan multiple websites at once? | 0.38 | 2,810 | $0.0007 | 1.96s |
| Assistant serviable axé sur un langage simple | gpt-4o-mini | how to scan multiple websites at once? | 0.81 | 5,047 | $0.0019 | 10.47s |
| Conseiller axé sur la sécurité, privilégiant les bonnes pratiques | gemini-2.0-flash-001 | how to do an authenticated web scan? | 0.86 | 3,837 | $0.0010 | 10.24s |
| Conseiller axé sur la sécurité, privilégiant les bonnes pratiques | gpt-4o-mini | how to do an authenticated web scan? | 0.78 | 13,199 | $0.0050 | 24.94s |
| Spécialiste technique fournissant des conseils précis | gemini-2.0-flash-001 | list open tickets with their details | 0.72 | 6,927 | $0.0017 | 7.68s |
| Spécialiste technique fournissant des conseils précis | gpt-4o-mini | list open tickets with their details | 0.79 | 10,518 | $0.0040 | 13.65s |
| Assistant serviable axé sur un langage simple | gemini-2.0-flash-001 | show me p0 tickets | 0.69 | 5,898 | $0.0015 | 4.60s |
| Assistant serviable axé sur un langage simple | gpt-4o-mini | show me my P0 tickets | 0.72 | 9,602 | $0.0037 | 7.84s |
Analyse des résultats
Caractéristiques de performance des modèles
Gemini 2.0 Flash
- Temps de réponse moyen : 6.52s
- Utilisation moyenne de tokens : 4,724
- Coût total (USD) : $0.0083
- Plage du score de similarité : 0.38-0.87
- Meilleure performance : scans web techniques (0.87)
- Performance la plus faible : scan simple de plusieurs sites web (0.38)
GPT-4o Mini
- Temps de réponse moyen : 13.58s
- Utilisation moyenne de tokens : 10,633
- Coût total (USD) : $0.0201
- Plage du score de similarité : 0.72-0.86
- Meilleure performance : scans web techniques (0.86)
- Le plus constant : scénarios conviviaux pour l'utilisateur (0.72-0.81)
Gemini Flash 2.0 (Google)
Nous avons tenté d'utiliser Gemini Flash 2.0, mais la qualité des réponses n'était pas satisfaisante.
Gemini Pro 2.0 Experimental (Google)
De même, Gemini Pro 2.0 Experimental (gratuit) a donné de bons résultats, mais il est limité par un quota qui restreint son utilisation.
Mistral: Ministral 8B
Le modèle Mistral: Ministral 8B a rencontré des erreurs lorsqu'il était utilisé avec les outils, ce qui a empêché toute exécution réussie.
Mistral: Ministral 3B
Comme son grand frère, Mistral: Ministral 3B a lui aussi généré des erreurs à cause de problèmes liés aux outils.
Autres modèles GPT
Nous avons également exploré o1 et o1-mini, DeepSeek et Groq LLAMA 3.3 R1 Distill, mais ces modèles étaient soit trop chers, soit trop lents, soit ne prenaient pas en charge l'appel d'outils ou les réponses structurées.
Stratégie de sélection des modèles
Utiliser Gemini pour
- Les requêtes sur la documentation technique : Gemini excelle à traiter rapidement les scans web techniques et les requêtes liées à la documentation avec des scores de similarité élevés, mais peine sur les tâches plus complexes. La version Pro a montré de bien meilleures capacités mais n'est pas encore disponible pour un usage en production.
- Les applications à réponse rapide : Avec un temps de réponse moyen plus court (6.52s), Gemini convient aux applications où la rapidité des réponses est essentielle.
- Les scénarios à ressources limitées : Grâce à sa moindre utilisation de tokens et à son efficacité en coût, Gemini est idéal lorsque les ressources système ou les budgets sont limités.
- La documentation axée sur la sécurité : Les meilleures performances de Gemini dans les scénarios techniques en font un bon choix pour les tâches liées à la sécurité ou pour la documentation qui exige de la précision.
Utiliser GPT-4o pour
- Les interactions destinées aux utilisateurs : La constance de GPT-4o dans les scénarios conviviaux en fait un excellent choix pour les chatbots, le service client ou l'IA conversationnelle.
- Les workflows complexes en plusieurs étapes : Sa capacité à gérer une forte utilisation de tokens et à maintenir des scores de similarité élevés permet à GPT-4o de gérer de manière fiable des tâches complexes en plusieurs étapes.
- Les scénarios exigeant de la constance : Avec une plage de scores de similarité plus étroite (0.72-0.86), GPT-4o fournit des sorties plus prévisibles, ce qui le rend idéal pour les tâches où la constance est essentielle.
- Les interactions riches en langage naturel : GPT-4o est bien adapté aux tâches de traitement du langage naturel comme la génération d'histoires, la rédaction de rapports ou les instructions détaillées pour l'utilisateur, où la fluidité et la clarté sont essentielles.
Commencer simple : développement de l'interface et de l'API
Lorsque nous avons commencé à travailler sur les briques fondamentales, l'interface utilisateur (UI) et l'API, nous avions plusieurs options pour implémenter l'API, notamment WebSockets, GraphQL et REST.
Si les WebSockets peuvent sembler la meilleure option grâce à leur rapidité pour le streaming et la messagerie en temps réel, nous avons finalement choisi GraphQL, car il était largement adopté dans notre plateforme et nous permettait de livrer plus vite, sans changement significatif de la plateforme ni de l'infrastructure existante.
[Capture d'écran de l'interface]
Interface à composants structurés
Nous avons expérimenté l'utilisation de composants structurés pour améliorer la capacité de l'IA à fournir des réponses visuellement riches et interactives.
Le concept de composants structurés consiste à faire renvoyer par l'IA non seulement du texte brut ou des réponses en markdown, mais aussi des éléments d'interface structurés comme des tableaux, des images et des composants interactifs. Notre objectif était d'améliorer la clarté et la facilité d'utilisation des réponses de l'IA.
Voici un exemple des composants structurés attendus :
Format de réponse de l'agent :
"message": {
  "components": [
    {
      "type": "Text",
      "content": "Step 1: Click the scans menu"
    },
    {
      "type": "Image",
      "url": "https://placehold.co/600x400/EEE/31343C"
    },
    {
      "type": "Text",
      "content": "Step 2: Click on 'Create a Scan'"
    },
    {
      "type": "Table",
      "data": {
        "headers": ["Name", "ID"],
        "rows": [...]
      }
    }
  ]
}
Cette approche serait extrêmement utile pour afficher des informations complexes issues des réponses de l'IA, comme des graphiques, des tableaux et des cartes personnalisées.
Malheureusement, gpt-4o-mini retombait systématiquement sur un unique composant texte contenant tout en format markdown, au lieu de renvoyer des composants structurés. Par exemple :
"message": {
"components": [
{
"type": "Text",
"content": "Step 1: Click the scans menu \n ...."
}
]
}
Cette limitation nous a poussés à adapter notre approche du rendu de l'interface, afin d'assurer une meilleure compatibilité avec le modèle retenu tout en cherchant à conserver des réponses structurées lorsque c'est possible.
Interactions avec la plateforme et appel d'outils
Pour permettre à l'agent d'interagir avec la plateforme, par exemple pour lire des données ou effectuer des actions, nous avons envisagé plusieurs approches :
- Requêtes SQL directes : Cette option a été rapidement écartée en raison de préoccupations de sécurité et de stabilité.
- Utilisation des API existantes : Bien que ce soit un choix raisonnable, elle introduisait une surcharge de performance qui ne convenait pas à nos besoins.
- Outils personnalisés : Finalement, la meilleure approche a été de développer des outils personnalisés qui s'appuient sur notre infrastructure existante. Cette méthode nous permet d'interagir efficacement avec la plateforme et d'exécuter des requêtes et des actions aussi rapidement que possible, tout en gardant un contrôle total sur les autorisations.
Exemple d'outil pour lister les tickets :
@security_agent.tool
def list_tickets(ctx,status: str):
    return fetch_tickets_from_db(status)
Type de retour des outils.
En développant les outils, nous avions plusieurs options pour le type de sortie qu'ils devaient fournir : des chaînes simples,
des dicts ou des modèles Pydantic. Si renvoyer de simples chaînes peut sembler séduisant, elles ne sont pas maintenables.
Les dictionnaires ne sont pas typés, et les modèles de langage se sont montrés peu aptes à les comprendre comme sorties d'outils. Le choix évident a donc été d'utiliser des modèles Pydantic.
De plus, lorsqu'on travaille avec des outils, la docstring joue un rôle crucial pour aider l'agent IA à comprendre ce qu'est l'outil et comment il fonctionne.
Voici un exemple d'outil qui renvoie un modèle Pydantic avec une docstring très claire :
class TicketType(pydantic.BaseModel):
    """Model for a single ticket"""

    id: int = pydantic.Field(None, description="Ticket identifier")
    key: str = pydantic.Field(None, description="Ticket key in org-id format")
    ...

@security_agent.tool
def list_tickets(ctx,status: str) -> list[Ticket]:
 """List tickets based on the provided filters and context.

    Retrieves ticket records matching the specified criteria. All filter parameters are optional
    and can be combined to create complex queries.

    Args:
    ...
"""
    return fetch_tickets_from_db(status)
Gestion des erreurs
En travaillant avec les outils, nous voulions informer le LLM (grand modèle de langage) qu'il avait appelé les outils avec des arguments incorrects. Lever des exceptions n'était pas une solution viable, car cela ferait échouer l'ensemble du workflow.
Nous avons donc décidé d'utiliser des chaînes de caractères pour signaler les erreurs au LLM, afin de le guider pour qu'il corrige ses erreurs.
class TicketType(pydantic.BaseModel):
    """Model for a single ticket"""

    id: int = pydantic.Field(None, description="Ticket identifier")
    key: str = pydantic.Field(None, description="Ticket key in org-id format")
    ...

@security_agent.tool
def list_tickets(ctx,status: str) -> list[Ticket]:
 """List tickets based on the provided filters and context.

    Retrieves ticket records matching the specified criteria. All filter parameters are optional
    and can be combined to create complex queries.

    Args:
    ...
"""
    if status in ALLOWED_STATUS:
        return fetch_tickets_from_db(status)
    else:
        return f"Error: invalid status was provided, status should be one off {ALLOWED_STATUS}"
Gestion des grands jeux de données
Lorsqu'on traite de grands ensembles de données, comme les nœuds potentiels d'une surface d'attaque, nous devions nous assurer que l'IA pouvait traiter efficacement les informations pertinentes et les récupérer. Nous y sommes parvenus en optimisant la longueur du contexte et en mettant en place des mécanismes de pagination pour gérer de vastes volumes d'informations sans dépasser les limites du modèle.
class TicketsType(pydantic.BaseModel):
    """Paginated tickets response type."""

    total: int
    page: int
    tickets: list[TicketType]

@security_agent.tool
def list_tickets(ctx,status: str,page:int,count:int=10) -> TicketsType:
    return fetch_tickets_from_db(status=status,count=count,page=page)
Cela nous a permis d'éviter de transmettre trop de données, ou des données inutiles, à l'agent IA et de ne pas saturer la fenêtre de contexte du modèle LLM utilisé.
Récupération de données pour répondre aux questions
Pour améliorer la capacité de Copilot à répondre aux questions des utilisateurs relatives à la plateforme, nous devons d'une manière ou d'une autre permettre à l'agent d'accéder aux informations sur la plateforme et sur les fonctionnalités disponibles. Heureusement, nous avions déjà fait le travail de documenter toutes les fonctionnalités et leur mode d'emploi : c'est notre documentation.
Nous avons utilisé FAISS pour indexer l'intégralité de notre documentation et l'avons fournie comme outil à l'agent, afin qu'il y recherche des détails liés aux questions des utilisateurs.
Au départ, nous avions décidé d'indexer les images et les vidéos en plus de la documentation Markdown afin que le modèle puisse générer des réponses visuellement riches. Si cette approche a bien fonctionné dans certains cas, elle a aussi provoqué des hallucinations. En approfondissant, nous avons constaté que les images et les vidéos manquaient de contexte textuel suffisant, ce qui perturbait l'agent et entraînait des réponses inexactes. Nous avons finalement privilégié une indexation uniquement textuelle, en intégrant des éléments visuels de façon sélective lorsque c'était nécessaire.
Agent conscient du contexte
Lorsque l'utilisateur interagit avec la plateforme, l'agent doit savoir exactement ce que l'utilisateur voit en termes de données. Par exemple, si l'utilisateur se trouve sur la page d'un ticket, l'agent IA doit savoir où se trouve l'utilisateur et ce qu'il voit.
Nous avons mis à jour notre interface afin que, chaque fois que nous envoyons un message à l'agent, nous y ajoutions un objet de contexte qui représente le POC de l'utilisateur
{
  "question": "What this ticket is about?",
  "context": {
    "page": "/remediation/tickets/os-11638",
    "ticketKey": "os-11638"
  }
}
Implications pour la sécurité
Pour garantir que l'agent IA opère dans les limites des permissions de l'utilisateur, nous avons mis en place des contrôles d'autorisation stricts pour tous les outils. Chaque outil s'exécute avec le même niveau d'accès et les mêmes permissions que l'utilisateur à l'origine de la requête, ce qui empêche les actions non autorisées.
Nous avons utilisé des décorateurs Python pour garantir que les outils ne puissent être invoqués que par des utilisateurs disposant des permissions nécessaires :
@permissions.require_permission(PermissionAction.READ)
@security_agent.tool
def list_tickets(ctx, status: str) -> list:
    return fetch_tickets_from_db(status)
Les outils des agents introduisent aussi une catégorie entièrement nouvelle de vecteurs d'injection via les entrées, qu'il a fallu tester et automatiser, mais nous y reviendrons plus tard 🙂.
Conclusion
Mettre en œuvre l'agent IA Ostorlab Copilot a été un parcours à la fois passionnant et exigeant. Il n'est cependant pas terminé, car nous travaillons déjà sur une multitude de nouveautés, de l'amélioration de l'interface au raisonnement, en passant par des interactions avancées en arrière-plan.
Grâce à une sélection soignée des frameworks, des modèles et des méthodes d'intégration, nous avons créé un assistant puissant et efficace qui améliore l'expérience utilisateur.
Si des défis comme les réponses d'interface structurées et les incohérences des modèles subsistent, notre approche itérative nous permet d'améliorer continuellement les capacités de Copilot.
Remerciements
Nous tenons à remercier chaleureusement les contributeurs suivants, qui ont travaillé sans relâche sur le projet Ostorlab Copilot :
- Adnane Serrar
- Anas Zouiten
- Mohamed El Yousfi
- Mouhcine Narhmouche
- Othmane Hachim
- Rabson Phiri
Leur dévouement et leur expertise ont été précieux pour donner vie à ce projet.