De un moonshot a producción: cómo construimos Ostorlab Copilot
Este artículo describe nuestro camino para implementar Ostorlab Copilot, los desafíos que encontramos y las lecciones que aprendimos por el camino.
De un moonshot a producción: cómo construimos Ostorlab Copilot
¿Qué es la IA agéntica? Una nueva era de asistencia inteligente
La IA agéntica supone un cambio transformador en la inteligencia artificial: va más allá de las respuestas pasivas para pasar a la acción autónoma, el aprendizaje continuo y la toma de decisiones informada. Estos agentes de IA aprovechan herramientas estructuradas, conciencia del contexto y capacidades de razonamiento para ofrecer una asistencia inteligente, adaptable y específica para cada tarea.
En Ostorlab reconocimos desde el principio el potencial de la IA agéntica y la hemos ido integrando en nuestra plataforma para mejorar las operaciones de seguridad y la experiencia de usuario.
Nuestro objetivo es habilitar la automatización impulsada por IA, la toma de decisiones guiada y el soporte interactivo.
Inspirándonos en herramientas como GitHub Copilot y Microsoft Copilot, que muestran cómo la IA puede impulsar la productividad y agilizar los flujos de trabajo mediante interacciones intuitivas en la interfaz, desarrollamos agentes de IA que ofrecen una asistencia fluida e inteligente sin renunciar a una interfaz ágil y fácil de usar.
Por ejemplo, al usar la gestión de la superficie de ataque de Ostorlab, las organizaciones suelen tener que analizar cientos o incluso miles de posibles activos. Verificar manualmente cada activo para confirmar o descartar su propiedad consume mucho tiempo y resulta tedioso. Con un modelo de lenguaje grande (LLM), podemos automatizar este proceso y reducir a cero las horas de trabajo manual.
En lugar de revisar los activos uno por uno, los usuarios pueden simplemente indicar al LLM que confirme todos los activos que cumplan unos criterios concretos, lo que hace la validación más rápida, más eficiente y totalmente automatizada.
La visión de Ostorlab: asistencia de seguridad impulsada por IA
Ostorlab Copilot es un asistente basado en IA diseñado para responder preguntas sobre seguridad y sobre la plataforma, ayudar a gestionar su organización y ejecutar tareas en su nombre, como crear escaneos y gestionar tickets.
Gracias a los modelos de lenguaje grandes y a las herramientas integradas, Copilot ofrece una solución eficiente y fácil de usar para gestionar las operaciones diarias, que en última instancia agiliza y mejora su flujo de trabajo.
Este artículo describe nuestro camino para implementar esta funcionalidad, los desafíos que encontramos y las lecciones que aprendimos por el camino.
Moonshot Week: el origen de Copilot
Moonshot Week es un evento interno en el que dedicamos una semana completa a explorar ideas audaces y ambiciosas, conceptos que pueden parecer descabellados, difíciles o incluso imposibles de implementar.
Durante una de esas semanas, varios miembros del equipo propusieron por primera vez la idea de Ostorlab Copilot y decidieron colaborar para construir un prototipo funcional.
Antes de esto, nuestro equipo ya había adquirido experiencia con frameworks de IA agéntica como CrewAI y LangChain, así que nos propusimos aprovecharlos para este experimento.
Para nuestra sorpresa, en solo unos días teníamos una prueba de concepto (PoC) en marcha. No solo construimos una interfaz totalmente funcional, sino que también permitimos que la IA respondiera preguntas basadas en la documentación e interactuara con la plataforma. El Moonshot fue un éxito rotundo.
Con unos resultados tan prometedores, decidimos seguir adelante con la idea. Descartamos la PoC inicial y diseñamos una nueva implementación desde cero. Sin embargo, no imaginábamos los desafíos que nos esperaban: lo que funcionaba para una tarea única y sencilla en un entorno controlado tuvo que replantearse para escalar de forma eficiente y cubrir muchos más casos de uso. El camino no había hecho más que empezar.
Stack tecnológico y desafíos
Frameworks: CrewAI frente a PydanticAI frente a LangChain
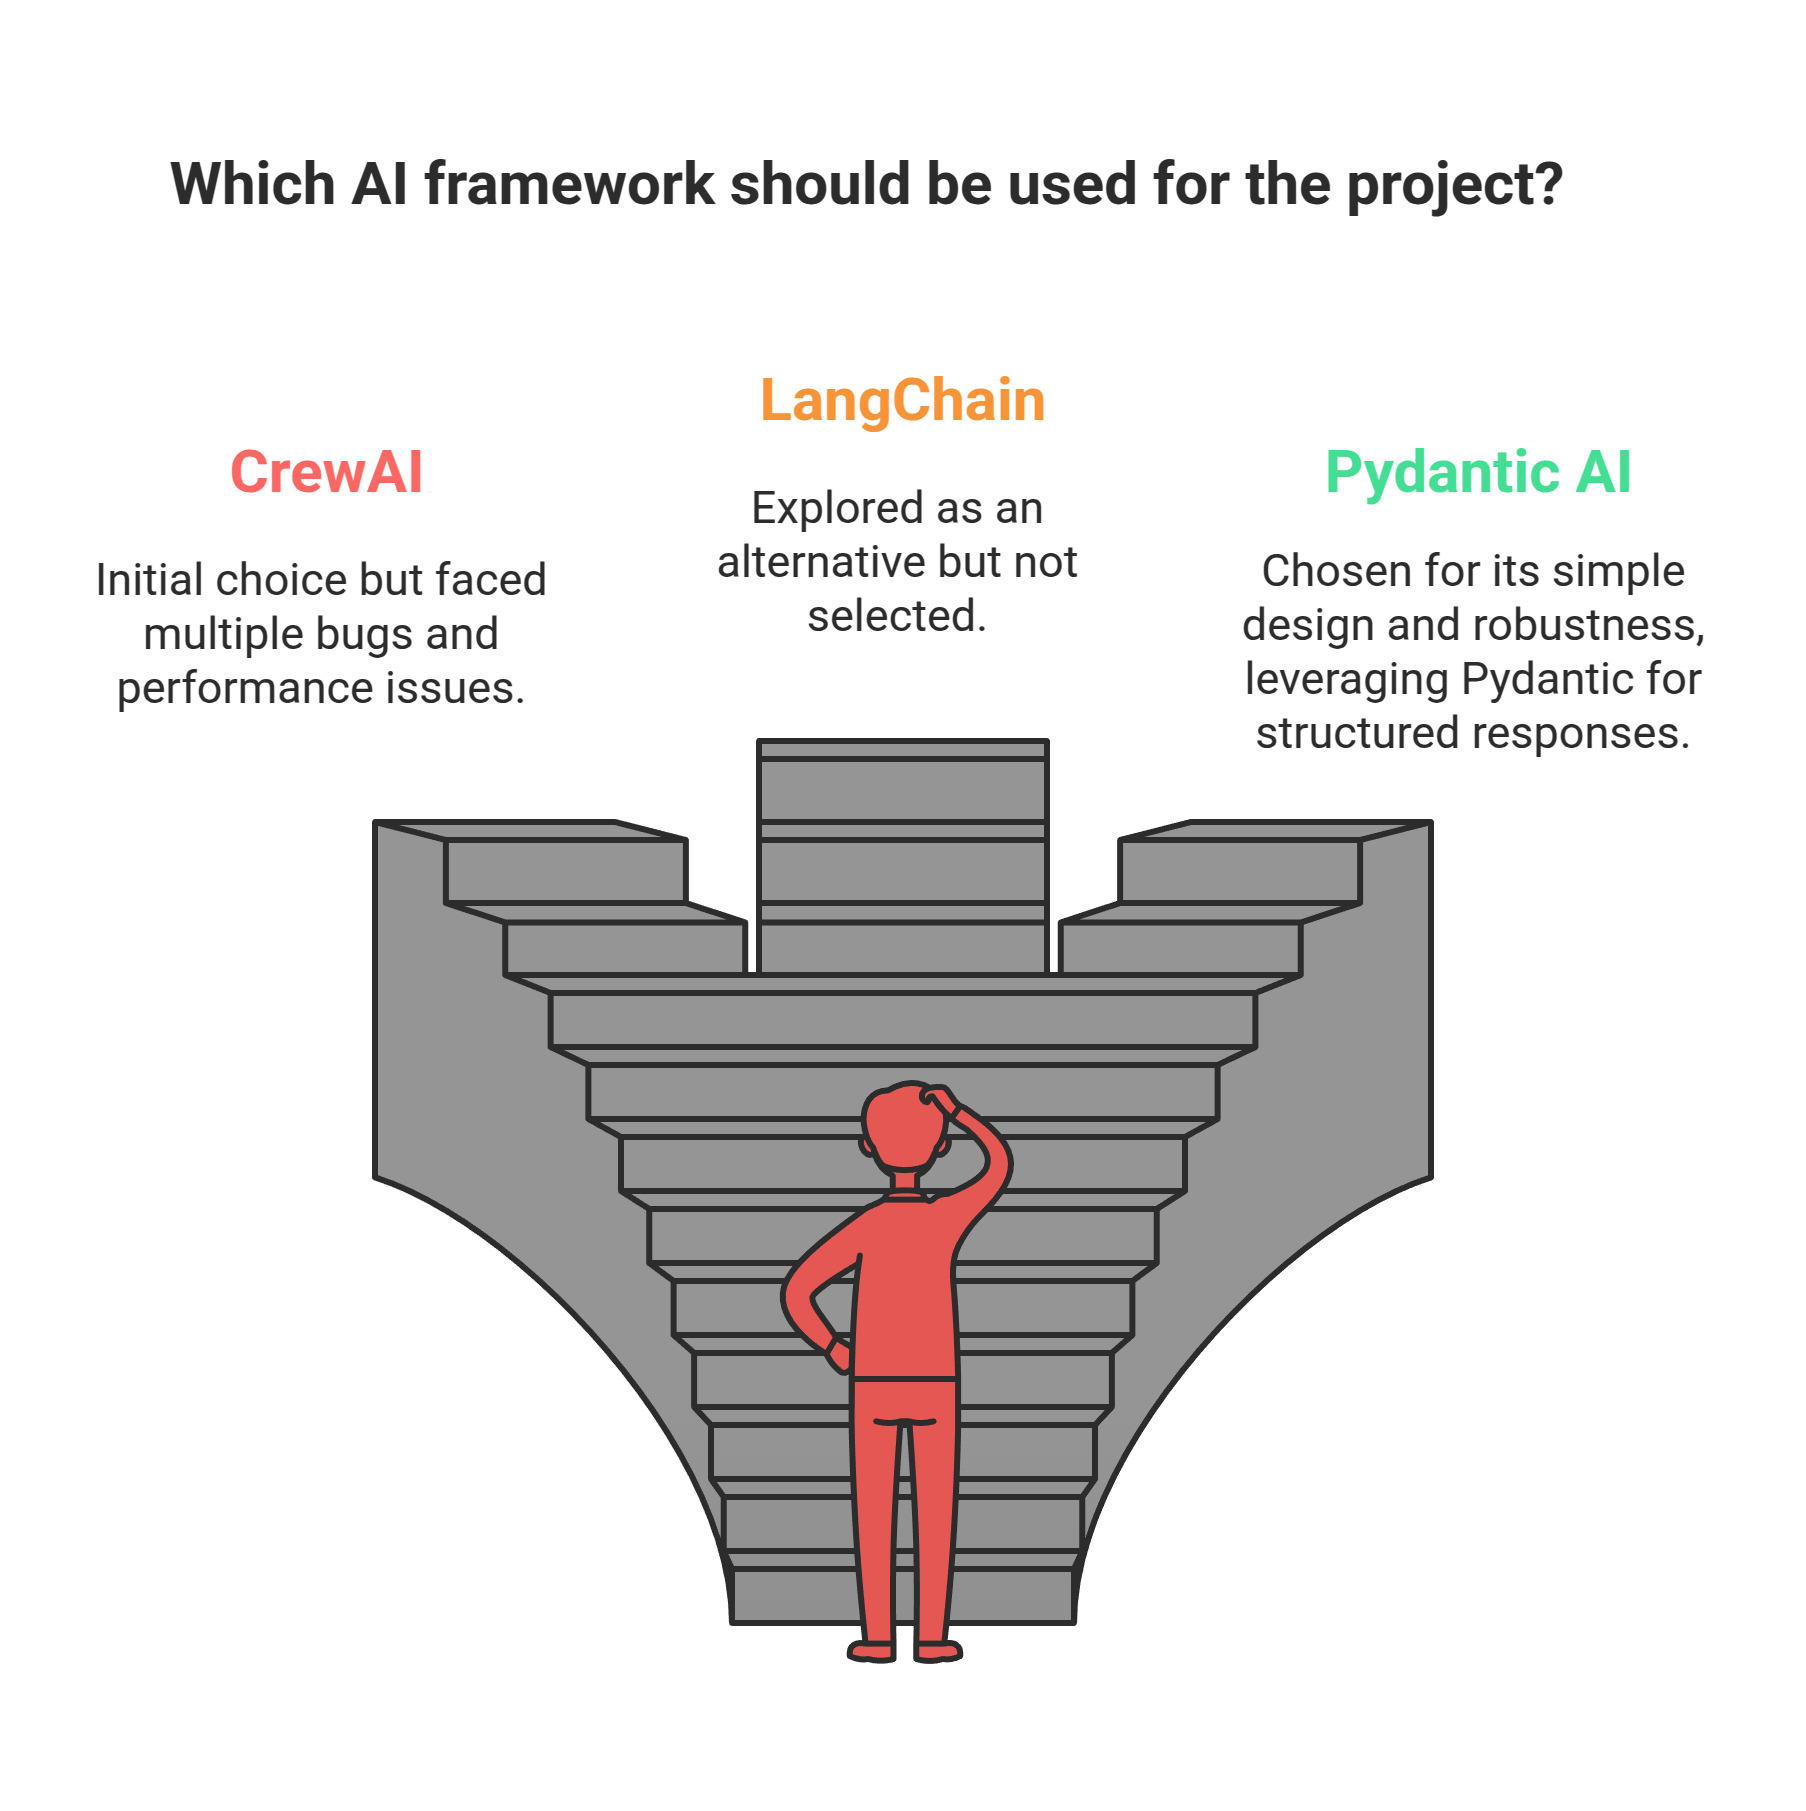
Durante la Moonshot Week, nuestra prueba de concepto (PoC) inicial se construyó con CrewAI. Sin embargo, nos encontramos con varios errores y problemas de rendimiento. Después exploramos LangChain como alternativa, pero finalmente elegimos PydanticAI por su simplicidad y robustez.
PydanticAI destacó como la mejor opción para nuestro caso de uso. Aprovecha Pydantic para generar respuestas estructuradas y tipadas al interactuar con el LLM, lo que garantiza una experiencia más fiable y eficiente.
Ejemplo de declaración de un agente
from pydantic_ai import Agent

security_agent = Agent(
    'openai:gpt-4o',
    deps_type=int,
    result_type=str,
    system_prompt='Provides security insights and best practices.'
)
Cómo imponer respuestas estructuradas y tipadas
Una de las grandes fortalezas de PydanticAI es su capacidad para imponer respuestas estructuradas y con formato. Gracias a la validación de Pydantic, el agente garantiza que las salidas se ajusten a tipos de datos predefinidos, lo que facilita analizarlas e integrarlas en las aplicaciones.
Ejemplo: salida estructurada con Pydantic
from pydantic import BaseModel
from pydantic_ai import Agent

class CityLocation(BaseModel):
    city: str
    country: str

agent = Agent('google-gla:gemini-1.5-flash', result_type=CityLocation)
result = agent.run_sync('Where were the Olympics held in 2012?')
print(result.data)
#> city='London' country='United Kingdom'
Integración de herramientas en PydanticAI
Una de las funciones más potentes de PydanticAI es su capacidad para integrar herramientas: funciones de Python sencillas que el agente puede invocar y utilizar. Sin embargo, esta funcionalidad depende de que el modelo admita el uso de herramientas, y no todos los LLM ofrecen esta característica.
Ejemplo: definición de una herramienta
@security_agent.tool
def fetch_vulnerability_data(vuln_name: str) -> str:
    return f"Details for vulnerability {vuln_name}: ..."

result = security_agent.run_sync('What is SQL injection?', deps=success_number)
print(result.data)
Al combinar las salidas estructuradas con la integración de herramientas, PydanticAI ofrece un framework robusto para construir aplicaciones impulsadas por IA con mayor fiabilidad y control.
Benchmark de modelos LLM
Mientras trabajábamos en el proyecto, no dejamos de realizar benchmarks y pruebas con varios LLM para determinar qué podíamos y qué no podíamos hacer. Nuestro objetivo era encontrar el mejor equilibrio entre velocidad, calidad y coste. Otro factor clave en nuestra decisión fue la capacidad de un LLM para admitir respuestas en JSON y llamadas a herramientas.
1. Definición de escenarios
Cada escenario de prueba se define meticulosamente con:
- Un identificador único
- Modelo objetivo (por ejemplo,
gemini-2.0-flash-001ogpt-4o-mini) - Prompt de sistema (técnico, sencillo o centrado en la seguridad)
- Prompt de usuario
- Salida esperada
- Umbral de similitud para la evaluación
2. Motor de ejecución
Se encarga de ejecutar los escenarios de prueba, medir el tiempo de respuesta, hacer seguimiento del uso de tokens y evaluar la calidad de las respuestas mediante métricas de similitud semántica.
3. Sistema de análisis
Proporciona un análisis en profundidad, que incluye:
- Cálculos de similitud semántica para medir la precisión de las respuestas
- Seguimiento del consumo de tokens para optimizar el uso de recursos
- Informes completos para obtener información sobre el rendimiento
Resultados completos de las pruebas
| Prompt de sistema | Modelo | Prompt de usuario | Similitud | Número de tokens | Coste (USD) | Tiempo |
|---|---|---|---|---|---|---|
| Asistente de IA especializado en la plataforma Ostorlab | gemini-2.0-flash-001 | how to do an android store scan? | 0.80 | 10,904 | $0.0027 | 13.06s |
| Asistente de IA especializado en la plataforma Ostorlab | gpt-4o-mini | how to do an IOS store scan? | 0.77 | 12,245 | $0.0046 | 14.80s |
| Especialista técnico que ofrece orientación precisa | gemini-2.0-flash-001 | how to do a web application scan? | 0.87 | 2,967 | $0.0007 | 3.33s |
| Especialista técnico que ofrece orientación precisa | gpt-4o-mini | how to do a web application scan? | 0.86 | 3,108 | $0.0012 | 16.31s |
| Asistente útil centrado en un lenguaje sencillo | gemini-2.0-flash-001 | how to scan multiple websites at once? | 0.38 | 2,810 | $0.0007 | 1.96s |
| Asistente útil centrado en un lenguaje sencillo | gpt-4o-mini | how to scan multiple websites at once? | 0.81 | 5,047 | $0.0019 | 10.47s |
| Asesor centrado en la seguridad que hace hincapié en las mejores prácticas | gemini-2.0-flash-001 | how to do an authenticated web scan? | 0.86 | 3,837 | $0.0010 | 10.24s |
| Asesor centrado en la seguridad que hace hincapié en las mejores prácticas | gpt-4o-mini | how to do an authenticated web scan? | 0.78 | 13,199 | $0.0050 | 24.94s |
| Especialista técnico que ofrece orientación precisa | gemini-2.0-flash-001 | list open tickets with their details | 0.72 | 6,927 | $0.0017 | 7.68s |
| Especialista técnico que ofrece orientación precisa | gpt-4o-mini | list open tickets with their details | 0.79 | 10,518 | $0.0040 | 13.65s |
| Asistente útil centrado en un lenguaje sencillo | gemini-2.0-flash-001 | show me p0 tickets | 0.69 | 5,898 | $0.0015 | 4.60s |
| Asistente útil centrado en un lenguaje sencillo | gpt-4o-mini | show me my P0 tickets | 0.72 | 9,602 | $0.0037 | 7.84s |
Análisis de los resultados
Características de rendimiento de los modelos
Gemini 2.0 Flash
- Tiempo medio de respuesta: 6.52s
- Uso medio de tokens: 4,724
- Coste total (USD): $0.0083
- Rango de puntuación de similitud: 0.38-0.87
- Mejor rendimiento: escaneos web técnicos (0.87)
- Peor rendimiento: escaneo sencillo de varios sitios web (0.38)
GPT-4o Mini
- Tiempo medio de respuesta: 13.58s
- Uso medio de tokens: 10,633
- Coste total (USD): $0.0201
- Rango de puntuación de similitud: 0.72-0.86
- Mejor rendimiento: escaneos web técnicos (0.86)
- Más consistente: escenarios orientados al usuario (0.72-0.81)
Gemini Flash 2.0 (Google)
Intentamos utilizar Gemini Flash 2.0, pero la calidad de las respuestas no fue satisfactoria.
Gemini Pro 2.0 Experimental (Google)
De forma similar, Gemini Pro 2.0 Experimental (gratuito) presentó buenos resultados, pero está limitado por una cuota que restringe su uso.
Mistral: Ministral 8B
El modelo Mistral: Ministral 8B produjo errores al usarse con las herramientas, lo que impidió ejecuciones correctas.
Mistral: Ministral 3B
Al igual que su hermano mayor, Mistral: Ministral 3B también generó errores por problemas relacionados con las herramientas.
Otros modelos GPT
También exploramos o1 y o1-mini, DeepSeek y Groq LLAMA 3.3 R1 Distill, pero estos modelos eran demasiado caros, demasiado lentos o no admitían la llamada a herramientas ni las respuestas estructuradas.
Estrategia de selección de modelos
Use Gemini para
- Consultas de documentación técnica: Gemini destaca al procesar con rapidez escaneos web técnicos y consultas relacionadas con la documentación, con puntuaciones de similitud altas, pero tiene dificultades con tareas más complejas. La versión Pro mostró capacidades mucho mejores, pero aún no está disponible para su uso en producción.
- Aplicaciones de respuesta rápida: Con un tiempo medio de respuesta más rápido (6.52s), Gemini es adecuado para aplicaciones en las que las respuestas rápidas son críticas.
- Escenarios con recursos limitados: Gracias a su menor uso de tokens y a su eficiencia de costes, Gemini es ideal cuando los recursos del sistema o los presupuestos son limitados.
- Documentación centrada en la seguridad: El mejor rendimiento de Gemini en escenarios técnicos lo hace adecuado para tareas relacionadas con la seguridad o para documentación que requiere precisión.
Use GPT-4o para
- Interacciones de cara al usuario: La consistencia de GPT-4o en escenarios orientados al usuario lo convierte en una excelente opción para chatbots, atención al cliente o IA conversacional.
- Flujos de trabajo complejos de varios pasos: Su capacidad para gestionar un uso elevado de tokens y mantener puntuaciones de similitud altas garantiza que GPT-4o pueda gestionar de forma fiable tareas complejas de varias etapas.
- Escenarios que requieren consistencia: Con un rango de puntuación de similitud más estrecho (0.72-0.86), GPT-4o ofrece resultados más predecibles, lo que lo hace ideal para tareas en las que la consistencia es clave.
- Interacciones con mucho lenguaje natural: GPT-4o es muy adecuado para tareas de procesamiento del lenguaje natural como la generación de historias, la redacción de informes o las instrucciones detalladas para el usuario, en las que la fluidez y la claridad son esenciales.
Empezar por lo sencillo: desarrollo de la interfaz y de la API
Cuando empezamos a trabajar en los bloques fundamentales, la interfaz de usuario (UI) y la API, teníamos varias opciones para implementar la API, entre ellas WebSockets, GraphQL y REST.
Aunque WebSockets puede parecer la mejor opción por su velocidad en el streaming y en la mensajería en tiempo real, finalmente elegimos GraphQL, ya que estaba ampliamente adoptado en nuestra plataforma y nos permitía entregar más rápido sin cambios significativos en la plataforma ni en la infraestructura existente.
[Captura de pantalla de la interfaz]
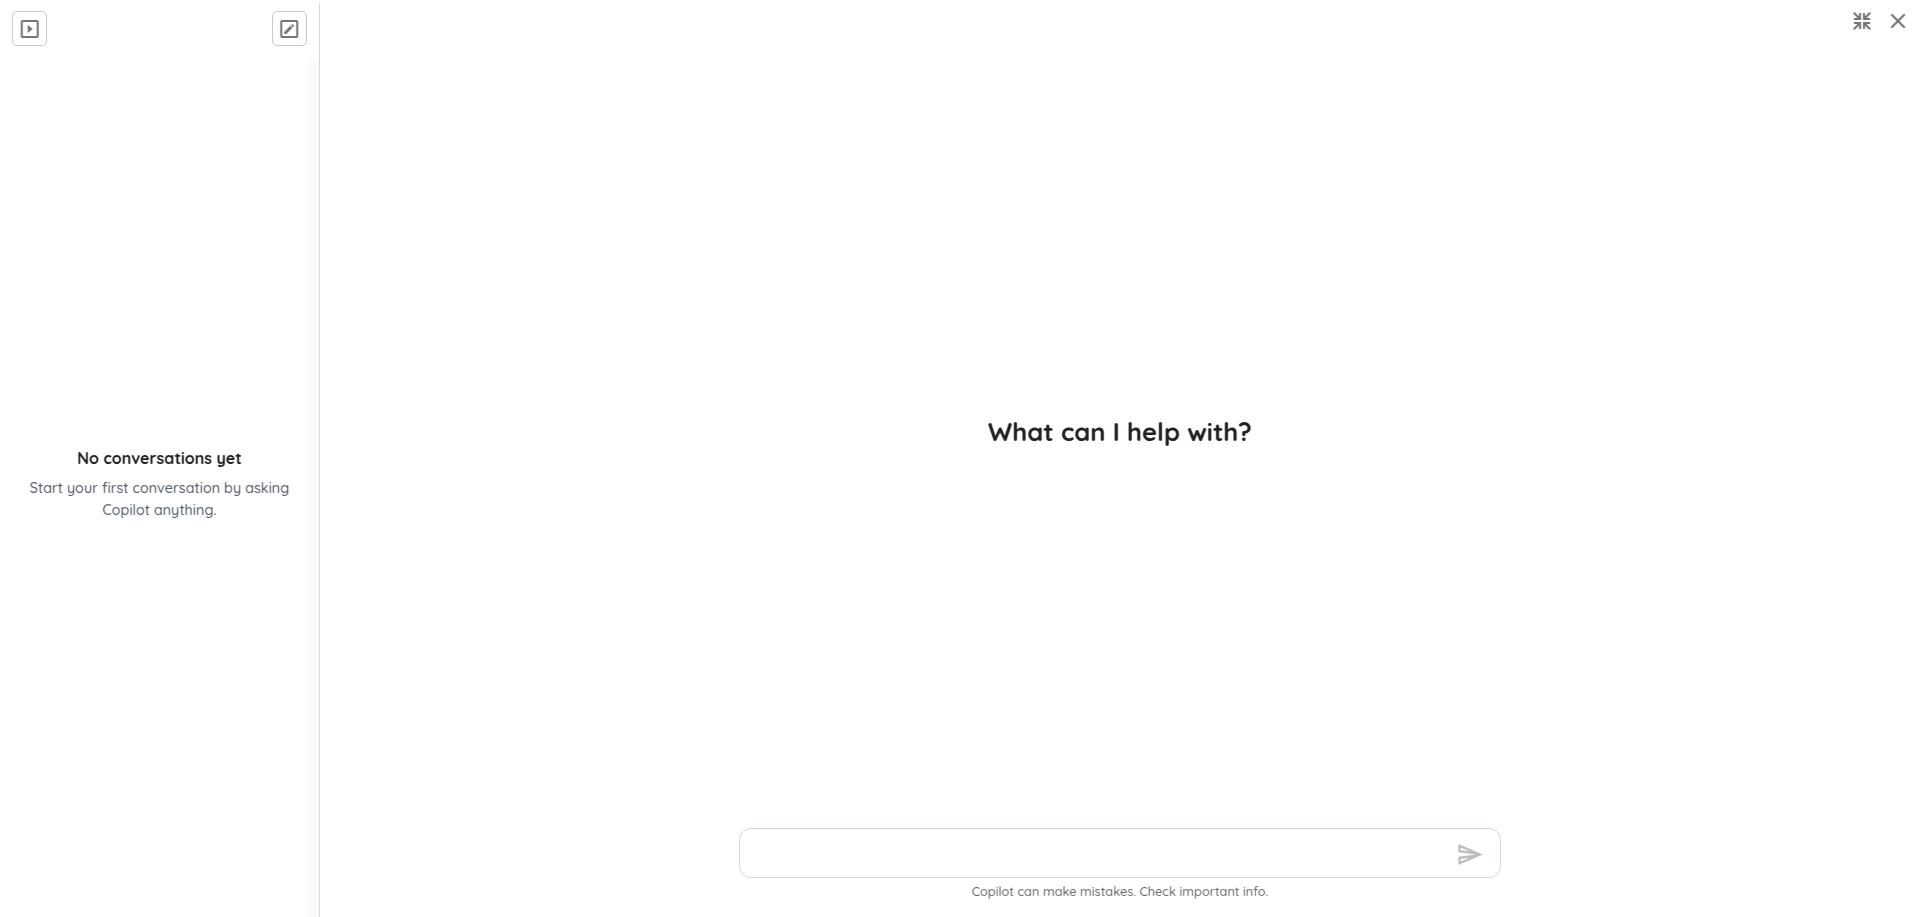
Interfaz con componentes estructurados
Experimentamos con el uso de componentes estructurados para mejorar la capacidad de la IA de ofrecer respuestas visualmente ricas e interactivas.
El concepto de componentes estructurados consiste en que la IA devuelva no solo respuestas en texto plano o en markdown, sino también elementos de interfaz estructurados como tablas, imágenes y componentes interactivos. Nuestro objetivo era mejorar la claridad y la usabilidad de las respuestas de la IA.
Este es un ejemplo de los componentes estructurados esperados:
Formato de respuesta del agente:
"message": {
  "components": [
    {
      "type": "Text",
      "content": "Step 1: Click the scans menu"
    },
    {
      "type": "Image",
      "url": "https://placehold.co/600x400/EEE/31343C"
    },
    {
      "type": "Text",
      "content": "Step 2: Click on 'Create a Scan'"
    },
    {
      "type": "Table",
      "data": {
        "headers": ["Name", "ID"],
        "rows": [...]
      }
    }
  ]
}
Este enfoque sería extremadamente útil para renderizar información compleja de las respuestas de la IA, como gráficos, tablas y tarjetas personalizadas.
Por desgracia, gpt-4o-mini recurría de forma sistemática a un único componente de texto, que contenía todo en formato markdown, en lugar de devolver componentes estructurados. Por ejemplo:
"message": {
"components": [
{
"type": "Text",
"content": "Step 1: Click the scans menu \n ...."
}
]
}
Esta limitación nos llevó a adaptar nuestro enfoque del renderizado de la interfaz, para garantizar una mejor compatibilidad con el modelo seleccionado y esforzándonos por mantener respuestas estructuradas siempre que fuera posible.
Interacciones con la plataforma y llamadas a herramientas
Para permitir que el agente interactúe con la plataforma, por ejemplo leyendo datos o realizando acciones, consideramos varios enfoques:
- Consultas SQL directas: Esta opción se descartó rápidamente por motivos de seguridad y de estabilidad.
- Uso de las API existentes: Aunque era una opción razonable, introducía una sobrecarga de rendimiento que no era ideal para nuestras necesidades.
- Herramientas personalizadas: En definitiva, el mejor enfoque fue desarrollar herramientas personalizadas que aprovechen nuestra infraestructura existente. Este método nos permite interactuar con la plataforma de forma eficiente y ejecutar consultas y acciones lo más rápido posible, manteniendo al mismo tiempo un control total sobre la autorización.
Ejemplo de una herramienta para listar tickets:
@security_agent.tool
def list_tickets(ctx,status: str):
    return fetch_tickets_from_db(status)
Tipo de retorno de las herramientas.
Al desarrollar las herramientas, teníamos varias opciones para el tipo de salida que debían proporcionar: cadenas de texto simples,
diccionarios o modelos de Pydantic. Aunque devolver cadenas simples puede parecer atractivo, no son mantenibles.
Los diccionarios no están tipados, y los modelos de lenguaje han demostrado una capacidad deficiente para entenderlos como salidas de herramientas. Por ello, la elección clara fue utilizar modelos de Pydantic.
Además, al trabajar con herramientas, el docstring desempeña un papel fundamental para que el agente de IA entienda qué es la herramienta y cómo funciona.
Este es un ejemplo de una herramienta que devuelve un modelo de Pydantic con un docstring muy claro:
class TicketType(pydantic.BaseModel):
    """Model for a single ticket"""

    id: int = pydantic.Field(None, description="Ticket identifier")
    key: str = pydantic.Field(None, description="Ticket key in org-id format")
    ...

@security_agent.tool
def list_tickets(ctx,status: str) -> list[Ticket]:
 """List tickets based on the provided filters and context.

    Retrieves ticket records matching the specified criteria. All filter parameters are optional
    and can be combined to create complex queries.

    Args:
    ...
"""
    return fetch_tickets_from_db(status)
Gestión de errores
Al trabajar con las herramientas, queríamos informar al LLM (modelo de lenguaje grande) de que había llamado a las herramientas con argumentos incorrectos. Lanzar excepciones no era una solución viable, ya que haría fallar todo el flujo de trabajo.
En su lugar, decidimos utilizar cadenas de texto para indicar los errores al LLM y guiarlo para que corrigiera sus fallos.
class TicketType(pydantic.BaseModel):
    """Model for a single ticket"""

    id: int = pydantic.Field(None, description="Ticket identifier")
    key: str = pydantic.Field(None, description="Ticket key in org-id format")
    ...

@security_agent.tool
def list_tickets(ctx,status: str) -> list[Ticket]:
 """List tickets based on the provided filters and context.

    Retrieves ticket records matching the specified criteria. All filter parameters are optional
    and can be combined to create complex queries.

    Args:
    ...
"""
    if status in ALLOWED_STATUS:
        return fetch_tickets_from_db(status)
    else:
        return f"Error: invalid status was provided, status should be one off {ALLOWED_STATUS}"
Gestión de grandes conjuntos de datos
Al trabajar con grandes conjuntos de datos, como los posibles nodos de una superficie de ataque, tuvimos que asegurarnos de que la IA pudiera procesar y recuperar de forma eficiente la información relevante. Lo resolvimos optimizando la longitud del contexto e implementando mecanismos de paginación para manejar grandes cantidades de información sin superar los límites del modelo.
class TicketsType(pydantic.BaseModel):
    """Paginated tickets response type."""

    total: int
    page: int
    tickets: list[TicketType]

@security_agent.tool
def list_tickets(ctx,status: str,page:int,count:int=10) -> TicketsType:
    return fetch_tickets_from_db(status=status,count=count,page=page)
Esto nos permitió evitar pasar al agente de IA demasiados datos o datos innecesarios y evitar sobrecargar la ventana de contexto del modelo LLM utilizado.
Recuperación de datos para responder preguntas
Para mejorar la capacidad de Copilot de responder a las preguntas de los usuarios relacionadas con la plataforma, necesitamos de algún modo permitir que el agente acceda a información sobre la plataforma y sobre las funcionalidades disponibles. Por suerte, ya habíamos hecho el trabajo de documentar todas las funcionalidades y cómo usarlas: es nuestra documentación.
Usamos FAISS para indexar toda nuestra documentación y la proporcionamos como una herramienta para que el agente busque detalles relacionados con las preguntas de los usuarios.
Inicialmente decidimos indexar imágenes y vídeos junto con la documentación en Markdown para que el modelo pudiera generar respuestas visualmente ricas. Aunque este enfoque funcionó bien en algunos casos, también provocó alucinaciones. Tras investigarlo más a fondo, descubrimos que las imágenes y los vídeos carecían de suficiente contexto textual, lo que confundía al agente y daba lugar a respuestas inexactas. Finalmente, optamos por utilizar únicamente una indexación basada en texto e incorporar selectivamente elementos visuales cuando fuera necesario.
Agente con conciencia del contexto
Cuando el usuario interactúa con la plataforma, el agente necesita saber exactamente qué datos ve el usuario y qué está viendo; por ejemplo, si el usuario está dentro de la página de un ticket, el agente de IA debe ser consciente de dónde se encuentra el usuario y de lo que está viendo.
Actualizamos nuestra interfaz para que, cada vez que enviamos un mensaje al agente, le añadamos un objeto de contexto que representa el punto de vista del usuario
{
  "question": "What this ticket is about?",
  "context": {
    "page": "/remediation/tickets/os-11638",
    "ticketKey": "os-11638"
  }
}
Implicaciones de seguridad
Para garantizar que el agente de IA opere dentro de los permisos del usuario, implementamos controles de autorización estrictos para todas las herramientas. Cada herramienta se ejecuta con el mismo nivel de acceso y de permisos que el usuario que realiza la solicitud, lo que evita acciones no autorizadas.
Utilizamos decoradores de Python para garantizar que las herramientas solo pudieran ser invocadas por usuarios con los permisos necesarios:
@permissions.require_permission(PermissionAction.READ)
@security_agent.tool
def list_tickets(ctx, status: str) -> list:
    return fetch_tickets_from_db(status)
Las herramientas del agente también introducen una categoría completamente nueva de vectores de inyección de entrada que hubo que probar y automatizar, pero de eso hablaremos más adelante 🙂.
Conclusión
Implementar el agente de IA Ostorlab Copilot ha sido un camino emocionante y desafiante. Sin embargo, aún no ha terminado, ya que estamos trabajando en multitud de novedades, desde una interfaz mejorada hasta el razonamiento y la interacción avanzada en segundo plano.
Mediante una cuidadosa selección de frameworks, modelos y métodos de integración, hemos creado un asistente potente y eficiente que mejora la experiencia de usuario.
Aunque persisten desafíos como las respuestas estructuradas en la interfaz y las inconsistencias de los modelos, nuestro enfoque iterativo nos permite mejorar continuamente las capacidades de Copilot.
Agradecimientos
Queremos expresar nuestro más sincero agradecimiento a los siguientes colaboradores, que han trabajado sin descanso en el proyecto Ostorlab Copilot:
- Adnane Serrar
- Anas Zouiten
- Mohamed El Yousfi
- Mouhcine Narhmouche
- Othmane Hachim
- Rabson Phiri
Su dedicación y su experiencia han sido invaluables para dar vida a este proyecto.