从登月计划到生产环境:构建 Ostorlab Copilot
本文梳理了我们实现 Ostorlab Copilot 的历程、过程中遇到的挑战,以及我们一路走来总结的经验。
从登月计划到生产环境:构建 Ostorlab Copilot
什么是智能体式 AI?智能辅助的新纪元
智能体式(Agentic)AI 标志着人工智能的一次变革性转变,它从被动响应迈向了自主行动、持续学习和基于信息的决策。这些 AI 智能体借助结构化工具、上下文感知和推理能力,提供智能、自适应、针对特定任务的辅助。
在 Ostorlab,我们很早就认识到智能体式 AI 的潜力,并一直将其集成到我们的平台中,以增强安全运营和用户体验。
我们的目标是实现由 AI 驱动的自动化、引导式决策和交互式支持。
受到 GitHub Copilot 和 Microsoft Copilot 等工具的启发——两者都展示了 AI 如何通过直观的 UI 交互提升生产力、简化工作流程——我们开发了一批 AI 智能体,它们在保持流畅、易用界面的同时,提供无缝、智能的辅助。
举例来说,当使用 Ostorlab 的攻击面管理时,组织往往需要分析成百上千个潜在资产。手动核实每一个资产以确认或排除归属既耗时又繁琐。借助大语言模型(LLM),我们可以将这一过程自动化,把数小时的手动工作缩减为零。
用户无需逐个审查资产,只需让 LLM 确认所有满足特定条件的资产即可,从而让核实工作更快、更高效、且完全自动化。
Ostorlab 的愿景:由 AI 驱动的安全辅助
Ostorlab Copilot 是一款由 AI 驱动的助手,旨在回答安全与平台相关的问题、帮助您管理组织,并代您执行诸如创建扫描和管理工单等任务。
通过借助大语言模型和集成工具,Copilot 为处理日常运营提供了一套高效、易用的解决方案,最终简化并增强您的工作流程。
本文梳理了我们实现这一功能的历程、过程中遇到的挑战,以及我们一路走来总结的经验。
登月周:Copilot 的缘起
登月周(Moonshot Week)是我们的一项内部活动,我们会用整整一周时间去探索那些大胆、雄心勃勃的想法——那些看起来天马行空、困难重重、甚至几乎不可能实现的构想。
在某一次这样的活动中,Ostorlab Copilot 的想法最初由几位团队成员提出,他们决定协作构建一个可运行的原型。
在此之前,我们的团队已经积累了使用 CrewAI、LangChain 等智能体式 AI 框架的经验,因此我们打算在这次实验中利用它们。
令我们惊讶的是,仅仅几天时间,我们就让一个概念验证(PoC)跑了起来。我们不仅构建了一个功能完备的 UI,还让 AI 能够基于文档回答问题并与平台交互。这次登月尝试取得了显而易见的成功。
鉴于这些令人振奋的结果,我们决定继续推进这个想法。最初的 PoC 被弃用,一套新的实现从头开始设计。然而,我们当时并未料到前方的种种挑战——在受控环境中适用于单一简单任务的方案,必须重新构想,才能高效扩展并覆盖多得多的使用场景。这段旅程才刚刚开始。
技术栈与挑战
框架之选:CrewAI vs. PydanticAI vs. LangChain
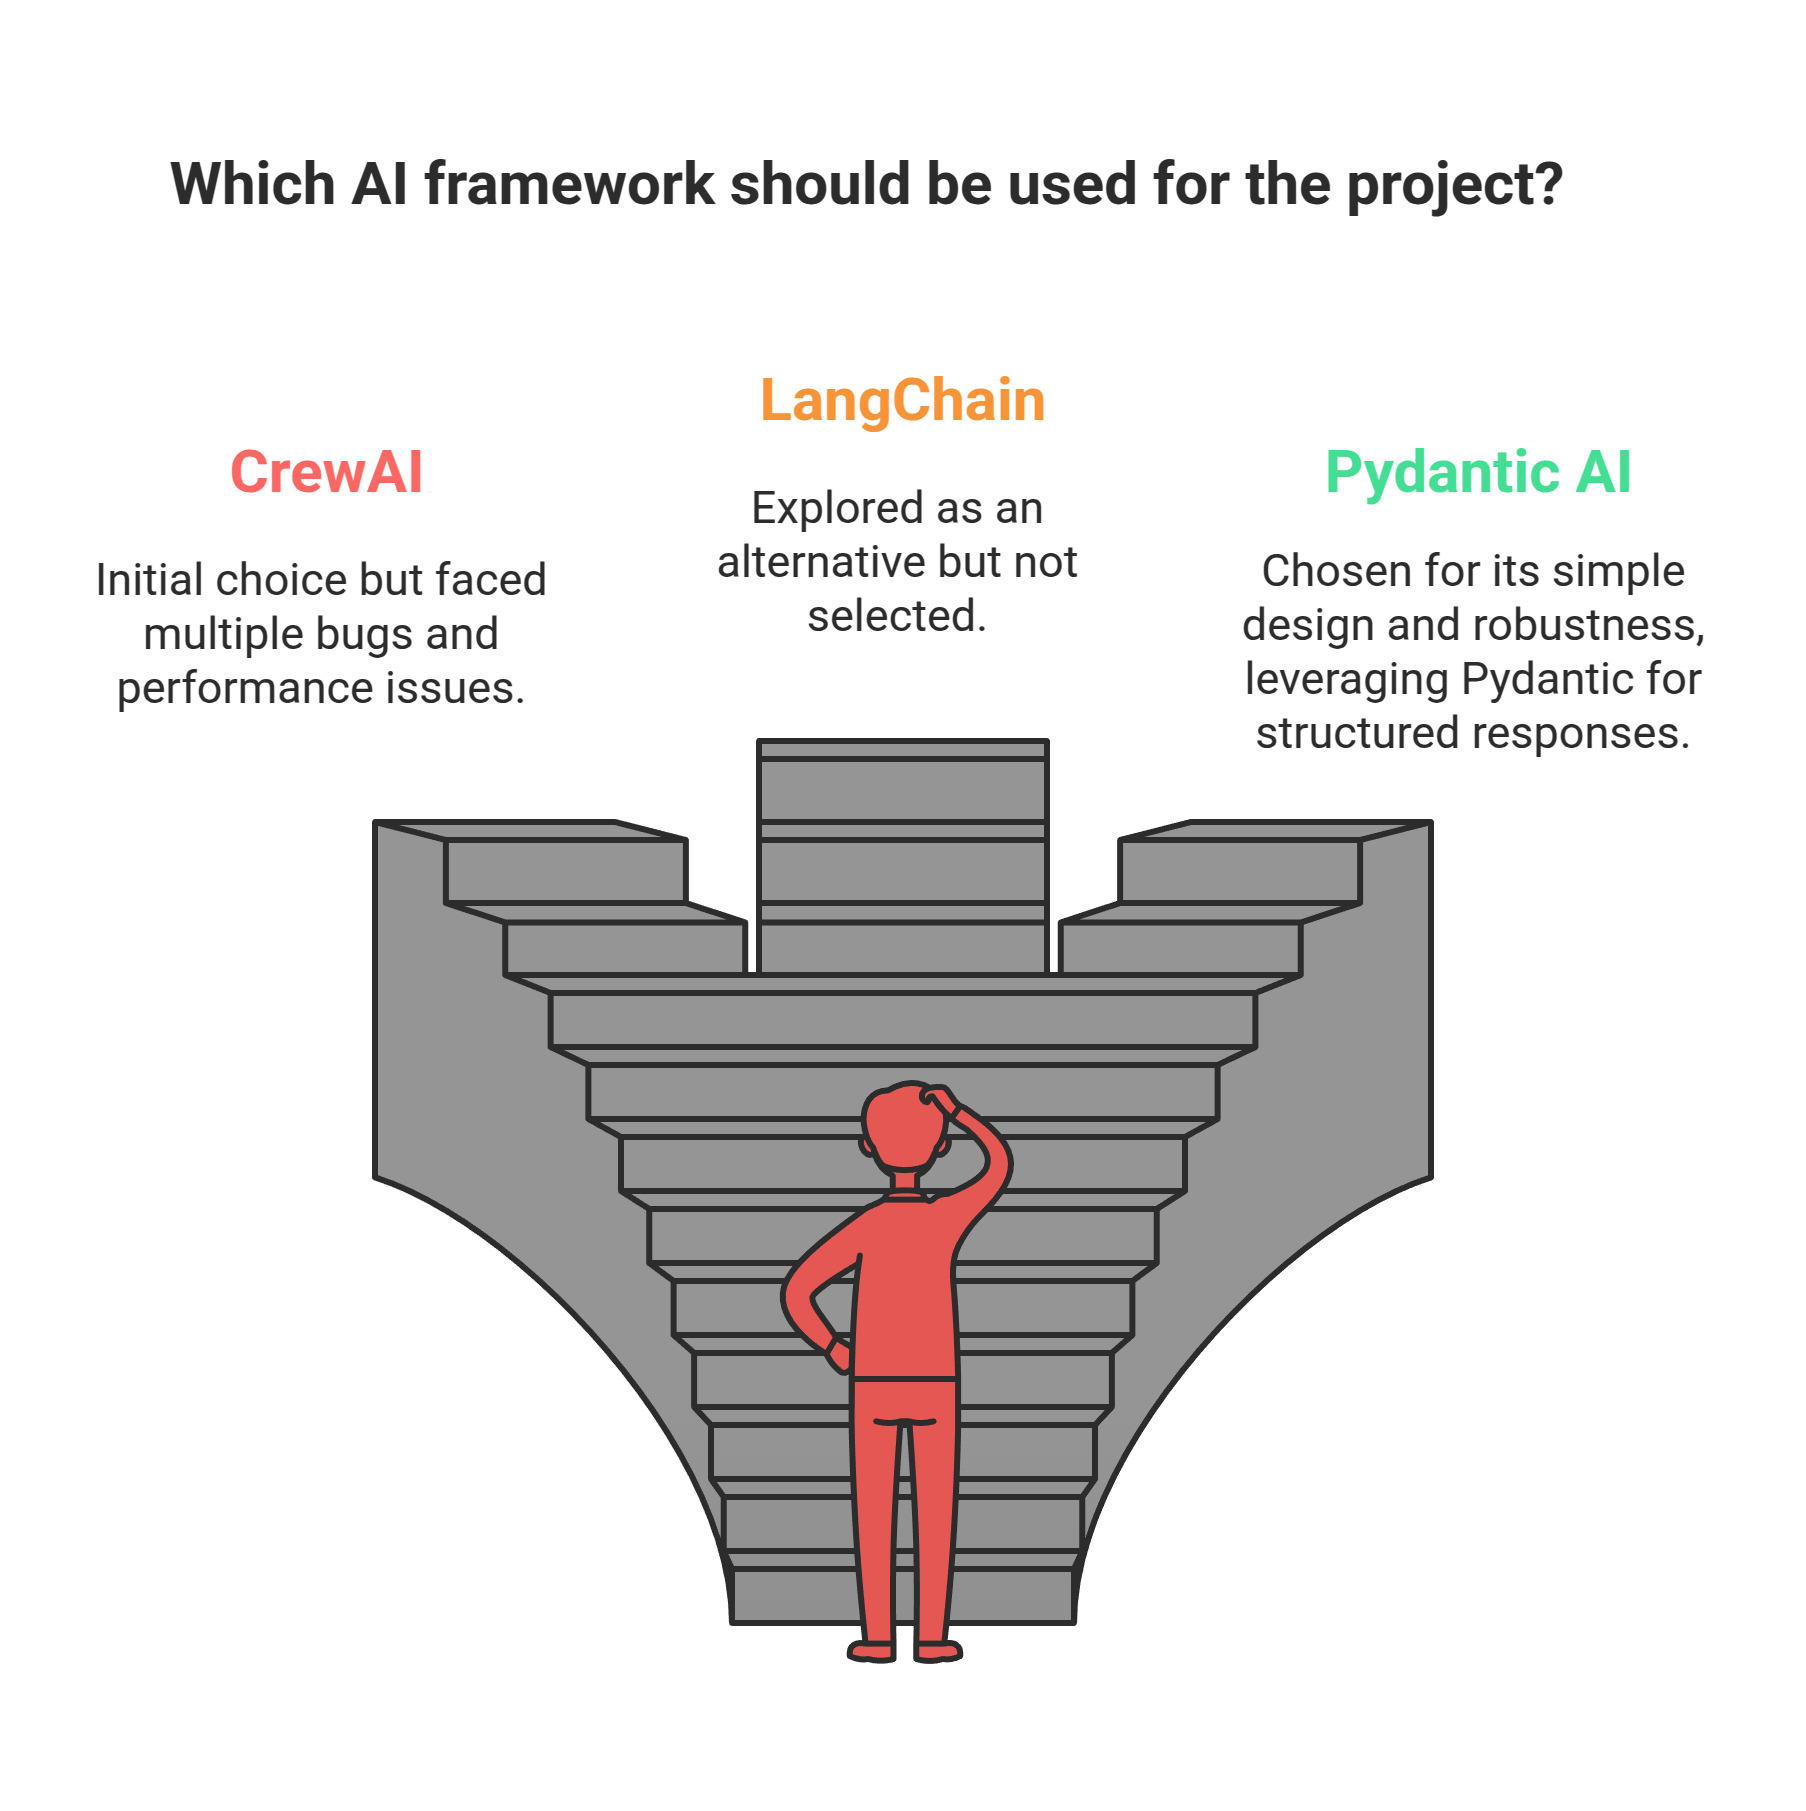
在登月周期间,我们最初的概念验证(PoC)是使用 CrewAI 构建的。然而,我们遇到了多个缺陷和性能问题。随后我们将 LangChain 作为备选方案进行了探索,但最终因 PydanticAI 的简洁与健壮而选择了它。
对于我们的使用场景,PydanticAI 脱颖而出,成为最佳选择。它借助 Pydantic 在与 LLM 交互时生成结构化、带类型的响应,从而确保更可靠、更高效的体验。
智能体声明示例
from pydantic_ai import Agent

security_agent = Agent(
    'openai:gpt-4o',
    deps_type=int,
    result_type=str,
    system_prompt='Provides security insights and best practices.'
)
强制要求结构化、带类型的响应
PydanticAI 的一大优势在于它能够强制要求响应保持结构化和规范格式。通过利用 Pydantic 的校验,智能体可以确保输出符合预定义的数据类型,使其更易于解析并集成到应用中。
示例:使用 Pydantic 的结构化输出
from pydantic import BaseModel
from pydantic_ai import Agent

class CityLocation(BaseModel):
    city: str
    country: str

agent = Agent('google-gla:gemini-1.5-flash', result_type=CityLocation)
result = agent.run_sync('Where were the Olympics held in 2012?')
print(result.data)
#> city='London' country='United Kingdom'
PydanticAI 中的工具集成
PydanticAI 最强大的功能之一是能够集成工具——即智能体可以调用和使用的简单 Python 函数。不过,这一功能取决于模型是否支持工具调用,而并非所有 LLM 都提供这一能力。
示例:定义一个工具
@security_agent.tool
def fetch_vulnerability_data(vuln_name: str) -> str:
    return f"Details for vulnerability {vuln_name}: ..."

result = security_agent.run_sync('What is SQL injection?', deps=success_number)
print(result.data)
通过结合结构化输出与工具集成,PydanticAI 为构建由 AI 驱动的应用提供了一套健壮的框架,带来了更高的可靠性和可控性。
对 LLM 模型进行基准测试
在项目推进过程中,我们持续对多个 LLM 进行基准测试和试验,判断哪些能做、哪些不能做。我们力图在速度、质量和成本之间找到最佳平衡。影响我们决策的另一个关键因素是 LLM 是否支持 JSON 响应和工具调用能力。
1. 场景定义
每个测试场景都会被细致地定义,包含:
- 唯一标识符
- 目标模型(例如
gemini-2.0-flash-001或gpt-4o-mini) - 系统提示词(技术型、简明型或安全导向型)
- 用户提示词
- 预期输出
- 用于评估的相似度阈值
2. 执行引擎
负责执行测试场景、测量响应时间、跟踪令牌使用量,并使用语义相似度指标评估响应质量。
3. 分析系统
提供深入分析,包括:
- 语义相似度计算,用于衡量响应准确性
- 令牌消耗跟踪,用于优化资源使用
- 全面的报告,用于获取性能洞察
完整测试结果
| 系统提示词 | 模型 | 用户提示词 | 相似度 | 令牌数 | 成本(USD) | 耗时 |
|---|---|---|---|---|---|---|
| 专注于 Ostorlab 平台的 AI 助手 | gemini-2.0-flash-001 | how to do an android store scan? | 0.80 | 10,904 | $0.0027 | 13.06s |
| 专注于 Ostorlab 平台的 AI 助手 | gpt-4o-mini | how to do an IOS store scan? | 0.77 | 12,245 | $0.0046 | 14.80s |
| 提供精确指导的技术专家 | gemini-2.0-flash-001 | how to do a web application scan? | 0.87 | 2,967 | $0.0007 | 3.33s |
| 提供精确指导的技术专家 | gpt-4o-mini | how to do a web application scan? | 0.86 | 3,108 | $0.0012 | 16.31s |
| 专注于简明语言的得力助手 | gemini-2.0-flash-001 | how to scan multiple websites at once? | 0.38 | 2,810 | $0.0007 | 1.96s |
| 专注于简明语言的得力助手 | gpt-4o-mini | how to scan multiple websites at once? | 0.81 | 5,047 | $0.0019 | 10.47s |
| 强调最佳实践的安全导向型顾问 | gemini-2.0-flash-001 | how to do an authenticated web scan? | 0.86 | 3,837 | $0.0010 | 10.24s |
| 强调最佳实践的安全导向型顾问 | gpt-4o-mini | how to do an authenticated web scan? | 0.78 | 13,199 | $0.0050 | 24.94s |
| 提供精确指导的技术专家 | gemini-2.0-flash-001 | list open tickets with their details | 0.72 | 6,927 | $0.0017 | 7.68s |
| 提供精确指导的技术专家 | gpt-4o-mini | list open tickets with their details | 0.79 | 10,518 | $0.0040 | 13.65s |
| 专注于简明语言的得力助手 | gemini-2.0-flash-001 | show me p0 tickets | 0.69 | 5,898 | $0.0015 | 4.60s |
| 专注于简明语言的得力助手 | gpt-4o-mini | show me my P0 tickets | 0.72 | 9,602 | $0.0037 | 7.84s |
结果分析
模型性能特征
Gemini 2.0 Flash
- 平均响应时间:6.52s
- 平均令牌使用量:4,724
- 总成本(USD):$0.0083
- 相似度得分区间:0.38-0.87
- 最佳表现:技术型 Web 扫描(0.87)
- 最弱表现:简明型多网站扫描(0.38)
GPT-4o Mini
- 平均响应时间:13.58s
- 平均令牌使用量:10,633
- 总成本(USD):$0.0201
- 相似度得分区间:0.72-0.86
- 最佳表现:技术型 Web 扫描(0.86)
- 最稳定:面向用户的友好型场景(0.72-0.81)
Gemini Flash 2.0(Google)
我们曾尝试使用 Gemini Flash 2.0,但响应质量不尽如人意。
Gemini Pro 2.0 Experimental(Google)
同样,Gemini Pro 2.0 Experimental(免费版)表现出不错的结果,但受配额限制,制约了其使用。
Mistral:Ministral 8B
Mistral: Ministral 8B 模型在与工具配合使用时出现了错误,导致无法成功运行。
Mistral:Ministral 3B
与其较大的同类一样,Mistral: Ministral 3B 也因工具相关问题而报错。
其他 GPT 模型
我们还探索了 o1 与 o1-mini、DeepSeek,以及 Groq LLAMA 3.3 R1 Distill,但这些模型要么太昂贵、要么太慢,要么不支持工具调用或结构化响应。
模型选择策略
在以下场景使用 Gemini
- 技术文档查询:Gemini 擅长快速处理技术型 Web 扫描和文档相关查询,相似度得分很高,但在更复杂的任务上表现欠佳。Pro 版本展现出强得多的能力,但尚不可用于生产环境。
- 快速响应型应用:凭借更快的平均响应时间(6.52s),Gemini 适用于那些对快速响应有关键要求的应用。
- 资源受限的场景:由于其较低的令牌使用量和成本效率,当系统资源或预算有限时,Gemini 是理想之选。
- 安全导向型文档:Gemini 在技术型场景中的最佳表现,使其非常适合需要准确性的安全相关任务或文档。
在以下场景使用 GPT-4o
- 面向用户的交互:GPT-4o 在面向用户的友好型场景中表现稳定,使其成为聊天机器人、客户服务或对话式 AI 的绝佳选择。
- 复杂的多步骤工作流程:它能够处理大量令牌使用并保持高相似度得分,确保 GPT-4o 能够可靠地管理复杂的多阶段任务。
- 需要一致性的场景:凭借更窄的相似度得分区间(0.72-0.86),GPT-4o 提供了更可预测的输出,使其成为以一致性为关键的任务的理想之选。
- 大量自然语言的交互:GPT-4o 非常适合自然语言处理任务,如故事生成、报告撰写或详细的用户指令,这些任务对流畅度和清晰度有着至关重要的要求。
从简单起步:UI 与 API 开发
当我们着手开发最基础的构件——用户界面(UI)和 API 时,对于如何实现 API,我们有多个选项,包括 WebSocket、GraphQL 和 REST。
虽然 WebSocket 凭借其在流式传输和实时消息方面的速度看似是最佳选项,但我们最终选择了 GraphQL,因为它在我们的平台中已被广泛采用,让我们能够更快地交付,而无需对平台和现有基础设施做出重大改动。
[UI 截图]
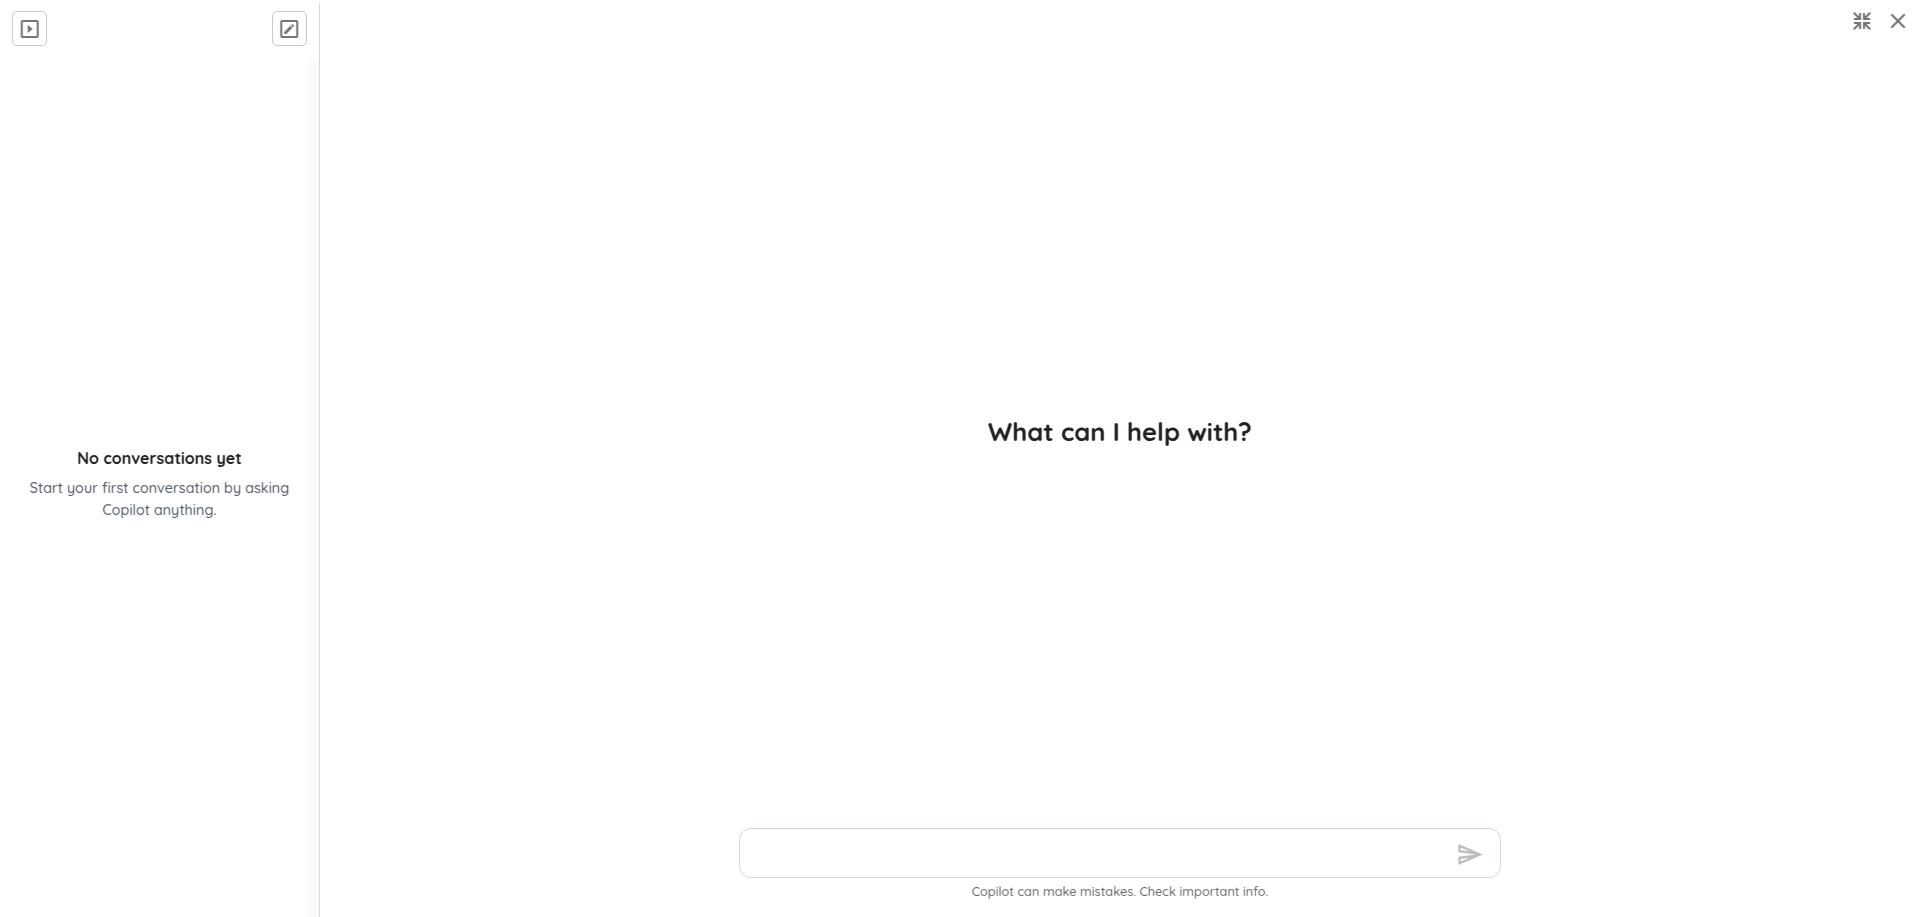
结构化组件 UI
我们尝试使用结构化组件,以增强 AI 提供视觉丰富、可交互响应的能力。
结构化组件的理念在于:AI 返回的不仅是纯文本或 markdown 答案,还包括表格、图像和可交互组件等结构化 UI 元素。我们的目标是提升 AI 响应的清晰度和可用性。
下面是预期的结构化组件示例:
智能体回答格式:
"message": {
  "components": [
    {
      "type": "Text",
      "content": "Step 1: Click the scans menu"
    },
    {
      "type": "Image",
      "url": "https://placehold.co/600x400/EEE/31343C"
    },
    {
      "type": "Text",
      "content": "Step 2: Click on 'Create a Scan'"
    },
    {
      "type": "Table",
      "data": {
        "headers": ["Name", "ID"],
        "rows": [...]
      }
    }
  ]
}
这种方式对于渲染来自 AI 响应的复杂信息(如图表、表格和自定义卡片)极为有用。
遗憾的是,gpt-4o-mini 始终倾向于只使用单个文本组件,把所有内容都塞进 markdown 格式里,而不是返回结构化组件。例如:
"message": {
"components": [
{
"type": "Text",
"content": "Step 1: Click the scans menu \n ...."
}
]
}
这一局限促使我们调整了 UI 渲染的方式,以确保与所选模型更好地兼容,同时尽可能保持结构化响应。
与平台的交互及工具调用
为了让智能体能够与平台交互——例如读取数据或执行操作——我们考虑了几种方案:
- 直接 SQL 查询:出于对安全性和稳定性的顾虑,这一选项很快被否决。
- 使用现有 API:虽然这是一个合理的选择,但它引入了性能开销,并不符合我们的需求。
- 自定义工具:最终,最佳方案是开发利用我们现有基础设施的自定义工具。这种方法让我们能够高效地与平台交互,尽可能快地执行查询和操作,同时对授权保持完全掌控。
列出工单的工具示例:
@security_agent.tool
def list_tickets(ctx,status: str):
    return fetch_tickets_from_db(status)
工具的返回类型
在开发工具时,对于它们应提供何种类型的输出,我们有几个选项:纯字符串、 字典,或 Pydantic 模型。虽然返回纯字符串看似颇具吸引力,但它们难以维护。
字典没有类型,而语言模型在理解作为工具输出的字典方面表现不佳。因此,明确的选择是使用 Pydantic 模型。
此外,在使用工具时,文档字符串(docstring)对于帮助 AI 智能体理解该工具是什么以及如何运作起着至关重要的作用。
下面是一个返回 Pydantic 模型、并带有非常清晰文档字符串的工具示例:
class TicketType(pydantic.BaseModel):
    """Model for a single ticket"""

    id: int = pydantic.Field(None, description="Ticket identifier")
    key: str = pydantic.Field(None, description="Ticket key in org-id format")
    ...

@security_agent.tool
def list_tickets(ctx,status: str) -> list[Ticket]:
 """List tickets based on the provided filters and context.

    Retrieves ticket records matching the specified criteria. All filter parameters are optional
    and can be combined to create complex queries.

    Args:
    ...
"""
    return fetch_tickets_from_db(status)
错误处理
在使用工具时,我们希望告知 LLM(大语言模型)它调用工具时使用了错误的参数。抛出异常并不是一个可行的方案,因为那会导致整个工作流程失败。
相反,我们决定使用字符串向 LLM 指示错误,引导它纠正自己的失误。
class TicketType(pydantic.BaseModel):
    """Model for a single ticket"""

    id: int = pydantic.Field(None, description="Ticket identifier")
    key: str = pydantic.Field(None, description="Ticket key in org-id format")
    ...

@security_agent.tool
def list_tickets(ctx,status: str) -> list[Ticket]:
 """List tickets based on the provided filters and context.

    Retrieves ticket records matching the specified criteria. All filter parameters are optional
    and can be combined to create complex queries.

    Args:
    ...
"""
    if status in ALLOWED_STATUS:
        return fetch_tickets_from_db(status)
    else:
        return f"Error: invalid status was provided, status should be one off {ALLOWED_STATUS}"
处理大型数据集
在处理大型数据集时,例如攻击面中的潜在节点,我们必须确保 AI 能够高效地处理和检索相关信息。为此,我们优化了上下文长度,并实现了分页机制,以在不超出模型限制的前提下处理海量信息。
class TicketsType(pydantic.BaseModel):
    """Paginated tickets response type."""

    total: int
    page: int
    tickets: list[TicketType]

@security_agent.tool
def list_tickets(ctx,status: str,page:int,count:int=10) -> TicketsType:
    return fetch_tickets_from_db(status=status,count=count,page=page)
这让我们能够避免向 AI 智能体传递过多或不必要的数据,也避免耗尽所用 LLM 模型的上下文窗口。
为回答问题而检索数据
为了增强 Copilot 回答平台相关用户问题的能力,我们需要以某种方式让智能体获取有关平台的信息以及有哪些可用功能。所幸,我们早已完成了记录所有功能及其使用方法的工作,这就是我们的文档。
我们使用 FAISS 为整套文档建立索引,并将其作为一个工具提供给智能体,以搜索与用户问题相关的细节。
起初,我们决定将图像和视频与 Markdown 文档一同索引,以便模型能够生成视觉丰富的响应。虽然这种方法在某些情况下效果不错,但也导致了幻觉。经过进一步调查,我们发现图像和视频缺乏足够的文本上下文,这让智能体感到困惑,并导致了不准确的响应。最终,我们优先采用仅基于文本的索引,并在必要时有选择地引入视觉内容。
具备上下文感知能力的智能体
当用户在与平台交互时,它需要确切地知道用户在数据层面看到了什么、以及用户正在看什么。例如,如果用户正处于某个工单页面,AI 智能体就需要知道用户身处何处、正在看什么。
我们确实更新了 UI,使得每当我们向智能体发送消息时,都会附带一个表示用户 POC 的上下文对象
{
  "question": "What this ticket is about?",
  "context": {
    "page": "/remediation/tickets/os-11638",
    "ticketKey": "os-11638"
  }
}
安全影响
为了确保 AI 智能体在用户权限范围内运行,我们对所有工具实施了严格的授权控制。每个工具都以与发起请求的用户相同的访问级别和权限执行,从而防止未经授权的操作。
我们使用 Python 装饰器来确保只有具备必要权限的用户才能调用工具:
@permissions.require_permission(PermissionAction.READ)
@security_agent.tool
def list_tickets(ctx, status: str) -> list:
    return fetch_tickets_from_db(status)
这些智能体工具还引入了一类全新的输入注入向量,必须对其进行测试并实现自动化,但这些我们稍后再谈 🙂。
结语
实现 Ostorlab Copilot AI 智能体是一段既激动人心又充满挑战的旅程。不过它尚未结束,我们已经在着手一系列新的功能扩充,从改进的 UI、推理能力到高级的后台交互。
通过精心选择框架、模型和集成方法,我们打造了一款强大而高效的助手,提升了用户体验。
尽管结构化 UI 响应和模型不一致等挑战依然存在,但我们迭代式的方法让我们能够持续提升 Copilot 的能力。
致谢
我们谨向以下为 Ostorlab Copilot 项目不懈努力的贡献者致以衷心的感谢:
- Adnane Serrar
- Anas Zouiten
- Mohamed El Yousfi
- Mouhcine Narhmouche
- Othmane Hachim
- Rabson Phiri
他们的奉献与专业知识对于将这个项目变为现实而言弥足珍贵。