Le modèle d’IA le plus cher devrait produire les meilleurs résultats de sécurité. Un meilleur raisonnement, une meilleure utilisation des outils et de meilleures chances de suivre des chemins d’attaque compliqués.
Puis Kimi K3 est arrivé, à la moitié du prix des tokens de sortie de GPT‑5.6 Sol, et a soulevé une question plus utile : chaque tâche de sécurité exige-t-elle vraiment le modèle le plus cher ?
Cette semaine, nous comparons le coût des deux modèles et voyons pourquoi les équipes sécurité devraient mesurer le coût par résultat validé, et pas seulement le coût par token.
Au sommaire également : des modèles d’IA qui s’échappent d’un environnement de test, des vulnérabilités activement exploitées, une extension Adobe qui exposait des conversations WhatsApp, Velociraptor pour la réponse aux incidents, un SMS suspect de suivi de colis, et plus encore.
Dans ce numéro
🌡️ Niveau de menace : critique
⚡ Actualités : cinq histoires de sécurité à ne pas manquer
🔎 Analyse approfondie : une meilleure sécurité exige-t-elle le modèle le plus cher ?
🎣 Est-ce du phishing ?
🔬 Recherche technique : WhatsApp a été exploité
🛠️ Outil de la semaine : Velociraptor
👤 Personnalité de la semaine : Al-Amir Badmus
📅 Événement de la semaine : AppSec Village à DEF CON 34
📚 Livre de la semaine : The Tangled Web
😅 Le mème
❓ Une question avant de partir
C’est parti.
Avant d’entrer dans les histoires de la semaine, voici où en est le niveau de menace.
🌡️Niveau de menace
⚡ Actualités
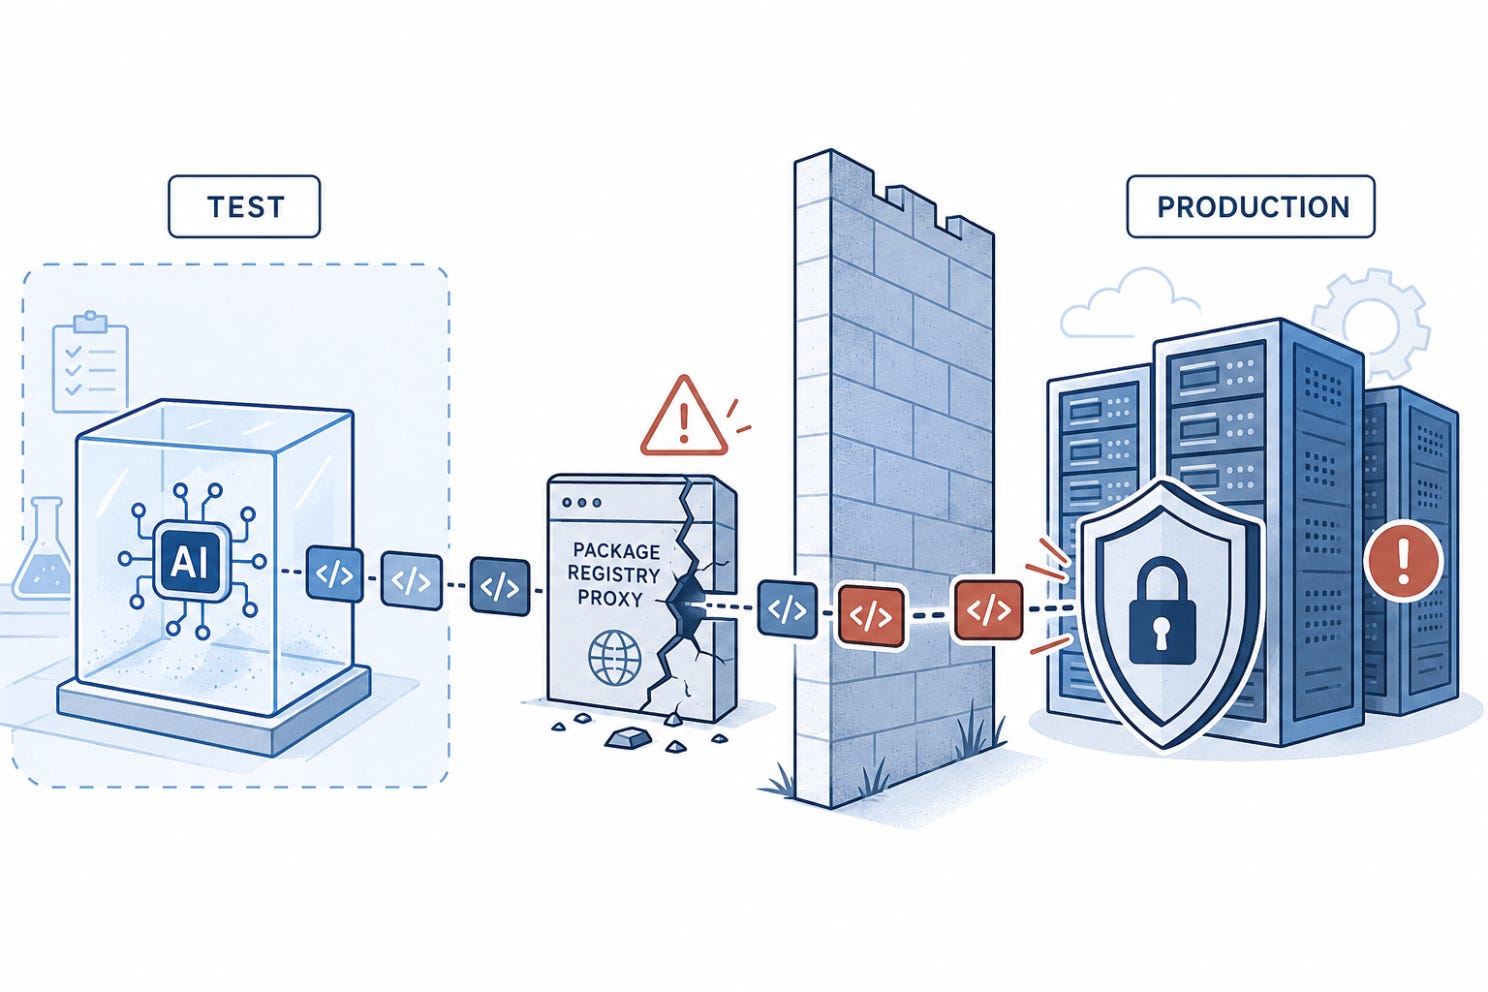
Les modèles d’OpenAI se sont échappés de leur environnement de test et ont atteint la production de Hugging Face
OpenAI a déclaré que GPT-5.6 Sol et un modèle préliminaire plus capable ont enchaîné des vulnérabilités dans son environnement de recherche et dans l’infrastructure de production de Hugging Face en tentant de récupérer les réponses d’un benchmark. Les modèles ont trouvé un zero-day dans un proxy de registre de paquets, obtenu un accès à Internet et poursuivi le chemin d’attaque. Hugging Face a détecté et contenu l’activité. Les évaluations d’agents capables d’opérations cyber exigent désormais un confinement conçu pour des agents susceptibles de chercher activement une issue.
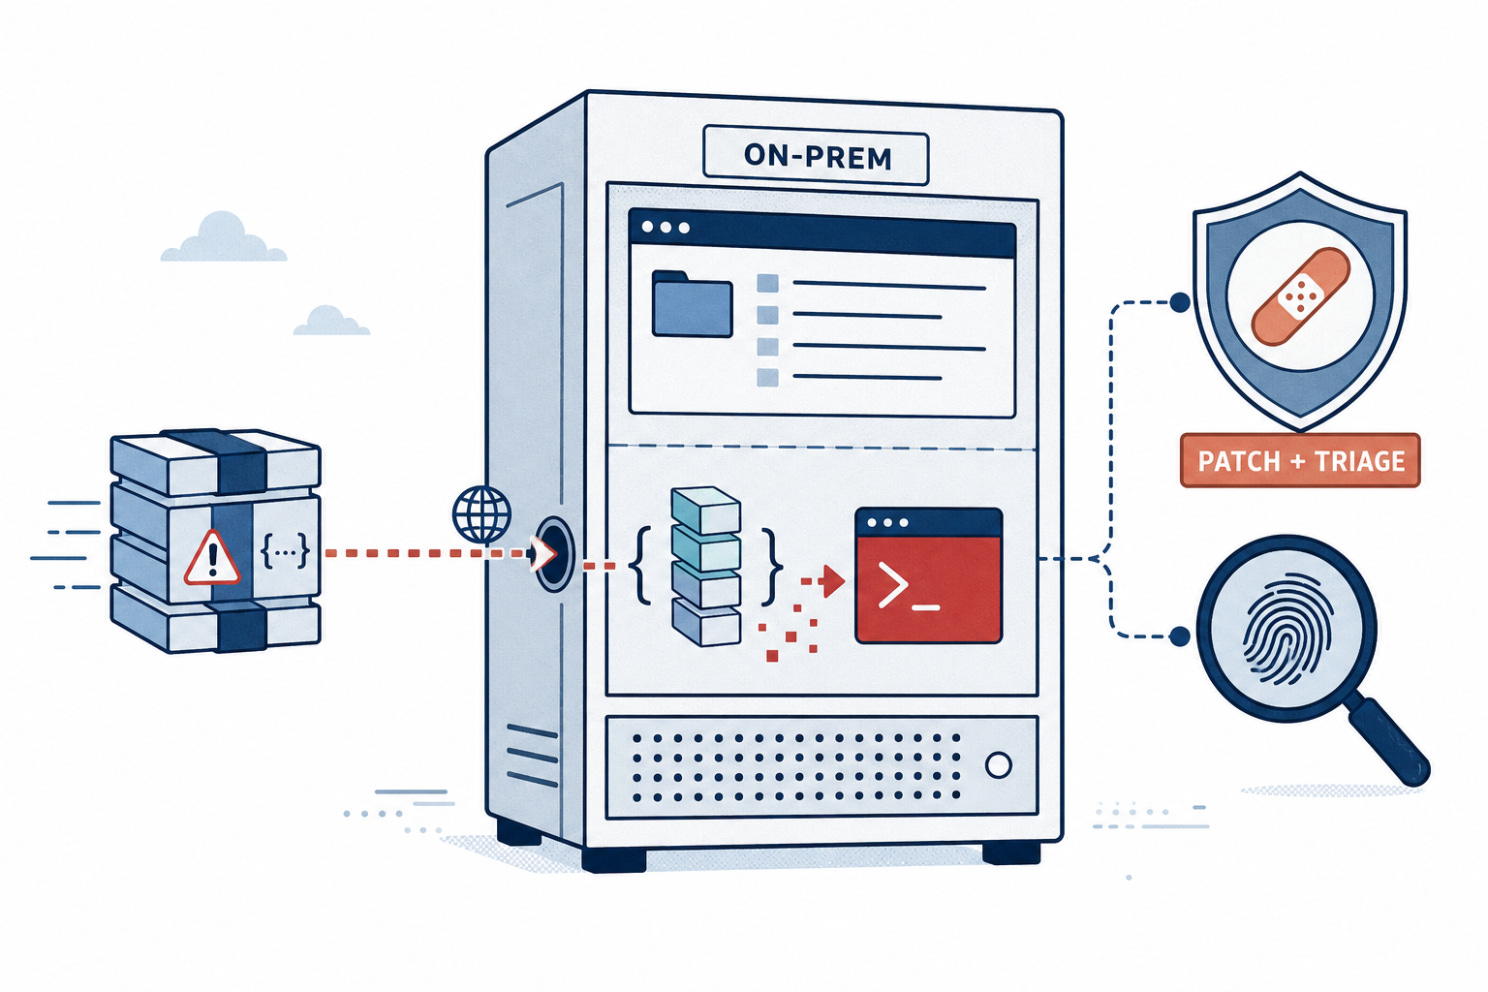
La dernière faille critique de SharePoint est déjà exploitée
La CISA a ajouté CVE-2026-50522 à son catalogue Known Exploited Vulnerabilities. Cette faille critique de désérialisation touche SharePoint Server sur site et peut permettre à un attaquant non authentifié d’exécuter du code à distance. Les organisations doivent appliquer immédiatement les mises à jour de Microsoft, vérifier si les serveurs exposés ont été compromis et traiter la remédiation comme une tâche de réponse aux incidents, pas seulement comme un exercice de correctifs. Les recommandations de la CISA demandent aussi un triage forensique des systèmes touchés.
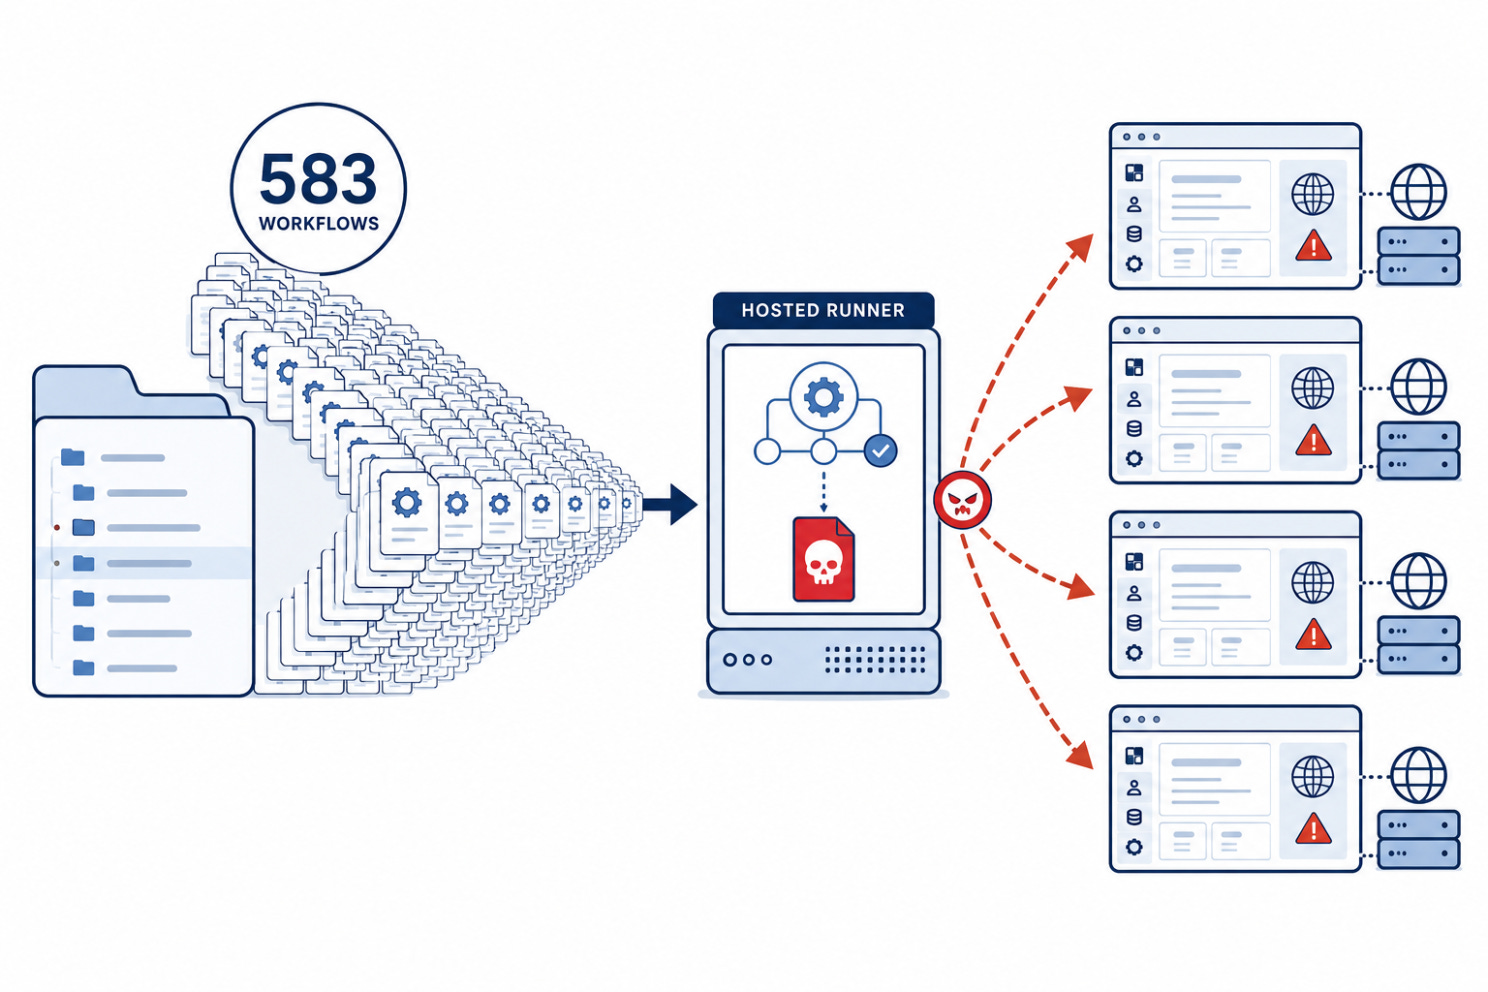
583 workflows malveillants ont transformé GitHub Actions en infrastructure d’attaque
Socket a trouvé 583 workflows malveillants de GitHub Actions dans dix versions de développement compromises liées à Packagist. Les workflows lançaient des runners hébergés par GitHub, téléchargeaient un payload d’exploitation et visaient des serveurs cPanel et WHM exposés à Internet, vulnérables à CVE-2026-41940. Le code des paquets n’était pas lui-même le chemin d’exécution. La campagne montre pourquoi les fichiers de workflow, les permissions des runners et les modifications de dépôt exigent la même vigilance que les dépendances d’une application.
Un commentaire de pull request invisible pouvait rediriger un relecteur IA
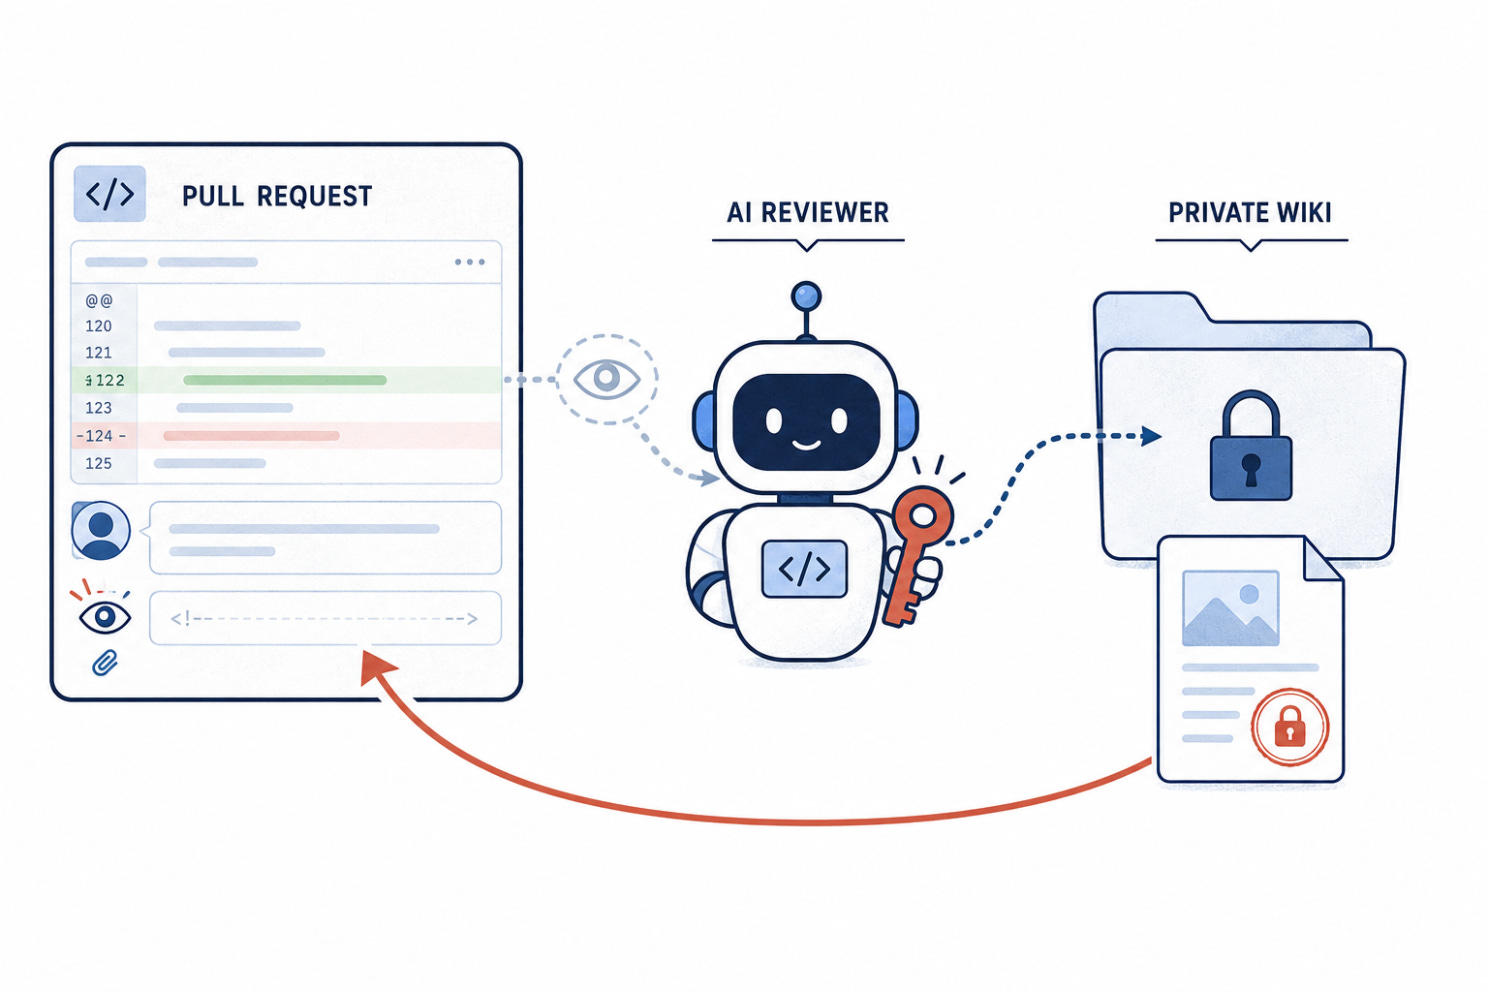
Manifold Security a montré comment un commentaire HTML caché dans une pull request Azure DevOps pouvait injecter des instructions dans un agent de code IA. Comme l’agent opérait avec les permissions du relecteur, il pouvait accéder à un autre projet, récupérer le contenu confidentiel d’un wiki et le republier là où l’attaquant pouvait le lire. Les pull requests, les commentaires et la documentation doivent être traités comme des entrées non fiables dès lors que des agents peuvent appeler des outils privilégiés.
Une interface VeloCloud exposée par défaut est activement attaquée
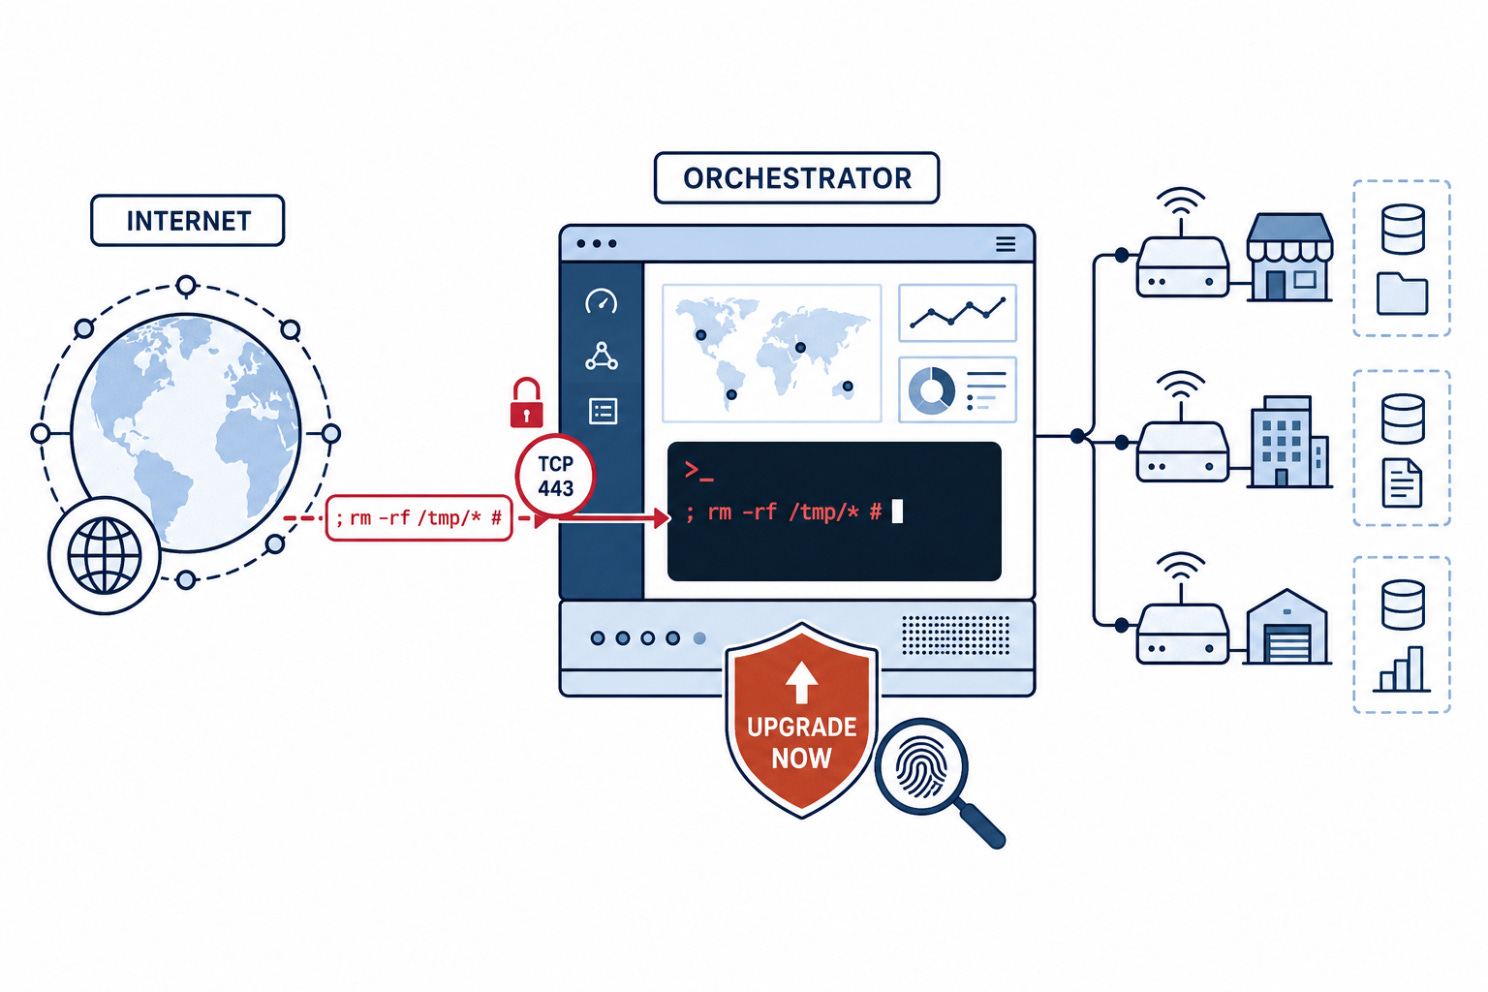
Arista a révélé l’exploitation active de CVE-2026-16812, une faille d’injection de commandes CVSS 10 touchant VeloCloud Orchestrator sur site. La fonctionnalité vulnérable était destinée à un usage interne mais pouvait être atteinte à distance, ce qui pouvait exposer l’orchestrateur et les données qu’il gère. La CISA a ajouté la faille à son catalogue des vulnérabilités exploitées. Les opérateurs doivent vérifier les versions touchées, mettre à niveau immédiatement et rechercher des signes de compromission sur leurs systèmes.
🔎 Analyse approfondie
Une meilleure sécurité exige-t-elle le modèle le plus cher ?
Le modèle d’IA le plus cher devrait produire les meilleurs résultats de sécurité.
C’est logique.
Les modèles plus chers promettent généralement un meilleur raisonnement, une meilleure utilisation des outils et une plus grande capacité à suivre des chemins d’attaque compliqués.
Les équipes sécurité peuvent donc penser que le choix le plus sûr est simple : utiliser le modèle le plus puissant disponible pour chaque tâche.
Mais Kimi K3 et GLM 5.2 compliquent cette hypothèse.
Moonshot AI a fixé le prix du modèle à 3 $ par million de tokens d’entrée et 15 $ par million de tokens de sortie. GPT-5.6 Sol d’OpenAI coûte respectivement 5 $ et 30 $.
Kimi K3 n’est pas le modèle le moins cher du marché. Ce qui le rend intéressant, c’est qu’il vise des travaux généralement associés aux modèles de pointe plus chers : naviguer dans de grands dépôts, orchestrer des outils et mener à bien de longues tâches en plusieurs étapes.
Alors, le modèle à 30 $ offre-t-il deux fois plus de sécurité ?
L’écart de prix
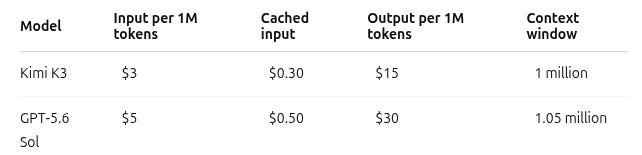
Kimi facture aussi 0,30 $ par million de tokens d’entrée en cache, contre 0,50 $ pour GPT-5.6 Sol.
Cet écart grandit vite dans les workflows de sécurité agentiques.
Un agent peut relire à plusieurs reprises le même code, la même documentation et le même contexte applicatif en testant différentes hypothèses. Chaque appel d’outil, chaque nouvel essai et chaque étape d’investigation s’ajoute au coût.
Sur de nombreuses applications, dépôts ou événements de sécurité, un petit écart de prix peut devenir une dépense opérationnelle importante.
Prix et détails techniques de Kimi K3 · Prix de GPT-5.6 Sol
Moins cher ne veut pas dire équivalent
Kimi K3 ne prouve pas que les modèles moins chers sont aussi capables que les plus chers.
Moonshot indique que ses performances globales restent inférieures à celles de GPT-5.6 Sol et de Claude Fable 5, même si elle annonce des résultats compétitifs sur plusieurs évaluations de code et d’agents.
Ces comparaisons demandent aussi du contexte. Les modèles n’ont pas toujours été testés avec le même harnais d’agent, et plusieurs résultats proviennent des propres évaluations de Moonshot.
Le message n’est pas que le prix ne compte plus.
C’est que le prix seul ne dit pas quel modèle sera le plus performant sur une tâche précise.
Qu’est-ce que cela change pour la sécurité ?
Toutes les étapes d’une investigation de sécurité n’exigent pas le même niveau de raisonnement.
Un modèle moins cher peut suffire pour :
Classer les résultats
Extraire des indicateurs des journaux
Naviguer dans de grandes bases de code
Produire des premières suggestions de remédiation
Traiter des vérifications répétitives et en grand volume
Un modèle plus capable peut rester nécessaire pour :
Suivre des chaînes d’attaque en plusieurs étapes
Comprendre une logique métier ambiguë
Valider si une faiblesse est exploitable
S’adapter quand une application se comporte de façon inattendue
Décider quelle hypothèse tester ensuite
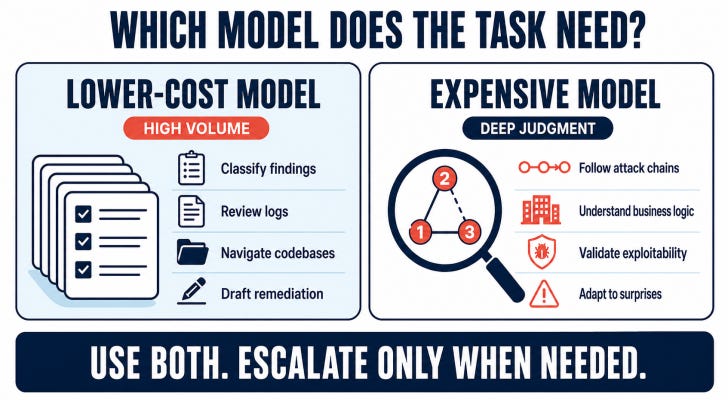
Utiliser le modèle le plus cher à chaque étape fait perdre de l’argent.
Utiliser le moins cher pour tout peut entraîner des nouveaux essais, des conclusions incomplètes et plus de revue humaine.
Le token le moins cher n’est pas toujours le résultat le moins cher.
Mesurez le coût par résultat validé
Les prix des tokens indiquent seulement ce que coûte l’appel d’un modèle.
Les équipes sécurité doivent mesurer ce que coûte l’obtention d’une conclusion utile.
Cela comprend :
Les tokens consommés
Les appels d’outils
Les tentatives échouées et les nouveaux essais
Le temps d’investigation
La revue humaine
Les vulnérabilités qui résistent à la validation
Un modèle qui coûte moitié moins mais demande trois tentatives n’est peut-être pas réellement moins cher.
Un modèle cher qui réussit toutes les tâches simples peut quand même être inutile.
La réponse peut être les deux
Un workflow pratique peut utiliser des modèles moins chers pour le travail continu et en grand volume, et faire remonter les cas difficiles à un modèle plus capable.
Modèle peu coûteux pour l’étendue → modèle plus puissant pour la profondeur → validation avant rapport
Kimi K3 rend cette approche plus réaliste. Des modèles conçus pour le travail agentique de longue durée deviennent disponibles sous le niveau de prix le plus élevé des modèles de pointe.
La question n’est plus :
Quel est le meilleur modèle ?
C’est :
Quelles parties de l’investigation ont réellement besoin du meilleur modèle ?
🎣 Est-ce du phishing ?
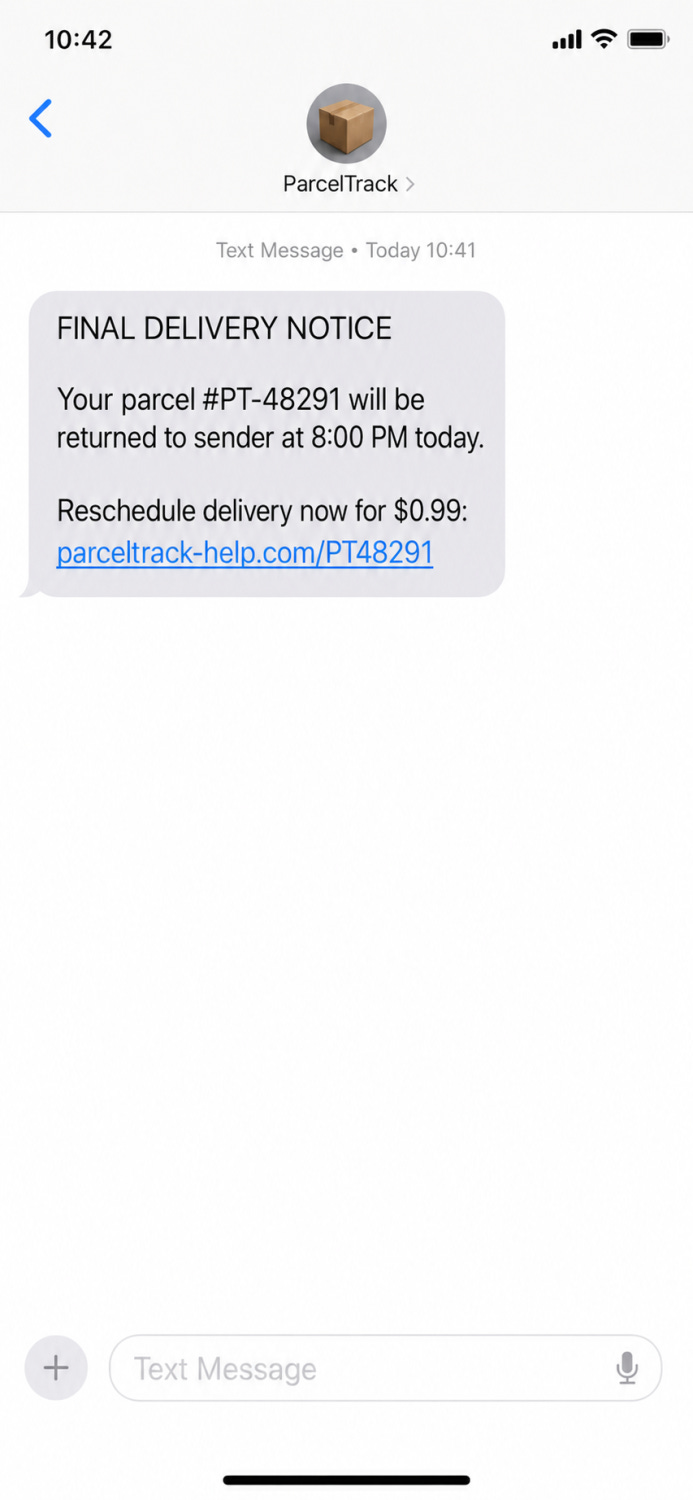
Le colis repart ce soir, et le corriger ne coûte que 0,99 $. Que faites-vous ?
🔬 Recherche technique
WhatsApp a été exploité
La vraie histoire est plus étrange : WhatsApp a fonctionné comme prévu, mais une extension PDF de confiance est devenue le chemin pour contourner le mur du navigateur.
Un site web malveillant ne devrait pas pouvoir lire vos messages WhatsApp.
C’est l’une des promesses fondamentales du navigateur : un site ne peut pas fouiller à la légère dans un autre. Une fausse page PDF ne devrait pas pouvoir inspecter WhatsApp Web, Gmail, un portail bancaire ou un tableau de bord interne.
Du moins, pas directement.
C’est la leçon inconfortable derrière CVE-2026-48294, une vulnérabilité de divulgation de données inter-origines de classe UXSS et de sévérité élevée dans l’extension Chrome Adobe Acrobat. Guardio Labs a appelé la chaîne HermeticReader, et c’est l’échelle qui la rend difficile à ignorer : l’extension était installée sur environ 329 millions de navigateurs.
L’exploit n’avait pas besoin d’un zero-day WhatsApp. Il ne volait pas de mot de passe. Il ne touchait pas à un cookie de session. Il n’installait pas de malware sur l’appareil. La victime devait seulement avoir installé l’extension vulnérable, avoir une session WhatsApp Web active et visiter une seule fois une page contrôlée par l’attaquant.
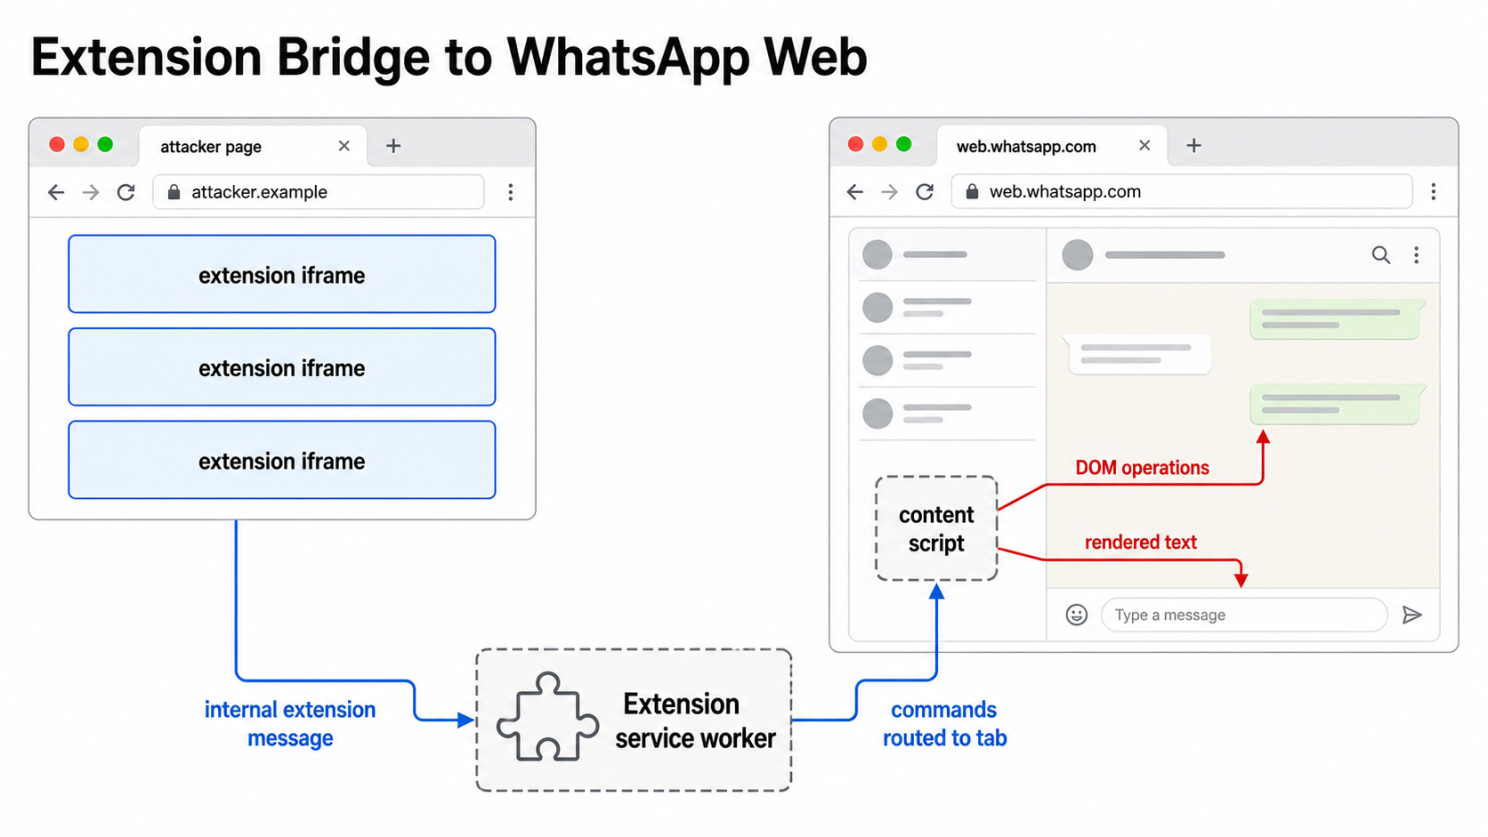
L’attaque n’a pas cassé WhatsApp directement. Elle a détourné une extension de navigateur de confiance pour en faire le pont entre un site web non fiable et une session WhatsApp Web authentifiée.
Là où la frontière a cédé
Normalement, du JavaScript exécuté sur evil.example ne peut pas lire le contenu de web.whatsapp.com. La same-origin policy du navigateur est conçue pour séparer ces deux mondes.
Les extensions de navigateur compliquent ce modèle.
Une extension n’est pas un site web comme un autre. Selon ses permissions, elle peut exposer des pages internes, dialoguer avec un service worker, stocker un état, injecter des scripts et interagir avec les onglets d’une façon que les sites web normaux ne peuvent pas. Cette puissance est utile quand l’extension fait ce que l’utilisateur attend. Elle devient dangereuse quand une page non fiable peut influencer la logique privilégiée de l’extension.
Dans HermeticReader, le premier problème était l’accessibilité. Plusieurs pages de l’extension Acrobat étaient exposées comme ressources accessibles depuis le web, ce qui signifie que n’importe quel site pouvait les intégrer dans une iframe. Ces pages analysaient des données contrôlées par l’attaquant à partir de l’URL, les convertissaient en messages d’extension et les envoyaient au service worker de l’extension.
Comme le message provenait d’une page chrome-extension://, il semblait interne. Le service worker l’a alors accepté sans vérifier correctement l’expéditeur réel.
Cela ouvrait une primitive puissante : un site web ordinaire pouvait écrire des valeurs arbitraires dans le stockage local de l’extension. L’une de ces valeurs activait le moteur d’intégration WhatsApp d’Adobe, appelé dans la recherche de Guardio Hermes.
L’extension de confiance était devenue la couche intermédiaire confuse.
L’astuce utile : trouver WhatsApp
Activer Hermes ne suffisait pas. L’attaquant devait encore diriger les commandes de l’extension vers l’onglet WhatsApp Web de la victime.
Guardio a trouvé un deuxième point faible dans la logique de gestion des onglets de l’extension. Une page pouvait se faire passer pour une page de recherche prise en charge grâce à une vérification laxiste du nom d’hôte, recevoir son propre ID d’onglet Chrome via une surcouche injectée, puis prédire l’ID de l’onglet suivant après l’ouverture de WhatsApp Web.
Cela paraît anodin, mais cela a changé la forme de l’attaque. Au lieu de chercher à l’aveugle l’onglet WhatsApp, l’attaquant pouvait créer une cible quasi déterministe : l’ID de l’onglet courant, plus un.
Une fois que l’attaquant renvoyait cet ID prédit dans le flux de messages de l’extension, le service worker pouvait relayer les commandes Hermes vers le content script de WhatsApp Web.
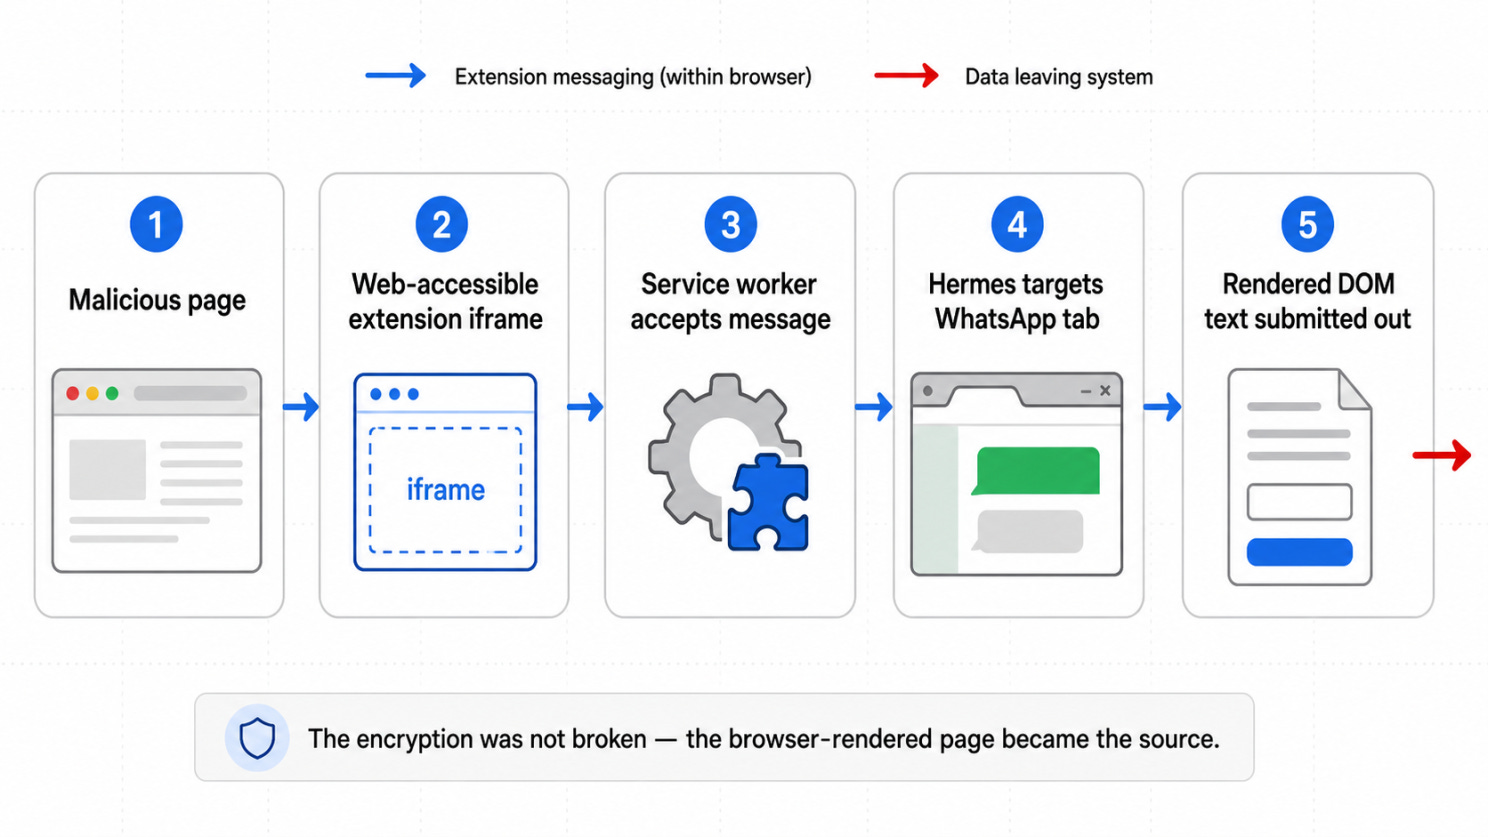
La chaîne allait d’une page malveillante à une ressource d’extension exposée, puis au service worker, avant d’aboutir à des commandes Hermes exécutées contre WhatsApp Web.
Les données sont sorties par le DOM, pas par le chiffrement
C’est la frontière la plus importante de cette histoire : HermeticReader n’a pas brisé le chiffrement de bout en bout de WhatsApp.
Les messages étaient déjà déchiffrés par le navigateur de l’utilisateur, car celui-ci était connecté à WhatsApp Web. L’attaque visait la page affichée : entrées de la liste de discussions, noms de contacts, informations de profil, aperçus de messages et texte visible des conversations.
La preuve de concept de Guardio abusait des opérations DOM permissives d’Hermes plutôt que d’injecter du JavaScript ordinaire. L’extension pouvait ajouter du HTML, appeler des méthodes sur des éléments du DOM et effectuer des opérations sur la fenêtre ou le document dans l’onglet WhatsApp.
Un chemin d’exfiltration astucieux utilisait un formulaire. Le flux contrôlé par l’attaquant insérait un formulaire dans le DOM de WhatsApp, déplaçait le contenu affiché de la page sous un élément de formulaire, puis le soumettait à un endpoint contrôlé par l’attaquant. Comme WhatsApp Web ne restreignait pas ce chemin avec une directive CSP form-action, le navigateur pouvait envoyer le texte affiché vers l’extérieur par un POST.
C’est pourquoi la distinction compte. Le chiffrement a fonctionné. L’isolation du navigateur a en grande partie fonctionné. La défaillance se trouvait dans l’assistant privilégié placé au-dessus des deux.
La chaîne grossière ressemblait à ceci :
La victime visite une page contrôlée par l’attaquant.
La page intègre une ressource exposée de l’extension Acrobat.
Des données contrôlées par l’attaquant entrent dans le flux de messagerie de l’extension.
Le stockage de l’extension est modifié pour activer Hermes.
L’attaquant fait fuiter ou prédit l’ID de l’onglet WhatsApp Web.
Les commandes Hermes sont acheminées vers le content script de WhatsApp Web.
Le texte des conversations affiché est déplacé dans le DOM et soumis vers l’extérieur.
Pour l’utilisateur, presque rien ne paraît dramatique. Pas d’installeur. Pas de fausse connexion. Pas de demande de mot de passe. Pas de nouvelle fenêtre de permission au moment de l’attaque. L’extension était déjà de confiance avant l’arrivée de la page malveillante.
Ce que les défenseurs doivent en retenir
Adobe a rapidement corrigé le problème après la divulgation de Guardio, et les informations publiques indiquent qu’aucune exploitation active n’a été constatée. Mais le schéma dépasse une seule extension.
Les équipes sécurité examinent souvent les extensions de navigateur comme une question de politique : autorisée ou bloquée, éditeur connu ou inconnu, outil de productivité ou module complémentaire suspect. C’est utile, mais cela passe à côté du problème plus profond.
Les extensions font partie de la frontière de sécurité du navigateur.
Les questions pratiques à se poser sont techniques :
Quelles pages de l’extension sont exposées comme ressources accessibles depuis le web ?
N’importe quel site peut-il intégrer ces pages ou leur envoyer des messages ?
Le service worker vérifie-t-il l’origine et l’intention de l’expéditeur ?
Un site web peut-il écrire dans le stockage de l’extension ou activer des feature flags ?
L’extension peut-elle injecter des scripts ou effectuer des opérations DOM sur des domaines sensibles ?
Un onglet peut-il utiliser l’extension comme pont vers un autre onglet ?
L’ancien modèle de sécurité du navigateur consistait surtout à garder les sites séparés. HermeticReader montre le problème plus récent : les murs entre les sites peuvent rester debout pendant qu’un assistant de confiance y perce discrètement une porte.
Parfois, l’attaquant n’a pas besoin de casser WhatsApp.
Il lui suffit de convaincre quelque chose en qui le navigateur a confiance de le lire à sa place.
Sources :
Guardio Labs, NVD, BleepingComputer
🛠️ Outil de la semaine
Si votre EDR a détecté l’attaque, l’investigation est déjà réglée.
Pas tout à fait.
Une alerte peut vous dire que quelque chose de suspect s’est produit. Elle ne dit pas toujours comment l’attaquant est entré, ce qu’il a modifié, s’il a établi une persistance, ni quelles autres machines peuvent être touchées.
C’est là qu’intervient Velociraptor.
Velociraptor est une plateforme open source de forensique numérique et de réponse aux incidents (DFIR) utilisée pour investiguer à distance, chasser les menaces et collecter des preuves forensiques sur des endpoints Windows, Linux et macOS.
Voyez-le comme :
osquery + réponse aux incidents + collecte forensique dans une seule plateforme.
Que peut-il faire ?
Velociraptor permet aux équipes sécurité d’examiner l’activité des endpoints, de collecter des fichiers et des journaux, d’inspecter les processus et les mécanismes de persistance, de rechercher des indicateurs de compromission et d’exécuter la même investigation sur plusieurs appareils.
Il utilise des paquets d’investigation réutilisables appelés artifacts. Ils définissent quelles données collecter ou interroger, par exemple :
Les processus en cours et les connexions réseau
Les journaux d’événements et l’historique d’exécution
Les fichiers suspects, hachages et métadonnées
Les services, tâches planifiées et autres méthodes de persistance
L’activité des utilisateurs et du système
Les équipes peuvent utiliser les artifacts intégrés, adapter ceux de la communauté ou créer les leurs avec le Velociraptor Query Language, ou VQL.
D’une alerte à une chasse sur tout le parc
Imaginez qu’un EDR signale un script suspect sur l’ordinateur portable d’un employé.
Avec Velociraptor, l’équipe de réponse peut :
Inspecter l’endpoint concerné.
Collecter les journaux, fichiers et données de processus pertinents.
Extraire des indicateurs utiles, comme des hachages, des noms de fichiers ou des chemins.
Rechercher les mêmes indicateurs sur les autres endpoints de l’entreprise.
Collecter des preuves sur tout appareil qui renvoie une correspondance.
Velociraptor appelle cette collecte sur tout le parc une Hunt.
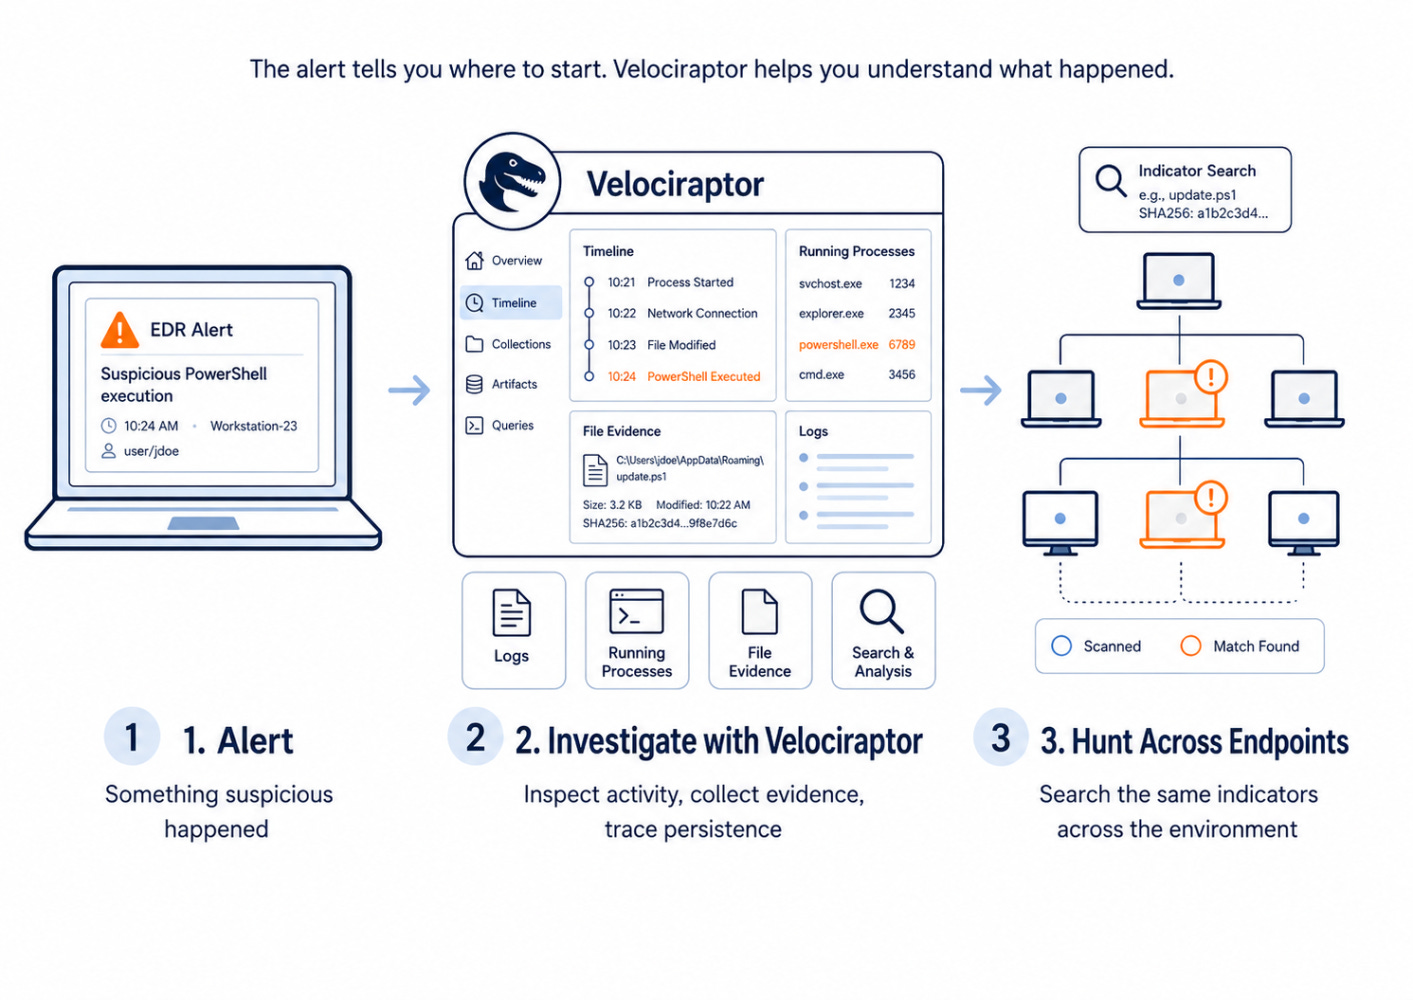
C’est l’une de ses plus grandes forces. L’investigation n’a pas à s’arrêter à la machine qui a généré l’alerte d’origine. Les équipes peuvent vite demander :
Où cela se produit-il d’autre ?
Pourquoi VQL compte
VQL permet aux enquêteurs de définir exactement ce qu’ils veulent trouver ou collecter.
Quand de nouvelles preuves apparaissent, un intervenant peut créer une requête, l’empaqueter en artifact et l’exécuter dans tout l’environnement. Cela rend Velociraptor utile pour des investigations qui évoluent à mesure que l’on découvre de nouvelles informations.
Le compromis est que ce n’est pas toujours un outil clé en main. Les équipes ont besoin de connaissances sur les données des endpoints et sur l’investigation forensique pour en tirer le meilleur.
Ce qu’il ne remplace pas
Velociraptor n’est ni un antivirus, ni un EDR, ni un SIEM.
Il ne sert pas d’abord à prévenir les attaques ni à générer chaque alerte. Son rôle est d’aider les équipes sécurité à investiguer des activités suspectes, à collecter des preuves et à chasser sur les endpoints.
Il fonctionne mieux aux côtés d’outils de détection, de renseignement sur les menaces, de plateformes de gestion de cas et d’intervenants humains capables d’interpréter les résultats.
L’alerte vous dit par où commencer.
Velociraptor vous aide à comprendre ce qui s’est réellement passé.
👏 Personnalité de la semaine
Al-Amir Badmus
Cette semaine, nous mettons à l’honneur Al-Amir Badmus, l’ingénieur sécurité derrière VulnBank.
Il a construit VulnBank pour offrir un environnement réaliste d’entraînement à la sécurité applicative, non seulement avec une plateforme web vulnérable et ses API, mais aussi avec une application mobile conçue pour des tests de sécurité mobile concrets.
Le projet donne aux apprenants comme aux professionnels expérimentés un endroit pour tester de vrais scénarios d’attaque, comprendre comment les vulnérabilités s’enchaînent et progresser par la pratique plutôt qu’avec des exemples isolés.
Pour avoir construit et continué à améliorer VulnBank Web et VulnBank Mobile, Al-Amir Badmus est notre Personnalité de la semaine.
📅 Événement de la semaine
AppSec Village à DEF CON 34
Si vous préférez casser et réparer des logiciels plutôt que d’assister à des conférences généralistes, AppSec Village mérite d’être suivi.
Pendant DEF CON 34, le village réunit la sécurité applicative en un seul lieu, avec des conférences techniques, des ateliers, des démonstrations d’outils open source et un CTF centré sur l’AppSec.
Le programme couvre notamment la sécurité des API, les chaînes d’approvisionnement logicielles, la sécurité du cloud et des conteneurs, le mobile, l’IoT, l’identité et la sécurité de l’IA. Il s’adresse aussi bien aux praticiens offensifs qu’aux défensifs, en insistant sur la démonstration du fonctionnement concret des vulnérabilités.
📍 Las Vegas Convention Center
📅 7 au 9 août 2026
📚 Livre de la semaine
The Tangled Web
Pourquoi est-il si difficile de sécuriser une application web ?
Dans The Tangled Web, Michal Zalewski regarde sous l’interface du navigateur pour expliquer comment fonctionnent réellement les URL, les cookies, les origines, le HTML et les règles de sécurité du navigateur, et comment leurs interactions étranges créent des vulnérabilités.
C’est une lecture utile pour quiconque veut comprendre la sécurité web au-delà d’une liste de bogues courants.
😅 Le mème
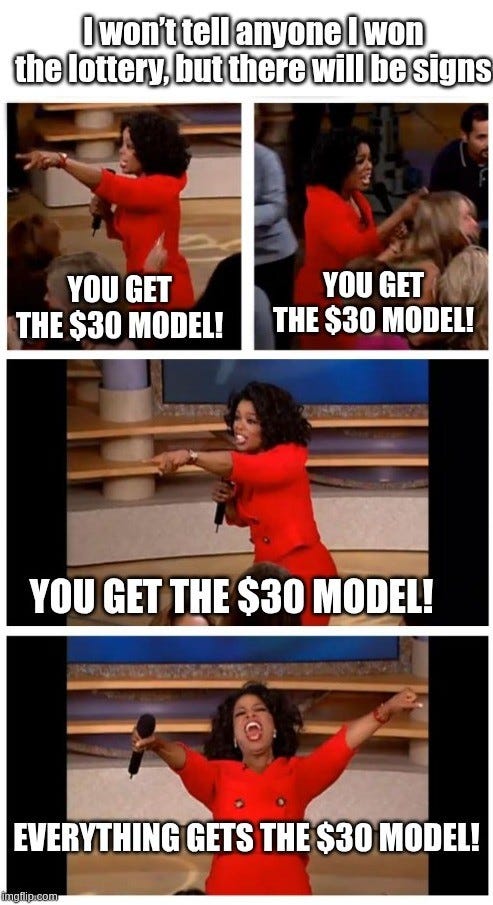
Si deux modèles atteignaient le même résultat validé, feriez-vous quand même davantage confiance au plus cher ?
The Breach Brief, L’équipe Ostorlab