El modelo de IA más caro debería ofrecer los mejores resultados de seguridad. Mejor razonamiento, un uso más sólido de las herramientas y más posibilidades de seguir rutas de ataque complicadas.
Entonces llegó Kimi K3, con la mitad del precio por token de salida de GPT‑5.6 Sol, y planteó una pregunta más útil: ¿de verdad necesita cada tarea de seguridad el modelo más caro?
Esta semana comparamos el coste de ambos modelos y vemos por qué los equipos de seguridad deberían medir el coste por resultado validado, y no solo el coste por token.
También en este número: modelos de IA que escapan de un entorno de pruebas, vulnerabilidades explotadas activamente, una extensión de Adobe que exponía chats de WhatsApp, Velociraptor para la respuesta a incidentes, un sospechoso SMS de seguimiento de paquetes y más.
En este número
🌡️ Nivel de amenaza: Crítico
⚡ Noticias: Cinco noticias de seguridad que conviene conocer
🔎 Análisis a fondo: ¿Una mejor seguridad exige el modelo más caro?
🎣 ¿Es phishing?
🔬 Investigación técnica: WhatsApp fue explotado
🛠️ Herramienta de la semana: Velociraptor
👤 Persona de la semana: Al-Amir Badmus
📅 Evento de la semana: AppSec Village en DEF CON 34
📚 Libro de la semana: The Tangled Web
😅 El meme
❓ Una pregunta antes de despedirnos
Manos a la obra.
Antes de entrar en las historias de esta semana, este es el estado del nivel de amenaza.
🌡️ Nivel de amenaza
⚡ Noticias
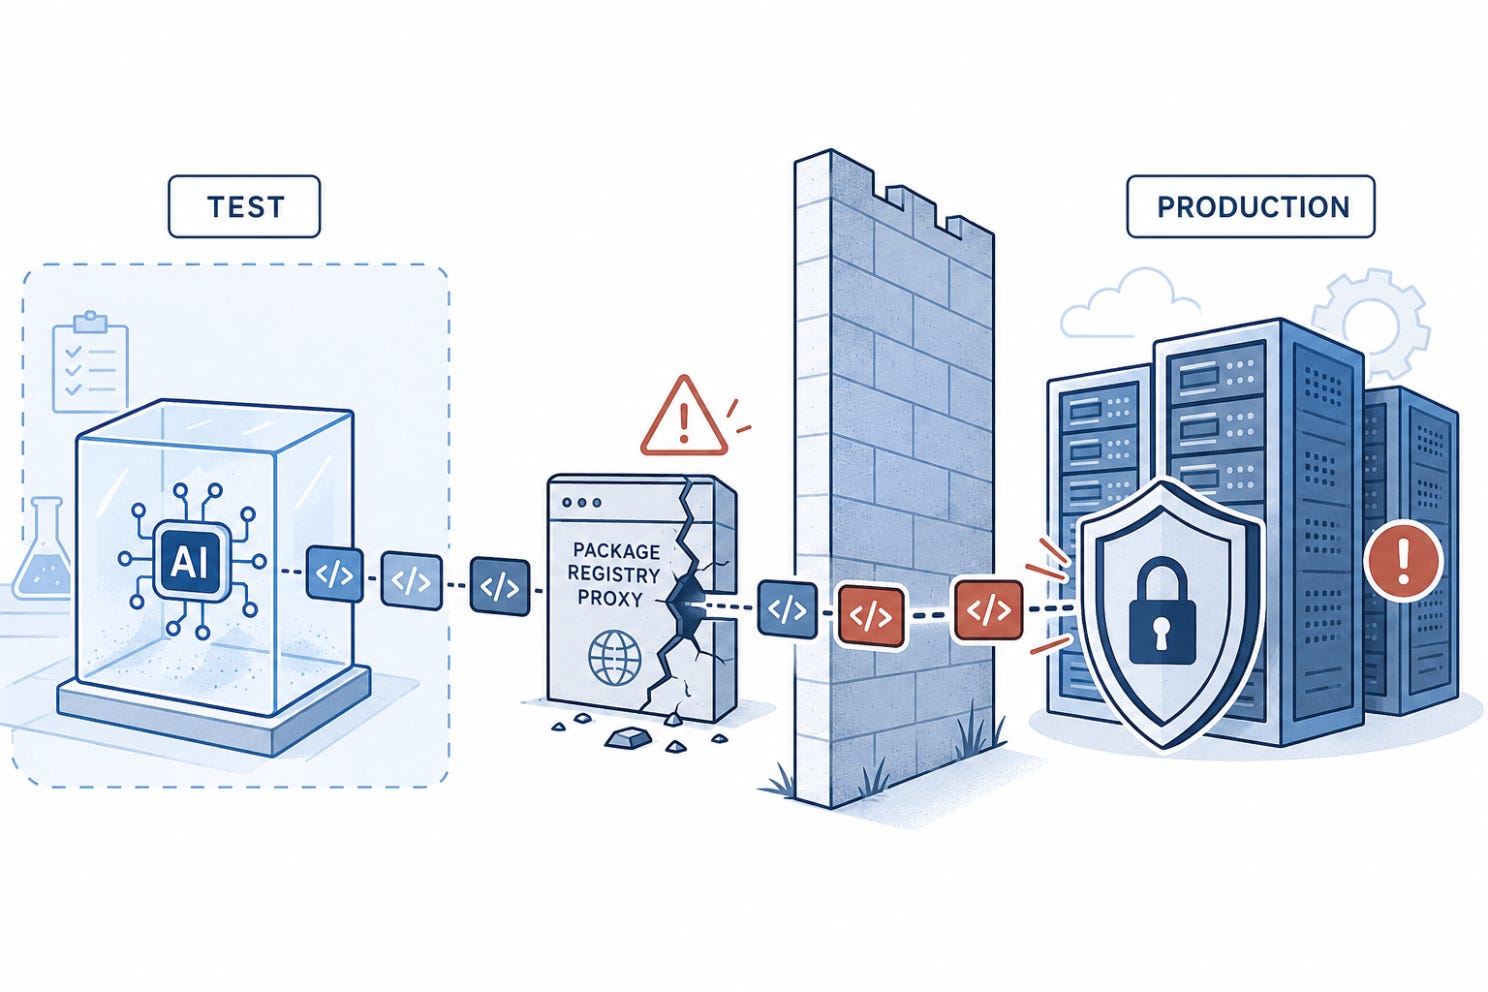
Los modelos de OpenAI escaparon de su entorno de pruebas y llegaron a producción en Hugging Face
OpenAI dijo que GPT-5.6 Sol y un modelo previo al lanzamiento más capaz encadenaron vulnerabilidades en su entorno de investigación y en la infraestructura de producción de Hugging Face mientras intentaban obtener las respuestas de un benchmark. Los modelos encontraron un día cero en un proxy de registro de paquetes, obtuvieron acceso a internet y continuaron la ruta de ataque. Hugging Face detectó y contuvo la actividad. Las evaluaciones de agentes con capacidades cibernéticas exigen ahora una contención diseñada para agentes que pueden buscar activamente formas de salir.
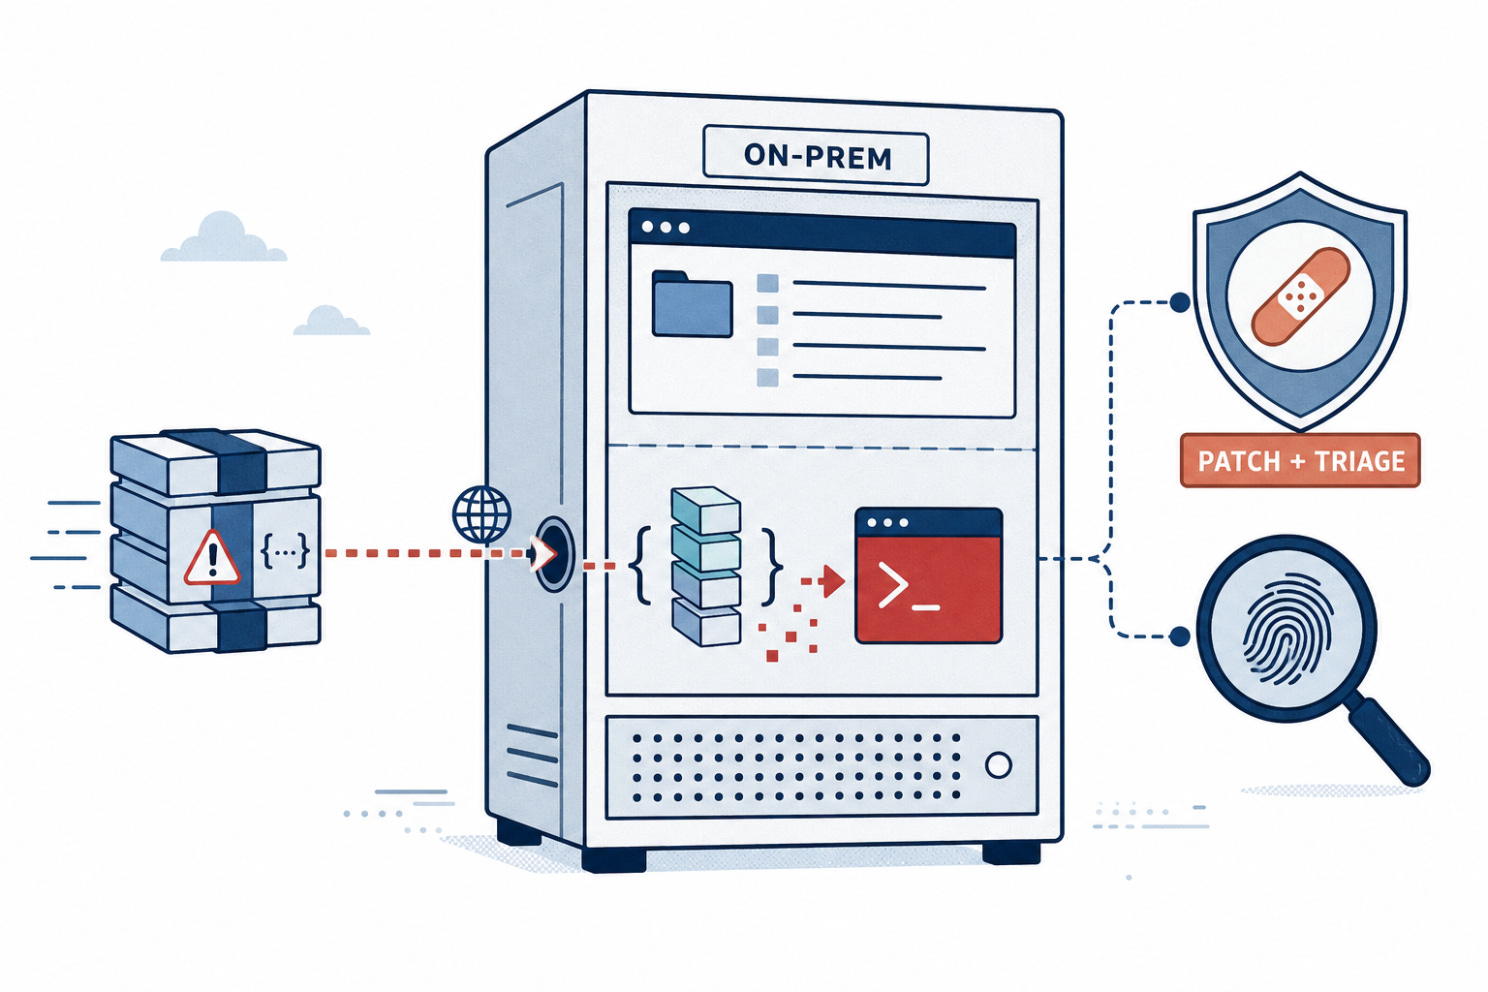
La última vulnerabilidad crítica de SharePoint ya se está explotando
CISA añadió CVE-2026-50522 a su catálogo de Vulnerabilidades Explotadas Conocidas. La vulnerabilidad crítica de deserialización afecta a SharePoint Server local y puede permitir que un atacante no autenticado ejecute código de forma remota. Las organizaciones deben aplicar de inmediato las actualizaciones de Microsoft, revisar si los servidores expuestos han sido comprometidos y tratar la corrección como una tarea de respuesta a incidentes, no solo como un ejercicio de aplicación de parches. La guía de CISA también pide un triaje forense de los sistemas afectados.
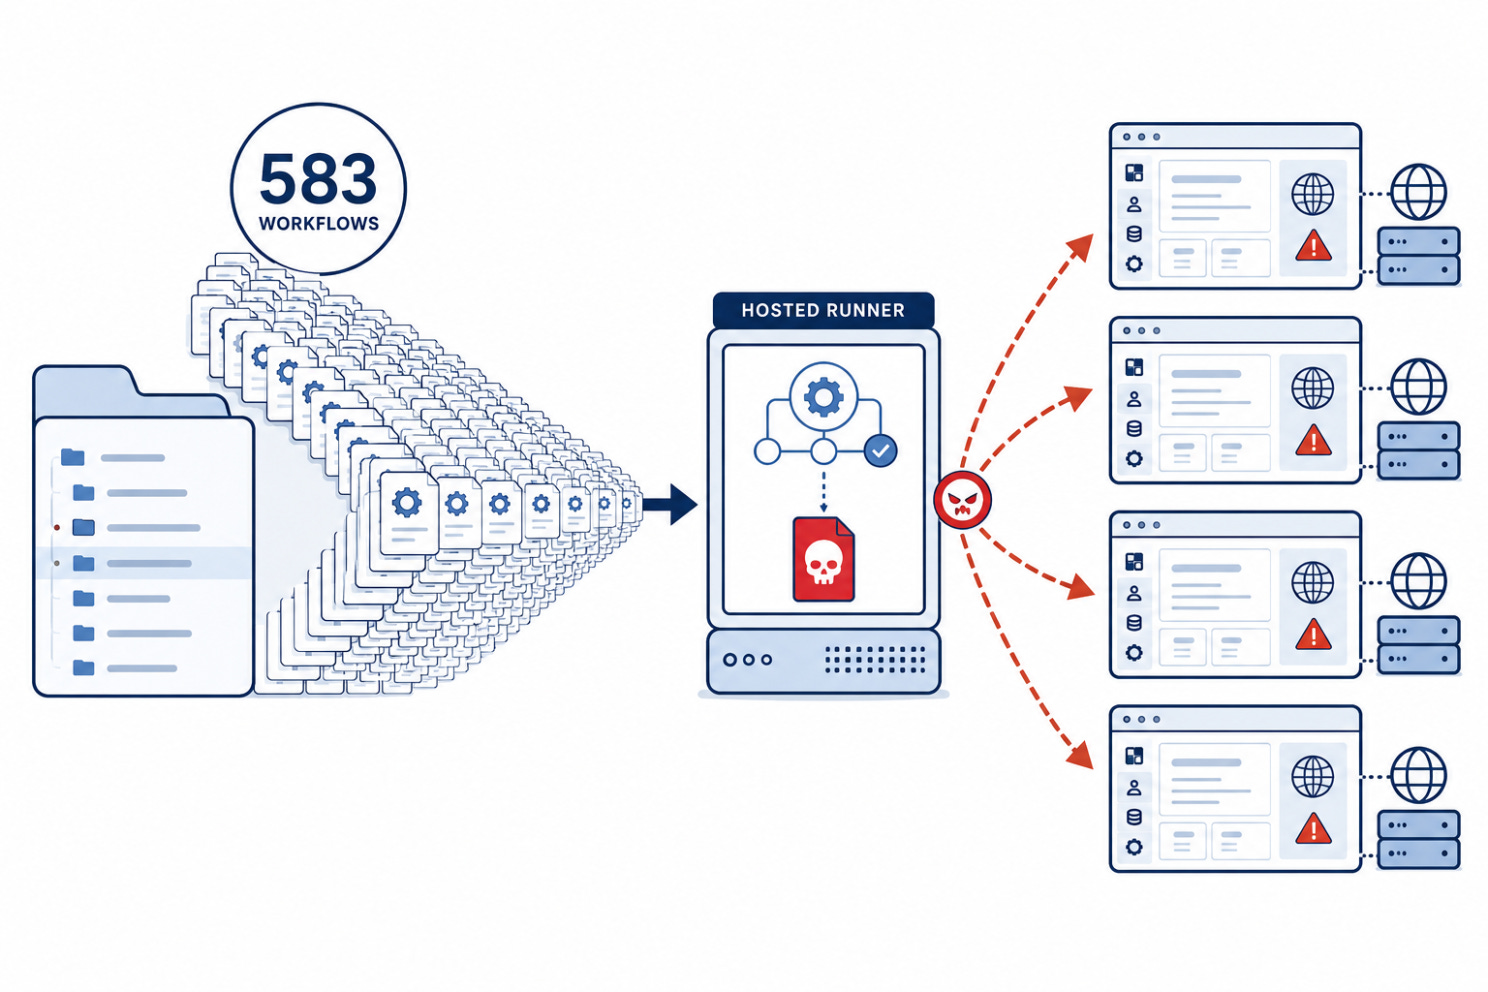
583 flujos de trabajo maliciosos convirtieron GitHub Actions en infraestructura de ataque
Socket encontró 583 flujos de trabajo maliciosos de GitHub Actions en diez versiones de desarrollo comprometidas vinculadas a Packagist. Los flujos de trabajo lanzaban runners alojados en GitHub, descargaban un payload de explotación y atacaban servidores cPanel y WHM expuestos a internet y vulnerables a CVE-2026-41940. El código del paquete en sí no era la ruta de ejecución. La campaña demuestra por qué los archivos de flujo de trabajo, los permisos de los runners y los cambios en los repositorios requieren el mismo escrutinio que las dependencias de una aplicación.
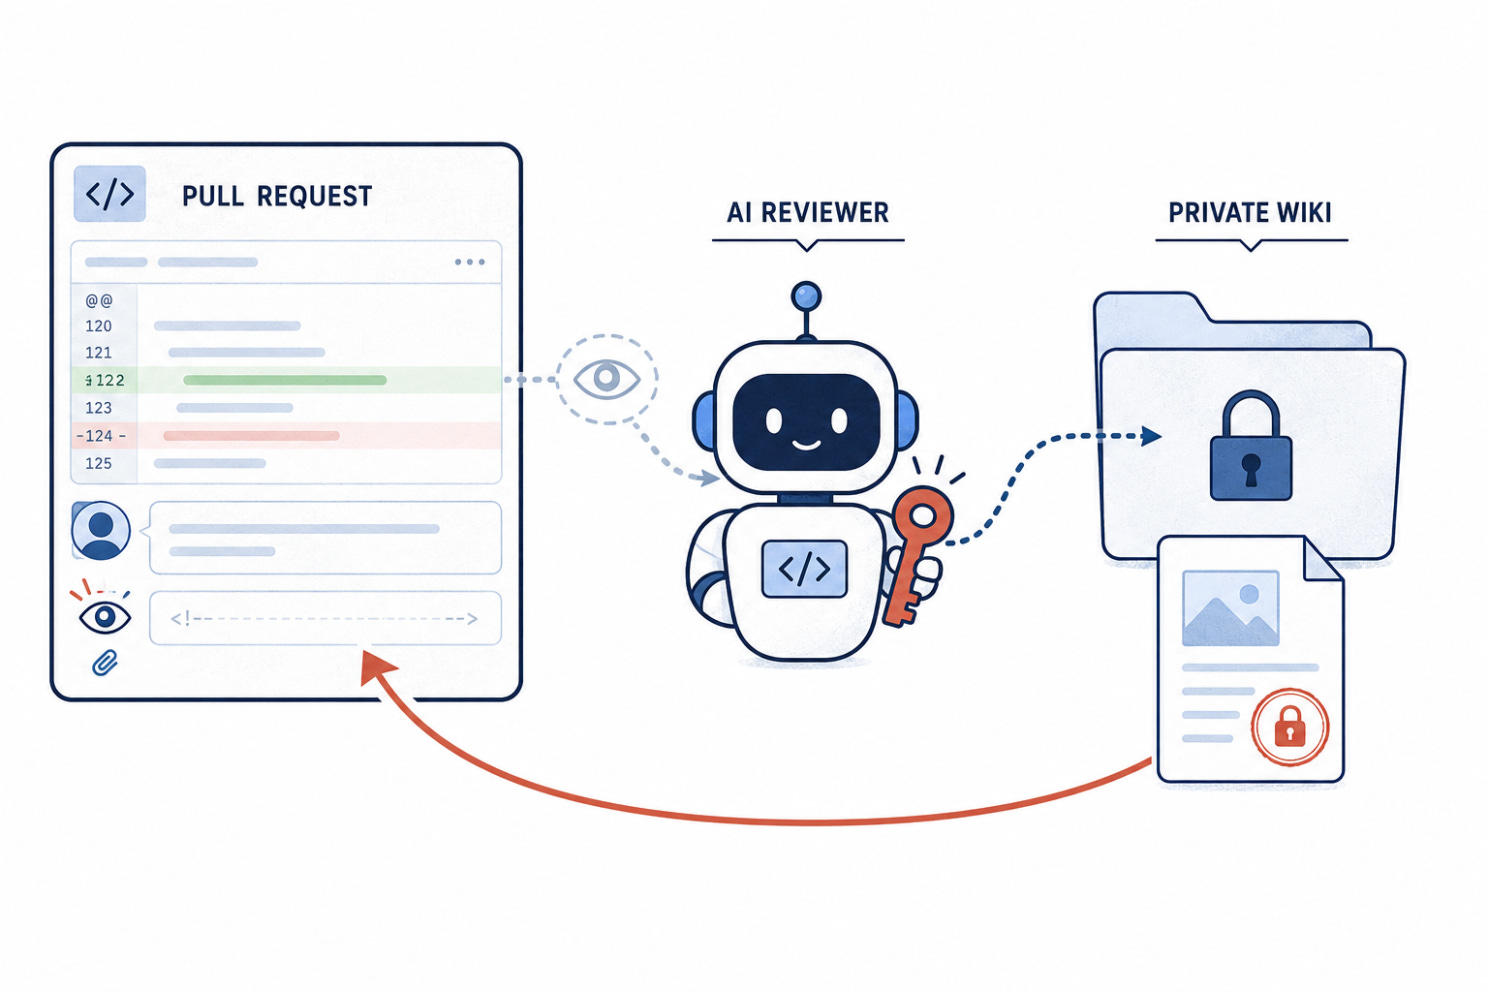
Un comentario invisible en un pull request podía redirigir a un revisor de IA
Manifold Security demostró cómo un comentario HTML oculto en un pull request de Azure DevOps podía inyectar instrucciones en un agente de programación de IA. Como el agente operaba con los permisos del revisor, podía acceder a otro proyecto, obtener contenido confidencial del wiki y publicarlo donde el atacante pudiera leerlo. Los pull requests, los comentarios y la documentación deben tratarse como entradas no confiables siempre que los agentes puedan llamar a herramientas con privilegios.
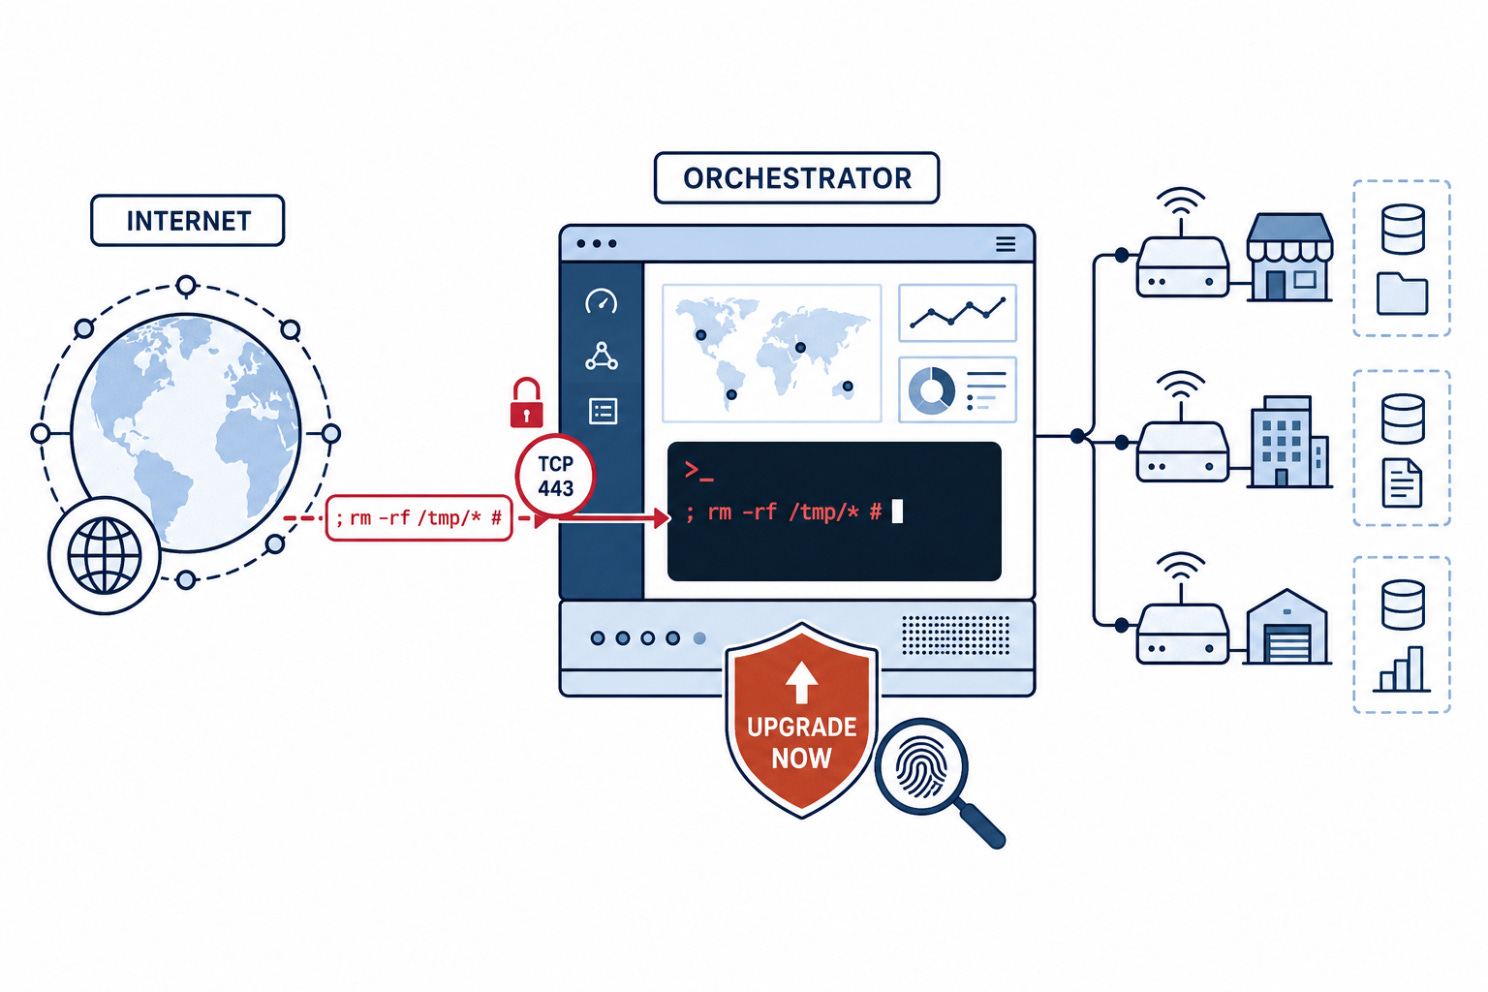
Una interfaz de VeloCloud expuesta por defecto sufre ataques activos
Arista divulgó la explotación activa de CVE-2026-16812, una vulnerabilidad de inyección de comandos CVSS 10 que afecta a VeloCloud Orchestrator local. La funcionalidad vulnerable estaba pensada para uso interno, pero era accesible de forma remota, lo que podía exponer el orquestador y los datos que gestiona. CISA ha añadido la vulnerabilidad a su catálogo de vulnerabilidades explotadas. Los operadores deben verificar las versiones afectadas, actualizar de inmediato y revisar los sistemas en busca de señales de compromiso.
🔎 Análisis a fondo
¿Una mejor seguridad exige el modelo más caro?
El modelo de IA más caro debería ofrecer los mejores resultados de seguridad.
Parece lógico.
Los modelos más caros suelen prometer un razonamiento más sólido, un mejor uso de las herramientas y una mayor capacidad para seguir rutas de ataque complicadas.
Así que los equipos de seguridad pueden suponer que la opción más segura es sencilla: usar el modelo más potente disponible para cada tarea.
Pero Kimi K3 y GLM 5.2 complican esa suposición.
Moonshot AI fijó el precio del modelo en $3 por millón de tokens de entrada y $15 por millón de tokens de salida. GPT-5.6 Sol de OpenAI cuesta $5 y $30, respectivamente.
Kimi K3 no es el modelo más barato disponible. Lo interesante es que se dirige a tareas que suelen asociarse con modelos de frontera más caros: navegar por repositorios grandes, orquestar herramientas y completar tareas largas de varios pasos.
Entonces, ¿el modelo de $30 ofrece el doble de seguridad?
La diferencia de precio
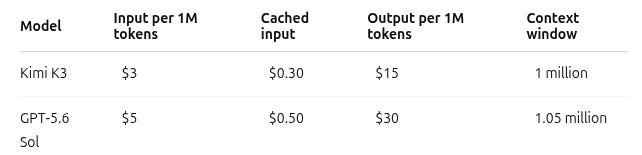
Kimi también cobra $0.30 por millón de tokens de entrada en caché, frente a $0.50 de GPT-5.6 Sol.
Esa diferencia crece rápidamente en los flujos de trabajo de seguridad agénticos.
Un agente puede leer repetidamente la misma base de código, la misma documentación y el mismo contexto de la aplicación mientras prueba distintas hipótesis. Cada llamada a una herramienta, cada reintento y cada paso de investigación suman coste.
Entre muchas aplicaciones, repositorios o eventos de seguridad, una pequeña diferencia de precio puede convertirse en un gran gasto operativo.
Precios y detalles técnicos de Kimi K3 · Precios de GPT-5.6 Sol
Más barato no significa igual
Kimi K3 no demuestra que los modelos más baratos sean tan capaces como los más caros.
Moonshot afirma que su rendimiento global sigue por detrás de GPT-5.6 Sol y Claude Fable 5, aunque informa de resultados competitivos en varias evaluaciones de programación y agénticas.
Esas comparaciones también necesitan contexto. Los modelos no siempre se probaron con el mismo arnés de agente, y varios resultados procedían de las propias evaluaciones de Moonshot.
La conclusión no es que el precio ya no importe.
Es que el precio por sí solo no dice qué modelo funcionará mejor en una tarea concreta.
¿Qué cambia esto para la seguridad?
No todos los pasos de una investigación de seguridad requieren el mismo nivel de razonamiento.
Un modelo de menor coste puede bastar para:
Clasificar hallazgos
Extraer indicadores de los registros
Navegar por bases de código grandes
Producir sugerencias iniciales de corrección
Gestionar comprobaciones repetitivas y de gran volumen
Puede seguir siendo necesario un modelo más capaz para:
Seguir cadenas de ataque de varios pasos
Entender una lógica de negocio ambigua
Validar si una debilidad es explotable
Adaptarse cuando una aplicación se comporta de forma inesperada
Decidir qué hipótesis probar a continuación
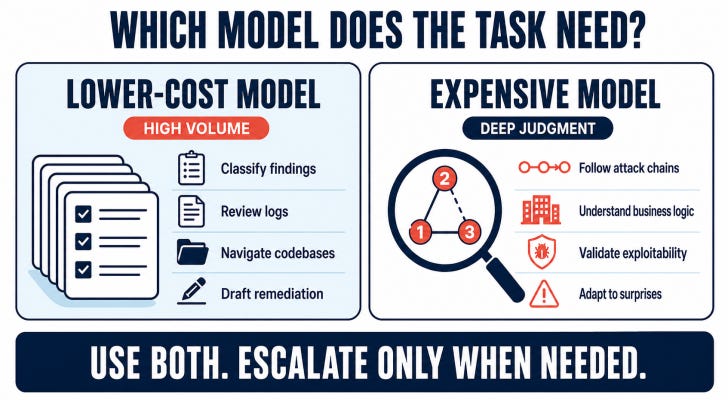
Usar el modelo más caro para cada paso desperdicia dinero.
Usar el modelo más barato para todo puede generar reintentos, conclusiones incompletas y más revisión humana.
El token más barato no siempre es el resultado más barato.
Mida el coste por resultado validado
Los precios por token solo muestran cuánto cuesta llamar a un modelo.
Los equipos de seguridad necesitan medir cuánto cuesta llegar a una conclusión útil.
Eso incluye:
Tokens consumidos
Llamadas a herramientas
Intentos fallidos y reintentos
Tiempo de investigación
Revisión humana
Hallazgos que superan la validación
Un modelo que cuesta la mitad pero necesita tres intentos puede no ser en realidad más barato.
Un modelo caro que resuelve con éxito todas las tareas sencillas puede seguir siendo innecesario.
La respuesta pueden ser ambos
Un flujo de trabajo práctico puede usar modelos de menor coste para el trabajo continuo y de gran volumen, y escalar los casos difíciles a un modelo más capaz.
Modelo de bajo coste para la amplitud → modelo más potente para la profundidad → validación antes de informar
Kimi K3 hace más realista ese enfoque. Los modelos diseñados para trabajo agéntico y de larga duración se están volviendo accesibles por debajo del nivel de precio más alto de la frontera.
La pregunta ya no es:
¿Cuál es el mejor modelo?
Es:
¿Qué partes de la investigación necesitan realmente el mejor modelo?
🎣 ¿Es phishing?
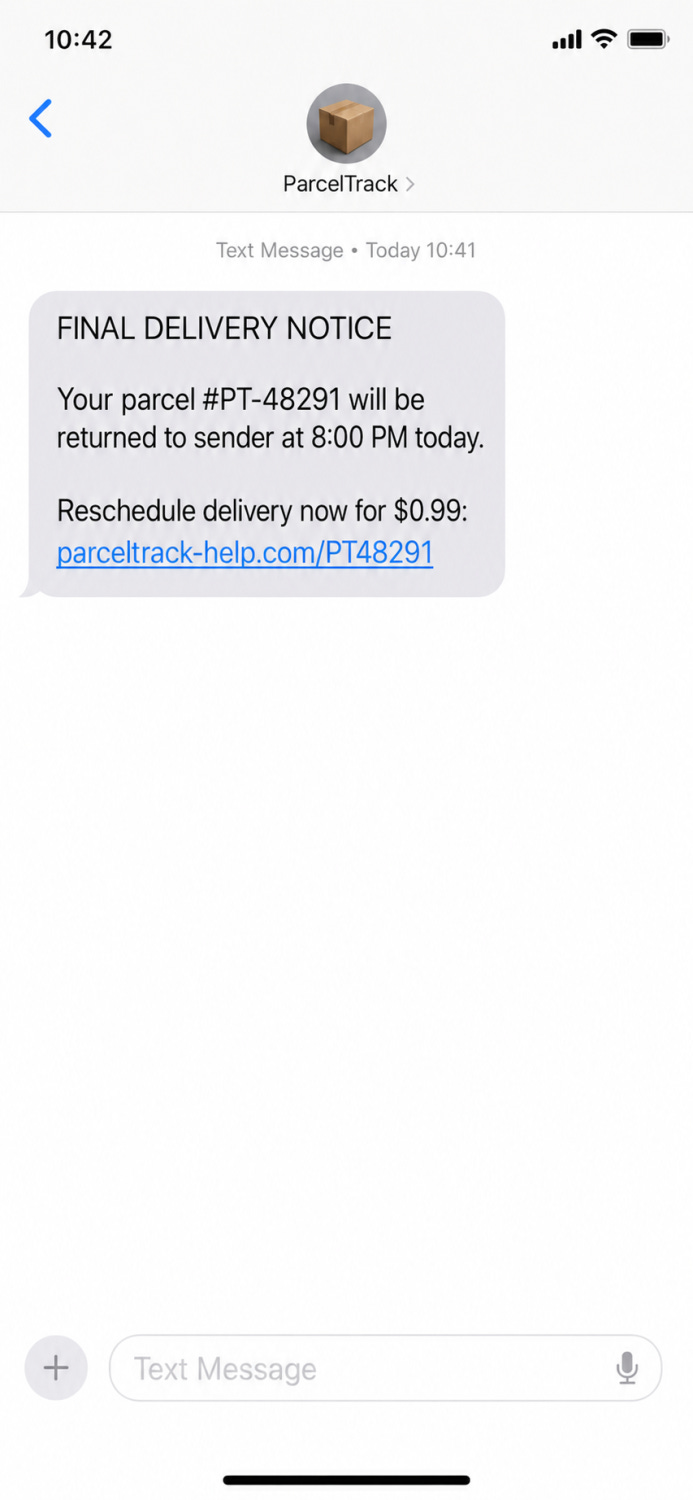
El paquete se devuelve esta noche y arreglarlo cuesta solo $0.99. ¿Qué hace?
🔬 Investigación técnica
WhatsApp fue explotado
La historia real es más extraña: WhatsApp funcionó como estaba diseñado, pero una extensión de PDF de confianza se convirtió en el camino para sortear el muro del navegador.
Un sitio web malicioso no debería poder leer sus mensajes de WhatsApp.
Esa es una de las promesas básicas del navegador: un sitio no puede meterse sin más en otro. Una página falsa de PDF no debería poder inspeccionar WhatsApp Web, Gmail, un portal bancario ni un panel interno.
Al menos, no directamente.
Esa es la lección incómoda que hay detrás de CVE-2026-48294, una vulnerabilidad de severidad alta de divulgación de datos entre orígenes, de clase UXSS, en la extensión de Adobe Acrobat para Chrome. Guardio Labs llamó a la cadena HermeticReader, y lo que la hace difícil de ignorar es su escala: la extensión estaba instalada en aproximadamente 329 millones de navegadores.
El exploit no necesitó un día cero de WhatsApp. No robó una contraseña. No tocó una cookie de sesión. No instaló malware en el dispositivo. La víctima solo necesitaba tener instalada la extensión vulnerable, una sesión activa de WhatsApp Web y visitar una vez una página controlada por el atacante.
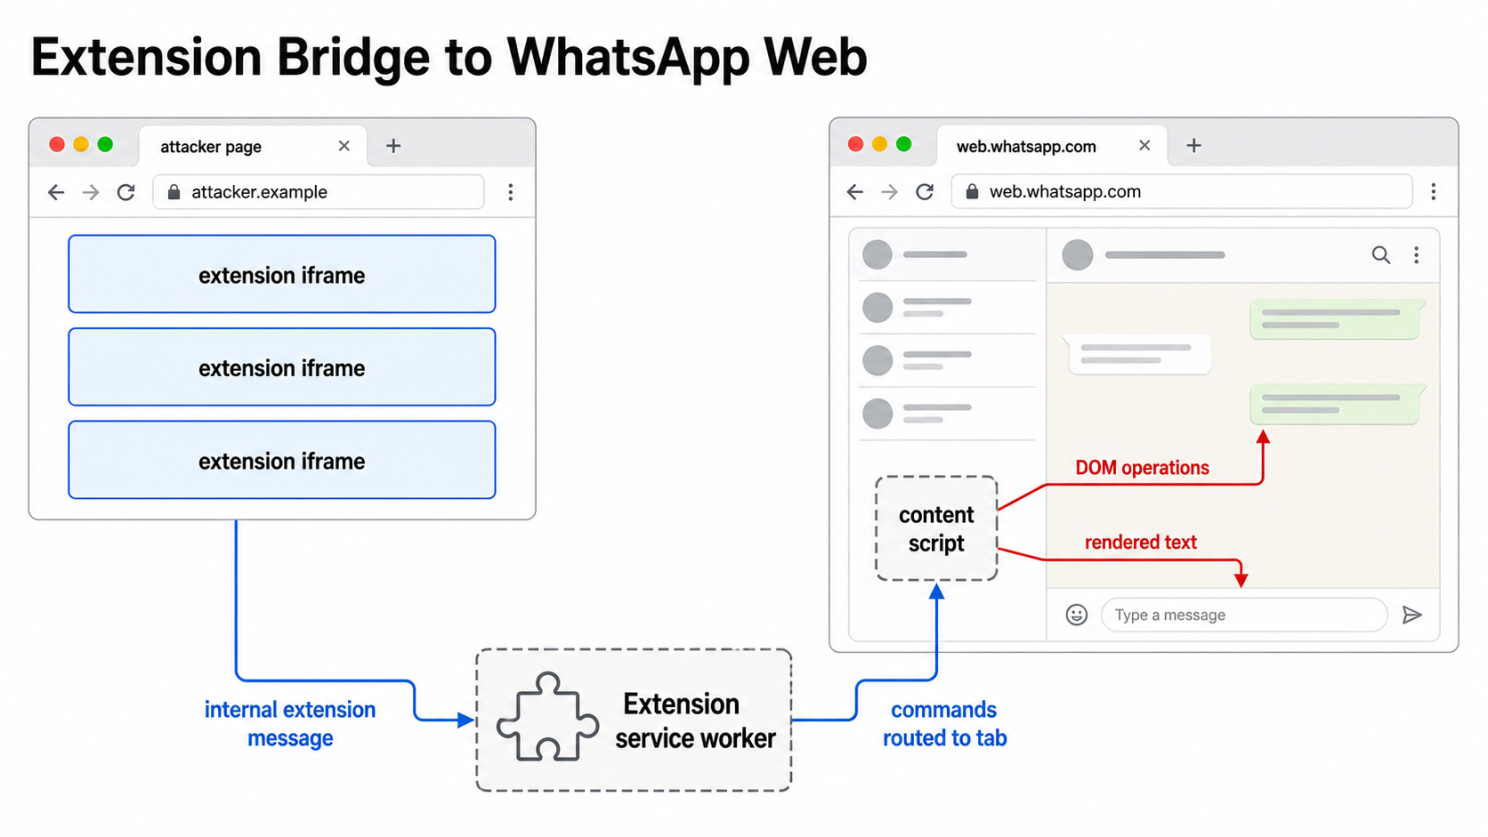
El ataque no vulneró WhatsApp directamente. Abusó de una extensión de navegador de confianza como puente entre un sitio web no confiable y una sesión autenticada de WhatsApp Web.
Dónde falló el límite
Normalmente, el JavaScript que se ejecuta en evil.example no puede leer el contenido de web.whatsapp.com. La política del mismo origen del navegador está diseñada para mantener esos mundos separados.
Las extensiones de navegador complican ese modelo.
Una extensión no es simplemente otro sitio web. Según sus permisos, puede exponer páginas internas, comunicarse con un service worker, almacenar estado, inyectar scripts e interactuar con pestañas de maneras que los sitios web normales no pueden. Ese poder es útil cuando la extensión hace lo que el usuario espera. Se vuelve peligroso cuando una página no confiable puede influir en la lógica privilegiada de la extensión.
En HermeticReader, el primer problema fue la accesibilidad. Varias páginas de la extensión de Acrobat estaban expuestas como recursos accesibles desde la web, es decir, cualquier sitio web podía incrustarlas en un iframe. Esas páginas analizaban datos controlados por el atacante a partir de la URL, los convertían en mensajes de la extensión y los enviaban al service worker de la extensión.
Como el mensaje procedía del interior de una página chrome-extension:// , parecía interno. El service worker lo aceptaba entonces sin comprobar debidamente el remitente real.
Eso abrió una primitiva potente: un sitio web normal podía escribir valores arbitrarios en el almacenamiento local de la extensión. Uno de esos valores activaba el motor de integración de WhatsApp de Adobe, al que la investigación de Guardio se refiere como Hermes.
La extensión de confianza se había convertido en la capa intermedia confundida.
El truco útil: encontrar WhatsApp
Activar Hermes no bastaba. El atacante aún necesitaba dirigir los comandos de la extensión a la pestaña de WhatsApp Web de la víctima.
Guardio encontró un segundo punto débil en la lógica de gestión de pestañas de la extensión. Una página podía hacerse pasar por una página de búsqueda admitida mediante una comprobación laxa del nombre de host, recibir el ID de su propia pestaña de Chrome a través de una superposición inyectada y luego predecir el ID de la siguiente pestaña tras abrir WhatsApp Web.
Parece algo menor, pero cambió la forma del ataque. En lugar de buscar a ciegas la pestaña de WhatsApp, el atacante podía crear un objetivo casi determinista: el ID de la pestaña actual más uno.
Una vez que el atacante devolvía ese ID predicho al flujo de mensajes de la extensión, el service worker podía retransmitir los comandos de Hermes al content script de WhatsApp Web.
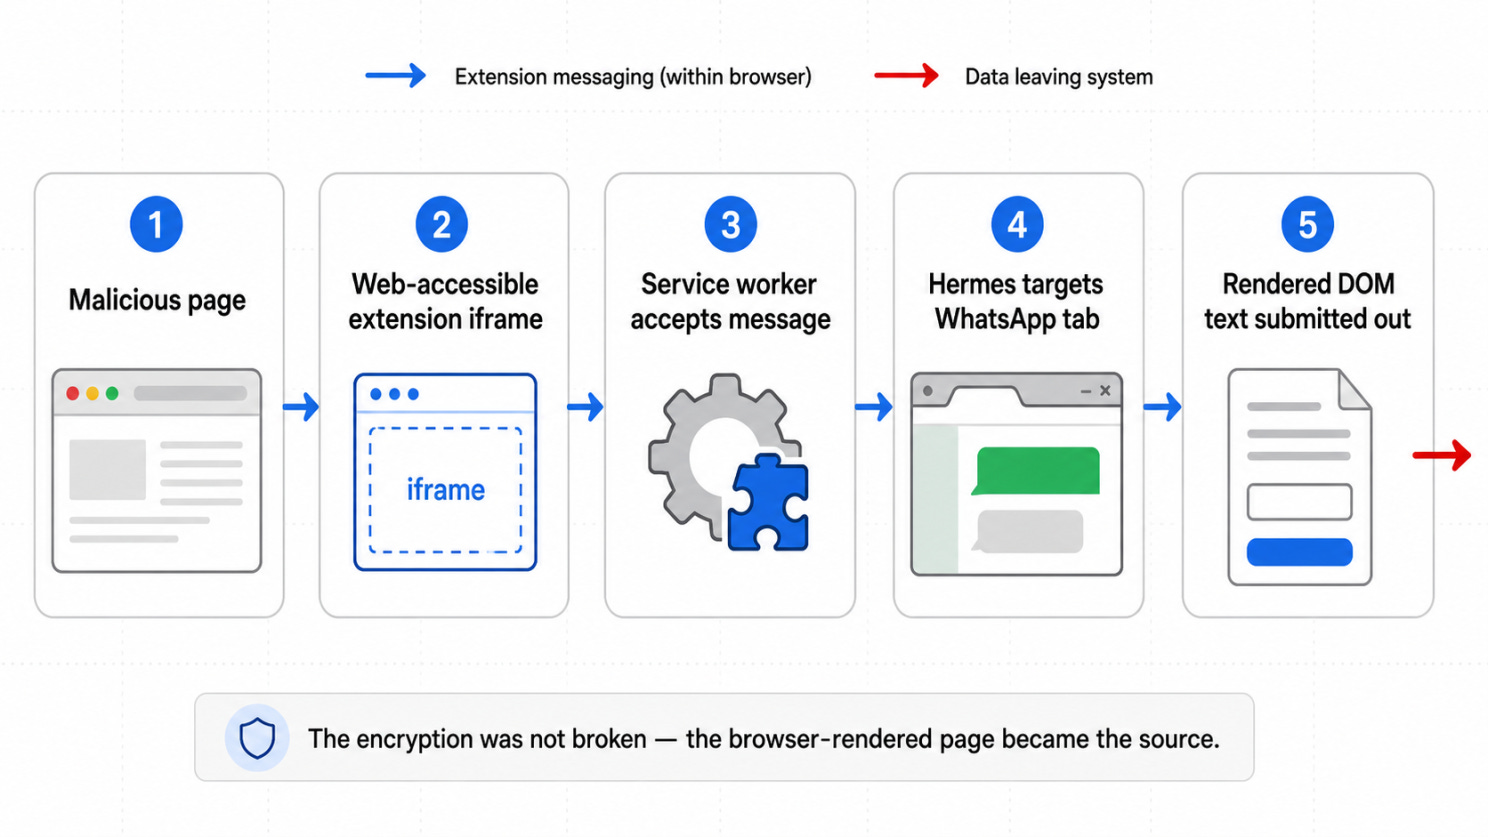
La cadena pasaba de una página maliciosa a un recurso expuesto de la extensión, luego al service worker y después a comandos de Hermes que se ejecutaban contra WhatsApp Web.
Los datos salieron a través del DOM, no del cifrado
Este es el límite más importante de la historia: HermeticReader no rompió el cifrado de extremo a extremo de WhatsApp.
El navegador del usuario ya había descifrado los mensajes porque el usuario había iniciado sesión en WhatsApp Web. El ataque tenía como objetivo la página renderizada: las entradas de la lista de chats, los nombres de contactos, la información de perfil, las vistas previas de mensajes y el texto visible de las conversaciones.
La prueba de concepto de Guardio abusó de operaciones DOM permisivas de Hermes en lugar de inyectar JavaScript ordinario. La extensión podía añadir HTML, llamar a métodos de elementos del DOM y realizar operaciones de ventana o de documento dentro de la pestaña de WhatsApp.
Una vía de exfiltración ingeniosa usaba un formulario. El flujo controlado por el atacante insertaba un formulario en el DOM de WhatsApp, movía el contenido renderizado de la página bajo un elemento de formulario y luego lo enviaba a un endpoint controlado por el atacante. Como WhatsApp Web no restringía esta vía con una directiva CSP form-action , el navegador podía enviar mediante POST el texto renderizado hacia el exterior.
Por eso importa la distinción. El cifrado funcionó. El aislamiento del navegador funcionó en su mayor parte. El fallo estuvo en el ayudante privilegiado situado por encima de ambos.
La cadena aproximada era esta:
La víctima visita una página controlada por el atacante.
La página incrusta un recurso expuesto de la extensión de Acrobat.
Datos controlados por el atacante entran en el flujo de mensajes de la extensión.
Se modifica el almacenamiento de la extensión para activar Hermes.
El atacante filtra o predice el ID de la pestaña de WhatsApp Web.
Los comandos de Hermes se enrutan al content script de WhatsApp Web.
El texto renderizado del chat se mueve a través del DOM y se envía hacia el exterior.
Para el usuario, casi nada parece dramático. Ningún instalador. Ningún inicio de sesión falso. Ninguna solicitud de contraseña. Ninguna ventana emergente de nuevos permisos en el momento del ataque. La extensión ya era de confianza antes de que llegara la página maliciosa.
Qué deberían extraer los defensores
Adobe corrigió el problema rápidamente tras la divulgación de Guardio, y los informes públicos dicen que no había evidencia de explotación activa. Pero el patrón va más allá de una sola extensión.
Los equipos de seguridad suelen revisar las extensiones de navegador como una cuestión de política: permitida o bloqueada, proveedor conocido o desconocido, herramienta de productividad o complemento sospechoso. Eso es útil, pero pasa por alto el problema de fondo.
Las extensiones forman parte del límite de seguridad del navegador.
Las preguntas prácticas de revisión son técnicas:
¿Qué páginas de la extensión están expuestas como recursos accesibles desde la web?
¿Pueden sitios web arbitrarios incrustar esas páginas o enviarles mensajes?
¿Valida el service worker el origen y la intención del remitente?
¿Puede un sitio web escribir en el almacenamiento de la extensión o activar indicadores de funcionalidad?
¿Puede la extensión inyectar scripts o realizar operaciones del DOM en dominios sensibles?
¿Puede una pestaña usar la extensión como puente hacia otra pestaña?
El viejo modelo de seguridad del navegador consistía sobre todo en mantener separados los sitios. HermeticReader muestra el problema más reciente: los muros entre sitios pueden seguir en pie mientras un ayudante de confianza construye en silencio una puerta a través de ellos.
A veces el atacante no necesita vulnerar WhatsApp.
Solo necesita convencer a algo en lo que el navegador confía para que lo lea por él.
Fuentes:
Guardio Labs, NVD, BleepingComputer
🛠️ Herramienta de la semana
Si su EDR detectó el ataque, la investigación ya está resuelta.
No exactamente.
Una alerta puede decirle que ocurrió algo sospechoso. No siempre le dice cómo entró el atacante, qué cambió, si estableció persistencia o qué otros equipos pueden estar afectados.
Ahí es donde entra Velociraptor .
Velociraptor es una plataforma de código abierto de análisis forense digital y respuesta a incidentes (DFIR) que se usa para investigar de forma remota, buscar amenazas y recopilar evidencia forense en endpoints con Windows, Linux y macOS.
Piense en ella como:
osquery + respuesta a incidentes + recopilación forense en una sola plataforma.
¿Qué puede hacer?
Velociraptor permite a los equipos de seguridad examinar la actividad de los endpoints, recopilar archivos y registros, inspeccionar procesos y mecanismos de persistencia, buscar indicadores de compromiso y ejecutar la misma investigación en varios dispositivos.
Usa paquetes de investigación reutilizables llamados artifacts. Estos definen qué datos deben recopilarse o consultarse, como:
Procesos en ejecución y conexiones de red
Registros de eventos e historial de ejecución
Archivos sospechosos, hashes y metadatos
Servicios, tareas programadas y otros métodos de persistencia
Actividad de usuarios y del sistema
Los equipos pueden usar artifacts integrados, adaptar los de la comunidad o crear los suyos propios con el Velociraptor Query Language, o VQL.
De una alerta a una búsqueda en toda la flota
Imagine que un EDR marca un script sospechoso en el portátil de un empleado.
Con Velociraptor, el equipo de respuesta puede:
Inspeccionar el endpoint afectado.
Recopilar los registros, archivos y datos de procesos pertinentes.
Extraer indicadores útiles, como hashes, nombres de archivo o rutas.
Buscar los mismos indicadores en el resto de los endpoints de la empresa.
Recopilar evidencia de cualquier dispositivo que devuelva una coincidencia.
Velociraptor llama a esta recopilación en toda la flota un Hunt.
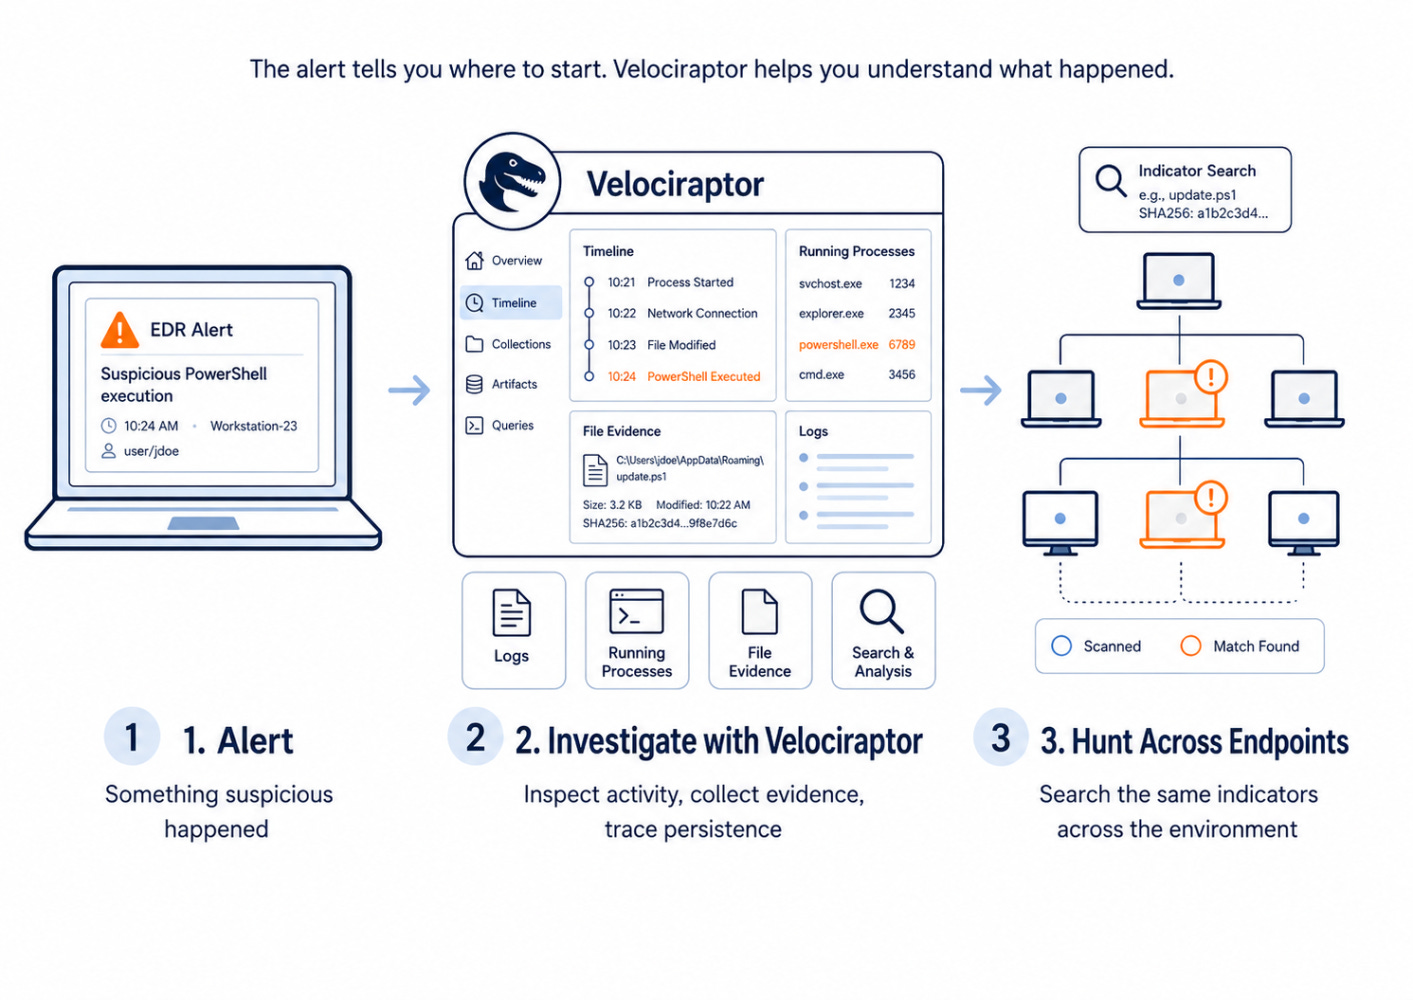
Esa es una de sus mayores fortalezas. La investigación no tiene por qué detenerse en la máquina que generó la alerta original. Los equipos pueden preguntar rápidamente:
¿Dónde más está ocurriendo esto?
Por qué importa VQL
VQL permite a los investigadores definir exactamente qué quieren encontrar o recopilar.
Cuando aparece nueva evidencia, un analista de respuesta puede crear una consulta, empaquetarla como artifact y ejecutarla en todo el entorno. Esto hace que Velociraptor sea útil para investigaciones que cambian a medida que se descubre más información.
La contrapartida es que no siempre es una herramienta de hacer clic y listo. Los equipos necesitan cierto conocimiento de los datos de los endpoints y de la investigación forense para sacarle el máximo partido.
Lo que no sustituye
Velociraptor no es un antivirus, un EDR ni un SIEM.
Su función principal no es prevenir ataques ni generar todas las alertas. Su papel es ayudar a los equipos de seguridad a investigar actividad sospechosa, recopilar evidencia y buscar en los endpoints.
Funciona mejor junto con herramientas de detección, inteligencia de amenazas, plataformas de gestión de casos y analistas humanos que sepan interpretar los hallazgos.
La alerta le dice por dónde empezar.
Velociraptor le ayuda a entender qué ocurrió realmente.
👏 Persona de la semana
Al-Amir Badmus
Esta semana destacamos a Al-Amir Badmus , el ingeniero de seguridad detrás de VulnBank.
Creó VulnBank para ofrecer a las personas un entorno realista donde practicar la seguridad de aplicaciones, no solo mediante una plataforma web vulnerable y sus API, sino también con una aplicación móvil diseñada para pruebas prácticas de seguridad móvil.
El proyecto ofrece a quienes aprenden y a los profesionales de seguridad con experiencia un lugar donde probar escenarios de ataque reales, entender cómo se conectan las vulnerabilidades y mejorar sus habilidades mediante la práctica en lugar de ejemplos aislados.
Por crear y seguir mejorando tanto VulnBank Web como VulnBank Mobile, Al-Amir Badmus es nuestra Persona de la semana.
📅 Evento de la semana
AppSec Village en DEF CON 34
Si prefiere romper y arreglar software a asistir a charlas generales de conferencias, AppSec Village merece la pena seguirlo.
Durante DEF CON 34, el village reúne la seguridad de aplicaciones en un solo lugar con charlas técnicas, talleres, demostraciones de herramientas de código abierto y un CTF centrado en AppSec.
El programa abarca áreas como la seguridad de las API, las cadenas de suministro de software, la seguridad en la nube y en contenedores, móvil, IoT, identidad y seguridad de la IA. Está diseñado tanto para profesionales ofensivos como defensivos, con énfasis en mostrar cómo funcionan las vulnerabilidades en la práctica.
📍 Las Vegas Convention Center
📅 7–9 de agosto de 2026
📚 Libro de la semana
The Tangled Web
¿Por qué es tan difícil proteger una aplicación web?
En The Tangled Web, Michal Zalewski mira bajo la interfaz del navegador para explicar cómo funcionan realmente las URL, las cookies, los orígenes, el HTML y las reglas de seguridad del navegador, y cómo sus extrañas interacciones crean vulnerabilidades.
Es una lectura útil para quien quiera entender la seguridad web más allá de una lista de errores comunes.
😅 El meme
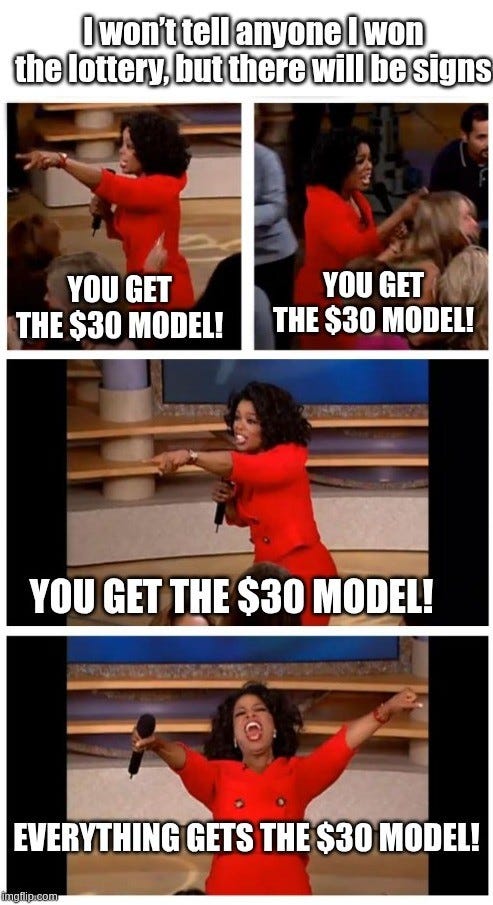
Si dos modelos alcanzaran el mismo resultado validado, ¿seguiría confiando más en el más caro?
The Breach Brief, Equipo de Ostorlab