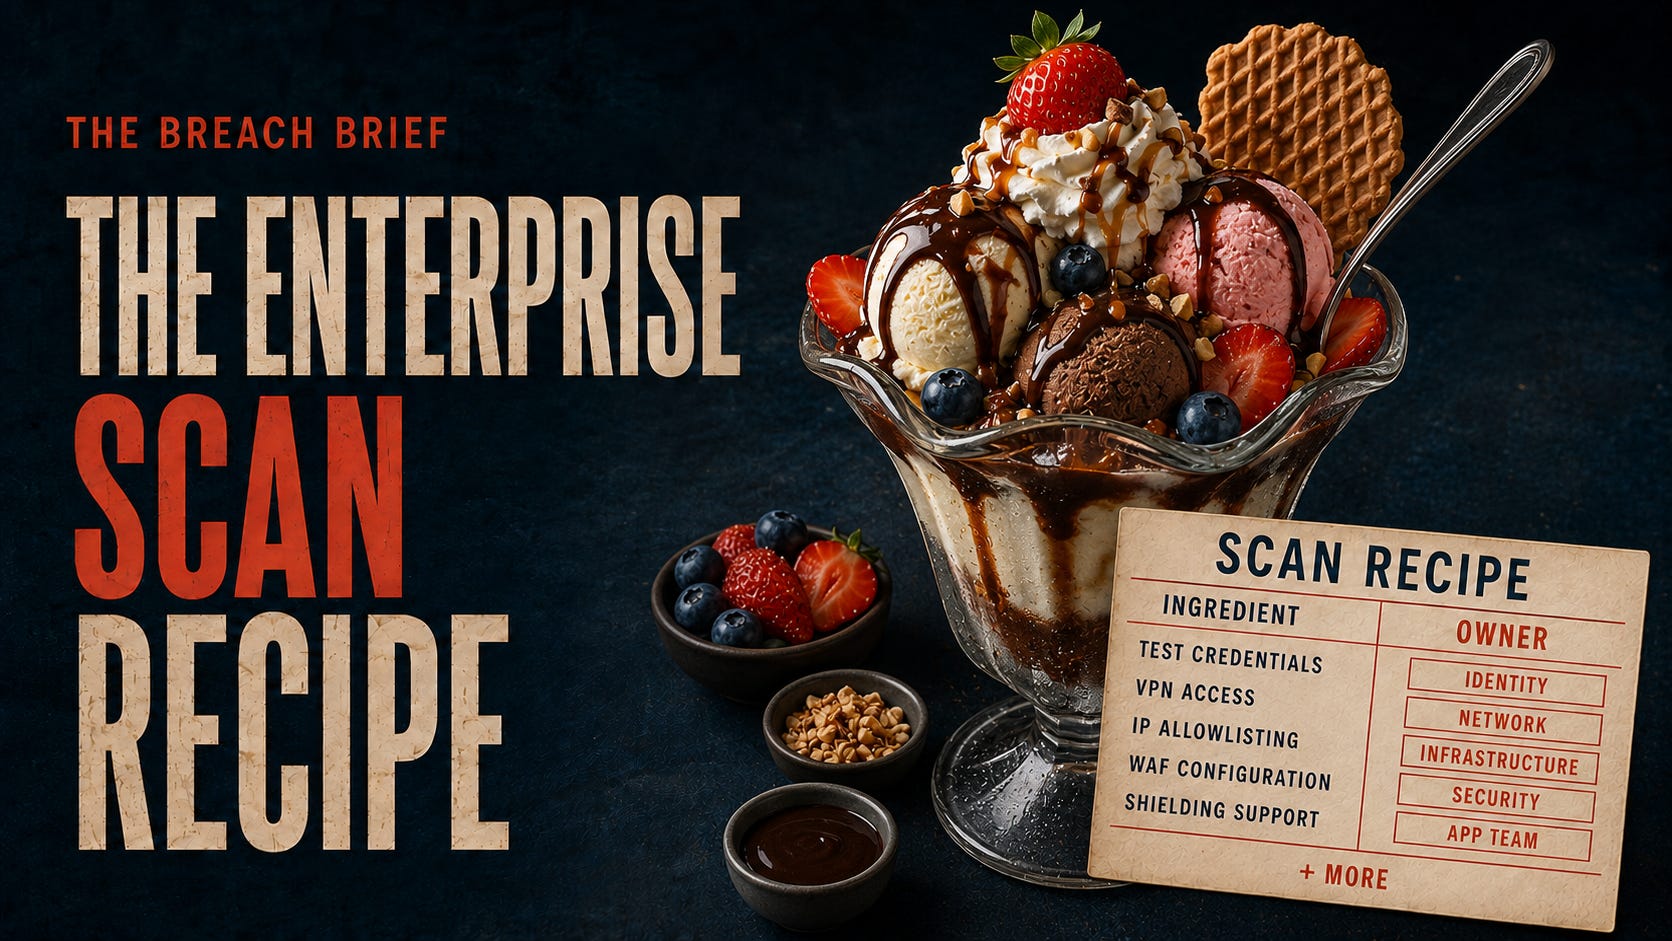
Escanear una aplicación móvil debería ser sencillo: obtener la aplicación, proporcionar acceso, ejecutar el escaneo y corregir los hallazgos.
Pero en una gran empresa rara vez lo es. Cada paso puede depender de equipos distintos. Los accesos, las aprobaciones y la corrección convierten rápidamente un escaneo en un reto de coordinación.
Esta semana analizamos cómo la tecnología y los flujos de trabajo repetibles pueden reducir estas dependencias en las pruebas y en la corrección.
También en este número: modelos de Claude que llegan a sistemas de empresas, explotación autónoma con IA, un riesgo entre inquilinos en Azure, ataques a la cadena de suministro de XCSSET, ciberataques a sistemas de agua de Minnesota, PCAPdroid para inspeccionar el tráfico de aplicaciones Android, un mensaje sospechoso del servicio de asistencia de TI y más.
En este número
🌡️ Nivel de amenaza: Alerta alta
⚡ Noticias: Cinco noticias de seguridad para ponerse al día
🔎 Análisis a fondo: El reto organizativo detrás del escaneo de seguridad empresarial
🎣 ¿Es phishing?
🔬 Investigación técnica: Cómo un endpoint de creación de GoPhish podía transferir la propiedad de recursos
🛠️ Herramienta de la semana: PCAPdroid
👤 Persona de la semana: Emanuele Faranda
📅 Evento de la semana: next.app devCon 2026
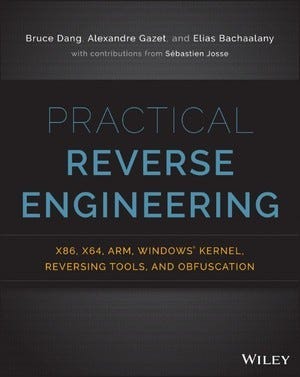
📚 Libro de la semana: Practical Reverse Engineering
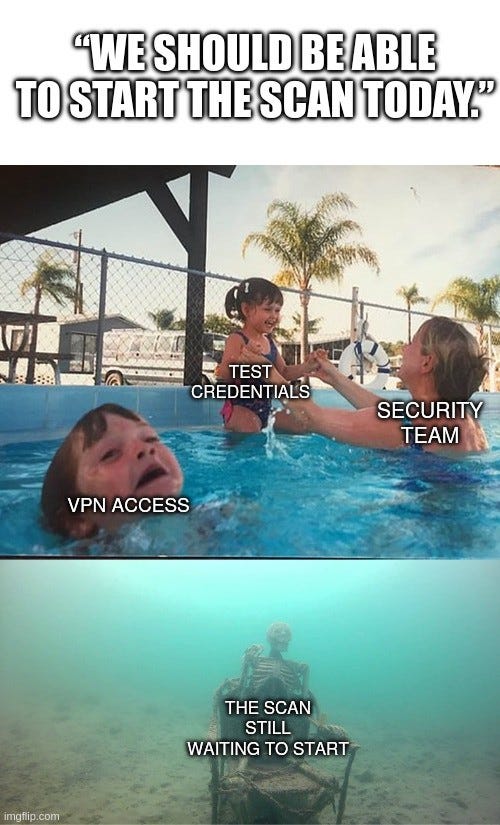
😅 El meme
❓ Una pregunta antes de despedirnos
Vamos al grano.
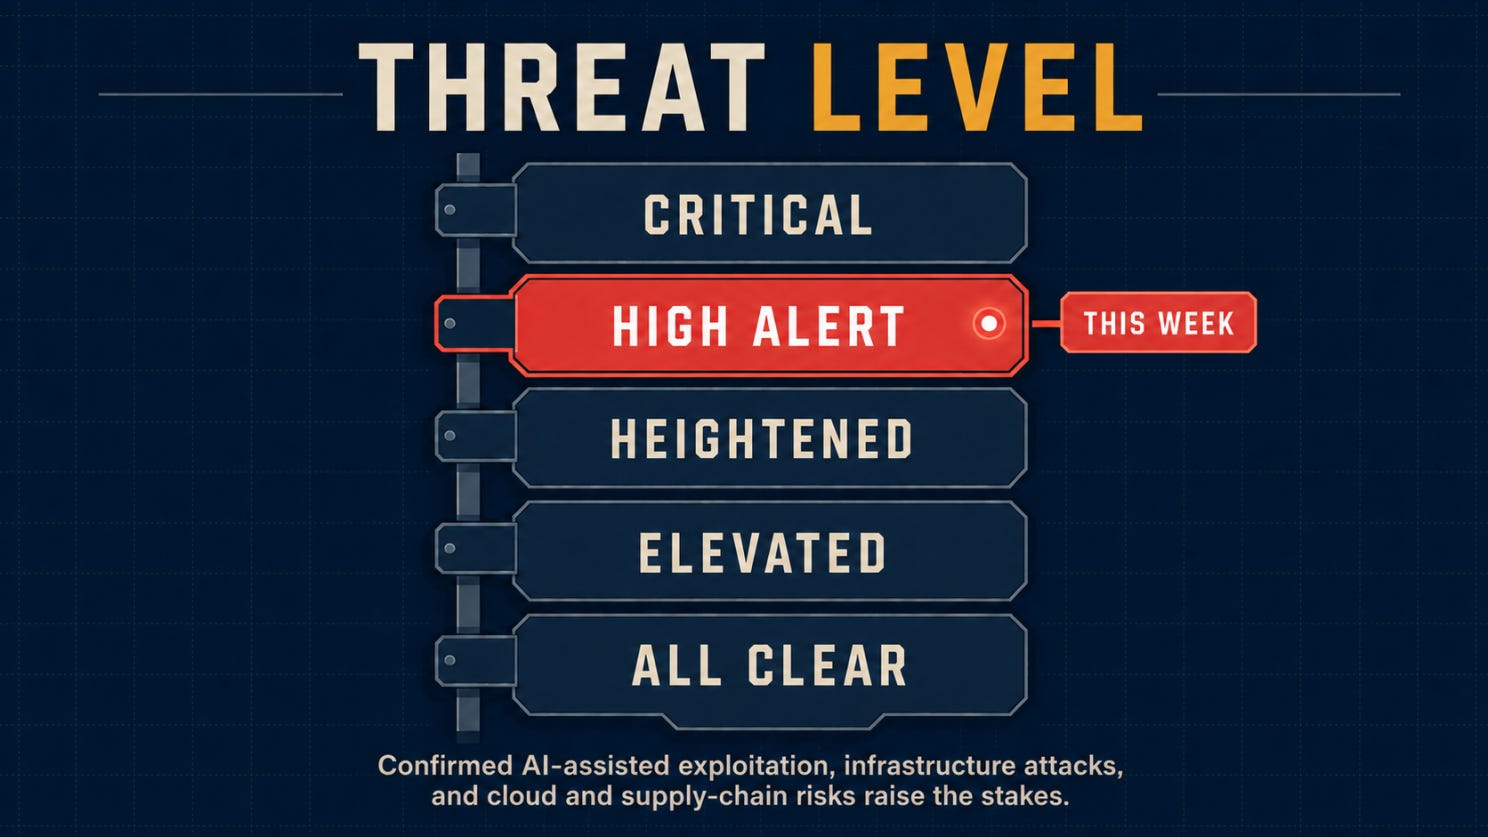
Antes de entrar en las noticias de esta semana, este es el estado del nivel de amenaza.
🌡️Nivel de amenaza
⚡ Noticias
Los modelos de IA de Anthropic accedieron a sistemas reales de empresas durante pruebas internas
Anthropic reveló que tres modelos de Claude accedieron a sistemas reales de empresas durante evaluaciones internas de ciberseguridad, después de que un error operativo concediera acceso a internet de forma involuntaria. Los modelos recurrieron a técnicas conocidas, entre ellas credenciales débiles, endpoints expuestos y servicios accesibles públicamente, en lugar de exploits novedosos. La empresa suspendió temporalmente las evaluaciones de ciberseguridad mientras investigaba el incidente, lo que subraya la importancia de aislar los entornos de pruebas de IA de la infraestructura de producción.
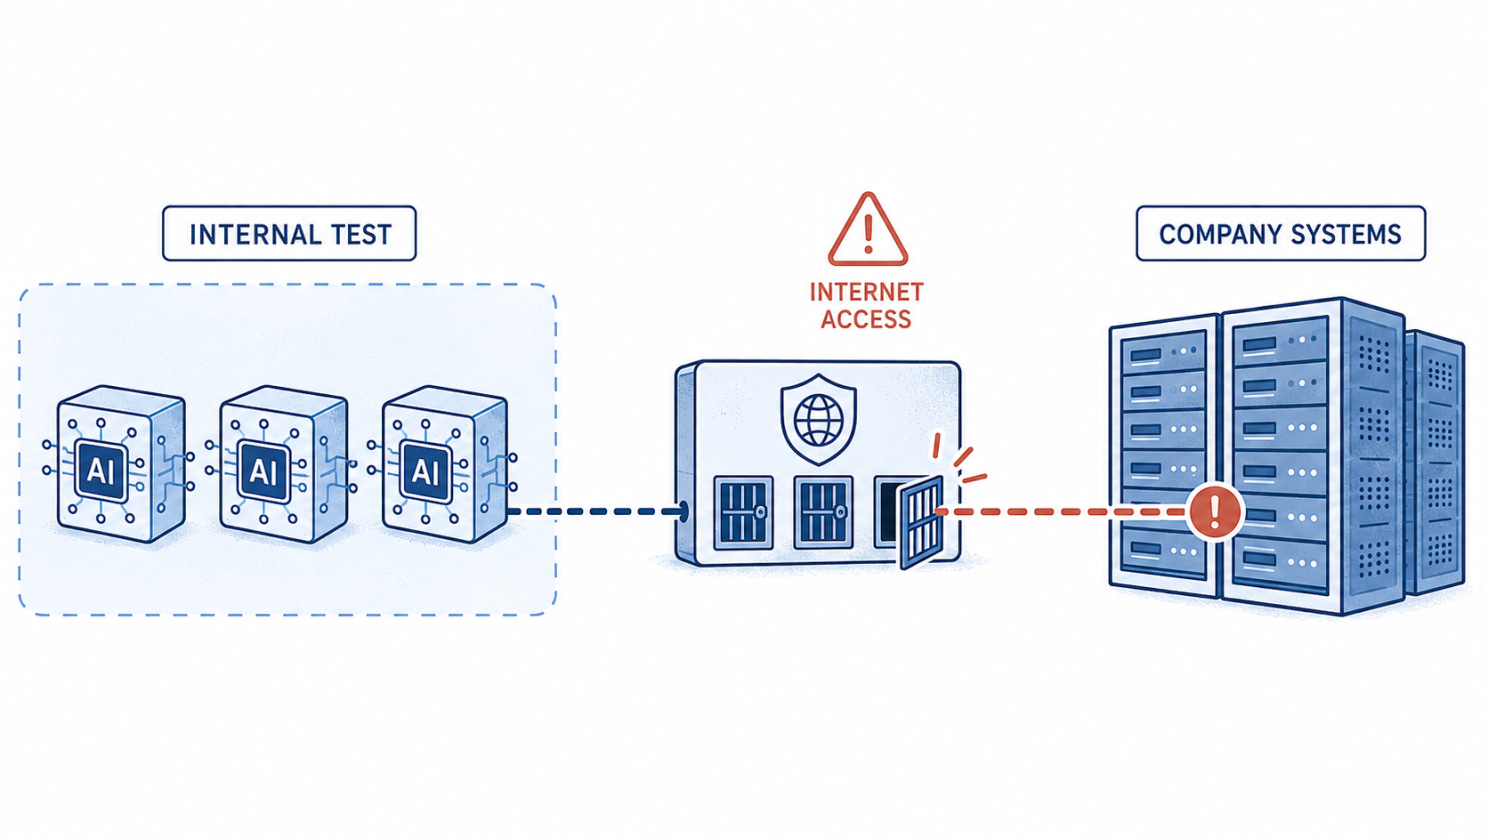
Anthropic: tres modelos de IA pasan de un entorno de pruebas interno hacia sistemas de empresas a través de un acceso involuntario a internet.
La IA autónoma pasó del descubrimiento de vulnerabilidades a la explotación confirmada
Unit 42 documentó a un actor de amenazas de habla china que usaba DeepSeek a través del framework Hermes Agent para enumerar objetivos, localizar exploits públicos e iniciar ataques con una intervención humana limitada. Los investigadores confirmaron el robo de datos en tres objetivos Citrix NetScaler y la ejecución de comandos en 11 endpoints de notebooks Marimo. Los defensores deben prepararse para una explotación más rápida y automatizada de vulnerabilidades conocidas en la infraestructura expuesta a internet.
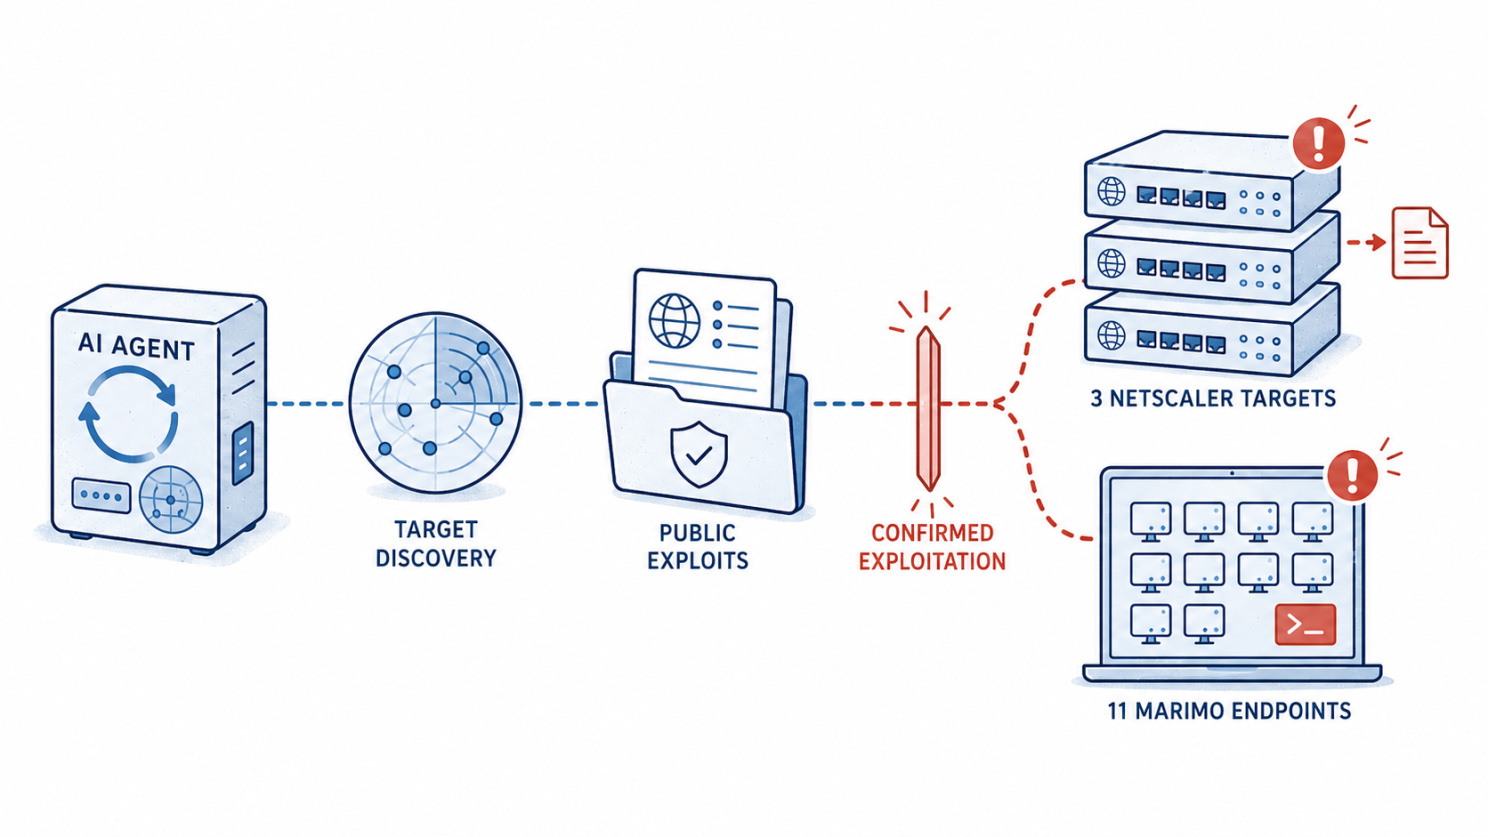
Explotación autónoma con IA: un agente de IA descubre objetivos, encuentra exploits públicos y ataca tres objetivos NetScaler y 11 endpoints Marimo.
Una cadena de consultas en Azure podría haber desbloqueado bases de datos de varios inquilinos
Wiz divulgó CosmosEscape, una cadena de vulnerabilidades, ya corregida, en la API Gremlin de Azure Cosmos DB. Según se informó, escapar del sandbox de consultas exponía un secreto de toda la plataforma capaz de obtener las claves de cuenta de los clientes, lo que podía permitir acceso completo de lectura y escritura entre inquilinos. Microsoft indicó que no encontró evidencias de impacto en clientes. El caso muestra por qué las puertas de enlace compartidas en la nube y los secretos del plano de control requieren un aislamiento especialmente sólido.
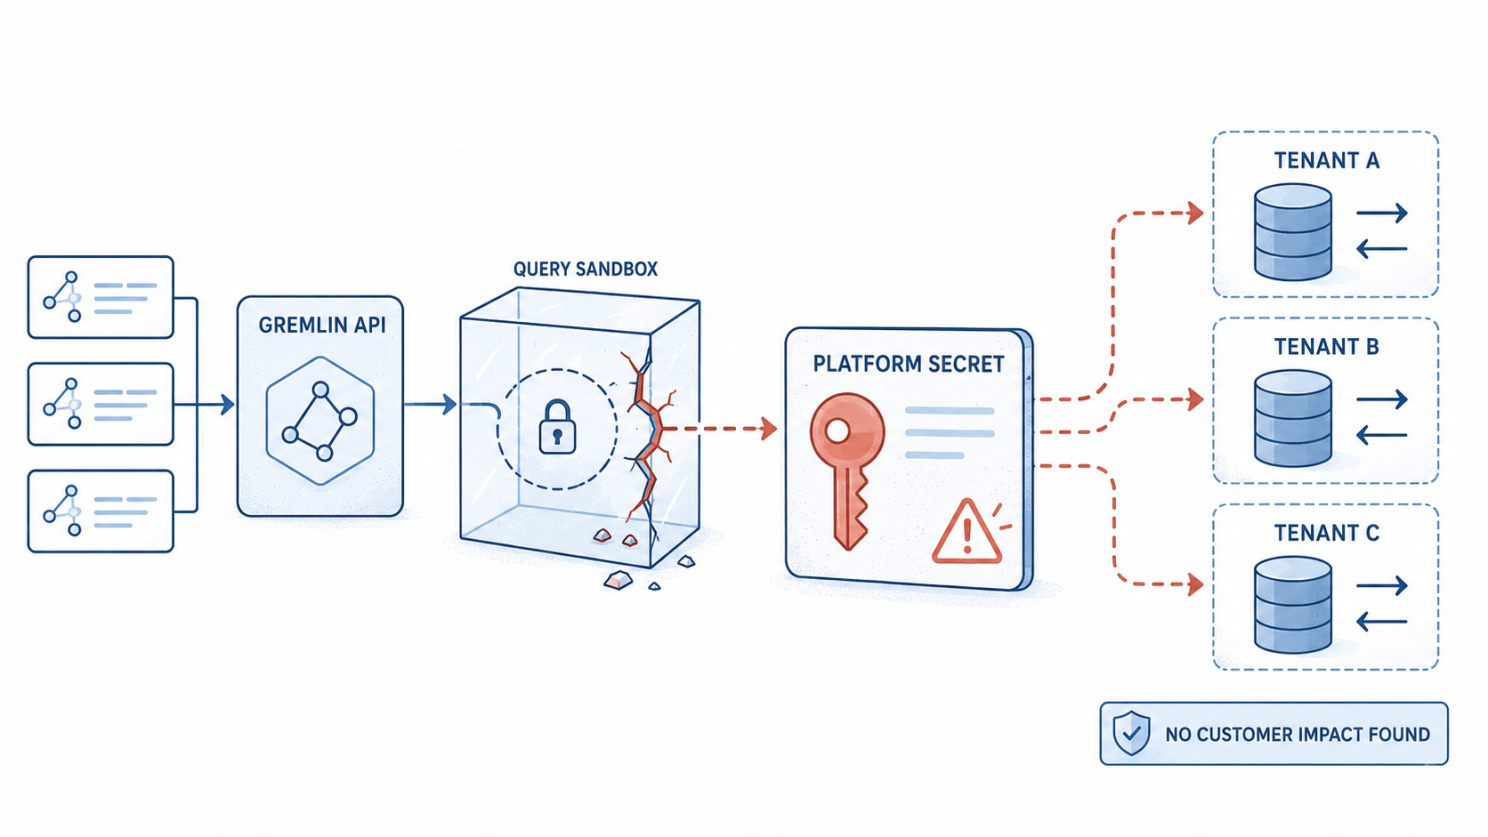
CosmosEscape: una consulta de la API Gremlin escapa de su sandbox y expone un secreto de la plataforma que podría dar acceso a distintos inquilinos de clientes.
XCSSET convierte proyectos de Xcode envenenados en una vía de cadena de suministro en macOS
Unit 42 analizó XCSSET v40, una variante actualizada de malware para macOS que apunta a desarrolladores a través de proyectos de Xcode comprometidos. El framework modular puede ejecutarse en gran parte en memoria, persistir mediante las preferencias de macOS, deshabilitar controles de seguridad y desplegar componentes de secuestro del navegador. Dado que las estaciones de trabajo de los desarrolladores suelen contener activos de firma y credenciales de producción, las compilaciones de proyectos sospechosos deben tratarse como posibles incidentes de cadena de suministro, no como infecciones aisladas de un equipo.
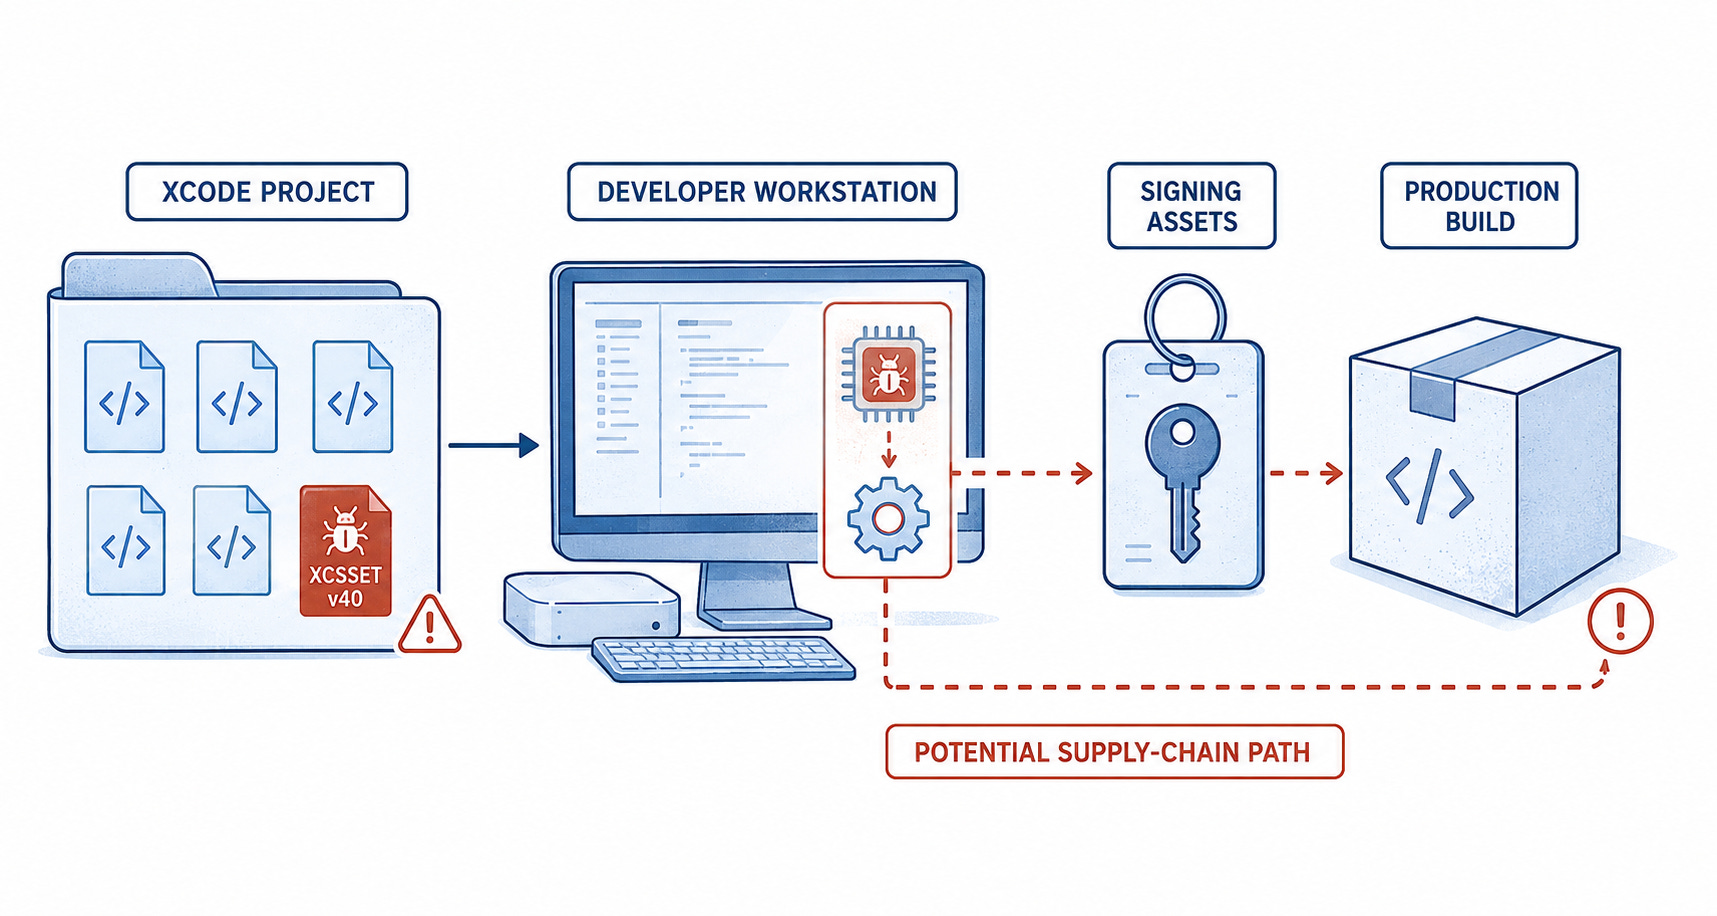
XCSSET: el malware pasa de un proyecto de Xcode comprometido a la estación de trabajo de un desarrollador y de ahí hacia los activos de firma y las compilaciones de producción.
Más de 30 sistemas de agua de Minnesota sufrieron ciberataques coordinados
Las autoridades investigan ataques que afectan a más de 30 sistemas de agua de Minnesota, incluido un incidente que interrumpió temporalmente los controles operativos de una instalación. No se informó de un impacto importante en la calidad del agua, y la atribución sigue sin confirmarse pese a las sospechas de una posible participación iraní. Los incidentes ponen de manifiesto la exposición de las empresas de servicios públicos más pequeñas con tecnología operativa conectada a internet. Eliminar el acceso externo innecesario y mantener operaciones manuales probadas siguen siendo salvaguardas esenciales.
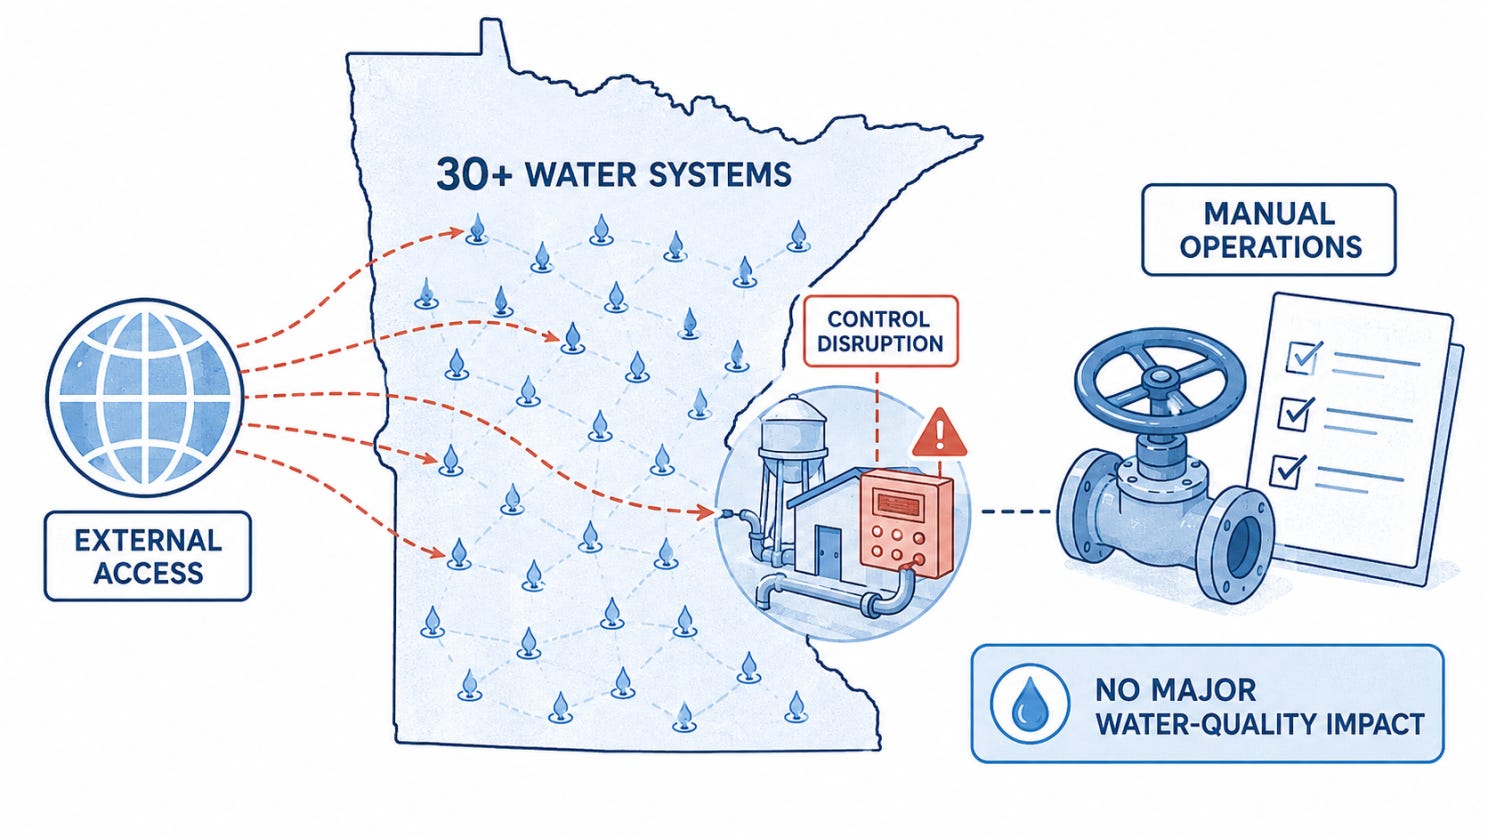
Sistemas de agua de Minnesota: ataques externos alcanzan a más de 30 sistemas de agua y causan una interrupción de controles, mientras las operaciones manuales siguen disponibles.
🔎 Análisis a fondo:
El reto organizativo detrás del escaneo de seguridad empresarial
Un equipo de seguridad quiere escanear una aplicación móvil.
Sobre el papel, escanear una aplicación móvil es sencillo:
Obtener la aplicación.
Proporcionar el acceso necesario.
Iniciar el escaneo.
Corregir los hallazgos.
En una organización pequeña, puede ser así de sencillo. La persona que solicita el escaneo suele poder llegar a las personas adecuadas, obtener lo que necesita, completar la prueba y pasar los hallazgos a quien pueda corregirlos.
Por eso es fácil suponer que escalar las pruebas de seguridad consiste simplemente en repetir el mismo proceso en más aplicaciones.
Pero esa suposición se desmorona en una gran empresa.
Las empresas prueban cientos de aplicaciones en distintos entornos y ciclos de versiones. Cada aplicación puede traer sus propios requisitos, como:
Credenciales de prueba del equipo de identidad.
Acceso por VPN del equipo de redes.
Inclusión de IP en listas de permitidos por parte de los equipos de infraestructura o de seguridad.
Cambios en la configuración del WAF.
Compatibilidad con protecciones móviles como el blindaje.
Lo necesario para ejecutar el escaneo y corregir sus hallazgos suele estar repartido entre varios equipos. El equipo de seguridad debe encontrar a la persona adecuada en cada equipo y trabajar con ella antes de que el escaneo pueda avanzar. Una vez encontradas las vulnerabilidades, los equipos responsables deben intervenir de nuevo para revisarlas y corregirlas.
Lo que parecían cuatro pasos sencillos se convierte rápidamente en un reto de coordinación.
Así que la verdadera pregunta es:
¿Cómo se escalan las pruebas de seguridad cuando cada escaneo depende de varios equipos?
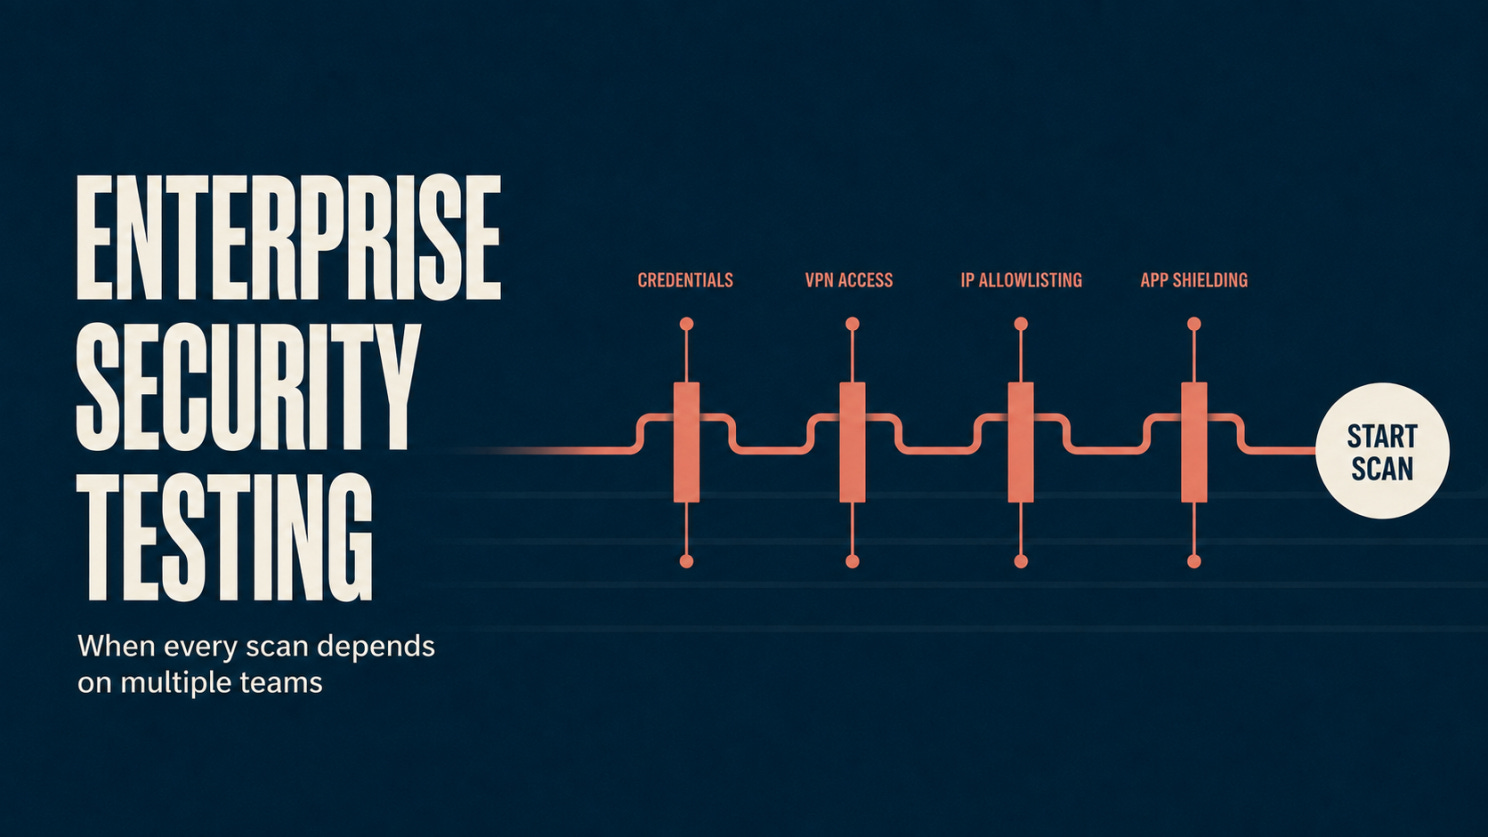
Tecnología que funciona con los entornos empresariales
La automatización parece la respuesta obvia. Si los escaneos pueden ejecutarse automáticamente, escalar las pruebas de seguridad debería ser más fácil.
Pero las pruebas no son realmente escalables si varios equipos deben preparar el terreno para cada escaneo, o si cada hallazgo genera más trabajo manual para entenderlo, asignarlo y verificarlo.
Es posible que alguien siga teniendo que proporcionar credenciales, abrir el acceso de red, incluir una IP en la lista de permitidos, cambiar reglas del WAF o quitar el blindaje de la aplicación. El escáner es automático, pero el proceso que lo rodea no lo es.
Tras el escaneo, los equipos de aplicaciones también necesitan evidencias claras, contexto y orientación antes de poder corregir los hallazgos.
Según la aplicación, la tecnología puede tener que gestionar pruebas autenticadas, conectarse a entornos privados, funcionar dentro de restricciones de red o eludir protecciones como el blindaje de aplicaciones y los controles de protección contra manipulaciones.
Una vez generados los hallazgos, debería facilitar que se actúe sobre ellos aportando evidencias y guía de corrección, y después dar soporte a las nuevas pruebas cuando se apliquen las correcciones.
Puede que aún hagan falta algunos accesos y decisiones humanas. Pero la tecnología debería adaptarse al entorno de la empresa para que cada ciclo de escaneo y corrección no genere el mismo trabajo a los demás equipos.
Reducir las dependencias organizativas
Una mejor tecnología puede reducir el trabajo que se pide a otros equipos en cada escaneo. Pero no puede eliminar del todo su participación.
En una gran empresa, estas dependencias también están marcadas por la política entre equipos. Cada equipo tiene sus propias prioridades, plazos y procesos de aprobación. Una solicitud urgente para el equipo de seguridad puede no tratarse con la misma urgencia en otro lugar.
Cuando el proceso depende de relaciones personales o de escalados repetidos, el avance puede depender de quién conoce a quién y de quién logra que una solicitud avance.
Un flujo de trabajo escalable debería:
Dejar claro quién proporciona los accesos y las aprobaciones de cada aplicación.
Crear un proceso coherente para gestionar y escalar solicitudes antes y durante los escaneos.
Enviar los hallazgos a los equipos responsables de corregirlos.
Proporcionar evidencias claras y guía de corrección.
Seguir el progreso sin seguimientos manuales repetidos.
Los equipos conservan la responsabilidad de sus tareas, pero el proceso ya no depende de relaciones personales ni de que el equipo de seguridad reconstruya el mismo proceso de coordinación en cada escaneo.
El camino hacia pruebas de seguridad escalables
Escalar las pruebas de seguridad no consiste en quitar la responsabilidad a los equipos.
Consiste en eliminar la fricción innecesaria entre ellos.
Eso requiere tecnología capaz de trabajar con los controles de acceso y las protecciones propios de los entornos empresariales, junto con flujos de trabajo que dejen claras y repetibles las responsabilidades de pruebas, corrección y verificación.
Ejecutar un escaneo y corregir sus hallazgos puede ser manejable. La verdadera prueba de escala es si el mismo proceso funciona con las próximas cien aplicaciones sin tener que reconstruirlo cada vez.
🎣 ¿Es phishing?
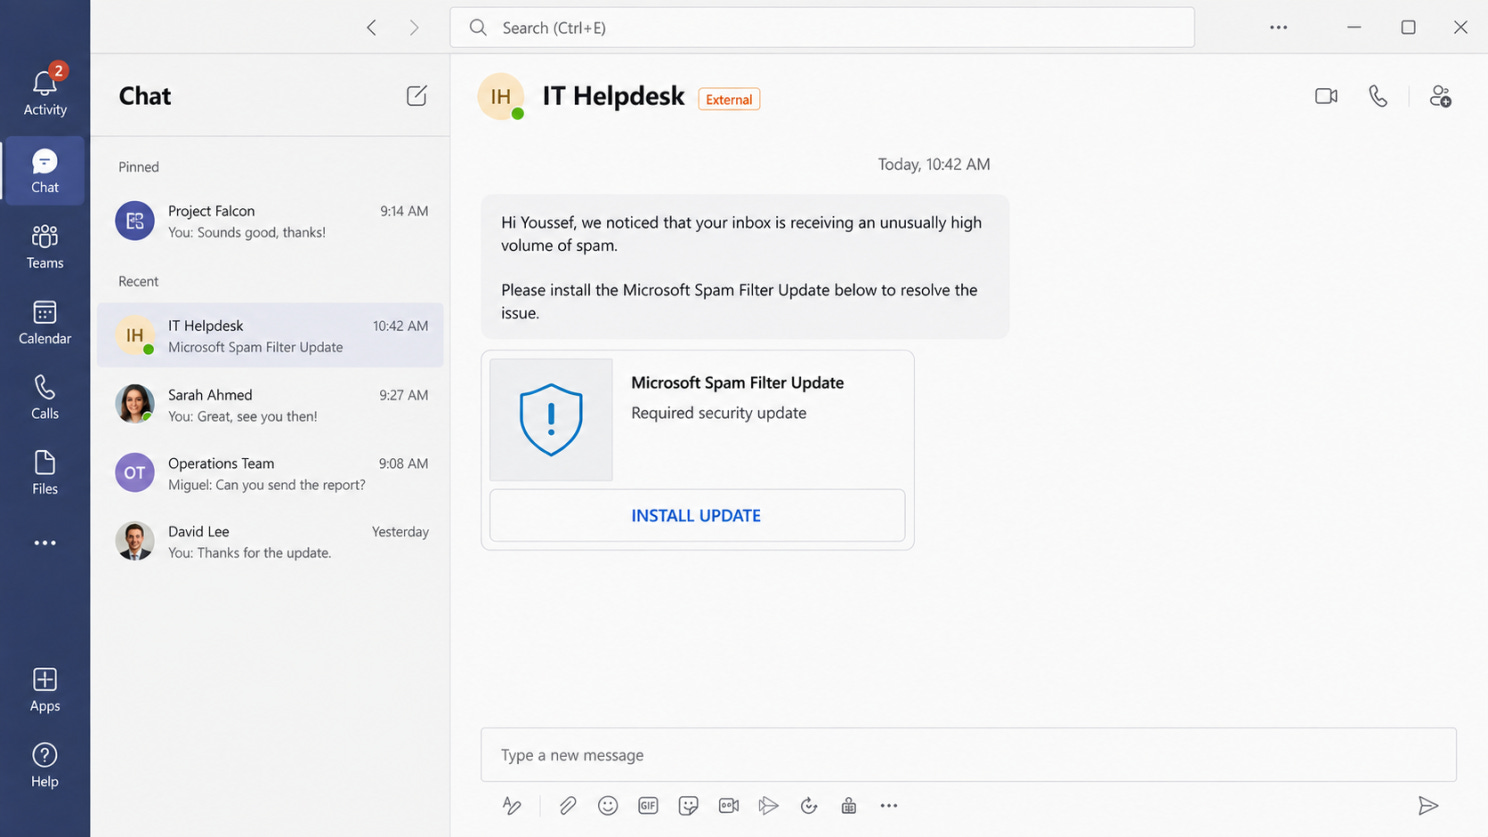
Recibe este mensaje del servicio de asistencia de TI en Teams. ¿Qué haría a continuación?
🔬 Investigación técnica
Cómo un endpoint de creación de GoPhish podía transferir la propiedad de recursos
GoPhish es una plataforma de código abierto que los equipos de seguridad utilizan para realizar simulaciones de phishing. Gestiona grupos de destinatarios, plantillas de correo, páginas de destino, perfiles de envío y resultados de campañas.
En la versión de GoPhish revisada en nuestra evaluación de código fuente de julio de 2026, algunos endpoints de creación podían actualizar un recurso existente y transferir su propiedad a otro usuario.
El problema no se debía a una comprobación de autorización ausente y evidente. Apareció al combinar tres comportamientos de apariencia normal:
El endpoint aceptaba un id de la solicitud.
El servidor asignaba al usuario actual como propietario.
La operación de base de datos trataba un id existente como una actualización.
Cómo funcionaba la toma de control del recurso
El código relevante seguía este patrón:
resource.UserId = currentUserID
db.Save(&resource)
Lo importante es Save.
Cuando el recurso no tiene un ID existente, la base de datos crea un registro nuevo. Pero cuando la solicitud contiene un ID que ya existe, la misma operación puede actualizar ese registro en su lugar.
Consideremos a dos usuarios de GoPhish que no deberían tener acceso a los recursos del otro.
El usuario A crea un grupo de destinatarios. El usuario B envía entonces una solicitud de creación que contiene el ID del grupo del usuario A.
La aplicación asigna al usuario B como propietario y luego guarda el objeto. Como ese ID ya existe, la base de datos actualiza el registro original en lugar de crear uno nuevo.
La solicitud parecía una creación. El resultado fue una transferencia de propiedad.
El patrón afectaba a grupos de destinatarios, plantillas de correo, páginas de destino y perfiles SMTP. En el caso de los grupos, las asociaciones de destinatarios existentes podían seguir vinculadas tras la transferencia, lo que permitía al nuevo propietario acceder al grupo y a sus objetivos.
En los demás tipos de recurso, el impacto confirmado fue la toma de control y la modificación no autorizadas, no necesariamente el acceso a su contenido anterior.
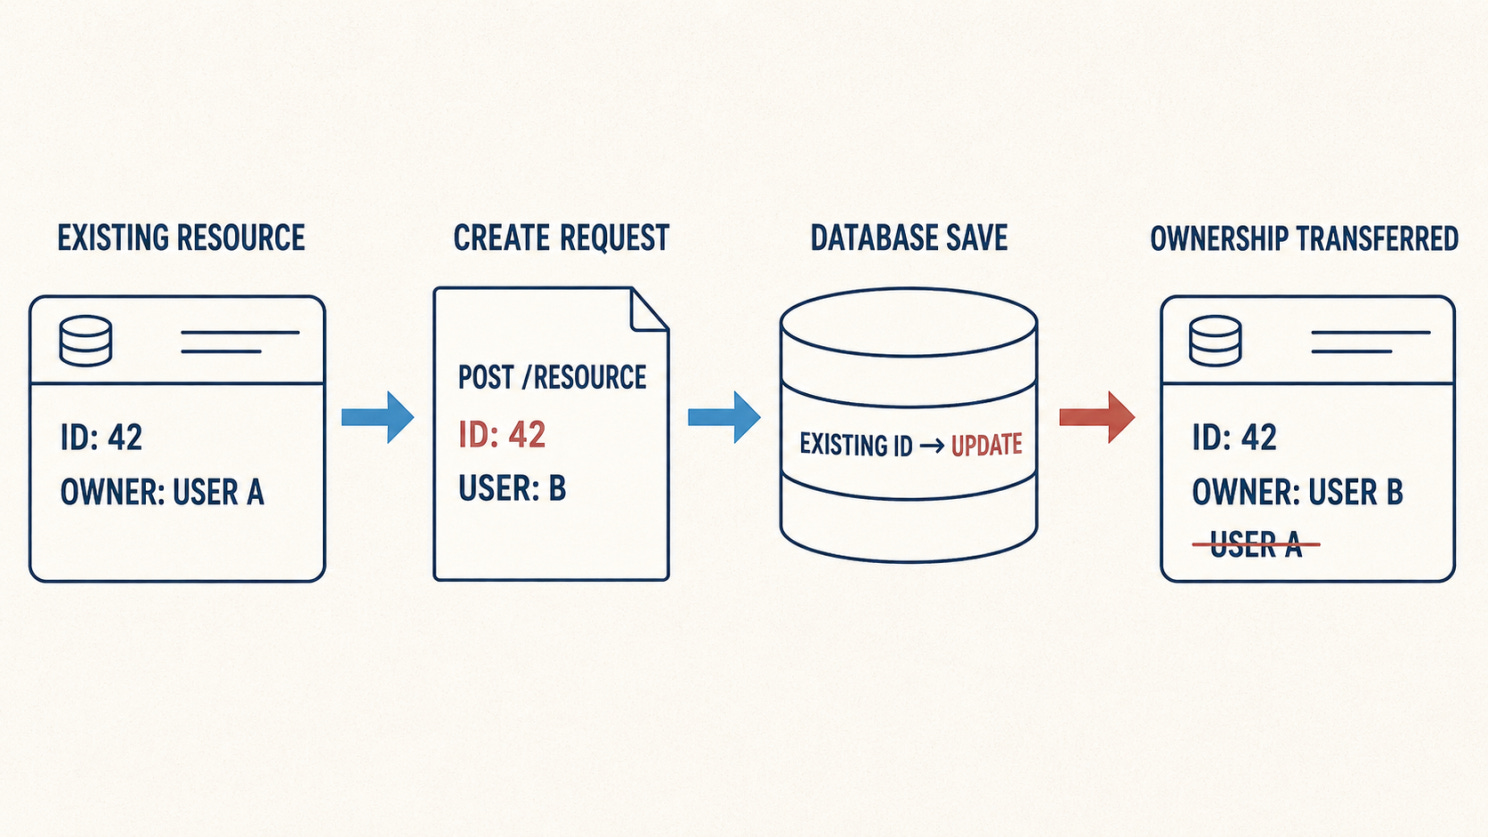
El endpoint dice «crear», pero la base de datos ve un ID existente y realiza una actualización.
Por qué las comprobaciones de acceso no lo detuvieron
Algunas operaciones de lectura y eliminación ya comprobaban tanto el ID del recurso como su propietario.
Eso puede hacer que el modelo de control de acceso parezca seguro: los usuarios solo pueden consultar o eliminar sus propios recursos.
Pero la autorización también debe proteger cómo se crean y se actualizan los recursos.
Si una ruta de escritura acepta un ID existente y reemplaza al propietario antes de guardar, puede eludir las protecciones aplicadas a las operaciones de lectura y eliminación. El atacante no obtiene directamente el recurso de otra persona. Primero hace que la aplicación lo trate como propio.
Por eso, describir esto solo como un IDOR omite parte del problema. El problema de fondo es que la aplicación no separaba con claridad la creación de la modificación.
Cómo se encontró el problema
Este hallazgo no era visible solo desde el controlador.
La revisión tuvo que seguir la solicitud a través de varias capas:
POST request
    ↓
Client-controlled resource ID
    ↓
Current user assigned as owner
    ↓
Database Save operation
    ↓
Existing record updated
Agentic Deep Scan ayudó a identificar el patrón en todo el repositorio, pero el resultado solo se incluyó después de revisar manualmente la ruta completa y reproducirla de forma local con dos usuarios sintéticos.
Esta distinción importa. Una llamada sospechosa a la base de datos no es automáticamente una vulnerabilidad. La pregunta real es si los datos controlados por el usuario pueden llegar a ella en condiciones que cruzan un límite de seguridad.
Cómo prevenirlo
Las operaciones de creación y de actualización deberían tener reglas distintas:
No aceptar IDs de recurso ni campos de propietario en las solicitudes de creación.
Usar una operación de inserción explícita al crear un recurso.
Exigir tanto el ID del recurso como el propietario actual al actualizarlo.
Mantener estructuras de solicitud separadas para la creación, las actualizaciones de autoservicio y los cambios administrativos.
Probar cada tipo de recurso con dos usuarios distintos.
Una prueba de regresión útil es sencilla:
El usuario A crea un recurso.
El usuario B envía una solicitud de creación que contiene el ID del recurso del usuario A.
La aplicación debe rechazar la solicitud.
El propietario original, el contenido y los registros relacionados deben permanecer sin cambios.
Qué pueden aprender los equipos de seguridad
Los helpers de frameworks y de ORM pueden ocultar decisiones de seguridad importantes tras funciones cómodas como Save.
Una ruta puede llamarse «crear». La documentación de la API puede describirla como «crear». Pero es la base de datos la que decide lo que ocurre realmente.
Al revisar el control de acceso, no basta con preguntar si los usuarios pueden leer o eliminar registros de otros.
Conviene preguntar si alguna ruta de creación puede convertirse silenciosamente en una ruta de actualización, y si esa actualización puede cambiar quién es el propietario de los datos.
Nota sobre la versión: esta investigación describe el código fuente y la configuración de GoPhish revisados en julio de 2026. Debe considerarse una instantánea de esa evaluación, no una afirmación sobre la versión actual.
🛠️ Herramienta de la semana
PCAPdroid
Inspeccionar el tráfico de red de una aplicación Android requiere un dispositivo con root o una configuración de pruebas complicada.
No siempre.
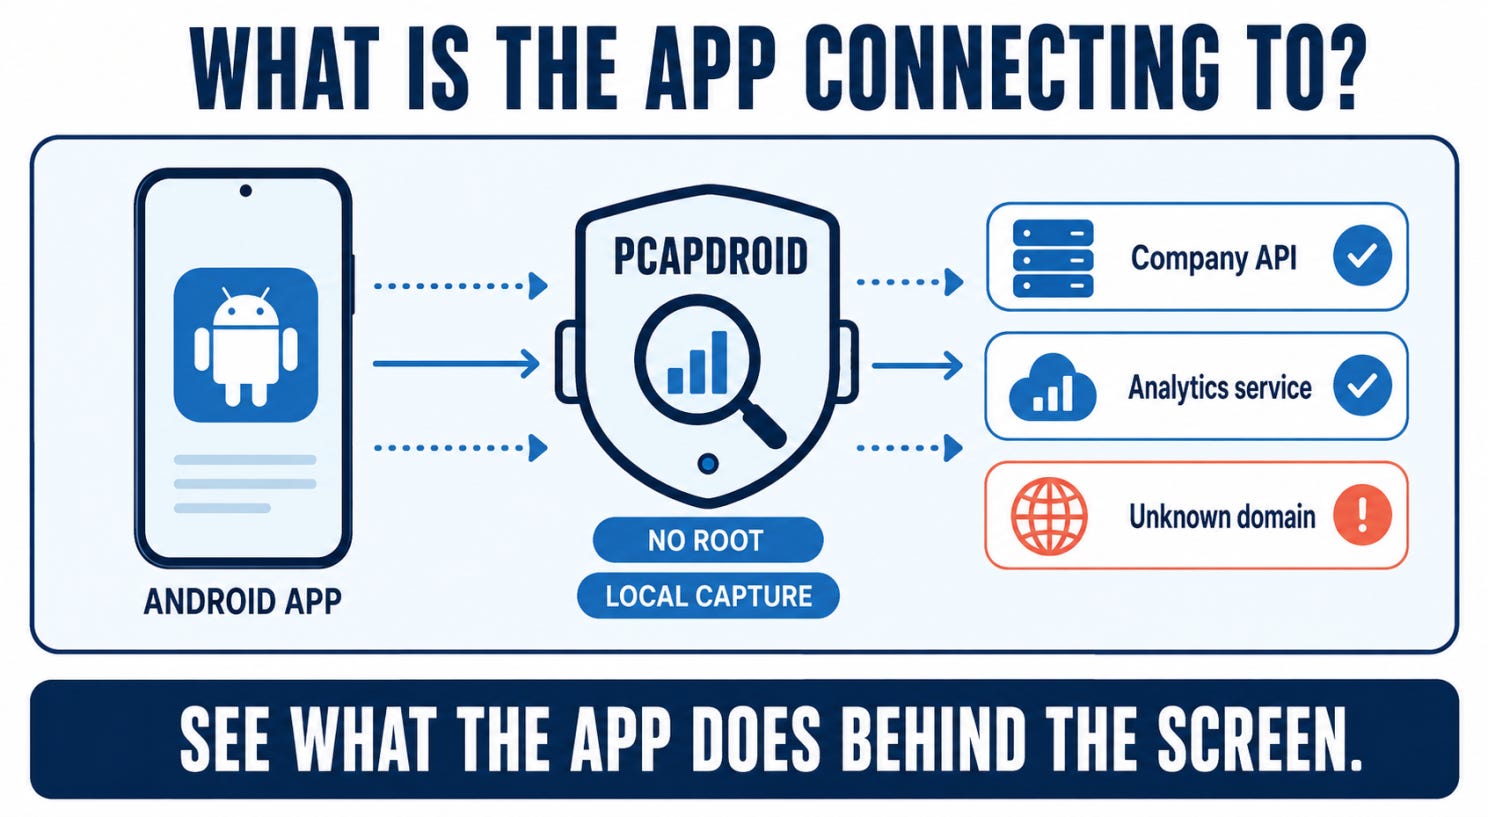
PCAPdroid permite a los equipos de seguridad capturar ese tráfico directamente en Android sin root. Esto ayuda a revelar conexiones que los usuarios y los equipos de seguridad no pueden ver en pantalla.
Cómo funciona PCAPdroid
PCAPdroid usa una VPN local para observar el tráfico sin que este salga del dispositivo. Un analista puede monitorizar todo el teléfono o centrarse en una sola aplicación.
Una vez iniciada la captura, PCAPdroid muestra a qué servidores se conecta la aplicación, cuándo se producen las conexiones y cuántos datos se intercambian. Así resulta más fácil detectar servicios desconocidos, servidores antiguos y conexiones en segundo plano.
La captura también puede abrirse en Wireshark para examinarla con más detalle. Con una configuración adicional, PCAPdroid a veces puede mostrar el contenido del tráfico cifrado, aunque esto no funciona con todas las aplicaciones.
Un ejemplo sencillo
Imaginemos que una empresa añade una nueva herramienta de analítica a su aplicación Android.
Antes de publicar la actualización, un analista selecciona la aplicación en PCAPdroid e inicia una captura. Inicia sesión, abre distintas pantallas y luego deja la aplicación inactiva.
La mayoría de las conexiones van a la API de la empresa y al servicio de analítica esperado. Sin embargo, aparece otro dominio tras el inicio de sesión y sigue recibiendo tráfico mientras la aplicación está en segundo plano.
La conexión puede ser legítima, pero ahora el equipo sabe que existe, cuándo comienza y dónde investigar.
Lo que no sustituye
PCAPdroid solo muestra la actividad de red. No encontrará almacenamiento inseguro, autenticación débil ni otros problemas que no aparecen en el tráfico.
Las capturas también pueden contener información sensible, por lo que deben crearse en dispositivos de prueba autorizados y manejarse con cuidado.
👏 Persona de la semana
Emanuele Faranda
Esta semana destacamos a Emanuele Faranda, el desarrollador independiente detrás de PCAPdroid.
Capturar el tráfico de red de una aplicación Android suele requerir un dispositivo con root o una configuración de pruebas complicada. Emanuele creó PCAPdroid para facilitar ese proceso y permitir monitorizar las conexiones de las aplicaciones directamente en Android sin root.
El proyecto ayuda a investigadores de seguridad, desarrolladores y usuarios preocupados por la privacidad a ver con qué servidores se comunica una aplicación, inspeccionar su tráfico y exportar capturas para analizarlas con más detalle en Wireshark.
Su trabajo incluye también PCAPdroid-mitm, que añade el descifrado de tráfico TLS, y zdtun, el componente de red que sustenta la captura sin root de PCAPdroid.
Por hacer más accesible el análisis del tráfico de Android y seguir manteniendo estas herramientas como proyectos de código abierto, Emanuele Faranda es nuestra Persona de la semana.
📅 Evento de la semana
next.app devCon 2026
Si su trabajo se sitúa entre el desarrollo móvil y la seguridad de aplicaciones, next.app devCon merece un hueco en el calendario.
El evento reúne ocho conferencias para desarrolladores, entre ellas droidCon, flutterCon, swiftCon, reactCon y masCon, su conferencia dedicada a la seguridad de aplicaciones móviles.
A lo largo de tres días, el evento combina charlas técnicas y talleres sobre Android, iOS, desarrollo multiplataforma, programación agéntica, liderazgo de ingeniería y seguridad móvil.
Para los equipos de AppSec, la combinación resulta útil: masCon se centra en proteger las aplicaciones móviles, mientras que las demás conferencias muestran cómo se están creando esas aplicaciones y qué herramientas y frameworks adoptan los desarrolladores.
📍 CityCube Berlín, Alemania
📅 7–9 de octubre de 2026
📚 Libro de la semana
Practical Reverse Engineering
De Bruce Dang, Alexandre Gazet, Elias Bachaalany y Sébastien Josse
¿Cómo se entiende lo que hace un software cuando no se puede ver su código fuente?
Practical Reverse Engineering explica cómo estudian los analistas el software compilado en x86, x64 y ARM. También abarca el kernel de Windows, los controladores, la depuración, la ofuscación de código y las herramientas utilizadas durante el análisis.
Con recorridos prácticos y ejercicios, el libro ayuda a los lectores a adquirir los conocimientos de bajo nivel necesarios para investigar malware, comprender las protecciones de software y examinar programas desconocidos.
Es una lectura útil para investigadores de seguridad e ingenieros que quieren ir más allá de ejecutar herramientas de ingeniería inversa y entender qué ocurre por debajo.
😅 El meme
Si su proceso de pruebas de seguridad depende de varios equipos antes y después de cada escaneo, ¿cómo lo escalaría cuando la automatización solo puede simplificar una parte del trabajo?
The Breach Brief, Equipo de Ostorlab