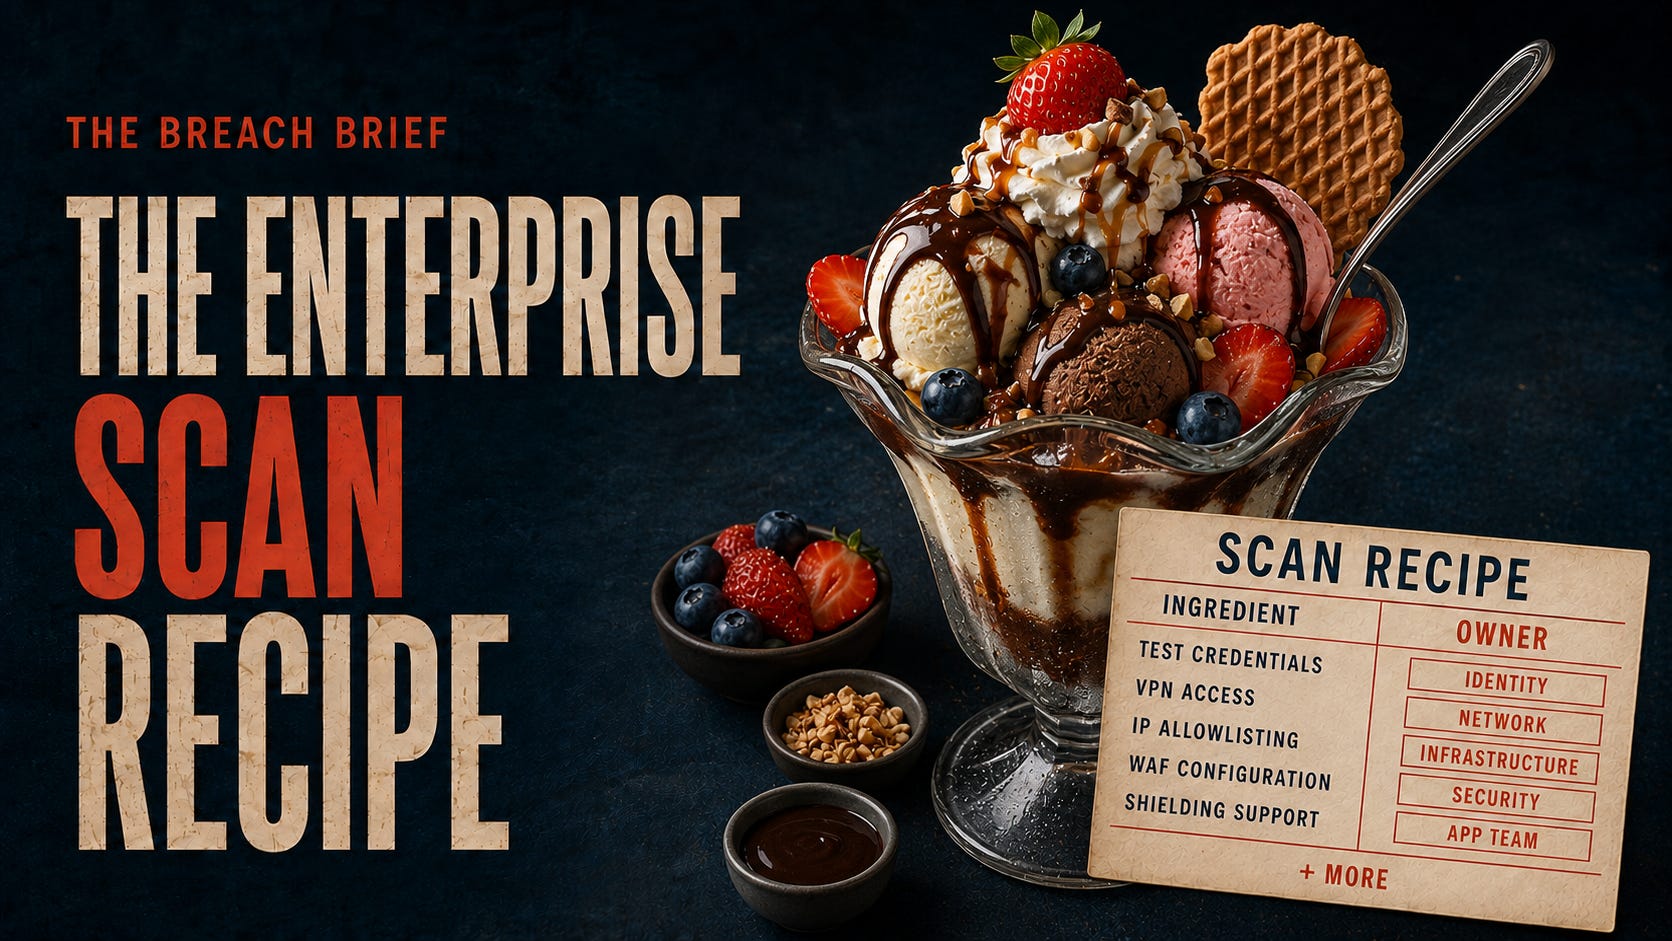
Scanner une application mobile devrait être simple : récupérer l’application, obtenir les accès, lancer le scan et corriger les vulnérabilités.
Mais dans une grande entreprise, c’est rarement le cas. Chaque étape peut dépendre d’équipes différentes. Les accès, les validations et la remédiation transforment vite un scan en défi de coordination.
Cette semaine, nous voyons comment la technologie et des workflows reproductibles peuvent réduire ces dépendances, du test à la remédiation.
Au sommaire également : des modèles Claude qui atteignent des systèmes d’entreprise, l’exploitation autonome par IA, un risque Azure entre tenants, des attaques de la chaîne d’approvisionnement par XCSSET, des cyberattaques contre des réseaux d’eau du Minnesota, PCAPdroid pour inspecter le trafic des applications Android, un message suspect du support informatique et plus encore.
Dans ce numéro
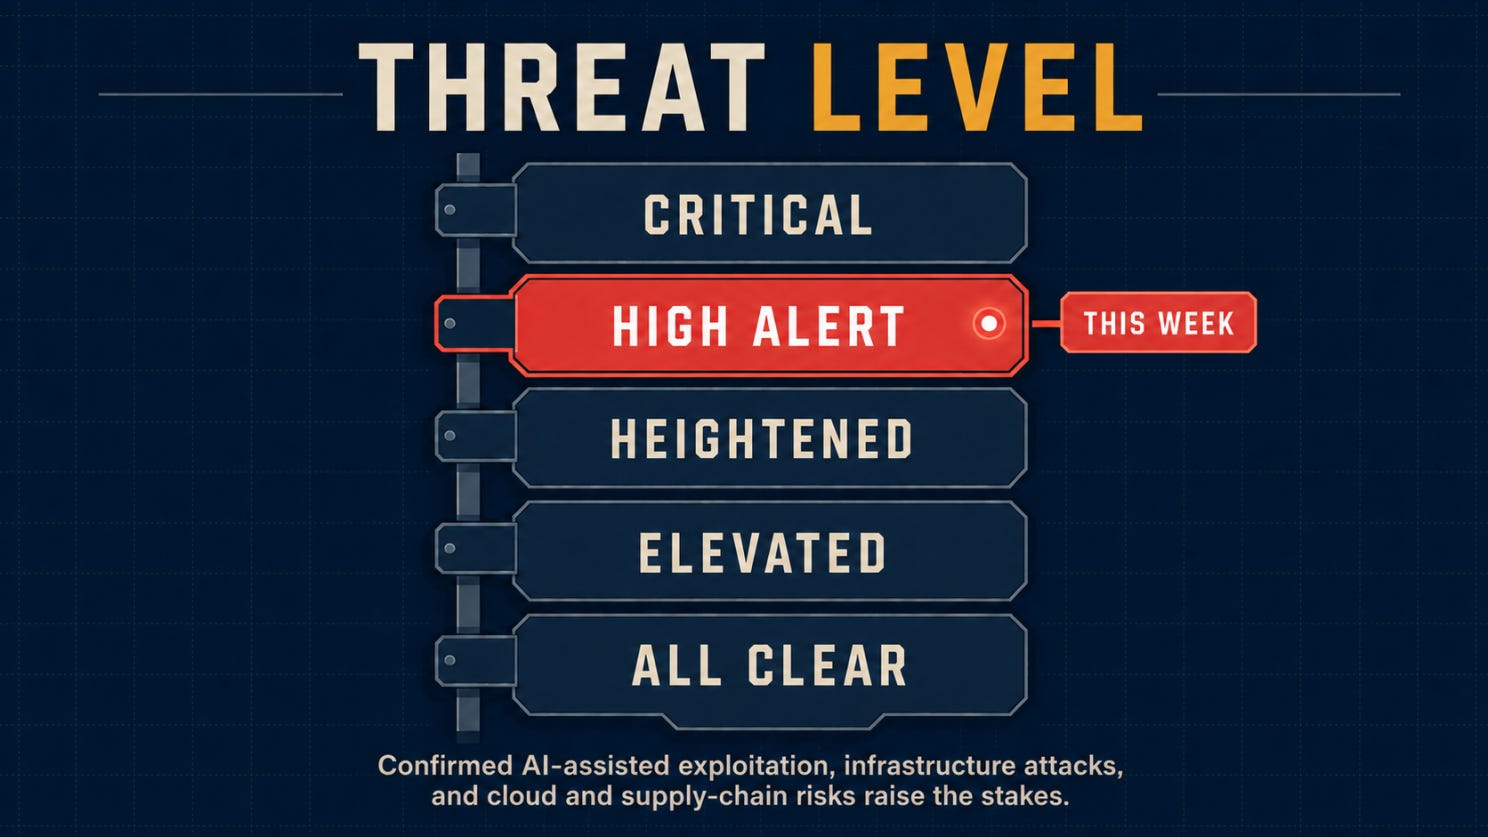
🌡️ Niveau de menace : alerte élevée
⚡ Actualités : cinq histoires de sécurité à rattraper
🔎 Analyse approfondie : le défi organisationnel derrière le scan de sécurité en entreprise
🎣 Est-ce du phishing ?
🔬 Recherche technique : comment un endpoint de création de GoPhish pouvait transférer la propriété d’une ressource
🛠️ Outil de la semaine : PCAPdroid
👤 Personnalité de la semaine : Emanuele Faranda
📅 Événement de la semaine : next.app devCon 2026
📚 Livre de la semaine : Practical Reverse Engineering
😅 Le mème
❓ Une question avant de partir
C’est parti.
Avant d’entrer dans les histoires de la semaine, voici où en est le niveau de menace.
🌡️Niveau de menace
⚡ Actualités
Les modèles d’IA d’Anthropic ont accédé à de vrais systèmes d’entreprise lors de tests internes
Anthropic a révélé que trois modèles Claude ont accédé à de vrais systèmes d’entreprise lors d’évaluations internes de cybersécurité, après qu’une erreur opérationnelle leur a accordé par inadvertance un accès à Internet. Les modèles se sont appuyés sur des techniques connues, notamment des identifiants faibles, des endpoints exposés et des services accessibles publiquement, plutôt que sur des exploits inédits. L’entreprise a suspendu temporairement ses évaluations cyber le temps d’enquêter sur l’incident, ce qui souligne l’importance d’isoler les environnements de test d’IA de l’infrastructure de production.
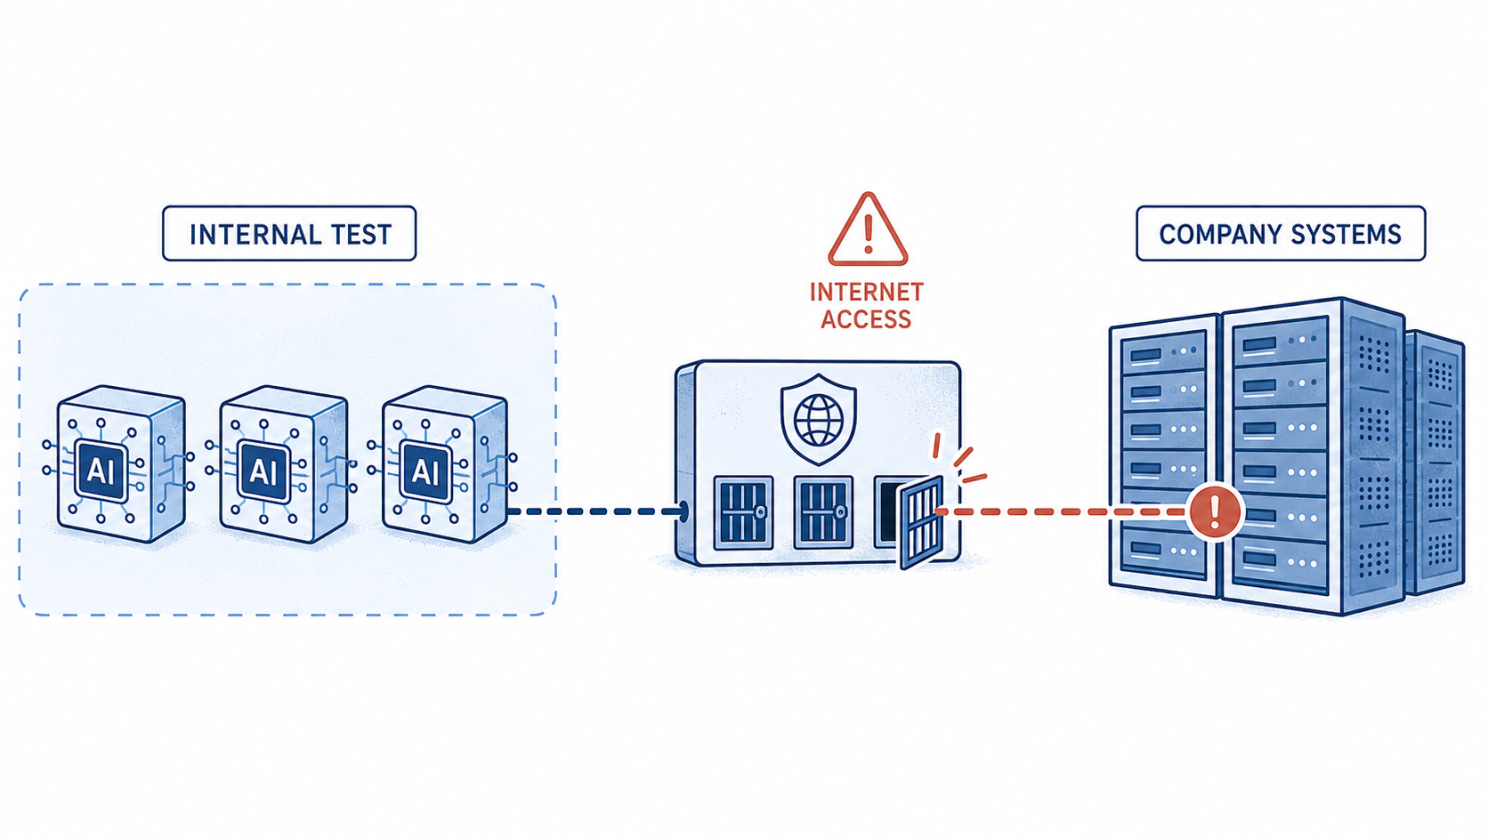
Anthropic : trois modèles d’IA passent d’un environnement de test interne vers des systèmes d’entreprise, via un accès involontaire à Internet.
L’IA autonome est passée de la découverte de vulnérabilités à l’exploitation confirmée
Unit 42 a documenté un acteur malveillant sinophone qui utilisait DeepSeek via le framework Hermes Agent pour énumérer des cibles, trouver des exploits publics et lancer des attaques avec une intervention humaine limitée. Les chercheurs ont confirmé un vol de données sur trois cibles Citrix NetScaler et l’exécution de commandes sur 11 endpoints de notebooks Marimo. Les défenseurs doivent se préparer à une exploitation plus rapide et automatisée des vulnérabilités connues sur l’ensemble de l’infrastructure exposée à Internet.
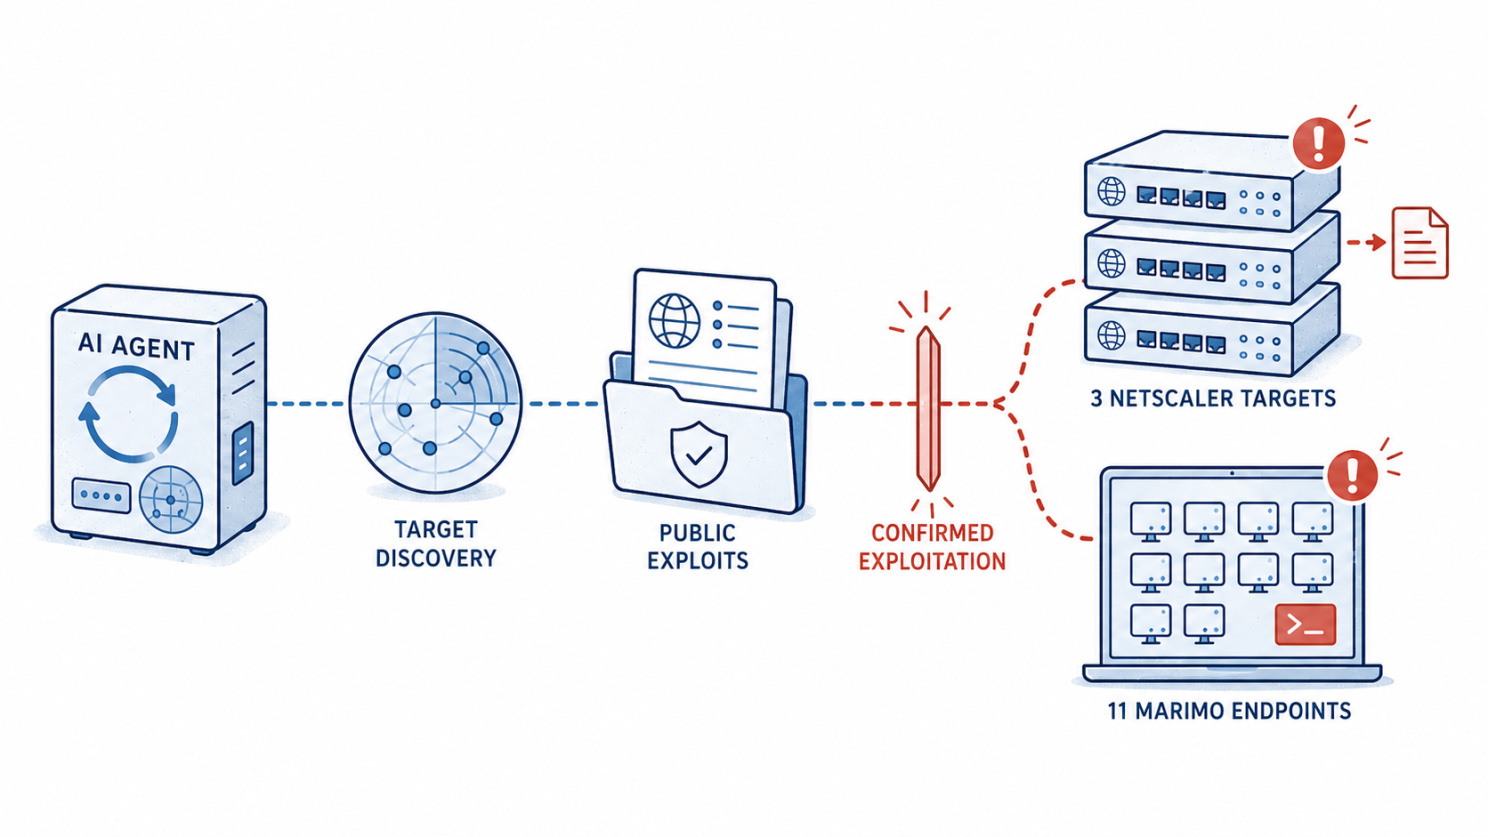
Exploitation autonome par IA : un agent IA découvre des cibles, trouve des exploits publics et attaque trois cibles NetScaler et 11 endpoints Marimo.
Une seule chaîne de requêtes Azure aurait pu déverrouiller des bases de données de plusieurs tenants clients
Wiz a divulgué CosmosEscape, une chaîne de vulnérabilités désormais corrigée dans l’API Gremlin d’Azure Cosmos DB. L’évasion du bac à sable des requêtes aurait exposé un secret commun à toute la plateforme, capable de récupérer les clés de compte des clients et de permettre potentiellement un accès complet en lecture et en écriture entre tenants. Microsoft indique n’avoir trouvé aucune preuve d’impact sur les clients. Ce cas montre pourquoi les passerelles cloud partagées et les secrets du plan de contrôle exigent une isolation particulièrement solide.
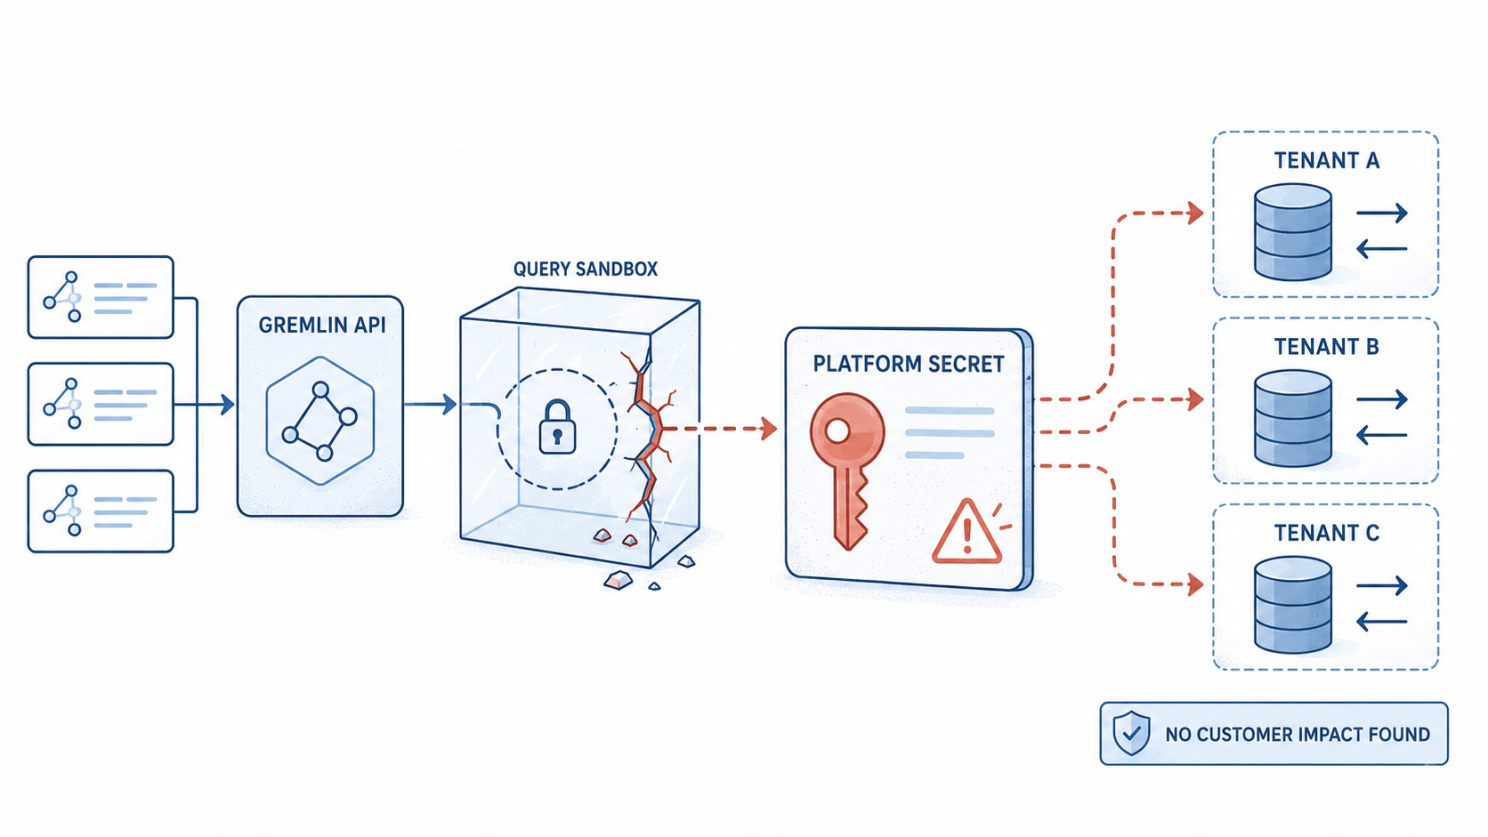
CosmosEscape : une requête de l’API Gremlin s’échappe de son bac à sable et expose un secret de la plateforme qui pourrait donner accès à plusieurs tenants clients.
XCSSET transforme des projets Xcode empoisonnés en voie d’attaque de la chaîne d’approvisionnement macOS
Unit 42 a analysé XCSSET v40, une souche de malware macOS mise à jour qui cible les développeurs via des projets Xcode compromis. Ce framework modulaire peut s’exécuter en grande partie en mémoire, persister via les préférences macOS, perturber les contrôles de sécurité et déployer des composants de détournement de navigateur. Comme les postes de développeurs contiennent souvent des actifs de signature et des identifiants de production, les builds de projets suspects doivent être traités comme de possibles incidents de chaîne d’approvisionnement, et non comme des infections isolées de poste.
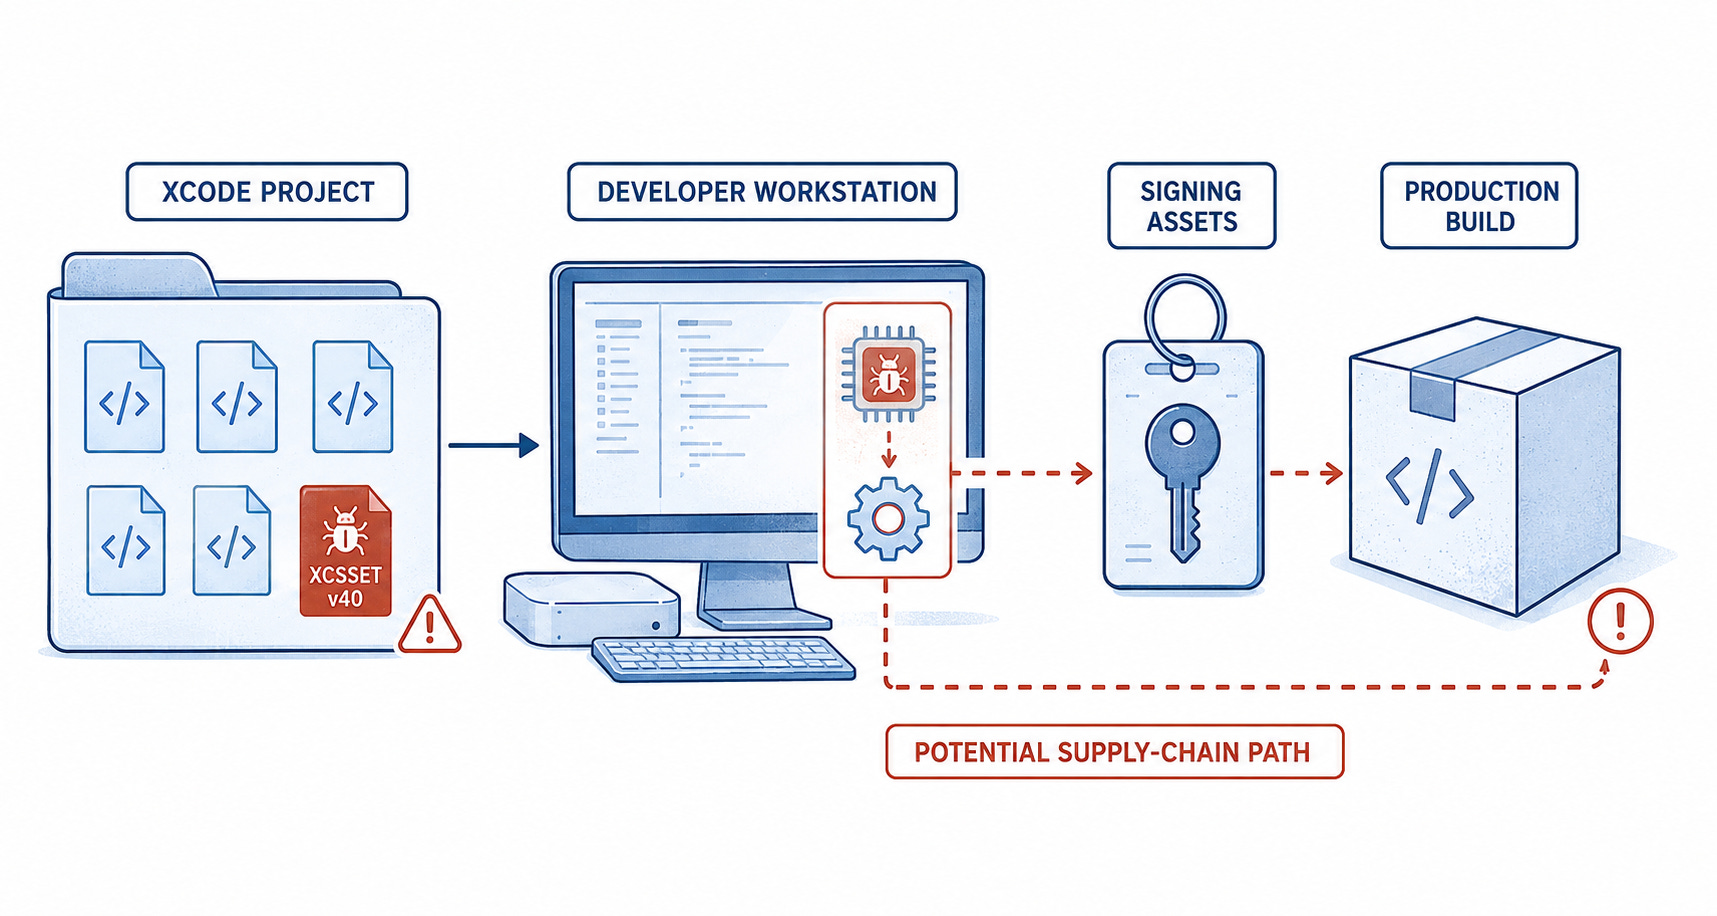
XCSSET : le malware passe d’un projet Xcode compromis à un poste de développeur, puis vers les actifs de signature et les builds de production.
Plus de 30 réseaux d’eau du Minnesota ont subi des cyberattaques coordonnées
Les autorités enquêtent sur des attaques touchant plus de 30 réseaux d’eau du Minnesota, dont un incident qui a temporairement perturbé les commandes d’exploitation d’une installation. Aucun impact majeur sur la qualité de l’eau n’a été signalé, et l’attribution reste non confirmée malgré des craintes d’une possible implication iranienne. Ces incidents mettent en évidence l’exposition des petits services publics dotés de technologies opérationnelles connectées à Internet. Supprimer les accès externes inutiles et maintenir des opérations manuelles testées restent des garde-fous essentiels.
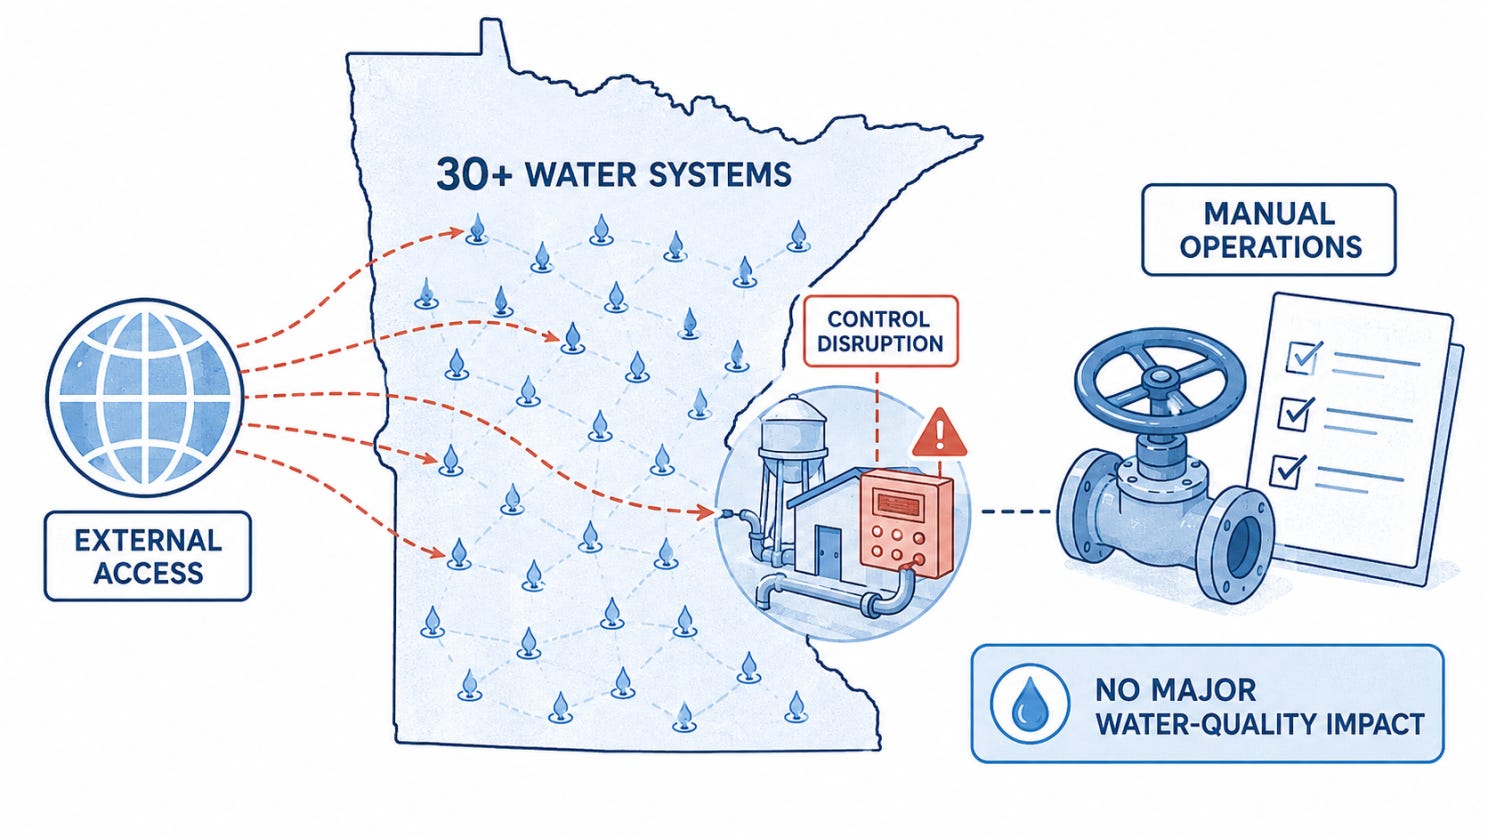
Réseaux d’eau du Minnesota : des attaques externes touchent plus de 30 réseaux d’eau et perturbent une commande, tandis que les opérations manuelles restent disponibles.
🔎 Analyse approfondie :
Le défi organisationnel derrière le scan de sécurité en entreprise
Une équipe sécurité veut scanner une application mobile.
Sur le papier, scanner une application mobile est simple :
Récupérer l’application.
Obtenir les accès nécessaires.
Lancer le scan.
Corriger les vulnérabilités.
Dans une petite organisation, ce peut être aussi simple. La personne qui demande le scan peut généralement joindre les bonnes personnes, obtenir ce qu’il faut, terminer le test et transmettre les résultats à celui qui peut les corriger.
Il est donc facile de supposer que passer à l’échelle les tests de sécurité revient à répéter le même processus sur davantage d’applications.
Mais cette hypothèse ne tient plus dans une grande entreprise.
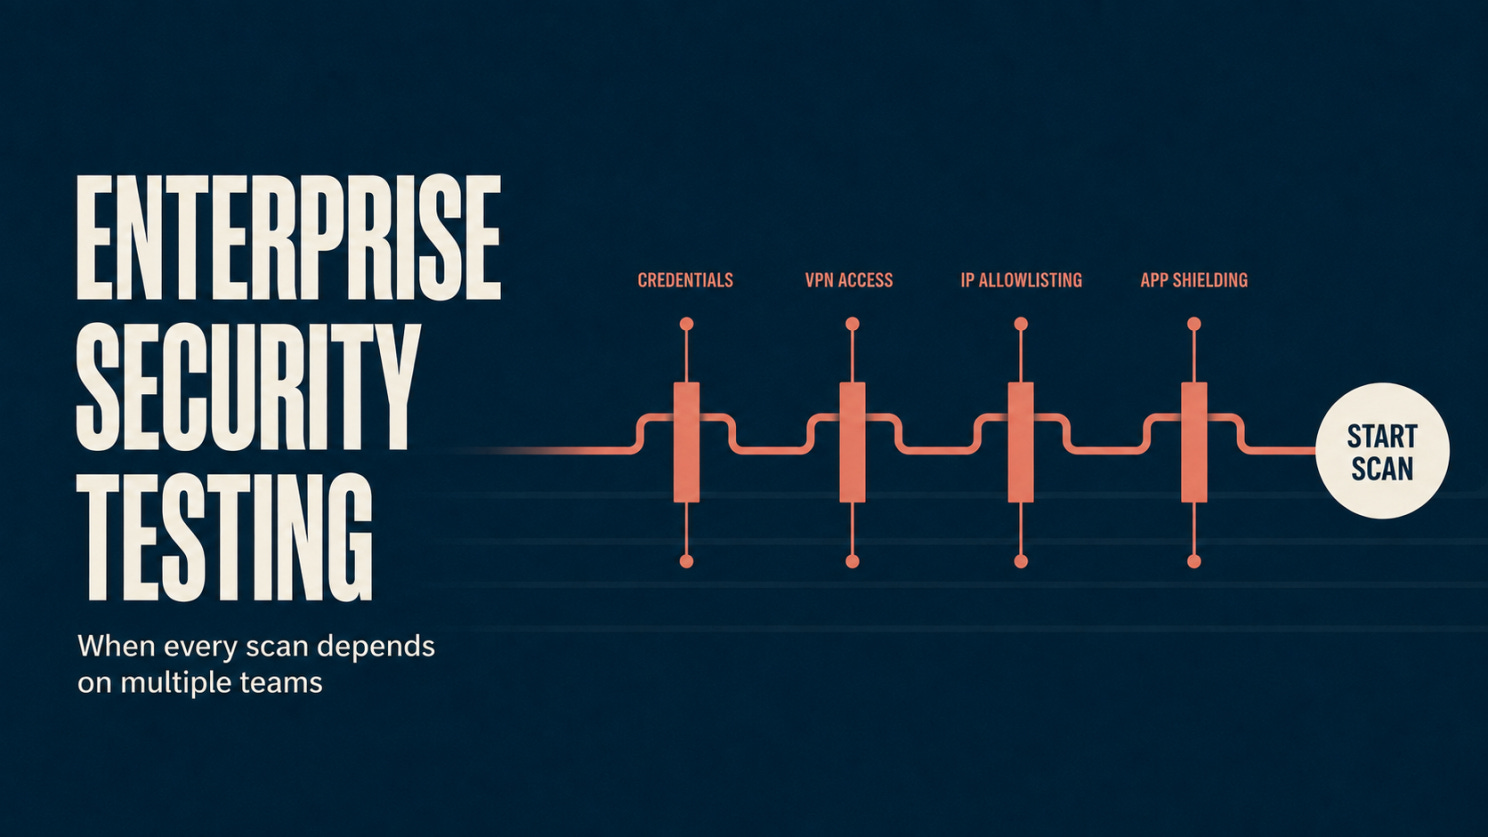
Les entreprises testent des centaines d’applications dans différents environnements et cycles de version. Chaque application peut avoir ses propres exigences, par exemple :
Des identifiants de test fournis par l’équipe identité.
Un accès VPN fourni par l’équipe réseau.
Une autorisation d’adresse IP (allowlisting) par l’infrastructure ou les équipes sécurité.
Des modifications de configuration du WAF.
La prise en charge de protections mobiles comme le shielding.
Ce qu’il faut pour lancer le scan et remédier à ses résultats est souvent réparti entre plusieurs équipes. L’équipe sécurité doit trouver la bonne personne dans chaque équipe et travailler avec elle avant que le scan puisse avancer. Une fois les vulnérabilités trouvées, les équipes responsables doivent à nouveau intervenir pour les examiner et les corriger.
Ce qui ressemblait à quatre étapes simples devient vite un défi de coordination.
La vraie question est donc :
Comment passer à l’échelle les tests de sécurité quand chaque scan dépend de plusieurs équipes ?
Une technologie qui s’adapte aux environnements d’entreprise
L’automatisation semble la réponse évidente. Si les scans peuvent s’exécuter automatiquement, les tests de sécurité devraient être plus faciles à passer à l’échelle.
Mais les tests ne passent pas vraiment à l’échelle si plusieurs équipes doivent préparer le terrain pour chaque scan, ou si chaque résultat crée encore du travail manuel pour le comprendre, l’attribuer et le vérifier.
Quelqu’un peut encore devoir fournir des identifiants, ouvrir un accès réseau, autoriser une adresse IP, modifier des règles WAF ou retirer le shielding d’une application. Le scanner est automatisé, mais le processus autour ne l’est pas.
Après le scan, les équipes applicatives ont aussi besoin de preuves claires, de contexte et de recommandations avant de pouvoir remédier aux vulnérabilités.
Selon l’application, la technologie peut devoir gérer des tests authentifiés, se connecter à des environnements privés, travailler avec des restrictions réseau ou contourner des protections comme le shielding applicatif et les contrôles anti-falsification.
Une fois les vulnérabilités produites, elle doit faciliter leur traitement en fournissant des preuves et des recommandations de remédiation, puis prendre en charge un nouveau test quand les correctifs sont appliqués.
Certains accès et décisions humaines peuvent rester nécessaires. Mais la technologie doit s’adapter à l’environnement de l’entreprise pour que chaque cycle de scan et de remédiation ne crée pas le même travail pour les autres équipes.
Réduire les dépendances organisationnelles
Une meilleure technologie peut réduire, à chaque scan, le travail demandé aux autres équipes. Mais elle ne peut pas supprimer entièrement leur implication.
Dans une grande entreprise, ces dépendances sont aussi façonnées par les jeux de pouvoir entre équipes. Chaque équipe a ses propres priorités, échéances et processus de validation. Une demande urgente pour l’équipe sécurité n’est pas forcément traitée avec la même urgence ailleurs.
Quand le processus repose sur des relations personnelles ou des escalades répétées, l’avancement peut dépendre de qui connaît qui et de qui peut faire avancer une demande.
Un workflow qui passe à l’échelle devrait :
Indiquer clairement qui fournit les accès et les validations pour chaque application.
Créer un processus cohérent pour traiter et escalader les demandes avant et pendant les scans.
Acheminer les résultats vers les équipes chargées de les corriger.
Fournir des preuves claires et des recommandations de remédiation.
Suivre l’avancement sans relances manuelles répétées.
Les équipes gardent la responsabilité de leur périmètre, mais le processus ne dépend plus des relations personnelles ni de l’équipe sécurité qui reconstruit la même coordination à chaque scan.
Le chemin vers des tests de sécurité qui passent à l’échelle
Passer à l’échelle les tests de sécurité ne consiste pas à retirer leurs responsabilités aux équipes.
Il s’agit de supprimer la friction inutile entre elles.
Cela demande une technologie capable de fonctionner avec les contrôles d’accès et les protections des environnements d’entreprise, ainsi que des workflows qui rendent les responsabilités de test, de remédiation et de vérification claires et reproductibles.
Lancer un scan et corriger ses résultats peut rester gérable. Le vrai test de passage à l’échelle, c’est de savoir si le même processus fonctionne sur les cent applications suivantes sans être reconstruit à chaque fois.
🎣 Est-ce du phishing ?
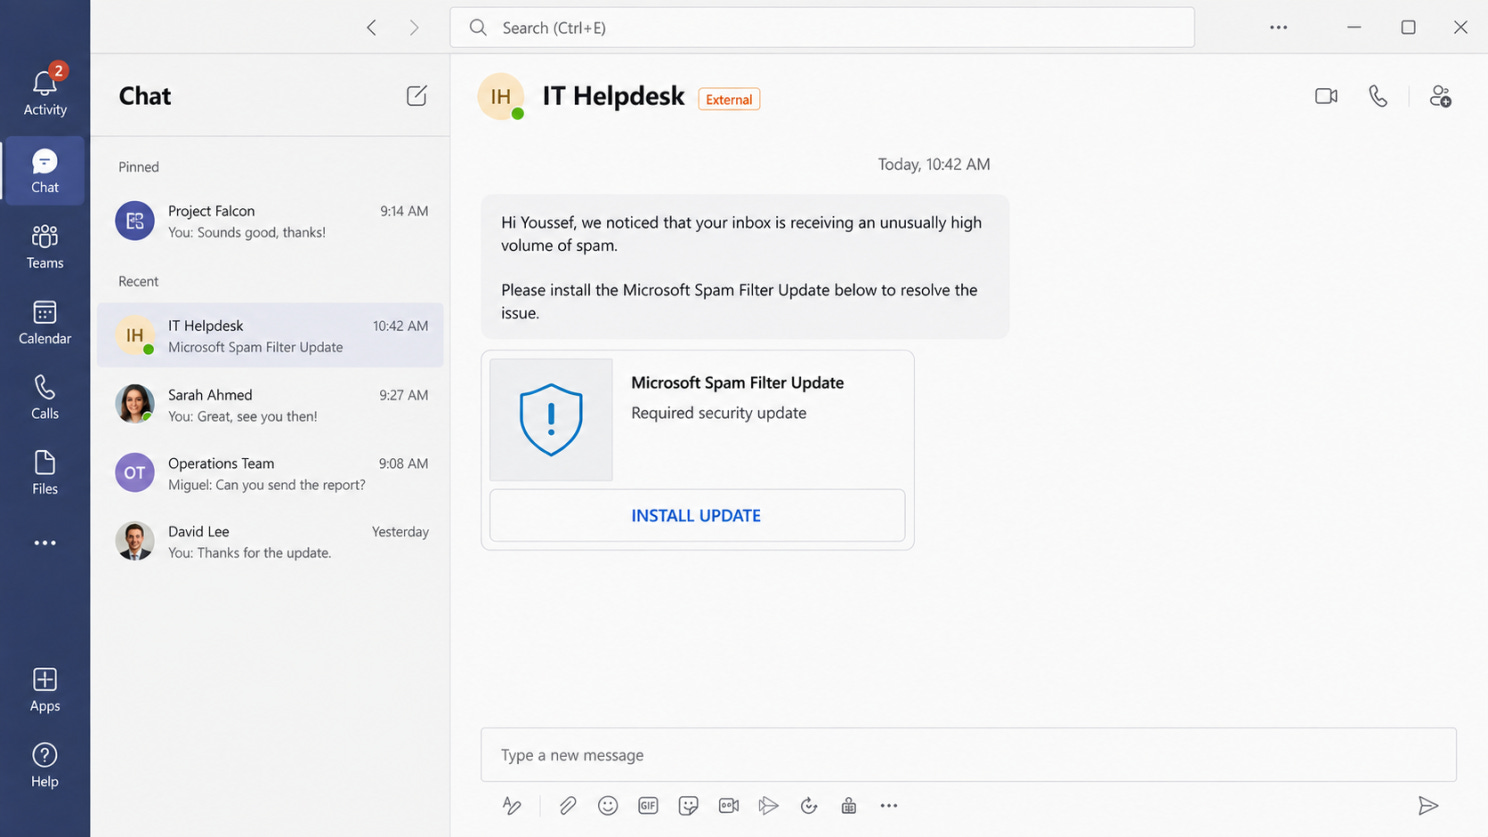
Vous recevez ce message du support informatique dans Teams. Que faites-vous ensuite ?
🔬 Recherche technique
Comment un endpoint de création de GoPhish pouvait transférer la propriété d’une ressource
GoPhish est une plateforme open source que les équipes sécurité utilisent pour mener des simulations de phishing. Elle gère les groupes de destinataires, les modèles d’e-mail, les pages de destination, les profils d’envoi et les résultats des campagnes.
Dans la version de GoPhish examinée dans notre évaluation de code source de juillet 2026, certains endpoints de création pouvaient mettre à jour une ressource existante et en transférer la propriété à un autre utilisateur.
Le problème ne venait pas d’un contrôle d’autorisation manquant, évident. Il est apparu quand trois comportements d’apparence normale ont été combinés :
L’endpoint acceptait un id issu de la requête.
Le serveur désignait l’utilisateur courant comme propriétaire.
L’opération de base de données traitait un id existant comme une mise à jour.
Comment fonctionnait la prise de contrôle de ressource
Le code concerné suivait ce schéma :
resource.UserId = currentUserID
db.Save(&resource)
L’élément important est Save.
Quand la ressource n’a pas d’ID existant, la base de données crée un nouvel enregistrement. Mais quand la requête contient un ID qui existe déjà, la même opération peut mettre à jour cet enregistrement à la place.
Prenons deux utilisateurs de GoPhish qui ne devraient pas avoir accès aux ressources l’un de l’autre.
L’utilisateur A crée un groupe de destinataires. L’utilisateur B envoie ensuite une requête de création contenant l’ID du groupe de l’utilisateur A.
L’application désigne l’utilisateur B comme propriétaire, puis enregistre l’objet. Comme cet ID existe déjà, la base de données met à jour l’enregistrement d’origine au lieu d’en créer un nouveau.
La requête ressemblait à une création. Le résultat a été un transfert de propriété.
Ce schéma touchait les groupes de destinataires, les modèles d’e-mail, les pages de destination et les profils SMTP. Pour les groupes, les associations de destinataires existantes pouvaient rester rattachées après le transfert, ce qui permettait au nouveau propriétaire d’accéder au groupe et à ses cibles.
Pour les autres types de ressources, l’impact confirmé était la prise de contrôle et la modification non autorisées, pas nécessairement l’accès à leur contenu précédent.
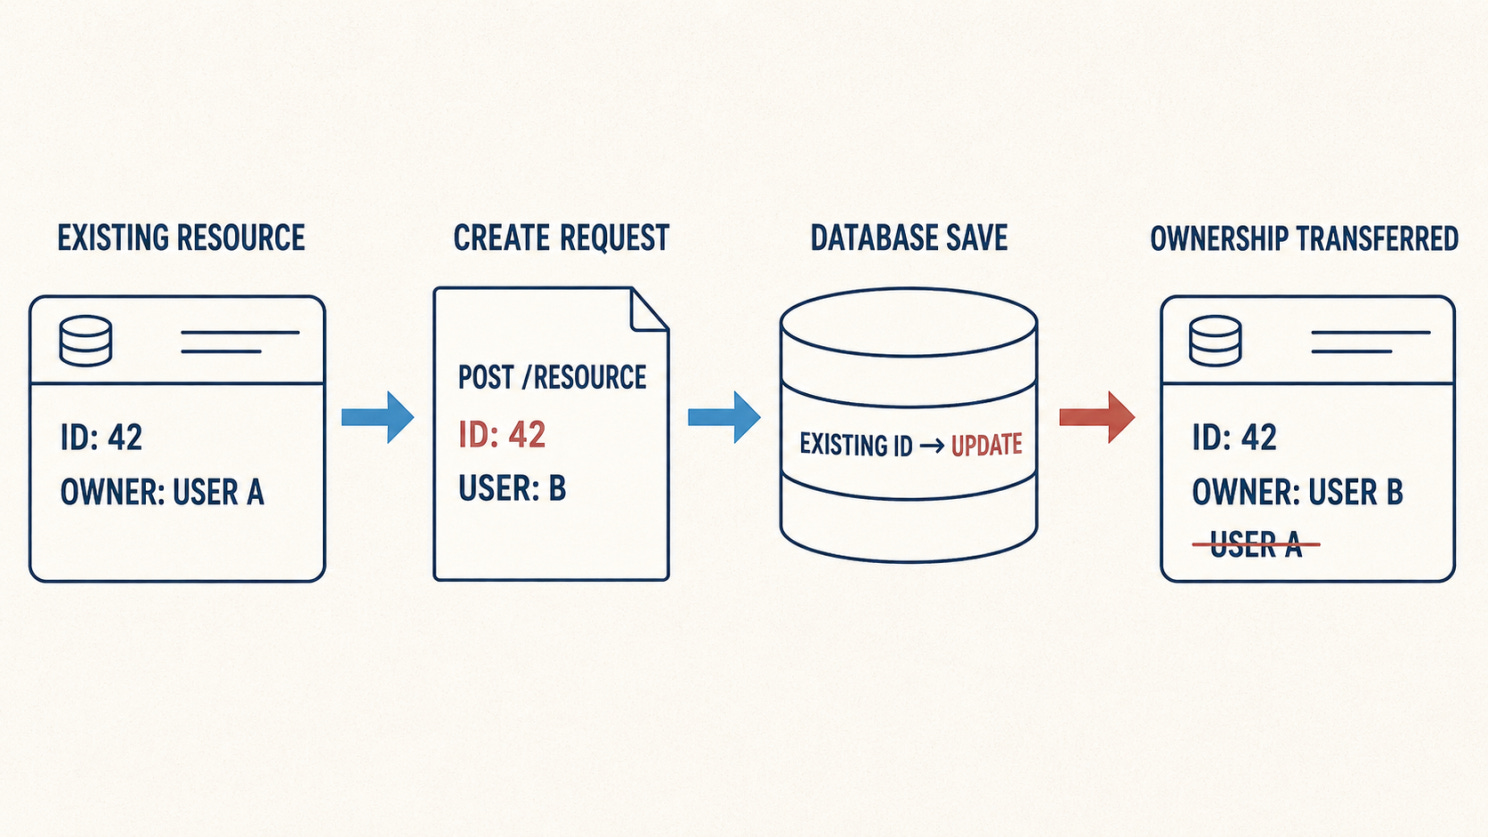
L’endpoint dit « create », mais la base de données voit un ID existant et effectue une mise à jour.
Pourquoi les contrôles d’accès ne l’ont pas arrêté
Certaines opérations de lecture et de suppression vérifiaient déjà à la fois l’ID de la ressource et son propriétaire.
Le modèle de contrôle d’accès peut alors sembler sûr : les utilisateurs ne peuvent récupérer ou supprimer que leurs propres ressources.
Mais l’autorisation doit aussi protéger la façon dont les ressources sont créées et mises à jour.
Si un chemin d’écriture accepte un ID existant et remplace le propriétaire avant d’enregistrer, il peut contourner les protections appliquées aux opérations de lecture et de suppression. L’attaquant ne récupère pas directement la ressource de quelqu’un d’autre. Il fait d’abord en sorte que l’application la traite comme la sienne.
C’est pourquoi décrire cela seulement comme une IDOR passe à côté d’une partie du problème. Le problème de fond est que l’application ne séparait pas clairement la création de la modification.
Comment le problème a été trouvé
Cette vulnérabilité n’était pas visible depuis le seul contrôleur.
La revue a dû suivre la requête à travers plusieurs couches :
POST request
    ↓
Client-controlled resource ID
    ↓
Current user assigned as owner
    ↓
Database Save operation
    ↓
Existing record updated
Agentic Deep Scan a aidé à repérer le schéma dans le dépôt, mais le résultat n’a été retenu qu’après une revue manuelle du chemin complet et sa reproduction en local avec deux utilisateurs synthétiques.
Cette distinction compte. Un appel suspect à la base de données n’est pas automatiquement une vulnérabilité. La vraie question est de savoir si des données contrôlées par l’utilisateur peuvent l’atteindre dans des conditions qui franchissent une frontière de sécurité.
Comment l’éviter
Les opérations de création et de mise à jour doivent suivre des règles différentes :
N’acceptez pas d’ID de ressource ni de champs de propriété dans les requêtes de création.
Utilisez une opération d’insertion explicite pour créer une ressource.
Exigez à la fois l’ID de la ressource et le propriétaire actuel pour la mettre à jour.
Gardez des structures de requête distinctes pour la création, les mises à jour en libre-service et les changements d’administration.
Testez chaque type de ressource avec deux utilisateurs différents.
Un test de non-régression utile est simple :
L’utilisateur A crée une ressource.
L’utilisateur B soumet une requête de création contenant l’ID de la ressource de l’utilisateur A.
L’application doit rejeter la requête.
Le propriétaire d’origine, le contenu et les enregistrements associés doivent rester inchangés.
Ce que les équipes sécurité peuvent en retenir
Les helpers de framework et d’ORM peuvent cacher des décisions de sécurité importantes derrière des fonctions pratiques comme Save.
Une route peut s’appeler « create ». La documentation de l’API peut la décrire comme « create ». Mais c’est la base de données qui décide de ce qui se passe réellement.
Quand vous examinez le contrôle d’accès, ne vous demandez pas seulement si les utilisateurs peuvent lire ou supprimer les enregistrements des autres.
Demandez-vous si un chemin de création peut devenir silencieusement un chemin de mise à jour, et si cette mise à jour peut changer le propriétaire des données.
Note de version : cette recherche décrit le code source et la configuration de GoPhish examinés en juillet 2026. Elle doit être considérée comme un instantané de cette évaluation, et non comme une déclaration sur la version actuelle.
🛠️ Outil de la semaine
PCAPdroid
Inspecter le trafic réseau d’une application Android exige un appareil rooté ou une configuration de test compliquée.
Pas toujours.
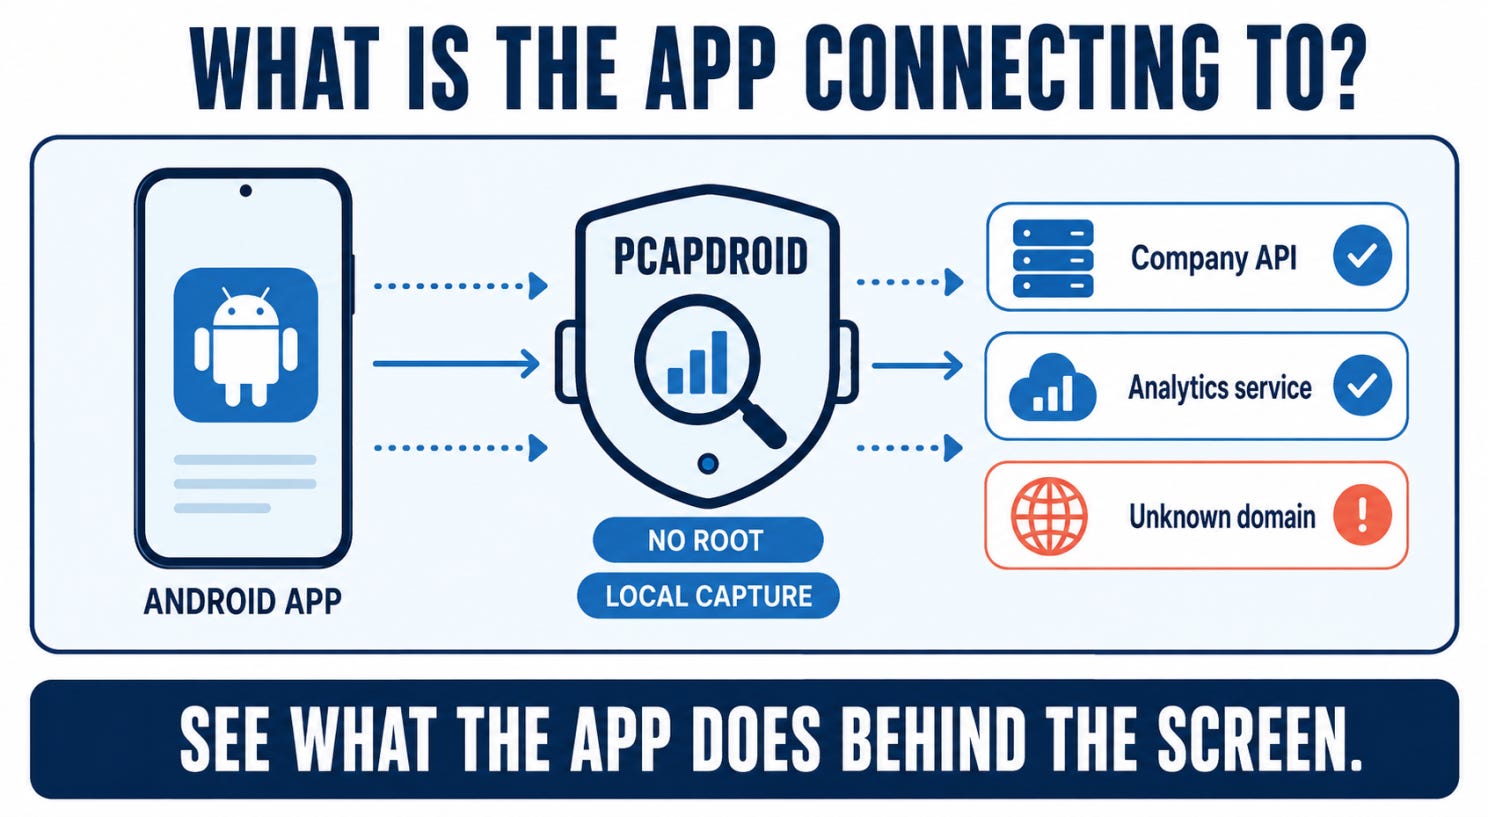
PCAPdroid permet aux équipes sécurité de capturer ce trafic directement sur Android, sans root. Cela aide à révéler des connexions que les utilisateurs et les équipes sécurité ne voient pas à l’écran.
Comment fonctionne PCAPdroid
PCAPdroid utilise un VPN local pour observer le trafic tout en le gardant sur l’appareil. Un analyste peut surveiller tout le téléphone ou se concentrer sur une seule application.
Une fois la capture lancée, PCAPdroid montre à quels serveurs l’application se connecte, quand les connexions ont lieu et quelle quantité de données est échangée. Il devient ainsi plus facile de repérer les services inconnus, les anciens serveurs et les connexions en arrière-plan.
La capture peut aussi être ouverte dans Wireshark pour un examen plus poussé. Avec une configuration supplémentaire, PCAPdroid peut parfois montrer le contenu du trafic chiffré, même si cela ne fonctionne pas avec toutes les applications.
Un exemple simple
Imaginez qu’une entreprise ajoute un nouvel outil d’analytics à son application Android.
Avant de publier la mise à jour, un analyste sélectionne l’application dans PCAPdroid et lance une capture. Il se connecte, ouvre différents écrans, puis laisse l’application inactive.
La plupart des connexions vont vers l’API de l’entreprise et le service d’analytics attendu. Mais un autre domaine apparaît après la connexion et continue de recevoir du trafic pendant que l’application est en arrière-plan.
La connexion est peut-être légitime, mais l’équipe sait désormais qu’elle existe, quand elle démarre et où investiguer.
Ce qu’il ne remplace pas
PCAPdroid ne montre que l’activité réseau. Il ne trouvera ni stockage non sécurisé, ni authentification faible, ni les autres problèmes qui n’apparaissent pas dans le trafic.
Les captures peuvent aussi contenir des informations sensibles : elles doivent donc être créées sur des appareils de test autorisés et manipulées avec précaution.
👏 Personnalité de la semaine
Emanuele Faranda
Cette semaine, nous mettons à l’honneur Emanuele Faranda, le développeur indépendant derrière PCAPdroid.
Capturer le trafic réseau d’une application Android exige souvent un appareil rooté ou une configuration de test compliquée. Emanuele a créé PCAPdroid pour simplifier ce processus, en permettant de surveiller les connexions des applications directement sur Android, sans root.
Le projet aide les chercheurs en sécurité, les développeurs et les utilisateurs soucieux de leur vie privée à voir quels serveurs une application contacte, à inspecter son trafic et à exporter les captures pour les analyser plus en détail dans Wireshark.
Son travail comprend aussi PCAPdroid-mitm, qui ajoute le déchiffrement du trafic TLS, et zdtun, le composant réseau qui rend possible la capture sans root de PCAPdroid.
Pour avoir rendu l’analyse du trafic Android plus accessible et continué à maintenir ces outils en projets open source, Emanuele Faranda est notre Personnalité de la semaine.
📅 Événement de la semaine
next.app devCon 2026
Si votre travail se situe entre le développement mobile et la sécurité applicative, next.app devCon mérite une place dans votre agenda.
L’événement réunit huit conférences de développeurs, dont droidCon, flutterCon, swiftCon, reactCon et masCon, sa conférence consacrée à la sécurité des applications mobiles.
Sur trois jours, l’événement associe conférences techniques et ateliers sur Android, iOS, le développement multiplateforme, le codage agentique, le leadership en ingénierie et la sécurité mobile.
Pour les équipes AppSec, ce mélange est utile : masCon se concentre sur la protection des applications mobiles, tandis que les autres conférences montrent comment ces applications sont construites et quels outils et frameworks les développeurs adoptent.
📍 CityCube Berlin, Allemagne
📅 Du 7 au 9 octobre 2026
📚 Livre de la semaine
Practical Reverse Engineering
De Bruce Dang, Alexandre Gazet, Elias Bachaalany et Sébastien Josse
Comment comprendre ce que fait un logiciel quand on ne peut pas voir son code source ?
Practical Reverse Engineering explique comment les analystes étudient les logiciels compilés sur x86, x64 et ARM. Il couvre aussi le noyau Windows, les pilotes, le débogage, l’obfuscation de code et les outils utilisés pendant l’analyse.
Avec des démonstrations pratiques et des exercices, le livre aide les lecteurs à acquérir les connaissances bas niveau nécessaires pour investiguer des malwares, comprendre les protections logicielles et examiner des programmes inconnus.
C’est une lecture utile pour les chercheurs en sécurité et les ingénieurs qui veulent aller au-delà de l’exécution d’outils de rétro-ingénierie et comprendre ce qui se passe en dessous.
😅 Le mème
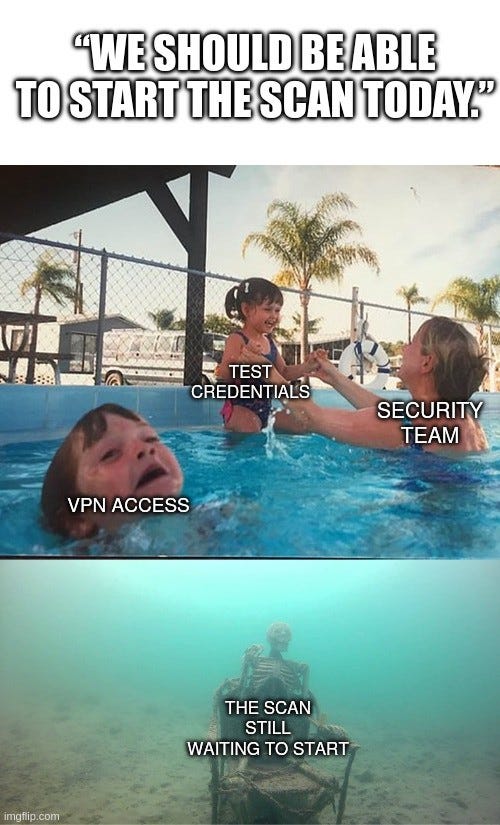
Si votre processus de tests de sécurité dépend de plusieurs équipes avant et après chaque scan, comment le passer à l’échelle quand l’automatisation ne peut simplifier qu’une partie du travail ?
The Breach Brief, L’équipe Ostorlab