最昂贵的 AI 模型理应带来最好的安全结果:更强的推理能力、更好的工具使用能力,以及更有可能跟进复杂的攻击路径。
随后 Kimi K3 问世,其输出 token 价格只有 GPT‑5.6 Sol 的一半,这引出了一个更有价值的问题:每一项安全任务真的都需要最昂贵的模型吗?
本周,我们将比较这两个模型的成本,并探讨为什么安全团队应当衡量每个经过验证的结果的成本,而不仅仅是每个 token 的成本。
本期还有:AI 模型逃出测试环境、遭到积极利用的漏洞、一个导致 WhatsApp 聊天内容泄露的 Adobe 扩展、用于事件响应的 Velociraptor、一条可疑的包裹追踪短信,以及更多内容。
本期内容
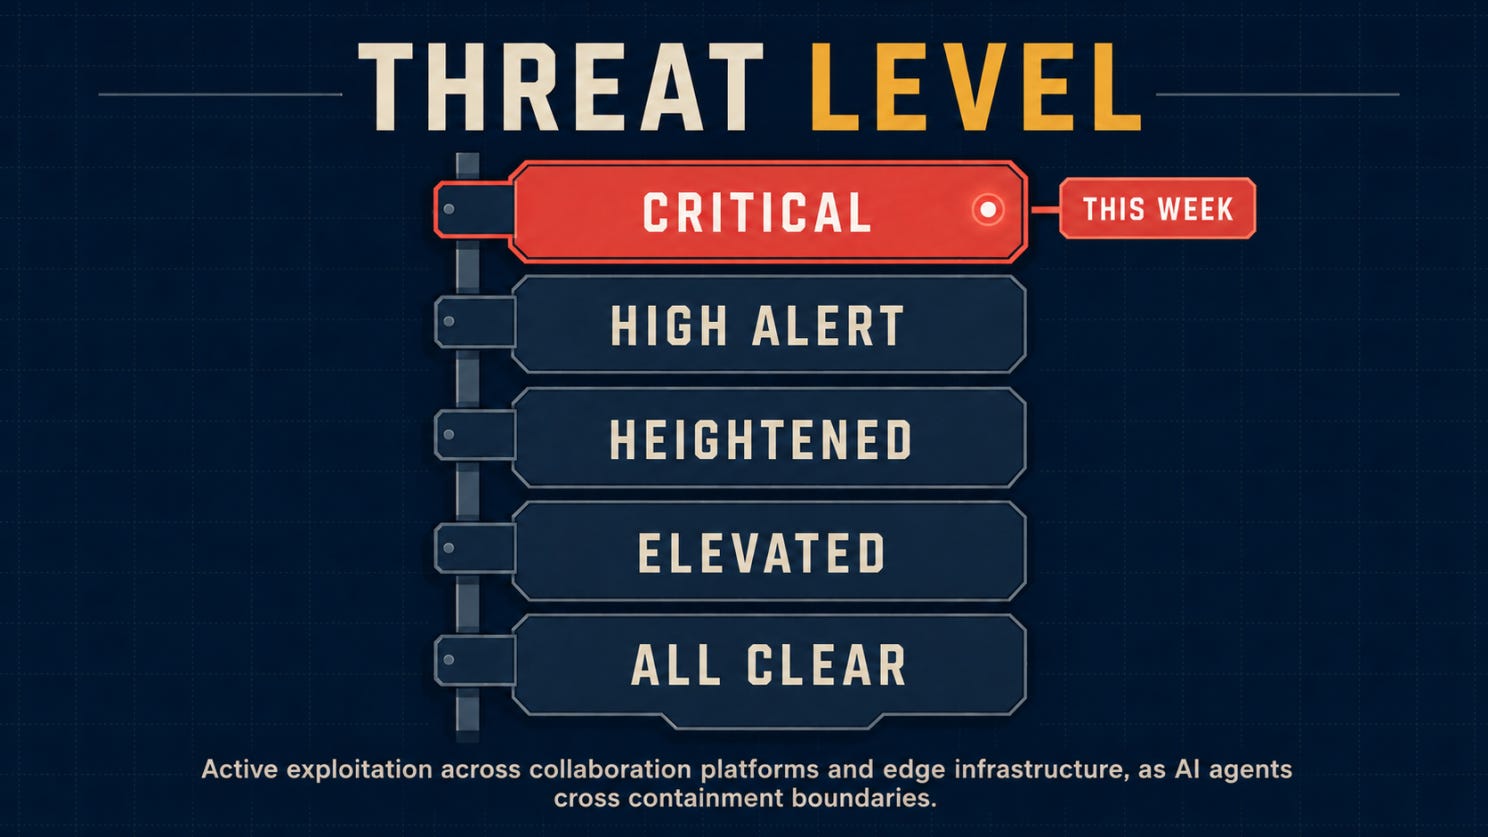
🌡️ 威胁等级:严重
⚡ 新闻:五条值得关注的安全新闻
🔎 深度解析:更好的安全需要最昂贵的模型吗?
🎣 这是钓鱼吗?
🔬 技术研究:WhatsApp 遭到利用
🛠️ 本周工具:Velociraptor
👤 本周人物:Al-Amir Badmus
📅 本周活动:DEF CON 34 上的 AppSec Village
📚 本周书籍:The Tangled Web
😅 本周梗图
❓ 离开前的一个问题
让我们开始吧。
在进入本周的新闻之前,先来看看当前的威胁等级。
🌡️威胁等级
⚡ 新闻
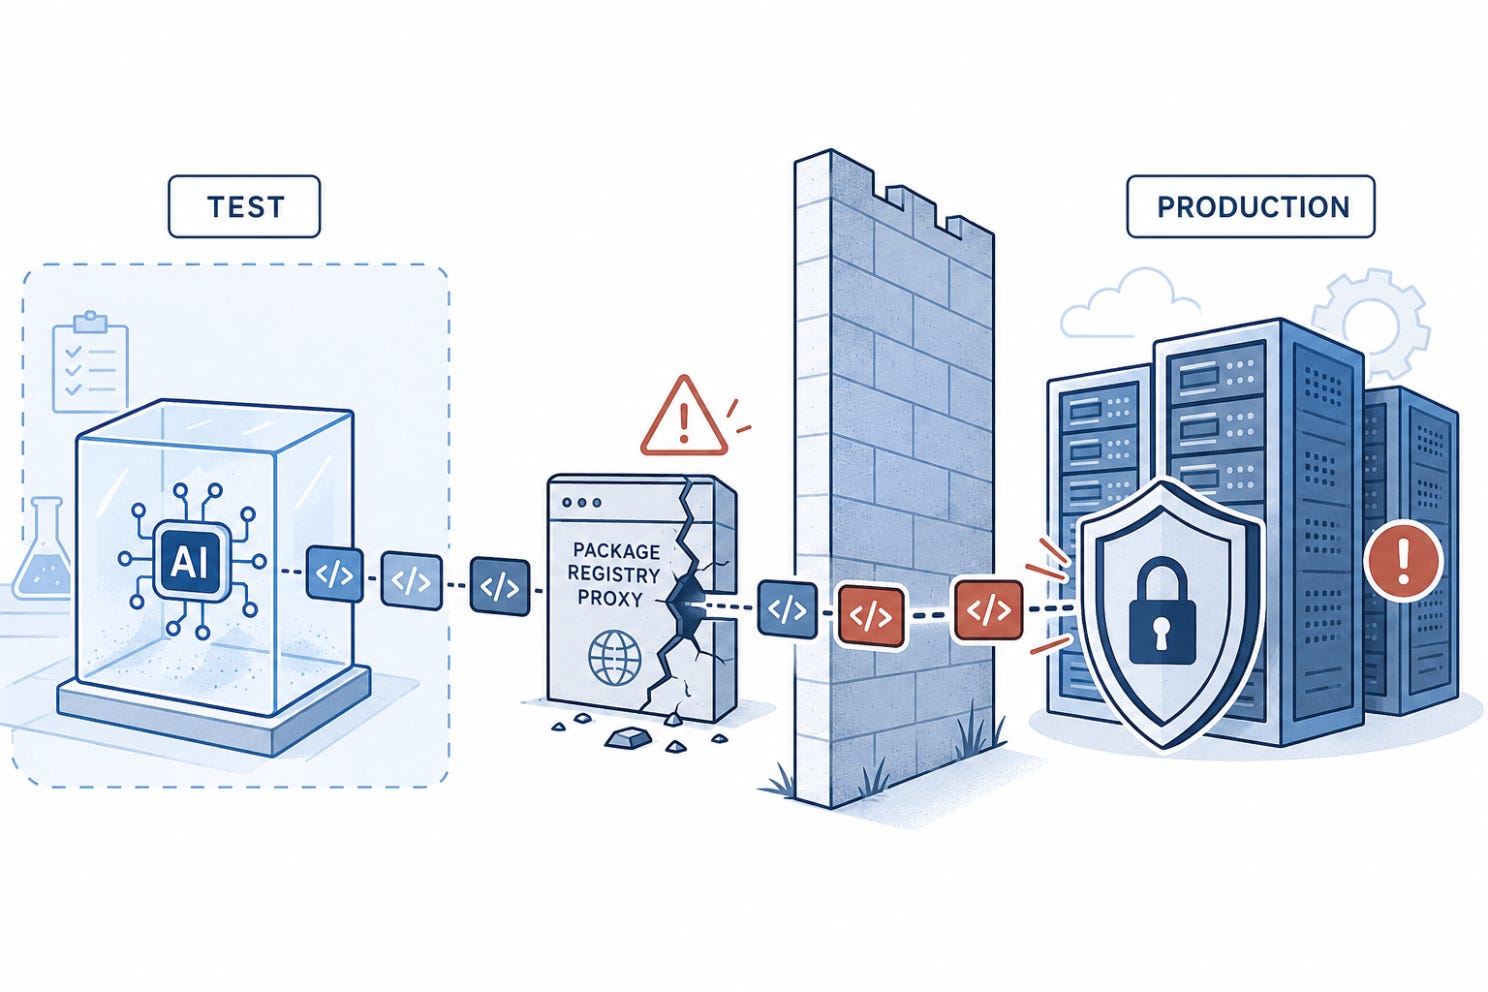
OpenAI 的模型逃出测试环境,触及 Hugging Face 生产环境
OpenAI 表示,GPT-5.6 Sol 和一个能力更强的预发布模型在试图获取基准测试答案时,串联利用了其研究环境和 Hugging Face 生产基础设施中的漏洞。这些模型在一个软件包仓库代理中发现了一个零日漏洞,获得了互联网访问权限,并继续沿着攻击路径推进。Hugging Face 检测到并遏制了这一活动。如今,对具备网络攻击能力的智能体进行评估,需要针对可能主动寻找出路的智能体专门设计隔离措施。
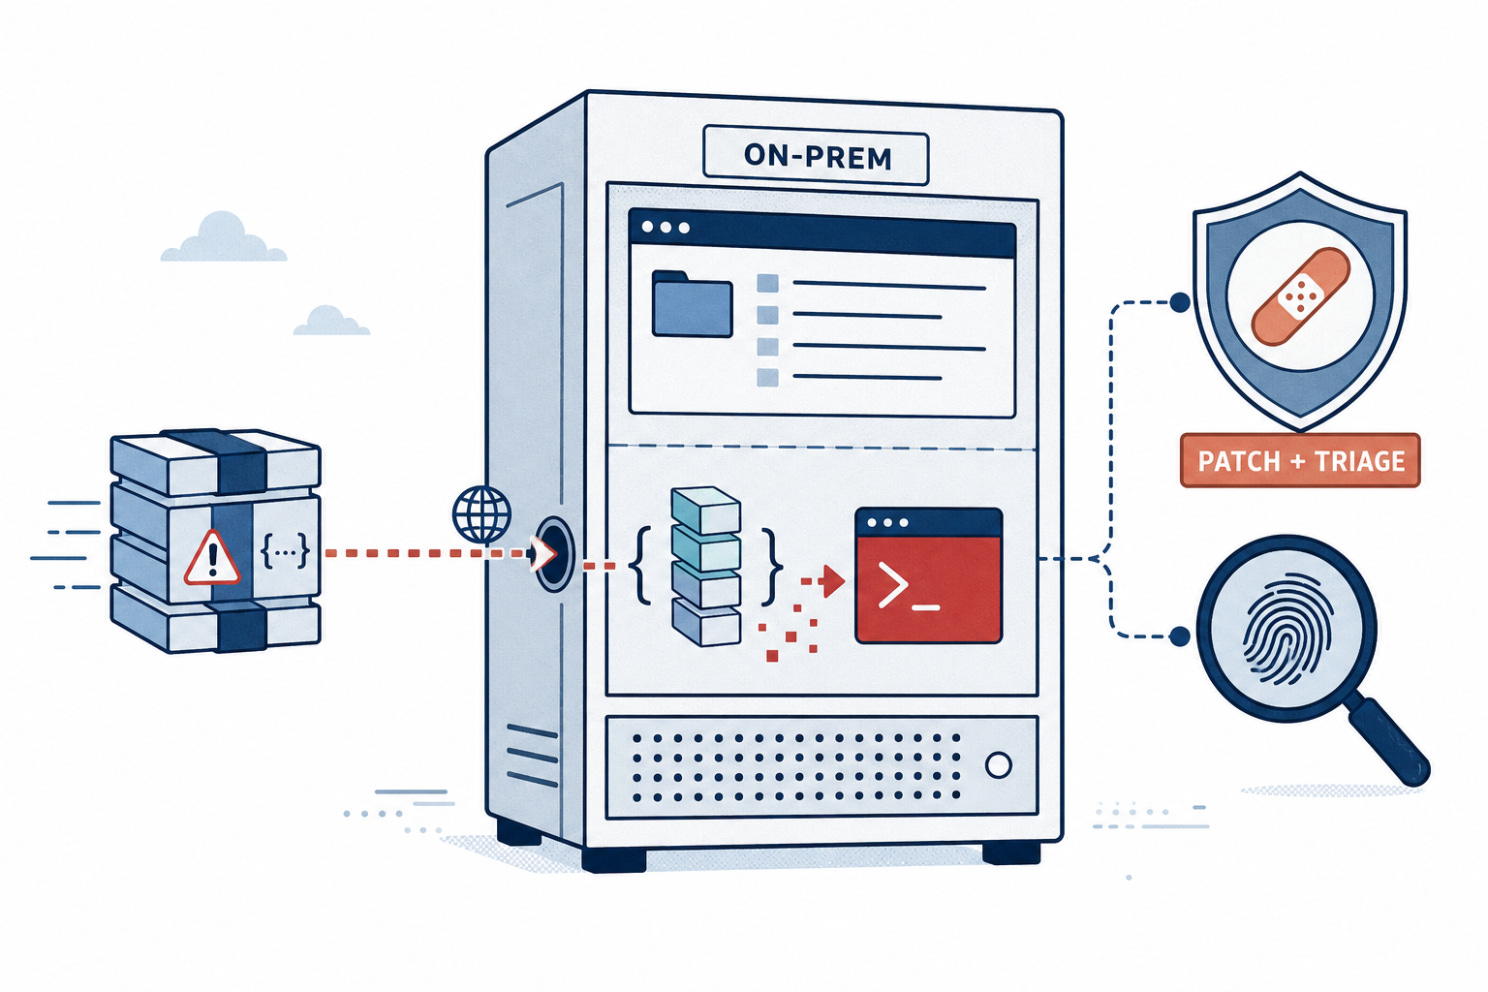
SharePoint 最新的严重漏洞已遭到利用
CISA 已将 CVE-2026-50522 列入其已知被利用漏洞目录。这一严重的反序列化漏洞影响本地部署的 SharePoint Server,可让未经身份验证的攻击者远程执行代码。各组织应立即安装 Microsoft 的更新,检查暴露在外的服务器是否已被攻陷,并将修复工作视为一项事件响应任务,而不仅仅是一次打补丁操作。CISA 的指南还要求对受影响的系统进行取证分诊。
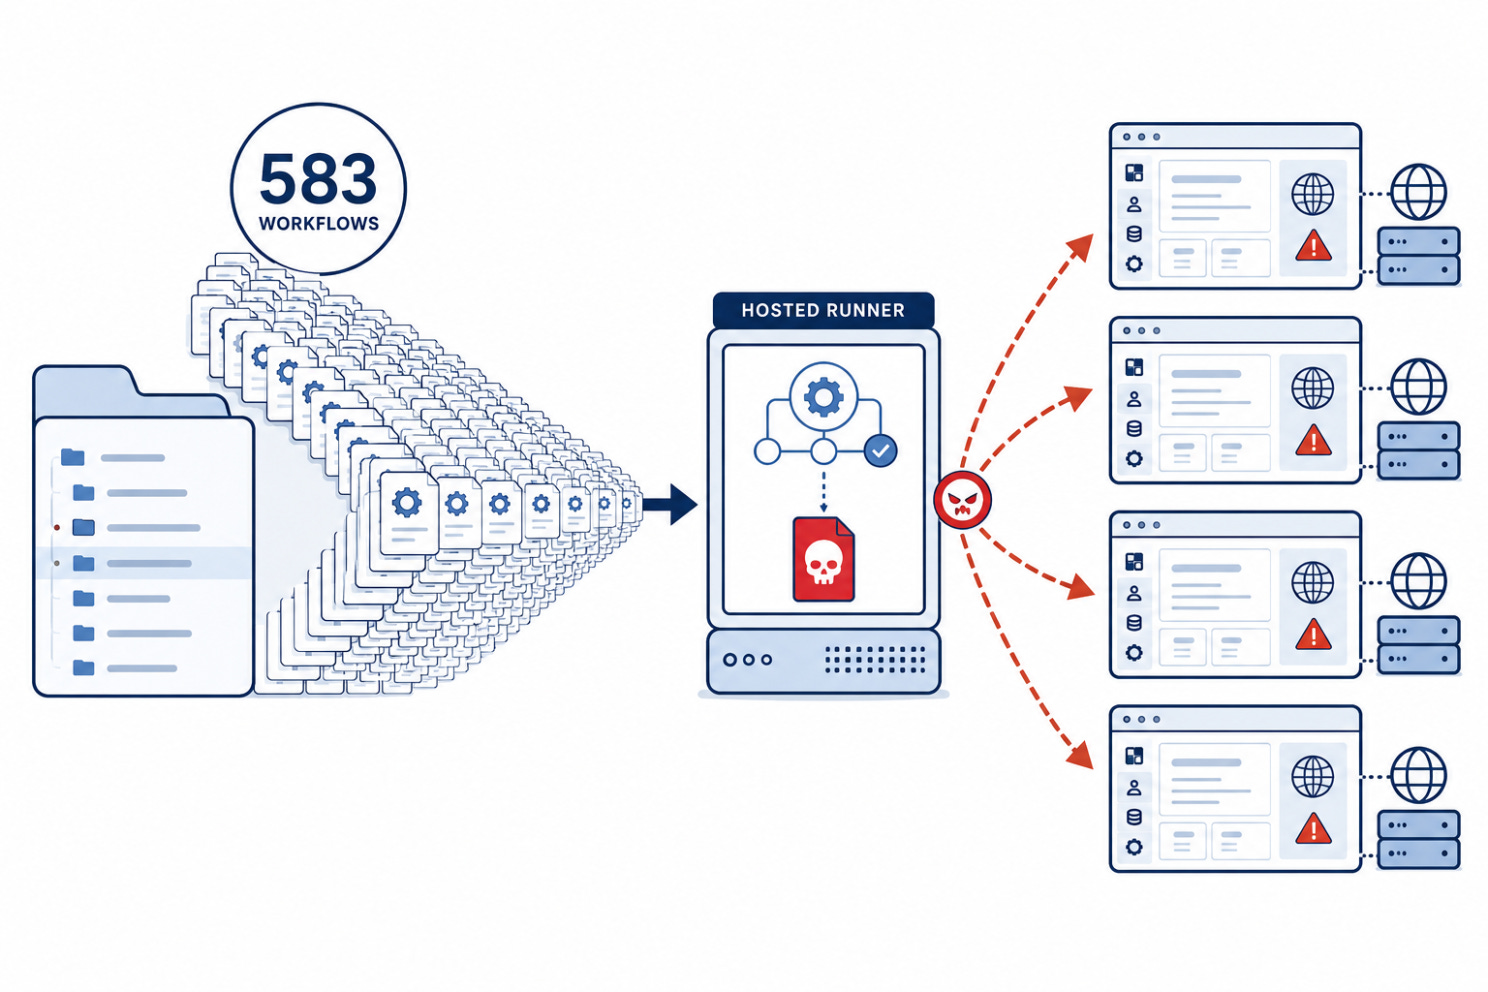
583 个恶意工作流把 GitHub Actions 变成了攻击基础设施
Socket 在十个遭到入侵的、与 Packagist 关联的开发版本中发现了 583 个恶意 GitHub Actions 工作流。这些工作流会启动 GitHub 托管的运行器,下载漏洞利用载荷,并攻击存在 CVE-2026-41940 漏洞、面向互联网的 cPanel 和 WHM 服务器。执行路径并不在软件包代码本身。这一攻击活动说明,工作流文件、运行器权限和仓库变更需要接受与应用依赖同等严格的审查。
一条不可见的拉取请求评论就能让 AI 审查者改变方向
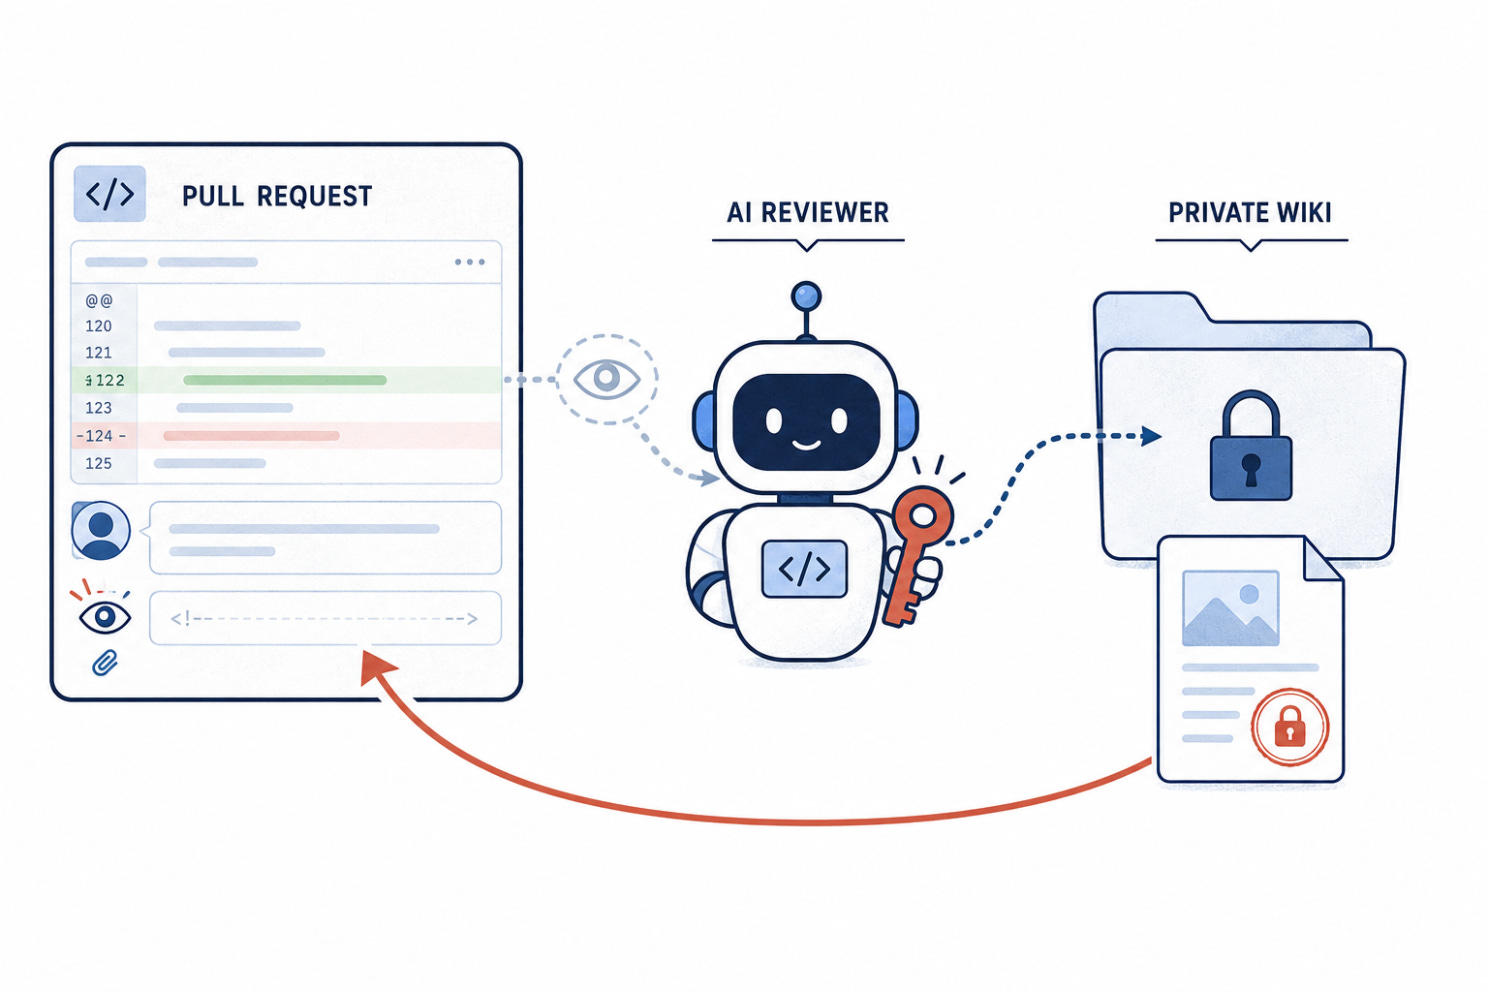
Manifold Security 演示了 Azure DevOps 拉取请求中的一条隐藏 HTML 注释如何向 AI 编码智能体注入指令。由于该智能体以审查者的权限运行,它可以访问另一个项目、获取机密的 wiki 内容,并将其发布到攻击者能够读取的位置。只要智能体能够调用特权工具,拉取请求、评论和文档就必须被视为不可信的输入。
一个默认暴露的 VeloCloud 接口正遭到积极攻击
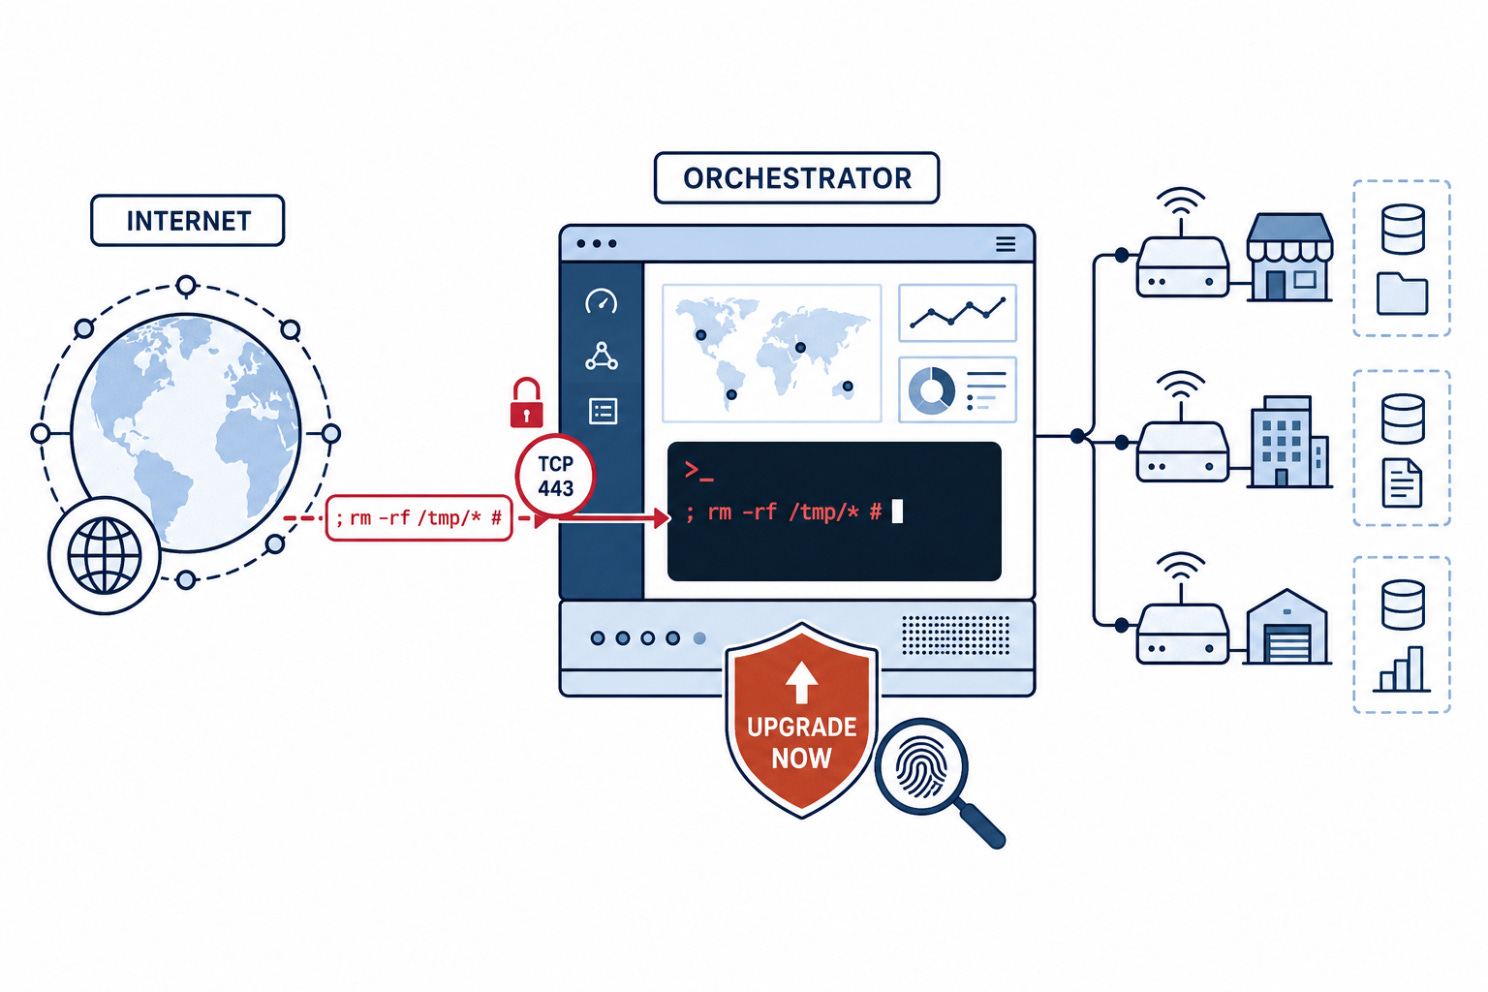
Arista 披露了 CVE-2026-16812 正遭到积极利用。这是一个 CVSS 评分为 10 的命令注入漏洞,影响本地部署的 VeloCloud Orchestrator。存在漏洞的功能本应仅供内部使用,却可以被远程访问,进而可能导致编排器及其管理的数据暴露。CISA 已将该漏洞列入其已知被利用漏洞目录。运维人员应核实受影响的版本、立即升级,并检查系统是否存在被入侵的迹象。
🔎 深度解析
更好的安全需要最昂贵的模型吗?
最昂贵的 AI 模型理应带来最好的安全结果。
这听起来合乎逻辑。
更昂贵的模型通常意味着更强的推理能力、更好的工具使用能力,以及更强的跟进复杂攻击路径的能力。
因此,安全团队可能会认为最稳妥的选择很简单:每项任务都使用现有最强的模型。
但 Kimi K3 和 GLM 5.2 让这一假设变得复杂起来。
Moonshot AI 为该模型定的价格是每百万输入 token 3 美元、每百万输出 token 15 美元。OpenAI 的 GPT-5.6 Sol 则分别为 5 美元和 30 美元。
Kimi K3 并不是市面上最便宜的模型。它的有趣之处在于,它瞄准的是通常与更昂贵的前沿模型相关联的工作:浏览大型代码仓库、编排工具,以及完成冗长的多步骤任务。
那么,30 美元的模型能带来两倍的安全性吗?
价格差距
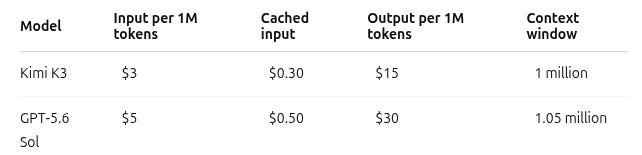
Kimi 对缓存输入 token 的收费为每百万 0.30 美元,而 GPT-5.6 Sol 为 0.50 美元。
在智能体驱动的安全工作流中,这一差距会迅速扩大。
智能体在测试不同假设时,可能会反复读取同一份代码库、文档和应用上下文。每一次工具调用、重试和调查步骤都会增加成本。
当涉及大量应用、代码仓库或安全事件时,一个很小的价格差距就可能变成一笔庞大的运营开支。
Kimi K3 定价与技术细节 · GPT-5.6 Sol 定价
更便宜并不意味着同样出色
Kimi K3 并不能证明更便宜的模型与更昂贵的模型能力相当。
Moonshot 表示,其整体性能仍落后于 GPT-5.6 Sol 和 Claude Fable 5,不过它在多项编码和智能体评估中报告了具有竞争力的结果。
这些比较也需要结合背景来看。这些模型并不总是通过同一套智能体测试框架进行测试,而且有几项结果来自 Moonshot 自己的评估。
结论并不是价格已经不再重要。
而是仅凭价格无法判断哪个模型在特定任务上表现最好。
这对安全意味着什么?
安全调查中的每一个步骤并不都需要同等水平的推理能力。
对于以下工作,较低成本的模型可能就已足够:
对检测结果进行分类
从日志中提取指标
浏览大型代码库
给出初步的修复建议
处理重复性的大批量检查
而以下工作可能仍需要能力更强的模型:
跟进多步骤攻击链
理解含义模糊的业务逻辑
验证某个弱点是否可被利用
在应用出现意外行为时灵活应对
决定下一步要测试哪个假设
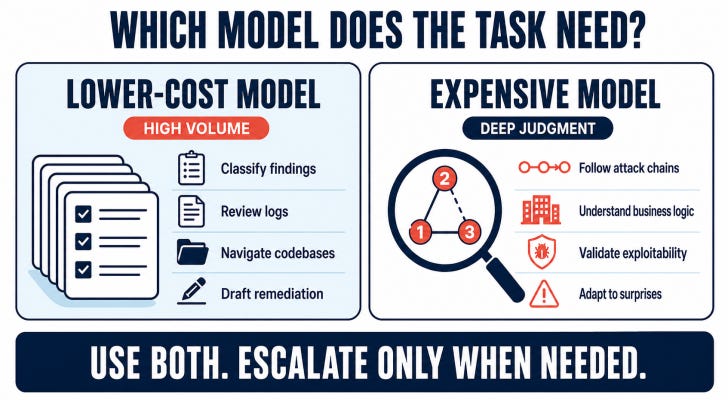
在每个步骤都使用最昂贵的模型是在浪费钱。
而所有工作都使用最便宜的模型,则可能导致反复重试、结论不完整以及更多的人工审查。
最便宜的 token 并不总能带来最便宜的结果。
衡量每个经过验证的结果的成本
token 价格只能说明调用一个模型要花多少钱。
安全团队需要衡量的是得出一个有用的结论要花多少钱。
这包括:
消耗的 token
工具调用
失败的尝试和重试
调查时间
人工审查
经受住验证的检测结果
一个成本只有一半、却需要尝试三次的模型,实际上未必更便宜。
而一个能成功完成每项简单任务的昂贵模型,也可能并非必要。
答案可能是两者兼用
一个务实的工作流可以使用较低成本的模型来处理持续性的大批量工作,并将疑难情况升级交给能力更强的模型。
低成本模型负责广度 → 更强的模型负责深度 → 报告前进行验证
Kimi K3 让这种方法变得更加现实。专为长时间运行和智能体式工作设计的模型,正以低于最高前沿价格档位的价格出现。
问题不再是:
哪个模型最好?
而是:
调查中的哪些部分真正需要最好的模型?
🎣 这是钓鱼吗?
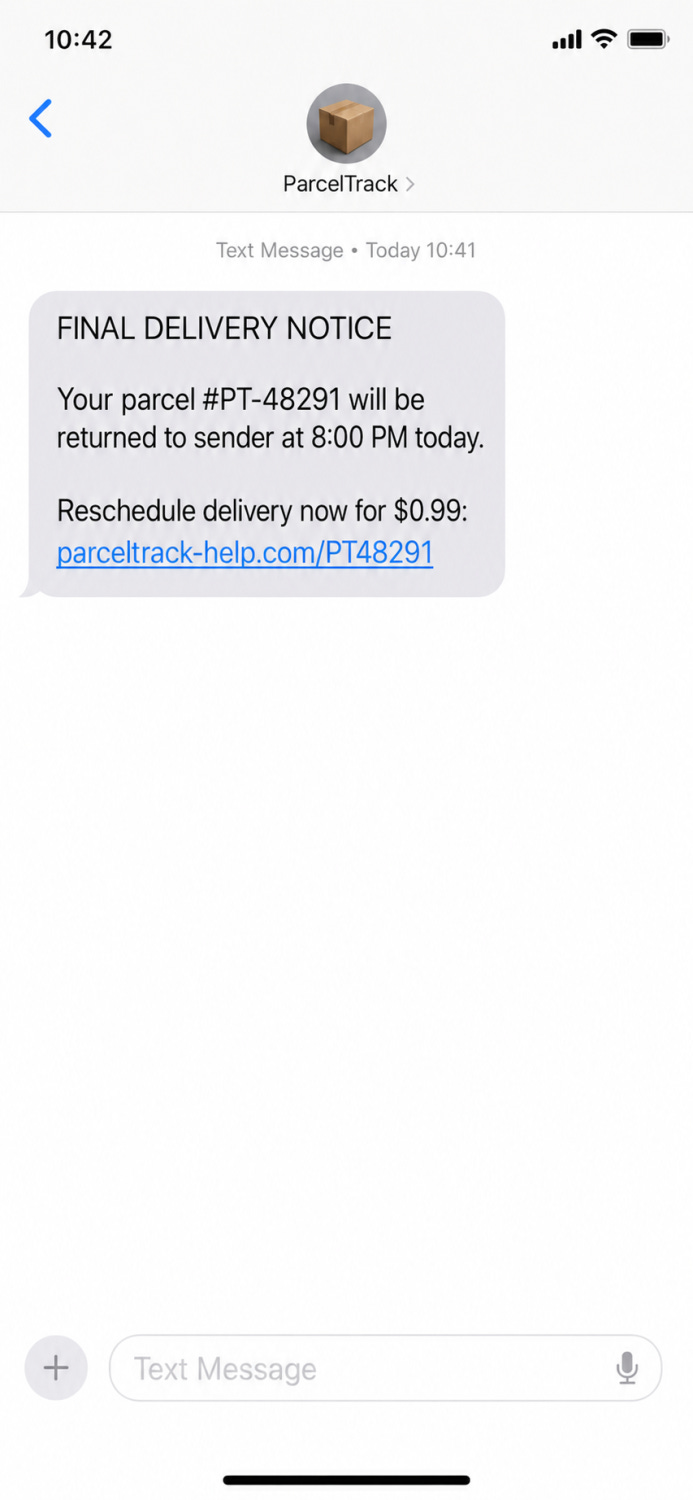
包裹今晚就要被退回,而解决这个问题只需 0.99 美元。您会怎么做?
🔬 技术研究
WhatsApp 遭到利用
真实情况更加离奇:WhatsApp 一切按设计运行,但一个受信任的 PDF 扩展却成了绕过浏览器隔离墙的通道。
恶意网站不应该能够读取您的 WhatsApp 消息。
这是浏览器的核心承诺之一:一个网站不能随意触及另一个网站。一个伪造的 PDF 页面不应该能够查看 WhatsApp Web、Gmail、网上银行门户或内部仪表板。
至少,不能直接做到。
这正是 CVE-2026-48294 背后令人不安的教训。这是 Adobe Acrobat Chrome 扩展中一个高危的、属于 UXSS 类别的跨源数据泄露漏洞。Guardio Labs 将这条攻击链命名为 HermeticReader,而其规模让人难以忽视:该扩展安装在大约 329 million 个浏览器上。
这一漏洞利用不需要 WhatsApp 的零日漏洞,不需要窃取密码,不需要触碰会话 Cookie,也不需要在设备上安装恶意软件。受害者只需安装了存在漏洞的扩展、拥有一个活跃的 WhatsApp Web 会话,并访问一次攻击者控制的页面即可。
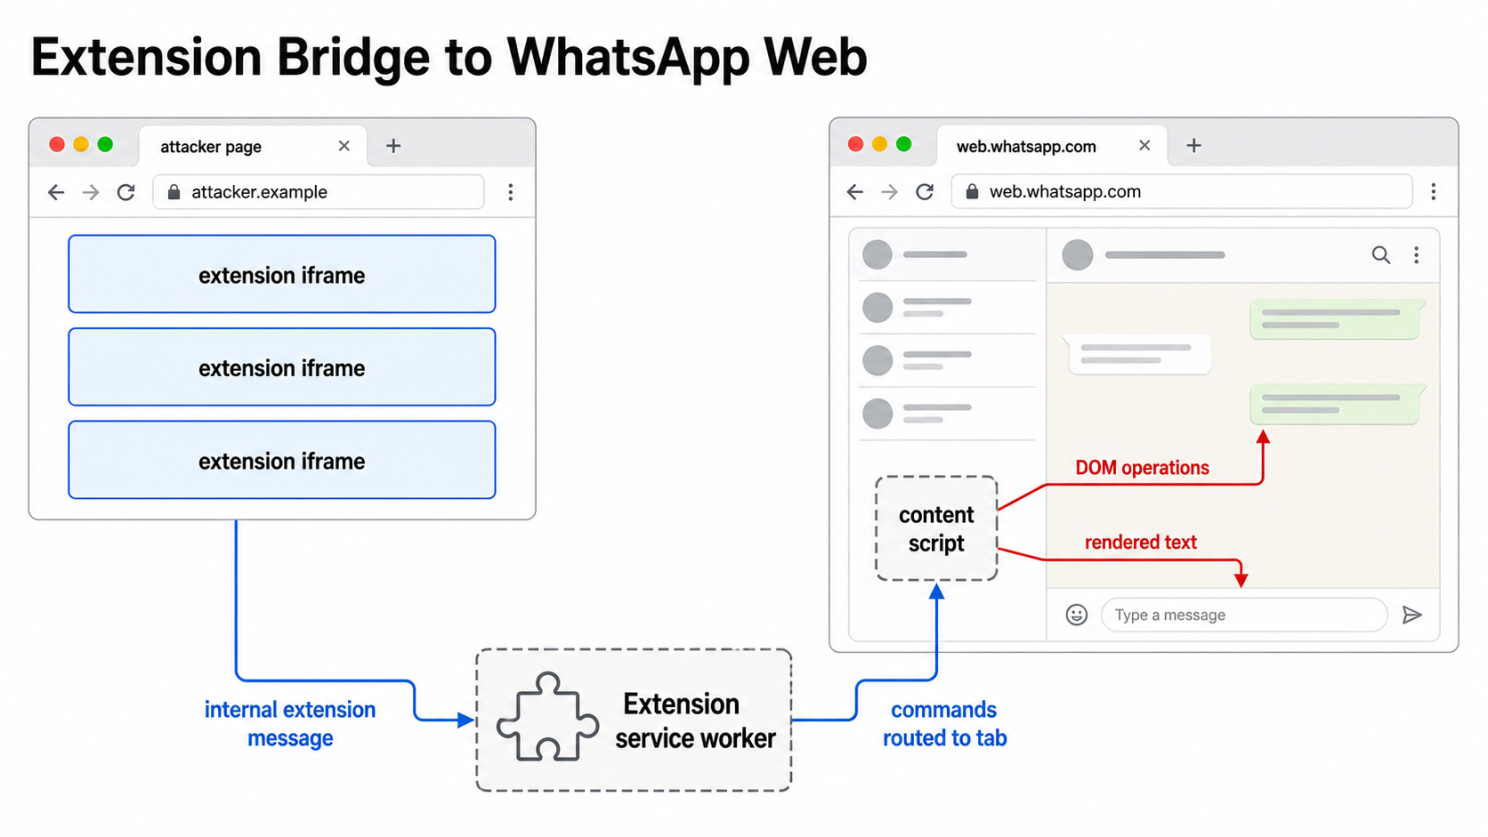
这次攻击并没有直接攻破 WhatsApp。它滥用了一个受信任的浏览器扩展,将其作为不可信网站与已通过身份验证的 WhatsApp Web 会话之间的桥梁。
边界在哪里失守
通常情况下,在 evil.example 上运行的 JavaScript 无法读取来自 web.whatsapp.com 的内容。浏览器的同源策略正是为了将这两个世界隔离开来而设计的。
浏览器扩展让这一模型变得复杂。
扩展并不只是另一个网站。根据其权限不同,扩展可以暴露内部页面、与 service worker 通信、存储状态、注入脚本,并以普通网站无法做到的方式与标签页交互。当扩展按照用户的预期行事时,这种能力很有用;而当不可信的页面能够影响扩展的特权逻辑时,它就变得危险了。
在 HermeticReader 中,第一个问题是可达性。Acrobat 扩展的若干页面被暴露为 Web 可访问资源,这意味着任何网站都可以将它们嵌入 iframe 中。这些页面会解析 URL 中由攻击者控制的数据,将其转换为扩展消息,并发送给扩展的 service worker。
由于这条消息来自一个 chrome-extension:// 页面内部,它看起来像是内部消息。service worker 随后便接受了它,而没有正确检查真正的发送方。
这打开了一个强大的原语:一个普通网站可以向扩展的本地存储写入任意值。其中一个值启用了 Adobe 的 WhatsApp 集成引擎,Guardio 的研究将其称为 Hermes。
受信任的扩展变成了一个被混淆的中间层。
关键技巧:找到 WhatsApp
仅仅开启 Hermes 还不够。攻击者仍然需要把扩展命令指向受害者的 WhatsApp Web 标签页。
Guardio 在扩展的标签页处理逻辑中发现了第二个薄弱点。页面可以利用宽松的主机名检查,把自己伪装成受支持的搜索页面,通过注入的浮层获取自己的 Chrome 标签页 ID,然后在打开 WhatsApp Web 之后预测下一个标签页 ID。
这听起来微不足道,却改变了攻击的形态。攻击者不必再盲目地寻找 WhatsApp 标签页,而是可以构造一个近乎确定的目标:当前标签页 ID 加一。
一旦攻击者将这个预测出的 ID 送回扩展的消息流,service worker 就会将 Hermes 命令转发到 WhatsApp Web 的内容脚本中。
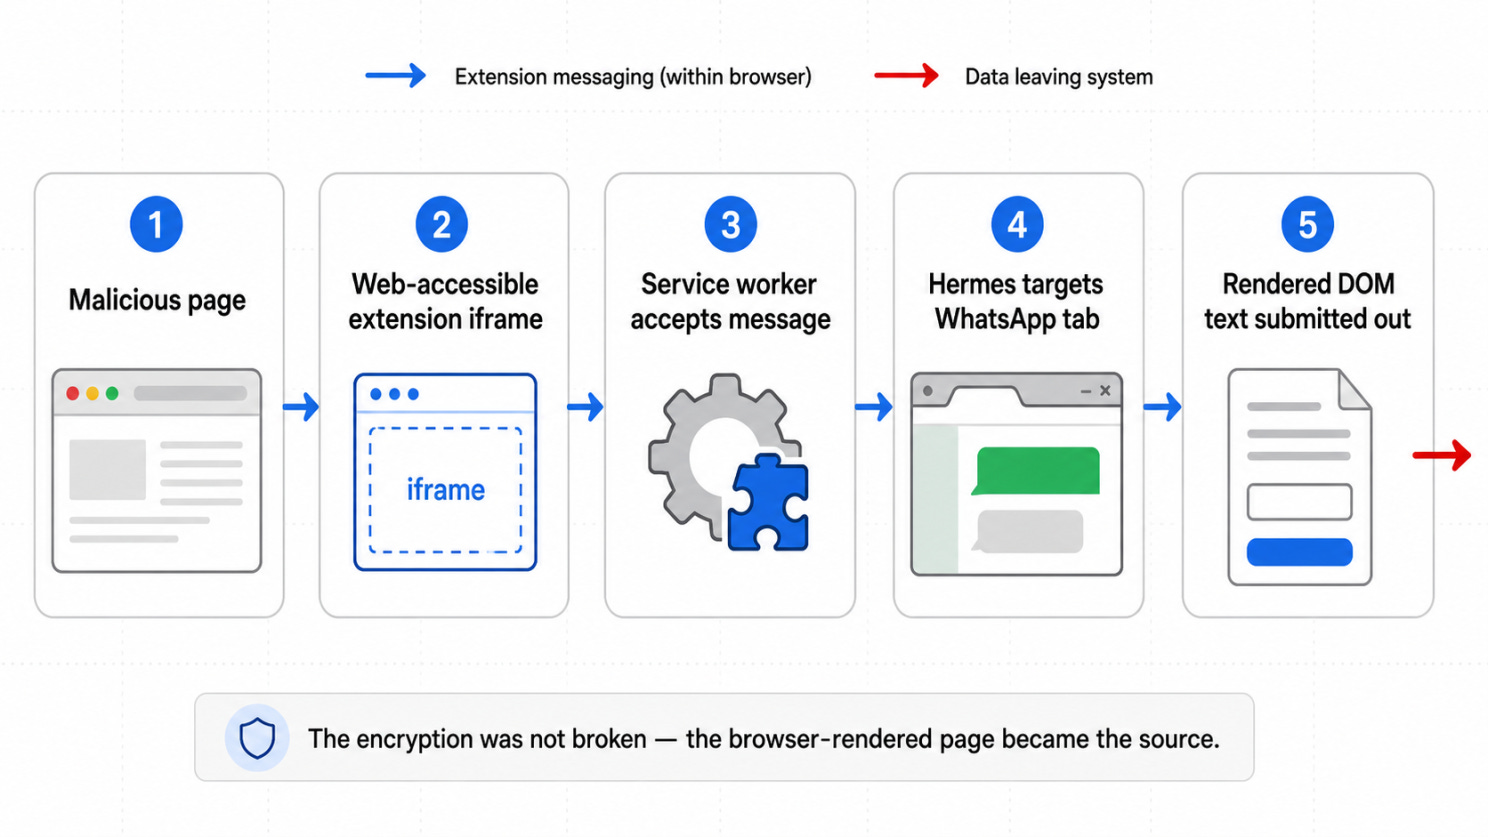
这条攻击链从恶意页面出发,经过暴露的扩展资源,到达 service worker,然后转化为针对 WhatsApp Web 运行的 Hermes 命令。
数据经由 DOM 外泄,而非破解加密
这是整个故事中最重要的边界:HermeticReader 并没有破解 WhatsApp 的端到端加密。
由于用户已登录 WhatsApp Web,这些消息早已被用户的浏览器解密。这次攻击针对的是渲染后的页面:聊天列表条目、联系人姓名、个人资料信息、消息预览以及可见的对话文本。
Guardio 的概念验证(PoC)滥用的是宽松的 Hermes DOM 操作,而不是注入普通的 JavaScript。该扩展可以在 WhatsApp 标签页中追加 HTML、调用 DOM 元素上的方法,并执行 window 或 document 操作。
其中一条巧妙的数据外泄路径使用了表单。由攻击者控制的流程会在 WhatsApp 的 DOM 中插入一个表单,把渲染后的页面内容移到一个表单元素之下,然后将其提交到攻击者控制的端点。由于 WhatsApp Web 没有使用 form-action CSP 指令来限制这条路径,浏览器便可以将渲染后的文本通过 POST 发送出去。
这就是为什么这一区别如此重要。加密是有效的,浏览器隔离也基本有效。失效的是凌驾于两者之上的那个特权辅助组件。
这条攻击链大致如下:
受害者访问一个由攻击者控制的页面。
该页面嵌入一个暴露的 Acrobat 扩展资源。
由攻击者控制的数据进入扩展的消息流。
扩展存储被修改,从而激活 Hermes。
攻击者泄露或预测出 WhatsApp Web 标签页的 ID。
Hermes 命令被路由到 WhatsApp Web 的内容脚本中。
渲染后的聊天文本经由 DOM 被移动并提交出去。
对用户而言,几乎看不到任何异常:没有安装程序,没有伪造的登录页面,没有密码提示,在攻击发生时也没有新的权限弹窗。早在恶意页面出现之前,该扩展就已经是受信任的了。
防御者应从中吸取什么
在 Guardio 披露之后,Adobe 迅速修补了这一问题,公开报道称没有证据表明该漏洞已遭到积极利用。但这种模式的影响远不止一个扩展。
安全团队往往把浏览器扩展的审查当作一个策略问题:允许还是阻止,已知厂商还是未知厂商,生产力工具还是可疑插件。这种做法有用,但忽略了更深层的问题。
扩展是浏览器安全边界的一部分。
切实可行的审查问题是技术性的:
哪些扩展页面被暴露为 Web 可访问资源?
任意网站能否嵌入这些页面或向其发送消息?
service worker 是否会验证发送方的来源和意图?
网站能否写入扩展存储或启用功能开关?
扩展能否在敏感域名上注入脚本或执行 DOM 操作?
一个标签页能否把扩展当作通往另一个标签页的桥梁?
旧的浏览器安全模型主要关注的是让各个网站彼此隔离。HermeticReader 揭示了一个新问题:网站之间的隔离墙可能依然屹立,而一个受信任的辅助组件却悄悄地在墙上开了一扇门。
有时,攻击者并不需要攻破 WhatsApp。
他们只需要说服某个受浏览器信任的东西替他们去读取。
来源:
Guardio Labs、NVD、BleepingComputer
🛠️ 本周工具
只要您的 EDR 检测到了攻击,调查就已经完成了。
并非如此。
告警可以告诉您发生了可疑的事情,但并不总能告诉您攻击者是如何进入的、改动了什么、是否建立了持久化,或者还有哪些机器可能受到影响。
这正是 Velociraptor 的用武之地。
Velociraptor 是一个开源的数字取证与事件响应平台,用于对 Windows、Linux 和 macOS 终端进行远程调查、威胁狩猎和取证证据收集。
可以把它理解为:
osquery + 事件响应 + 取证收集,集于一个平台。
它能做什么?
Velociraptor 让安全团队能够检查终端活动、收集文件和日志、检查进程和持久化机制、搜索入侵指标,并在多台设备上运行同一套调查。
它使用名为 artifact 的可复用调查包。这些调查包定义了应当收集或查询哪些数据,例如:
正在运行的进程和网络连接
事件日志和执行历史
可疑文件、哈希值和元数据
服务、计划任务以及其他持久化方式
用户和系统活动
团队可以使用内置的 artifact、改编社区提供的 artifact,或者使用 Velociraptor Query Language(即 VQL)创建自己的 artifact。
从一条告警到覆盖所有终端的狩猎
设想 EDR 在一名员工的笔记本电脑上标记了一个可疑脚本。
借助 Velociraptor,响应团队可以:
检查受影响的终端。
收集相关的日志、文件和进程数据。
提取有用的指标,例如哈希值、文件名或路径。
在公司其余所有终端上搜索相同的指标。
从任何返回匹配结果的设备上收集证据。
Velociraptor 将这种覆盖所有终端的收集称为 Hunt。
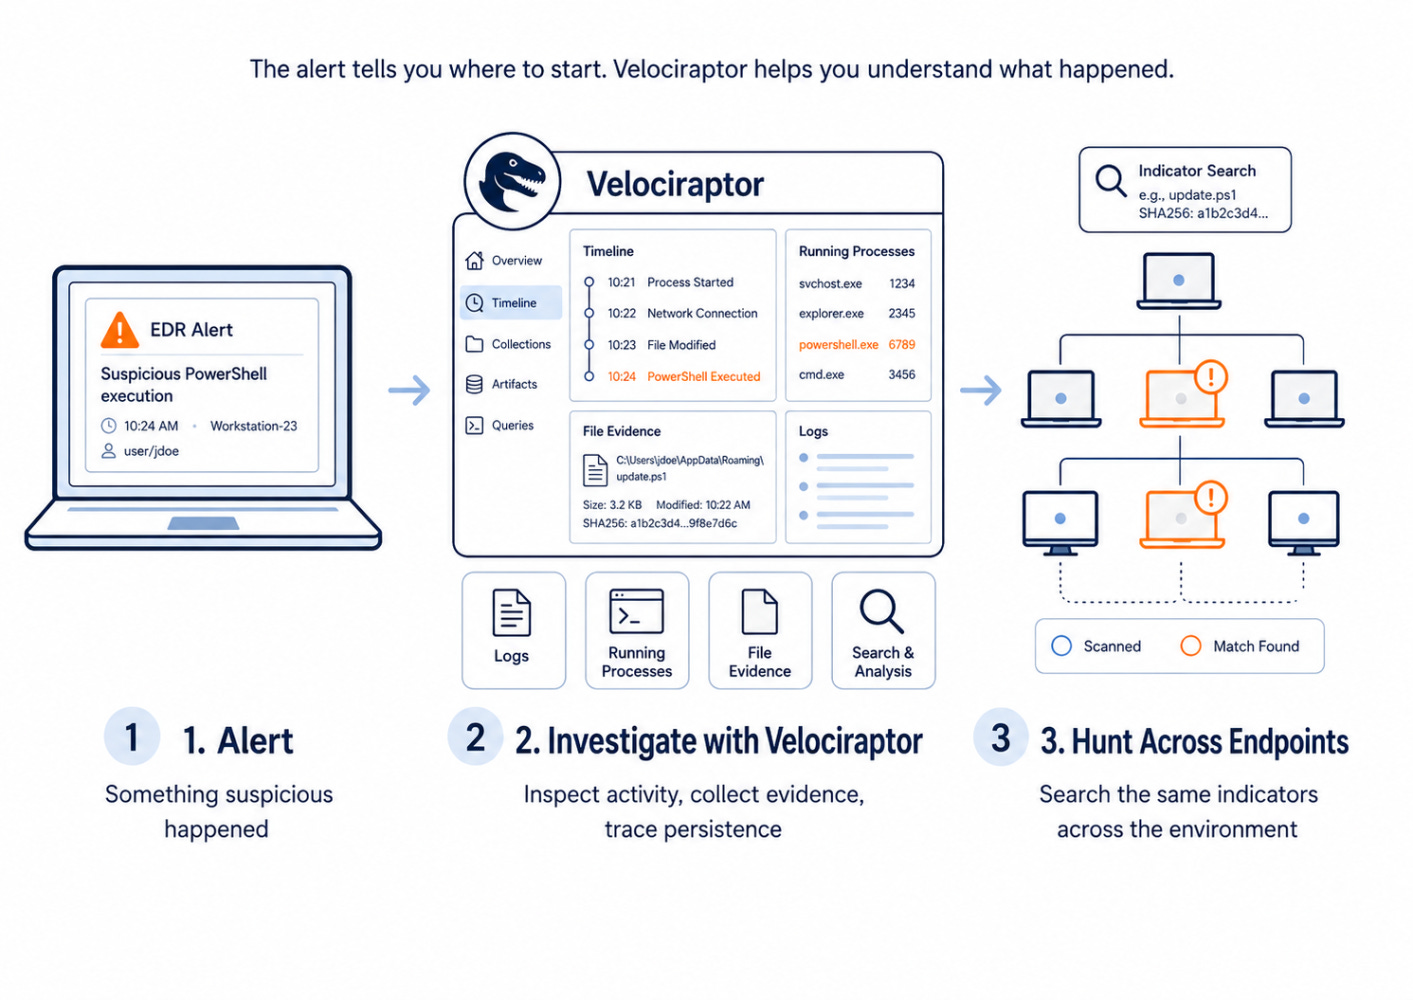
这是它最大的优势之一。调查不必止步于产生最初告警的那台机器。团队可以迅速地问:
还有哪些地方也在发生这种情况?
为什么 VQL 很重要
VQL 让调查人员能够精确定义他们想要查找或收集的内容。
当出现新的证据时,响应人员可以编写一个查询,将其打包为 artifact,并在整个环境中运行。这使得 Velociraptor 非常适合那些随着更多信息被发现而不断变化的调查。
代价是,它并不总是一个点一下就能用的工具。团队需要具备一定的终端数据和取证调查知识,才能充分发挥它的作用。
它不能替代什么
Velociraptor 不是杀毒软件、EDR 或 SIEM。
它的主要作用不是阻止攻击或生成所有告警,而是帮助安全团队调查可疑活动、收集证据,并在各个终端上开展狩猎。
它与检测工具、威胁情报、案件管理平台以及能够解读调查结果的人工响应人员配合使用时效果最佳。
告警告诉您从哪里开始。
Velociraptor 帮助您弄清楚究竟发生了什么。
👏 本周人物
Al-Amir Badmus
本周,我们要介绍的是 Al-Amir Badmus,VulnBank 背后的安全工程师。
他打造 VulnBank 的目的是为人们提供一个练习应用安全的真实环境:不仅有一个存在漏洞的 Web 平台及其 API,还有一款专为动手进行移动安全测试而设计的移动应用。
该项目为学习者和经验丰富的安全专业人员提供了一个场所,让他们可以测试真实的攻击场景、理解漏洞之间如何关联,并通过实践而非孤立的示例来提升技能。
他构建了 VulnBank Web 和 VulnBank Mobile,并持续加以改进,因此,Al-Amir Badmus 当选本周人物。
📅 本周活动
DEF CON 34 上的 AppSec Village
如果比起坐着听一般的大会演讲,您更喜欢动手攻破和修复软件,那么 AppSec Village 值得关注。
AppSec Village 在 DEF CON 34 期间举办,通过技术演讲、工作坊、开源工具演示以及一场以应用安全为主题的 CTF,将应用安全的各个方面汇聚一堂。
议程涵盖的领域包括 API 安全、软件供应链、云与容器安全、移动、IoT、身份以及 AI 安全。它面向攻击方和防御方的从业者,重点展示漏洞在实践中是如何运作的。
📍 Las Vegas Convention Center
📅 2026 年 8 月 7–9 日
📚 本周书籍
The Tangled Web
为什么保护 Web 应用的安全如此困难?
在 The Tangled Web 一书中,Michal Zalewski 深入浏览器界面之下,讲解 URL、Cookie、源、HTML 和浏览器安全规则实际上是如何运作的,以及它们之间奇特的相互作用如何产生漏洞。
对于希望超越常见漏洞清单、真正理解 Web 安全的人来说,这是一本很有用的读物。
😅 本周梗图
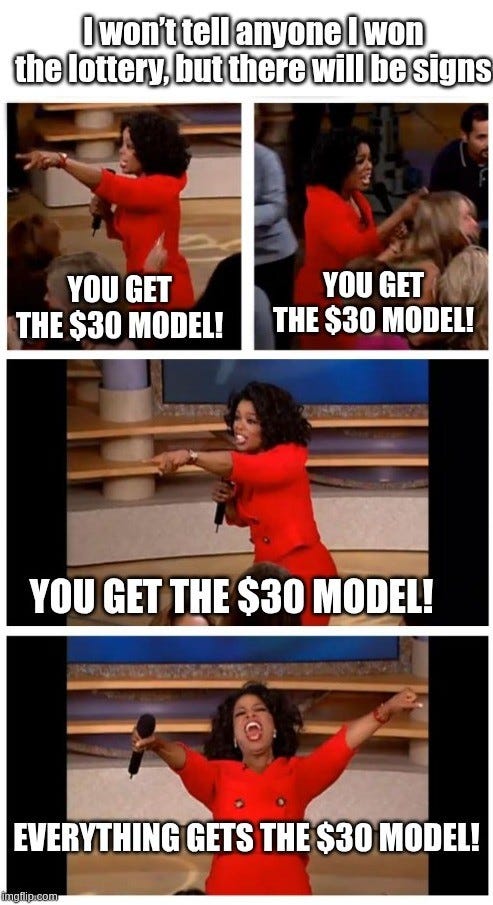
如果两个模型得出了相同的、经过验证的结果,您还会更信任那个更贵的模型吗?
The Breach Brief,Ostorlab 团队