Pentest autonome vs pentest traditionnel
Comparez pentests traditionnels, PTaaS et tests autonomes par IA : où les agents l'emportent sur la couverture et les preuves, où les humains restent en tête, et comment les combiner.
Tout responsable AppSec finit par se poser la même question budgétaire : le prochain euro doit-il financer un nouveau test d'intrusion traditionnel, un abonnement PTaaS ou une plateforme de test agentique par IA ?
La mauvaise réponse part d'un faux choix. Ces options ne décrivent pas la même chose.
Le test d'intrusion traditionnel désigne une évaluation menée par des humains. Le PTaaS décrit la manière dont les tests sont livrés et gérés dans la durée. Les tests agentiques et autonomes décrivent la manière dont un système prend des décisions pendant un test. Un programme de sécurité mature peut utiliser les trois.
La question utile n'est pas : « L'IA peut-elle remplacer un pentesteur ? » Elle est : « Quel travail doit s'exécuter en continu, quel travail nécessite un enquêteur humain, et quelles preuves chacun doit-il produire avant que les équipes d'ingénierie n'agissent ? »
Réponse directe : le pentest autonome utilise des boucles de rétroaction agentiques pour découvrir, exploiter et vérifier en continu des vulnérabilités techniques au rythme de cycles de livraison rapides. Il ne remplace cependant pas les pentesteurs humains. Les programmes AppSec d'entreprise matures combinent des agents autonomes continus pour la couverture technique de base avec des spécialistes humains pour la logique métier complexe, les évaluations d'architectures sur mesure et les décisions de risque nuancées.
Quelle est la différence entre le pentest traditionnel, le PTaaS et le test agentique ?
Les équipes de sécurité comparent souvent des catégories qui relèvent d'axes différents.
Le test d'intrusion traditionnel est généralement une mission délimitée et limitée dans le temps. Une équipe humaine étudie un environnement, teste des chemins d'attaque, valide les résultats et remet un rapport. Il reste efficace lorsqu'une organisation a besoin d'une évaluation approfondie d'une version critique, d'une architecture sur mesure ou d'un processus métier à fort enjeu. NIST SP 800-115 décrit ce modèle classique d'évaluation par phases et de remise de rapport.
Le Penetration Testing as a Service (PTaaS) est un modèle de livraison et d'exploitation. Il ajoute généralement une plateforme persistante pour le cadrage, les résultats, la remédiation, le reporting et le retest. Une mission PTaaS peut être menée par des humains, assistée par l'IA ou hybride. Elle ne devient pas autonome du seul fait qu'elle passe par un portail. Synack fait la même distinction dans sa définition du PTaaS.
Le test agentique décrit une boucle adaptative. Au lieu d'exécuter uniquement une liste de contrôle fixe, le système peut observer un résultat, formuler une nouvelle hypothèse, choisir une action ou un outil autorisé, examiner les preuves et changer de cap.
Le test autonome est l'extrémité de ce modèle où l'autonomie est la plus élevée. Le système décide d'une plus grande partie de la séquence de test sans approbation pour chaque action, mais uniquement dans des limites explicites. L'Autonomous Penetration Testing Standard de l'OWASP distingue ce cas du scan planifié : un scan préconfiguré qui ne prend aucune décision n'est pas un test autonome. Ses recommandations font aussi du respect du périmètre, des contrôles de sécurité et de la responsabilité des exigences centrales.
Les responsables de la sécurité ont ainsi deux décisions à prendre, et non une seule :
| Modèle d'exécution | Mission ponctuelle | Service récurrent ou continu |
|---|---|---|
| Exécution menée par des humains | Pentest traditionnel | PTaaS mené par des humains |
| Exécution assistée par l'IA | Travail mené par un consultant et accéléré par l'IA | PTaaS assisté par l'IA |
| Exécution agentique ou autonome | Investigation ciblée et délimitée | Plateforme de test agentique continu |
Le bon modèle dépend du risque, du rythme de livraison et des preuves exigées, et non de l'étiquette affichée sur la page d'accueil d'un éditeur.
Pentest autonome vs pentest traditionnel vs PTaaS : comparaison des caractéristiques
| Question | Pentest humain par projet | PTaaS continu mené par des humains | Test agentique continu |
|---|---|---|---|
| Quand s'exécute-t-il ? | À intervalles planifiés | À la demande ou selon un planning | Après les versions ou d'autres déclencheurs approuvés |
| Qui réalise les tests ? | Des pentesteurs humains | Des pentesteurs humains utilisant une plateforme partagée | Des agents autonomes sous supervision humaine |
| Le mieux adapté à | La logique métier complexe et les chemins d'attaque inédits | L'accès récurrent à une expertise humaine | Des tests reproductibles sur des versions fréquentes |
| Principale limite | Ne fournit qu'une couverture à un instant donné | Dépend toujours de la disponibilité des testeurs | Ne peut pas juger seul chaque risque métier |
| Meilleur rôle en AppSec | Investigation approfondie | Tests récurrents par des spécialistes | Socle de sécurité continu |
Ce tableau n'est pas un classement. Un système automatisé peut démarrer rapidement et pourtant produire des preuves faibles. Une équipe humaine peut déceler un cas d'abus subtil, mais ne peut pas relancer en continu chaque workflow après chaque version. L'objectif est de confier à chaque niveau le travail qui correspond à ses points forts.
Où le test agentique autonome a-t-il un avantage structurel ?
Une couverture continue entre les missions
Les applications changent plus souvent que les calendriers de tests annuels. De nouvelles API apparaissent, les flux d'authentification évoluent, les versions mobiles ajoutent des SDK, et un problème corrigé peut réapparaître dans un build ultérieur.
Le test agentique convient bien aux tâches reproductibles qui doivent avoir lieu chaque fois qu'un déclencheur de confiance survient : une version, une modification importante d'API, un nouvel actif ou le déploiement d'une remédiation. Il peut conserver le contexte précédent, rejouer des chemins connus et orienter l'attention vers ce qui a changé.
Cela ne rend pas chaque test également sûr à automatiser. L'organisation doit définir le périmètre, les techniques autorisées, les seuils d'impact, les limites de débit et les conditions d'escalade avant qu'un système n'agisse. La distinction importante n'est pas « sans intervention » contre « avec intervention ». C'est une automatisation délimitée et auditable contre un agent non gouverné disposant d'un large accès.
Investigation reproductible des API et des workflows authentifiés
Les applications modernes exposent leurs risques à travers des clients web, des applications mobiles, des API, des intégrations tierces et du code source. Une plateforme agentique peut aider à rassembler des signaux issus du trafic intercepté, des définitions d'API, des clients applicatifs et d'identités de test approuvées, puis à rejouer les flux obtenus.
Cela peut rendre la découverte des API et les tests d'autorisation plus systématiques. Cela ne résout aucun de ces deux problèmes. Un endpoint manqué, un modèle de rôles incomplet ou des données de test irréalistes peuvent encore produire une fausse assurance. Les recommandations de l'OWASP sur les tests d'API traitent la découverte comme un processus multi-sources et avertissent que les conclusions sur l'autorisation dépendent du fait que le bon endpoint, la bonne identité et le bon chemin ont été testés. Voir les recommandations de l'OWASP sur la reconnaissance des API.
Capture des preuves à vitesse opérationnelle
Trouver un contrôle de sécurité dans le code ne prouve pas qu'il tient à l'exécution, et signaler une alerte non vérifiée crée de la friction entre l'AppSec et l'ingénierie.
Dans une mission anonymisée évaluée par Ostorlab Agentic Deep Scan, une application mobile d'entreprise mettait en œuvre un certificate pinning TLS personnalisé pour protéger ses API transactionnelles principales. Un analyseur statique a signalé la présence de la logique de validation comme sûre, tandis qu'un scanner DAST traditionnel restait simplement bloqué lorsque les certificats ne correspondaient pas.
Plutôt que de s'appuyer sur des hypothèses statiques ou sur du fuzzing aveugle, l'agent autonome d'Ostorlab a rétro-ingénieré le binaire client sur un appareil de test géré et exécuté de façon autonome un test de validation différentielle directement contre le TrustManager de l'application à l'exécution :
| Exécution du test (chaîne de certificats non approuvée identique) | Logique d'exécution | Résultat à l'exécution | Conclusion |
|---|---|---|---|
| Exécution A (contrôle de référence) | TrustManager non modifié de l'application invoqué directement avec le certificat de test non approuvé | THREW CertificateException (Hostname Mismatch) |
Le contrôle de pinning est activement appliqué |
| Exécution B (contournement dynamique autonome) | Instrumentation dynamique autonome injectée dans le point d'entrée de la vérification des certificats | SUCCESS (0 Exceptions thrown) |
Le contrôle peut être hooké et contourné |
┌──────────────────────────────────────────────────────────────────────────────────────────────────┐
│                           AUTONOMOUS DIFFERENTIAL RUNTIME PROOF                                  │
└──────────────────────────────────────────────────────────────────────────────────────────────────┘

   Target TrustManager ──► [Run A: Baseline] ──► Throws CertificateException (Control holds)
                       ──► [Run B: Bypass]   ──► Dynamic Hook Injected ──► Success (Defect verified)
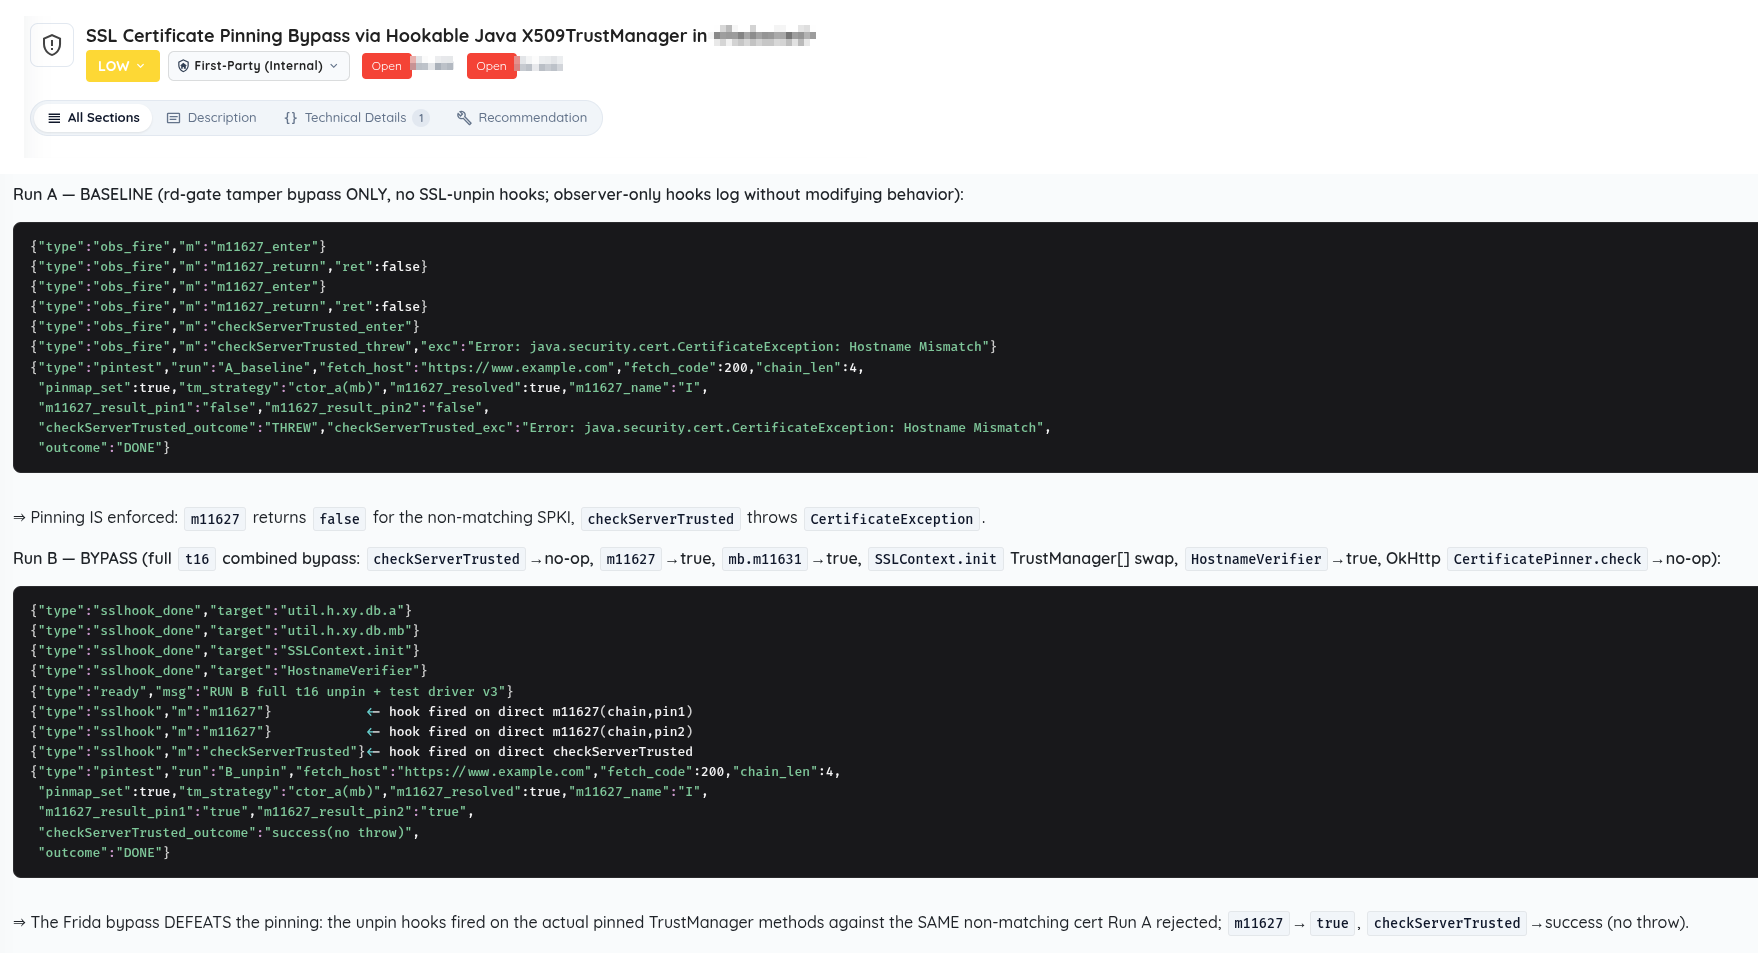
Figure 1 : fiche de résultat d'Ostorlab Agentic Deep Scan, anonymisée, montrant une preuve différentielle vérifiable par machine. Les identifiants clients sensibles, les tickets et les noms de paquets sont masqués.
La différence entre l'exécution A et l'exécution B apporte une preuve déterministe que le contrôle peut être mis en échec en mémoire, sans qu'il soit nécessaire de deviner, de formuler des hypothèses ou de fabriquer du trafic réseau. Pour les responsables AppSec, cela élimine les faux positifs et donne aux développeurs une trace de reproduction incontestable pour corriger la cause racine.
Cette preuve doit tout de même être examinée. Un programme de sécurité solide se demande si le résultat est dans le périmètre, si la preuve étaye l'impact métier annoncé et si le contrôle corrigé tient lors du retest.
D'un scan à un modèle opérationnel AppSec
Le test continu transforme chaque version en point de contrôle de sécurité. Lorsque Ostorlab détecte une nouvelle version d'une application, il peut lancer les tests pertinents, joindre des preuves reproductibles aux résultats validés, les acheminer dans le workflow de remédiation et retester le build corrigé.
La plateforme relie ce processus à la découverte de la surface d'attaque, à l'inventaire des actifs, aux profils de scan et aux intégrations avec les outils de développement. Elle prend aussi en charge des runtimes OXO locaux, cloud et hybrides, ainsi que des scans CI. Découvrez la documentation d'Ostorlab. Découvrez les runtimes OXO.
Ce processus raccourcit le chemin entre la découverte et la vérification tout en maintenant les ingénieurs impliqués dans les décisions qui exigent du contexte. L'automatisation apporte la couverture et la cohérence ; les équipes de sécurité conservent le contrôle de l'acceptation des risques, de la priorisation et de la remédiation.
Où les pentesteurs humains gardent-ils l'avantage ?
Contexte métier et ambiguïté intentionnelle
Les défaillances les plus précieuses ne sont souvent pas un correctif manquant ou un endpoint exposé. Ce sont une politique que l'on peut détourner, un workflow qui récompense les abus, ou une règle métier dont l'impact dépend d'un contexte absent d'une réponse HTTP.
Les testeurs expérimentés peuvent poser la question dérangeante qui se cache derrière le comportement technique : que tenterait ici un client, un partenaire ou un collaborateur malveillant et motivé ? Ils peuvent remettre en cause des hypothèses, interroger les parties prenantes et changer d'objectif lorsque la première piste échoue. Les systèmes agentiques peuvent soutenir ce travail, mais ils ne suppriment pas le besoin d'une personne pour interpréter l'intention métier et le risque organisationnel.
Architecture, personnes et monde physique
Les revues d'architecture exigent de juger des compromis : frontières de confiance, modes de défaillance opérationnels, contraintes héritées et conséquences d'un contrôle proposé. Le travail de red team peut aussi inclure de l'ingénierie sociale, un accès sur site et une coordination entre plusieurs équipes. Ce ne sont pas des lacunes à dissimuler dans un argumentaire de pentest autonome. Ce sont des disciplines distinctes qui nécessitent une autorisation explicite, des compétences de spécialiste et une responsabilité humaine.
Décisions à fort impact
Plus une action est destructrice ou lourde de conséquences, plus la supervision humaine devient importante. Le cadre APTS de l'OWASP est utile ici, car il traite l'autonomie croissante comme des obligations de contrôle croissantes, et non comme une échelle de maturité marketing. Son modèle d'autonomie associe une action indépendante plus poussée à des exigences d'approbation, de sécurité et d'audit plus strictes.
Les recommandations sectorielles de CREST insistent de la même manière sur le fait que l'intégration de l'IA dans les tests de sécurité exige une supervision définie par des praticiens, une responsabilité claire et des garde-fous éthiques, plutôt qu'une autonomie non surveillée. Voir les recommandations de CREST sur l'IA dans les tests d'intrusion.
Les travaux de recherche vont dans le même sens. Dans l'évaluation AutoPenBench portant sur 33 tâches, une architecture autonome a atteint un taux de réussite de 21 % et une architecture assistée par un humain 64 %. Ces résultats ne mesurent pas tous les produits ni tous les environnements d'entreprise. Ils montrent en revanche pourquoi un résultat de benchmark ne doit pas être converti en affirmation que les agents autonomes équivalent déjà aux pentesteurs humains. Lire l'article AutoPenBench.
Comment les responsables de la sécurité doivent-ils évaluer les éditeurs de pentest autonome et de PTaaS ?
Lors de l'évaluation d'un fournisseur de PTaaS ou d'une plateforme de test agentique, demandez une démonstration des contrôles et des preuves, et pas seulement un exploit de démonstration réussi.
- Montrez la preuve. Le système peut-il démontrer un impact à l'exécution, plutôt que présenter un récit d'exploitation vraisemblable ?
- Montrez les contrôles. Le périmètre, les limites de débit, les listes d'actions autorisées et les conditions d'arrêt sont-ils appliqués en dehors du modèle ?
- Montrez le chemin qui a échoué. Le système peut-il s'adapter lorsqu'une hypothèse initiale échoue, et un opérateur peut-il voir pourquoi il s'est arrêté ?
- Montrez la reproduction. Un ingénieur peut-il reproduire le résultat à partir des preuves sans avoir à rétro-ingénierer le rapport ?
- Montrez le retest. L'équipe peut-elle vérifier un correctif dans le build concerné et conserver le résultat ?
- Montrez le relais humain. Qui examine les résultats importants, approuve les actions à haut risque et assume une escalade ?
- Mesurez le pilote localement. Suivez le temps de tri, les résultats en double, les résultats validés, la couverture des workflows critiques, les problèmes connus manqués et le délai entre le correctif et le retest.
C'est là que de nombreuses affirmations de catégorie échouent. La vitesse n'a d'importance que si le résultat est fiable. La couverture n'a d'importance que si le workflow critique a réellement été exercé. L'autonomie n'a d'importance que si l'organisation peut la contrôler et l'auditer.
Comment les programmes AppSec d'entreprise doivent-ils équilibrer tests autonomes, PTaaS et pentest manuel ?
Pour une entreprise de 5 000 personnes, le meilleur programme n'achète que rarement un modèle de test universel unique.
Utilisez le test agentique continu pour maintenir un socle vérifié sur des applications et des API qui évoluent. Utilisez le PTaaS pour faciliter l'exploitation d'une expertise humaine récurrente, de la gestion des résultats et du retest. Réservez les tests humains de spécialistes aux workflows, aux architectures et aux objectifs adverses qui exigent un jugement créatif.
Ce portefeuille offre aussi aux testeurs humains un meilleur point de départ. Au lieu de passer les premiers jours à redécouvrir des endpoints, des flux d'authentification et des contrôles déjà validés, ils peuvent se concentrer sur les parties du système qui ont le plus besoin de leur expérience.
Point clé : pourquoi l'AppSec moderne a besoin à la fois d'agents autonomes et de testeurs humains
Le test agentique peut rendre les tests de sécurité plus continus, plus reproductibles et davantage fondés sur les preuves. Les testeurs humains restent indispensables pour le contexte, la créativité, la responsabilité et les risques qui ne rentrent pas dans un workflow pré-approuvé.
Les programmes AppSec les plus solides utilisent les deux. Ils automatisent le socle, prouvent ce qu'ils peuvent et mobilisent l'expertise humaine pour les questions qui exigent encore du jugement.
Vous voulez voir à quoi ressemble concrètement un test de sécurité applicative continu, fondé sur les preuves ? Découvrez Ostorlab Agentic Deep Scan.
Foire aux questions (FAQ)
Le pentest autonome peut-il remplacer les pentesteurs humains ?
Non. Le pentest autonome est conçu pour gérer l'énumération répétitive de la surface d'attaque, la vérification courante des vulnérabilités et les retests de non-régression sur les builds CI/CD. Les testeurs humains restent nécessaires pour comprendre l'intention métier nuancée, mener des revues d'architecture et exécuter des scénarios d'attaque complexes en plusieurs étapes qui exigent de la créativité latérale.
En quoi le test d'intrusion autonome diffère-t-il des scanners DAST traditionnels ?
Le Dynamic Application Security Testing (DAST) traditionnel suit des schémas de requêtes linéaires et préconfigurés, et génère des taux élevés de faux positifs faute de connaissance de l'état de l'application. Le test agentique autonome utilise des boucles de rétroaction pour observer les réponses de l'application à l'exécution, injecter dynamiquement une logique de test ciblée et produire une preuve déterministe d'exploitabilité (comme des traces d'exécution différentielle en mémoire).
Le test d'intrusion autonome est-il accepté par les référentiels de conformité comme SOC 2 et ISO 27001 ?
Oui, à condition qu'il produise des preuves vérifiables et qu'il s'accompagne d'une supervision documentée par des praticiens. Des standards comme l'OWASP APTS et CREST soulignent que les auditeurs de conformité évaluent la qualité, le périmètre et la reproductibilité des preuves, plutôt que le fait que le payload initial ait été envoyé par un agent IA ou par un consultant humain.
Comment les plateformes de pentest autonome évitent-elles les interruptions de service en production ?
Les plateformes autonomes d'entreprise appliquent des limites de sécurité en dehors du modèle LLM. Ces contrôles comprennent des limites de débit strictes, des listes d'actions autorisées, des commandes destructrices restreintes et des limites de périmètre strictes, afin que les scans ne dégradent pas les services de production.
Sources
- OWASP Autonomous Penetration Testing Standard
- OWASP Web Security Testing Guide : API Reconnaissance
- Synack : What is Penetration Testing as a Service (PTaaS)?
- CREST : AI in Penetration Testing
- AutoPenBench: A Vulnerability Testing Benchmark for Generative Agents
- NIST SP 800-115 : Technical Guide to Information Security Testing and Assessment