自律型ペンテスト対従来型ペンテスト
従来型ペンテスト、PTaaS、自律型AIテストを比較します。エージェントがカバレッジとエビデンスで勝る領域、人間が依然として主導する領域、そしてそれらを組み合わせる方法を解説します。
AppSec責任者は誰しも、やがて同じ予算の問いに直面します。次の1ドルは、もう一度の従来型ペネトレーションテストに充てるべきか、PTaaSのサブスクリプションか、それともエージェント型AIテストのプラットフォームか。
誤った答えは、誤った二者択一から始まります。これらの選択肢は、同じものを指しているわけではありません。
従来型ペネトレーションテストは、人間が主導する評価を指します。PTaaSは、テストが時間をかけてどのように提供・管理されるかを指します。エージェント型および自律型テストは、テストの最中にシステムがどのように判断を下すかを指します。成熟したセキュリティプログラムは、この3つすべてを使うことができます。
有用な問いは「AIはペンテスターを置き換えられるか」ではありません。それは「どの作業を継続的に実行すべきか、どの作業に人間の調査員が必要か、そしてエンジニアリングが動く前に、いずれもどのようなエビデンスを生み出すべきか」です。
直接的な答え:自律型ペンテストは、エージェント型のフィードバックループを用いて、速いリリースサイクルにわたって技術的な脆弱性を継続的に発見し、悪用し、検証します。ただし、それは人間のペネトレーションテスターを置き換えるものではありません。成熟したエンタープライズのAppSecプログラムは、ベースラインとなる技術的カバレッジのための継続的な自律エージェントを、複雑なビジネスロジック、カスタムアーキテクチャの評価、そして微妙なリスクの判断のための人間の専門家と組み合わせます。
従来型ペンテスト、PTaaS、エージェント型テストの違いは何か
セキュリティチームはしばしば、異なる軸に属するカテゴリーを比較しています。
従来型ペネトレーションテストは、通常、スコープを定め、期間を区切った作業です。人間のチームが環境を調べ、攻撃経路をテストし、検出結果を検証し、レポートを提供します。組織が、重要なリリース、カスタムアーキテクチャ、あるいは影響の大きいビジネスプロセスについて深い評価を必要とする場合、これは依然として有効です。NIST SP 800-115は、この古典的な段階的評価とレポートのモデルを概説しています。
サービスとしてのペネトレーションテスト(PTaaS)は、提供と運用のモデルです。通常、スコープの設定、検出結果、修復、レポート、再テストのための永続的なプラットフォームを追加します。PTaaSの作業は、人間主導、AI支援型、あるいはハイブリッドであり得ます。ポータルを通じて実行されるというだけで、自律型になるわけではありません。SynackもPTaaSの定義で同じ区別をしています。
エージェント型テストは、適応的なループを指します。固定されたチェックリストだけを実行するのではなく、システムは結果を観測し、次の仮説を立て、許可された操作やツールを選び、エビデンスを検査し、方向を変えることができます。
自律型テストは、そのモデルのうち自律性が高い側の端に位置します。システムは、操作ごとの承認なしに、テストの手順のより多くを決定しますが、それは明示的な境界の範囲内に限られます。OWASPの自律型ペネトレーションテスト標準は、これをスケジュールされたスキャンと区別しています。すなわち、何の判断も下さない事前設定済みのスキャンは、自律型テストではありません。そのガイダンスはまた、スコープの強制、安全性の制御、説明責任を中心的な要件としています。
これにより、セキュリティリーダーには、一つではなく二つの判断が課されます。
| 実行モデル | プロジェクト型の作業 | 繰り返しまたは継続的なサービス |
|---|---|---|
| 人間主導の実行 | 従来型ペンテスト | 人間主導のPTaaS |
| AI支援型の実行 | AIで加速されるコンサルタント主導の作業 | AI支援型のPTaaS |
| エージェント型または自律型の実行 | 対象を絞った、境界を定めた調査 | 継続的なエージェント型テストのプラットフォーム |
正しいモデルは、ベンダーのホームページ上のラベルではなく、リスク、リリースの頻度、そして必要とされるエビデンスに依存します。
自律型ペンテスト対従来型ペンテスト対PTaaS:機能の比較
| 問い | プロジェクト型の人間によるペンテスト | 継続的な人間主導のPTaaS | 継続的なエージェント型テスト |
|---|---|---|---|
| いつ実行されるか | 定められた間隔で | 要求されたとき、または定められたとき | リリース後、またはその他の承認されたトリガーの後 |
| 誰がテストを実施するか | 人間のペンテスター | 共有プラットフォームを使う人間のペンテスター | 人間の監督を伴う自律エージェント |
| 最も適した用途 | 複雑なビジネスロジックと新規の攻撃経路 | 人間の専門知識への繰り返しのアクセス | 頻繁なリリースにわたる再現可能なテスト |
| 主な限界 | 特定時点のカバレッジしか提供しない | 依然としてテスターの稼働可能性に依存する | すべてのビジネスリスクを独立して判断することはできない |
| AppSecにおける最適な役割 | 深い調査 | 繰り返しの専門家によるテスト | 継続的なセキュリティのベースライン |
この表はスコアカードではありません。自動化されたシステムは素早く着手できますが、それでも弱いエビデンスしか生み出さないことがあります。人間のチームは微妙な悪用のケースを見つけられますが、リリースのたびにすべてのワークフローを継続的に再実行することはできません。目標は、各レイヤーに、その強みに合った作業を割り当てることです。
自律型のエージェント型テストが構造的な優位性を持つのはどこか
作業と作業の間の継続的なカバレッジ
アプリケーションは、年次のテストカレンダーよりも頻繁に変化します。新しいAPIが現れ、認証フローが進化し、モバイルのリリースがSDKを追加し、修正された問題が後のビルドで再発することもあります。
エージェント型テストは、信頼できるトリガー(リリース、重大なAPIの変更、新しいアセット、あるいは修復のデプロイ)が発生するたびに実行すべき、再現可能な作業によく適しています。それは、以前のコンテキストを保持し、既知の経路を再度実行し、変化したものへと注意を向けることができます。
とはいえ、すべてのテストが同じように安全に自動化できるわけではありません。システムが動く前に、組織はスコープ、許可される手法、影響のしきい値、レート制限、エスカレーションの条件を定義しなければなりません。重要な区別は「手放し」対「手動」ではありません。それは、境界を定めた監査可能な自動化と、広範なアクセス権を持つ統制されていないエージェントとの違いです。
再現可能なAPIと認証済みワークフローの調査
現代のアプリケーションは、Webクライアント、モバイルアプリ、API、サードパーティとの連携、ソースコードにわたってリスクを露出します。エージェント型のプラットフォームは、傍受したトラフィック、APIの定義、アプリケーションのクライアント、承認されたテスト用のアイデンティティからのシグナルをまとめ、そこから得られるフローを再実行する助けになります。
これにより、APIの検出と認可のテストをより体系的にできます。ただし、どちらの問題も解決されるわけではありません。見逃したエンドポイント、不完全なロールモデル、非現実的なテストデータは、依然として誤った安心感を生み出すことがあります。OWASPのAPIテストのガイダンスは、検出を複数ソースのプロセスとして扱い、認可に関する結論が、正しいエンドポイント、アイデンティティ、経路がテストされることに依存すると警告しています。OWASPのAPI偵察ガイダンスを参照してください。
運用速度でのエビデンスの取得
コードの中にセキュリティ制御を見つけても、それが実行時に機能することは実証されません。そして、検証されていないアラートを指摘することは、AppSecとエンジニアリングの間に摩擦を生みます。
Ostorlab Agentic Deep Scanによって評価された、匿名化されたある作業では、あるエンタープライズのモバイルアプリケーションが、中核となる取引APIを保護するためにカスタムのTLS証明書ピンニングを実装していました。静的アナライザーは、その検証ロジックの存在を安全であると判定した一方、従来のDASTスキャナーは、証明書が一致しないと単に停止してしまいました。
静的な想定やあてずっぽうのファジングに頼る代わりに、Ostorlabの自律エージェントは、管理されたテスト端末上でクライアントバイナリをリバースし、アプリケーションの実行時のTrustManagerに対して直接、自律的な差分検証テストを実行しました。
| テスト実行(同一の信頼されない証明書チェーン) | 実行ロジック | 実行時の結果 | 結論 |
|---|---|---|---|
| 実行A(ベースラインの対照) | 信頼されないテスト証明書を用いて、アプリケーションの未改変のTrustManagerを直接呼び出し | THREW CertificateException (Hostname Mismatch) |
ピンニングの制御は実際に強制されている |
| 実行B(自律的な動的バイパス) | 証明書検証のエントリーポイントに注入された自律的な動的計装 | SUCCESS (0 Exceptions thrown) |
制御はフック可能であり、バイパスされた |
┌──────────────────────────────────────────────────────────────────────────────────────────────────┐
│                           AUTONOMOUS DIFFERENTIAL RUNTIME PROOF                                  │
└──────────────────────────────────────────────────────────────────────────────────────────────────┘

   Target TrustManager ──► [Run A: Baseline] ──► Throws CertificateException (Control holds)
                       ──► [Run B: Bypass]   ──► Dynamic Hook Injected ──► Success (Defect verified)
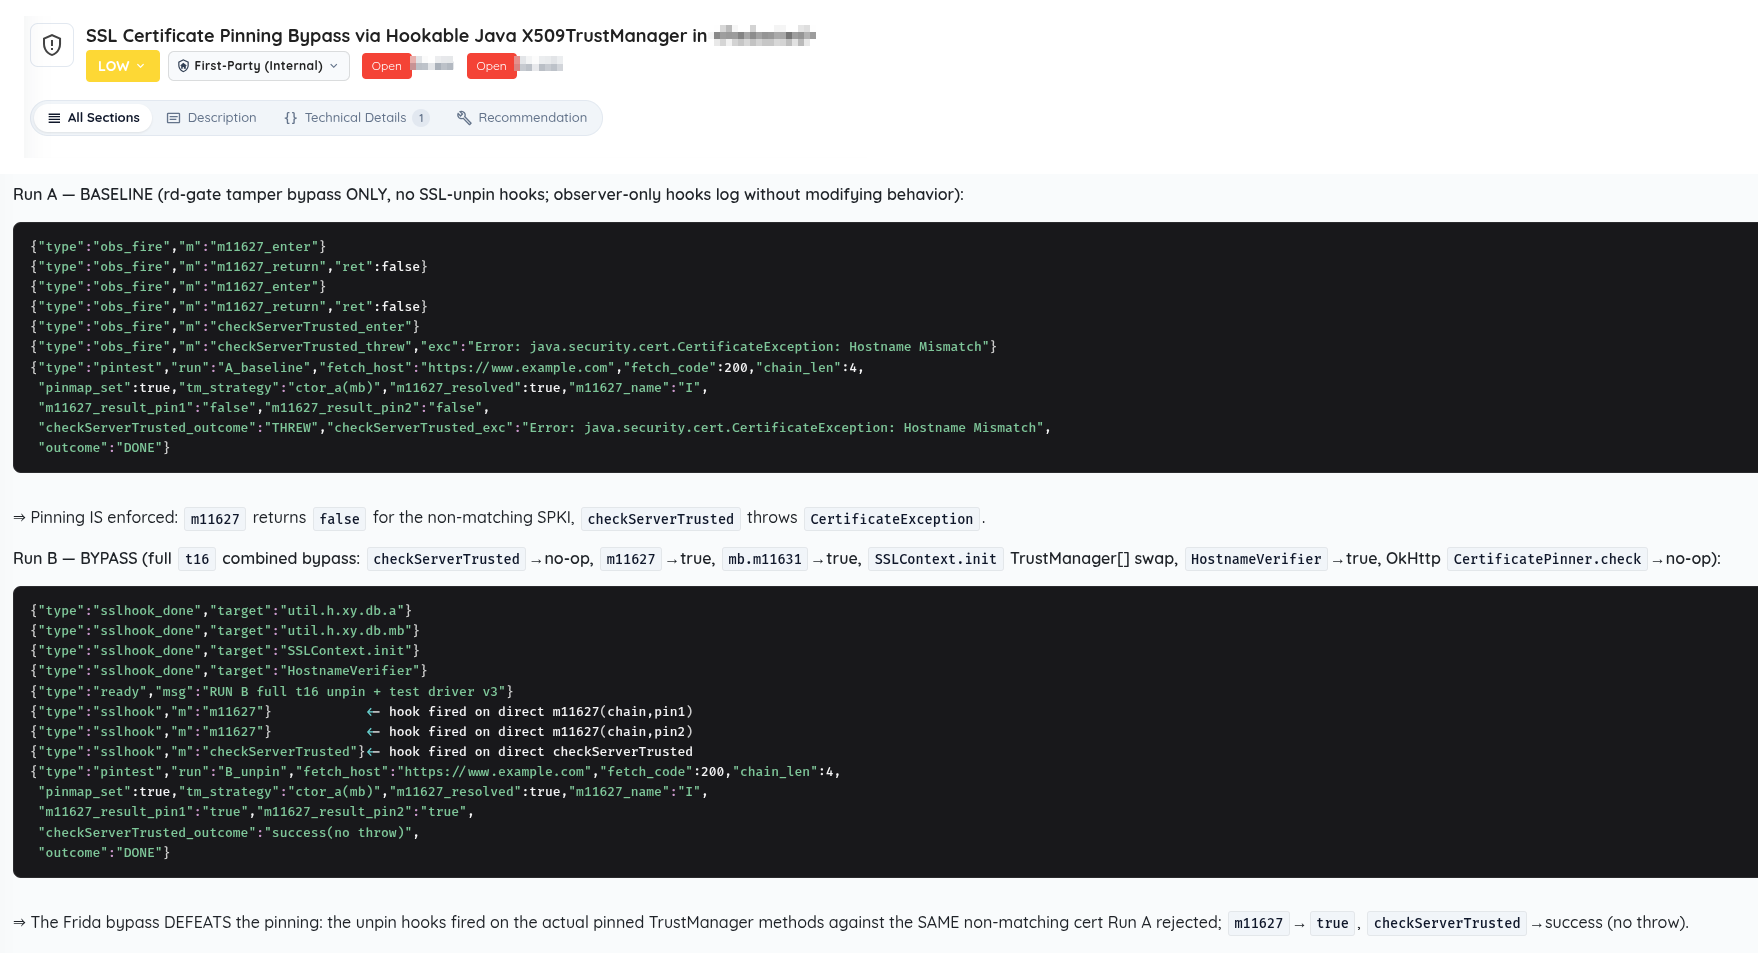
図1:機械で検証可能な差分の実証を示す、サニタイズ済みのOstorlab Agentic Deep Scanの検出結果カード。機密性の高いクライアントの識別子、チケット、パッケージ名は伏字にしてあります。
実行Aと実行Bの差は、推測したり、仮説を立てたり、ネットワークトラフィックを捏造したりすることなく、その制御がメモリ上で突破され得るという決定論的な実証を提供します。AppSecのリーダーにとって、これは誤検知を排除し、開発者に、根本原因を修正するための否定しようのない再現トレースを与えます。
そのエビデンスも、依然としてレビューが必要です。強力なセキュリティプログラムは、その検出結果がスコープ内か、その実証が主張されたビジネスへの影響を裏付けるか、そして修正された制御が再テストの際に機能するかを問います。
スキャンからAppSecの運用モデルへ
継続的なテストは、各リリースをセキュリティのチェックポイントに変えます。Ostorlabは、新しいアプリケーションのバージョンを検出すると、関連するテストを起動し、検証済みの検出結果に再現可能なエビデンスを添付し、それらを修復のワークフローに振り分け、修正されたビルドを再テストすることができます。
このプラットフォームは、このプロセスを、アタックサーフェス検出、アセットインベントリ、スキャンプロファイル、開発ツールとの連携に接続します。また、ローカル、クラウド、ハイブリッドのOXOランタイム、そしてCIスキャンもサポートします。Ostorlabのドキュメントを見る。 OXOランタイムを見る。
このプロセスは、発見から検証までの経路を短縮しつつ、コンテキストを要する判断にはエンジニアを関与させ続けます。自動化はカバレッジと一貫性を提供し、セキュリティチームはリスクの受容、優先順位付け、修復に対する制御を保ち続けます。
人間のペネトレーションテスターが依然として主導するのはどこか
ビジネスのコンテキストと意図的な曖昧さ
最も価値のある失敗は、多くの場合、欠けているパッチや露出したエンドポイントではありません。それは、曲げられるポリシー、悪用に報いるワークフロー、あるいはその影響がHTTPレスポンスでは得られないコンテキストに依存するビジネスルールです。
経験豊富なテスターは、技術的な挙動の背後にある、居心地の悪い問いを投げかけることができます。すなわち「動機を持った顧客、パートナー、あるいはインサイダーは、ここで何を試みるだろうか」という問いです。彼らは、想定に異議を唱え、ステークホルダーに聞き取りを行い、最初の経路が失敗したときに目的を変えることができます。エージェント型システムはその作業を支援できますが、ビジネスの意図や組織のリスクを解釈する人間の必要性を取り除くわけではありません。
アーキテクチャ、人、そして物理世界
アーキテクチャのレビューには、トレードオフについての判断が必要です。すなわち、信頼境界、運用上の障害モード、レガシーの制約、そして提案された制御がもたらす結果です。レッドチームの作業には、ソーシャルエンジニアリング、現地でのアクセス、複数チームの調整が含まれることもあります。これらは、自律型ペンテストの売り込みの中で隠すべきギャップではありません。これらは、明示的な認可、専門的なスキル、そして人間の説明責任を必要とする、独立した専門領域です。
影響の大きい判断
ある操作が破壊的、あるいは重大になるほど、人間の監督がより重要になります。OWASPのAPTSフレームワークがここで有用なのは、それが自律性の増大を、マーケティング上の成熟度のはしごではなく、制御義務の増大として扱うからです。その自律性モデルは、より高い独立した行動を、より強力な承認、安全性、監査の要件と対にしています。
CRESTによる業界ガイダンスも同様に、AIをセキュリティテストに組み込むことは、監視されていない自律性ではなく、定められた実務者の監督、説明責任、倫理的なガードレールを要求すると強調しています。ペネトレーションテストにおけるAIに関するCRESTのガイダンスを参照してください。
研究も同じ方向を指しています。33タスクのAutoPenBench評価では、自律型のアーキテクチャは21%の成功率を達成し、人間支援型のアーキテクチャは64%を達成しました。これらの結果は、あらゆる製品やあらゆるエンタープライズ環境を計測するものではありません。しかしそれらは、ベンチマークの結果を、自律エージェントがすでに人間のペンテスターと同等であるという主張に変換すべきでない理由を示しています。AutoPenBenchの論文を読む。
セキュリティリーダーは、自律型ペンテストやPTaaSのベンダーをどう評価すべきか
PTaaSのプロバイダーやエージェント型テストのプラットフォームを評価する際には、成功したデモのエクスプロイトだけでなく、制御とエビデンスの実演を求めてください。
- 実証を見せてもらう。システムは、もっともらしいエクスプロイトの物語を提示するのではなく、実行時の影響を実証できるか。
- 制御を見せてもらう。スコープ、レート制限、操作の許可リスト、停止条件は、モデルの外側で強制されているか。
- 失敗した経路を見せてもらう。最初の仮説が失敗したときにシステムは適応できるか、そしてオペレーターは、なぜそれが停止したのかを見られるか。
- 再現を見せてもらう。エンジニアは、レポートをリバースエンジニアリングすることなく、エビデンスから検出結果を再現できるか。
- 再テストを見せてもらう。チームは、影響を受けたビルドで修正を検証し、その結果を保持できるか。
- 人間への引き継ぎを見せてもらう。誰が重要な検出結果をレビューし、リスクの高い操作を承認し、エスカレーションを担うのか。
- パイロットを自社で計測する。トリアージまでの時間、重複した検出結果、検証済みの検出結果、重要なワークフローのカバレッジ、見逃した既知の問題、そして修正から再テストまでの時間を追跡する。
多くのカテゴリーに関する主張が破綻するのは、まさにここです。速度が重要なのは、結果が信頼できる場合に限られます。カバレッジが重要なのは、重要なワークフローが実際に実行された場合に限られます。自律性が重要なのは、組織がそれを制御し監査できる場合に限られます。
エンタープライズのAppSecプログラムは、自律型テスト、PTaaS、手動ペンテストをどうバランスさせるべきか
5,000人規模のエンタープライズにとって、最良のプログラムが、単一の万能なテストモデルを購入することはめったにありません。
変化するアプリケーションとAPIにわたって検証済みのベースラインを維持するには、継続的なエージェント型テストを使ってください。繰り返しの人間の専門知識、検出結果の管理、再テストをより運用しやすくするには、PTaaSを使ってください。創造的な判断を要するワークフロー、アーキテクチャ、敵対的な目的のためには、専門家による人間のテストを取っておいてください。
このポートフォリオはまた、人間のテスターにより良い出発点を与えます。最初の数日をエンドポイント、認証フロー、すでに検証済みの制御の再発見に費やす代わりに、彼らは、自らの経験を最も必要とするシステムの部分に集中できます。
要点:なぜ現代のAppSecには自律エージェントと人間のテスターの両方が必要なのか
エージェント型テストは、セキュリティテストをより継続的で、再現可能で、エビデンス主導のものにできます。人間のテスターは、コンテキスト、創造性、説明責任、そして事前承認されたワークフローに収まらないリスクのために、依然として欠かせません。
最も強力なAppSecプログラムは、その両方を使います。それらはベースラインを自動化し、実証できるものを実証し、依然として判断を要する問いには人間の専門知識を持ち込みます。
エビデンス主導の継続的なアプリケーションセキュリティテストが、実際にどのようなものかをご覧になりたいですか。Ostorlab Agentic Deep Scanを見る。
よくある質問(FAQ)
自律型ペンテストは、人間のペネトレーションテスターを置き換えられるか
いいえ。自律型ペンテストは、反復的なアタックサーフェスの列挙、定型的な脆弱性の検証、そしてCI/CDのビルドにわたるリグレッションの再テストを扱うよう設計されています。微妙なビジネスの意図を理解し、アーキテクチャのレビューを行い、横断的な創造性を要する複雑で多段階の攻撃シナリオを実行するには、依然として人間のテスターが必要です。
自律型ペネトレーションテストは、レガシーなDASTスキャナーとどう異なるのか
従来の動的アプリケーションセキュリティテスト(DAST)は、事前設定された線形のリクエストパターンに従い、アプリケーションの状態を認識しないために高い誤検知率を生み出します。自律型のエージェント型テストは、フィードバックループを用いて実行時のアプリケーションのレスポンスを観測し、対象を絞ったテストロジックを動的に注入し、悪用可能性の決定論的な実証(メモリ上の差分実行トレースなど)を生み出します。
自律型ペネトレーションテストは、SOC 2やISO 27001のようなコンプライアンスフレームワークで受け入れられるか
はい、ただし検証可能な実証を生み出し、文書化された実務者の監督を維持する場合に限ります。OWASP APTSやCRESTのような標準は、コンプライアンスの監査人が、最初のペイロードをAIエージェントが送出したのか手動のコンサルタントが送出したのかではなく、エビデンスの品質、スコープ、再現性を評価することを強調しています。
自律型ペンテストのプラットフォームは、本番環境でのサービス停止をどう防ぐのか
エンタープライズの自律型プラットフォームは、安全性の境界をLLMモデルの外側で強制します。これらの制御には、厳格なレート制限、操作の許可リスト、制限された破壊的コマンド、そして厳密なスコープの境界が含まれ、スキャンが本番環境のサービスを劣化させないことを保証します。