Pentesting autónomo vs pentesting tradicional
Compare los pentests tradicionales, PTaaS y las pruebas autónomas con IA: dónde ganan los agentes en cobertura y evidencias, dónde siguen liderando las personas y cómo combinarlos.
Todo responsable de AppSec acaba enfrentándose a la misma pregunta presupuestaria: ¿el próximo dólar debe financiar otra prueba de penetración tradicional, una suscripción a PTaaS o una plataforma de pruebas con IA agéntica?
La respuesta equivocada empieza con una falsa disyuntiva. Estas opciones no describen lo mismo.
La prueba de penetración tradicional describe una evaluación dirigida por personas. PTaaS describe cómo se entregan y gestionan las pruebas a lo largo del tiempo. Las pruebas agénticas y autónomas describen cómo un sistema toma decisiones durante una prueba. Un programa de seguridad maduro puede usar las tres.
La pregunta útil no es «¿puede la IA sustituir a un pentester?». Es «¿qué trabajo debe ejecutarse de forma continua, qué trabajo necesita a un investigador humano y qué evidencias debe producir cada uno antes de que ingeniería actúe?».
Respuesta directa: el pentesting autónomo utiliza bucles de retroalimentación agénticos para descubrir, explotar y verificar de forma continua vulnerabilidades técnicas a lo largo de ciclos de versiones rápidos. Sin embargo, no sustituye a los pentesters humanos. Los programas de AppSec empresariales maduros combinan agentes autónomos continuos para la cobertura técnica de referencia con especialistas humanos para la lógica de negocio compleja, las evaluaciones de arquitecturas personalizadas y las decisiones de riesgo con matices.
¿Cuál es la diferencia entre el pentesting tradicional, PTaaS y las pruebas agénticas?
Los equipos de seguridad suelen comparar categorías que pertenecen a ejes distintos.
La prueba de penetración tradicional suele ser un encargo con alcance definido y plazo limitado. Un equipo humano estudia un entorno, prueba rutas de ataque, valida hallazgos y entrega un informe. Sigue siendo eficaz cuando una organización necesita una evaluación en profundidad de una versión crítica, una arquitectura personalizada o un proceso de negocio de alto impacto. NIST SP 800-115 describe este modelo clásico de evaluación e informes por fases.
Penetration Testing as a Service (PTaaS) es un modelo de entrega y operación. Normalmente añade una plataforma persistente para la definición del alcance, los hallazgos, la corrección, los informes y las nuevas pruebas. Un servicio PTaaS puede estar dirigido por personas, asistido por IA o ser híbrido. No se vuelve autónomo solo por ejecutarse a través de un portal. Synack hace la misma distinción en su definición de PTaaS.
Las pruebas agénticas describen un bucle adaptativo. En lugar de ejecutar únicamente una lista de comprobación fija, el sistema puede observar un resultado, formular la siguiente hipótesis, seleccionar una acción o herramienta permitida, inspeccionar las evidencias y cambiar de rumbo.
Las pruebas autónomas son el extremo de mayor autonomía de ese modelo. El sistema decide una parte mayor de la secuencia de pruebas sin aprobación por acción, pero solo dentro de límites explícitos. El Autonomous Penetration Testing Standard de OWASP distingue esto del escaneo programado: un escaneo preconfigurado que no toma decisiones no es una prueba autónoma. Su guía también establece como requisitos centrales la aplicación del alcance, los controles de seguridad y la rendición de cuentas.
Esto plantea a los líderes de seguridad dos decisiones, no una:
| Modelo de ejecución | Encargo por proyecto | Servicio recurrente o continuo |
|---|---|---|
| Ejecución dirigida por personas | Pentest tradicional | PTaaS dirigido por personas |
| Ejecución asistida por IA | Trabajo dirigido por consultores y acelerado con IA | PTaaS asistido por IA |
| Ejecución agéntica o autónoma | Investigación dirigida y acotada | Plataforma continua de pruebas agénticas |
El modelo adecuado depende del riesgo, del ritmo de publicación de versiones y de las evidencias requeridas, no de la etiqueta que figure en la página de inicio de un proveedor.
Pentesting autónomo vs. pentesting tradicional vs. PTaaS: comparación de características
| Pregunta | Pentest humano por proyecto | PTaaS continuo dirigido por personas | Pruebas agénticas continuas |
|---|---|---|---|
| ¿Cuándo se ejecuta? | A intervalos programados | Cuando se solicita o se programa | Tras las versiones u otros disparadores aprobados |
| ¿Quién realiza las pruebas? | Pentesters humanos | Pentesters humanos que usan una plataforma compartida | Agentes autónomos con supervisión humana |
| Más adecuado para | Lógica de negocio compleja y rutas de ataque novedosas | Acceso recurrente a la experiencia humana | Pruebas repetibles en versiones frecuentes |
| Principal limitación | Ofrece cobertura solo en un momento puntual | Sigue dependiendo de la disponibilidad de los testers | No puede juzgar por sí solo todos los riesgos de negocio |
| Mejor papel en AppSec | Investigación en profundidad | Pruebas especializadas recurrentes | Base de seguridad continua |
La tabla no es un cuadro de puntuación. Un sistema automatizado puede arrancar rápido y aun así producir evidencias débiles. Un equipo humano puede encontrar un caso de abuso sutil, pero no puede volver a ejecutar de forma continua todos los flujos de trabajo tras cada versión. El objetivo es asignar a cada capa el trabajo que se ajuste a sus fortalezas.
¿Dónde tienen una ventaja estructural las pruebas agénticas autónomas?
Cobertura continua entre encargos
Las aplicaciones cambian con más frecuencia que los calendarios de pruebas anuales. Aparecen nuevas API, evolucionan los flujos de autenticación, las versiones móviles añaden SDK y un problema corregido puede reaparecer en una compilación posterior.
Las pruebas agénticas son idóneas para el trabajo repetible que debe realizarse siempre que ocurra un disparador de confianza: una versión, un cambio relevante en una API, un nuevo activo o un despliegue de una corrección. Pueden conservar el contexto previo, volver a ejercitar rutas conocidas y dirigir la atención hacia lo que ha cambiado.
Eso no hace que todas las pruebas sean igualmente seguras de automatizar. La organización debe definir el alcance, las técnicas permitidas, los umbrales de impacto, los límites de frecuencia y las condiciones de escalado antes de que un sistema actúe. La distinción importante no es «sin intervención» frente a «con intervención». Es la automatización acotada y auditable frente a un agente sin gobierno y con acceso amplio.
Investigación repetible de API y de flujos de trabajo autenticados
Las aplicaciones modernas exponen su riesgo a través de clientes web, aplicaciones móviles, API, integraciones de terceros y código fuente. Una plataforma agéntica puede ayudar a reunir señales procedentes del tráfico interceptado, las definiciones de API, los clientes de la aplicación y las identidades de prueba aprobadas, y luego volver a ejercitar los flujos resultantes.
Esto puede hacer que el descubrimiento de API y las pruebas de autorización sean más sistemáticos. No significa que ninguno de los dos problemas esté resuelto. Un endpoint omitido, un modelo de roles incompleto o unos datos de prueba poco realistas pueden seguir produciendo una falsa sensación de garantía. La guía de pruebas de API de OWASP trata el descubrimiento como un proceso de múltiples fuentes y advierte de que las conclusiones sobre la autorización dependen de que se pruebe el endpoint, la identidad y la ruta correctos. Consulte la guía de reconocimiento de API de OWASP.
Captura de evidencias a velocidad operativa
Encontrar un control de seguridad en el código no demuestra que se cumpla en tiempo de ejecución, y señalar una alerta sin verificar genera fricción entre AppSec e ingeniería.
En un encargo anonimizado evaluado por Ostorlab Agentic Deep Scan, una aplicación móvil empresarial implementaba una fijación de certificados TLS personalizada para proteger sus API transaccionales principales. Un analizador estático señaló la presencia de la lógica de validación como segura, mientras que un escáner DAST tradicional simplemente se quedó bloqueado cuando los certificados no coincidían.
En lugar de basarse en suposiciones estáticas o en fuzzing a ciegas, el agente autónomo de Ostorlab aplicó ingeniería inversa al binario del cliente en un dispositivo de pruebas gestionado y ejecutó una prueba diferencial de validación autónoma directamente contra el TrustManager de la aplicación en tiempo de ejecución:
| Ejecución de prueba (cadena de certificados no confiable idéntica) | Lógica de ejecución | Resultado en tiempo de ejecución | Conclusión |
|---|---|---|---|
| Ejecución A (control de referencia) | TrustManager de la aplicación sin modificar, invocado directamente con un certificado de prueba no confiable | THREW CertificateException (Hostname Mismatch) |
El control de fijación se aplica activamente |
| Ejecución B (evasión dinámica autónoma) | Instrumentación dinámica autónoma inyectada en el punto de entrada de la verificación de certificados | SUCCESS (0 Exceptions thrown) |
El control puede interceptarse con hooks y eludirse |
┌──────────────────────────────────────────────────────────────────────────────────────────────────┐
│                           AUTONOMOUS DIFFERENTIAL RUNTIME PROOF                                  │
└──────────────────────────────────────────────────────────────────────────────────────────────────┘

   Target TrustManager ──► [Run A: Baseline] ──► Throws CertificateException (Control holds)
                       ──► [Run B: Bypass]   ──► Dynamic Hook Injected ──► Success (Defect verified)
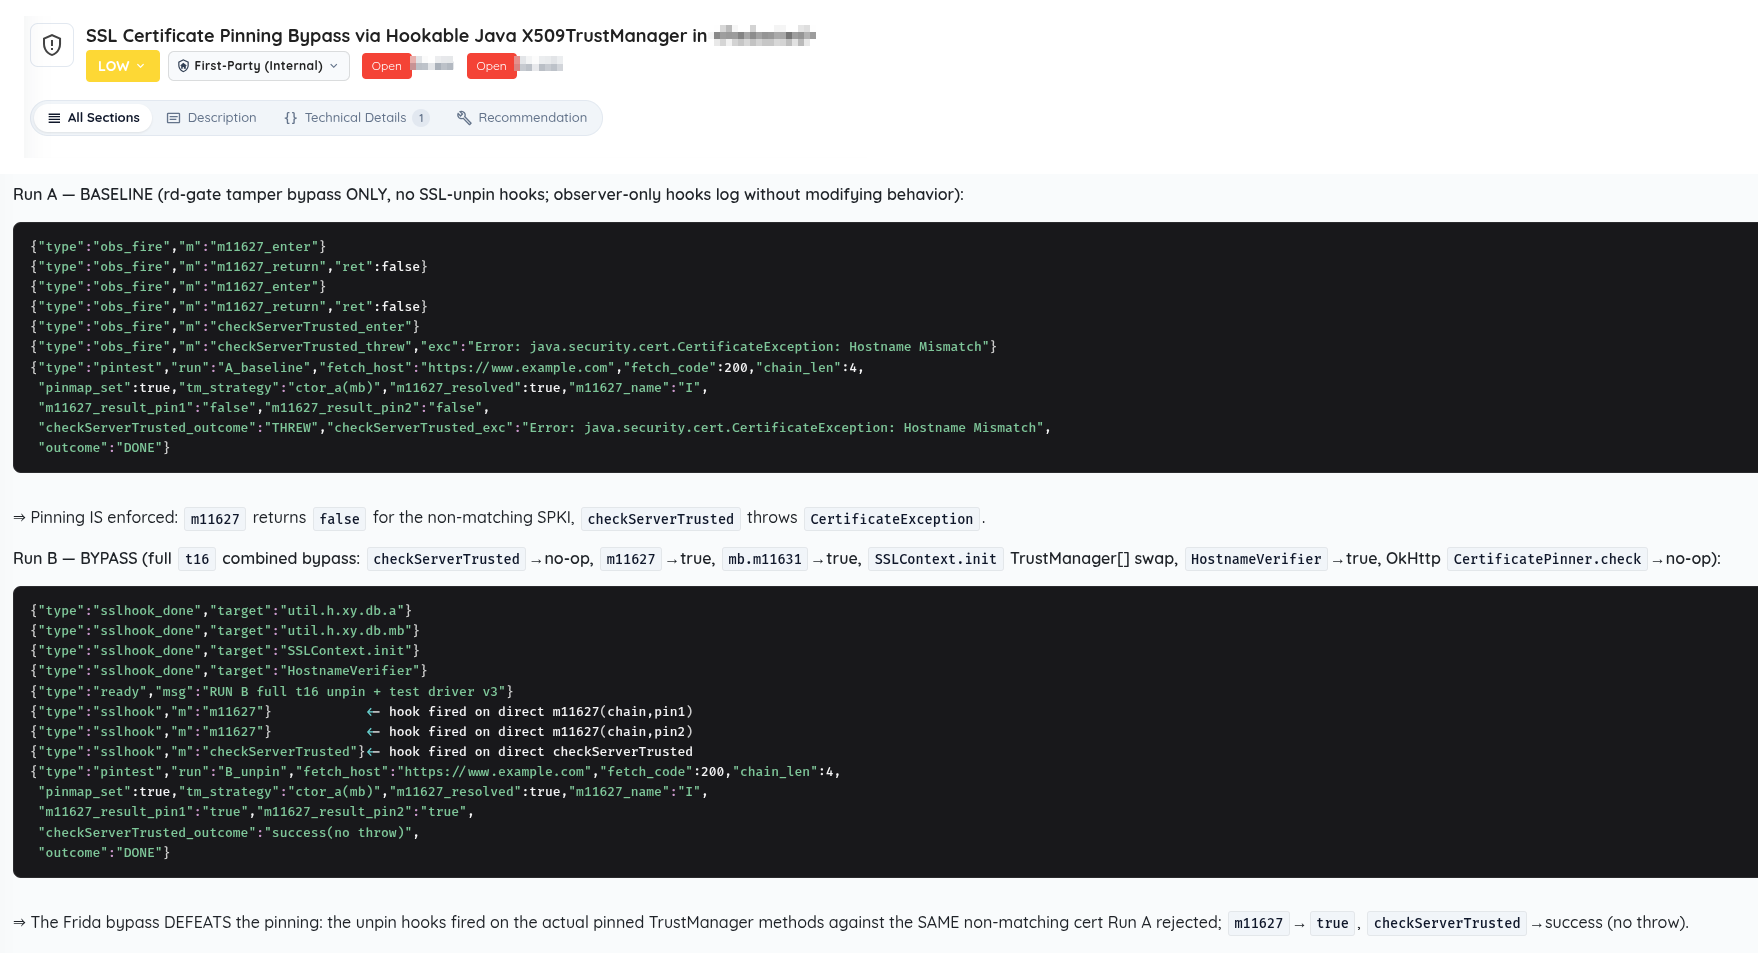
Figura 1: tarjeta de hallazgo de Ostorlab Agentic Deep Scan, saneada, que muestra una prueba diferencial verificable por máquina. Se han ocultado los identificadores de clientes, los tickets y los nombres de paquetes sensibles.
La diferencia entre la ejecución A y la ejecución B ofrece una prueba determinista de que el control puede ser derrotado en memoria, sin necesidad de adivinar, plantear hipótesis ni fabricar tráfico de red. Para los líderes de AppSec, esto elimina los falsos positivos y proporciona a los desarrolladores una traza de reproducción irrefutable para corregir la causa raíz.
Esa evidencia aún requiere revisión. Un programa de seguridad sólido se pregunta si el hallazgo está dentro del alcance, si la prueba respalda el impacto de negocio alegado y si el control corregido se mantiene durante las nuevas pruebas.
De un escaneo a un modelo operativo de AppSec
Las pruebas continuas convierten cada versión en un punto de control de seguridad. Cuando Ostorlab detecta una nueva versión de la aplicación, puede lanzar las pruebas pertinentes, adjuntar evidencias reproducibles a los hallazgos validados, encaminarlos al flujo de trabajo de corrección y volver a probar la compilación corregida.
La plataforma conecta este proceso con el descubrimiento de la superficie de ataque, el inventario de activos, los perfiles de escaneo y las integraciones con herramientas de desarrollo. También admite runtimes de OXO locales, en la nube e híbridos, además de escaneos de CI. Explore la documentación de Ostorlab. Explore los runtimes de OXO.
Este proceso acorta el camino entre el descubrimiento y la verificación, al tiempo que mantiene a los ingenieros implicados en las decisiones que requieren contexto. La automatización aporta cobertura y coherencia; los equipos de seguridad conservan el control de la aceptación del riesgo, la priorización y la corrección.
¿Dónde siguen liderando los pentesters humanos?
Contexto de negocio y ambigüedad intencionada
Los fallos más valiosos a menudo no son un parche que falta o un endpoint expuesto. Son una política que se puede doblegar, un flujo de trabajo que premia el abuso o una regla de negocio cuyo impacto depende de un contexto que no está disponible en una respuesta HTTP.
Los testers con experiencia pueden formular la pregunta incómoda que hay detrás del comportamiento técnico: ¿qué intentaría aquí un cliente, un socio o una persona interna con motivación? Pueden cuestionar suposiciones, entrevistar a las partes interesadas y cambiar el objetivo cuando falla la primera vía. Los sistemas agénticos pueden apoyar ese trabajo, pero no eliminan la necesidad de que una persona interprete la intención del negocio y el riesgo organizativo.
Arquitectura, personas y el mundo físico
Las revisiones de arquitectura requieren criterio sobre las compensaciones: límites de confianza, modos de fallo operativos, restricciones heredadas y las consecuencias de un control propuesto. El trabajo de red team también puede incluir ingeniería social, acceso presencial y coordinación entre varios equipos. No son carencias que haya que ocultar en un discurso sobre el pentesting autónomo. Son disciplinas distintas que requieren autorización explícita, competencias especializadas y rendición de cuentas humana.
Decisiones de alto impacto
Cuanto más destructiva o trascendente es una acción, más importante se vuelve la supervisión humana. El marco APTS de OWASP resulta útil aquí porque trata la autonomía creciente como obligaciones de control crecientes, no como una escalera de madurez de marketing. Su modelo de autonomía asocia una mayor capacidad de actuación independiente con requisitos más estrictos de aprobación, seguridad y auditoría.
La guía del sector de CREST subraya de forma similar que incorporar la IA a las pruebas de seguridad exige una supervisión definida por parte de profesionales, rendición de cuentas y salvaguardas éticas, en lugar de una autonomía sin monitorización. Consulte la guía de CREST sobre la IA en las pruebas de penetración.
La investigación apunta en la misma dirección. En la evaluación AutoPenBench de 33 tareas, una arquitectura autónoma logró una tasa de éxito del 21% y una arquitectura asistida por humanos logró el 64%. Esos resultados no miden todos los productos ni todos los entornos empresariales. Sí muestran por qué un resultado de benchmark no debe convertirse en la afirmación de que los agentes autónomos ya equivalen a los pentesters humanos. Lea el artículo de AutoPenBench.
¿Cómo deben evaluar los líderes de seguridad a los proveedores de pentesting autónomo y PTaaS?
Al evaluar a un proveedor de PTaaS o una plataforma de pruebas agénticas, pida una demostración de los controles y de las evidencias, no solo un exploit de demostración exitoso.
- Muestre la prueba. ¿Puede el sistema demostrar el impacto en tiempo de ejecución, en lugar de presentar una narrativa verosímil de exploit?
- Muestre los controles. ¿Se aplican el alcance, los límites de frecuencia, las listas de acciones permitidas y las condiciones de parada fuera del modelo?
- Muestre la ruta fallida. ¿Puede el sistema adaptarse cuando falla una hipótesis inicial y puede un operador ver por qué se detuvo?
- Muestre la reproducción. ¿Puede un ingeniero reproducir el hallazgo a partir de las evidencias sin tener que aplicar ingeniería inversa al informe?
- Muestre la nueva prueba. ¿Puede el equipo verificar una corrección en la compilación afectada y conservar el resultado?
- Muestre el traspaso a las personas. ¿Quién revisa los hallazgos relevantes, aprueba las acciones de alto riesgo y se encarga de un escalado?
- Mida el piloto localmente. Registre el tiempo hasta el triaje, los hallazgos duplicados, los hallazgos validados, la cobertura de los flujos de trabajo críticos, los problemas conocidos omitidos y el tiempo desde la corrección hasta la nueva prueba.
Aquí es donde fallan muchas afirmaciones de la categoría. La velocidad solo importa si el resultado es fiable. La cobertura solo importa si el flujo de trabajo crítico se ejercitó realmente. La autonomía solo importa si la organización puede controlarla y auditarla.
¿Cómo deben equilibrar los programas de AppSec empresariales las pruebas autónomas, PTaaS y el pentesting manual?
Para una empresa de 5,000 personas, el mejor programa rara vez adquiere un único modelo de pruebas universal.
Utilice pruebas agénticas continuas para mantener una base verificada en aplicaciones y API cambiantes. Utilice PTaaS para facilitar la operación de la experiencia humana recurrente, la gestión de hallazgos y las nuevas pruebas. Reserve las pruebas humanas especializadas para los flujos de trabajo, las arquitecturas y los objetivos adversarios que requieren un criterio creativo.
Este portafolio también ofrece a los testers humanos un mejor punto de partida. En lugar de dedicar los primeros días a redescubrir endpoints, flujos de autenticación y controles ya validados, pueden centrarse en las partes del sistema que más necesitan su experiencia.
Conclusión clave: por qué el AppSec moderno requiere tanto agentes autónomos como testers humanos
Las pruebas agénticas pueden hacer que las pruebas de seguridad sean más continuas, repetibles y basadas en evidencias. Los testers humanos siguen siendo esenciales para el contexto, la creatividad, la rendición de cuentas y los riesgos que no encajan en un flujo de trabajo preaprobado.
Los programas de AppSec más sólidos utilizan ambos. Automatizan la base, demuestran lo que pueden y aportan experiencia humana a las preguntas que aún requieren criterio.
¿Quiere ver cómo son en la práctica las pruebas de seguridad de aplicaciones continuas y basadas en evidencias? Explore Ostorlab Agentic Deep Scan.
Preguntas frecuentes (FAQ)
¿Puede el pentesting autónomo sustituir a los pentesters humanos?
No. El pentesting autónomo está diseñado para encargarse de la enumeración repetitiva de la superficie de ataque, la verificación rutinaria de vulnerabilidades y las nuevas pruebas de regresión en las compilaciones de CI/CD. Los testers humanos siguen siendo necesarios para comprender la intención de negocio con sus matices, realizar revisiones de arquitectura y ejecutar escenarios de ataque complejos y de varias etapas que requieren creatividad lateral.
¿En qué se diferencia la prueba de penetración autónoma de los escáneres DAST heredados?
Las pruebas de seguridad de aplicaciones dinámicas (DAST) tradicionales siguen patrones de solicitudes lineales y preconfigurados, y generan altas tasas de falsos positivos por la falta de conocimiento del estado de la aplicación. Las pruebas agénticas autónomas utilizan bucles de retroalimentación para observar las respuestas de la aplicación en tiempo de ejecución, inyectar dinámicamente lógica de prueba dirigida y producir pruebas deterministas de explotabilidad (como trazas de ejecución diferencial en memoria).
¿Se acepta la prueba de penetración autónoma en marcos de cumplimiento normativo como SOC 2 e ISO 27001?
Sí, siempre que produzca pruebas verificables y mantenga una supervisión documentada por parte de profesionales. Estándares como OWASP APTS y CREST subrayan que los auditores de cumplimiento evalúan la calidad, el alcance y la reproducibilidad de las evidencias, y no si el payload inicial lo envió un agente de IA o un consultor manual.
¿Cómo evitan las plataformas de pentesting autónomo la interrupción del servicio en producción?
Las plataformas autónomas empresariales aplican límites de seguridad fuera del modelo LLM. Estos controles incluyen límites estrictos de frecuencia, listas de acciones permitidas, comandos destructivos restringidos y límites de alcance rigurosos para garantizar que los escaneos no degraden los servicios de producción.
Fuentes
- OWASP Autonomous Penetration Testing Standard
- OWASP Web Security Testing Guide: API Reconnaissance
- Synack: What is Penetration Testing as a Service (PTaaS)?
- CREST: AI in Penetration Testing
- AutoPenBench: A Vulnerability Testing Benchmark for Generative Agents
- NIST SP 800-115: Technical Guide to Information Security Testing and Assessment