Ostorlab、Webセキュリティスキャンを機能群に追加
Ostorlabは、脆弱性の発見に対する新たなアプローチを備えたWebセキュリティスキャナーを、その機能群に追加します。
お知らせ
Ostorlabは、新しいWebセキュリティスキャナーを機能群に追加することを誇りを持ってお知らせします。この新しいスキャナーは、過去に特定された脆弱性を活用して類似の脆弱性を発見する、脆弱性発見への新たなアプローチを実装しています。
Ostorlab Web Security Scannerは、ほとんどの組織が直面している痛みの種に対処するために作られました。相互運用性のない複数のツールを使い分けてモバイルアプリケーションとWebアプリケーションをテストすることは、開発者とセキュリティチームにとってあまりに手間がかかります。
両方のプラットフォームをカバーする単一のツールを提供することで、導入のハードルを下げることを目指します。同時に、新しい検出アプローチの目標は、自動化された脆弱性発見を抜本的に向上させ、願わくは手動テストの能力を超えていくことにあります。
現在のリリースはまだアルファ版です。試してみたい方は、hereからメッセージをお寄せください。
課題
Ostorlab Web Security Scannerは脆弱性発見への新たなアプローチを備えていますが、その仕組みを掘り下げる前に、まず現在の脆弱性スキャナーが抱える問題を明確にしておきましょう。
ほとんどのセキュリティ専門家は、SQLMapがおそらく利用可能な最良のSQLインジェクション検出ツールであることに同意するでしょう。これは主に、その非常に豊富なペイロードのデータベースと、膨大な数のインジェクションコンテキストへの対応によるものです。たとえば、シングルクォートを用いたWHERE句でのインジェクション、ダブルクォートを用いたWHERE句、ORDER BYコンテキスト、HAVINGコンテキスト、SORTコンテキスト、MySQLコンテキスト、Postgresコンテキスト、Oracleコンテキストなど、挙げればきりがありません。これらのインジェクションコンテキストにはそれぞれ専用のペイロードが必要です。
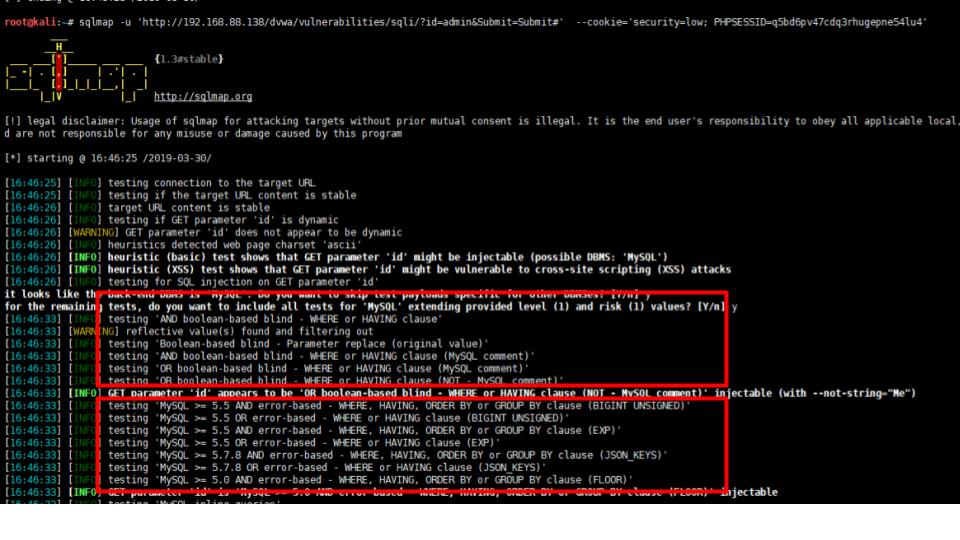
SQLMapが単一のパラメーターをこれらすべてのコンテキストでテストするには、完了まで数分かかります……たった一つのパラメーターにです。
単一のリクエストには、URL、パス、引数、ヘッダー、クッキーの値、ボディのパラメーターから、数十、場合によっては数百ものインジェクションポイントが存在し得ます。しかもこれは、debugやtraceのような隠しパラメーターを探す前の話です。
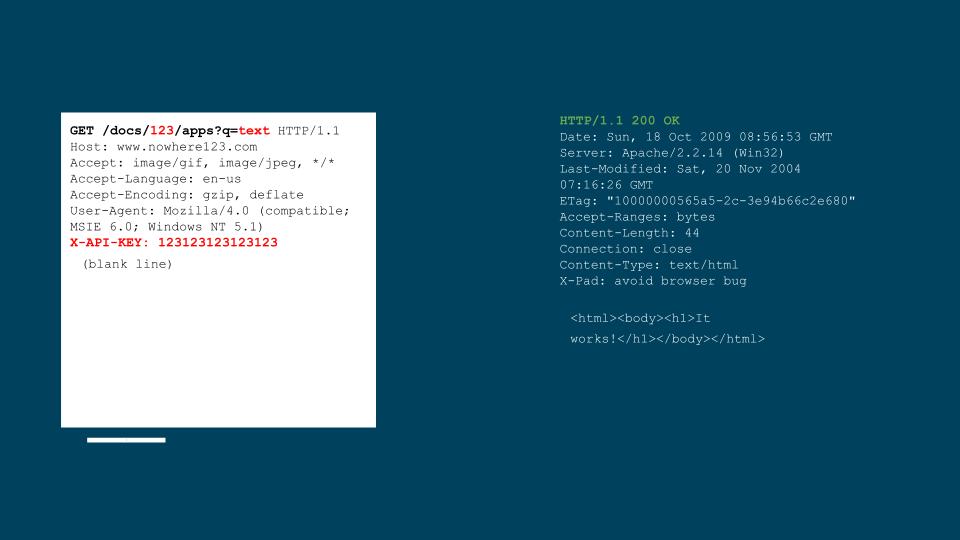
あらゆるページを、あらゆる入力について、あらゆる脆弱性に対して、あらゆるコンテキストをカバーしながらテストするには、数百万件のリクエストが必要となり、完了までに数週間を要します。
ほとんどのスキャナーは、せいぜい数時間以内に終了します。これは、スキャンにタイムアウトを設けたり、カバレッジを制限したりすることで実現しています。ほとんどのスキャナーでは、実際にこれらのパラメーターを調整できます。
この問題は、SQLi、コードインジェクション、テンプレートインジェクションのようなバックエンドの脆弱性に限られるものではなく、クロスサイトスクリプティング(XSS)のようなクライアントサイドの脆弱性にも当てはまります。
XSSもクライアントサイドでさまざまなコンテキストで発生します。aタグ、divタグ、属性、その内容の中で起こり得ますし、サイズの制限や文字数の制限がある場合もあり、特殊なJSONオブジェクトの挿入によって引き起こされることもあれば、さまざまな入力ソースから生じることもあります。
XSSの脆弱性を動的に検出するには、成功するとコールバックをトリガーするペイロードを挿入する必要があります。各コンテキストには、コールバックの実行につながるカスタムのペイロードが必要です。
バックエンドの脆弱性と同様に、各コンテキストを専用のペイロードでテストすると、膨大な数のリクエストが生じ、数週間に及ぶテストが必要になります。
これらの課題に加えて、脆弱性発見の自動化は、ほかにも数多くのハードルに直面します。たとえば、入れ子になったシリアライゼーション(クッキー内のJSONの中のBase64の中のJSON)への対応、過去の実行やほかのスキャンで収集した以前の知識(クロール、パラメーター、国際化、ブルートフォース用の辞書)を活用しないこと、あるいはJavaScriptを多用するWebアプリケーション(SPA)への対応の欠如などです。
当社のアプローチ
ほとんどの脆弱性スキャナーは、解析エンジン群とナレッジベースの2つの部分に分けられます。エンジンの定義はかなり緩やかで、HTTPリクエストを送信するといった最も単純なものから、テイント解析やコンコリック実行といった最も複雑なものまで、さまざまなアクションや変換を実行できます。
ナレッジベースは、解析エンジンが収集したデータを解釈し、脆弱な挙動を報告するために使用されます。強力な検出には、強力なエンジンの両方が必要ですが、何よりも重要なのは豊富なナレッジベースです。
すべての脆弱性スキャナーにおいて、ナレッジベースの構築は複雑で退屈な、そして手作業のプロセスです。しかし、新しい脆弱性が報告され、新しいフレームワーク(Vue.js、Hotwire、Svelteなど)、新しいプログラミング言語(Julia、Scala、Rustなど)、新しいテンプレートエンジン、新しいバックエンドソリューション、新しいクエリ言語が登場するそのスケールは、手作業のアプローチをまったくスケールしないものにしてしまいました。
一部のプロジェクトは、クラウドソーシングを通じて作られたナレッジベースをスケールさせようと試みてきましたが、依然としてまったく解決されていない問題のままです。
自動化された脆弱性発見をスケールさせるには、脆弱性ナレッジベースを構築する自動化された手段が必要です。
バックエンドの脆弱性
この問題に対処する当社のアプローチには、2つの形があります。
1つ目のアプローチは、「スマートなコンポーネント」に影響するバックエンドの脆弱性に対処します。たとえば、SQLデータベース、テンプレートエンジン、シェルインタープリター、あるいは任意のオブジェクトのデシリアライザーなどです。
これらのコンポーネントは通常、インジェクションを引き起こす文字列や任意のバイト列を受け付け、アプリケーションの想定される挙動を改変して害を及ぼします。
セキュリティ研究者がこれらの脆弱性クラスをテストする際には、通常、奇妙な挙動を検出するためのごく単純なペイロードのセットから始めます。たとえば、シングルクォート'を1つ追加し、次にシングルクォートを2つ''、次に0で割る、あるいは(1-1)で割る、といった具合です。目的は、500ステータスコードや空のレスポンスのような、予期しない挙動を検出することです。
次にテスターは、より精巧なペイロードを使って、一つまたは複数の脆弱性クラスに絞り込んでいきます。どのペイロードをテストし、どのような結論を導くかを知るうえで、テスターの経験が重要な役割を果たすのは、この段階です。
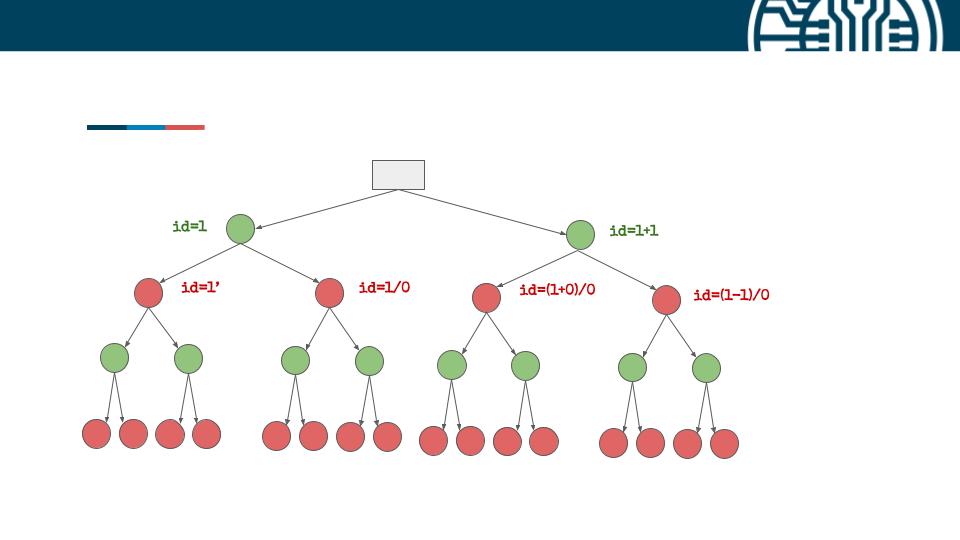
Ostorlabは同じアプローチを再現します。精巧なペイロードを1つ挿入するのではなく、小さなペイロードを連続して挿入し、それらへのレスポンスをもとに、次にどのテストケースを続けるべきかを判断します。これらすべてのペイロードが非常に大きなツリーを構成しており、各ノードで、ステータスコード、ページのサイズ、scriptタグやaタグの数など、レスポンスから特徴量を収集します。
各テストの目的は、ノイズの多い特徴量を除外することです。アプリケーションが脆弱であれば、ある特徴量のセットが、特定の脆弱性クラスのコンテキストに固有の変化を示します。
ただし、これらのテスティングツリーを書くことは、フル機能のペイロードを作り上げるよりもはるかに難しい作業です。過去のテストケースを踏まえて推論し、誤検知がどのように生じ得るかを予測する必要があるからです。
しかし、この作業を自動化することは可能です。必要なのは、脆弱なアプリケーションと脆弱でないアプリケーションを大量に用意し、脆弱なものにはその脆弱性クラスをタグ付けし、すべてのテストケースに対して数十万件のペイロードを実行し、決定木の生成アルゴリズムに似たアルゴリズムを用いてテスティングツリーを構築することだけです。
その結果得られるのは、数千のノードで構成された圧縮済みのテスティングツリーです。
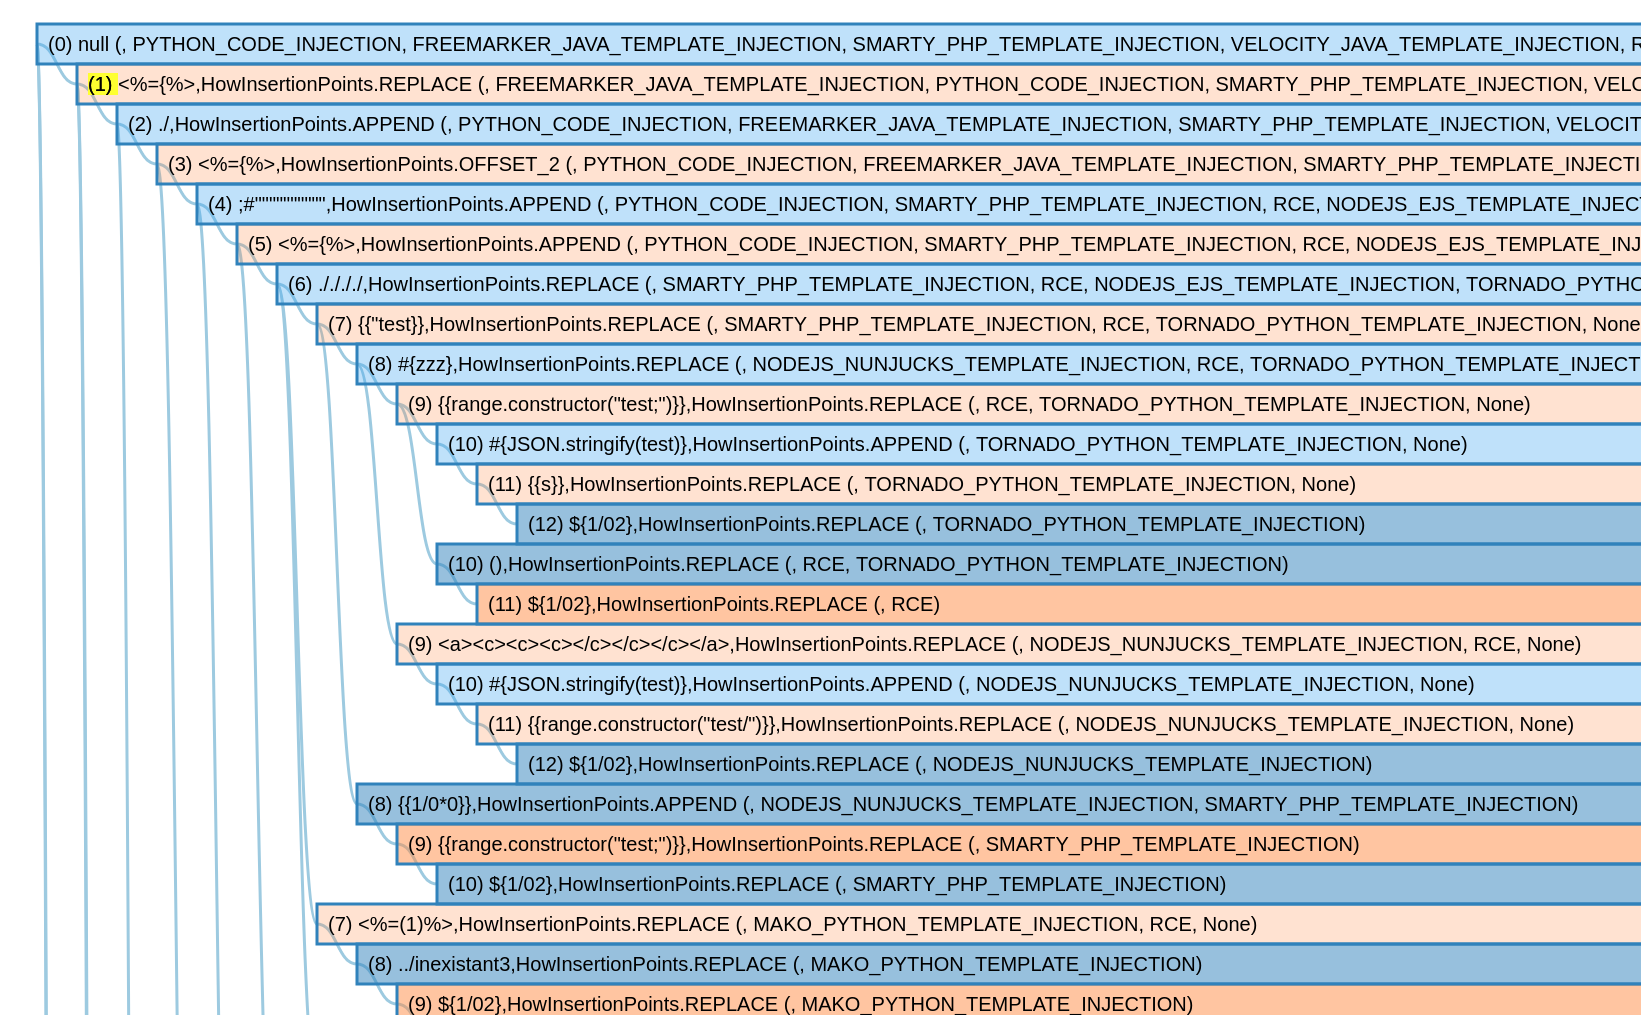
このアプローチの利点は、静的なページのような最も単純なケースでは、あるパラメーターが脆弱でないと判断するために、(数百万件ではなく)数十件のペイロードを送るだけで済むことです。同時に、アプリケーションが脆弱な場合も、テストがツリーの一つの枝へと絞り込まれていくため、脆弱であることを確認するのに数百件のペイロードを送るだけで済みます。
もう一つの利点はカバレッジの向上です。テスティングツリーの性能は当社のテストベッド次第であり、関連するテストケースを追加してツリーを再生成することで、誤検知や検出漏れに対処できます(再生成には依然として数日の計算を要します)。
この組み合わせにより、当社はカバレッジとテストの両面でスケールできます。
XSS
2つ目のアプローチは、最も一般的な脆弱性クラスであるクロスサイトスクリプティング(XSS)に対処します。
OstorlabのXSS検出は、同じ課題に対処しますが、抜本的に異なるアプローチを採るわけではありません。この分野における既存の成果、すなわちポリグロットペイロードを土台にしています。
ポリグロットペイロードとは、できるだけ多くの対象コンテキストを単一のペイロードに詰め込もうとする、手作りの文字列です。このテーマについては、コンテストやテストに使える優れたペイロードのリストとともに、優れた公開資料をオンラインで見つけることができます。
しかし問題は、一部のコンテキストは互いに相容れないため、どうしても複数のペイロードが必要になることです。しかも、XSSを引き起こし得るほぼすべてのテンプレートエンジンは、これらのペイロードではまったくカバーされていません。CordovaやIonicのようなJavaScriptのモバイルフレームワークは独自のコンテキストのリストを持っており、これらのコンテキストを効率的にカバーする公開ペイロードは存在しません。
各コンテキストに対して効率的なポリグロットペイロードを手作りすることは、退屈で複雑な、骨の折れる作業です。
これらの課題に対処するため、Ostorlabは遺伝的アルゴリズムを用いて、高度に最適化された多数のポリグロットペイロードを生成します。その結果得られるペイロードは、スケーラビリティを損なうことなく、それぞれが単一の手作りペイロードよりも多くのインジェクションコンテキストをカバーします。
遺伝的アルゴリズムは、進化的アルゴリズム(EA)というより大きなクラスに属する、自然選択のプロセスに着想を得たものです。遺伝的アルゴリズムは、突然変異、交叉、選択といった生物学に着想を得た演算子を用いることで、最適化問題や探索問題に対する高品質な解を生成するために広く使われています。
遺伝的アルゴリズムは実装が容易で、解が見つかるか、あるいは一定回数の反復を終えると停止する、繰り返し可能なフェーズで構成されています。当社の問題に対する実装は次のようになります。
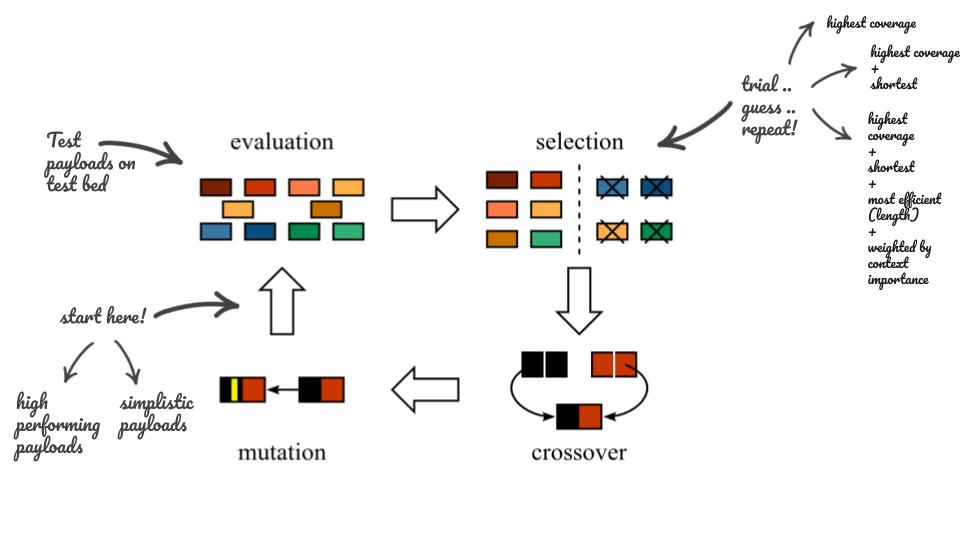
- 第1フェーズ、集団(Population):各反復は集団から始まります。この場合の初期集団は、当社のテストベッド内のあらゆるコンテキストをカバーするペイロードのリストです。単純で小さなペイロードを使う実験もあれば、高性能なペイロードを混ぜて使う実験も行われました。
- 第2フェーズ、評価(Evaluation):このフェーズでは、各ペイロードをテストベッドでテストし、それぞれについてカバーしたテストケースを列挙します。
- 第3フェーズ、選択(Selection):最も性能の高いペイロードを見つける作業です。これは、カバーしたコンテキストの数、ペイロードのサイズ、サイズあたりのコンテキストの重み付き比率など、さまざまな選択基準を用いて行えます。
- 第4フェーズ、突然変異(Mutation)と交叉(Crossover):既存の集団から新しい集団を生成する作業です。これらは、トークンの挿入、文字の反転、切り詰め、部分的な連結など、一連の変換です。
最も性能の高いペイロードを見つけるために、適切な組み合わせ(あるいは、そう呼ぶ人もいるハイパーパラメーター)を見つけるための複数の実験が行われました。たとえば、初期集団に高性能なペイロードを使うと、高性能な解へのカバレッジは速くなりますが、すぐに局所的な最大値で停滞してしまいます。一方、小さなペイロードを使うと収束は遅くなりますが、独自の予期しない解も生み出されます。
その結果得られたペイロードには、ブラウザーのレンダリングエンジンにおける文書化されていない挙動を利用する、いくつかの予期しないパターンが含まれており、XSSフィルターの回避においても有望な結果を示しました。
これから
Ostorlab Scannerは、入れ子になったシリアライゼーションの検出やシングルページアプリケーション(SPA)のクロールといった、ほかの問題にも対処します。これを手がけるチームは、JavaScriptのテイント解析やpostMessage XSSの検出など、新機能の追加に積極的に取り組んでいます。
Ostorlabはまた、過去のスキャンやほかのスキャンから収集したデータを活用して、今後の結果を向上させることにも注力しています。Ostorlabは、スキャンを実行するたびに賢くなろうとしています。
現在のリリースはまだアルファ版です。試してみたい方は、hereからメッセージをお寄せください。
タグ:
web