Ostorlab incorpora el escaneo de seguridad web a su arsenal
Ostorlab incorpora Web Security Scanner a su arsenal, con enfoques novedosos para el descubrimiento de vulnerabilidades.
Anuncio
Ostorlab se complace en anunciar la incorporación de un nuevo escáner de seguridad web a su arsenal. El nuevo escáner implementa nuevos enfoques para el descubrimiento de vulnerabilidades que aprovechan vulnerabilidades identificadas previamente para descubrir otras similares.
Ostorlab Web Security Scanner se creó para resolver un problema que afecta a la mayoría de las organizaciones: manejar varias herramientas sin interoperabilidad para probar aplicaciones móviles y web supone demasiada molestia para los desarrolladores y los equipos de seguridad.
Al ofrecer una única herramienta que cubre ambas plataformas, buscamos reducir la barrera de adopción. Al mismo tiempo, el objetivo de los nuevos enfoques de detección es mejorar radicalmente el descubrimiento automatizado de vulnerabilidades y, con suerte, ir más allá de las capacidades de las pruebas manuales.
La versión actual todavía está en fase alfa; quien esté interesado en probarla puede escribirnos here.
El problema
Ostorlab Web Security Scanner incorpora enfoques novedosos para el descubrimiento de vulnerabilidades, pero antes de explicar cómo funciona, aclaremos primero los problemas de los escáneres de vulnerabilidades actuales.
La mayoría de los profesionales de la seguridad coincidirá en que SQLMap es probablemente la mejor herramienta disponible para detectar inyecciones SQL.
Esto se debe en gran medida a su riquísima base de datos de payloads y a que cubre un enorme conjunto de contextos de inyección,
como la inyección en una cláusula WHERE con comilla simple, en una cláusula WHERE con comilla doble, en contextos ORDER BY, HAVING o SORT,
y en contextos de MySQL, Postgres u Oracle, por mencionar solo algunos. Cada uno de estos contextos de inyección requiere un
payload especializado.
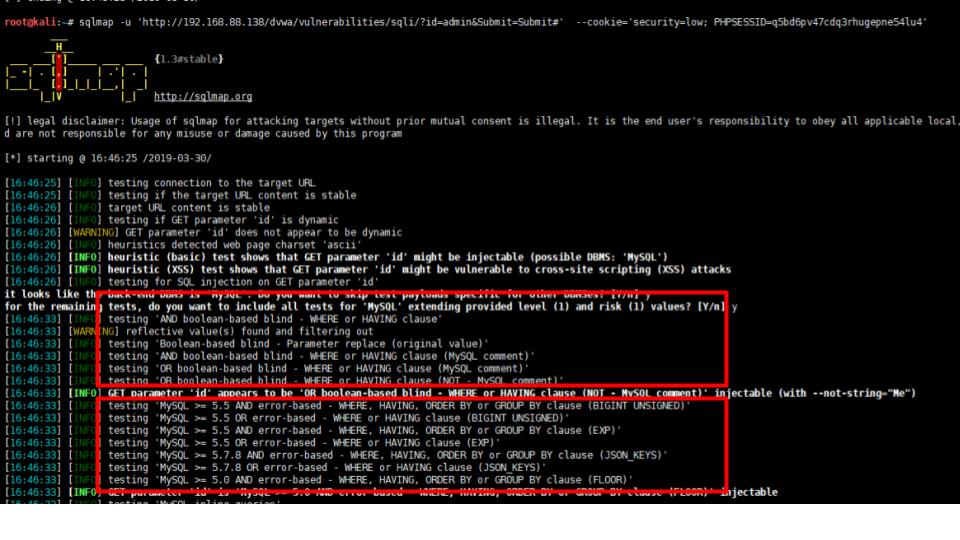
Para que SQLMap pruebe un único parámetro con todos estos contextos, necesita varios minutos... para un solo parámetro.
Una sola solicitud puede tener decenas, si no cientos, de puntos de inyección: la URL, las rutas, los argumentos, las cabeceras,
los valores de las cookies, los parámetros del cuerpo, y ni siquiera estamos buscando parámetros ocultos, como debug o trace.
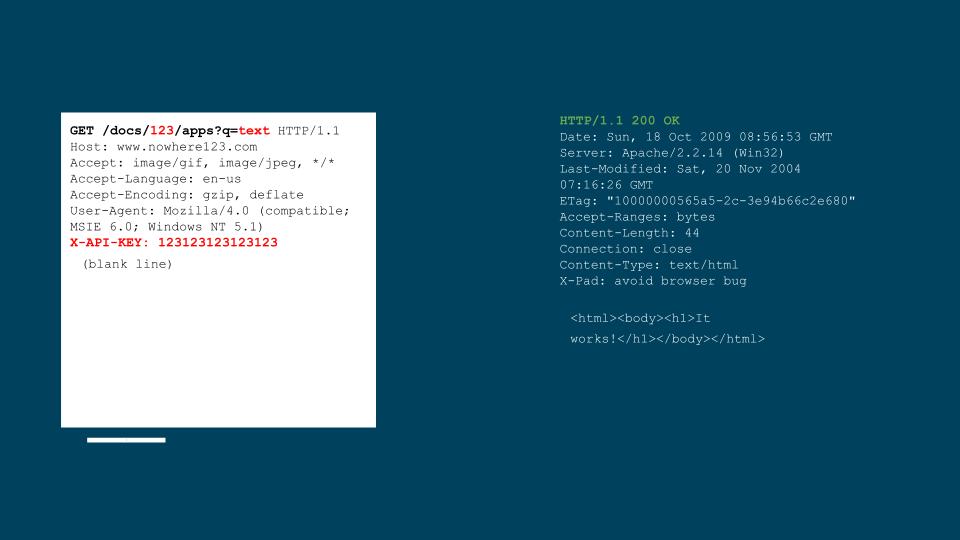
Probar cada página, en cada entrada, para cada vulnerabilidad y cubriendo cada contexto, requiere millones de solicitudes, lo que exige semanas para completarse.
La mayoría de los escáneres terminan en unas pocas horas... como máximo. Lo consiguen limitando el tiempo de la prueba o reduciendo su cobertura. En la mayoría de los escáneres, estos parámetros se pueden ajustar.
Este problema no se limita a las vulnerabilidades de backend, como SQLi, la inyección de código o la inyección de plantillas, sino que también afecta a las vulnerabilidades del lado del cliente, como el Cross Site Scripting (XSS).
Los XSS también se producen en distintos contextos del lado del cliente: pueden aparecer en una etiqueta a, en una etiqueta div, en un atributo, en su
contenido, pueden tener una limitación de tamaño o de caracteres, pueden deberse a la inyección de un objeto JSON especializado y
pueden provenir de diferentes fuentes de entrada.
Detectar vulnerabilidades XSS de forma dinámica requiere inyectar payloads que, cuando tienen éxito, activan una devolución de llamada. Cada contexto requiere un payload a medida que provoque la ejecución de dicha devolución de llamada.
Al igual que con las vulnerabilidades de backend, probar cada contexto con un payload específico genera un gran número de solicitudes que requieren semanas de pruebas.
Además de estos desafíos, la automatización del descubrimiento de vulnerabilidades se enfrenta a MUCHOS otros obstáculos, como la compatibilidad con la serialización anidada (un JSON dentro de un base64 dentro de un JSON dentro de una cookie), el no aprovechar el conocimiento recopilado en ejecuciones anteriores o en otros escaneos (rastreos, parámetros, internacionalización, diccionarios de fuerza bruta), o la falta de compatibilidad con las aplicaciones web con un uso intensivo de JavaScript (SPA).
Nuestro enfoque
La mayoría de los escáneres de vulnerabilidades pueden dividirse en 2 partes: un conjunto de motores de análisis y una base de conocimiento. Los motores tienen una definición bastante laxa y pueden realizar diversas acciones y transformaciones, desde las más simples, como enviar una solicitud HTTP, hasta las más complejas, como el análisis de contaminación (taint analysis) o la ejecución concólica.
La base de conocimiento se utiliza después para interpretar los datos recopilados por los motores de análisis e informar de comportamientos vulnerables. Una detección potente requiere motores potentes, pero sobre todo una base de conocimiento rica.
Construir bases de conocimiento en todos los escáneres de vulnerabilidades es un proceso complejo, tedioso y manual. Sin embargo, la escala a la que se reportan nuevas vulnerabilidades y a la que surgen nuevos frameworks (Vue.js, Hotwire, Svelte...), nuevos lenguajes de programación (Julia, Scala, Rust...), nuevos motores de plantillas, nuevas soluciones de backend y nuevos lenguajes de consulta ha hecho que el enfoque manual no sea escalable EN ABSOLUTO.
Aunque algunos proyectos han intentado escalar la creación de bases de conocimiento mediante el crowdsourcing, sigue siendo un problema en gran medida sin resolver.
Para que el descubrimiento automatizado de vulnerabilidades sea escalable, necesitamos una forma automatizada de construir bases de conocimiento de vulnerabilidades.
Vulnerabilidades de backend
Nuestro enfoque para abordar este problema tiene dos vertientes.
La primera aborda las vulnerabilidades de backend que afectan a «componentes inteligentes», por ejemplo una base de datos SQL, un motor de plantillas, un intérprete de shell o incluso un deserializador de objetos arbitrarios.
Estos componentes suelen aceptar una cadena o bytes arbitrarios que dan lugar a una inyección, alterando el comportamiento esperado de la aplicación para causar daño.
Cuando un investigador de seguridad prueba estas clases de vulnerabilidades, suele empezar con un conjunto muy sencillo de payloads para detectar
comportamientos extraños, como añadir una comilla simple ', luego dos comillas simples '', y después dividir entre 0 o entre (1-1). El objetivo es detectar
cualquier comportamiento inesperado, como un código de estado 500 o una respuesta vacía.
A continuación, el evaluador utiliza payloads más elaborados para acotar una o varias clases de vulnerabilidades, y es en esta etapa cuando la experiencia del evaluador desempeña un papel importante para saber qué payloads probar y qué conclusiones extraer.
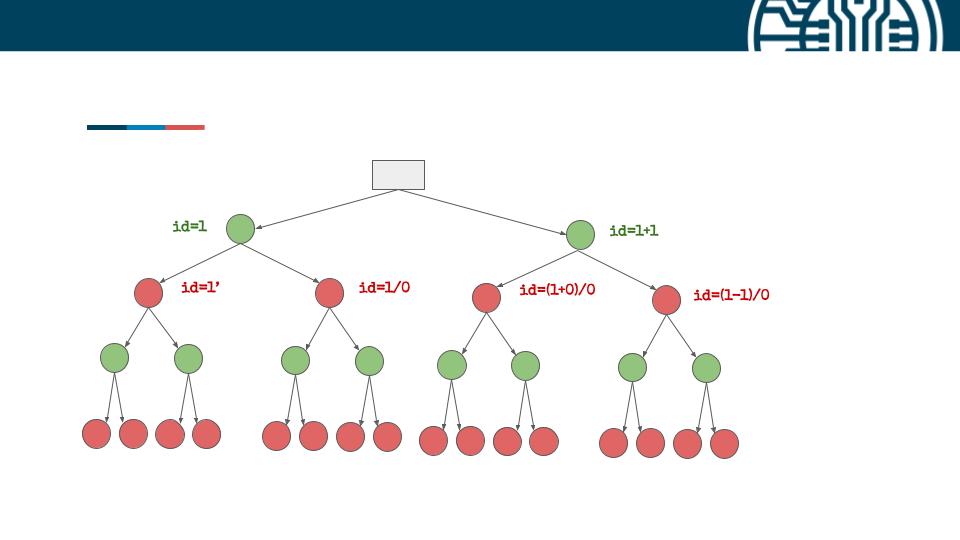
Ostorlab reproduce el mismo enfoque: en lugar de inyectar un único payload elaborado, inyectamos una serie de pequeños
payloads, y las respuestas a estos payloads se utilizan para decidir qué casos de prueba deben seguir. Todos estos payloads
componen un árbol muy grande; en cada nodo recopilamos características de la respuesta, como el código de estado, el tamaño de
la página, el número de etiquetas script o a, etc.
El objetivo de cada prueba es filtrar las características ruidosas y, si la aplicación es vulnerable, un conjunto de características mostrará una variación exclusiva del contexto de una clase de vulnerabilidad.
Sin embargo, escribir estos árboles de pruebas es una tarea mucho más difícil que elaborar un payload completo, ya que hay que razonar a partir de los casos de prueba anteriores y anticipar cómo pueden surgir falsos positivos.
No obstante, automatizar esta tarea es posible: basta con crear un gran conjunto de aplicaciones vulnerables y no vulnerables, etiquetar las vulnerables con su clase de vulnerabilidad, ejecutar cientos de miles de payloads en todos los casos de prueba y construir el árbol de pruebas con algoritmos similares a los de generación de árboles de decisión.
El resultado es un árbol de pruebas comprimido compuesto por miles de nodos:
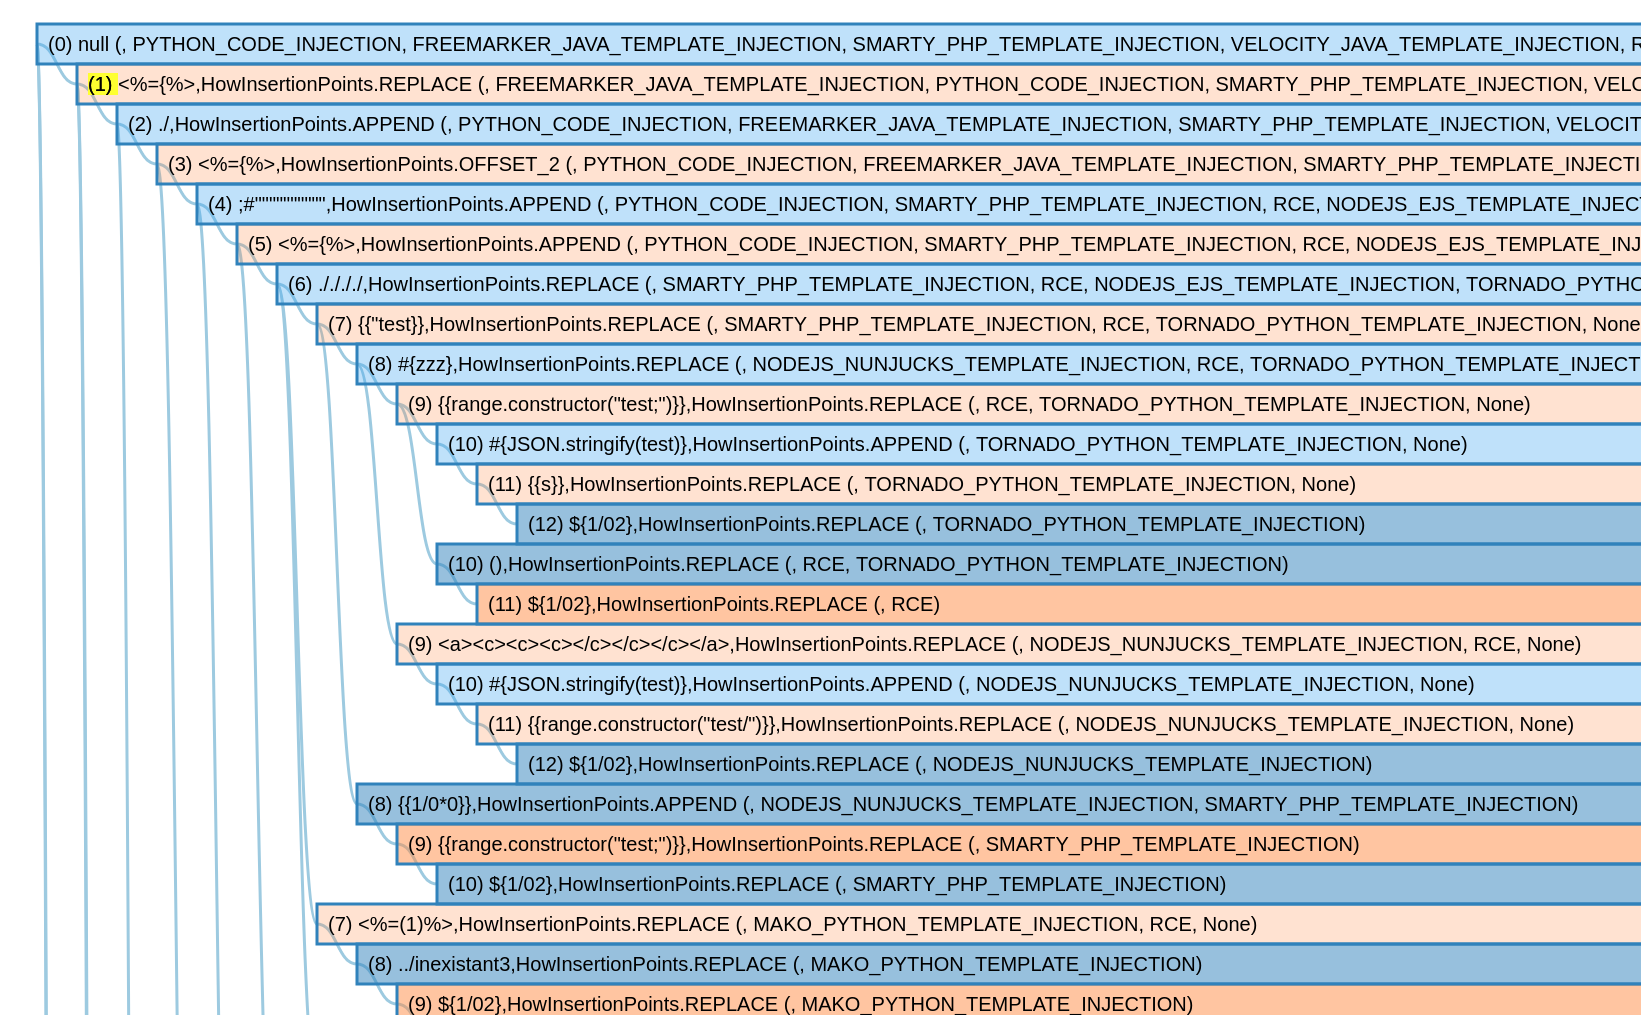
La ventaja de este enfoque es que, en el caso más sencillo, como una página estática, solo necesitamos enviar decenas de payloads (frente a millones) para descartar que un parámetro sea vulnerable. Al mismo tiempo, si la aplicación es vulnerable, solo necesitamos enviar cientos de payloads para confirmarlo, ya que la prueba se irá acotando hacia una rama del árbol.
La otra ventaja es la mayor cobertura: el árbol de pruebas es tan bueno como nuestro banco de pruebas, y los falsos positivos y los falsos negativos pueden corregirse añadiendo el caso de prueba pertinente y regenerando el árbol, lo que aún tarda días en calcularse.
Esta combinación nos permite escalar tanto en cobertura como en pruebas.
XSS
El 2.º enfoque afecta a la clase de vulnerabilidades más común, el Cross Site Scripting (XSS).
La detección de XSS de Ostorlab aborda el mismo desafío, pero no incorpora un enfoque radicalmente distinto. Se apoya en el trabajo existente en este campo, que son los payloads políglotas.
Los payloads políglotas son cadenas elaboradas a mano que intentan comprimir en un único payload la mayor cantidad posible de contextos de destino. En línea se pueden encontrar excelentes publicaciones sobre el tema, con competiciones y una lista de buenos payloads para las pruebas.
Sin embargo, el problema es que algunos contextos son incompatibles, por lo que se necesita más de uno, y casi todos los motores de plantillas que pueden introducir un XSS nunca quedan cubiertos por estos payloads. Los frameworks móviles de JavaScript, como Cordova e Ionic, tienen su propia lista de contextos y no existen payloads públicos que cubran estos contextos de forma eficiente.
Elaborar a mano payloads políglotas eficientes para cada contexto es un trabajo tedioso, complejo y duro.
Para abordar estos desafíos, Ostorlab crea una multitud de payloads políglotas altamente optimizados mediante algoritmos genéticos. Cada uno de los payloads resultantes cubre más contextos de inyección que un único payload elaborado a mano, sin comprometer la escalabilidad.
Los algoritmos genéticos se inspiran en el proceso de selección natural y pertenecen a la clase más amplia de los algoritmos evolutivos (EA). Los algoritmos genéticos se utilizan habitualmente para generar soluciones de alta calidad a problemas de optimización y búsqueda, apoyándose en operadores de inspiración biológica como la mutación, el cruce y la selección.
Los algoritmos genéticos son sencillos de implementar: se componen de fases repetibles que se detienen al encontrar una solución o tras un número fijo de iteraciones. La implementación para nuestro problema es la siguiente:
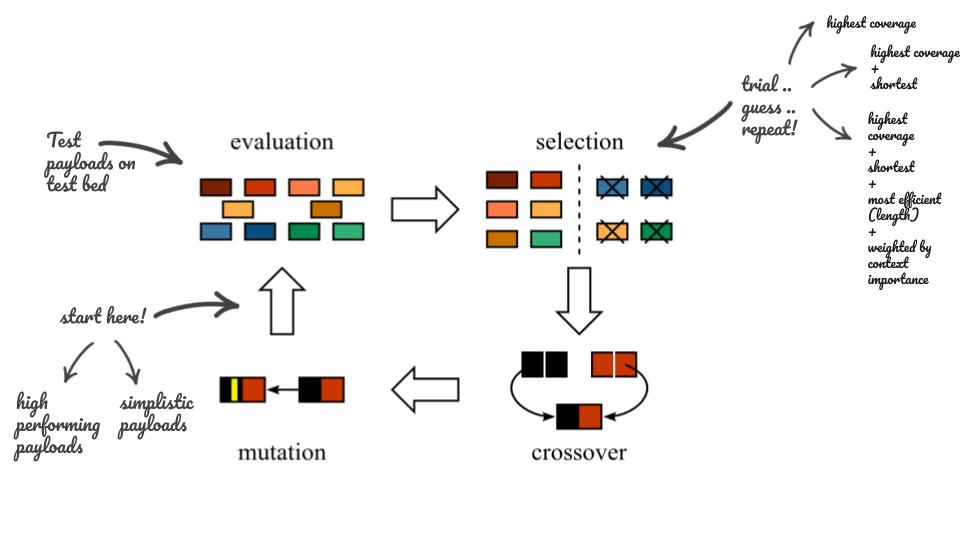
- 1.ª fase, la población: cada iteración comienza con una población. La población inicial, en nuestro caso, es una lista de payloads que cubren todos los contextos de nuestro banco de pruebas. Se realizaron varios experimentos con payloads pequeños y sencillos, y en otros se añadieron a la mezcla payloads de alto rendimiento.
- 2.ª fase, la evaluación: esta fase consiste en probar cada payload en el banco de pruebas y enumerar, para cada uno, los casos de prueba que cubre.
- 3.ª fase, la selección: consiste en encontrar los payloads con mejor rendimiento. Esto puede hacerse con distintos criterios de selección, como el número de contextos cubiertos, el tamaño del payload, la proporción ponderada de contextos por tamaño, etc.
- 4.ª fase, la mutación y el cruce: consiste en generar una nueva población a partir de las existentes. Se trata de un conjunto de transformaciones como la inyección de tokens, la inversión de caracteres, el truncamiento, la concatenación parcial, etc.
Para encontrar los payloads con mejor rendimiento, se realizaron varios experimentos para dar con la mezcla adecuada (o los hiperparámetros, como a algunos les gusta llamarlos). Por ejemplo, usar payloads de alto rendimiento en la población inicial da lugar a una cobertura rápida de soluciones de alto rendimiento, pero se estanca enseguida en un máximo local. En cambio, usar payloads pequeños conduce a una convergencia lenta, pero también crea soluciones únicas e inesperadas.
Los payloads resultantes contenían algunos patrones inesperados que aprovechan comportamientos no documentados de los motores de renderizado de los navegadores y también mostraron resultados prometedores al eludir filtros XSS.
Futuro
Ostorlab Scanner aborda otros problemas, como la detección de serialización anidada y el rastreo de aplicaciones de una sola página (SPA). El equipo que lo desarrolla trabaja activamente en añadir nuevas funcionalidades, como el análisis de contaminación (taint analysis) de JavaScript y la detección de XSS mediante postMessage.
Ostorlab también se centra en aprovechar los datos recopilados en escaneos anteriores y en otros escaneos para mejorar los resultados futuros. Ostorlab intenta volverse más inteligente con cada escaneo que ejecuta.
La versión actual todavía está en fase alfa; quien esté interesado en probarla puede escribirnos here.
Etiquetas:
web