Ostorlab ajoute l'analyse de sécurité web à son arsenal
Ostorlab ajoute un scanner de sécurité web à son arsenal, avec des approches inédites pour la découverte de vulnérabilités.
Annonce
Ostorlab est fier d'annoncer l'ajout d'un nouveau scanner de sécurité web à son arsenal. Ce nouveau scanner met en œuvre de nouvelles approches de la découverte de vulnérabilités, qui s'appuient sur des vulnérabilités déjà identifiées pour en découvrir de similaires.
Ostorlab Web Security Scanner a été créé pour répondre à un problème que rencontrent la plupart des organisations : jongler entre plusieurs outils sans interopérabilité pour tester les applications mobiles et web est une charge trop lourde pour les développeurs et les équipes sécurité.
En proposant un outil unique pour couvrir les deux plateformes, nous visons à abaisser la barrière à l'adoption. En même temps, les nouvelles approches de détection ont pour objectif d'améliorer radicalement la découverte automatisée de vulnérabilités et, nous l'espérons, de dépasser les capacités des tests manuels.
La version actuelle est encore en alpha ; toute personne souhaitant l'essayer peut nous écrire via here.
Le problème
Ostorlab Web Security Scanner repose sur des approches inédites de la découverte de vulnérabilités, mais avant de détailler son fonctionnement, commençons par clarifier les problèmes des scanners de vulnérabilités actuels.
La plupart des professionnels de la sécurité vous diront que SQLMap est probablement le meilleur outil de détection d'injections SQL
disponible. Cela tient en grande partie à sa très riche base de payloads et à sa couverture d'un très grand nombre de contextes d'injection,
comme l'injection dans une clause WHERE avec une apostrophe, une clause WHERE avec des guillemets doubles, les contextes ORDER BY, HAVING, SORT,
les contextes MySQL, Postgres, Oracle, et ainsi de suite. Chacun de ces contextes d'injection nécessite un payload
spécialisé.
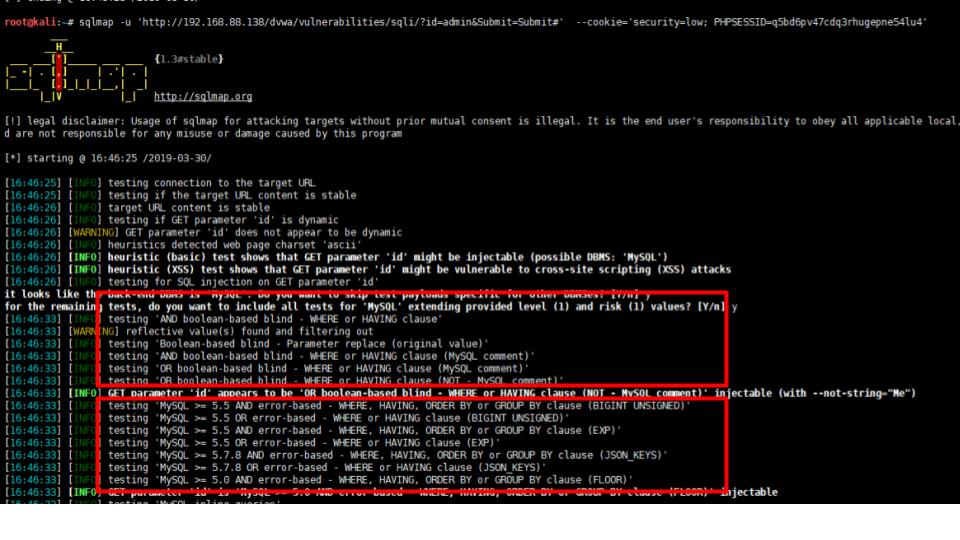
Pour que SQLMap teste un seul paramètre avec tous ces contextes, il faut quelques minutes ... pour un seul paramètre.
Une seule requête peut comporter des dizaines, voire des centaines de points d'injection : l'URL, les chemins, les arguments, les en-têtes,
les valeurs de cookies, les paramètres du corps, et nous ne cherchons même pas les paramètres cachés, comme debug ou trace.
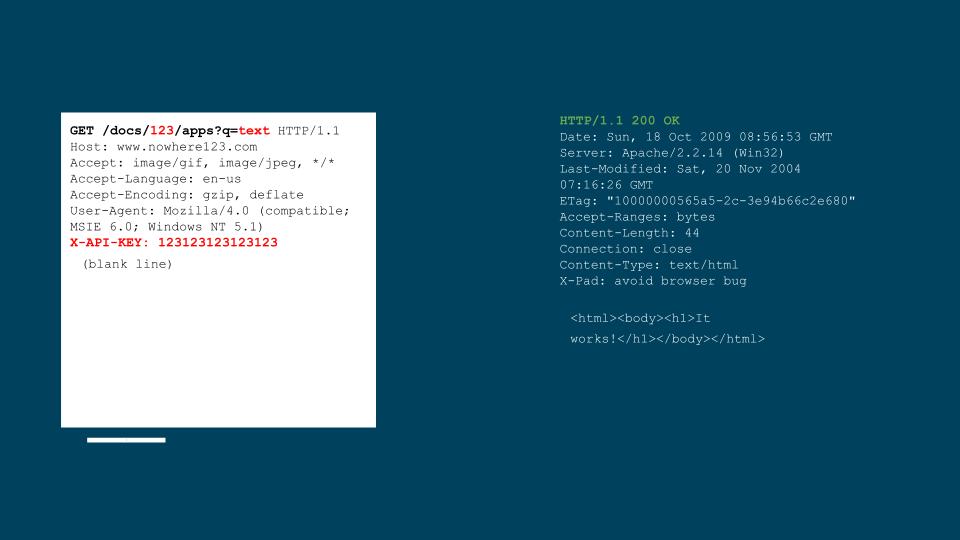
Tester chaque page, chaque entrée, pour chaque vulnérabilité, en couvrant chaque contexte, nécessite des millions de requêtes, soit des semaines de travail.
La plupart des scanners terminent en quelques heures ... au maximum. Ils y parviennent en limitant la durée du scan ou en restreignant leur couverture. Dans la plupart des scanners, ces paramètres sont d'ailleurs ajustables.
Ce problème ne se limite pas aux vulnérabilités côté serveur, comme les SQLi, l'injection de code ou l'injection de template, mais concerne aussi les vulnérabilités côté client, comme le Cross Site Scripting (XSS).
Les XSS surviennent eux aussi dans différents contextes côté client : dans une balise a, une balise div, dans un attribut, dans son
contenu ; ils peuvent être soumis à une limite de taille, à une limite de caractères, être causés par l'injection d'un objet JSON spécialisé et
provenir de différentes sources d'entrée.
Détecter dynamiquement les vulnérabilités XSS nécessite d'injecter des payloads qui, en cas de succès, déclenchent un callback. Chaque contexte exige un payload spécifique qui provoque l'exécution du callback.
Comme pour les vulnérabilités côté serveur, tester chaque contexte avec un payload dédié génère un grand nombre de requêtes, qui demandent des semaines de tests.
Outre ces difficultés, l'automatisation de la découverte de vulnérabilités se heurte à BEAUCOUP d'autres obstacles, comme la prise en charge de la sérialisation imbriquée (un JSON dans du base64 dans un JSON dans un cookie), l'absence de réutilisation des connaissances collectées lors d'exécutions précédentes ou d'autres scans (crawls, paramètres, internationalisation, dictionnaires de force brute), ou le manque de prise en charge des applications web fortement basées sur JavaScript (SPA).
Notre approche
La plupart des scanners de vulnérabilités peuvent se diviser en deux parties : un ensemble de moteurs d'analyse et une base de connaissances. Les moteurs sont définis de façon assez large et peuvent effectuer toutes sortes d'actions et de transformations, des plus simples, comme envoyer une requête HTTP, aux plus complexes, comme l'analyse de taint ou l'exécution concolique.
La base de connaissances sert ensuite à interpréter les données collectées par les moteurs d'analyse et à signaler les comportements vulnérables. Une détection puissante exige à la fois des moteurs puissants et, surtout, une base de connaissances riche.
Construire la base de connaissances de n'importe quel scanner de vulnérabilités est un processus complexe, fastidieux et manuel. Or, l'échelle à laquelle de nouvelles vulnérabilités sont signalées et à laquelle apparaissent de nouveaux frameworks (Vue.js, Hotwire, Svelte ...), de nouveaux langages de programmation (Julia, Scala, Rust ...), de nouveaux moteurs de templates, de nouvelles solutions côté serveur et de nouveaux langages de requête rend l'approche manuelle impossible à passer à l'échelle, ABSOLUMENT PAS viable.
Si certains projets ont tenté de passer à l'échelle une base de connaissances alimentée par la contribution collective, le problème reste largement non résolu.
Pour que la découverte automatisée de vulnérabilités passe à l'échelle, il faut un moyen automatisé de construire des bases de connaissances de vulnérabilités.
Vulnérabilités côté serveur
Notre approche pour répondre à ce problème comporte deux volets.
La première approche traite les vulnérabilités côté serveur qui touchent des « composants intelligents », par exemple une base de données SQL, un moteur de templates, un interpréteur de shell ou même un désérialiseur d'objets arbitraires.
Ces composants acceptent généralement une chaîne de caractères ou des octets arbitraires qui débouchent sur une injection, altérant le comportement attendu de l'application pour causer des dommages.
Lorsqu'un chercheur en sécurité teste ces classes de vulnérabilités, il commence généralement par un ensemble très simple de payloads pour détecter
un comportement étrange : ajouter une apostrophe ', puis deux apostrophes '', puis diviser par 0, ou par (1-1). L'objectif est de détecter
tout comportement inattendu, comme un code de statut 500 ou une réponse vide.
Le testeur utilise ensuite des payloads plus élaborés pour cerner une ou plusieurs classes de vulnérabilités, et c'est à ce stade que l'expérience du testeur joue un rôle important pour savoir quels payloads tester et quelles conclusions en tirer.
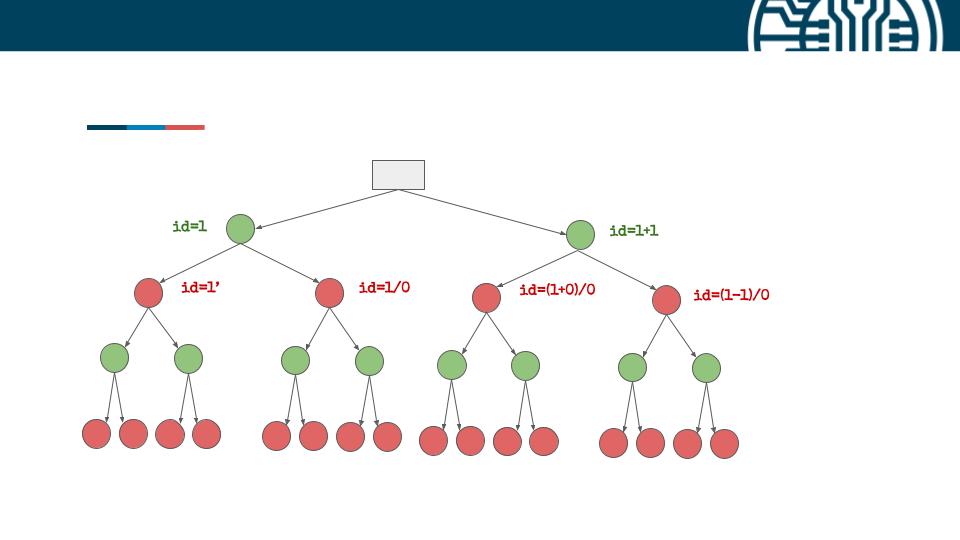
Ostorlab reproduit la même approche : au lieu d'injecter un seul payload élaboré, nous injectons une série de petits
payloads, dont les réponses servent à décider des cas de test suivants. L'ensemble de ces payloads
compose un très grand arbre ; à chaque nœud, nous collectons des caractéristiques de la réponse, comme le code de statut, la taille de
la page, le nombre de balises script ou a, etc.
L'objectif de chaque test est d'écarter les caractéristiques bruyantes ; si l'application est vulnérable, un ensemble de caractéristiques présentera une variation propre au contexte d'une classe de vulnérabilités.
Écrire ces arbres de test est toutefois une tâche bien plus difficile que de forger un payload complet, car il faut raisonner à travers les cas de test précédents et anticiper l'apparition de faux positifs.
Automatiser cette tâche est cependant possible : il suffit de créer un grand ensemble d'applications vulnérables et non vulnérables, d'étiqueter les applications vulnérables avec leur classe de vulnérabilité, d'exécuter des centaines de milliers de payloads sur tous les cas de test et de construire l'arbre de test à l'aide d'algorithmes similaires aux algorithmes de génération d'arbres de décision.
Le résultat est un arbre de test compressé composé de milliers de nœuds :
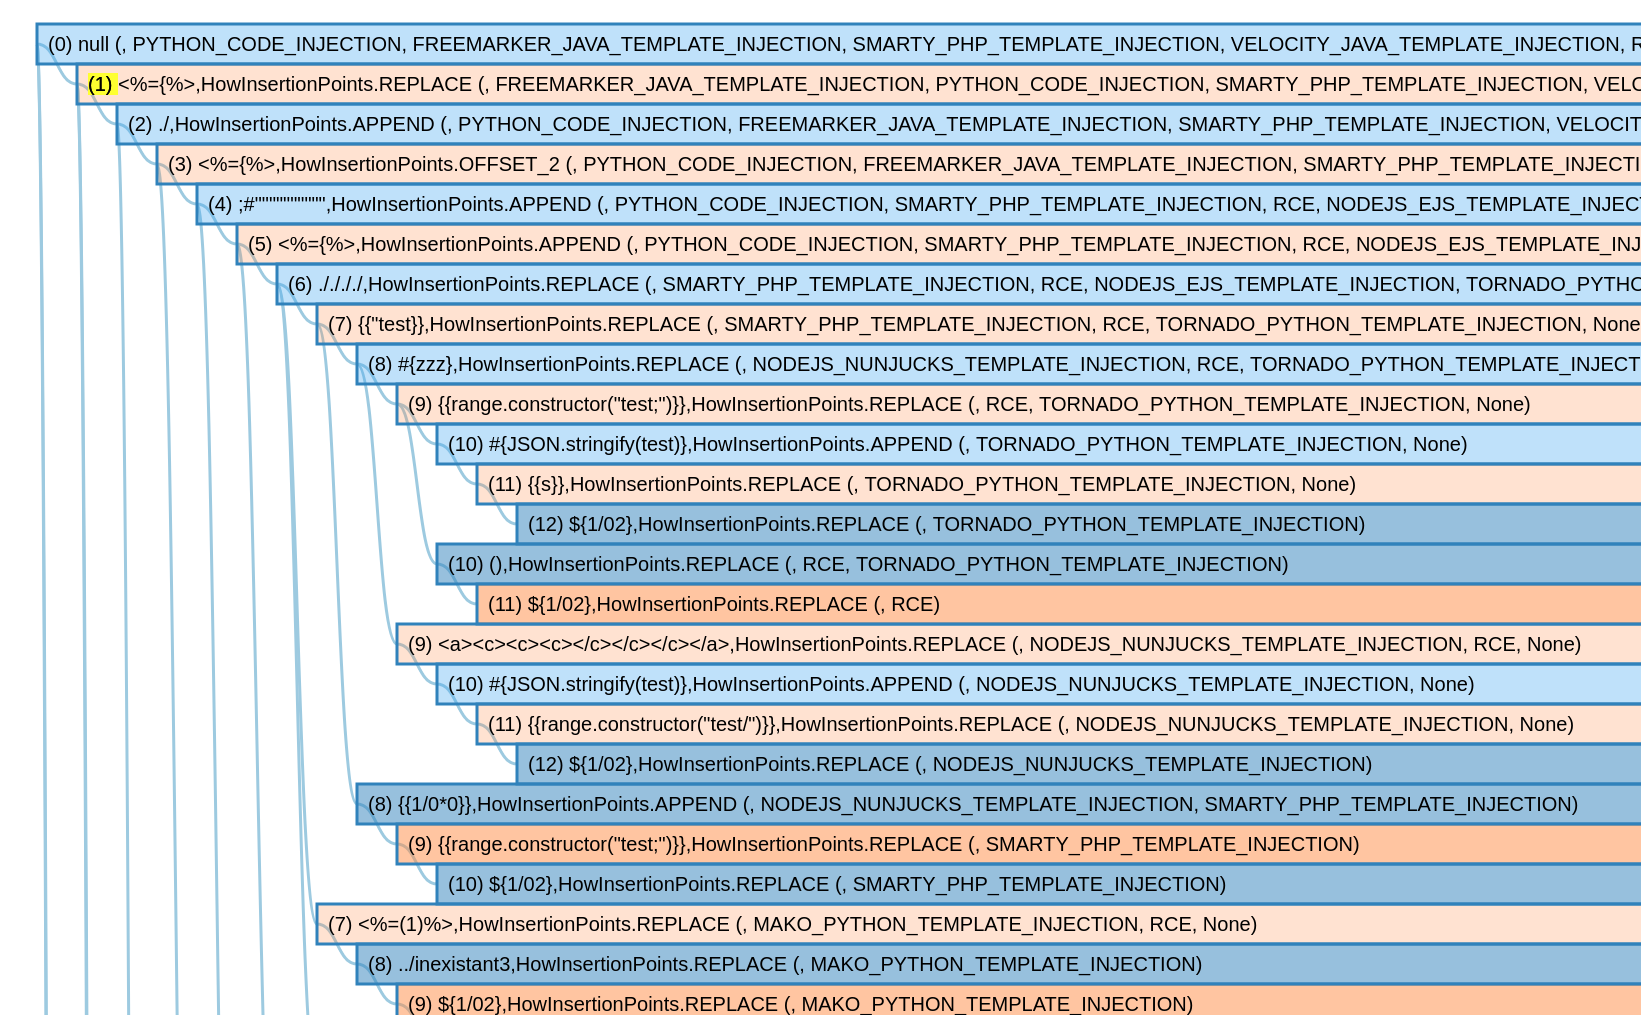
L'avantage de cette approche est que, dans le cas le plus simple, comme une page statique, il suffit d'envoyer des dizaines de payloads (contre des millions) pour exclure qu'un paramètre soit vulnérable. En même temps, si l'application est vulnérable, il suffit d'envoyer des centaines de payloads pour confirmer la vulnérabilité, car le test se resserre sur une branche de l'arbre.
L'autre avantage est l'amélioration de la couverture : l'arbre de test vaut ce que vaut notre banc de test, et les faux positifs et faux négatifs peuvent être corrigés en ajoutant le cas de test pertinent et en régénérant l'arbre, ce qui prend encore des jours de calcul.
Cette combinaison nous permet de passer à l'échelle à la fois en couverture et en tests.
XSS
La seconde approche concerne la classe de vulnérabilités la plus courante, le Cross Site Scripting (XSS).
La détection des XSS par Ostorlab répond au même défi, mais ne repose pas sur une approche radicalement différente. Elle s'appuie sur les travaux existants dans ce domaine, à savoir les payloads polyglottes.
Les payloads polyglottes sont des chaînes de caractères conçues à la main qui tentent de condenser le plus de contextes cibles possible dans un seul payload. On trouve en ligne d'excellentes publications sur le sujet, avec des compétitions et une liste de bons payloads à utiliser pour les tests.
Le problème, cependant, est que certains contextes sont incompatibles : il en faut donc absolument plus d'un, et presque tous les moteurs de templates susceptibles d'introduire un XSS ne sont jamais couverts par ces payloads. Les frameworks mobiles JavaScript comme Cordova et Ionic ont leurs propres listes de contextes, et aucun payload public ne couvre efficacement ces contextes.
Concevoir à la main des payloads polyglottes efficaces pour chaque contexte est un travail fastidieux, complexe et difficile.
Pour relever ces défis, Ostorlab crée une multitude de payloads polyglottes très optimisés à l'aide d'algorithmes génétiques. Les payloads obtenus couvrent chacun plus de contextes d'injection qu'un seul payload conçu à la main, sans compromettre la capacité de passage à l'échelle.
Les algorithmes génétiques s'inspirent du processus de sélection naturelle et appartiennent à la grande classe des algorithmes évolutionnistes (EA). Ils sont couramment utilisés pour générer des solutions de haute qualité à des problèmes d'optimisation et de recherche, en s'appuyant sur des opérateurs d'inspiration biologique tels que la mutation, le croisement et la sélection.
Les algorithmes génétiques sont simples à implémenter : ils se composent de phases répétables qui s'arrêtent soit après avoir trouvé une solution, soit après un nombre fixe d'itérations. L'implémentation pour notre problème se présente comme suit :
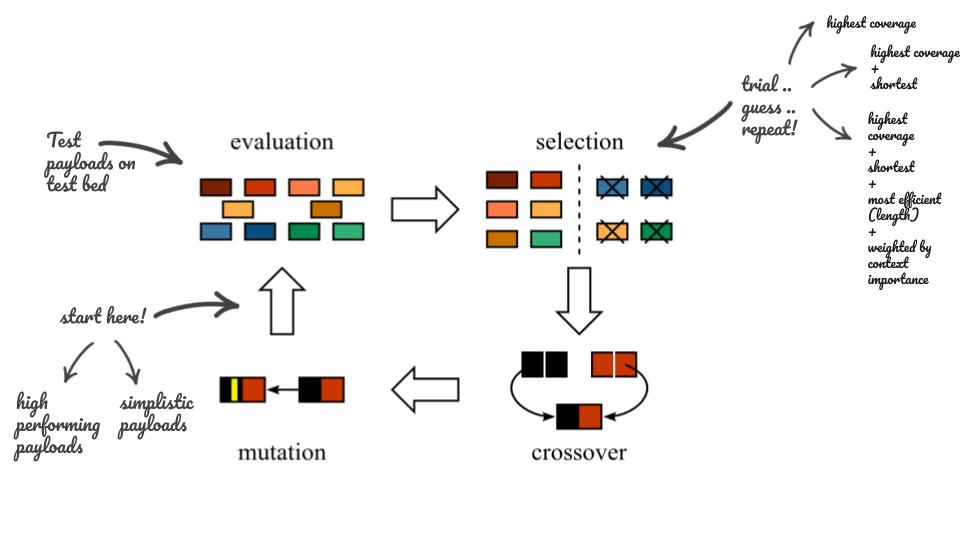
- 1re phase, la population : chaque itération commence par une population. Dans notre cas, la population initiale est une liste de payloads qui couvrent chaque contexte de notre banc de test. Plusieurs expériences ont été menées avec de petits payloads simples, d'autres en ajoutant au mélange des payloads très performants.
- 2e phase, l'évaluation : cette phase consiste à tester chaque payload sur le banc de test et à lister, pour chacun, les cas de test couverts.
- 3e phase, la sélection : elle consiste à trouver les payloads les plus performants. Cela peut se faire selon différents critères de sélection, comme le nombre de contextes couverts, la taille du payload, le ratio pondéré entre contextes et taille, etc.
- 4e phase, la mutation et le croisement : elle consiste à générer une nouvelle population à partir des existantes. Il s'agit d'un ensemble de transformations comme l'injection de tokens, l'inversion de caractères, la troncature, la concaténation partielle, etc.
Pour trouver les payloads les plus performants, plusieurs expériences ont été menées afin de trouver le bon dosage (ou les hyperparamètres, comme certains aiment les appeler). Par exemple, utiliser des payloads très performants dans la population initiale donne rapidement une bonne couverture avec des solutions performantes, mais stagne vite sur un maximum local. Utiliser de petits payloads donne en revanche une convergence lente, mais crée aussi des solutions uniques et inattendues.
Les payloads obtenus contenaient des motifs inattendus qui exploitent des comportements non documentés des moteurs de rendu des navigateurs et ont aussi montré des résultats prometteurs pour contourner les filtres XSS.
Perspectives
Ostorlab Scanner traite d'autres problèmes, comme la détection de la sérialisation imbriquée et le crawling des applications monopages (SPA). L'équipe qui le développe travaille activement à l'ajout de nouvelles fonctionnalités, comme l'analyse de taint JavaScript et la détection des XSS via postMessage.
Ostorlab met aussi l'accent sur l'exploitation des données collectées lors de scans précédents et d'autres scans pour améliorer les résultats futurs. Ostorlab cherche à devenir plus intelligent à chaque scan.
La version actuelle est encore en alpha ; toute personne souhaitant l'essayer peut nous écrire via here.
Tags :
web