誤検知の真のコスト:ノイズの多いスキャナーが課すエンジニアリング税を計算する
誤検知は、スキャナーの品質だけの問題ではなく、エンジニアリングのキャパシティの問題です。そのコストを計測し、実証エクスプロイトテストのROIを評価する方法を学びましょう。
1件の誤検知は、エンジニアリングチームに30ドル、300ドル、あるいは3,000ドルのコストをもたらすことがあります。
人件費込みで時給90ドルの場合、20分で片付ければ30ドルのコストです。後述する300ドルのシナリオは、時給120ドルの開発者が2.5時間を要することを前提としています。時給180ドルのシニア開発者と時給195ドルのAppSecレビュー担当者が、それぞれ8時間かけて再構成する場合、3,000ドル(8 ×(180ドル + 195ドル))のコストになります。
同じスキャナーでも、誰がそのアラートに触れ、どれだけのコンテキストを再構成しなければならないかによって、まったく異なるコストを生み出すことがあります。
だからこそ、「当社のスキャナーは誤検知が少ない」ということだけでは、ビジネス上の妥当性の根拠になりません。有用な問いはこうです。
チームが自信を持って、それを修正するか、先送りするか、クローズするかを判断できるようになるまでに、1件のアラートはどれだけのエンジニアリング時間を消費するのか。
ノイズの多いセキュリティプログラムでは、その時間がエンジニアリング税になります。その税は、中断された機能開発、AppSecの調査、Slackのスレッド、重複したチケット、そして次のアラートへの信頼の喪失という形で支払われます。
誤検知はエンジニアリングチームにどれだけのコストをもたらすか
誤検知は、人間のワークフローに到達する、対応不要なアラート(ここでは修復タスクを伴わずにクローズされたアラートと定義します)のすべてについて、その人件費込みのコストをエンジニアリングチームに負わせます。後述の計算例では、開発者の時間だけで1件あたり300ドルになります。
次のモデルを使ってください。
Annual noise cost =
non-actionable alerts that reach humans
× average labor cost per alert
× number of periods per year (12 when the alert count is monthly)
個々のアラートについては、次のとおりです。
Labor cost per alert =
((developer investigation time + context-recovery time) × loaded developer hourly cost)
+ (security-review time × loaded security hourly cost)
+ other coordination costs not already included above
給与だけでなく、人件費込みのコストを使ってください。雇用主が負担する税金、福利厚生、機器、管理、間接費のすべてが重要です。
実際に人間のワークフローに到達するアラートだけを数えてください。自動的に抑制されるアラートは、同じ限界コストをもたらしません。
計算例:なぜ1件の誤報が300ドルを超えうるのか
ある開発者が次の時間を費やすと仮定します。
- コードパス、アプリケーションの挙動、または設定の確認に90分
- チケットの読み込みとAppSecとの調整に15分
- 中断された開発のコンテキストの再構成に45分
これは開発者の時間として2.5時間です。人件費込みで時給120ドルの場合、次のようになります。
2.5 hours × $120/hour = $300 per non-actionable alert
これは一つのシナリオであり、業界平均ではありません。時給やワークフローが異なるチームは、自社の数値を当てはめるべきです。
これを、ささやかな件数に適用してみましょう。
| 前提 | 値 |
|---|---|
| 毎月開発者に振り分けられるアラート | 120 |
| 後に対応不要としてクローズされる割合 | 25% |
| 対応不要なアラート1件あたりの開発者の工数 | 2.5時間 |
| 人件費込みの開発者コスト | 120ドル/時間 |
| 月あたりの開発者コスト | 9,000ドル |
| 年あたりの開発者コスト | 108,000ドル |
AppSecエンジニアが、それら毎月30件のアラートそれぞれに、人件費込みで時給100ドルで20分を費やす場合、月あたりさらに1,000ドルが加わります。合わせると、対応不要なアラート1件あたり約333ドル、つまり月あたり10,000ドルになります。モデル上の年あたりの税は、納期の遅延、重複作業、あるいは開発者がキューを無視し始めるリスクを数える前の時点で、120,000ドルになります。
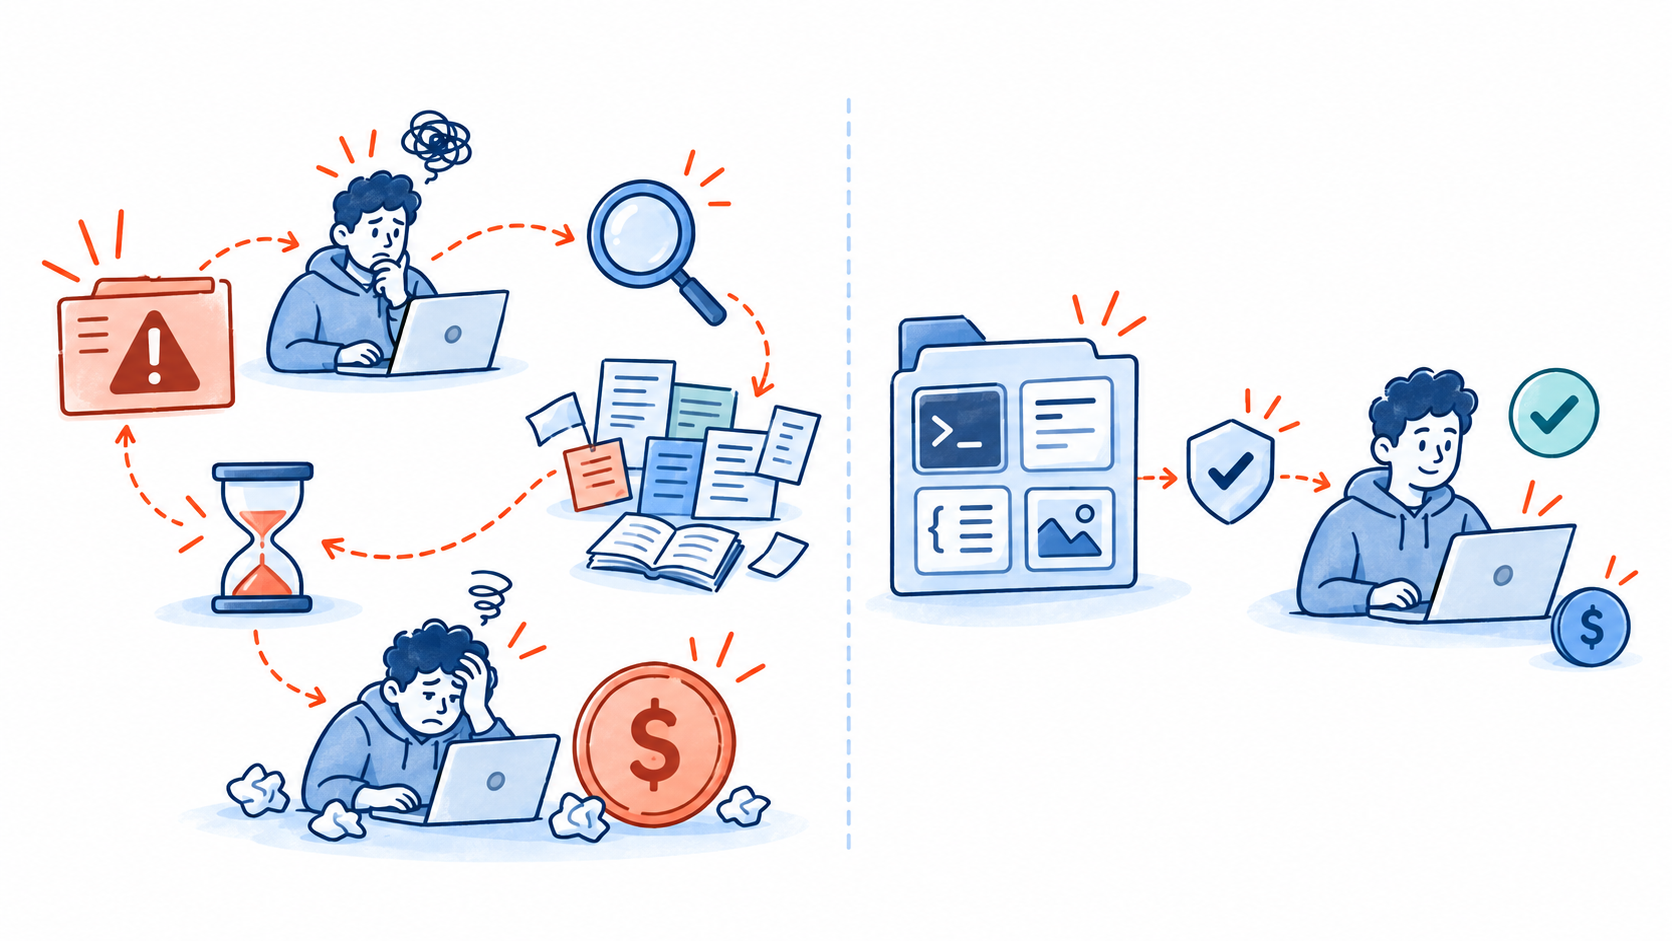
図1:ノイズの多いアラートは繰り返しの調査とコンテキストの再構成を必要とする一方、実証に裏付けられた検出結果はエンジニアに実証を検証して直接対応させる。
なぜ誤検知は、記録されたトリアージ時間よりも多くのコストがかかるのか
チケットに記録される分数は、この税の最も小さな部分にすぎません。隠れたコストは、開発者が行う調査、コンテキストの再構成、そして作業への復帰であり、チケットには決して捉えられないものです。
1件のセキュリティアラートは、開発者に、影響を受けるリリースの特定、意図された認可モデルの再構成、適切なテストデータを用いたリクエストの再現、上流の制御が適用されるかどうかの判定、そしてその結果のセキュリティチームへの説明を要求することがあります。その後、開発者は元の作業に戻らなければなりません。
その再構成の作業は、架空の間接費ではありません。
プログラミング活動の中断後のタスク再開に関する探索的研究で、Chris ParninとSpencer Rugaberは、開発者が再び編集を始める前に、追加のタスクコンテキストを探して移動しなければならないことが一般的であり、記録されたセッションのうち、1分未満でコーディングを再開できたのはごく一部にすぎなかったことを明らかにしました。
ノイズの多いアラートは、開発者が機能開発に戻るときに、同じコンテキスト再構成の負担を生み出すことがあります。この研究はセキュリティアラートによる中断を直接的に定量化していないため、300ドルという数字は、研究の結果ではなく、あくまで説明のためのシナリオにとどまります。ParninとRugaberのタスク再開研究を読む
このコストモデルは厳密な意味での誤検知よりも広いものですが、そのカテゴリーをひとまとめにすべきではありません。誤検知、重複、スコープ外のアラートは、修復作業にならない候補の検出結果です。受容されたリスクと、本物だが到達不可能な弱点は、ガバナンスの判断を要する本物の検出結果であり得ます。
どちらのカテゴリーも時間を消費するため追跡してください。ただし、ガバナンスの作業をスキャナーの誤りとして報告してはなりません。
対応不要なアラートの件数は、計測すべき運用上の数値です。すなわち、修復タスクを伴わずにクローズされたアラートであり、スキャナーの素の誤検知件数と同一視するのではなく、カテゴリー別に報告します。
なぜセキュリティスキャナーは誤検知を生み出すのか
スキャナーがノイズを生み出すのは、候補の検出が、カスタムの制御、実行時の設定、外部コンポーネント、到達可能性、ビジネスロジックについて不完全な情報のもとで動作するからです。それでもスキャナーには価値があります。静的解析は開発の早い段階で潜在的に危険な経路を特定でき、動的テストはソースコードだけでは実証できない挙動を明らかにできます。
しかし、候補の検出は、報告可能な脆弱性と同じではありません。
OWASPも同じ境界を引いています。静的解析ツールは誤検知を生み出すことがあり、特定された問題が実際の脆弱性かどうかを確認するのは、しばしば困難です。OWASPの静的解析ガイダンス
したがって、誤検知率は持ち運び可能なマーケティング統計ではありません。258のオープンソース組み込みプロジェクトに関する現在の拡張レポートでは、CodeQLは34%の誤検知率で709件の真の欠陥を報告しました。それは、一つの環境における問題の規模を示す有用なエビデンスであって、あらゆるスキャナーやコードベースに適用すべき率ではありません。CodeQLの258プロジェクトのレポートを読む
正しい対応は、スキャンをやめることではありません。35の産業プロジェクトに関する研究では、静的解析ツールはチームが欠陥を早期に発見して除去するのを助けるため、総合的には依然として費用対効果が高くなり得ることが分かりました。費用対効果の研究を読む
運用上の目標は、その早期のシグナルを保ちつつ、裏付けのない仮説が開発者のチケットになるのを防ぐことです。
実証エクスプロイトのセキュリティテストとは何か
実証エクスプロイトテストは、候補となる弱点が開発者のチケットになる前に、制御された環境でそれを検証するものです。
実証エクスプロイトテストは、引き継ぎを次の形から、
Possible weakness → developer repeats the investigation → verdict
次の形へと変えます。
Candidate weakness → controlled validation → evidence-backed finding, conditional result, or suppression
エビデンスは、レビュー担当者が4つの問いに素早く答えられるようにすべきです。
- 正確には何がテストされ、どのバージョンまたは環境に対してか。
- どのような条件やテスト用のアイデンティティが必要だったか。
- どのリクエスト、操作、またはコードパスがその挙動を引き起こしたか。
- どのような観測可能な結果が影響を立証するか。そして、その結果が意味のあるものだと示すネガティブコントロールは何か。
抑制を使うのは、検証が同等環境のエビデンスと意味のあるネガティブコントロールを含む場合に限ってください。制約のあるテストで再現できなかったというだけでは、その候補が誤検知であったことを実証したことにはなりません。
WebまたはAPIの検出結果については、それは伏字化したcurlコマンド、対応するHTTPリクエストとレスポンス、そして想定される認可の失敗と観測された結果を対比して示す比較であることがあります。サニタイズされた開発者向けのエビデンスは、プレースホルダーと再現のためのコンテキストを保持すべきです。完全なリクエスト、シークレット、その他の機密性の高いアーティファクトは、アクセス制御されたエビデンス記録に置くべきです。モバイルテストについては、スクリーンショット、実行時ログ、端末のテレメトリ、再実行可能な手順を含むことがあります。
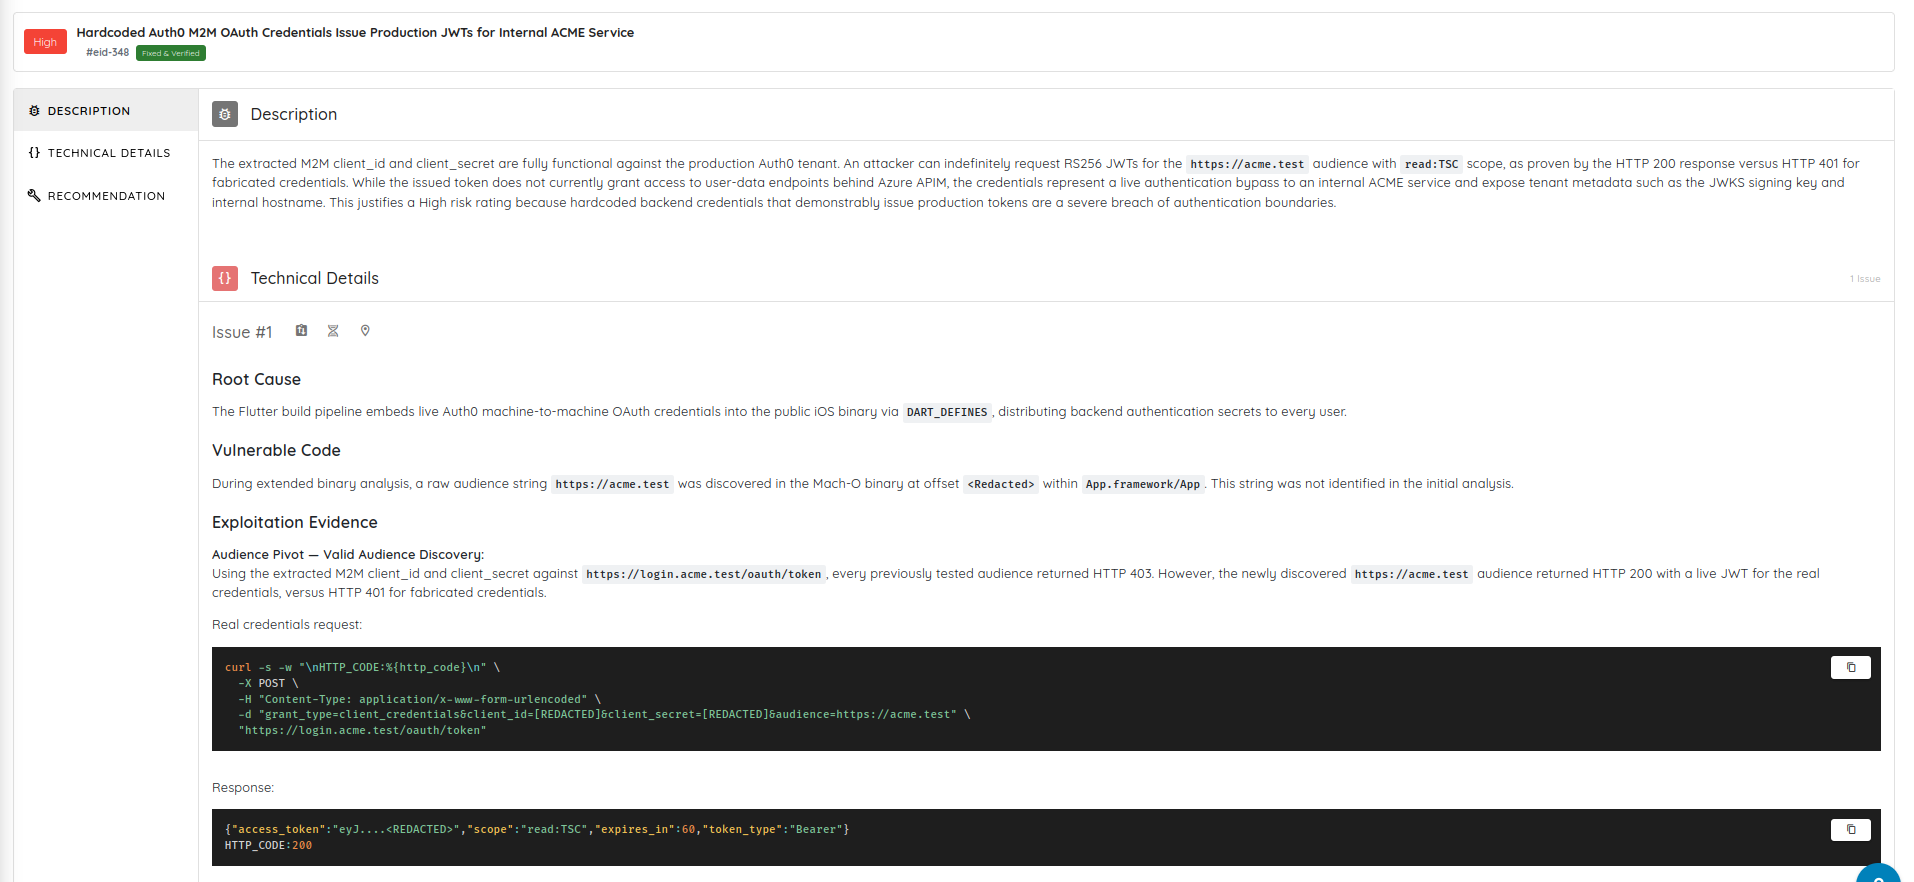
図2:サニタイズされた検出結果は、根本原因を伏字化したリクエストと観測されたレスポンスに結び付けるため、レビュー担当者は最初の調査を再現せずに結果を検証できる。
実証は、実行時のリクエストではなく、コードに根ざしたものであることもあります。下記のRawSpeedのソースコードの検出結果では、Exploitation Evidenceパネルが、幅クラスの分析、最小化されたPoCの条件、そして脆弱なバージョンと修正済みバージョンの検証を検出結果とともに保持しています。レポートにアクセスできるレビュー担当者は、チケットの要約から再構成するのではなく、詳細ビューでその保存されたエビデンスを見直すことができます。
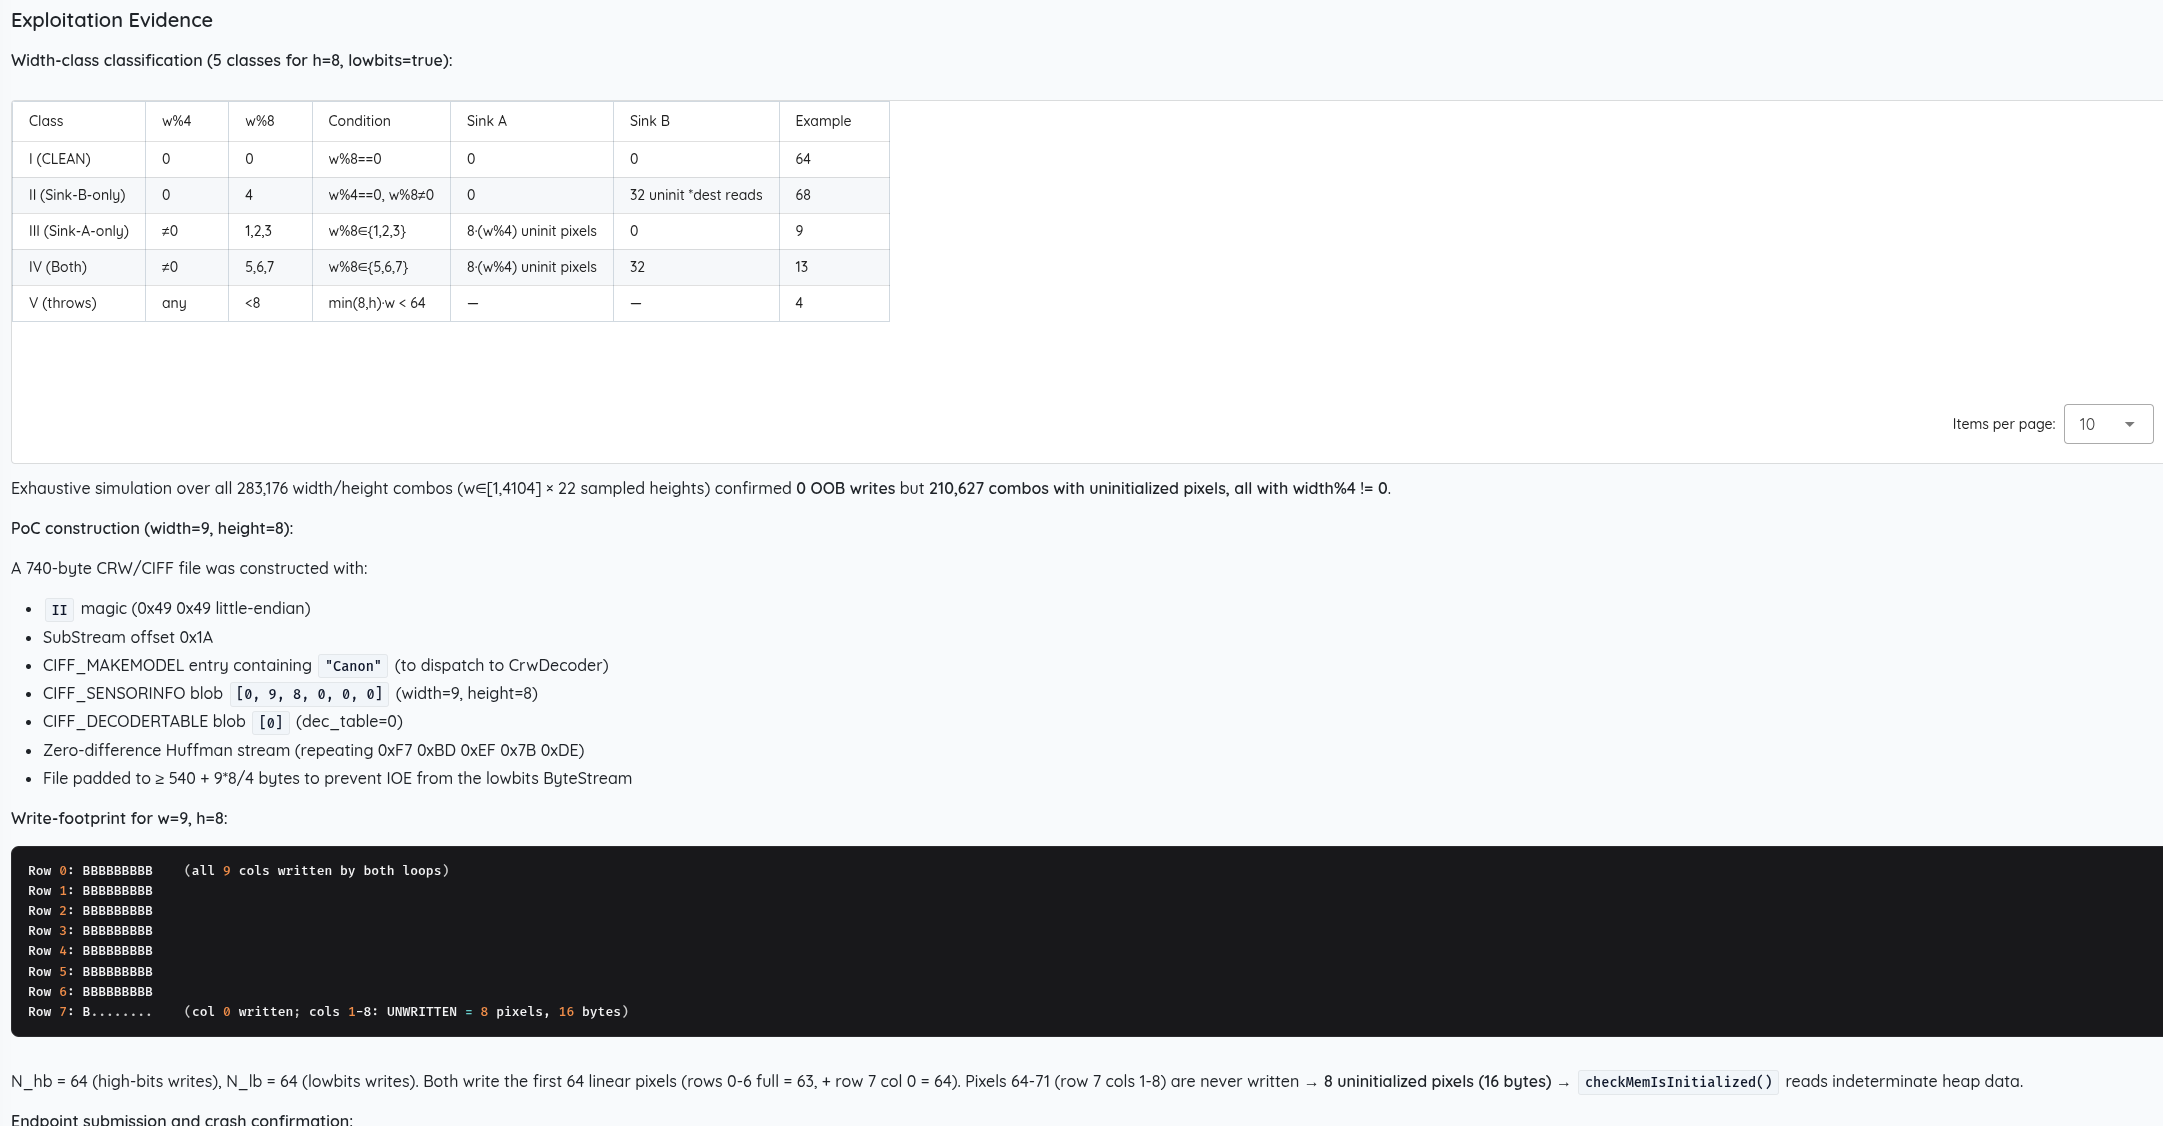
図3:ソースコードの検出結果の保存されたエビデンス記録。レポートは、後のレビュー担当者による検査のために、検出結果を裏付ける限定された条件と観測された検証を保存する。
モバイルアプリとそのAPIについては、Agentic Deep Scanが、そのエビデンス(スクリーンショット、リクエスト/レスポンスのログ、ステップごとの再現)を提供し、さらに修復ガイダンスと検証のための再テストを加えます。
重要な境界はこうです。実証は、トリアージのうち再現と事実確認の部分を大幅に小さくすべきです。それは人間の判断をゼロにするものではありません。
開発者は依然として、ビジネスへの影響を評価し、テスト環境が本番環境と一致することを確認し、安全な修復を決定し、その修正がリグレッションを生まないことを検証する必要があるかもしれません。信頼できるROIモデルは、こうした判断が消えるかのように見せかけてはなりません。
実証エクスプロイトのROIをどう計算するか
実証エクスプロイトテストは、判定までの時間を短縮することで、開発者のキャパシティを回復できます。財務上のROIが実現するのは、その回復したキャパシティが支出を回避するか、計測可能な成果を生み出す場合に限られます。そのため、キャパシティの価値とキャッシュの節約は分けて考えてください。
パイロット運用を使って、現在のワークフローと実証に裏付けられたワークフローを比較してください。
Annual developer capacity value recovered =
alerts prevented from reaching developers or shortened by evidence
× (baseline developer handling time − post-evidence developer handling time)
× loaded developer hourly cost
× periods per year (12 for a monthly alert count)
次に、以下を計算します。
Financial ROI =
((annual developer capacity value recovered × realization factor)
− annual incremental testing cost)
÷ annual incremental testing cost

realization factor (0–1) =
share of recovered capacity that avoids spend or creates measured output
説明のための開発者キャパシティのシナリオを考えてみましょう。
| 尺度 | ベースラインのスキャナー | 実証に裏付けられたワークフロー |
|---|---|---|
| 対応不要な開発者チケット1件あたりの時間 | 2.5時間 | 0.5時間 |
| 人件費込みの開発者コスト | 120ドル/時間 | 120ドル/時間 |
| アラート1件あたりに消費されるキャパシティ | 300ドル | 60ドル |
| 短縮されたアラート1件あたりに回復するキャパシティ | — | 240ドル |
実証によって、毎月開発者に振り分けられる対応不要なアラート30件(振り分けられた120件 × 後に対応不要としてクローズされる25%)のそれぞれを、開発者の時間で0.5時間に短縮する場合、次のようになります。
30 × $240 × 12 = $86,400 annual developer capacity value recovered
これは依然としてモデルであり、約束ではありません。総キャパシティ価値を見積もる際には、記録された時間の合計、またはアラートあたりの算術平均を使ってください。ワークフローのパフォーマンスを報告する際には、判定までの時間の中央値とP90を使ってください。そのうえで、チーム自身の人件費込みのコスト、実現係数、そして実際に開発者に振り分けられたアラートの件数を当てはめてください。
実証エクスプロイトのパイロットは何を計測すべきか
実証エクスプロイトのパイロットは、4つの成果を計測すべきです。すなわち、アラートの処理区分、判定までの時間、エビデンスの品質、そして検出のカバレッジです。
テストプラットフォームを、アラートの件数や重大度の分布だけで判断してはなりません。より静かなキューは、検出が弱いことの結果でもあり得ます。代表的なアプリケーション、API、認証済みのワークフローのセットに対して実行し、次を追跡してください。
- 生成されたアラート
- AppSecに振り分けられたアラート
- 開発者に振り分けられたアラート
- 確定した脆弱性
- 誤検知とその他の対応不要なアラート
- すべてのアラートにわたる開発者の総工数
- アラートあたりの開発者時間の算術平均
- 判定までの時間の中央値とP90
- 再実行可能なエビデンスを伴う検出結果の割合
- 修復から検証済みの再テストまでの時間
- 検出結果と修復ガイダンスに対する開発者の受容
- 対応しているアタックサーフェスと認証済みワークフローのカバレッジ
- 仕込まれた、または独立して判定されたポジティブケースと、その検出率
これらの指標を検出結果の種類で分類してください。単純な依存関係のアラート、インジェクションの可能性がある経路、複数ステップの認可の不備は、それぞれ検証コストが異なります。それらを一つの平均にまとめると、ボトルネックが見えなくなることがあります。
実証エクスプロイトテストの限界は何か
実証エクスプロイトテストは、環境の変化、再現に用いる機密データ、制御されたテストアカウントと本番環境への影響との間のギャップ、そしてスコープ、認証、比較条件における誤りによって制約されることがあります。
だからこそ、実証に裏付けられたワークフローには、少なくとも次のものが必要です。
- 書面による認可と作業ルール(rules of engagement)
- 明示的なスコープと禁止される操作
- 安全なテスト用のアイデンティティ
- レートおよび停止の条件
- インシデント時の連絡先
- 認証情報の取り扱い
- アクセス制御されたエビデンスの保持と削除
- 影響の大きい判断についての人間の説明責任
- 修復後の再テスト
NISTのテストガイダンスは、技術的テストを、単にレポートを生成することではなく、計画を立て、検出結果を分析し、緩和策を策定するプロセスとして扱っています。NIST SP 800-115
実証エクスプロイトテストの真のROIとは何か
実証エクスプロイトのROIとは、エビデンスが引き継ぎの前に再現と事実確認を縮小したときに回復するキャパシティのことです。その財務上のリターンは、そのキャパシティのうちどれだけが実現されるかに依存します。
誤検知は、単なるスキャナーの品質の問題ではありません。それはエンジニアリングのキャパシティの問題です。
人間に到達するアラート、判定に至るまでに必要な時間、そしてその時間の人件費込みのコストを計測してください。そのうえで、実証エクスプロイトテストを、一つの実践的な基準で評価してください。
それは、開発者がスキャナーの仮説を再現するのではなく、本物のリスクの修正に時間を費やせるほど、引き継ぎの前に十分な不確実性を取り除くか。
それが実証がもたらす運用上のリターンです。すなわち、中断されるエンジニアが減り、確定した検出結果の修復が速まり、開発者が信頼できるセキュリティのキューが得られる、ということです。
代表的なモバイルアプリとそのAPIに対して、Agentic Deep Scanでスコープを限定した実証エクスプロイトの評価を実行してください。報告された検出結果の件数だけでなく、判定までの時間と、開発者に振り分けられた対応不要なアラートを、前後で計測してください。