Le vrai coût des faux positifs : calculer la taxe d'ingénierie des scanners bruyants
Les faux positifs sont un problème de capacité d'ingénierie, pas seulement un problème de qualité du scanner. Découvrez comment mesurer leur coût et évaluer le ROI des tests avec preuve d'exploitation.
Un faux positif peut coûter 30 $, 300 $ ou 3 000 $ à une équipe d'ingénierie.
Avec un taux chargé de 90 $ de l'heure, une clôture en 20 minutes coûte 30 $. Le scénario à 300 $ ci-dessous suppose 2,5 heures de développeur à 120 $ de l'heure. Une reconstitution nécessitant huit heures chacune d'un développeur senior à 180 $ de l'heure et d'un relecteur AppSec à 195 $ de l'heure coûte 3 000 $ (8 × (180 $ + 195 $)).
Le même scanner peut engendrer des coûts très différents selon la personne qui traite l'alerte et la quantité de contexte qu'elle doit reconstituer.
C'est pourquoi « notre scanner produit moins de faux positifs » ne constitue pas, à lui seul, un argumentaire économique. La question utile est :
Combien de temps d'ingénierie une alerte consomme-t-elle avant que l'équipe puisse décider avec confiance de la corriger, de la différer ou de la clore ?
Pour un programme de sécurité bruyant, ce temps devient une taxe d'ingénierie. Elle se paie en travail de développement interrompu, en investigation AppSec, en fils de discussion Slack, en tickets en double et en perte de confiance dans l'alerte suivante.
Combien les faux positifs coûtent-ils aux équipes d'ingénierie ?
Les faux positifs coûtent aux équipes d'ingénierie le coût chargé de chaque alerte non actionnable, définie ici comme une alerte close sans tâche de remédiation, qui atteint un workflow humain. Le temps de développeur seul représente 300 $ par alerte dans l'exemple détaillé ci-dessous.
Utilisez ce modèle :
Annual noise cost =
non-actionable alerts that reach humans
× average labor cost per alert
× number of periods per year (12 when the alert count is monthly)
Pour une alerte individuelle :
Labor cost per alert =
((developer investigation time + context-recovery time) × loaded developer hourly cost)
+ (security-review time × loaded security hourly cost)
+ other coordination costs not already included above
Utilisez le coût chargé plutôt que le seul salaire : charges patronales, avantages, équipement, encadrement et frais généraux comptent tous.
Ne comptez que les alertes qui atteignent réellement un workflow humain. Les alertes supprimées automatiquement n'imposent pas le même coût marginal.
Un exemple détaillé : pourquoi une fausse alerte peut dépasser 300 $
Supposons qu'un développeur passe :
- 90 minutes à vérifier le chemin de code, le comportement de l'application ou la configuration ;
- 15 minutes à lire le ticket et à se coordonner avec l'AppSec ;
- 45 minutes à reconstituer le contexte de développement interrompu.
Cela fait 2,5 heures de temps de développeur. À un coût entièrement chargé de 120 $ par heure :
2.5 hours × $120/hour = $300 per non-actionable alert
Il s'agit d'un scénario, pas d'une moyenne du secteur. Une équipe dont le coût horaire ou le workflow diffère doit y substituer ses propres chiffres.
Appliquons-le maintenant à un volume modeste :
| Hypothèse | Valeur |
|---|---|
| Alertes acheminées aux développeurs chaque mois | 120 |
| Part ensuite close comme non actionnable | 25 % |
| Effort de développeur par alerte non actionnable | 2,5 heures |
| Coût chargé du développeur | 120 $/heure |
| Coût mensuel développeur | 9 000 $ |
| Coût annuel développeur | 108 000 $ |
Si un ingénieur AppSec consacre 20 minutes à chacune de ces 30 alertes mensuelles, à un coût chargé de 100 $ de l'heure, cela ajoute encore 1 000 $ par mois. Au total, cela représente environ 333 $ par alerte non actionnable, soit 10 000 $ par mois. La taxe annuelle modélisée atteint 120 000 $, avant de compter le retard de livraison, le travail en double ou le risque que les développeurs se mettent à ignorer la file d'attente.
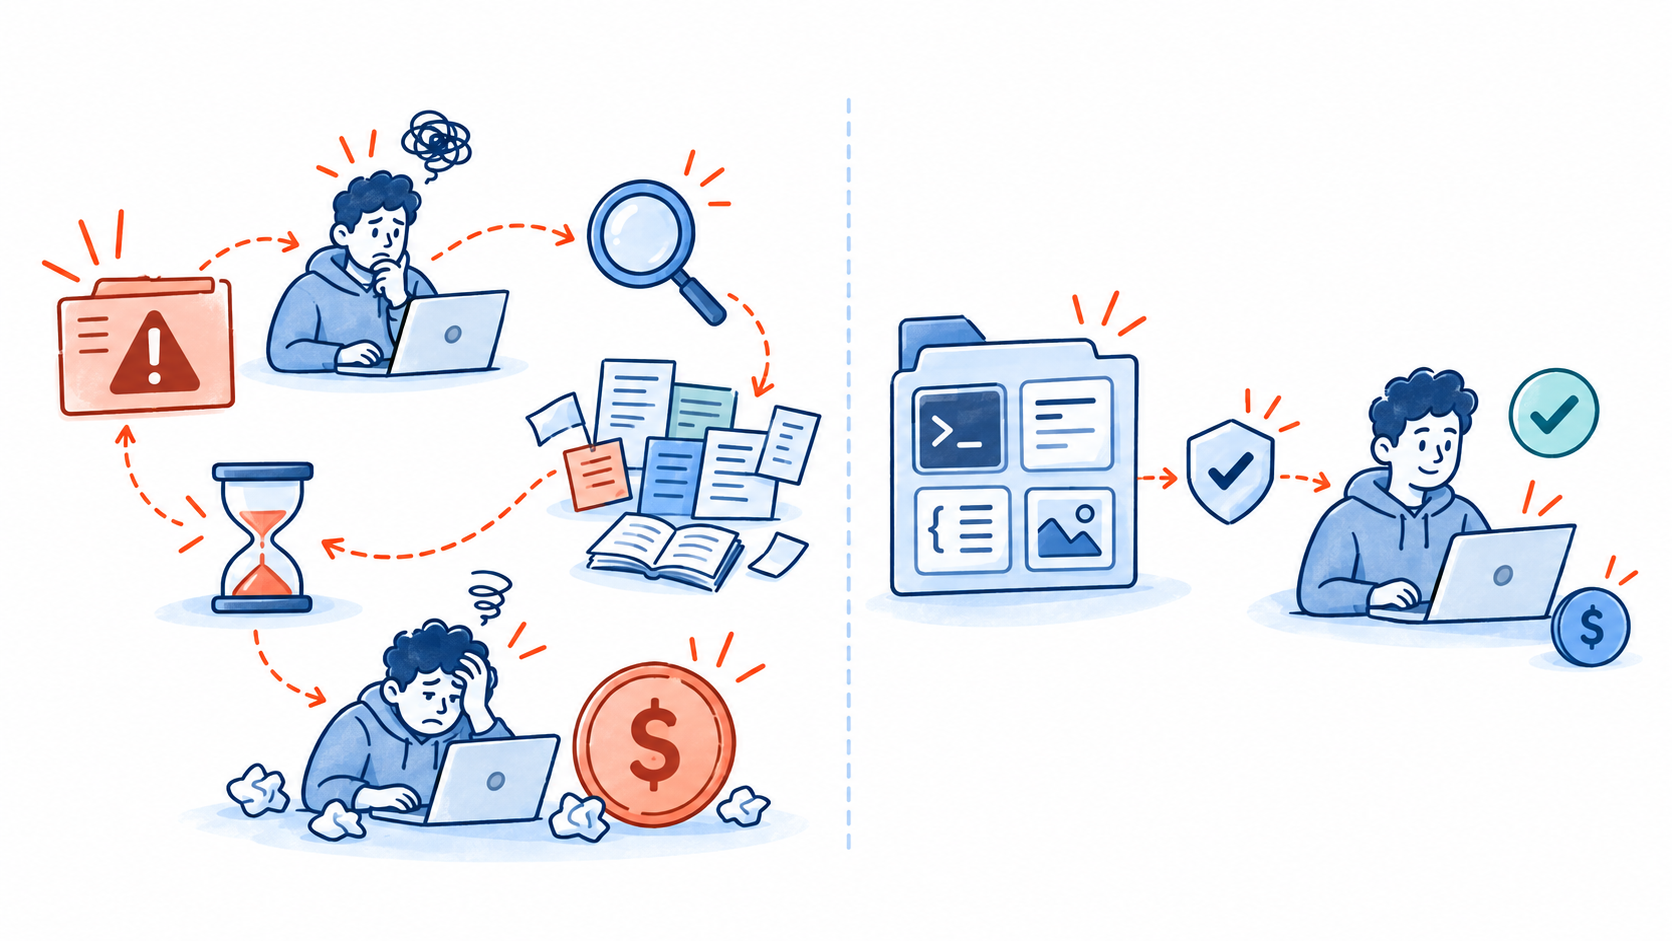
Figure 1 : une alerte bruyante exige des investigations répétées et une reconstitution du contexte, tandis qu'une vulnérabilité étayée par des preuves permet à un ingénieur de vérifier la preuve et d'agir directement.
Pourquoi les faux positifs coûtent-ils plus que le temps de tri enregistré ?
Les minutes consignées dans un ticket constituent la plus petite partie de la taxe ; le coût caché est l'investigation, la reconstitution du contexte et la reprise du travail qu'effectue un développeur et que le ticket ne capture jamais.
Une alerte de sécurité peut obliger un développeur à identifier la version concernée, à retrouver le modèle d'autorisation prévu, à reproduire une requête avec des données de test adaptées, à déterminer si un contrôle en amont s'applique et à expliquer le résultat à l'équipe sécurité. Ensuite, il doit reprendre son travail initial.
Ce travail de récupération n'est pas un surcoût imaginaire.
Dans une étude exploratoire sur la reprise des tâches après des interruptions de l'activité de programmation, Chris Parnin et Spencer Rugaber ont constaté que les développeurs devaient couramment naviguer et chercher du contexte supplémentaire avant de modifier de nouveau le code ; seule une petite fraction des sessions enregistrées reprenait le codage en moins d'une minute.
Une alerte bruyante peut créer la même charge de reconstitution du contexte lorsqu'un développeur retourne à son travail sur une fonctionnalité. L'étude ne quantifie pas directement les interruptions dues aux alertes de sécurité ; le chiffre de 300 $ reste donc un scénario illustratif et non un résultat de l'étude. Lire l'étude de Parnin et Rugaber sur la reprise des tâches
Le modèle de coût est plus large que les seuls faux positifs au sens strict, mais il ne faut pas confondre ses catégories. Les faux positifs, les doublons et les alertes hors périmètre sont des candidats de vulnérabilité qui ne deviennent pas des tâches de remédiation. Les risques acceptés et les faiblesses réelles mais inatteignables peuvent être de véritables vulnérabilités qui exigent des décisions de gouvernance.
Suivez les deux catégories, car chacune consomme du temps, mais ne présentez pas le travail de gouvernance comme une erreur du scanner.
Le volume d'alertes non actionnables est l'indicateur opérationnel à instrumenter : les alertes closes sans tâche de remédiation, rapportées par catégorie plutôt que confondues avec le nombre brut de faux positifs du scanner.
Pourquoi les scanners de sécurité produisent-ils des faux positifs ?
Les scanners produisent du bruit parce que la détection de candidats opère avec des informations incomplètes sur les contrôles personnalisés, la configuration à l'exécution, les composants externes, l'atteignabilité et la logique métier. Ils restent néanmoins précieux : l'analyse statique peut identifier tôt dans le développement des chemins potentiellement dangereux, et les tests dynamiques peuvent révéler des comportements que le seul code source ne peut pas prouver.
Mais la détection de candidats n'équivaut pas à une vulnérabilité à signaler.
L'OWASP trace la même frontière : les outils d'analyse statique peuvent générer des faux positifs, et il est souvent difficile de confirmer si un problème identifié est une véritable vulnérabilité. Les recommandations de l'OWASP sur l'analyse statique
Les taux de faux positifs ne sont donc pas des statistiques marketing transposables. Dans le rapport étendu actuel portant sur 258 projets embarqués open source, CodeQL a signalé 709 vrais défauts avec un taux de faux positifs de 34 % ; c'est une preuve utile de l'ampleur du problème dans un environnement donné, pas un taux à appliquer à tous les scanners ou à toutes les bases de code. Lire le rapport de CodeQL sur 258 projets
La bonne réponse n'est pas d'arrêter de scanner. Une recherche portant sur 35 projets industriels a constaté que les outils d'analyse statique pouvaient rester rentables dans l'ensemble, car ils aidaient les équipes à trouver et à supprimer les défauts plus tôt Lire l'étude coûts-bénéfices.
L'objectif opérationnel est de conserver ce signal précoce tout en évitant que des hypothèses non étayées ne deviennent des tickets pour les développeurs.
Qu'est-ce que le test de sécurité avec preuve d'exploitation ?
Le test avec preuve d'exploitation valide une faiblesse candidate dans un environnement contrôlé avant qu'elle ne devienne un ticket pour les développeurs.
Le test avec preuve d'exploitation change le passage de relais :
Possible weakness → developer repeats the investigation → verdict
en :
Candidate weakness → controlled validation → evidence-backed finding, conditional result, or suppression
Les preuves doivent permettre à un relecteur de répondre rapidement à quatre questions :
- Qu'est-ce qui a été testé exactement, et sur quelle version ou quel environnement ?
- Quelles conditions ou quelle identité de test étaient nécessaires ?
- Quelle requête, quelle action ou quel chemin de code a déclenché le comportement ?
- Quel résultat observable établit l'impact, et quel contrôle négatif montre que le résultat est significatif ?
Ne recourez à la suppression que si la validation inclut des preuves issues d'un environnement comparable et des contrôles négatifs significatifs. L'impossibilité de reproduire le problème dans un seul test contraint ne prouve pas que le candidat était un faux positif.
Pour une vulnérabilité web ou d'API, il peut s'agir d'une commande curl expurgée, de la requête et de la réponse HTTP correspondantes, et d'une comparaison montrant l'échec d'autorisation attendu par rapport au résultat observé. Les preuves destinées aux développeurs, une fois assainies, doivent conserver les espaces réservés et le contexte de reproduction ; les requêtes complètes, les secrets et les autres éléments sensibles relèvent de dossiers de preuves à accès contrôlé. Pour les tests mobiles, cela peut inclure des captures d'écran, des logs d'exécution, de la télémétrie d'appareil et des étapes rejouables.
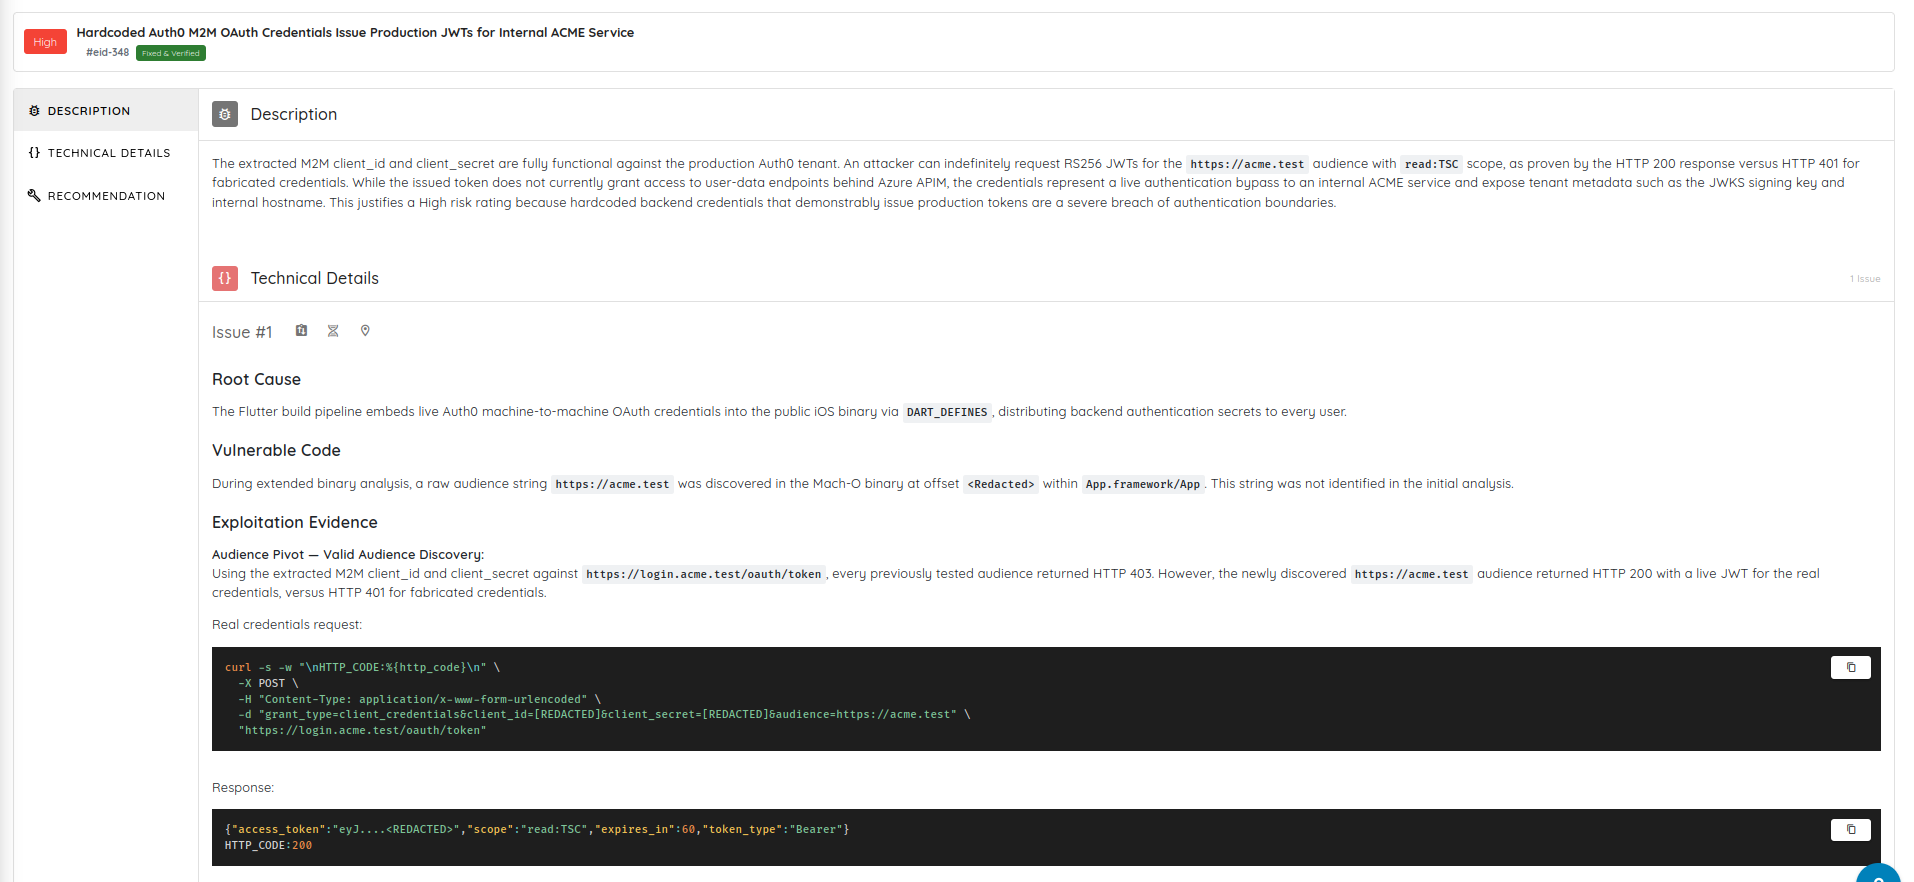
Figure 2 : une vulnérabilité assainie relie la cause racine à une requête expurgée et à la réponse observée, afin qu'un relecteur puisse vérifier le résultat sans refaire l'investigation initiale.
La preuve peut aussi reposer sur le code plutôt que sur une requête à l'exécution. Dans la vulnérabilité de code source RawSpeed ci-dessous, le panneau Exploitation Evidence conserve avec la vulnérabilité l'analyse des classes de largeur, les conditions minimisées de la PoC et la validation de la version vulnérable par rapport à la version corrigée. Un relecteur ayant accès au rapport peut consulter à nouveau ces preuves stockées dans la vue de détail, au lieu de les reconstituer à partir du résumé d'un ticket.
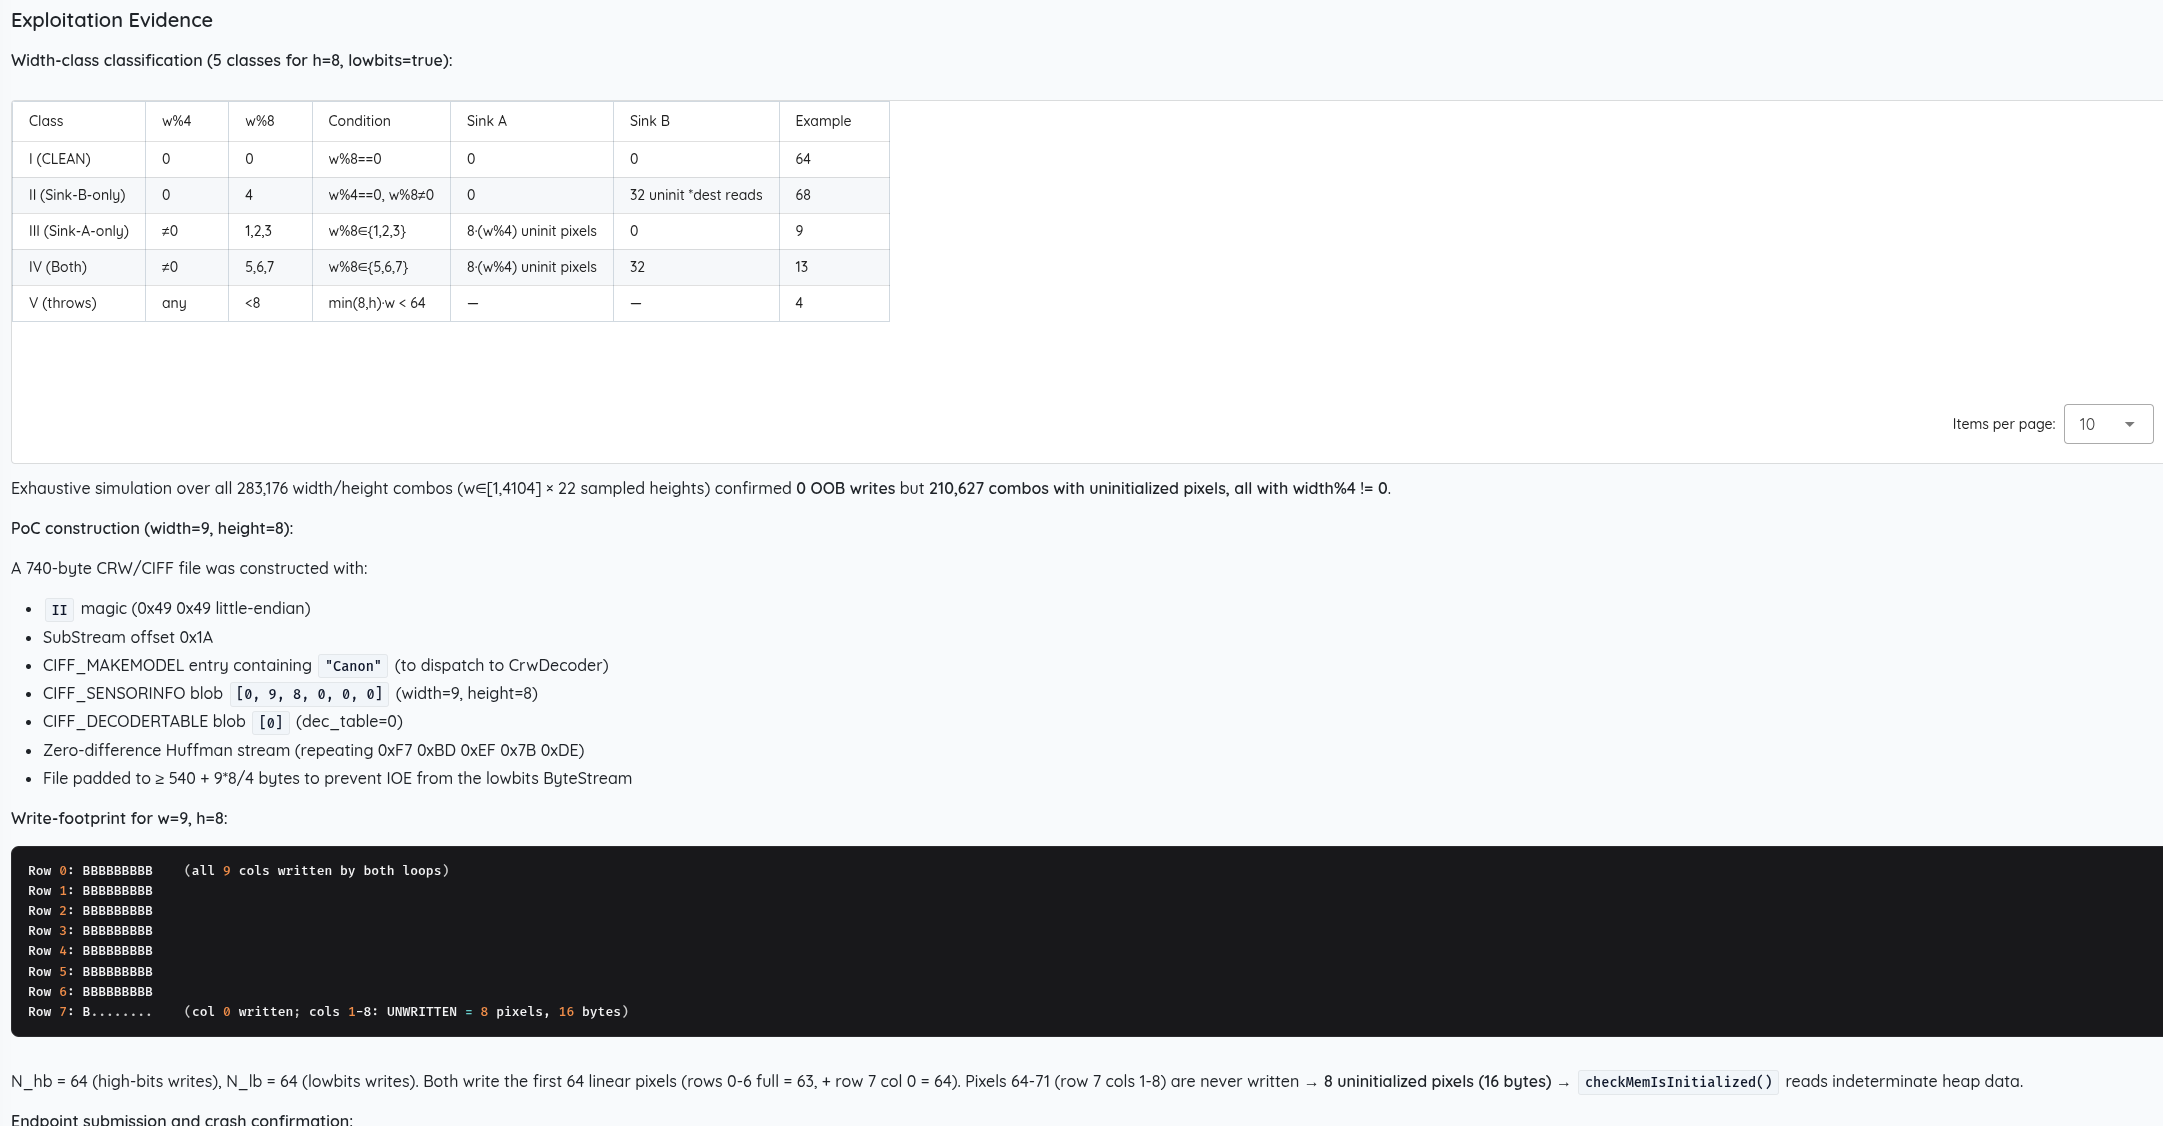
Figure 3 : le dossier de preuves stocké d'une vulnérabilité de code source. Le rapport conserve les conditions bornées et la validation observée qui étayent la vulnérabilité, pour une inspection ultérieure par un relecteur.
Pour les applications mobiles et leurs API, Agentic Deep Scan fournit ces preuves (captures d'écran, logs de requêtes et réponses, reproduction pas à pas), puis ajoute des recommandations de remédiation et un nouveau test de vérification.
La limite importante : la preuve doit réduire considérablement la part du tri consacrée à la reproduction et à la recherche des faits. Elle ne ramène pas le jugement humain à zéro.
Un développeur peut encore devoir évaluer l'impact métier, confirmer que l'environnement de test correspond à la production, décider d'une remédiation sûre et vérifier que le correctif ne crée pas de régression. Un modèle de ROI crédible ne doit pas faire comme si ces décisions disparaissaient.
Comment calculer le ROI d'un test avec preuve d'exploitation ?
Le test avec preuve d'exploitation peut récupérer de la capacité de développement en raccourcissant le délai d'obtention d'un verdict. Le ROI financier n'est réalisé que lorsque cette capacité récupérée évite une dépense ou produit un résultat mesurable ; séparez donc la valeur de la capacité des économies réelles.
Utilisez un pilote pour comparer le workflow actuel au workflow étayé par des preuves.
Annual developer capacity value recovered =
alerts prevented from reaching developers or shortened by evidence
× (baseline developer handling time − post-evidence developer handling time)
× loaded developer hourly cost
× periods per year (12 for a monthly alert count)
Calculez ensuite :
Financial ROI =
((annual developer capacity value recovered × realization factor)
− annual incremental testing cost)
÷ annual incremental testing cost

realization factor (0–1) =
share of recovered capacity that avoids spend or creates measured output
Prenons un scénario illustratif de capacité de développement :
| Mesure | Scanner de référence | Workflow étayé par des preuves |
|---|---|---|
| Temps par ticket développeur non actionnable | 2,5 heures | 0,5 heure |
| Coût chargé du développeur | 120 $/heure | 120 $/heure |
| Capacité consommée par alerte | 300 $ | 60 $ |
| Capacité récupérée par alerte raccourcie | — | 240 $ |
Si la preuve ramène chacune des 30 alertes non actionnables mensuelles acheminées aux développeurs (120 acheminées × 25 % ensuite closes comme non actionnables) à 0,5 heure de temps de développeur :
30 × $240 × 12 = $86,400 annual developer capacity value recovered
Cela reste un modèle, pas une promesse. Utilisez les heures consignées additionnées ou une moyenne arithmétique par alerte pour estimer la valeur totale de la capacité ; utilisez la médiane et le P90 du délai d'obtention d'un verdict pour rendre compte de la performance du workflow. Substituez ensuite les coûts chargés propres à l'équipe, son facteur de réalisation et le nombre d'alertes réellement acheminées aux développeurs.
Que doit mesurer un pilote de test avec preuve d'exploitation ?
Un pilote de test avec preuve d'exploitation doit mesurer quatre résultats : le traitement des alertes, le délai d'obtention d'un verdict, la qualité des preuves et la couverture de détection.
Ne jugez pas une plateforme de test uniquement sur le nombre d'alertes ou la répartition des sévérités. Une file d'attente plus calme peut aussi résulter d'une détection plus faible. Exécutez-la sur un ensemble représentatif d'applications, d'API et de workflows authentifiés, puis suivez :
- les alertes générées ;
- les alertes acheminées à l'AppSec ;
- les alertes acheminées aux développeurs ;
- les vulnérabilités confirmées ;
- les faux positifs et autres alertes non actionnables ;
- le total des heures de développeur sur l'ensemble des alertes ;
- le temps moyen arithmétique de développeur par alerte ;
- la médiane et le P90 du délai d'obtention d'un verdict ;
- le pourcentage de vulnérabilités avec des preuves rejouables ;
- le délai entre la remédiation et le nouveau test vérifié ;
- l'acceptation par les développeurs de la vulnérabilité et des recommandations de remédiation ;
- la surface d'attaque prise en charge et la couverture des workflows authentifiés ;
- les cas positifs injectés ou arbitrés de façon indépendante, et leur taux de détection.
Segmentez ces indicateurs par type de vulnérabilité. Une simple alerte de dépendance, un chemin d'injection potentiel et une faille d'autorisation en plusieurs étapes ont des coûts de validation différents. Les combiner en une seule moyenne peut masquer le goulot d'étranglement.
Quelles sont les limites du test avec preuve d'exploitation ?
Le test avec preuve d'exploitation peut être limité par l'évolution de l'environnement, les données de reproduction sensibles, l'écart entre les comptes de test contrôlés et l'impact en production, ainsi que par les erreurs de périmètre, d'authentification ou de conditions de comparaison.
C'est pourquoi un workflow étayé par des preuves exige, au minimum :
- une autorisation écrite et des règles d'engagement ;
- un périmètre explicite et des actions interdites ;
- des identités de test sûres ;
- des conditions de débit et d'arrêt ;
- des contacts en cas d'incident ;
- la gestion des identifiants ;
- la conservation et la suppression des preuves à accès contrôlé ;
- une responsabilité humaine pour les décisions à fort impact ; et
- un nouveau test après remédiation.
Les recommandations de test du NIST traitent le test technique comme un processus de planification, d'analyse des résultats et d'élaboration de stratégies d'atténuation, et non comme la simple production d'un rapport. NIST SP 800-115
Quel est le véritable ROI du test avec preuve d'exploitation ?
Le ROI du test avec preuve d'exploitation est la capacité récupérée lorsque les preuves réduisent la reproduction et la recherche des faits avant le passage de relais ; son rendement financier dépend de la part de cette capacité qui est effectivement réalisée.
Les faux positifs ne sont pas seulement un problème de qualité du scanner. Ce sont un problème de capacité d'ingénierie.
Mesurez les alertes qui atteignent des humains, le temps nécessaire pour parvenir à un verdict et le coût chargé de ce temps. Évaluez ensuite le test avec preuve d'exploitation selon un critère pratique :
Élimine-t-il suffisamment d'incertitude avant le passage de relais pour que les développeurs consacrent leur temps à corriger un risque réel plutôt qu'à reproduire l'hypothèse du scanner ?
C'est le rendement opérationnel de la preuve : moins d'ingénieurs interrompus, une remédiation plus rapide des vulnérabilités confirmées et une file d'attente de sécurité en laquelle les développeurs peuvent avoir confiance.
Lancez une évaluation circonscrite du test avec preuve d'exploitation avec Agentic Deep Scan sur des applications mobiles représentatives et leurs API. Mesurez le délai d'obtention d'un verdict et les alertes non actionnables acheminées aux développeurs avant et après, et pas seulement le nombre de vulnérabilités signalées.