El coste real de los falsos positivos: cómo calcular el impuesto de ingeniería de los escáneres ruidosos
Los falsos positivos son un problema de capacidad de ingeniería, y no solo de calidad del escáner. Aprenda a medir su coste y a evaluar el retorno de la inversión de las pruebas con prueba de explotación.
Un falso positivo puede costar a un equipo de ingeniería $30, $300 o $3,000.
Con una tarifa completa de $90 por hora, cerrar una alerta en 20 minutos cuesta $30. El escenario de $300 que se muestra más abajo supone 2.5 horas de desarrollador a $120 por hora. Una reconstrucción que requiera ocho horas de cada uno, de un desarrollador sénior a $180 por hora y de un revisor de AppSec a $195 por hora, cuesta $3,000 (8 × ($180 + $195)).
El mismo escáner puede generar costes muy distintos según quién toque la alerta y cuánto contexto tenga que reconstruir.
Por eso «nuestro escáner tiene menos falsos positivos» no es, por sí solo, un argumento de negocio. La pregunta útil es:
¿Cuánto tiempo de ingeniería consume una alerta antes de que el equipo pueda decidir con confianza si la corrige, la aplaza o la cierra?
En un programa de seguridad ruidoso, ese tiempo se convierte en un impuesto de ingeniería. Se paga con trabajo de desarrollo de funcionalidades interrumpido, investigación de AppSec, hilos de Slack, tickets duplicados y pérdida de confianza en la siguiente alerta.
¿Cuánto cuestan los falsos positivos a los equipos de ingeniería?
Los falsos positivos cuestan a los equipos de ingeniería el coste completo de cada alerta no accionable, definida aquí como una alerta cerrada sin una tarea de corrección, que llega a un flujo de trabajo humano. Solo el tiempo de los desarrolladores supone $300 por alerta en el ejemplo práctico que sigue.
Utilice este modelo:
Annual noise cost =
non-actionable alerts that reach humans
× average labor cost per alert
× number of periods per year (12 when the alert count is monthly)
Para una alerta individual:
Labor cost per alert =
((developer investigation time + context-recovery time) × loaded developer hourly cost)
+ (security-review time × loaded security hourly cost)
+ other coordination costs not already included above
Utilice el coste completo, y no solo el salario: los impuestos del empleador, los beneficios, el equipamiento, la gestión y los gastos generales importan.
Cuente solo las alertas que llegan realmente a un flujo de trabajo humano. Las alertas suprimidas automáticamente no imponen el mismo coste marginal.
Un ejemplo práctico: por qué una sola falsa alarma puede superar los $300
Suponga que un desarrollador dedica:
- 90 minutos a comprobar la ruta del código, el comportamiento de la aplicación o la configuración;
- 15 minutos a leer el ticket y coordinarse con AppSec;
- 45 minutos a reconstruir el contexto de desarrollo interrumpido.
Son 2.5 horas de tiempo del desarrollador. Con un coste completo de $120 por hora:
2.5 hours × $120/hour = $300 per non-actionable alert
Esto es un escenario, no un promedio del sector. Un equipo con un coste por hora o un flujo de trabajo diferentes debería sustituirlos por sus propias cifras.
Aplíquelo ahora a un volumen modesto:
| Supuesto | Valor |
|---|---|
| Alertas enviadas a los desarrolladores cada mes | 120 |
| Porcentaje que más tarde se cierra como no accionable | 25% |
| Esfuerzo del desarrollador por alerta no accionable | 2.5 horas |
| Coste completo del desarrollador | $120/hora |
| Coste mensual de los desarrolladores | $9,000 |
| Coste anual de los desarrolladores | $108,000 |
Si un ingeniero de AppSec dedica 20 minutos a cada una de esas 30 alertas mensuales, con un coste completo de $100 por hora, eso añade otros $1,000 al mes. En conjunto, son unos $333 por alerta no accionable, o $10,000 al mes. El impuesto anual modelado asciende a $120,000, antes de contar el retraso en las entregas, el trabajo duplicado o el riesgo de que los desarrolladores empiecen a ignorar la cola.
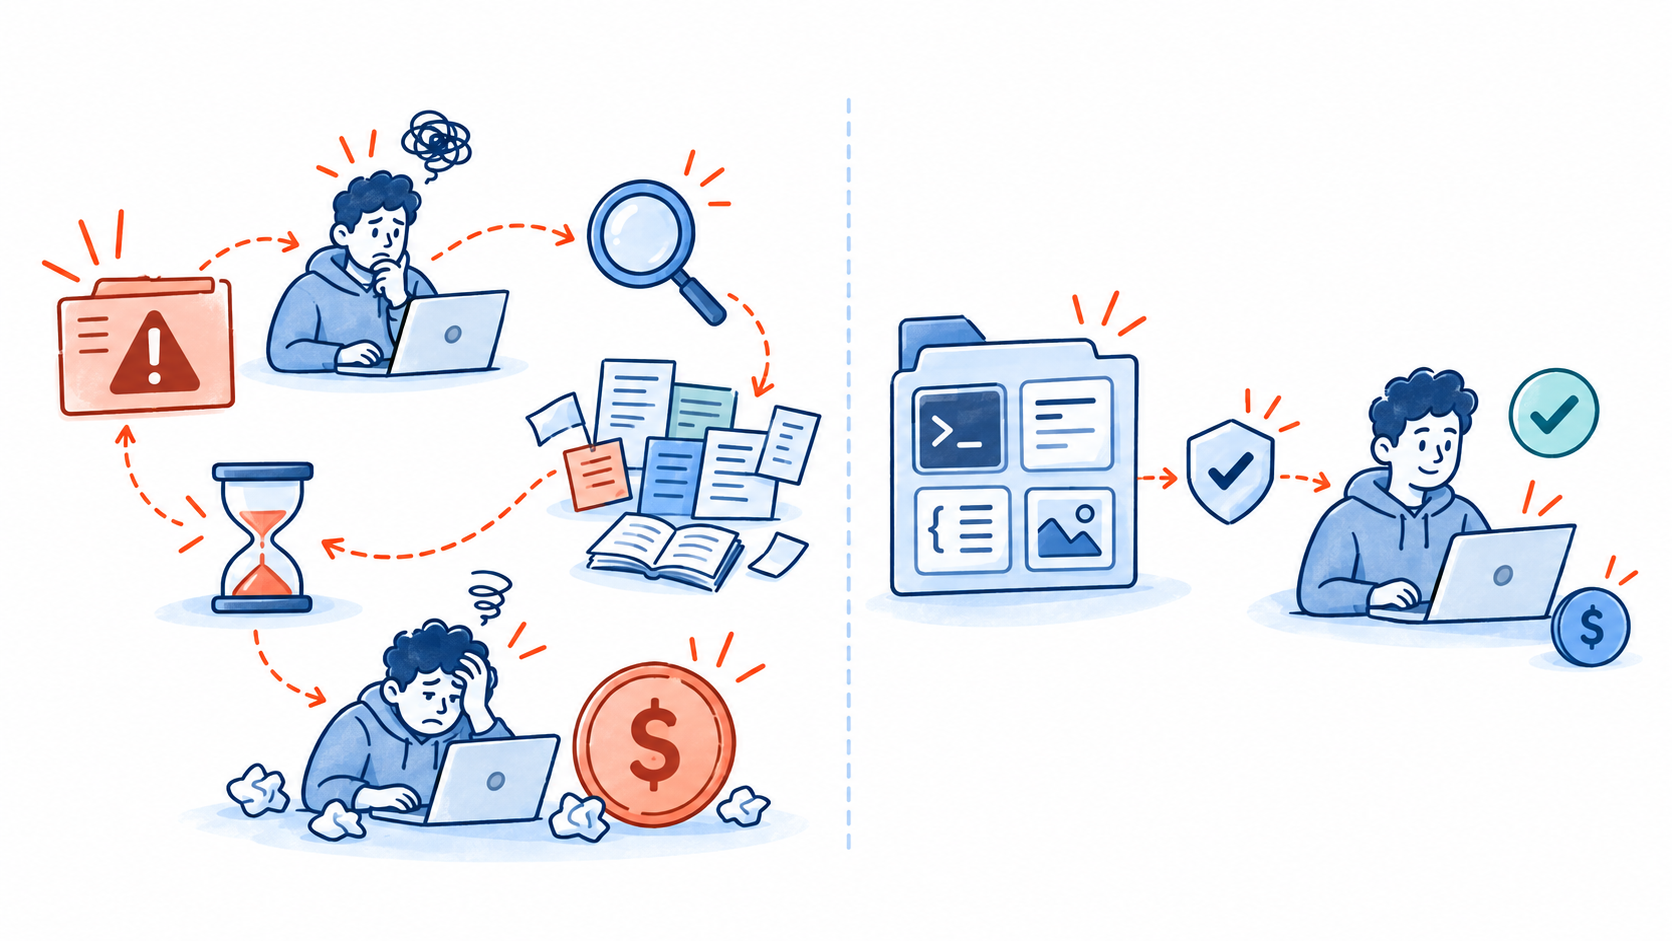
Figura 1: una alerta ruidosa requiere investigaciones repetidas y recuperación del contexto, mientras que un hallazgo respaldado por evidencias permite a un ingeniero verificar la prueba y actuar directamente.
¿Por qué los falsos positivos cuestan más que el tiempo de triaje registrado?
Los minutos registrados en un ticket son la parte más pequeña del impuesto; el coste oculto es la investigación, la recuperación del contexto y la vuelta al trabajo que realiza un desarrollador y que el ticket nunca recoge.
Una alerta de seguridad puede obligar a un desarrollador a identificar la versión afectada, recuperar el modelo de autorización previsto, reproducir una solicitud con datos de prueba adecuados, determinar si se aplica un control previo y explicar el resultado al equipo de seguridad. Después, tiene que volver a su trabajo original.
Ese trabajo de recuperación no es una sobrecarga imaginaria.
En un estudio exploratorio sobre la reanudación de tareas tras interrupciones en la actividad de programación, Chris Parnin y Spencer Rugaber observaron que los desarrolladores solían tener que navegar y buscar contexto adicional de la tarea antes de volver a editar; solo una pequeña fracción de las sesiones registradas retomaba la escritura de código en menos de un minuto.
Una alerta ruidosa puede crear la misma carga de recuperación de contexto cuando un desarrollador vuelve al trabajo de funcionalidades. El estudio no cuantifica directamente las interrupciones causadas por alertas de seguridad, por lo que la cifra de $300 sigue siendo un escenario ilustrativo y no un resultado del estudio. Lea el estudio de Parnin y Rugaber sobre la reanudación de tareas
El modelo de costes es más amplio que los falsos positivos en sentido estricto, pero no deben mezclarse sus categorías. Los falsos positivos, los duplicados y las alertas fuera del alcance son hallazgos candidatos que no se convierten en trabajo de corrección. Los riesgos aceptados y las debilidades genuinas pero inalcanzables pueden ser hallazgos reales que requieren decisiones de gobernanza.
Haga un seguimiento de ambas categorías porque cada una consume tiempo, pero no presente el trabajo de gobernanza como un error del escáner.
El volumen de alertas no accionables es la cifra operativa que conviene instrumentar: las alertas cerradas sin una tarea de corrección, notificadas por categoría y sin equipararlas con el recuento bruto de falsos positivos del escáner.
¿Por qué los escáneres de seguridad producen falsos positivos?
Los escáneres producen ruido porque la detección de candidatos opera con información incompleta sobre los controles personalizados, la configuración en tiempo de ejecución, los componentes externos, la alcanzabilidad y la lógica de negocio. Aun así siguen siendo valiosos: el análisis estático puede identificar pronto, durante el desarrollo, rutas potencialmente peligrosas, y las pruebas dinámicas pueden revelar comportamientos que el código fuente por sí solo no puede demostrar.
Pero la detección de candidatos no es lo mismo que una vulnerabilidad notificable.
OWASP traza el mismo límite: las herramientas de análisis estático pueden generar falsos positivos, y confirmar si un problema identificado es una vulnerabilidad real suele ser difícil. La guía de OWASP sobre análisis estático
Por eso, las tasas de falsos positivos no son estadísticas de marketing que se puedan trasladar sin más. En el informe ampliado más reciente sobre 258 proyectos embebidos de código abierto, CodeQL notificó 709 defectos reales con una tasa de falsos positivos del 34%; es una evidencia útil de la magnitud del problema en un entorno concreto, no una tasa que deba aplicarse a todos los escáneres o bases de código. Lea el informe de CodeQL sobre 258 proyectos
La respuesta correcta no es dejar de escanear. Una investigación sobre 35 proyectos industriales concluyó que las herramientas de análisis estático podían seguir siendo rentables en conjunto porque ayudaban a los equipos a encontrar y eliminar defectos antes Lea el estudio de coste-beneficio.
El objetivo operativo es conservar esa señal temprana evitando que hipótesis sin respaldo se conviertan en tickets para los desarrolladores.
¿Qué son las pruebas de seguridad con prueba de explotación?
Las pruebas con prueba de explotación validan una debilidad candidata en un entorno controlado antes de que se convierta en un ticket para los desarrolladores.
Las pruebas con prueba de explotación cambian el traspaso de:
Possible weakness → developer repeats the investigation → verdict
a:
Candidate weakness → controlled validation → evidence-backed finding, conditional result, or suppression
La evidencia debería permitir a un revisor responder rápidamente a cuatro preguntas:
- ¿Qué se probó exactamente y en qué versión o entorno?
- ¿Qué condiciones o qué identidad de prueba se necesitaron?
- ¿Qué solicitud, acción o ruta de código desencadenó el comportamiento?
- ¿Qué resultado observable establece el impacto y qué control negativo demuestra que el resultado es significativo?
Utilice la supresión solo cuando la validación incluya evidencias de un entorno comparable y controles negativos significativos. Que no se pueda reproducir en una prueba restringida no demuestra, por sí solo, que el candidato fuera un falso positivo.
En el caso de un hallazgo web o de API, puede ser un comando curl redactado, la solicitud y la respuesta HTTP correspondientes y una comparación que muestre el fallo de autorización esperado frente al resultado observado. La evidencia saneada para los desarrolladores debe conservar los marcadores de posición y el contexto de reproducción; las solicitudes completas, los secretos y otros artefactos sensibles pertenecen a registros de evidencias con acceso controlado. En las pruebas móviles, puede incluir capturas de pantalla, logs de ejecución, telemetría del dispositivo y pasos reproducibles.
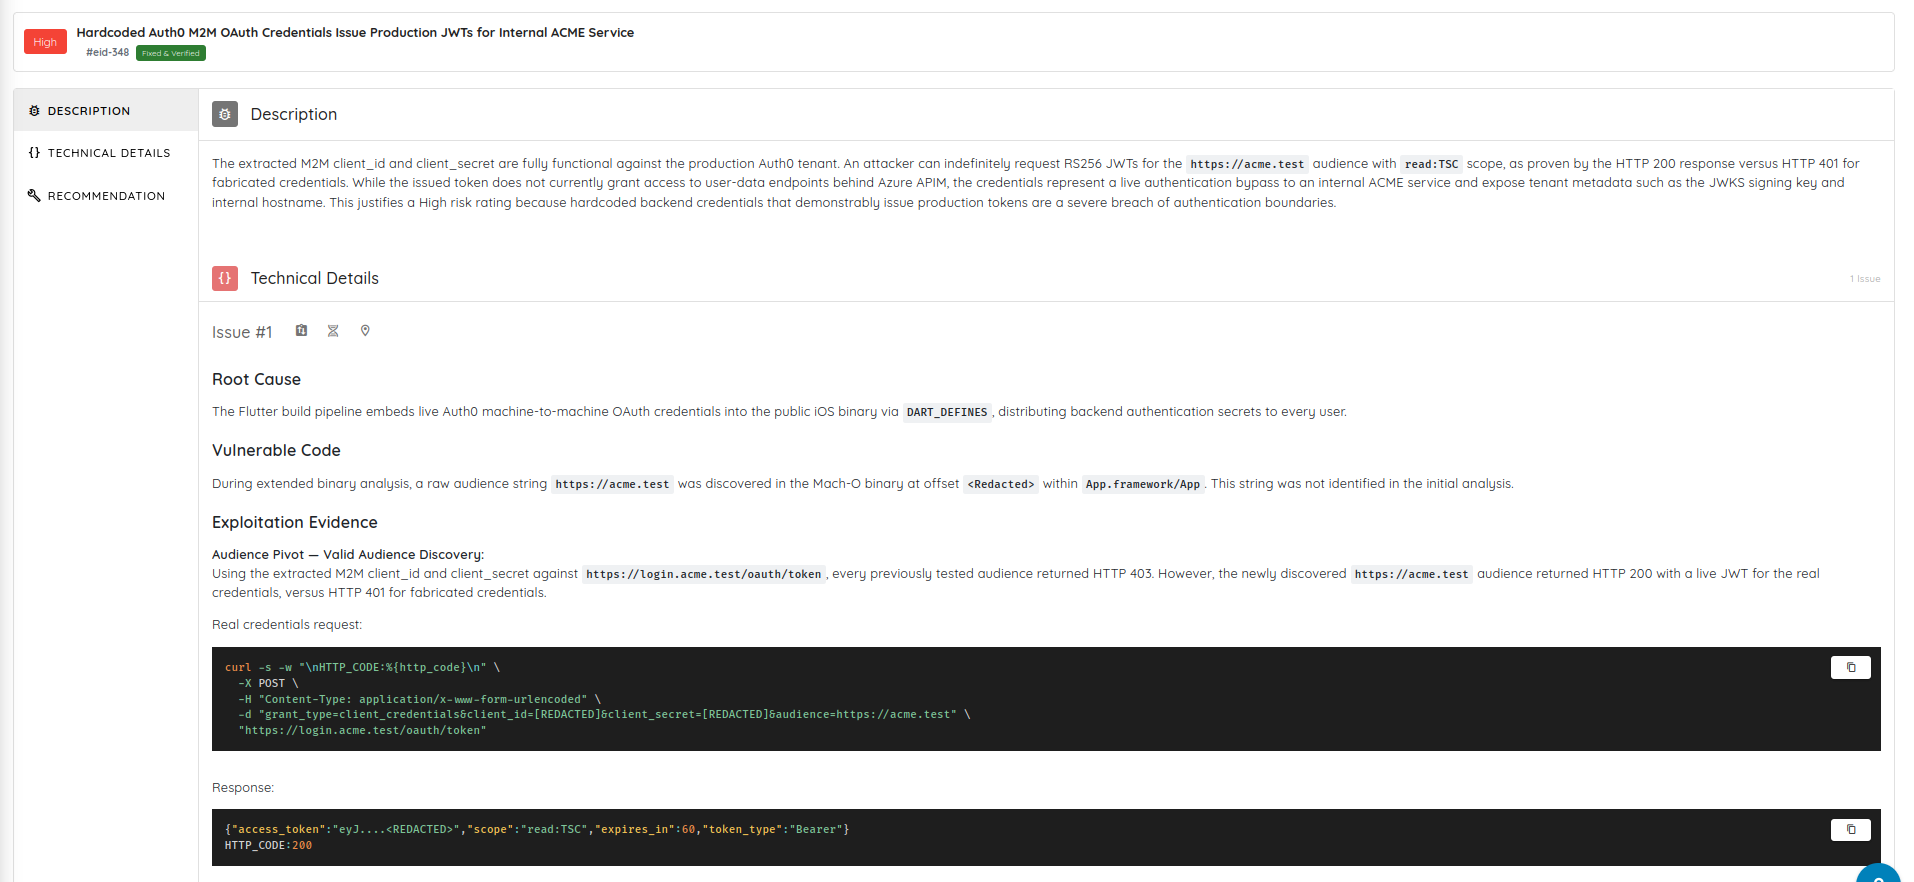
Figura 2: un hallazgo saneado vincula la causa raíz con una solicitud redactada y la respuesta observada, de modo que un revisor pueda verificar el resultado sin volver a hacer la investigación inicial.
La prueba también puede estar basada en el código en lugar de en una solicitud en tiempo de ejecución. En el hallazgo de código fuente de RawSpeed que se muestra a continuación, el panel Exploitation Evidence conserva con el hallazgo el análisis de clases de ancho, las condiciones mínimas de la PoC y la validación de la versión vulnerable frente a la corregida. Un revisor con acceso al informe puede volver a consultar esa evidencia almacenada en la vista de detalle, en lugar de reconstruirla a partir del resumen de un ticket.
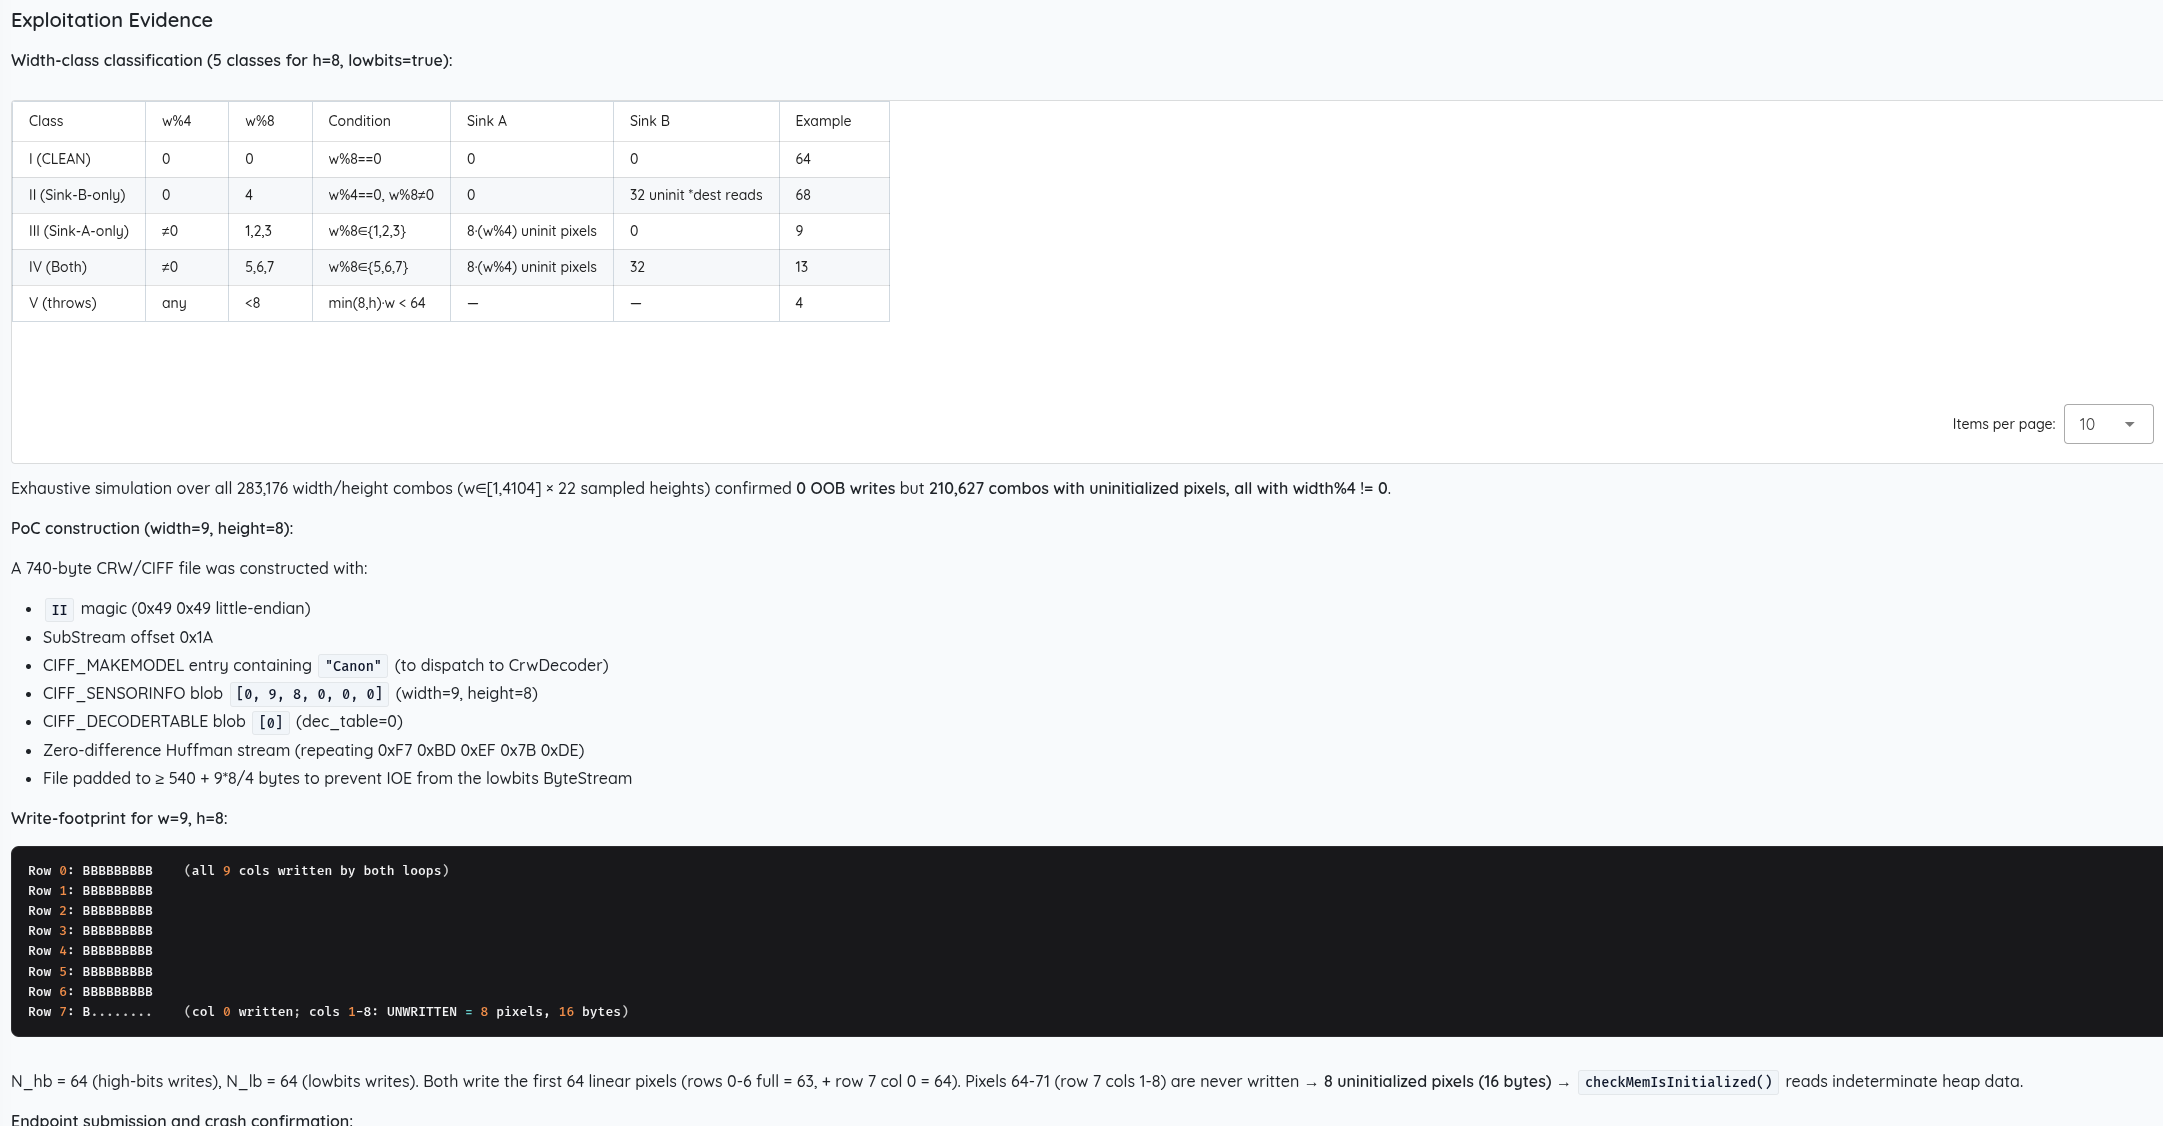
Figura 3: el registro de evidencias almacenado de un hallazgo de código fuente. El informe conserva las condiciones acotadas y la validación observada que respaldan el hallazgo para que un revisor pueda inspeccionarlas más adelante.
Para las aplicaciones móviles y sus API, Agentic Deep Scan aporta esa evidencia (capturas de pantalla, logs de solicitudes y respuestas, y reproducción paso a paso) y añade después una guía de corrección y un reescaneo de verificación.
El límite importante: la prueba debería reducir mucho la parte de reproducción y obtención de hechos del triaje. No reduce a cero el criterio humano.
Un desarrollador puede seguir necesitando evaluar el impacto en el negocio, confirmar que el entorno de pruebas coincide con producción, decidir una corrección segura y validar que la corrección no genere una regresión. Un modelo de ROI creíble no debe fingir que esas decisiones desaparecen.
¿Cómo se calcula el ROI de las pruebas con prueba de explotación?
Las pruebas con prueba de explotación pueden recuperar capacidad de los desarrolladores al acortar el tiempo hasta el veredicto. El ROI financiero solo se materializa cuando esa capacidad recuperada evita un gasto o produce un resultado medible, por lo que conviene mantener separado el valor de la capacidad y el ahorro en efectivo.
Utilice un piloto para comparar el flujo de trabajo actual con el flujo de trabajo respaldado por evidencias.
Annual developer capacity value recovered =
alerts prevented from reaching developers or shortened by evidence
× (baseline developer handling time − post-evidence developer handling time)
× loaded developer hourly cost
× periods per year (12 for a monthly alert count)
Después, calcule:
Financial ROI =
((annual developer capacity value recovered × realization factor)
− annual incremental testing cost)
÷ annual incremental testing cost

realization factor (0–1) =
share of recovered capacity that avoids spend or creates measured output
Considere un escenario ilustrativo de capacidad de los desarrolladores:
| Medida | Escáner de referencia | Flujo de trabajo respaldado por evidencias |
|---|---|---|
| Tiempo por ticket no accionable de un desarrollador | 2.5 horas | 0.5 horas |
| Coste completo del desarrollador | $120/hora | $120/hora |
| Capacidad consumida por alerta | $300 | $60 |
| Capacidad recuperada por alerta acortada | — | $240 |
Si la prueba acorta a 0.5 horas de tiempo del desarrollador cada una de las 30 alertas no accionables mensuales enviadas a desarrolladores (120 enviadas × 25% cerradas más tarde como no accionables):
30 × $240 × 12 = $86,400 annual developer capacity value recovered
Esto sigue siendo un modelo, no una promesa. Utilice la suma de las horas registradas o la media aritmética por alerta al estimar el valor total de la capacidad; utilice la mediana y el P90 del tiempo hasta el veredicto para notificar el rendimiento del flujo de trabajo. Después, sustituya por los costes completos del propio equipo, el factor de materialización y el número de alertas realmente enviadas a los desarrolladores.
¿Qué debe medir un piloto de pruebas con prueba de explotación?
Un piloto de pruebas con prueba de explotación debe medir cuatro resultados: la disposición de las alertas, el tiempo hasta el veredicto, la calidad de las evidencias y la cobertura de detección.
No juzgue una plataforma de pruebas únicamente por el número de alertas o por la distribución de severidades. Una cola más tranquila también puede deberse a una detección más débil. Ejecútela sobre un conjunto representativo de aplicaciones, API y flujos de trabajo autenticados y, a continuación, haga un seguimiento de:
- alertas generadas;
- alertas enviadas a AppSec;
- alertas enviadas a los desarrolladores;
- vulnerabilidades confirmadas;
- falsos positivos y otras alertas no accionables;
- total de horas de los desarrolladores en todas las alertas;
- tiempo medio aritmético del desarrollador por alerta;
- mediana y P90 del tiempo hasta el veredicto;
- porcentaje de hallazgos con evidencia reproducible;
- tiempo desde la corrección hasta el reescaneo verificado;
- aceptación por parte de los desarrolladores del hallazgo y de la guía de corrección;
- cobertura admitida de la superficie de ataque y de los flujos de trabajo autenticados;
- casos positivos sembrados o adjudicados de forma independiente y su tasa de detección.
Segmente esas métricas por tipo de hallazgo. Una alerta simple de dependencias, una posible ruta de inyección y un fallo de autorización de varios pasos tienen costes de validación distintos. Combinarlos en un único promedio puede ocultar el cuello de botella.
¿Cuáles son los límites de las pruebas con prueba de explotación?
Las pruebas con prueba de explotación pueden verse limitadas por los cambios en el entorno, los datos sensibles de reproducción, la distancia entre las cuentas de prueba controladas y el impacto en producción, y los errores en el alcance, la autenticación o las condiciones de comparación.
Por eso un flujo de trabajo respaldado por evidencias necesita, como mínimo:
- autorización por escrito y reglas de compromiso;
- alcance explícito y acciones prohibidas;
- identidades de prueba seguras;
- límites de frecuencia y condiciones de parada;
- contactos para incidentes;
- gestión de credenciales;
- conservación y eliminación de evidencias con acceso controlado;
- responsabilidad humana en las decisiones de alto impacto; y
- reescaneo tras la corrección.
La guía de pruebas del NIST trata las pruebas técnicas como un proceso de planificación, análisis de los hallazgos y desarrollo de estrategias de mitigación, y no simplemente como la generación de un informe. NIST SP 800-115
¿Cuál es el ROI real de las pruebas con prueba de explotación?
El ROI de la prueba de explotación es la capacidad recuperada cuando la evidencia reduce la reproducción y la obtención de hechos antes del traspaso; su retorno financiero depende de cuánta de esa capacidad se materialice.
Los falsos positivos no son solo un problema de calidad del escáner. Son un problema de capacidad de ingeniería.
Mida las alertas que llegan a las personas, el tiempo necesario para llegar a un veredicto y el coste completo de ese tiempo. Después, evalúe las pruebas con prueba de explotación con un criterio práctico:
¿Elimina suficiente incertidumbre antes del traspaso como para que los desarrolladores dediquen su tiempo a corregir riesgos reales en lugar de reproducir la hipótesis del escáner?
Ese es el retorno operativo de la prueba: menos ingenieros interrumpidos, una corrección más rápida de los hallazgos confirmados y una cola de seguridad en la que los desarrolladores puedan confiar.
Ejecute una evaluación acotada de prueba de explotación con Agentic Deep Scan sobre aplicaciones móviles representativas y sus API. Mida el tiempo hasta el veredicto y las alertas no accionables enviadas a los desarrolladores antes y después, y no solo el número de hallazgos notificados.