误报的真实成本:计算高噪声扫描器带来的工程“税”
误报不仅是扫描器质量问题,更是工程产能问题。了解如何衡量误报的成本,并评估漏洞利用验证测试的投资回报率(ROI)。
一条误报可能让工程团队付出 $30、$300 或 $3,000 的代价。
按每小时 $90 的全口径成本计算,一次耗时 20 分钟的关闭操作花费 $30。下文中 $300 的场景假设开发人员投入 2.5 小时、每小时 $120。如果一次重建工作需要每小时 $180 的资深开发人员和每小时 $195 的 AppSec 审核人员各投入 8 小时,成本就是 $3,000(8 × ($180 + $195))。
同一个扫描器可能产生截然不同的成本,这取决于由谁处理告警,以及他们需要重建多少上下文。
正因如此,“我们的扫描器误报更少”本身并不能构成商业论证。真正有用的问题是:
在团队能够有把握地决定修复、推迟还是关闭某条告警之前,这条告警要消耗多少工程时间?
对于一个噪声很大的安全计划来说,这些时间就变成了一种工程“税”。它以被打断的功能开发、AppSec 调查、Slack 讨论串、重复工单,以及对下一条告警的信任丧失为代价。
误报给工程团队带来多少成本?
误报给工程团队带来的成本,是每一条进入人工工作流的不可操作告警(此处定义为未产生修复任务即被关闭的告警)的全口径成本。在下面的计算示例中,仅开发人员的时间成本就达到每条告警 $300。
使用以下模型:
Annual noise cost =
non-actionable alerts that reach humans
× average labor cost per alert
× number of periods per year (12 when the alert count is monthly)
对于单条告警:
Labor cost per alert =
((developer investigation time + context-recovery time) × loaded developer hourly cost)
+ (security-review time × loaded security hourly cost)
+ other coordination costs not already included above
请使用全口径成本,而不仅仅是薪资:雇主税费、福利、设备、管理和日常开销都应计算在内。
只统计真正进入人工工作流的告警。被自动抑制的告警不会带来同样的边际成本。
计算示例:为什么一条误报的成本可能超过 $300
假设一名开发人员花费:
- 90 分钟检查代码路径、应用行为或配置;
- 15 分钟阅读工单并与 AppSec 协调;
- 45 分钟重建被打断的开发上下文。
这就是 2.5 小时的开发人员时间。按每小时 $120 的全口径成本计算:
2.5 hours × $120/hour = $300 per non-actionable alert
这是一个假设场景,而不是行业平均水平。时薪成本或工作流不同的团队应代入自己的数据。
现在将其应用到一个不算大的告警量上:
| 假设 | 数值 |
|---|---|
| 每月分派给开发人员的告警 | 120 |
| 后来作为不可操作告警关闭的比例 | 25% |
| 每条不可操作告警的开发人员工作量 | 2.5 小时 |
| 开发人员全口径成本 | $120/小时 |
| 每月开发人员成本 | $9,000 |
| 每年开发人员成本 | $108,000 |
如果一名 AppSec 工程师在每月这 30 条告警中的每一条上花费 20 分钟,全口径成本为每小时 $100,那么每月还要再增加 $1,000。两者合计,相当于每条不可操作告警约 $333,即每月 $10,000。在尚未计入交付延迟、重复工作或开发人员开始忽视告警队列的风险之前,模型测算的年度“税”就已达到 $120,000。
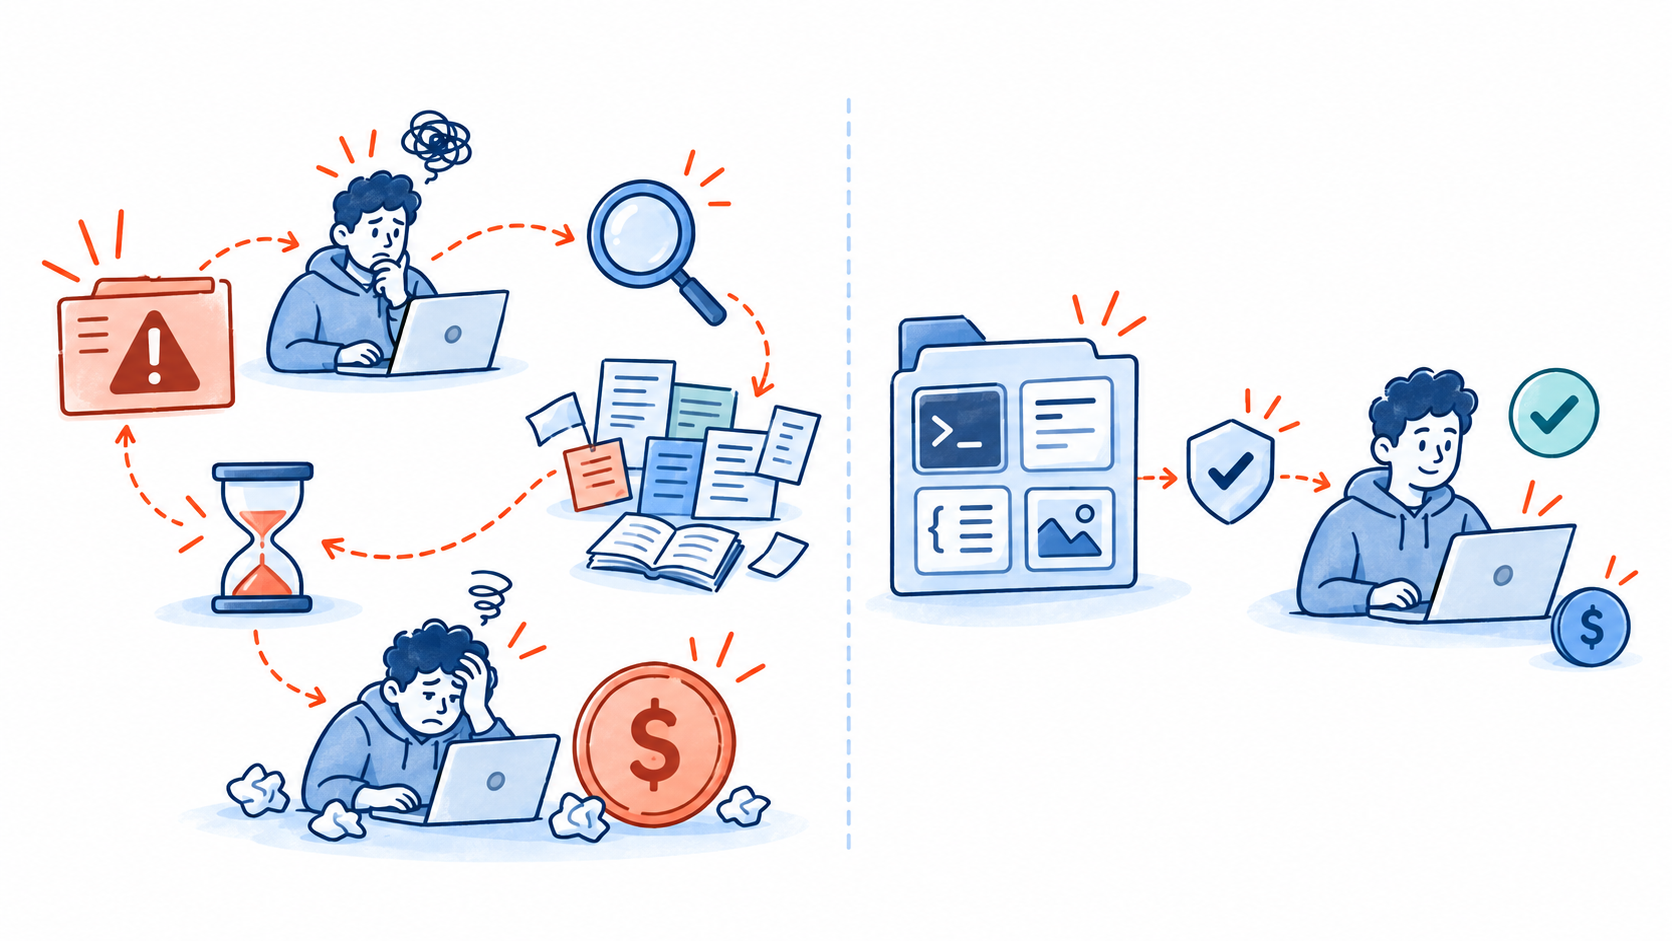
图 1:高噪声告警需要反复调查和恢复上下文,而有实证支撑的发现让工程师能够验证证据并直接采取行动。
为什么误报的成本高于记录在案的分诊时间?
工单中记录的分钟数只是这笔“税”中最小的一部分;隐性成本在于开发人员所做的调查、上下文恢复和重新投入工作,而这些工单从未记录下来。
一条安全告警可能要求开发人员确定受影响的版本、还原预期的授权模型、使用合适的测试数据复现请求、判断是否有上游控制措施生效,并向安全团队解释结果。在此之后,他们还必须回到原来的工作上。
这种恢复工作并不是凭空想象的额外开销。
Chris Parnin 和 Spencer Rugaber 在一项关于编程活动中断后任务恢复的探索性研究中发现,开发人员在重新开始编辑之前,通常需要浏览代码并寻找额外的任务上下文;在记录的会话中,只有一小部分能在 1 分钟内恢复编码。
当开发人员回到功能开发时,一条高噪声告警也会造成同样的上下文恢复负担。该研究并没有直接量化安全告警造成的中断,因此 $300 这一数字仍然只是一个说明性场景,而非该研究的结论。阅读 Parnin 和 Rugaber 关于任务恢复的研究
这一成本模型的范围比严格意义上的误报更广,但不应将其中的类别混为一谈。误报、重复项和超出范围的告警是未能转化为修复工作的候选发现。已接受的风险以及真实存在但不可达的弱点则可能是需要做出治理决策的真实发现。
这两类都要跟踪,因为每一类都会消耗时间,但不要把治理工作报告为扫描器错误。
不可操作告警量是需要埋点统计的运营指标:即未产生修复任务就被关闭的告警,按类别报告,而不是等同于扫描器的原始误报数量。
安全扫描器为什么会产生误报?
扫描器之所以产生噪声,是因为候选检测是在信息不完整的情况下进行的:它不完全了解自定义控制措施、运行时配置、外部组件、可达性和业务逻辑。但扫描器仍然很有价值:静态分析可以在开发早期识别出潜在的危险路径,动态测试可以揭示仅凭源代码无法证明的行为。
但候选检测并不等同于可报告的漏洞。
OWASP 也划出了同样的界线:静态分析工具可能产生误报,而确认已识别的问题是否为真实漏洞往往很困难。OWASP 的静态分析指南
因此,误报率并不是可以随意套用的营销统计数据。在当前一份针对 258 个开源嵌入式项目的扩展报告中,CodeQL 报告了 709 个真实缺陷,误报率为 34%;这为该问题在某一环境中的规模提供了有用的证据,但并不是一个可以套用到所有扫描器或代码库上的比率。阅读 CodeQL 的 258 个项目报告
正确的应对方式不是停止扫描。一项针对 35 个工业项目的研究发现,静态分析工具总体上仍然具有成本效益,因为它们帮助团队更早地发现并消除缺陷 阅读这项成本效益研究。
运营目标是保留这种早期信号,同时防止缺乏依据的假设变成开发人员的工单。
什么是漏洞利用验证(proof-of-exploit)安全测试?
漏洞利用验证测试会在候选弱点变成开发人员工单之前,在受控环境中对其进行验证。
漏洞利用验证测试将交接流程从:
Possible weakness → developer repeats the investigation → verdict
转变为:
Candidate weakness → controlled validation → evidence-backed finding, conditional result, or suppression
证据应让审核人员能够快速回答以下四个问题:
- 具体测试了什么?针对的是哪个版本或环境?
- 需要哪些条件或测试身份?
- 是什么请求、操作或代码路径触发了该行为?
- 哪个可观察的结果确立了影响?又有哪个负向对照表明该结果是有意义的?
只有当验证包含可比环境中的证据和有意义的负向对照时,才使用抑制。仅凭在受限测试中未能复现,并不能证明该候选发现是误报。
对于 Web 或 API 发现,证据可以是一条经过脱敏的 curl 命令、对应的 HTTP 请求和响应,以及一份对比预期授权失败与实际观察结果的比较。提供给开发人员的脱敏证据应保留占位符和复现上下文;完整的请求、密钥和其他敏感产物则应保存在有访问控制的证据记录中。对于移动测试,证据可以包括屏幕截图、运行时日志、设备遥测数据和可重放的步骤。
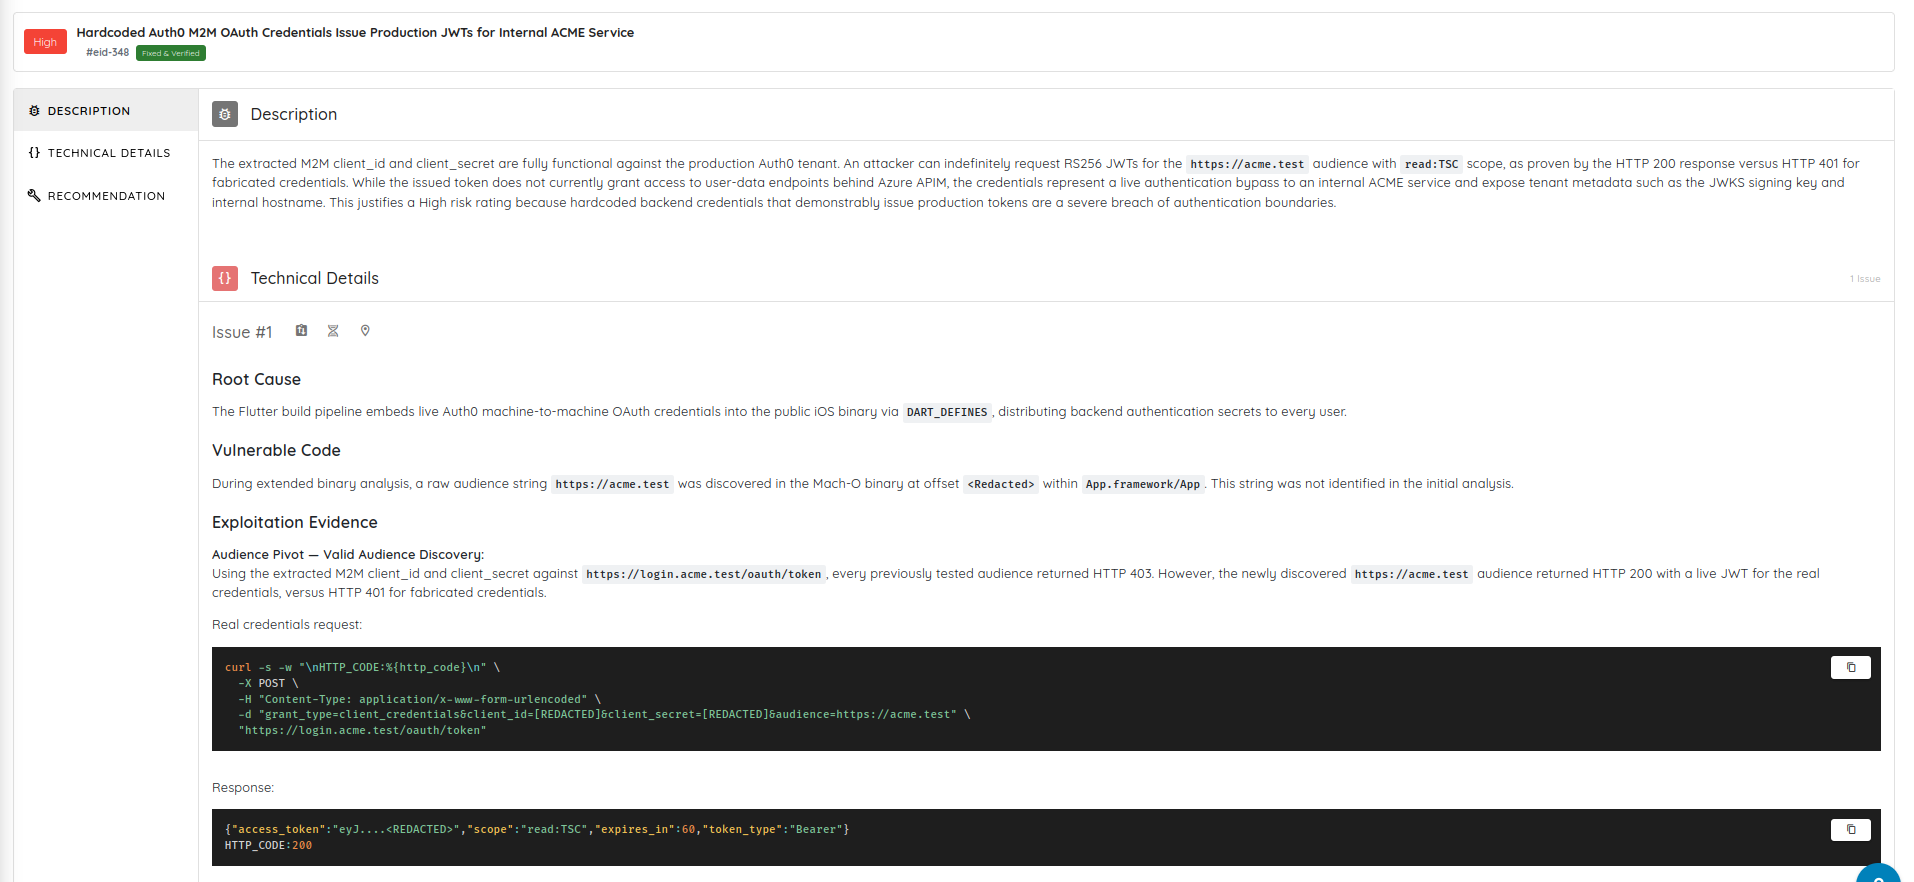
图 2:脱敏后的发现将根因与经过脱敏的请求和观察到的响应关联起来,使审核人员无需重新进行最初的调查即可验证结果。
证据也可以基于代码,而不一定是运行时请求。在下面的 RawSpeed 源代码发现中,Exploitation Evidence 面板将宽度类分析、最小化的 PoC 条件以及漏洞版本与修复版本的对比验证与该发现一起保存。有权访问报告的审核人员可以在详情视图中重新查看这些已存储的证据,而无需从工单摘要中重建。
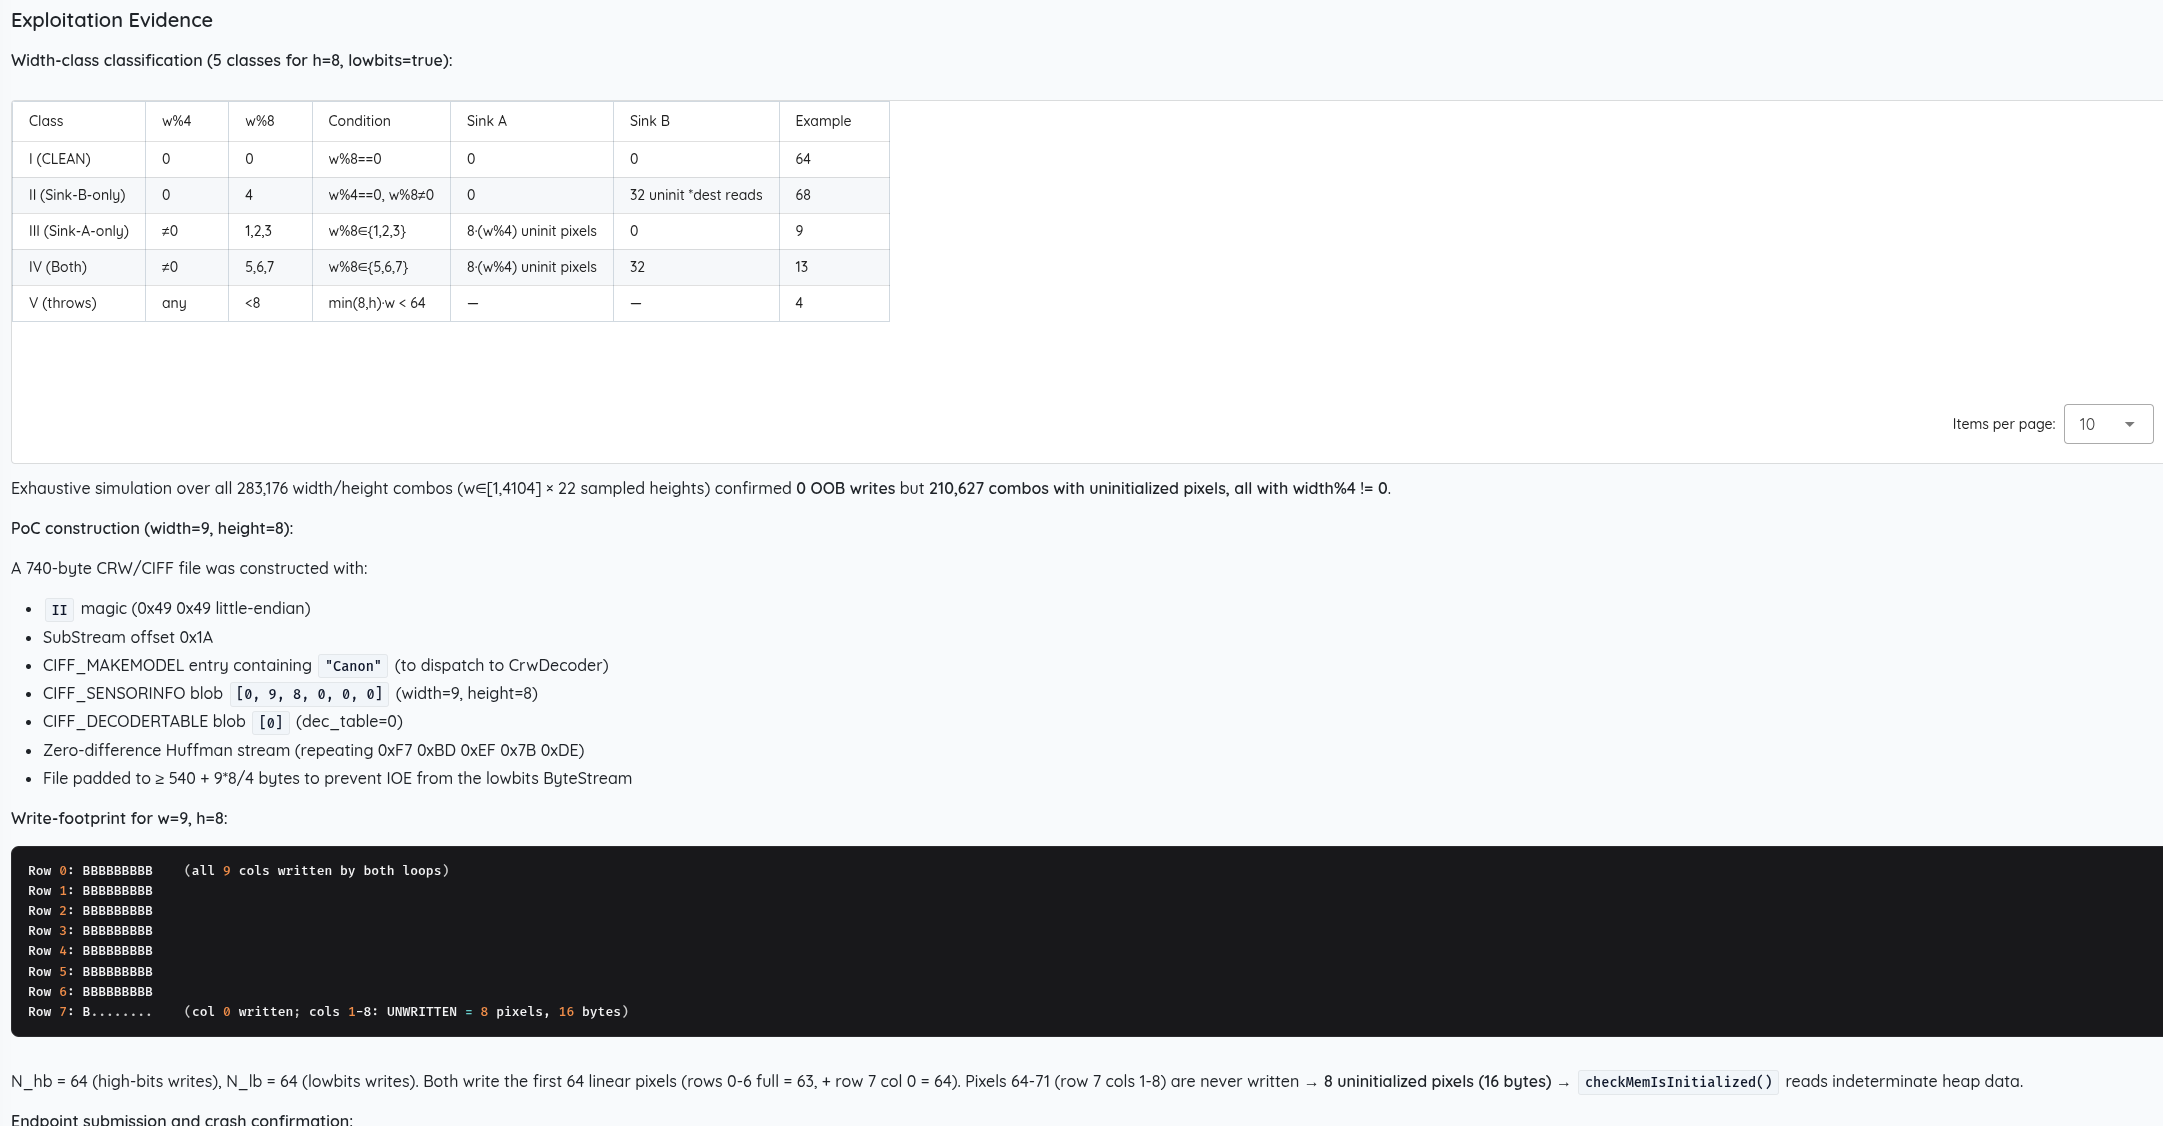
图 3:某个源代码发现的已存储证据记录。报告保留了支撑该发现的有界条件和观察到的验证结果,供审核人员日后查看。
对于移动应用及其 API,Agentic Deep Scan 会提供这些证据——屏幕截图、请求/响应日志和逐步复现步骤——并附上修复指导和验证性重新测试。
需要注意的界限是:证据应大幅缩小分诊中复现和事实查明的部分,但并不能让人工判断归零。
开发人员可能仍需评估业务影响、确认测试环境与生产环境一致、决定安全的修复方案,并验证修复不会引入回归问题。一个可信的 ROI 模型绝不能假装这些决策会消失。
如何计算漏洞利用验证的 ROI?
漏洞利用验证测试可以通过缩短得出结论所需的时间来释放开发人员的产能。只有当释放出的产能避免了支出或产生了可衡量的产出时,财务 ROI 才会真正实现,因此要将产能价值与现金节省区分开来。
通过试点来比较当前工作流与有实证支撑的工作流。
Annual developer capacity value recovered =
alerts prevented from reaching developers or shortened by evidence
× (baseline developer handling time − post-evidence developer handling time)
× loaded developer hourly cost
× periods per year (12 for a monthly alert count)
然后计算:
Financial ROI =
((annual developer capacity value recovered × realization factor)
− annual incremental testing cost)
÷ annual incremental testing cost

realization factor (0–1) =
share of recovered capacity that avoids spend or creates measured output
来看一个说明性的开发人员产能场景:
| 指标 | 基线扫描器 | 有实证支撑的工作流 |
|---|---|---|
| 每张不可操作开发工单耗时 | 2.5 小时 | 0.5 小时 |
| 开发人员全口径成本 | $120/小时 | $120/小时 |
| 每条告警消耗的产能 | $300 | $60 |
| 每条缩短处理时间的告警释放的产能 | — | $240 |
如果证据将每月分派给开发人员的 30 条不可操作告警(分派 120 条 × 25% 后来作为不可操作告警关闭)中每一条的开发人员处理时间都缩短到 0.5 小时:
30 × $240 × 12 = $86,400 annual developer capacity value recovered
这仍然只是一个模型,而不是承诺。估算总产能价值时,请使用记录工时的总和或每条告警的算术平均值;报告工作流表现时,请使用得出结论所需时间的中位数和 P90。然后代入团队自己的全口径成本、实现系数,以及实际分派给开发人员的告警数量。
漏洞利用验证试点应衡量什么?
漏洞利用验证试点应衡量四项结果:告警处置、得出结论所需时间、证据质量和检测覆盖范围。
不要仅凭告警数量或严重程度分布来评判一个测试平台。告警队列变安静,也可能是检测能力变弱的结果。请针对一组具有代表性的应用、API 和需要身份验证的工作流运行试点,然后跟踪:
- 产生的告警;
- 分派给 AppSec 的告警;
- 分派给开发人员的告警;
- 已确认的漏洞;
- 误报和其他不可操作告警;
- 所有告警的开发人员总工时;
- 每条告警的开发人员平均耗时(算术平均值);
- 得出结论所需时间的中位数和 P90;
- 附带可重放证据的发现所占百分比;
- 从修复到完成验证性重新测试所需的时间;
- 开发人员对发现和修复指导的接受程度;
- 所支持的攻击面和需要身份验证的工作流的覆盖范围;
- 预置的或经独立裁定的阳性用例及其检出率。
按发现类型对这些指标进行细分。一个简单的依赖告警、一条潜在的注入路径和一个多步骤的授权缺陷,其验证成本各不相同。把它们合并成一个平均值可能会掩盖瓶颈所在。
漏洞利用验证测试有哪些局限?
漏洞利用验证测试可能受到以下因素的限制:环境变化、敏感的复现数据、受控测试账户与生产环境影响之间的差距,以及在范围、身份验证或对比条件方面的错误。
因此,一个有实证支撑的工作流至少需要:
- 书面授权和交战规则;
- 明确的范围和禁止的操作;
- 安全的测试身份;
- 速率限制和停止条件;
- 事件联系人;
- 凭据处理;
- 有访问控制的证据保留与删除;
- 由人对高影响决策负责;以及
- 修复后的重新测试。
NIST 的测试指南将技术测试视为一个包含规划、分析发现和制定缓解策略的过程——而不仅仅是生成一份报告。NIST SP 800-115
漏洞利用验证测试的真实 ROI 是什么?
漏洞利用验证的 ROI,是指在交接前证据缩减了复现和事实查明工作后所释放的产能;其财务回报取决于这些产能有多少得到了实际兑现。
误报不仅仅是扫描器质量问题,更是工程产能问题。
衡量进入人工流程的告警、得出结论所需的时间,以及这些时间的全口径成本。然后用一个务实的标准来评估漏洞利用验证测试:
它能否在交接前消除足够多的不确定性,让开发人员把时间花在修复真实风险上,而不是复现扫描器的假设?
这就是证据带来的运营回报:被打断的工程师更少、已确认发现的修复更快,以及一个开发人员可以信任的安全告警队列。
使用 Agentic Deep Scan 运行一次限定范围的漏洞利用验证评估,对象为具有代表性的移动应用及其 API。衡量评估前后得出结论所需的时间以及分派给开发人员的不可操作告警数量——而不仅仅是报告的发现数量。