超高速なPythonコードを書くための戦略
インタープリター型言語であるPythonのパフォーマンスを向上させるさまざまな方法を、実際のベンチマークとともに紹介します。
Pythonは、使いやすさ、シンプルさ、読みやすさから絶大な人気を集めているプログラミング言語です。しかし、その動的な性質のために、ほかの言語と比べると比較的低速です。
大規模なデータセット、計算負荷の高い処理、あるいは素早い応答が求められるリアルタイムアプリケーションを扱う場合、Pythonコードのパフォーマンスは問題になり得ます。また、計算リソースが使用量に応じて課金されるクラウド環境では、遅いコードはアプリケーションの実行コストを押し上げる可能性もあります。
そのため、開発者はPythonコードをより速く実行する方法を常に探し求めています。本記事では、超高速なPythonコードを書くための戦略を探っていきます。
組み込みのAPIやモジュールの活用から、サードパーティのライブラリやツールまで、開発者がPythonコードを超高速にするためのさまざまな方法を取り上げます。
比較のために、ベースとなるスクリプトを用意し、本記事で取り上げる各種ツールや手法とパフォーマンスを比較します。このスクリプトは、画像URLのリストを使ってUnsplashから画像をダウンロードするだけのものです。
# base.py

import requests

IMG_URLS = [
    'https://images.unsplash.com/photo-1681139504760-4c17f2c8b380',
    'https://images.unsplash.com/photo-1661956601031-4cf09efadfce',
    'https://images.unsplash.com/photo-1681138279775-2b407d5d962a',
    'https://images.unsplash.com/photo-1530224264768-7ff8c1789d79',
    'https://images.unsplash.com/photo-1564135624576-c5c88640f235',
    'https://images.unsplash.com/photo-1541698444083-023c97d3f4b6',
    'https://images.unsplash.com/photo-1522364723953-452d3431c267',
    'https://images.unsplash.com/photo-1513938709626-033611b8cc03',
    'https://images.unsplash.com/photo-1507143550189-fed454f93097',
    'https://images.unsplash.com/photo-1504198453319-5ce911bafcde',
    'https://images.unsplash.com/photo-1661956602116-aa6865609028',
    'https://images.unsplash.com/photo-1516972810927-80185027ca84',
    'https://images.unsplash.com/photo-1681105225329-2372f21a59a8',
    'https://images.unsplash.com/photo-1661956601349-f61c959a8fd4'
]


def download_images() -> None:
    for img_url in IMG_URLS:
        img_bytes = requests.get(img_url).content
        img_name = img_url.split('/')[3]
        img_name = f'{img_name}.jpg'
        with open(img_name, 'wb') as img_file:
            img_file.write(img_bytes)
            print(f'{img_name} was downloaded...')
このスクリプトは、最適化を施していない通常のPythonコードです。
ベンチマーク用のスクリプトは次のとおりです。
# benchmark.py

from timeit import timeit

t1 = timeit(
    "download_images()",
    setup="from base import download_images",
    number=1
)
print(f'Finished running base script in {t1} seconds')

t2 = timeit(
    "run_download_images()",
    setup="from threads import run_download_images",
    number=1
)
print(f'Finished running threads script in {t2} seconds')

print(f"Base: {t1:.3f} seconds")
print(f"Threading: {t2:.3f} seconds")
print(f"Threading is  {t1 / t2:.3f}x faster!")
benchmark.pyスクリプトは、各スクリプトのパフォーマンスを計測するために使用します。setup(「from threads import run_download_images」と「from base import download_images」)とstmt(「run_download_images()」と「download_images()」)は、テストする対象に応じて変更します。
1. Pythonの新しいバージョン
Pythonの新しいバージョン、特にPython 3.11(2023年時点)を使うと、以前のバージョンと比べてさまざまなパフォーマンス改善が得られます。Pythonのドキュメントによると、Python 3.11はPython 3.10より10-60%高速で、平均するとPython 3.10の約1.25倍の速さです。
2. スレッド
PythonのThread APIは、スレッドを作成・管理するためのシンプルで効率的な方法を提供します。スレッドを使うと、開発者は複数のタスクを同時に実行でき、コードの実行が速くなります。スレッドはI/Oバウンドなタスク、つまりファイルシステムへの読み書き、APIリクエストの送信、データのダウンロードなど、入出力処理を多く伴うタスクに最適です。これは、スレッドがコードの実行に依然として一つのプロセスしか使わないためです。そのため、より多くのタスクをこなすのには向いていますが、速度を求める用途(たとえばCPUバウンドなタスク、すなわち多くの計算を必要とするタスク)には理想的ではありません。
threadモジュール
Pythonのthreadモジュールは、スレッドを作成・管理するためのシンプルで使いやすいインターフェースを提供します。Pythonでは、スレッドはthreadingモジュールを使って作成され、このモジュールがスレッドの作成と管理のためのクラスを提供しています。
スレッドによるマルチコアの活用
スレッドを使う主な利点の一つは、プログラムがCPUの複数のコアを活用できるようになることです。複数のスレッドを同時に実行することで、開発者は複数のコアの処理能力を利用し、実行時間を短縮できます。スレッドで複数のコアを活用するには、コードが並行して実行されるように設計されていることを確認する必要があります。つまり、各スレッドは互いに干渉することなく、独立したタスクを実行する必要があります。変数やデータ構造などのリソースをスレッド間で共有する必要がある場合は、それらのリソースへのアクセスがスレッドセーフであることを保証しなければなりません。
base.pyのスクリプトを、スレッドを使うスクリプトに変換する方法を見てみましょう。
# threads.py

import requests
import uuid
import concurrent.futures

import base # base.py

def download_image(img_url: str) -> None:
    img_bytes = requests.get(img_url).content
    img_name = f"{img_url.split('/')[3]}{uuid.uuid4()}"
    img_name = f'{img_name}.jpg'
    with open(img_name, 'wb') as img_file:
        img_file.write(img_bytes)
        print(f'{img_name} was downloaded...')


def run_download_images():
    with concurrent.futures.ThreadPoolExecutor() as executor:
        executor.map(download_image, base.IMG_URLS)
上記のコードは、スレッドの処理を担うThreadPoolExecuterを作成しているだけです。
threads.pyとbase.pyのパフォーマンス比較:
benchmark.pyを実行します。
python3.10 benchmark.py
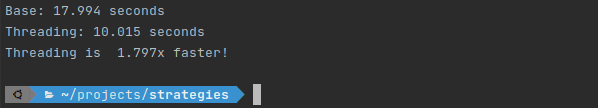
スレッドを使うことで、通常のコードより約1.7倍速く画像をダウンロードできたことがわかります。
スレッドセーフとGIL
Pythonでスレッドを扱う際、スレッドセーフは重要な検討事項です。複数のスレッドが変数やデータ構造などの共有リソースにアクセスすると、競合状態が発生し、予期しない結果につながる可能性があります。 スレッドセーフを確保するには、ロック、セマフォ、バリアなどの同期機構を使う必要があります。これらの機構により、共有リソースに一度にアクセスできるスレッドが一つだけに制限され、競合状態を防げます。
開発者は、グローバルインタープリターロック(GIL)にも注意する必要があります。GILは、一度に一つのスレッドだけがPythonバイトコードを実行できるようにするためにPythonが使用している仕組みです。GILはマルチスレッドプログラムのパフォーマンスを制限することがありますが、Pythonプログラムの一貫性と正しさを確保するうえで不可欠です。
3. マルチプロセッシング
マルチプロセッシングも、CPUの複数のコアを活用するための方法の一つです。スレッドとは異なり、マルチプロセッシングではスレッドの代わりに別々のプロセスを使います。各プロセスはそれぞれ独自のメモリ空間で動作するため、多くの処理能力を必要とするCPUバウンドとI/Oバウンドの両方のタスクに最適です。Pythonではmultiprocessingモジュールのおかげで、マルチプロセッシングを簡単に利用できます。開発者は複数のプロセスを生成して同時に実行させ、コードを高速化できます。
# multiprocessing_example.py

import uuid
import multiprocessing
import requests
import concurrent.futures

import base


def download_image(img_url: str) -> None:
    img_bytes = requests.get(img_url).content
    img_name = f"{img_url.split('/')[3]}{uuid.uuid4()}"
    img_name = f'{img_name}.jpg'
    with open(img_name, 'wb') as img_file:
        img_file.write(img_bytes)
        print(f'{img_name} was downloaded...')


def run_download_images() -> None:
    with concurrent.futures.ProcessPoolExecutor() as executor:
        executor.map(download_image, base.IMG_URLS)
        print(f"Using {len(multiprocessing.active_children())}/{multiprocessing.cpu_count()} CPUs")
multiprocessing_example.pyとbase.pyのパフォーマンス比較:
benchmark.pyを実行します。
python3.10 benchmark.py
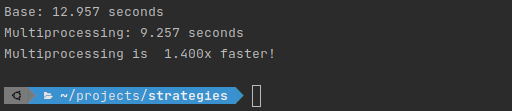
マルチプロセッシングを使うことで、ある程度のパフォーマンス向上が得られたことがわかります。マルチプロセッシングはI/Oバウンドなタスクにも使えますが、CPUバウンドなタスクのほうが適しています。
4. Asyncio
PythonのAsyncioモジュールを使うと、async/await構文で並行処理のコードを書くことができます。Asyncioにより、複数のスレッドやプロセスを使わずに、多数のジョブを同時に処理できるノンブロッキングなコードを作成できます。asyncioが最も適しているのは、外部リソースの応答を待つ必要があるネットワークリクエストなどのI/Oバウンドなタスクです。デバッグが難しい場合もありますが、asyncioはシンプルなので、開発者は低レベルの詳細を気にすることなく並行処理のコードを作成できます。
# asyncio_example.py

import asyncio
import uuid
import aiohttp # the requests library is synchronous, and so we'll use `aiohttp` which works better with asyncio

import base


async def download_image(img_url: str) -> None:
    async with aiohttp.ClientSession() as session:
        async with session.get(img_url) as response:
            img_bytes = await response.read()
    img_name = f"{img_url.split('/')[3]}{uuid.uuid4()}"
    img_name = f'{img_name}.jpg'
    with open(img_name, 'wb') as img_file:
        img_file.write(img_bytes)
        print(f'{img_name} was downloaded...')


async def run_download_images() -> None:
    await asyncio.gather(*[download_image(url) for url in base.IMG_URLS])


def download_images_async() -> None:
    asyncio.run(run_download_images())
asyncio_example.pyとbase.pyのパフォーマンス比較:
benchmark.pyを実行します。
python3.10 benchmark.py
asyncio_example.pyスクリプトの実行には約9.32862888701493秒かかり、base.pyスクリプト(約14.631273603008594秒)より約1.568倍高速でした。
5. Cythonによる並列処理
PythonのスーパーセットであるCythonを使うと、高度に最適化されたCまたはC++のコードに変換できるPythonコードを作成できます。CythonはCの速度を活用して、高性能なPythonプログラムを作成できるようにします。Cythonを使えば、Cに素早く変換できるPythonコードを書くことができます。多くの処理能力を必要とするCPUバウンドなタスクには、Cythonが最適です。Cythonの構文でPythonコードを書き、それをCにコンパイルすることで、より高速に実行できます。
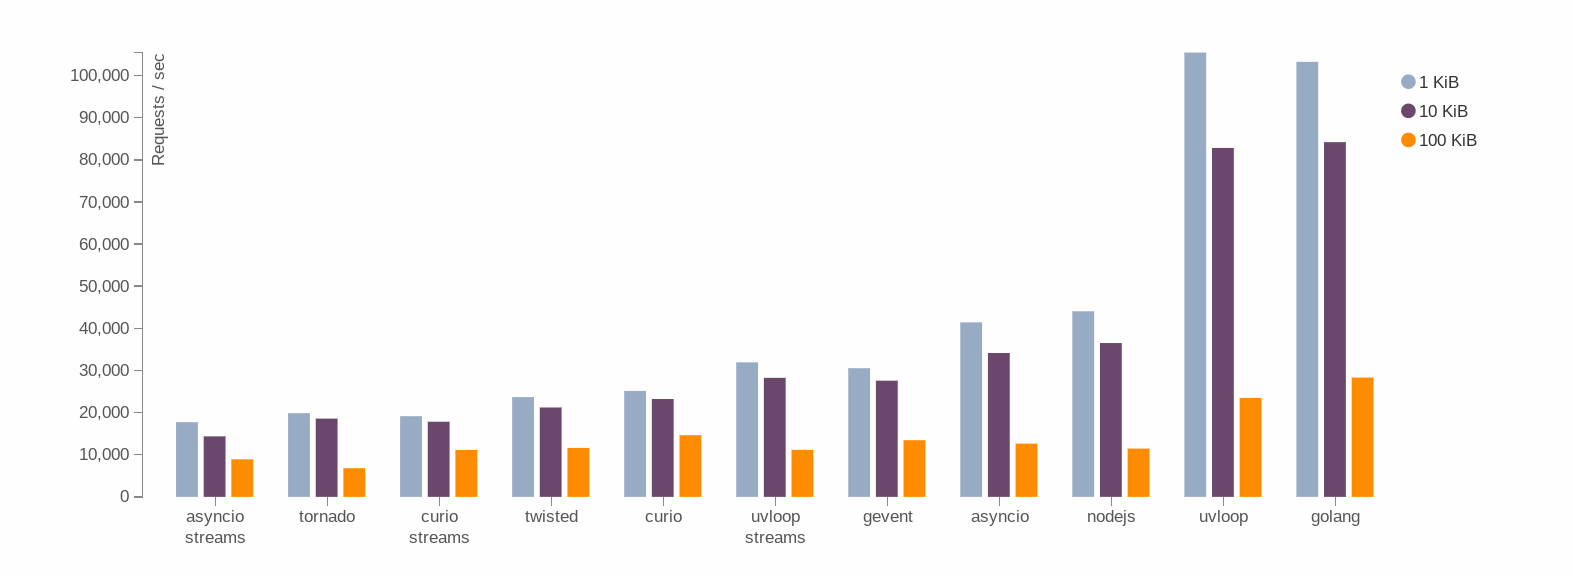
Cythonを使ってPythonを高速化したプロジェクトの実例として、超高速なasyncioイベントループであるuvloopがあります。uvloopを使うと、asyncioは平均で2-4倍高速になります。
Cythonの使い方
Pythonのコードを.pyファイルに書くのと同じように、Cythonのコードは.pyxファイルに書きます。
型宣言
Cythonの主な利点の一つは、変数、関数の引数、戻り値の型を宣言できることです。これにより、Cythonコンパイラーは高度に最適化されたCコードを生成できます。例を示します。
# base.py
import time

def fib(n: int) -> int:
    if n <= 1:
        return n
    else:
        return fib(n - 2) + fib(n - 1)

t0 = time.time()
fib(32)
print(f"Time: {time.time() - t0}")
nの型と戻り値の型はintとして宣言されています。これにより、Cythonコンパイラーはこの関数のために高度に最適化されたCコードを生成できます。
スクリプトはshell python3.10 base.pyコマンドで実行します。関数の実行には約0.37893152236938477秒かかります。
次に、Cythonのコードをテストするために、base.pyのスクリプトをbase_cython.pyxという新しいファイルにコピーします。
続いて、次のコードを含むsetup.pyファイルを作成します。
from setuptools import setup
from Cython.Build import cythonize

setup(
    name='Base script',
    ext_modules=cythonize("base_cython.pyx"),
    zip_safe=False,
)
ビルドするには、shell python setup.py build_ext --inplaceを実行します。
Pythonシェルを起動してshell from base import fibを実行し、スクリプトを実行します。実行には約0.09149384498596191秒かかります。Cythonを使うことで、純粋なPythonコードと比べて約4倍のパフォーマンス向上が得られたことがわかります。
Cライブラリの利用
Cythonを使うと、開発者はPythonコードの中でCライブラリを直接利用できます。これにより、特に計算負荷の高いタスクでは、大幅なパフォーマンス向上が得られる可能性があります。例を示します。
cdef extern from "math.h":
    double sin(double)

def compute_sine(double x):
    return sin(x)
ここでは、math.hというCライブラリのsin関数をPythonコードの中で直接使用しています。これにより、Pythonのmathライブラリと比べて大幅なパフォーマンス向上が得られる可能性があります。
メモリ管理
Cythonでは開発者がメモリを直接管理でき、これにより大幅なパフォーマンス向上が得られる可能性があります。例を示します。
cdef int *arr = <int *>malloc(sizeof(int) * n)

for i in range(n):
    arr[i] = i

free(arr)
上記の例では、C標準ライブラリのmalloc関数を使ってメモリを確保しています。メモリが不要になった後は、free関数を使って解放します。
6. Mypyc
Mypycは、PythonモジュールからCコードを生成するPython向けの静的コンパイラーです。Pythonコードを最適化し、高速化するために使えるツールです。MypycはPythonコードをマシンコードにコンパイルするため、インタープリターで実行されるPythonコードより高速になります。Python 3.5以降に対応しています。
mypycを使うには、mypyをインストールする必要があります(ドキュメントへのリンク)。
Mypycは静的型付けを利用するため、ベーススクリプトを、型付けされたシンプルなフィボナッチ関数を使うものに変更します。
# base.py
import time

def fib(n: int) -> int:
    if n <= 1:
        return n
    else:
        return fib(n - 2) + fib(n - 1)

t0 = time.time()
fib(32)
print(f"Time: {time.time() - t0}")
スクリプトはshell python3.10 base.pyコマンドで実行します。関数の実行には約0.37893152236938477秒かかります。
コードをコンパイルするために、まずコードに型の問題がないかを確認します。
mypy base.py
次に、プログラムをバイナリのC拡張にコンパイルします。
mypyc base.py
コンパイル済みのコードをテストするには、shell python3.10 -c "import base"コマンドを使います。実行には約0.018268108367919922秒かかります。mypycを使うことで、純粋なPythonコードと比べて約20倍のパフォーマンス向上が得られたことがわかります。
コンパイル済みのモジュールをプログラムとして実行するために、python3.10 -cを使用しています。
7. Pypy
Pypyは、Python言語の代替実装です。Python向けのJust-In-Time(JIT)コンパイラーであり、Pythonコードをその場でマシンコードにコンパイルします。PypyはPython 2.7とPython 3.6に対応しています。
PypyはCPUバウンドなタスクでの優れたパフォーマンスで知られています。Pythonコードを最適化するための強力なツールとなる機能をいくつも備えています。たとえば、「JIT特殊化(JIT specialization)」と呼ばれる手法を用いて、コードの中で頻繁に実行される部分のために最適化されたマシンコードを生成します。
Pypyはこちらのリンクからインストールできます。
Pypyを使ってフィボナッチのスクリプトを実行してみましょう。
pypy3 base.py
スクリプトの実行には約0.02586054801940918秒かかり、約0.37893152236938477秒かかったpython3.10での実行より約14.6倍高速でした。
8. Mamba
Mambaは、Pythonのデフォルトのパッケージマネージャーであるpipより高速になるよう設計されたPythonのパッケージマネージャーです。condaのパッケージ形式を使用し、PythonのAnacondaディストリビューションと組み合わせて使えます。パフォーマンス上の利点を実感できるかどうかはパッケージごとに異なります。Mambaでインストールしたパッケージの中には、pipでインストールしたものと同じパフォーマンスしか得られないものもあるためです。
Numpyは、Mambaを使うと最適化されるパッケージの一つです。インストールと設定についてはドキュメントに従ってください。ベーススクリプトを次のように変更します。
import numpy as np
import time

arr1 = np.random.rand(1000000)
arr2 = np.random.rand(1000000)

t0 = time.time()
result = np.dot(arr1, arr2)
print(f"Time taken using mamba: {time.time() - t0}")
pipとmambaのパフォーマンス比較:
pipでnumpyをインストールし、次のようにベーススクリプトを実行します。
# install
pip install numpy
# run
python3.10 base.py
スクリプトの実行には約0.004205226898193359秒かかります。
次に、mambaでnumpyをインストールしてみましょう。
# install
mamba install numpy
# run
python3.10 base.py
今回は、スクリプトの実行にかかった時間は約0.0014407634735107422で、pipより約2.92倍高速でした。
使用しているパッケージがmambaで高度に最適化されていない場合、パフォーマンスの向上はごくわずかにとどまる点に注意してください。
9. ネイティブコード
ネイティブコードとは、コンピューターのプロセッサーが直接実行するマシンコードのことです。ネイティブコードは通常、高水準プログラミング言語をマシンコードに変換するコンパイラーによって生成されます。ネイティブコードは実行時に変換する必要がないため、Pythonコードのようなインタープリター型のコードより高速かつ効率的です。
Pythonでは、PythonコードをネイティブコードにコンパイルするMyPyCやCythonなどのツールを使ってネイティブコードを生成できます。また、CやC++などのほかの言語を使ってネイティブコードを生成し、拡張モジュールを通じてPythonから呼び出すこともできます。
ネイティブコードの利点の一つは、インタープリター型のコードより高速かつ効率的であることです。ネイティブコードは解釈を必要とせずプロセッサーによって直接実行されるため、より速く実行できます。さらに、ネイティブコードは特定のプロセッサーアーキテクチャ向けに最適化できるため、パフォーマンスをさらに向上させられます。
一方で、ネイティブコードの欠点の一つは、インタープリター型のコードと比べて一般に記述やデバッグが難しいことです。ネイティブコードには、より低レベルのプログラミング知識が必要であり、プロセッサーによって直接実行されるためデバッグも難しくなりがちです。
10. Codon
Codonは、実行時にネイティブコードを生成して実行する簡単な方法を提供するPythonライブラリです。Codonを使うと、開発者は実行時にネイティブコードに変換される高水準のPythonコードを書くことができ、インタープリターで実行されるPythonコードより高速かつ効率的になり得ます。
CodonはJust-in-Time(JIT)コンパイルを使ってネイティブコードを生成します。JITコンパイルとは、コードを事前にではなく実行時にコンパイルする手法です。これにより、コンパイラーは特定の実行環境を考慮した最適化されたコードを生成できます。
codonを使うには、まずこちらのリンクからインストールする必要があります。
次のコマンドで、フィボナッチのbase.pyスクリプトを実行できます。
codon run -release base.py
codonを使うと、スクリプトの実行時間はわずか約0.00603247秒で、Python3.10を使った場合(約0.32192111015319824 秒)より約52.48倍高速でした。
Codonの利点の一つは、MyPyCやCythonなどの追加ツールを必要とせずに、ネイティブコードを簡単に生成できることです。また、Codonは高水準のAPIを提供しているため、開発者は新しい言語や構文を学ぶことなくPythonでコードを書けます。
一方で、Codonの欠点の一つは、すべてのユースケースに適しているとは限らないことです。Codonは、数値計算や機械学習など、JITコンパイルの恩恵を受けられるコードに最も適しています。さらに、ユースケースによっては、CodonはMyPyCやCythonなどのほかのネイティブコード生成ツールほど高速ではない場合があります。
ベンチマーク
| ツール | 平均時間(秒) | ベーススクリプト | パフォーマンス |
|---|---|---|---|
| Python3.10 | ~15.19 | base.py (Async) |
- |
| スレッド | ~10.015 | base.py (Async) |
~1.52x |
| マルチプロセッシング | ~9.257 | base.py (Async) |
~1.64x |
| Asyncio | ~9.32 | base.py (Async) |
~1.63x |
| - | - | - | - |
| Python3.11 | ~0.21 | base.py (Fibonacci) |
~1.65x |
| Cython | ~0.09 | base.py (Fibonacci) |
~3.99x |
| Mypyc | ~0.018 | base.py (Fibonacci) |
~19.99x |
| Pypy | ~0.025 | base.py (Fibonacci) |
~14.12x |
| Codon | ~0.006 | base.py (Fibonacci) |
~52.48x |
| - | - | - | - |
| PiP | ~0.004205 | base.py (Numpy) |
- |
| Mamba | ~0.001440 | base.py (Numpy) |
pip比 ~2.92x |
結論として、Pythonコードのパフォーマンスを最適化するために使える戦略やツールはさまざまです。ネイティブコードやCythonは計算負荷の高い処理を大幅に高速化でき、マルチスレッドやマルチプロセッシングはシステムリソースをより有効に活用できるようにします。Mambaパッケージマネージャーを使えば、科学計算向けに最適化されたプログラムをインストールすることもできます。 どのアプローチやツールを使うかは、最終的にはコードで何を実現しようとしているかによって決まります。
ただし、速度の最適化のために可読性や保守性を犠牲にしてはならないことを忘れないことが重要です。たとえパフォーマンス上の利点を多少諦めることになっても、開発者として、明確で簡潔、かつ理解しやすいコードを書くことを目指すべきです。