Stratégies pour écrire du Python ultra-rapide
Dans cet article, nous passons en revue plusieurs façons d'améliorer les performances de Python, un langage interprété.
Python est un langage de programmation très répandu, apprécié pour sa facilité d'utilisation, sa simplicité et sa lisibilité. Cependant, sa nature dynamique le rend relativement lent par rapport à d'autres langages.
Les performances du code Python peuvent devenir un problème lorsqu'on manipule de grands jeux de données, qu'on exécute des tâches de calcul intensif ou qu'on développe des applications temps réel exigeant des réponses rapides. Un code lent peut aussi augmenter le coût d'exécution des applications dans les environnements cloud, où les ressources de calcul sont facturées à l'usage.
Les développeurs cherchent donc sans cesse des moyens d'accélérer leur code Python. Dans cet article, nous explorons des stratégies pour écrire du code Python ultra-rapide.
Cet article présente différentes façons de rendre un code Python ultra-rapide, de l'utilisation des API et modules intégrés aux bibliothèques et outils tiers.
À des fins de comparaison, nous utiliserons un script de référence et comparerons ses performances avec les différents outils ou techniques abordés dans l'article. Le script se contente de télécharger des images depuis Unsplash à partir d'une liste d'URL d'images.
# base.py

import requests

IMG_URLS = [
    'https://images.unsplash.com/photo-1681139504760-4c17f2c8b380',
    'https://images.unsplash.com/photo-1661956601031-4cf09efadfce',
    'https://images.unsplash.com/photo-1681138279775-2b407d5d962a',
    'https://images.unsplash.com/photo-1530224264768-7ff8c1789d79',
    'https://images.unsplash.com/photo-1564135624576-c5c88640f235',
    'https://images.unsplash.com/photo-1541698444083-023c97d3f4b6',
    'https://images.unsplash.com/photo-1522364723953-452d3431c267',
    'https://images.unsplash.com/photo-1513938709626-033611b8cc03',
    'https://images.unsplash.com/photo-1507143550189-fed454f93097',
    'https://images.unsplash.com/photo-1504198453319-5ce911bafcde',
    'https://images.unsplash.com/photo-1661956602116-aa6865609028',
    'https://images.unsplash.com/photo-1516972810927-80185027ca84',
    'https://images.unsplash.com/photo-1681105225329-2372f21a59a8',
    'https://images.unsplash.com/photo-1661956601349-f61c959a8fd4'
]


def download_images() -> None:
    for img_url in IMG_URLS:
        img_bytes = requests.get(img_url).content
        img_name = img_url.split('/')[3]
        img_name = f'{img_name}.jpg'
        with open(img_name, 'wb') as img_file:
            img_file.write(img_bytes)
            print(f'{img_name} was downloaded...')
Ce script est du code Python ordinaire, qui n'a pas été optimisé.
Le script de benchmark :
# benchmark.py

from timeit import timeit

t1 = timeit(
    "download_images()",
    setup="from base import download_images",
    number=1
)
print(f'Finished running base script in {t1} seconds')

t2 = timeit(
    "run_download_images()",
    setup="from threads import run_download_images",
    number=1
)
print(f'Finished running threads script in {t2} seconds')

print(f"Base: {t1:.3f} seconds")
print(f"Threading: {t2:.3f} seconds")
print(f"Threading is  {t1 / t2:.3f}x faster!")
Le script benchmark.py servira à mesurer les performances de nos scripts. Les paramètres setup (« from threads import run_download_images » et « from base import download_images ») et stmt (« run_download_images() » et « download_images() ») changeront selon ce que nous testons.
1. Les versions récentes de Python
Utiliser des versions récentes de Python, en particulier Python 3.11 (en 2023), apporte plusieurs améliorations de performances par rapport aux versions précédentes. Selon la documentation de Python, Python 3.11 est de 10 à 60 % plus rapide que Python 3.10 et, en moyenne, environ 1.25x plus rapide que Python 3.10.
2. Les threads
L'API Thread de Python offre un moyen simple et efficace de créer et de gérer des threads. Avec les threads, les développeurs peuvent exécuter plusieurs tâches simultanément, ce qui accélère l'exécution du code. Les threads conviennent parfaitement aux tâches liées aux entrées/sorties (I/O bound), c'est-à-dire celles qui impliquent de nombreuses opérations d'entrée et de sortie, comme la lecture et l'écriture dans le système de fichiers, les requêtes d'API et le téléchargement de données. En effet, les threads utilisent toujours un seul processus pour exécuter le code : s'ils permettent d'effectuer davantage de tâches, ils ne sont pas idéaux pour la vitesse (par exemple pour les tâches liées au processeur, c'est-à-dire celles qui demandent beaucoup de calcul).
Le module thread
Le module thread de Python fournit une interface simple et facile à utiliser pour créer et gérer des threads. En Python, les threads sont créés avec le module threading, qui fournit des classes pour créer et gérer des threads.
Exploiter plusieurs cœurs avec les threads
L'un des principaux avantages des threads est qu'ils permettent à un programme de tirer parti de plusieurs cœurs d'un processeur. En exécutant plusieurs threads simultanément, les développeurs peuvent utiliser la puissance de traitement de plusieurs cœurs et obtenir des temps d'exécution plus courts. Pour tirer parti de plusieurs cœurs avec des threads, les développeurs doivent s'assurer que leur code est conçu pour s'exécuter de manière concurrente. Cela signifie que les threads doivent effectuer des tâches indépendantes, sans interférer les uns avec les autres. Si les threads doivent partager des ressources, comme des variables ou des structures de données, les développeurs doivent veiller à ce que l'accès à ces ressources soit thread-safe.
Voyons comment convertir le script de base.py en un script qui utilise des threads.
# threads.py

import requests
import uuid
import concurrent.futures

import base # base.py

def download_image(img_url: str) -> None:
    img_bytes = requests.get(img_url).content
    img_name = f"{img_url.split('/')[3]}{uuid.uuid4()}"
    img_name = f'{img_name}.jpg'
    with open(img_name, 'wb') as img_file:
        img_file.write(img_bytes)
        print(f'{img_name} was downloaded...')


def run_download_images():
    with concurrent.futures.ThreadPoolExecutor() as executor:
        executor.map(download_image, base.IMG_URLS)
Le code ci-dessus se contente de créer un ThreadPoolExecuter qui se charge de gérer les threads.
Performances de threads.py par rapport à base.py :
Exécutez benchmark.py :
python3.10 benchmark.py
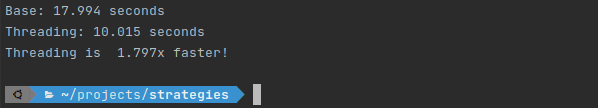
Nous constatons que l'utilisation de threads nous a permis de télécharger les images ~1.7x plus vite qu'avec le code normal.
Thread safety et GIL
La sécurité des threads (thread safety) est un point essentiel lorsqu'on travaille avec des threads en Python. Quand plusieurs threads accèdent à des ressources partagées, comme des variables ou des structures de données, ils peuvent créer des situations de concurrence (race conditions), qui conduisent à des résultats inattendus. Pour garantir la sécurité des threads, les développeurs doivent recourir à des mécanismes de synchronisation tels que les verrous (locks), les sémaphores et les barrières. Ces mécanismes garantissent qu'un seul thread à la fois peut accéder à une ressource partagée, ce qui évite les situations de concurrence.
Les développeurs doivent aussi connaître le verrou global de l'interpréteur (GIL, global interpreter lock), un mécanisme utilisé par Python pour garantir qu'un seul thread peut exécuter du bytecode Python à la fois. Si le GIL peut limiter les performances des programmes multithreads, il est essentiel pour garantir la cohérence et la correction des programmes Python.
3. Le multiprocessing
Le multiprocessing est une autre façon de tirer parti de plusieurs cœurs d'un processeur. Contrairement aux threads, le multiprocessing utilise des processus distincts. Chaque processus s'exécute dans son propre espace mémoire, ce qui le rend idéal à la fois pour les tâches liées au processeur et pour les tâches liées aux I/O qui demandent beaucoup de puissance de traitement. Le multiprocessing est facile à utiliser en Python grâce au module multiprocessing. Les développeurs peuvent lancer plusieurs processus qui s'exécutent simultanément, ce qui accélère leur code.
# multiprocessing_example.py

import uuid
import multiprocessing
import requests
import concurrent.futures

import base


def download_image(img_url: str) -> None:
    img_bytes = requests.get(img_url).content
    img_name = f"{img_url.split('/')[3]}{uuid.uuid4()}"
    img_name = f'{img_name}.jpg'
    with open(img_name, 'wb') as img_file:
        img_file.write(img_bytes)
        print(f'{img_name} was downloaded...')


def run_download_images() -> None:
    with concurrent.futures.ProcessPoolExecutor() as executor:
        executor.map(download_image, base.IMG_URLS)
        print(f"Using {len(multiprocessing.active_children())}/{multiprocessing.cpu_count()} CPUs")
Performances de multiprocessing_example.py par rapport à base.py :
Exécutez benchmark.py :
python3.10 benchmark.py
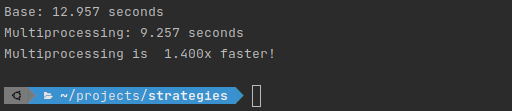
Nous constatons que le multiprocessing a apporté quelques gains de performances. Même s'il peut servir pour des tâches liées aux I/O, il convient mieux aux tâches liées au processeur.
4. Asyncio
Le module Asyncio de Python permet d'écrire du code concurrent avec la syntaxe async/await. Asyncio permet aux programmeurs de créer du code non bloquant, capable de gérer de nombreuses tâches à la fois sans recourir à plusieurs threads ou processus. Les tâches liées aux I/O, comme les requêtes réseau, qui nécessitent d'attendre la réponse de ressources externes, sont celles pour lesquelles asyncio convient le mieux. Grâce à la simplicité d'asyncio, les développeurs peuvent écrire du code concurrent sans se soucier des détails de bas niveau, même si le débogage peut parfois être difficile.
# asyncio_example.py

import asyncio
import uuid
import aiohttp # the requests library is synchronous, and so we'll use `aiohttp` which works better with asyncio

import base


async def download_image(img_url: str) -> None:
    async with aiohttp.ClientSession() as session:
        async with session.get(img_url) as response:
            img_bytes = await response.read()
    img_name = f"{img_url.split('/')[3]}{uuid.uuid4()}"
    img_name = f'{img_name}.jpg'
    with open(img_name, 'wb') as img_file:
        img_file.write(img_bytes)
        print(f'{img_name} was downloaded...')


async def run_download_images() -> None:
    await asyncio.gather(*[download_image(url) for url in base.IMG_URLS])


def download_images_async() -> None:
    asyncio.run(run_download_images())
Performances de asyncio_example.py par rapport à base.py :
Exécutez benchmark.py :
python3.10 benchmark.py
Le script asyncio_example.py a mis ~9.32862888701493 secondes à s'exécuter, soit ~1.568x plus vite que le script base.py (~14.631273603008594 secondes).
5. Le parallélisme avec Cython
Les développeurs peuvent créer du code Python convertible en code C ou C++ hautement optimisé grâce à Cython, un sur-ensemble de Python. Cython exploite la vitesse du C pour créer des programmes Python très performants. Avec Cython, les programmeurs peuvent écrire du code Python qui se convertit rapidement en C. Pour les tâches liées au processeur et très gourmandes en capacité de traitement, Cython est parfait. On peut écrire du code Python avec la syntaxe de Cython, puis le compiler en C pour qu'il s'exécute plus vite.
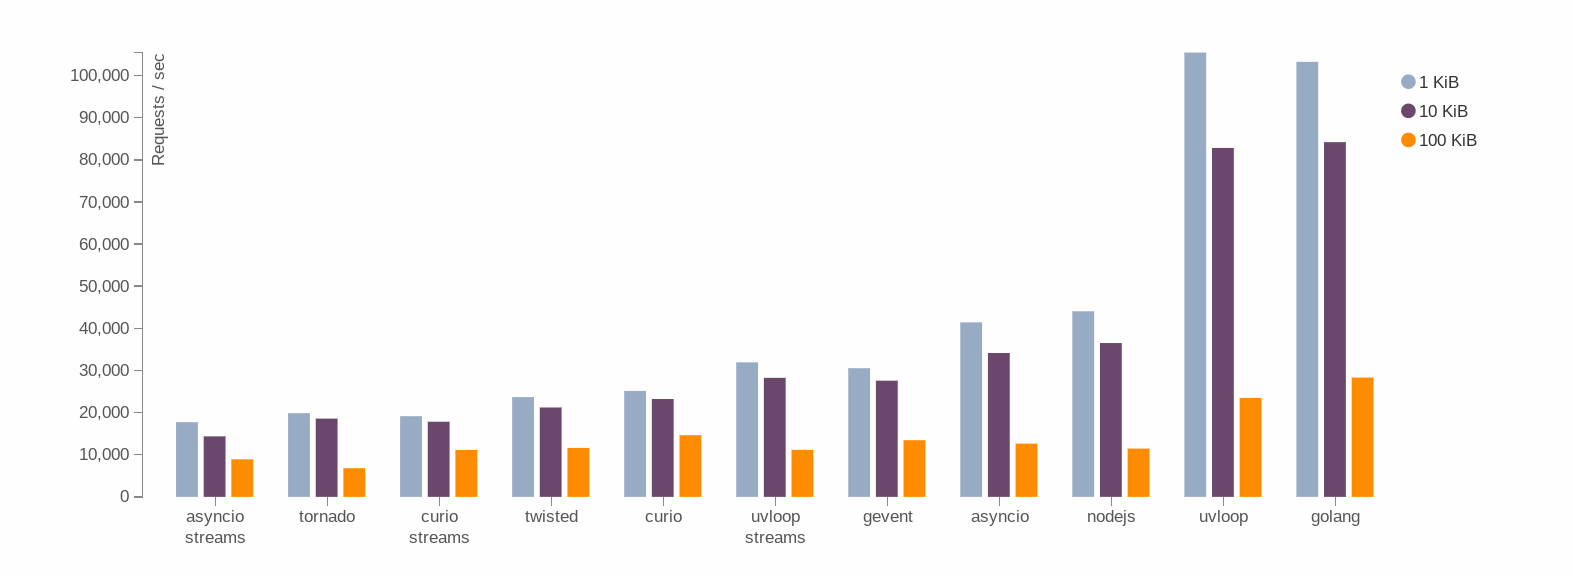
uvloop, une boucle d'événements asyncio ultra rapide, est un exemple concret de projet qui a utilisé Cython pour accélérer Python. En moyenne, uvloop rend asyncio 2 à 4x plus rapide.
Utiliser Cython
De la même façon que le code Python s'écrit dans des fichiers .py, le code Cython s'écrit dans des fichiers .pyx.
Déclarations de types
L'un des principaux avantages de Cython est la possibilité de déclarer les types des variables, des arguments de fonction et des valeurs de retour. Cela permet au compilateur Cython de générer du code C hautement optimisé. Par exemple :
# base.py
import time

def fib(n: int) -> int:
    if n <= 1:
        return n
    else:
        return fib(n - 2) + fib(n - 1)

t0 = time.time()
fib(32)
print(f"Time: {time.time() - t0}")
Le type de n et le type de retour sont déclarés comme int. Cela permet au compilateur Cython de générer du code C hautement optimisé pour la fonction.
Exécutez le script avec la commande shell python3.10 base.py. L'exécution de la fonction prend ~0.37893152236938477 secondes.
Pour tester notre code Cython, copiez maintenant le script de base.py dans un nouveau fichier nommé base_cython.pyx
Ensuite, nous créons un fichier setup.py avec le code suivant :
from setuptools import setup
from Cython.Build import cythonize

setup(
    name='Base script',
    ext_modules=cythonize("base_cython.pyx"),
    zip_safe=False,
)
Pour compiler, exécutez shell python setup.py build_ext --inplace.
Exécutez le script en démarrant un shell Python et en saisissant shell from base import fib. L'exécution prend ~0.09149384498596191 secondes. Avec Cython, nous obtenons un gain de performances de ~4x par rapport au code Python pur.
Utiliser des bibliothèques C
Cython permet aux développeurs d'utiliser directement des bibliothèques C dans leur code Python. Cela peut se traduire par des gains de performances importants, en particulier pour les tâches de calcul intensif. Par exemple :
cdef extern from "math.h":
    double sin(double)

def compute_sine(double x):
    return sin(x)
La fonction sin de la bibliothèque C math.h est utilisée directement dans le code Python. Cela peut apporter des gains de performances importants par rapport à la bibliothèque math de Python.
Gestion de la mémoire
Cython permet aux développeurs de gérer directement la mémoire, ce qui peut apporter des gains de performances importants. Par exemple :
cdef int *arr = <int *>malloc(sizeof(int) * n)

for i in range(n):
    arr[i] = i

free(arr)
Dans l'exemple ci-dessus, la mémoire est allouée avec la fonction malloc de la bibliothèque standard C. La fonction free sert à libérer la mémoire lorsqu'elle n'est plus nécessaire.
6. Mypyc
Mypyc est un compilateur statique pour Python qui génère du code C à partir de modules Python. C'est un outil qui permet d'optimiser et d'accélérer du code Python. Mypyc compile le code Python en code machine, ce qui le rend plus rapide que du code Python interprété. Il est compatible avec Python 3.5 et les versions ultérieures.
Pour utiliser mypyc, vous devez installer mypy (lien vers la documentation)
Comme Mypyc s'appuie sur le typage statique, nous modifions notre script de base pour utiliser une simple fonction de Fibonacci typée :
# base.py
import time

def fib(n: int) -> int:
    if n <= 1:
        return n
    else:
        return fib(n - 2) + fib(n - 1)

t0 = time.time()
fib(32)
print(f"Time: {time.time() - t0}")
Exécutez le script avec la commande shell python3.10 base.py. L'exécution de la fonction prend ~0.37893152236938477 secondes.
Pour compiler notre code, nous vérifions d'abord qu'il ne contient aucun problème de typage.
mypy base.py
Ensuite, nous compilons le programme en extension C binaire.
mypyc base.py
Pour tester notre code compilé, nous utilisons la commande shell python3.10 -c "import base", qui s'exécute en environ ~0.018268108367919922 secondes. Avec mypyc, nous obtenons un gain de performances de ~20x par rapport au code Python pur.
Nous utilisons python3.10 -c pour exécuter le module compilé comme un programme.
7. Pypy
Pypy est une implémentation alternative du langage Python. C'est un compilateur à la volée (JIT, Just-In-Time) pour Python, ce qui signifie qu'il compile le code Python en code machine au fil de l'exécution. Pypy est compatible avec Python 2.7 et Python 3.6.
Pypy est reconnu pour ses excellentes performances sur les tâches liées au processeur. Il offre plusieurs fonctionnalités qui en font un outil puissant pour optimiser le code Python. Par exemple, il utilise une technique appelée « JIT specialization » pour générer du code machine optimisé pour les parties du code les plus fréquemment exécutées.
Vous pouvez installer Pypy à partir de ce lien
Utilisons Pypy pour exécuter notre script de Fibonacci :
pypy3 base.py
Le script s'exécute en ~0.02586054801940918 secondes, soit ~14.6x plus vite qu'avec python3.10, qui a mis environ 0.37893152236938477 secondes.
8. Mamba
Mamba est un gestionnaire de paquets Python conçu pour être plus rapide que le gestionnaire de paquets Python par défaut, pip. Il utilise le format de paquet conda et peut s'utiliser avec la distribution Anaconda de Python. Que vous constatiez ou non un gain de performances dépendra de chaque paquet, car certains paquets installés avec Mamba peuvent offrir les mêmes performances que ceux installés avec pip.
Numpy est l'un des paquets optimisés lorsqu'on utilise Mamba. Pour l'installer et le configurer, suivez la documentation. Nous modifions notre script de base ainsi :
import numpy as np
import time

arr1 = np.random.rand(1000000)
arr2 = np.random.rand(1000000)

t0 = time.time()
result = np.dot(arr1, arr2)
print(f"Time taken using mamba: {time.time() - t0}")
Performances de pip par rapport à mamba :
Installez numpy avec pip et exécutez le script de base comme suit :
# install
pip install numpy
# run
python3.10 base.py
Le script s'exécute en ~0.004205226898193359 secondes.
Installons maintenant numpy avec mamba :
# install
mamba install numpy
# run
python3.10 base.py
Cette fois, le script s'exécute en ~0.0014407634735107422, soit ~2.92x plus vite qu'avec pip.
Il est important de noter que si les paquets que vous utilisez ne sont pas très optimisés dans mamba, vous constaterez des gains de performances très faibles.
9. Le code natif
Le code natif désigne du code machine exécuté directement par le processeur d'un ordinateur. Il est généralement produit par un compilateur qui traduit des langages de programmation de haut niveau en code machine. Le code natif est plus rapide et plus efficace que le code interprété, comme le code Python, car il n'a pas besoin d'être traduit à l'exécution.
En Python, du code natif peut être généré avec des outils tels que MyPyC et Cython, qui compilent du code Python en code natif. Il peut aussi être produit à partir d'autres langages, comme C ou C++, appelés depuis Python via des modules d'extension.
L'un des avantages du code natif est qu'il est plus rapide et plus efficace que le code interprété. Il peut s'exécuter plus vite parce que le processeur l'exécute directement, sans interprétation. De plus, le code natif peut être optimisé pour une architecture de processeur donnée, ce qui peut encore améliorer les performances.
En revanche, l'un des inconvénients du code natif est qu'il est généralement plus difficile à écrire et à déboguer que le code interprété. Il demande davantage de connaissances en programmation de bas niveau et peut être plus difficile à déboguer, car il est exécuté directement par le processeur.
10. Codon
Codon est une bibliothèque Python qui offre un moyen simple de générer et d'exécuter du code natif à l'exécution. Codon permet aux développeurs d'écrire du code Python de haut niveau qui est traduit en code natif à l'exécution, ce qui peut être plus rapide et plus efficace que du code Python interprété.
Codon utilise la compilation à la volée (JIT, Just-in-Time) pour générer du code natif. La compilation JIT est une technique dans laquelle le code est compilé à l'exécution plutôt qu'à l'avance. Cela permet au compilateur de générer du code optimisé qui tient compte de l'environnement d'exécution précis.
Pour utiliser codon, vous devez d'abord l'installer à partir de ce lien.
Nous pouvons exécuter notre script de Fibonacci base.py avec la commande suivante :
codon run -release base.py
Avec codon, notre script n'a pris que ~0.00603247 secondes, soit ~52.48 fois plus vite qu'avec Python3.10 (~0.32192111015319824 secondes)
L'un des avantages de Codon est qu'il offre un moyen simple de générer du code natif sans outils supplémentaires, comme MyPyC ou Cython. Codon fournit aussi une API de haut niveau qui permet aux développeurs d'écrire du code en Python, sans avoir à apprendre un nouveau langage ou une nouvelle syntaxe.
En revanche, l'un des inconvénients de Codon est qu'il peut ne pas convenir à tous les cas d'usage. Codon est surtout adapté au code qui peut bénéficier de la compilation JIT, comme le calcul numérique ou le machine learning. De plus, Codon peut ne pas être aussi rapide que d'autres outils de génération de code natif, comme MyPyC ou Cython, dans certains cas d'usage.
Benchmarks
| Outil | Temps moyen (secs) | Script de base | Performances |
|---|---|---|---|
| Python3.10 | ~15.19 | base.py (Async) |
- |
| Threads | ~10.015 | base.py (Async) |
~1.52x |
| Multiprocessing | ~9.257 | base.py (Async) |
~1.64x |
| Asyncio | ~9.32 | base.py (Async) |
~1.63x |
| - | - | - | - |
| Python3.11 | ~0.21 | base.py (Fibonacci) |
~1.65x |
| Cython | ~0.09 | base.py (Fibonacci) |
~3.99x |
| Mypyc | ~0.018 | base.py (Fibonacci) |
~19.99x |
| Pypy | ~0.025 | base.py (Fibonacci) |
~14.12x |
| Codon | ~0.006 | base.py (Fibonacci) |
~52.48x |
| - | - | - | - |
| PiP | ~0.004205 | base.py (Numpy) |
- |
| Mamba | ~0.001440 | base.py (Numpy) |
~2.92x vs pip |
En conclusion, il existe diverses stratégies et divers outils pour optimiser les performances du code Python. Si le code natif et Cython peuvent accélérer considérablement les activités de calcul intensif, le multithreading et le multiprocessing permettent une meilleure utilisation des ressources système. Il est également possible d'installer des programmes optimisés pour le calcul scientifique avec le gestionnaire de paquets Mamba. L'approche ou l'outil que vous choisirez dépendra, en définitive, de ce que votre code cherche à accomplir.
Il est toutefois essentiel de se rappeler que la lisibilité et la maintenabilité ne doivent pas pâtir de l'optimisation de la vitesse. Même si cela implique de renoncer à certains gains de performances, nous devrions, en tant que développeurs, viser un code clair, concis et facile à comprendre.