Estrategias para escribir Python superrápido
En este artículo analizamos diferentes formas de mejorar el rendimiento de Python, un lenguaje interpretado.
Python es un lenguaje de programación popular que ha ganado una enorme popularidad gracias a su facilidad de uso, su sencillez y su legibilidad. Sin embargo, su naturaleza dinámica lo hace relativamente lento en comparación con otros lenguajes.
El rendimiento del código Python puede convertirse en un problema al trabajar con grandes conjuntos de datos, tareas de cálculo intensivo o aplicaciones en tiempo real que requieren respuestas rápidas. El código lento también puede aumentar el coste de ejecutar aplicaciones en entornos de nube, donde los recursos de cómputo se cobran según el uso.
Por ello, los desarrolladores buscan constantemente formas de que su código Python se ejecute más rápido. En este artículo exploraremos estrategias para escribir código Python superrápido.
Este artículo explora diferentes maneras en que los desarrolladores pueden hacer que su código Python sea superrápido, desde aprovechar las API y los módulos integrados hasta las bibliotecas y herramientas de terceros.
A efectos de comparación, usaremos un script base y compararemos su rendimiento con las distintas herramientas o técnicas que se tratan en el artículo. El script simplemente descarga imágenes de Unsplash a partir de una lista de URL de imágenes.
# base.py

import requests

IMG_URLS = [
    'https://images.unsplash.com/photo-1681139504760-4c17f2c8b380',
    'https://images.unsplash.com/photo-1661956601031-4cf09efadfce',
    'https://images.unsplash.com/photo-1681138279775-2b407d5d962a',
    'https://images.unsplash.com/photo-1530224264768-7ff8c1789d79',
    'https://images.unsplash.com/photo-1564135624576-c5c88640f235',
    'https://images.unsplash.com/photo-1541698444083-023c97d3f4b6',
    'https://images.unsplash.com/photo-1522364723953-452d3431c267',
    'https://images.unsplash.com/photo-1513938709626-033611b8cc03',
    'https://images.unsplash.com/photo-1507143550189-fed454f93097',
    'https://images.unsplash.com/photo-1504198453319-5ce911bafcde',
    'https://images.unsplash.com/photo-1661956602116-aa6865609028',
    'https://images.unsplash.com/photo-1516972810927-80185027ca84',
    'https://images.unsplash.com/photo-1681105225329-2372f21a59a8',
    'https://images.unsplash.com/photo-1661956601349-f61c959a8fd4'
]


def download_images() -> None:
    for img_url in IMG_URLS:
        img_bytes = requests.get(img_url).content
        img_name = img_url.split('/')[3]
        img_name = f'{img_name}.jpg'
        with open(img_name, 'wb') as img_file:
            img_file.write(img_bytes)
            print(f'{img_name} was downloaded...')
El script es código Python normal que no se ha optimizado.
El script de benchmark:
# benchmark.py

from timeit import timeit

t1 = timeit(
    "download_images()",
    setup="from base import download_images",
    number=1
)
print(f'Finished running base script in {t1} seconds')

t2 = timeit(
    "run_download_images()",
    setup="from threads import run_download_images",
    number=1
)
print(f'Finished running threads script in {t2} seconds')

print(f"Base: {t1:.3f} seconds")
print(f"Threading: {t2:.3f} seconds")
print(f"Threading is  {t1 / t2:.3f}x faster!")
El script benchmark.py se utilizará para medir el rendimiento de nuestros scripts. El setup (‘from threads import run_download_images’ y ‘from base import download_images’) y el stmt (‘run_download_images()’ y ‘download_images()’) cambiarán según lo que estemos probando.
1. Versiones más recientes de Python
Ejecutar versiones más recientes de Python, en especial Python 3.11 (a fecha de 2023), aporta varias mejoras de rendimiento respecto a las versiones anteriores de Python. Según la documentación de Python, Python 3.11 es entre un 10-60% más rápido que Python 3.10 y, de media, es aproximadamente 1.25x más rápido que Python 3.10.
2. Hilos
La API Thread de Python ofrece una forma sencilla y eficiente de crear y gestionar hilos. Con los hilos, los desarrolladores pueden ejecutar varias tareas de forma simultánea, lo que acelera la ejecución del código. Los hilos son ideales para tareas limitadas por E/S, es decir, tareas que implican muchas operaciones de entrada y salida, como leer o escribir en el sistema de archivos, hacer solicitudes a API y descargar datos. Esto se debe a que los hilos siguen utilizando un único proceso para ejecutar el código y, por tanto, aunque son buenos para hacer más tareas, no son ideales para ganar velocidad (por ejemplo, en tareas limitadas por CPU, es decir, tareas que requieren mucho cálculo).
El módulo de hilos
El módulo de hilos de Python ofrece una interfaz sencilla y fácil de usar para crear y gestionar hilos. En Python, los hilos se crean con el módulo threading, que proporciona clases para crear y gestionar hilos.
Aprovechar varios núcleos con hilos
Una de las principales ventajas de usar hilos es que permiten a un programa aprovechar varios núcleos de una CPU. Al ejecutar varios hilos de forma simultánea, los desarrolladores pueden utilizar la potencia de procesamiento de varios núcleos y conseguir tiempos de ejecución más rápidos. Para aprovechar varios núcleos con hilos, los desarrolladores deben asegurarse de que su código esté diseñado para ejecutarse de forma concurrente. Esto significa que los hilos deben realizar tareas independientes, sin interferir entre sí. Si los hilos necesitan compartir recursos, como variables o estructuras de datos, los desarrolladores deben asegurarse de que el acceso a esos recursos sea seguro para hilos (thread-safe).
Veamos cómo podemos convertir el script de base.py en uno que utilice hilos.
# threads.py

import requests
import uuid
import concurrent.futures

import base # base.py

def download_image(img_url: str) -> None:
    img_bytes = requests.get(img_url).content
    img_name = f"{img_url.split('/')[3]}{uuid.uuid4()}"
    img_name = f'{img_name}.jpg'
    with open(img_name, 'wb') as img_file:
        img_file.write(img_bytes)
        print(f'{img_name} was downloaded...')


def run_download_images():
    with concurrent.futures.ThreadPoolExecutor() as executor:
        executor.map(download_image, base.IMG_URLS)
El código anterior simplemente crea un ThreadPoolExecuter que se encarga de gestionar los hilos.
Rendimiento de threads.py frente a base.py:
Ejecute benchmark.py:
python3.10 benchmark.py
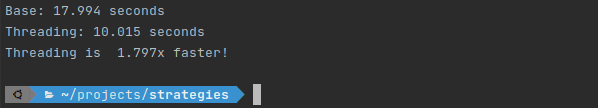
Podemos ver que el uso de hilos nos permitió descargar las imágenes ~1.7x más rápido que con el código normal.
Seguridad de hilos y el GIL
La seguridad de hilos es una consideración fundamental al trabajar con hilos en Python. Cuando varios hilos acceden a recursos compartidos, como variables o estructuras de datos, pueden crear condiciones de carrera, que pueden provocar resultados inesperados. Para garantizar la seguridad de hilos, los desarrolladores deben utilizar mecanismos de sincronización como bloqueos, semáforos y barreras. Estos mecanismos garantizan que solo un hilo pueda acceder a un recurso compartido a la vez, lo que evita las condiciones de carrera.
Los desarrolladores también deben conocer el bloqueo global del intérprete (GIL), un mecanismo que utiliza Python para garantizar que solo un hilo pueda ejecutar bytecode de Python a la vez. Aunque el GIL puede limitar el rendimiento de los programas con hilos, es esencial para garantizar la coherencia y la corrección de los programas de Python.
3. Multiprocesamiento
El multiprocesamiento es otra forma de aprovechar varios núcleos de una CPU. A diferencia de los hilos, el multiprocesamiento utiliza procesos independientes en lugar de hilos. Cada proceso se ejecuta en su propio espacio de memoria, lo que lo hace ideal tanto para tareas limitadas por CPU como por E/S que requieren mucha potencia de procesamiento. El multiprocesamiento es fácil de usar en Python gracias al módulo multiprocessing. Los desarrolladores pueden lanzar varios procesos que se ejecuten de forma simultánea y hacer así que su código se ejecute más rápido.
# multiprocessing_example.py

import uuid
import multiprocessing
import requests
import concurrent.futures

import base


def download_image(img_url: str) -> None:
    img_bytes = requests.get(img_url).content
    img_name = f"{img_url.split('/')[3]}{uuid.uuid4()}"
    img_name = f'{img_name}.jpg'
    with open(img_name, 'wb') as img_file:
        img_file.write(img_bytes)
        print(f'{img_name} was downloaded...')


def run_download_images() -> None:
    with concurrent.futures.ProcessPoolExecutor() as executor:
        executor.map(download_image, base.IMG_URLS)
        print(f"Using {len(multiprocessing.active_children())}/{multiprocessing.cpu_count()} CPUs")
Rendimiento de multiprocessing_example.py frente a base.py:
Ejecute benchmark.py:
python3.10 benchmark.py
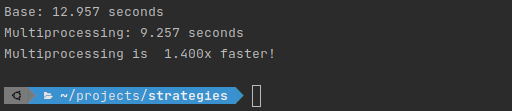
Podemos ver que sí obtuvimos algunos beneficios de rendimiento con el multiprocesamiento. Aunque el multiprocesamiento puede utilizarse para tareas limitadas por E/S, es más adecuado para tareas limitadas por CPU.
4. Asyncio
El módulo Asyncio de Python permite escribir código concurrente con la sintaxis async/await. Asyncio permite a los programadores crear código no bloqueante capaz de gestionar numerosos trabajos a la vez sin utilizar varios hilos o procesos. Las tareas limitadas por E/S, como las solicitudes de red, que necesitan esperar la respuesta de recursos externos, son las más adecuadas para asyncio. Gracias a la sencillez de asyncio, los desarrolladores pueden crear código concurrente sin preocuparse por los detalles de bajo nivel, aunque a veces depurar los problemas puede ser difícil.
# asyncio_example.py

import asyncio
import uuid
import aiohttp # the requests library is synchronous, and so we'll use `aiohttp` which works better with asyncio

import base


async def download_image(img_url: str) -> None:
    async with aiohttp.ClientSession() as session:
        async with session.get(img_url) as response:
            img_bytes = await response.read()
    img_name = f"{img_url.split('/')[3]}{uuid.uuid4()}"
    img_name = f'{img_name}.jpg'
    with open(img_name, 'wb') as img_file:
        img_file.write(img_bytes)
        print(f'{img_name} was downloaded...')


async def run_download_images() -> None:
    await asyncio.gather(*[download_image(url) for url in base.IMG_URLS])


def download_images_async() -> None:
    asyncio.run(run_download_images())
Rendimiento de asyncio_example.py frente a base.py:
Ejecute benchmark.py:
python3.10 benchmark.py
El script asyncio_example.py tardó ~9.32862888701493 segundos en ejecutarse, ~1.568x más rápido que el script base.py (~14.631273603008594 segundos).
5. Paralelismo con Cython
Los desarrolladores pueden crear código Python que se convierta en código C o C++ altamente optimizado mediante Cython, un superconjunto de Python. Cython utiliza la velocidad de C para permitir la creación de programas Python de alto rendimiento. Con Cython, los programadores pueden crear código Python que se convierte rápidamente a C. Para las tareas limitadas por CPU y que exigen mucha capacidad de procesamiento, Cython es perfecto. El código Python puede escribirse con la sintaxis de Cython y luego compilarse a C para que se ejecute más rápido.
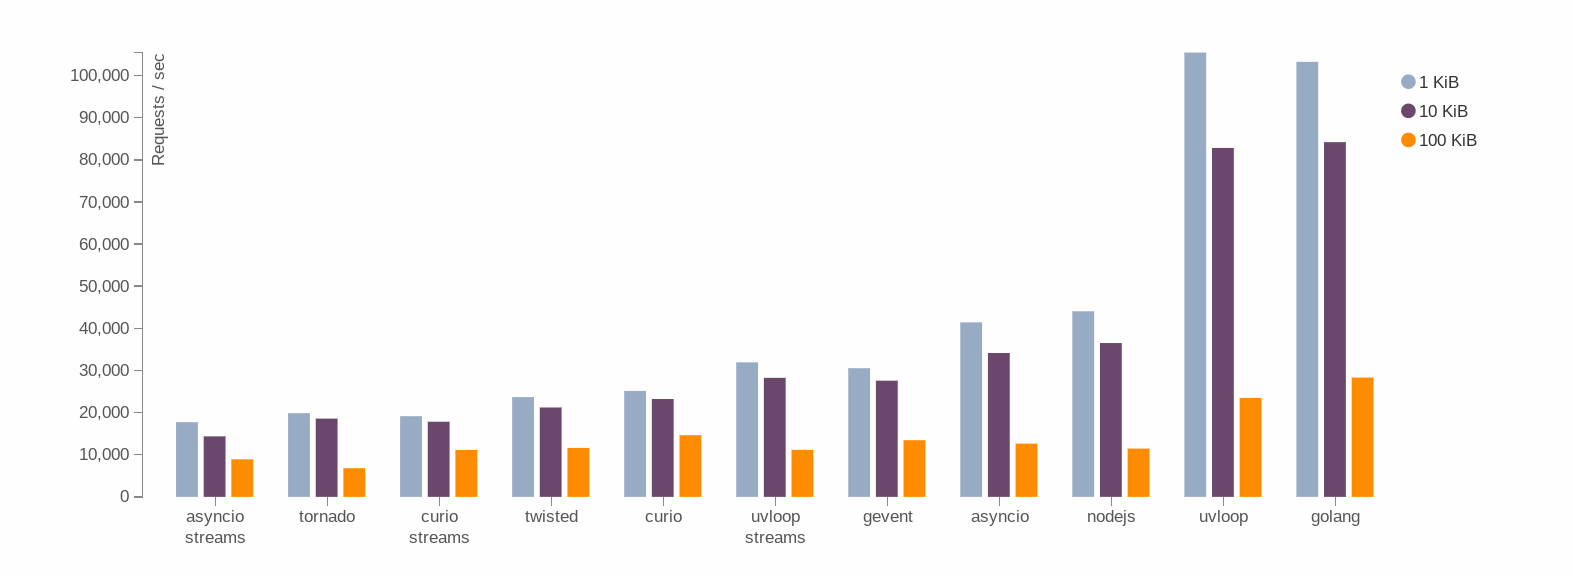
Un ejemplo práctico de un proyecto que ha utilizado Cython para acelerar Python es uvloop, un bucle de eventos de asyncio ultrarrápido. De media, uvloop hace que asyncio sea entre 2 y 4 veces más rápido.
Uso de Cython
Del mismo modo que el código Python se escribe en archivos .py, el código Cython se escribe en archivos .pyx.
Declaraciones de tipos
Uno de los principales beneficios de Cython es la posibilidad de declarar los tipos de las variables, los argumentos de las funciones y los tipos de retorno. Esto permite que el compilador de Cython genere código C altamente optimizado. Por ejemplo:
# base.py
import time

def fib(n: int) -> int:
    if n <= 1:
        return n
    else:
        return fib(n - 2) + fib(n - 1)

t0 = time.time()
fib(32)
print(f"Time: {time.time() - t0}")
El tipo de n y el tipo de retorno se declaran como int. Esto permite que el compilador de Cython genere código C altamente optimizado para la función.
Ejecute el script con el comando shell python3.10 base.py. La función tarda ~0.37893152236938477 segundos en ejecutarse.
Ahora, para probar nuestro código Cython, copie el script de base.py en un nuevo archivo llamado base_cython.pyx
A continuación, crearemos un archivo setup.py con el siguiente código:
from setuptools import setup
from Cython.Build import cythonize

setup(
    name='Base script',
    ext_modules=cythonize("base_cython.pyx"),
    zip_safe=False,
)
Para compilar, ejecute shell python setup.py build_ext --inplace.
Ejecute el script iniciando un intérprete de Python y escribiendo shell from base import fib. Tarda ~0.09149384498596191 segundos en ejecutarse. Con Cython, vemos que obtuvimos un beneficio de rendimiento de ~4x en comparación con el código Python puro.
Uso de bibliotecas de C
Cython permite a los desarrolladores utilizar bibliotecas de C directamente en su código Python. Esto puede traducirse en mejoras de rendimiento significativas, especialmente en tareas de cálculo intensivo. Por ejemplo:
cdef extern from "math.h":
    double sin(double)

def compute_sine(double x):
    return sin(x)
La función sin de la biblioteca de C math.h se utiliza directamente en el código Python. Esto puede traducirse en mejoras de rendimiento significativas frente a la biblioteca math de Python.
Gestión de memoria
Cython permite a los desarrolladores gestionar la memoria directamente, lo que puede traducirse en mejoras de rendimiento significativas. Por ejemplo:
cdef int *arr = <int *>malloc(sizeof(int) * n)

for i in range(n):
    arr[i] = i

free(arr)
En el ejemplo anterior, la memoria se asigna con la función malloc de la biblioteca estándar de C. La función free se utiliza para liberar la memoria cuando ya no es necesaria.
6. Mypyc
Mypyc es un compilador estático de Python que genera código C a partir de módulos de Python. Es una herramienta que puede utilizarse para optimizar y acelerar el código Python. Mypyc compila el código Python a código máquina, lo que lo hace más rápido que el código Python interpretado. Es compatible con Python 3.5 y versiones posteriores.
Para usar mypyc, necesita instalar mypy (enlace a la documentación)
Dado que Mypyc utiliza tipado estático, cambiaremos nuestro script base para que use una sencilla función de Fibonacci con tipos:
# base.py
import time

def fib(n: int) -> int:
    if n <= 1:
        return n
    else:
        return fib(n - 2) + fib(n - 1)

t0 = time.time()
fib(32)
print(f"Time: {time.time() - t0}")
Ejecute el script con el comando shell python3.10 base.py. La función tarda ~0.37893152236938477 segundos en ejecutarse.
Para compilar nuestro código, primero comprobaremos si hay problemas de tipado en él.
mypy base.py
A continuación, compilaremos el programa en una extensión binaria de C.
mypyc base.py
Para probar nuestro código compilado, usaremos el comando shell python3.10 -c "import base", que tarda unos ~0.018268108367919922 segundos en ejecutarse. Con mypyc, vemos que obtuvimos un beneficio de rendimiento de ~20x en comparación con el código Python puro.
Usamos python3.10 -c para ejecutar el módulo compilado como un programa.
7. Pypy
Pypy es una implementación alternativa del lenguaje Python. Es un compilador Just-In-Time (JIT) para Python, lo que significa que compila el código Python a código máquina sobre la marcha. Pypy es compatible con Python 2.7 y Python 3.6.
Pypy es conocido por su excelente rendimiento en tareas limitadas por CPU. Tiene varias características que lo convierten en una herramienta potente para optimizar código Python. Por ejemplo, utiliza una técnica llamada «JIT specialization» para generar código máquina optimizado para las partes del código que se ejecutan con más frecuencia.
Puede instalar Pypy desde este enlace
Usemos Pypy para ejecutar nuestro script de Fibonacci:
pypy3 base.py
El script tarda ~0.02586054801940918 segundos en ejecutarse, ~14.6x más rápido que ejecutarlo con python3.10, que tardó unos 0.37893152236938477 segundos.
8. Mamba
Mamba es un gestor de paquetes de Python diseñado para ser más rápido que el gestor de paquetes predeterminado de Python, pip. Utiliza el formato de paquetes de conda y puede usarse con la distribución Anaconda de Python. Que se note o no un beneficio de rendimiento dependerá de cada paquete, ya que algunos paquetes que se instalan con Mamba pueden ofrecer el mismo rendimiento que los instalados con pip.
Numpy es uno de los paquetes que están optimizados al usar Mamba. Para instalarlo y configurarlo, siga la documentación. Cambiaremos nuestro script base a:
import numpy as np
import time

arr1 = np.random.rand(1000000)
arr2 = np.random.rand(1000000)

t0 = time.time()
result = np.dot(arr1, arr2)
print(f"Time taken using mamba: {time.time() - t0}")
Rendimiento de pip frente a mamba:
Instale numpy con pip y ejecute el script base de la siguiente manera:
# install
pip install numpy
# run
python3.10 base.py
El script tarda ~0.004205226898193359 segundos en ejecutarse.
Instalemos numpy con mamba:
# install
mamba install numpy
# run
python3.10 base.py
Esta vez, el script tarda ~0.0014407634735107422 en ejecutarse, es decir, ~2.92x más rápido que con pip.
Es importante tener en cuenta que, si los paquetes que utiliza no están muy optimizados en mamba, notará ganancias de rendimiento muy pequeñas.
9. Código nativo
El código nativo es código máquina que el procesador de un equipo ejecuta directamente. El código nativo suele generarlo un compilador que traduce lenguajes de programación de alto nivel a código máquina. El código nativo es más rápido y más eficiente que el código interpretado, como el código Python, porque no necesita traducirse en tiempo de ejecución.
En Python, el código nativo puede generarse con herramientas como MyPyC y Cython, que compilan código Python a código nativo. El código nativo también puede generarse con otros lenguajes, como C o C++, que pueden invocarse desde Python mediante módulos de extensión.
Una ventaja del código nativo es que es más rápido y más eficiente que el código interpretado. El código nativo puede ejecutarse más rápido porque el procesador lo ejecuta directamente, sin necesidad de interpretación. Además, el código nativo puede optimizarse para una arquitectura de procesador concreta, lo que puede mejorar aún más el rendimiento.
Sin embargo, una desventaja del código nativo es que, por lo general, es más difícil de escribir y depurar que el código interpretado. El código nativo requiere más conocimientos de programación de bajo nivel y puede ser más difícil de depurar porque lo ejecuta directamente el procesador.
10. Codon
Codon es una biblioteca de Python que ofrece una forma sencilla de generar y ejecutar código nativo en tiempo de ejecución. Codon permite a los desarrolladores escribir código Python de alto nivel que se traduce a código nativo en tiempo de ejecución, lo que puede ser más rápido y más eficiente que el código Python interpretado.
Codon utiliza compilación Just-in-Time (JIT) para generar código nativo. La compilación JIT es una técnica en la que el código se compila en tiempo de ejecución en lugar de con antelación. Esto permite que el compilador genere código optimizado que tiene en cuenta el entorno de ejecución concreto.
Para usar codon, primero tiene que instalarlo desde este enlace.
Podemos ejecutar nuestro script base.py de Fibonacci con el siguiente comando:
codon run -release base.py
Con codon, nuestro script tardó solo ~0.00603247 segundos, es decir, ~52.48 más rápido que con Python3.10 (~0.32192111015319824 segundos)
Una ventaja de Codon es que ofrece una forma sencilla de generar código nativo sin necesidad de herramientas adicionales, como MyPyC o Cython. Codon también proporciona una API de alto nivel que permite a los desarrolladores escribir código en Python, sin necesidad de aprender un nuevo lenguaje o una nueva sintaxis.
Sin embargo, una desventaja de Codon es que puede no ser adecuado para todos los casos de uso. Codon es más adecuado para el código que puede beneficiarse de la compilación JIT, como el cálculo numérico o el aprendizaje automático. Además, Codon puede no ser tan rápido como otras herramientas de generación de código nativo, como MyPyC o Cython, en determinados casos de uso.
Benchmarks
| Herramienta | Tiempo medio (s) | Script base | Rendimiento |
|---|---|---|---|
| Python3.10 | ~15.19 | base.py (Async) |
- |
| Threads | ~10.015 | base.py (Async) |
~1.52x |
| Multiprocessing | ~9.257 | base.py (Async) |
~1.64x |
| Asyncio | ~9.32 | base.py (Async) |
~1.63x |
| - | - | - | - |
| Python3.11 | ~0.21 | base.py (Fibonacci) |
~1.65x |
| Cython | ~0.09 | base.py (Fibonacci) |
~3.99x |
| Mypyc | ~0.018 | base.py (Fibonacci) |
~19.99x |
| Pypy | ~0.025 | base.py (Fibonacci) |
~14.12x |
| Codon | ~0.006 | base.py (Fibonacci) |
~52.48x |
| - | - | - | - |
| PiP | ~0.004205 | base.py (Numpy) |
- |
| Mamba | ~0.001440 | base.py (Numpy) |
~2.92x vs pip |
En conclusión, existen varias estrategias y herramientas que pueden utilizarse para optimizar el rendimiento del código Python. Aunque el código nativo y Cython pueden acelerar de forma significativa las actividades de cálculo intensivo, el multihilo y el multiprocesamiento permiten un mejor aprovechamiento de los recursos del sistema. También es posible instalar programas optimizados para la computación científica con el gestor de paquetes Mamba. El enfoque o la herramienta que decida utilizar dependerá, en última instancia, de lo que su código intente lograr.
Sin embargo, es fundamental recordar que la legibilidad y la facilidad de mantenimiento no deben sacrificarse en nombre de la optimización de la velocidad. Aunque suponga renunciar a algunos beneficios de rendimiento, como desarrolladores debemos aspirar a crear código claro, conciso y fácil de entender.