编写超快 Python 代码的策略
本文介绍了提升 Python 这门解释型语言性能的多种方法。
Python 是一门广受欢迎的编程语言,凭借易用、简洁和可读性强的特点获得了极高的人气。然而,它的动态特性使其与其他语言相比运行速度相对较慢。
在处理大型数据集、计算密集型任务或需要快速响应的实时应用时,Python 代码的性能可能会成为问题。在按使用量计费计算资源的云环境中,缓慢的代码还会增加应用的运行成本。
因此,开发人员一直在寻找让 Python 代码运行得更快的方法。在本文中,我们将探讨编写超快 Python 代码的策略。
本文将介绍开发人员让 Python 代码变得超快的各种方法,从利用内置的 API/模块到使用第三方库/工具。
为了便于比较,我们将使用一个基准脚本,并将其性能与文中讨论的各种工具或技术进行对比。该脚本只是根据一组图片 URL 从 Unsplash 下载图片。
# base.py

import requests

IMG_URLS = [
    'https://images.unsplash.com/photo-1681139504760-4c17f2c8b380',
    'https://images.unsplash.com/photo-1661956601031-4cf09efadfce',
    'https://images.unsplash.com/photo-1681138279775-2b407d5d962a',
    'https://images.unsplash.com/photo-1530224264768-7ff8c1789d79',
    'https://images.unsplash.com/photo-1564135624576-c5c88640f235',
    'https://images.unsplash.com/photo-1541698444083-023c97d3f4b6',
    'https://images.unsplash.com/photo-1522364723953-452d3431c267',
    'https://images.unsplash.com/photo-1513938709626-033611b8cc03',
    'https://images.unsplash.com/photo-1507143550189-fed454f93097',
    'https://images.unsplash.com/photo-1504198453319-5ce911bafcde',
    'https://images.unsplash.com/photo-1661956602116-aa6865609028',
    'https://images.unsplash.com/photo-1516972810927-80185027ca84',
    'https://images.unsplash.com/photo-1681105225329-2372f21a59a8',
    'https://images.unsplash.com/photo-1661956601349-f61c959a8fd4'
]


def download_images() -> None:
    for img_url in IMG_URLS:
        img_bytes = requests.get(img_url).content
        img_name = img_url.split('/')[3]
        img_name = f'{img_name}.jpg'
        with open(img_name, 'wb') as img_file:
            img_file.write(img_bytes)
            print(f'{img_name} was downloaded...')
该脚本是未经优化的普通 Python 代码。
基准测试脚本:
# benchmark.py

from timeit import timeit

t1 = timeit(
    "download_images()",
    setup="from base import download_images",
    number=1
)
print(f'Finished running base script in {t1} seconds')

t2 = timeit(
    "run_download_images()",
    setup="from threads import run_download_images",
    number=1
)
print(f'Finished running threads script in {t2} seconds')

print(f"Base: {t1:.3f} seconds")
print(f"Threading: {t2:.3f} seconds")
print(f"Threading is  {t1 / t2:.3f}x faster!")
benchmark.py 脚本将用于对我们的各个脚本进行性能基准测试。setup(‘from threads import run_download_images’ 和 ‘from base import download_images’)以及 stmt(‘run_download_images()’ 和 ‘download_images()’)会根据我们测试的内容而变化。
1. 更新版本的 Python
运行更新版本的 Python,尤其是 Python 3.11(截至 2023 年),相比之前的 Python 版本带来了多项性能提升。根据 Python 文档,Python 3.11 比 Python 3.10 快 10-60%,平均约为 Python 3.10 的 1.25x。
2. 线程
Python 的 Thread API 提供了一种简单高效的方式来创建和管理线程。借助线程,开发人员可以同时运行多个任务,从而加快代码执行速度。线程非常适合 I/O 密集型任务,即涉及大量输入和输出操作的任务,例如读写文件系统、发起 API 请求和下载数据。这是因为线程仍然使用一个进程来执行代码,因此虽然它们适合同时处理更多任务,但并不适合追求速度(例如在执行 CPU 密集型任务,即需要大量计算的任务时)。
Thread 模块
Python 中的 thread 模块为创建和管理线程提供了一个简单易用的接口。在 Python 中,线程是使用 threading 模块创建的,该模块提供了用于创建和管理线程的类。
利用线程发挥多核优势
使用线程的主要优势之一是,它们使程序能够利用 CPU 的多个核心。通过同时运行多个线程,开发人员可以利用多个核心的处理能力,获得更快的执行速度。要通过线程利用多核,开发人员需要确保代码被设计为可并发运行。这意味着各个线程应执行相互独立的任务,彼此互不干扰。如果线程需要共享变量或数据结构等资源,开发人员需要确保对这些资源的访问是线程安全的。
让我们看看如何将 base.py 中的脚本改写为使用线程的版本。
# threads.py

import requests
import uuid
import concurrent.futures

import base # base.py

def download_image(img_url: str) -> None:
    img_bytes = requests.get(img_url).content
    img_name = f"{img_url.split('/')[3]}{uuid.uuid4()}"
    img_name = f'{img_name}.jpg'
    with open(img_name, 'wb') as img_file:
        img_file.write(img_bytes)
        print(f'{img_name} was downloaded...')


def run_download_images():
    with concurrent.futures.ThreadPoolExecutor() as executor:
        executor.map(download_image, base.IMG_URLS)
上面的代码只是创建了一个 ThreadPoolExecuter,由它负责处理线程。
threads.py 与 base.py 的性能对比:
运行 benchmark.py:
python3.10 benchmark.py
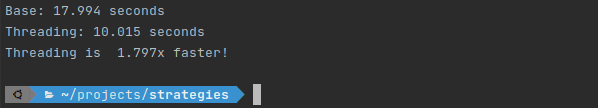
可以看到,使用线程后,图片下载速度约为普通代码的 ~1.7x。
线程安全与 GIL
在 Python 中使用线程时,线程安全是一个至关重要的考虑因素。当多个线程访问变量或数据结构等共享资源时,可能会产生竞态条件,从而导致意外的结果。 为了确保线程安全,开发人员需要使用锁、信号量和屏障等同步机制。这些机制可确保同一时间只有一个线程能够访问共享资源,从而防止竞态条件。
开发人员还需要了解全局解释器锁(GIL),这是 Python 用来确保同一时间只有一个线程能够执行 Python 字节码的机制。虽然 GIL 可能会限制多线程程序的性能,但它对于确保 Python 程序的一致性和正确性至关重要。
3. 多进程
多进程是利用 CPU 多核的另一种方式。与线程不同,多进程使用的是独立的进程而非线程。每个进程都在自己的内存空间中运行,因此非常适合需要大量处理能力的 CPU 密集型和 I/O 密集型任务。得益于 multiprocessing 模块,在 Python 中使用多进程非常简单。开发人员可以创建多个同时运行的进程,从而使代码运行得更快。
# multiprocessing_example.py

import uuid
import multiprocessing
import requests
import concurrent.futures

import base


def download_image(img_url: str) -> None:
    img_bytes = requests.get(img_url).content
    img_name = f"{img_url.split('/')[3]}{uuid.uuid4()}"
    img_name = f'{img_name}.jpg'
    with open(img_name, 'wb') as img_file:
        img_file.write(img_bytes)
        print(f'{img_name} was downloaded...')


def run_download_images() -> None:
    with concurrent.futures.ProcessPoolExecutor() as executor:
        executor.map(download_image, base.IMG_URLS)
        print(f"Using {len(multiprocessing.active_children())}/{multiprocessing.cpu_count()} CPUs")
multiprocessing_example.py 与 base.py 的性能对比:
运行 benchmark.py:
python3.10 benchmark.py
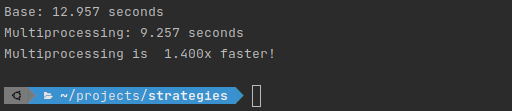
可以看到,使用多进程确实带来了一定的性能提升。虽然多进程也可以用于 I/O 密集型任务,但它更适合 CPU 密集型任务。
4. Asyncio
Python 的 Asyncio 模块允许使用 async/await 语法编写并发代码。Asyncio 使程序员能够编写非阻塞代码,无需使用多个线程或进程即可同时处理大量任务。需要等待外部资源响应的 I/O 密集型任务(例如网络请求)最适合使用 asyncio。尽管调试问题有时可能比较困难,但得益于 asyncio 的简洁性,开发人员无需操心底层细节即可编写并发代码。
# asyncio_example.py

import asyncio
import uuid
import aiohttp # the requests library is synchronous, and so we'll use `aiohttp` which works better with asyncio

import base


async def download_image(img_url: str) -> None:
    async with aiohttp.ClientSession() as session:
        async with session.get(img_url) as response:
            img_bytes = await response.read()
    img_name = f"{img_url.split('/')[3]}{uuid.uuid4()}"
    img_name = f'{img_name}.jpg'
    with open(img_name, 'wb') as img_file:
        img_file.write(img_bytes)
        print(f'{img_name} was downloaded...')


async def run_download_images() -> None:
    await asyncio.gather(*[download_image(url) for url in base.IMG_URLS])


def download_images_async() -> None:
    asyncio.run(run_download_images())
asyncio_example.py 与 base.py 的性能对比:
运行 benchmark.py:
python3.10 benchmark.py
asyncio_example.py 脚本的运行时间约为 ~9.32862888701493 秒,比 base.py 脚本(~14.631273603008594 秒)快 ~1.568x。
5. 使用 Cython 实现并行
借助 Python 的超集 Cython,开发人员可以编写能够转换为高度优化的 C 或 C++ 代码的 Python 代码。Cython 利用 C 的速度来实现高性能的 Python 程序。使用 Cython,程序员可以编写能够快速转换为 C 的 Python 代码。对于需要大量处理能力的 CPU 密集型任务,Cython 是理想之选。可以使用 Cython 语法编写 Python 代码,然后将其编译为 C,使其执行得更快。
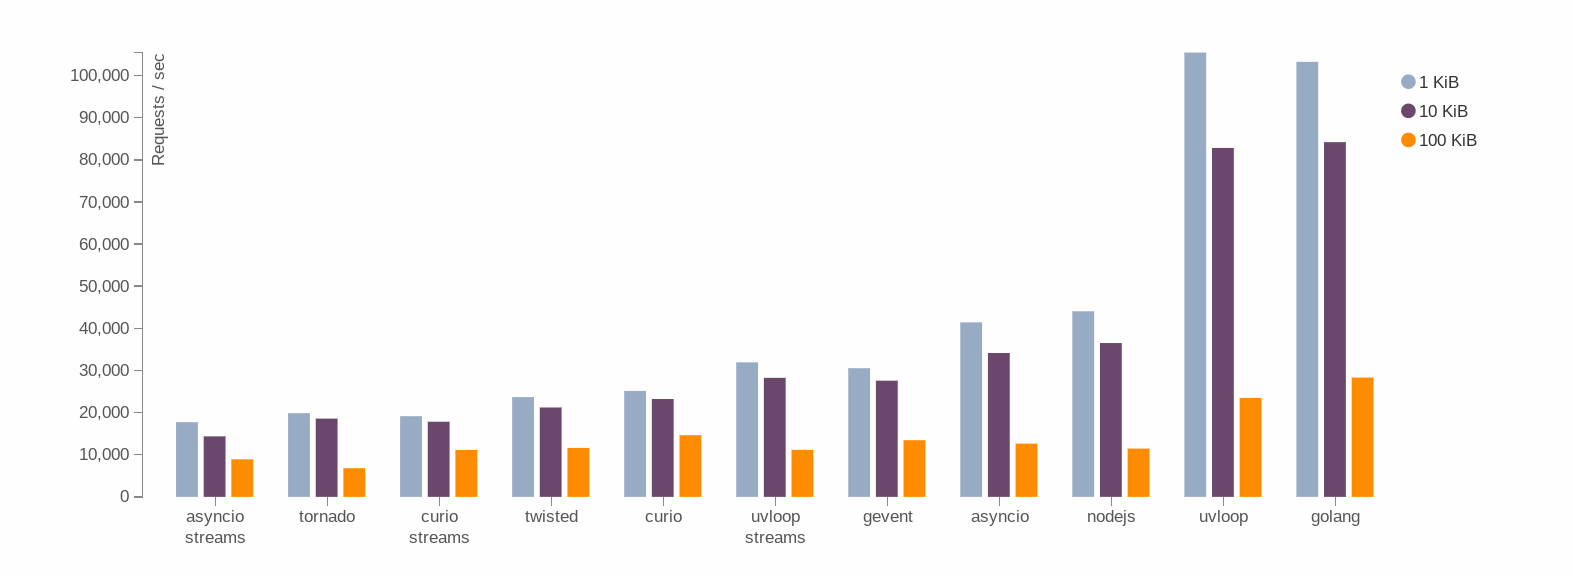
一个使用 Cython 加速 Python 的实际项目示例是 uvloop,这是一个超快的 asyncio 事件循环。平均而言,uvloop 可使 asyncio 快 2-4x。
使用 Cython
与 Python 代码写在 .py 文件中一样,Cython 代码写在 .pyx 文件中。
类型声明
Cython 的主要优势之一是能够声明变量、函数参数和返回值的类型。这使 Cython 编译器能够生成高度优化的 C 代码。例如:
# base.py
import time

def fib(n: int) -> int:
    if n <= 1:
        return n
    else:
        return fib(n - 2) + fib(n - 1)

t0 = time.time()
fib(32)
print(f"Time: {time.time() - t0}")
n 的类型和返回类型都被声明为 int。这使 Cython 编译器能够为该函数生成高度优化的 C 代码。
使用命令 shell python3.10 base.py 运行该脚本。该函数的运行时间约为 ~0.37893152236938477 秒。
现在,为了测试我们的 Cython 代码,将 base.py 中的脚本复制到一个名为 base_cython.pyx 的新文件中。
接下来,我们创建一个包含以下代码的 setup.py 文件:
from setuptools import setup
from Cython.Build import cythonize

setup(
    name='Base script',
    ext_modules=cythonize("base_cython.pyx"),
    zip_safe=False,
)
要进行构建,请运行 shell python setup.py build_ext --inplace。
启动一个 Python shell 并执行 shell from base import fib 来运行该脚本。运行时间约为 ~0.09149384498596191 秒。可以看到,与纯 Python 代码相比,使用 Cython 获得了约 ~4x 的性能提升。
使用 C 库
Cython 允许开发人员在 Python 代码中直接使用 C 库。这可以带来显著的性能提升,尤其是对于计算密集型任务。例如:
cdef extern from "math.h":
    double sin(double)

def compute_sine(double x):
    return sin(x)
这里直接在 Python 代码中使用了 math.h C 库中的 sin 函数。与 Python 的 math 库相比,这可以带来显著的性能提升。
内存管理
Cython 允许开发人员直接管理内存,这可以带来显著的性能提升。例如:
cdef int *arr = <int *>malloc(sizeof(int) * n)

for i in range(n):
    arr[i] = i

free(arr)
在上面的示例中,使用 C 标准库中的 malloc 函数分配内存。在不再需要这块内存后,使用 free 函数将其释放。
6. Mypyc
Mypyc 是一个面向 Python 的静态编译器,可以从 Python 模块生成 C 代码。它是一个可用于优化和加速 Python 代码的工具。Mypyc 将 Python 代码编译为机器码,因此比解释执行的 Python 代码更快。它兼容 Python 3.5 及以上版本。
要使用 mypyc,您需要安装 mypy(link to the docs)
由于 Mypyc 依赖静态类型,我们将把基准脚本改为一个带类型标注的简单斐波那契函数:
# base.py
import time

def fib(n: int) -> int:
    if n <= 1:
        return n
    else:
        return fib(n - 2) + fib(n - 1)

t0 = time.time()
fib(32)
print(f"Time: {time.time() - t0}")
使用命令 shell python3.10 base.py 运行该脚本。该函数的运行时间约为 ~0.37893152236938477 秒。
为了编译代码,我们首先检查代码中是否存在类型问题。
mypy base.py
接下来,我们将程序编译为二进制 C 扩展。
mypyc base.py
为了测试编译后的代码,我们使用命令 shell python3.10 -c "import base",运行时间约为 ~0.018268108367919922 秒。可以看到,与纯 Python 代码相比,使用 mypyc 获得了约 ~20x 的性能提升。
我们使用 python3.10 -c 将编译后的模块作为程序运行。
7. Pypy
Pypy 是 Python 语言的另一种实现。它是一个面向 Python 的即时(JIT)编译器,这意味着它会在运行时即时将 Python 代码编译为机器码。Pypy 兼容 Python 2.7 和 Python 3.6。
Pypy 以在 CPU 密集型任务上的出色性能而著称。它具备多项特性,使其成为优化 Python 代码的强大工具。例如,它使用一种名为“JIT 特化”(JIT specialization)的技术,为代码中频繁执行的部分生成优化的机器码。
您可以通过此链接安装 Pypy
让我们使用 Pypy 来运行斐波那契脚本:
pypy3 base.py
该脚本的运行时间约为 ~0.02586054801940918 秒,比使用 python3.10 运行(约 0.37893152236938477 秒)快 ~14.6x。
8. Mamba
Mamba 是一个 Python 包管理器,其设计目标是比默认的 Python 包管理器 pip 更快。它使用 conda 包格式,可以与 Python 的 Anaconda 发行版配合使用。能否感受到性能提升取决于具体的包,因为使用 Mamba 安装的某些包,其性能可能与使用 pip 安装的包相同。
Numpy 就是使用 Mamba 时经过优化的包之一。安装和配置方法请参阅文档。我们将基准脚本改为:
import numpy as np
import time

arr1 = np.random.rand(1000000)
arr2 = np.random.rand(1000000)

t0 = time.time()
result = np.dot(arr1, arr2)
print(f"Time taken using mamba: {time.time() - t0}")
pip 与 mamba 的性能对比:
使用 pip 安装 numpy,并按如下方式运行基准脚本:
# install
pip install numpy
# run
python3.10 base.py
该脚本的运行时间约为 ~0.004205226898193359 秒。
接下来使用 mamba 安装 numpy:
# install
mamba install numpy
# run
python3.10 base.py
这一次,该脚本的运行时间约为 ~0.0014407634735107422,比 pip 快 ~2.92x。
需要注意的是,如果您使用的包在 mamba 中没有经过高度优化,您只会看到非常小的性能提升。
9. 原生代码
原生代码是指由计算机处理器直接执行的机器码。原生代码通常由编译器生成,编译器会将高级编程语言翻译为机器码。原生代码比 Python 代码等解释执行的代码更快、更高效,因为它不需要在运行时进行翻译。
在 Python 中,可以使用 MyPyC 和 Cython 等工具生成原生代码,它们会将 Python 代码编译为原生代码。原生代码也可以使用 C 或 C++ 等其他语言生成,并通过扩展模块从 Python 中调用。
原生代码的一个优势是比解释执行的代码更快、更高效。原生代码由处理器直接执行,无需解释,因此执行速度更快。此外,原生代码还可以针对特定的处理器架构进行优化,从而进一步提升性能。
然而,原生代码的一个缺点是,与解释执行的代码相比,它通常更难编写和调试。原生代码需要更多的底层编程知识,而且由于由处理器直接执行,调试起来也可能更加困难。
10. Codon
Codon 是一个 Python 库,提供了一种在运行时生成和执行原生代码的简便方法。Codon 允许开发人员编写高级 Python 代码,并在运行时将其翻译为原生代码,这比解释执行的 Python 代码更快、更高效。
Codon 使用即时(JIT)编译来生成原生代码。JIT 编译是一种在运行时而非提前编译代码的技术。这使编译器能够结合具体的运行时环境生成优化的代码。
要使用 codon,您首先需要通过此链接进行安装。
我们可以使用以下命令运行斐波那契 base.py 脚本:
codon run -release base.py
使用 codon,我们的脚本只用了约 ~0.00603247 秒,比使用 Python3.10(~0.32192111015319824 秒)快 ~52.48 倍
Codon 的一个优势是,它提供了一种无需 MyPyC 或 Cython 等额外工具即可生成原生代码的简便方法。Codon 还提供了一个高级 API,使开发人员可以用 Python 编写代码,而无需学习新的语言或语法。
然而,Codon 的一个缺点是,它可能并不适用于所有用例。Codon 最适合能够从 JIT 编译中受益的代码,例如数值计算或机器学习。此外,在某些用例中,Codon 的速度可能不及 MyPyC 或 Cython 等其他原生代码生成工具。
基准测试结果
| 工具 | 平均时间(秒) | 基准脚本 | 性能 |
|---|---|---|---|
| Python3.10 | ~15.19 | base.py(Async) |
- |
| Threads | ~10.015 | base.py(Async) |
~1.52x |
| Multiprocessing | ~9.257 | base.py(Async) |
~1.64x |
| Asyncio | ~9.32 | base.py(Async) |
~1.63x |
| - | - | - | - |
| Python3.11 | ~0.21 | base.py(Fibonacci) |
~1.65x |
| Cython | ~0.09 | base.py(Fibonacci) |
~3.99x |
| Mypyc | ~0.018 | base.py(Fibonacci) |
~19.99x |
| Pypy | ~0.025 | base.py(Fibonacci) |
~14.12x |
| Codon | ~0.006 | base.py(Fibonacci) |
~52.48x |
| - | - | - | - |
| PiP | ~0.004205 | base.py(Numpy) |
- |
| Mamba | ~0.001440 | base.py(Numpy) |
相比 pip ~2.92x |
总之,有多种策略和工具可用于优化 Python 代码的性能。原生代码和 Cython 可以显著加快计算密集型任务的速度,而多线程和多进程则能更好地利用系统资源。还可以使用 Mamba 包管理器安装针对科学计算进行优化的程序。 最终选择哪种方法/工具,取决于您的代码要实现的目标。
但需要牢记的是,不应以牺牲可读性和可维护性为代价来追求速度优化。即使这意味着放弃一些性能收益,作为开发人员,我们也应致力于编写清晰、简洁且易于理解的代码。