エンジニアが本当に信頼できるAIプルリクエストレビュアーを構築する
当社はAIによるプルリクエストレビュアーを構築しましたが、ハルシネーションと誤検知によって開発者の信頼が損なわれたため運用を停止し、より優れたモデル、より広いコンテキスト、より慎重なエージェントアーキテクチャで再構築しました。本記事では、自動コードレビューについて学んだこと、カバレッジよりも信頼が重要な理由、そしてAIレビュアーが人間の判断に取って代わることなく、エンジニアリングチームの反復的なレビュー作業の削減にどう役立つかを紹介します。
プルリクエストレビューがAIに適した課題である理由
いつの間にか、当社のAIプルリクエストレビュアーは実験という感覚ではなくなっていました。
レビューのワークフローの一部になっていたのです。
エンジニアはその指摘に反論したり、無視したり、ときには感謝したりしました。あるエンジニアは、プルリクエストが承認された後、キスの絵文字で返信したほどです。
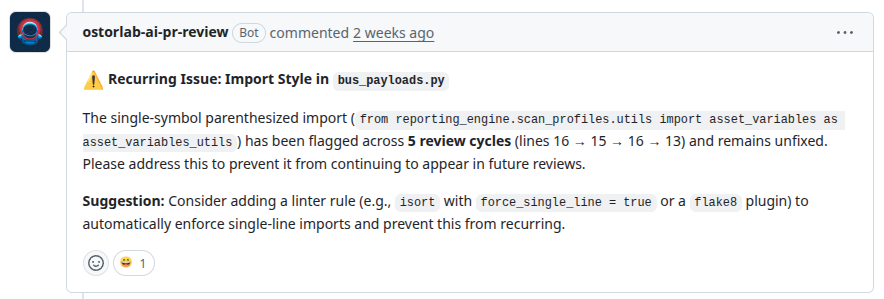
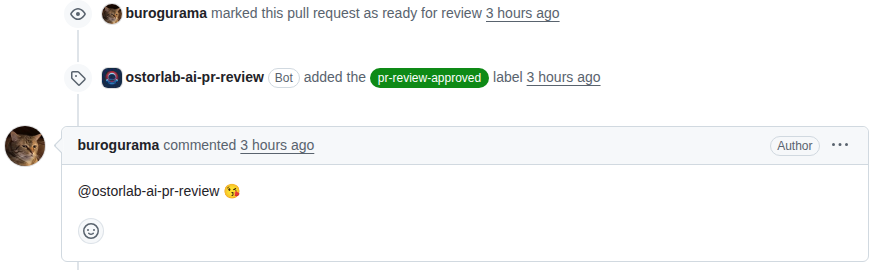
こうしたやり取りを目にしたのは有益でした。レビュアーが常に正しかったからではなく、AIのフィードバックがエンジニアリングのワークフローの一部になったときに何が起きるかを示していたからです。
問題はもはや、システムが問題を見つけられるかどうかだけではありません。
エンジニアがその指摘を信頼する気になれるかどうかです。
最初のバージョンは失敗しました。
運用を停止したのは、問題を見逃したからではありません。
存在しない問題をあまりにも多く見つけたからです。
この違いは重要です。AIコードレビューに関する議論の多くはカバレッジに焦点を当てています。システムがいくつのバグを見つけられるか、いくつの脆弱性を検出できるか、いくつのコメントを生成できるか、といった点です。実際には、当社にとって最も重要だった指標はカバレッジではありませんでした。信頼でした。
プルリクエストレビューは、AIを適用する場として自然な領域です。シニアエンジニアは、繰り返し現れるパターンの特定、規約の徹底、安全でない前提の発見、エッジケースの確認、そして変更がシステムの他の部分と整合しているかの確認に、かなりの時間を費やしています。その作業の一部には、アーキテクチャに関する深い判断が必要です。しかし、大部分は反復的で機械的なものです。
そうした反復的なチェックこそ、AIが役立つ領域です。
課題は、コードレビューが単に問題を見つけることではない点にあります。適切な問題を見つけ、それを明確に説明し、エンジニアがそのフィードバックに基づいて行動する気になれるだけの精度で行うことが求められます。
ノイズの多いレビュアーは、レビュアーがいないよりも悪い存在です。人間のエンジニアは沈黙を無視できます。しかし、もっともらしいが誤ったコメントは、それが間違っていることを証明するために時間を費やさない限り無視できません。
当社はこの教訓を、痛い思いをして学びました。
最初の試み
最初のバージョンの目標はシンプルでした。人間のレビュアーが関わる前にプルリクエストをレビューし、よくある問題を早い段階で見つけることです。
当時、これは実用的で効果の大きいユースケースだと感じていました。プルリクエストのレビューはボトルネックになっていました。シニアエンジニアは反復的なフィードバックに多くの時間を費やしすぎており、レビュー待ちの列がチーム全体の開発を遅らせていました。
目的はレビュアーを置き換えることではありませんでした。レビュープロセスの機械的な部分を減らし、エンジニアがアーキテクチャ、セキュリティへの影響、ビジネスロジックにより多くの時間を割けるようにすることでした。
最初のバージョンは、プルリクエストが作成または更新されると自動的に実行されました。差分を収集し、変更されたファイルと限られた周辺コンテキストを集め、その情報を言語モデルに送り、レビューコメントをプルリクエストに投稿していました。
ワークフローは意図的にシンプルにしていました。
- プルリクエストのイベントがレビュアーを起動する。
- システムが差分と変更されたファイルを抽出する。
- モデルが固定のプロンプトを使って変更をレビューする。
- 生成された検出結果をプルリクエストのコメントに変換する。
- エンジニアが人間のフィードバックとあわせてそのコメントを確認する。
このシンプルさのおかげでシステムは簡単に構築できましたが、それが最大の弱点にもなりました。エージェントは何が変わったかは見えても、検出結果が本当に妥当かどうかを理解するのに十分な周辺システムが見えないことが多かったのです。
机上では、この仮説は妥当なものでした。プルリクエストがシニアエンジニアに届く前にAIレビュアーがよくある問題を見つけられれば、レビュアーは同じフィードバックを繰り返す時間を減らし、設計上の判断について議論する時間を増やせます。
実際には、システムは役に立ちそうに聞こえるものの、しばしば間違っているコメントを生成しました。
失敗のパターン:もっともらしいが誤ったフィードバック
最初のバージョンは、分かりやすい形で失敗したわけではありません。
意味をなさないコメントを投稿したわけではありません。すべてのプルリクエストを誤解したわけでもありません。明らかに破綻した推奨を出したわけでもありません。
問題はもっと微妙なものでした。多くのコメントは、エンジニアが調査せざるを得ないと感じるほどにはもっともらしく、それでいて調査がしばしば時間の無駄に終わるほどには誤っていたのです。
軽微ながら苛立たしい例もありました。エージェントはときどき、当社の規約と矛盾するスタイルの変更を推奨しました。たとえば、一貫してcamelCaseを使っているコードベースで、snake_caseのテスト名を提案するといったものです。
より支障の大きいコメントもありました。あるケースでは、同じプルリクエストの別の箇所ですでに修正済みのコードを、エージェントが指摘しました。別のケースでは、当社のCI環境がブラウザーベースの実行をサポートしていないにもかかわらず、ブラウザー環境を必要とする結合テストの追加を推奨しました。
同じプルリクエストに重複したコメントが現れることもありました。エージェントが同じ問題と思われるものを複数回特定し、同じフィードバックの言い換えを複数投稿してしまうのです。根底にある指摘が妥当な場合でも、繰り返しによってレビューがノイズの多いものに感じられました。
最も厄介だったのは、一見すると妥当に見えるコメントでした。たとえば、より狭い例外型が意図的に選ばれていることを理解せずに、より広い例外処理を提案することがありました。あるいは、技術的には妥当でも近くのコードと一貫性のないリファクタリングを推奨することもありました。
質の悪いAIレビューコメントにはコストがかかります。誰かがそれを読み、理解し、当てはまるかどうかを確認し、周辺のコードを調べ、対応するかどうかを判断しなければなりません。コメントが間違っていれば、その時間はすべて無駄になります。
時間が経つにつれ、エンジニアはエージェントを役に立つレビュアーとして扱うのをやめ、レビューのノイズの発生源の一つとして扱うようになりました。
その時点で、このプロジェクトはもう役に立っていませんでした。
そこで、当社は運用を停止しました。
本当の教訓:誤検知は見逃しよりも悪い
最初のバージョンから得た最も重要な教訓は、誤検知(フォールスポジティブ)が、見逃しよりも大きな損害をもたらすことが多いという点でした。
ときどき問題を見逃すレビュアーでも、役に立つことはあります。誤った問題を繰り返し指摘するレビュアーは、他の全員に余計な作業を生み出します。
これはコードレビューでは特に当てはまります。レビューコメントはエンジニアの集中を中断させるからです。コメントは単なるテキストではありません。注意を向けてほしいという要求です。作成者に手を止めさせ、コードを調べさせ、問題について考えさせ、変更が必要かどうかを判断させます。
その要求があまりにも頻繁に誤りだと分かれば、信頼はすぐに失われます。
いったん信頼が失われると、正しいコメントでさえ価値が下がります。エンジニアはすべてを検証し始めます。エージェントのフィードバックを身構えて読むようになります。そうでないと証明されるまでは、おそらく間違っているだろうと考えるのです。
それによってツールの役割が変わります。レビューの負担を減らすどころか、増やしてしまうのです。
AIコードレビューでは、量よりも精度が重要です。10件のコメントのうち9件を手動で却下しなければならないなら、1件のコメントより優れているとは言えません。優れたレビューエージェントは、黙っていることをためらうべきではありません。
これが2つ目のバージョンの指針となりました。
コードレビューに差分以上のコンテキストが必要な理由
最初のバージョンは、プルリクエストレビューを主に差分分析の問題として扱っていました。それが間違いでした。
経験豊富なレビュアーは、変更された行だけを見て変更を評価するわけではありません。はるかに幅広いコンテキストを使います。
- 周辺コードにある既存のパターン
- プロジェクト固有の命名規約とテスト規約
- 依存関係の挙動
- 実行時の前提
- CIの制約
- セキュリティ境界
- 過去の設計判断
- ビジネスロジックと製品の意図
- 同様の問題がすでに別の場所で解決されているかどうか
単独で見ると疑わしく見える変更も、システム全体の中で見れば正しい場合があります。その逆もまた真です。差分では無害に見える変更が、別のファイル、サービス、実行パスの挙動が原因でバグを持ち込むこともあります。
このコンテキストの欠落が、最初のバージョンの失敗の多くを説明していました。
モデルが誤っていたのは、多くの場合、言語能力が不足していたからではありません。十分な情報がなかったからです。関連するコンテキストが見えないとき、システムは推測しました。そして推測したとき、自信に満ちているが誤ったフィードバックを生み出すことがありました。
問題はモデルだけではありませんでした。
問題は、モデルを取り巻くアーキテクチャにありました。
この課題に再び取り組んだ理由
当社は最終的に、AIプルリクエストレビューに再び取り組みました。当初の課題がなくなっていなかったからです。
シニアエンジニアは依然として反復的なレビュー作業に時間を費やしていました。そうした作業の多くは重要でしたが、必ずしもシニアレベルの判断を必要とするものではありませんでした。ノイズを生み出さずに済むのであれば、機械的な問題を早い段階で見つけることには価値があると、当社は引き続き考えていました。
同時に、技術も進歩していました。
新しいモデルは、コードの理解、制約への準拠、実装の詳細に関する推論に優れていました。コンテキストウィンドウが大きくなったことで、狭い差分だけからモデルに作業させるのではなく、より多くのリポジトリのコンテキストを提供できるようになりました。エージェントのパターンも成熟していました。単一のプロンプトに頼るのではなく、システムが情報を取得し、ファイルを調べ、ツールを呼び出し、具体的なレビュー目標に沿って作業を構成できるようになっていたのです。
これによって当社のアプローチが変わりました。
当社はもはや、気づいたことすべてにコメントする汎用的なレビュアーを作ろうとしていたわけではありません。確度が高くシグナルの強い検出結果に焦点を絞った、慎重なレビューシステムを作ろうとしていました。
問いは次のものから、
エージェントはいくつの問題を見つけられるか。
次のものへと変わりました。
エージェントにはどの問題についてコメントを許可すべきか。
この転換によって、2つ目のバージョンははるかに良くなりました。
アーキテクチャで変わったこと
現在のシステムは、一度の飛躍的な進歩から生まれたものではありません。一つの中核的な考え方を軸に、何度も改良を重ねて生まれました。その考え方とは、レビュアーはコメントする資格を得る前にコンテキストを必要とするというものです。
初期の実験では、CrewAIを使ってレビューの挙動を調整していました。このアプローチは有望でしたが、出力はプルリクエストレビューに求められるほど一貫して信頼できるものではありませんでした。次に、よりシンプルなPydanticベースのワークフローに移行し、レビューパイプラインの構造と制御を強化しました。これにより一貫性は向上しましたが、関連するコンテキストが欠けているときには、システムは依然としてコードを誤解していました。
次の改良では、ツールベースのアーキテクチャに移行しました。
固定のプロンプトからプルリクエストをレビューするようモデルに依頼するのではなく、システムは必要に応じて追加の情報を収集できるようになりました。関連するファイルを調べ、近くの実装を確認し、関連する規約を取得し、分析を具体的なレビュー作業に絞り込むことができます。
大まかな流れは次のとおりです。
-
プルリクエストのイベントを受信
プルリクエストが作成または更新されると、システムが動き出します。 -
差分と変更されたファイルを解析
レビュアーが、何が変わり、どのファイルが影響を受けるかを特定します。 -
レビュー目標を選択
範囲を限定しないレビューを行うのではなく、システムは特定のカテゴリの問題に焦点を当てます。 -
関連するコンテキストを取得
エージェントが、周辺のコード、関連する関数、テスト、設定ファイル、リポジトリ内のパターンを収集します。 -
的を絞った分析を実行
クリーンアップの欠如、処理されていない例外、安全でない前提、永続化されない状態変更など、具体的な問題がないかをシステムが確認します。 -
確信度で検出結果をフィルタリング
確信度の低い所見は、投稿せずに抑制します。 -
慎重にコメントを生成
具体的で、対応可能で、プルリクエストに結び付いた検出結果だけを提示します。
このアーキテクチャによって推測が減ったため、システムはより役立つものになりました。
レビュアーは、差分に反応するチャットボットというより、限定された役割を持つ専門的なエンジニアリングツールに近いものになりました。
コンテキストの収集が最も重要な機能になった
最大の改善は、システムにより良いコンテキストを与えたことから生まれました。
最初のバージョンはプルリクエストを見ていましたが、周辺の実装を見落とすことがよくありました。新しいバージョンは、次のような問いに答えるのに役立つ情報を取得できます。
- このパターンはリポジトリ内の他の場所ですでに使われているか
- 提案された変更は近くのコードと一貫しているか
- この関数には現在の挙動に依存する呼び出し元があるか
- このパスをカバーするテストはあるか
- この例外処理は意図的なものか
- コードは設定値や実行時の前提に依存しているか
- この問題は同じプルリクエストの別の部分ですでに対処されているか
これが重要なのは、質の悪いレビューコメントの多くが、見えている範囲が不完全であることから生じるからです。
たとえば、エージェントがディレクトリへの書き込みを見つけると、そのディレクトリが存在するかの確認を提案するかもしれません。それが役立つこともあります。しかし、関数が呼び出される前にセットアップのコードがすでにディレクトリを作成しているなら、そのコメントはノイズになります。
役に立つ検出結果と誤検知の違いは、多くの場合、1つか2つのファイル分のコンテキストにすぎません。
取得によってすべての問題が解決するわけではありませんが、モデルが部分的な視点から挙動を推測しなければならないケースは劇的に減ります。
コメント数の最適化をやめた
最も重要な変更の一つは、システムをより慎重にしたことです。
最初のバージョンは、暗黙のうちに何かを見つけることを評価していました。2つ目のバージョンは、役に立つことを評価します。
そのためには、出力に関する異なる考え方が必要でした。レビュアーは、何かが改善できるかもしれないというだけでコメントすべきではありません。具体的な問題があり、それを裏付けるコンテキストが十分にあり、作成者が取れる明確な行動があるときにコメントすべきです。
スタイルに関する提案は、たいてい十分な理由にはなりません。大規模なリファクタリングの提案も、たいてい十分ではありません。未知のビジネス上の意図に左右される問題の可能性も、たいてい十分ではありません。
現在のシステムは、確信度が低いときには沈黙を選ぶように設計されています。
これは難しくも必要な変更でした。多くのAIシステムは、出力が多いほど印象的に感じられます。コードレビューはその逆です。コメントの頻度は低くても、たいてい正しいレビューエージェントは、考えられるあらゆる懸念にコメントするエージェントよりもはるかに価値があります。
信頼は、抑制によって築かれます。
確信度のしきい値とコメントの品質
当社はまた、不確実性をシステムの中核的な要素として扱い始めました。
検出結果を投稿する前に、レビュアーはその問題が具体的で、対応可能で、利用可能なコンテキストによって裏付けられているかどうかを検討します。優れたコメントは、通常いくつかの基準を満たしているべきです。
- 変更内の具体的な場所を指している
- リスクを明確に説明している
- 曖昧な表現を避けている
- エージェントが検証できない前提に依存していない
- リポジトリで確認できる規約と矛盾していない
- 実用的な修正や次のステップを提案している
- 作成者の手を止めさせるだけの重要性がある
技術的に正しいコメントでも役に立たない場合があるため、このフィルタリングは重要です。
たとえば、リファクタリングの提案は単独で見れば妥当かもしれませんが、コードが明確で、近くのパターンと一貫しており、プルリクエストの目的と無関係であれば、投稿する価値はありません。同様に、より広い例外処理を推奨するのは安全そうに聞こえるかもしれませんが、有用な障害モードを隠し、デバッグを難しくする可能性があります。
レビュアーは、意見を持ったリンターのように振る舞うべきではありません。投稿するすべてのコメントのコストを理解した、慎重なアシスタントのように振る舞うべきです。
現在のバージョンがうまく見つけられるもの
現在のバージョンが最も力を発揮するのは、期待される挙動をコードから検証できる、反復的で機械的な問題です。
これらは重要であることが多い一方で、必ずしも深いビジネスコンテキストを必要としない種類の検出結果です。また、シニアエンジニアが手動レビューで繰り返し見つけている種類の問題でもあります。
このシステムは、次のような問題の特定に役立っています。
- クラッシュを引き起こす可能性のある、処理されていない例外
- 早期リターンの陰に隠れたリソースリーク
- 計算されるが永続化されない状態変更
- リファクタリング後に残されたデッドコード
- 存在しない可能性のあるディレクトリへの書き込みなど、セットアップ手順の欠如
- 成功パスと失敗パスで一貫しないクリーンアップの挙動
- ファイル、プロセス、ネットワークの操作に関する安全でない前提
- 限定的で具体的なシナリオにおける競合状態
特に役立った検出結果の一つは、実際のTOCTOU(time-of-check to time-of-use)の問題でした。コードはある条件が真であることを確認し、その後、条件が変わっていないという前提で操作を実行していました。この種の問題は、関連する行が個別には妥当に見えるため、レビューで見逃しやすいものです。エージェントはその一連の流れを結び付け、リスクを指摘できました。
現時点で当社がAIレビューに最も価値を感じているのはこの点です。アーキテクトとしてではなく、機械的な正しさを疲れることなくチェックするレビュアーとしての価値です。
これにより、重要なレビューの流れから反復的な作業の一部を取り除き、人間のレビュアーがより高いレベルの判断に集中できるようになります。
まだ見逃しているもの
このシステムは最初のバージョンより優れていますが、人間のレビューに取って代わるにはほど遠い状態です。
幅広いアーキテクチャ上の推論、ドメイン固有のビジネスロジック、そして最も重要なコンテキストがリポジトリの外にある判断には、依然として苦戦しています。コードがどう動くかは理解できることが多いものの、なぜそのように書かれたのかを理解するのははるかに困難です。
意図の理解は、依然として最も難しい課題です。
レビュアーは今でも、技術的には妥当でも役に立たない変更を提案することがあります。すでに許容できるコードのリファクタリングを推奨することがあります。現在の明示的な実装のほうが保守しやすいのに、より汎用的な抽象化を提案することがあります。より狭い例外型が意図的に選ばれている場合でも、より広い例外処理を提案することがあります。
たとえば、システムは次のような特定の例外処理を、
except RuntimeError
次のような広い処理に置き換えるよう提案したことがあります。
except Exception
文脈によっては、それが妥当な場合もあるでしょう。しかし、そうでない場合にはかえって悪くなります。広い例外を捕捉すると、プログラミングのエラーが隠れ、障害のデバッグが難しくなり、周辺のコードが依存している保証が弱まる可能性があります。
エージェントは実装の詳細を評価できますが、設計の意図を常に理解できるわけではありません。
この制約が、当社の使い方を決めています。強いエビデンスがない限り、レビュアーには広範なアーキテクチャ上の推奨をしてほしくありません。コード自体が、検出結果を信頼できるものにするのに十分なコンテキストを提供している問題に焦点を当ててほしいのです。
評価についての考え方
当社はもはや、レビュアーが生成するコメントの数で評価していません。
コメント数が多いことは成功ではありません。多くの場合、それは警告のサインです。
当社が重視している指標は、次のようなものに近いです。
- エンジニアがどれくらいの頻度でコメントに同意するか
- どれくらいの頻度でコメントが実際のコード変更につながるか
- 無関係として却下されるコメントがどれくらいあるか
- 同じ問題がどれくらいの頻度で複数回報告されるか
- レビュアーがエージェントのフィードバックの検証にどれくらいの時間を費やすか
- シニアレビュアーより先に、エージェントが反復的な問題を見つけられるか
- エンジニアが時間が経ってもツールを信頼し続けるか
最も重要なシグナルは、エンジニアがエージェントのフィードバックを読む価値のあるものとして扱っているかどうかです。
エンジニアがコメントを読み飛ばすなら、一部の検出結果が技術的に正しくても、システムは失敗しています。エンジニアが少数の的確なコメントに一貫して対応しているなら、システムは役割を果たしています。
だからこそ、当社は意図的に慎重な姿勢を取っています。エンジニアにレビュアーを無視する癖をつけさせるくらいなら、判断の分かれる問題を見逃すほうを選びます。
社内の実験からプラットフォームの機能へ
社内の実験として始まったものが、今ではより広い製品の方向性に生かされています。
当社は、AIによるコードレビュー機能をOstorlabプラットフォームに導入する取り組みを進めています。この機能を外部に公開する前に、当社自身のプルリクエストで使い、どこで役立つかを観察し、どこにガードレールが必要かを理解したいと考えました。
社内で使ったことで、この機能のあるべき姿が明確になりました。
エンジニアリングの判断に取って代わるべきではありません。すべてのプルリクエストを、AIが生成したコメントで埋め尽くすべきではありません。何かを見つけたことを証明しようとする、自信過剰なジュニアレビュアーのように振る舞うべきではありません。
そうではなく、チームが反復的、機械的、そしてセキュリティに関わる問題を、開発プロセスのより早い段階で見つけられるよう支援すべきです。
これはアプリケーションセキュリティ(AppSec)にとって特に重要です。多くのセキュリティ問題は、デプロイ後や後のスキャンの段階よりも、コードレビューの段階で修正するほうがコストを抑えられます。役に立つAIレビュアーは、コードが書かれる場所に近いところでリスクのあるパターンを特定することで、既存のAppSecワークフローを補完できます。
だからといって、SAST、DAST、手動のセキュリティレビュー、経験豊富なエンジニアの代わりになるわけではありません。ワークフローにもう一つの層を加えるものです。早期に、コンテキストを踏まえて、開発者に向けたフィードバックを提供することに特化した層です。
この機能がいつ利用可能になるのかを尋ねるユーザーからの関心も、すでに寄せられています。こうした需要は、コードレビューがアプリケーションセキュリティのワークフローの重要な一部になりつつあるという当社の考えを裏付けています。
しかし、リリースの速さよりも有用性のほうが重要です。当社が優先しているのは、本番環境のユーザーに届ける前に、この機能を慎重で、信頼でき、実用的なものにすることです。
学んだこと
AIレビュアーはジュニアエンジニアではない
よくある間違いは、AIレビュアーをジュニア開発者であるかのように扱うことです。
そうではありません。
ジュニアエンジニアは時間とともにコンテキストを蓄積します。質問をします。過去の判断を覚えています。システムの歴史やチームの好みを学びます。経験を通じて判断力を身に付けます。
AIシステムの動き方は異なります。パターン認識、一貫性、要約、反復的な分析が得意です。大量のコードを素早く調べられます。人間が見落としがちな機械的な問題を特定できます。
しかし、組織の歴史、製品の意図、アーキテクチャ上のトレードオフは、それらが利用可能な形で与えられない限り、自然に理解できるわけではありません。
AIレビュアーにとって最適な役割は、置き換えではありません。支援です。
カバレッジよりも信頼が重要
最も重要な指標は、レビュアーが生成する検出結果の数ではありません。
エンジニアが信頼する検出結果の数です。
正確で対応可能なコメントを10件生成するシステムは、手動での検証が必要なコメントを100件生成するシステムよりも価値があります。カバレッジは重要ですが、それはシステムが信頼を得た後の話です。
コードレビューエージェントにとって、抑制は機能の一つです。沈黙が正しい出力であることもあります。
コンテキストが、役に立つかノイズになるかを分ける
AIレビューの失敗の多くは、コンテキストの失敗です。
狭い差分をレビューするモデルは、疑わしく見えても実際には別の場所ですでに対処されているものを特定することがあります。リポジトリと矛盾する規約を推奨することがあります。テスト環境、実行時の前提、アーキテクチャ上の境界を誤解することがあります。
より優れたモデルは役立ちますが、より良いコンテキストも同じくらい重要です。
レビュアーには、人間のレビュアーが自然に使う情報、つまり周辺のコード、関連するファイル、テスト、規約、設定、過去のパターンへのアクセスが必要です。
そのコンテキストがなければ、システムは推測します。そして、コードレビューにおいて自信に満ちた推測は危険です。
止めることが正しい判断であるときもある
当社の最初の試みは失敗しました。
当時は残念な結果でした。振り返ってみると、それはこのプロジェクトで最も有益な成果の一つでした。
運用を停止したことで、当社は本当の問題を理解せざるを得なくなりました。問題は、単にモデルがもっと優れている必要があるということではありませんでした。当社のシステムが、信頼されるレビューコメントではなく、レビューコメントを生成することに最適化されていたことが問題だったのです。
プロジェクトに再び取り組んだとき、当社はゼロからやり直したわけではありません。失敗したバージョンから得た教訓の上に構築していたのです。
すべてのエンジニアリングプロジェクトが最初の試みで成功するわけではありません。ときには、いったん止めて学び、技術と問題への理解の両方が進んだときに戻ってくることが正しい判断になります。
今回起きたのは、まさにそういうことでした。
当社は今でも、AIが人間によるプルリクエストレビューに取って代わるべきだとは考えていません。しかし、焦点を絞り、コンテキストを踏まえ、慎重であれば、AIはレビューをより良いものにできると考えています。
目指すのは、より多くコメントするAIレビュアーではありません。
目指すのは、エンジニアが本当に信頼できるAIレビュアーです。