Construir un revisor de PR con IA en el que los ingenieros realmente confían
Construimos un revisor de pull requests con IA, lo desactivamos después de que las alucinaciones y los falsos positivos erosionaran la confianza de los desarrolladores, y luego lo reconstruimos con mejores modelos, un contexto más amplio y una arquitectura de agente más conservadora. Este artículo comparte lo que aprendimos sobre la revisión de código automatizada, por qué la confianza importa más que la cobertura, y cómo los revisores con IA pueden ayudar a los equipos de ingeniería a reducir el trabajo de revisión repetitivo sin reemplazar el criterio humano.
Por qué la revisión de PR es un buen problema para la IA
En algún momento del camino, nuestro revisor de pull requests con IA dejó de sentirse como un experimento.
Se convirtió en parte del flujo de revisión.
Los ingenieros no estaban de acuerdo con él, lo ignoraban y, en ocasiones, le daban las gracias. Un ingeniero incluso respondió con un emoji de beso después de que aprobara una pull request.
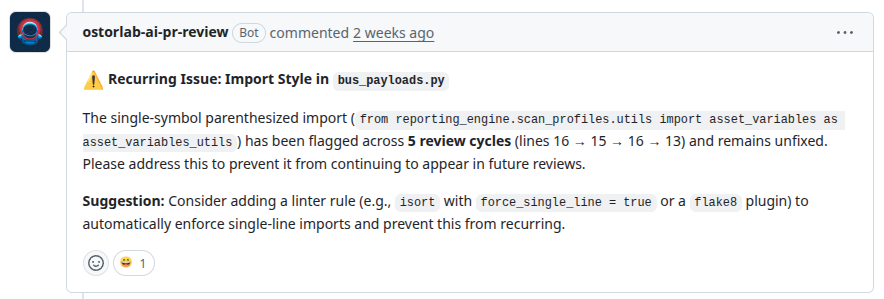
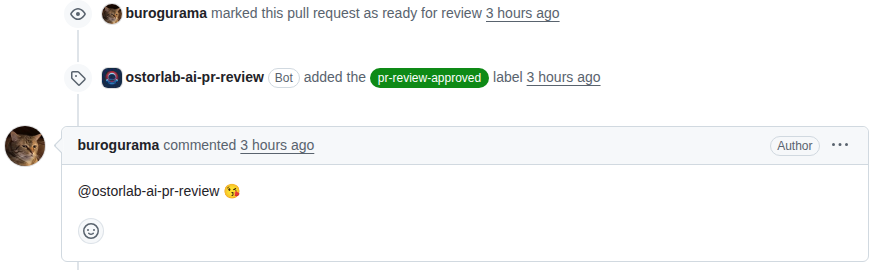
Esas interacciones fueron útiles de observar, no porque el revisor siempre tuviera razón, sino porque mostraban lo que ocurre cuando la retroalimentación de la IA pasa a formar parte de un flujo de trabajo de ingeniería.
La pregunta ya no es solo si el sistema puede encontrar problemas.
Es si los ingenieros están dispuestos a confiar en lo que dice.
Nuestra primera versión fracasó.
No la desactivamos porque pasara por alto problemas.
La desactivamos porque encontraba demasiados problemas que no existían.
Esa distinción importa. La mayoría de las conversaciones sobre la revisión de código con IA se centran en la cobertura: cuántos errores puede encontrar un sistema, cuántas vulnerabilidades puede detectar o cuántos comentarios puede generar. En la práctica, la métrica que más nos importó no fue la cobertura. Fue la confianza.
La revisión de pull requests es un lugar natural para aplicar IA. Los ingenieros sénior dedican una cantidad considerable de tiempo a identificar patrones recurrentes, hacer cumplir convenciones, detectar suposiciones poco seguras, comprobar casos límite y preguntarse si un cambio encaja con el resto del sistema. Parte de ese trabajo requiere un criterio arquitectónico profundo. Pero una gran parte es repetitiva y mecánica.
Esas comprobaciones repetitivas son exactamente donde la IA puede ayudar.
El reto es que la revisión de código no consiste solo en encontrar problemas. Consiste en encontrar los problemas correctos, explicarlos con claridad y hacerlo con la precisión suficiente para que los ingenieros estén dispuestos a actuar sobre la retroalimentación.
Un revisor ruidoso es peor que ningún revisor. Un ingeniero humano puede ignorar el silencio. No puede ignorar un comentario plausible pero incorrecto sin dedicar tiempo a demostrar que está equivocado.
Esa fue la lección que aprendimos por las malas.
Nuestro primer intento
Nuestra primera versión tenía un objetivo sencillo: revisar las pull requests antes de que interviniera un revisor humano y detectar los problemas comunes desde el principio.
En su momento, esto parecía un caso de uso práctico y de alto impacto. Las revisiones de pull requests se habían convertido en un cuello de botella. Los ingenieros sénior dedicaban demasiado tiempo a retroalimentación repetitiva, y las colas de revisión estaban ralentizando el desarrollo en todo el equipo.
El objetivo nunca fue reemplazar a los revisores. Era reducir la parte mecánica del proceso de revisión para que los ingenieros pudieran dedicar más tiempo a la arquitectura, el impacto en la seguridad y la lógica de negocio.
La primera versión se ejecutaba automáticamente cuando se abría o actualizaba una pull request. Recopilaba el diff, reunía los archivos modificados y un contexto circundante limitado, enviaba esa información a un modelo de lenguaje y publicaba comentarios de revisión de vuelta en la pull request.
El flujo de trabajo era deliberadamente simple:
- Un evento de pull request activaba el revisor.
- El sistema extraía el diff y los archivos modificados.
- El modelo revisaba el cambio usando un prompt fijo.
- Los hallazgos generados se convertían en comentarios de pull request.
- Los ingenieros revisaban esos comentarios junto con la retroalimentación humana.
La simplicidad facilitó la construcción del sistema, pero también se convirtió en su mayor debilidad. El agente podía ver qué había cambiado, pero a menudo no podía ver lo suficiente del sistema circundante para entender si un hallazgo era realmente válido.
Sobre el papel, la hipótesis era razonable. Si un revisor con IA pudiera detectar problemas comunes antes de que una pull request llegara a un ingeniero sénior, los revisores podrían dedicar menos tiempo a repetir la misma retroalimentación y más tiempo a discutir decisiones de diseño.
En la práctica, el sistema producía comentarios que sonaban útiles pero que a menudo eran incorrectos.
El modo de fallo: retroalimentación plausible pero incorrecta
La primera versión no falló de una manera evidente.
No publicaba comentarios sin sentido. No malinterpretaba todas las pull requests. No producía recomendaciones obviamente erróneas.
El problema era más sutil: muchos comentarios eran lo bastante plausibles como para que los ingenieros se sintieran obligados a investigarlos, pero lo bastante incorrectos como para que la investigación a menudo supusiera una pérdida de tiempo.
Algunos ejemplos eran menores pero molestos. El agente a veces recomendaba cambios de estilo que entraban en conflicto con nuestras propias convenciones, como sugerir nombres de pruebas en snake_case en una base de código que usaba sistemáticamente camelCase.
Algunos comentarios eran más disruptivos. En un caso, el agente marcó código que ya se había corregido en otra parte de la misma pull request. En otro, recomendó añadir pruebas de integración que requerían un entorno de navegador, aunque nuestro entorno de CI no admitía la ejecución basada en navegador.
También vimos aparecer comentarios duplicados en la misma pull request. El agente identificaba el mismo problema percibido más de una vez y publicaba varias variaciones de la misma retroalimentación. Incluso cuando la observación subyacente era válida, la repetición hacía que la revisión se sintiera ruidosa.
Los comentarios más frustrantes eran los que parecían razonables a primera vista. Por ejemplo, el agente podía sugerir un manejo de excepciones más amplio sin entender que el tipo de excepción más restringido era intencional. O podía recomendar una refactorización que era técnicamente válida pero incoherente con el código cercano.
Un mal comentario de revisión con IA tiene un coste. Alguien tiene que leerlo, entenderlo, comprobar si aplica, inspeccionar el código circundante y decidir si actuar sobre él. Si el comentario está equivocado, todo ese tiempo se desperdicia.
Con el tiempo, los ingenieros dejaron de tratar al agente como un revisor útil y empezaron a tratarlo como otra fuente de ruido de revisión.
Llegados a ese punto, el proyecto ya no estaba ayudando.
Así que lo apagamos.
La lección real: los falsos positivos son peores que los fallos omitidos
La lección más importante de la primera versión fue que los falsos positivos suelen ser más dañinos que los hallazgos omitidos.
Un revisor que ocasionalmente pasa por alto un problema puede seguir siendo útil. Un revisor que plantea repetidamente problemas incorrectos genera trabajo para todos los demás.
Esto es especialmente cierto en la revisión de código porque los comentarios de revisión interrumpen el flujo de trabajo de un ingeniero. Un comentario no es solo texto. Es una solicitud de atención. Pide al autor que se detenga, inspeccione el código, razone sobre el problema y decida si es necesario un cambio.
Si esa solicitud resulta estar equivocada con demasiada frecuencia, la confianza se erosiona rápidamente.
Una vez que se pierde la confianza, incluso los comentarios correctos pierden valor. Los ingenieros empiezan a verificarlo todo. Leen la retroalimentación del agente a la defensiva. Asumen que probablemente está equivocada hasta que se demuestre lo contrario.
Eso cambia el papel de la herramienta. En lugar de reducir la carga de revisión, la aumenta.
Para la revisión de código con IA, la precisión importa más que el volumen. Diez comentarios no son mejores que uno solo si nueve de ellos requieren un descarte manual. Un buen agente de revisión debería sentirse cómodo permaneciendo en silencio.
Ese se convirtió en el principio rector de la segunda versión.
Por qué la revisión de código necesita más contexto que un diff
Nuestra primera versión trataba la revisión de pull requests principalmente como un problema de análisis de diffs. Eso fue un error.
Los revisores experimentados no evalúan un cambio mirando solo las líneas modificadas. Usan un conjunto de contexto mucho más amplio:
- Patrones existentes en el código circundante
- Convenciones de nomenclatura y pruebas específicas del proyecto
- Comportamiento de las dependencias
- Suposiciones en tiempo de ejecución
- Limitaciones de la CI
- Límites de seguridad
- Decisiones de diseño previas
- Lógica de negocio e intención del producto
- Si un problema similar ya se ha resuelto en otro lugar
Un cambio que parece sospechoso de forma aislada puede ser correcto al verse dentro del sistema completo. Lo contrario también es cierto: un cambio que parece inofensivo en un diff puede introducir un error debido al comportamiento de otro archivo, servicio o ruta de ejecución.
Esta brecha de contexto explicaba muchos de los fallos de la primera versión.
El modelo a menudo no se equivocaba por falta de capacidad de lenguaje. Se equivocaba porque le faltaba suficiente información. Cuando el sistema no podía ver el contexto relevante, adivinaba. Y cuando adivinaba, a veces producía una retroalimentación confiada pero incorrecta.
El problema no era solo el modelo.
El problema era la arquitectura alrededor del modelo.
Por qué retomamos el problema
Finalmente retomamos la revisión de pull requests con IA porque el problema original no había desaparecido.
Los ingenieros sénior seguían dedicando tiempo a tareas de revisión repetitivas. Muchas de esas tareas eran importantes, pero no siempre requerían un criterio de nivel sénior. Seguíamos creyendo que había valor en detectar problemas mecánicos con antelación, siempre que pudiéramos evitar generar ruido.
Al mismo tiempo, la tecnología había mejorado.
Los modelos más nuevos eran mejores para entender el código, seguir restricciones y razonar a través de detalles de implementación. Las ventanas de contexto más amplias hicieron posible proporcionar más contexto del repositorio en lugar de obligar al modelo a trabajar a partir de un diff limitado. Los patrones de agentes también habían madurado: en lugar de depender de un único prompt, los sistemas podían recuperar información, inspeccionar archivos, invocar herramientas y estructurar su trabajo en torno a objetivos de revisión específicos.
Eso cambió nuestro enfoque.
Ya no intentábamos construir un revisor genérico que comentara todo lo que notara. Intentábamos construir un sistema de revisión conservador centrado en hallazgos de alta confianza y alta señal.
La pregunta cambió de:
¿Cuántos problemas puede encontrar el agente?
a:
¿Sobre qué problemas debería poder comentar el agente?
Ese cambio hizo que la segunda versión fuera mucho mejor.
Qué cambió en la arquitectura
El sistema actual no surgió de un único avance. Surgió de varias iteraciones en torno a una idea central: el revisor necesita contexto antes de ganarse el derecho a comentar.
Nuestros primeros experimentos usaban CrewAI para coordinar el comportamiento de revisión. Ese enfoque era prometedor, pero el resultado no era lo bastante fiable de forma consistente para la revisión de pull requests. Después pasamos a un flujo de trabajo más simple basado en Pydantic, que nos dio más estructura y más control sobre el pipeline de revisión. Eso mejoró la consistencia, pero el sistema seguía malinterpretando el código cuando faltaba el contexto relevante.
La siguiente iteración avanzó hacia una arquitectura basada en herramientas.
En lugar de pedirle al modelo que revise una pull request a partir de un prompt fijo, el sistema ahora puede reunir información adicional según sea necesario. Puede inspeccionar archivos relacionados, examinar implementaciones cercanas, recuperar convenciones relevantes y acotar su análisis a tareas de revisión específicas.
A grandes rasgos, el flujo es el siguiente:
-
Evento de pull request recibido
El sistema se inicia cuando se abre o actualiza una pull request. -
Diff y archivos modificados analizados
El revisor identifica qué cambió y qué archivos se vieron afectados. -
Objetivos de revisión seleccionados
En lugar de realizar una revisión abierta, el sistema se centra en categorías específicas de problemas. -
Contexto relevante recuperado
El agente reúne código circundante, funciones relacionadas, pruebas, archivos de configuración y patrones del repositorio. -
Análisis dirigido realizado
El sistema busca problemas concretos como falta de limpieza, excepciones no gestionadas, suposiciones poco seguras o cambios de estado que no se persisten. -
Hallazgos filtrados por confianza
Las observaciones de baja confianza se suprimen en lugar de publicarse. -
Comentarios generados de forma conservadora
Solo se muestran los hallazgos específicos, accionables y vinculados a la pull request.
Esta arquitectura hizo que el sistema fuera más útil porque redujo las conjeturas.
El revisor pasó de parecerse a un chatbot reaccionando a un diff a parecerse más a una herramienta de ingeniería especializada con un mandato acotado.
La recopilación de contexto se convirtió en la función más importante
La mayor mejora provino de dotar al sistema de un mejor contexto.
Nuestra primera versión veía la pull request pero a menudo pasaba por alto la implementación circundante. La versión más nueva puede recuperar información que ayuda a responder preguntas como:
- ¿Este patrón ya se usa en otra parte del repositorio?
- ¿El cambio sugerido es coherente con el código cercano?
- ¿Esta función tiene llamadores que dependen del comportamiento actual?
- ¿Hay pruebas que cubran esta ruta?
- ¿Este manejo de excepciones es intencional?
- ¿El código depende de un valor de configuración o de una suposición en tiempo de ejecución?
- ¿El problema ya se maneja en otra parte de la misma pull request?
Esto importa porque muchos comentarios de revisión erróneos provienen de una visibilidad incompleta.
Por ejemplo, si el agente ve una escritura en un directorio, puede sugerir comprobar que el directorio existe. Eso puede ser útil. Pero si el código de configuración ya crea el directorio antes de llamar a la función, el comentario se convierte en ruido.
La diferencia entre un hallazgo útil y un falso positivo suele ser uno o dos archivos de contexto.
La recuperación no resuelve todos los problemas, pero reduce drásticamente el número de casos en los que el modelo tiene que inferir el comportamiento a partir de una vista parcial.
Dejamos de optimizar para el número de comentarios
Uno de los cambios más importantes fue hacer que el sistema fuera más conservador.
La primera versión recompensaba implícitamente el hecho de encontrar cosas. La segunda recompensa ser útil.
Eso requirió una filosofía de salida diferente. El revisor no debería comentar solo porque algo podría mejorarse. Debería comentar cuando haya un problema concreto, suficiente contexto de respaldo y una acción clara que el autor pueda tomar.
Una sugerencia de estilo normalmente no es suficiente. Una sugerencia de refactorización amplia normalmente no es suficiente. Un posible problema que depende de una intención de negocio desconocida normalmente no es suficiente.
El sistema ahora está diseñado para preferir el silencio cuando la confianza es baja.
Fue un cambio difícil pero necesario. Muchos sistemas de IA se sienten más impresionantes cuando producen más resultados. La revisión de código es lo contrario. Un agente de revisión que comenta con menos frecuencia pero suele tener razón es mucho más valioso que uno que comenta sobre cada posible inquietud.
La confianza se construye mediante la contención.
Umbrales de confianza y calidad de los comentarios
También empezamos a tratar la incertidumbre como un elemento de primera clase del sistema.
Antes de publicar un hallazgo, el revisor considera si el problema es específico, accionable y está respaldado por el contexto disponible. Un buen comentario debería normalmente cumplir varios criterios:
- Señala una ubicación concreta en el cambio.
- Explica el riesgo con claridad.
- Evita el lenguaje vago.
- No depende de suposiciones que el agente no pueda verificar.
- No entra en conflicto con convenciones visibles del repositorio.
- Sugiere una corrección o un siguiente paso práctico.
- Es lo bastante importante como para interrumpir al autor.
Este filtrado importa porque los comentarios técnicamente correctos pueden seguir siendo poco útiles.
Por ejemplo, sugerir una refactorización puede ser razonable de forma aislada, pero no vale la pena publicarla si el código es claro, coherente con los patrones cercanos y ajeno al propósito de la pull request. Del mismo modo, recomendar un manejo de excepciones más amplio puede sonar más seguro, pero puede ocultar modos de fallo útiles y dificultar la depuración.
El revisor no debería comportarse como un linter con opiniones. Debería comportarse como un asistente cuidadoso que comprende el coste de cada comentario que publica.
Lo que la versión actual detecta bien
La versión actual rinde mejor en problemas repetitivos y mecánicos donde el comportamiento esperado se puede verificar a partir del código.
Este tipo de hallazgos suele importar, pero no siempre requiere un contexto de negocio profundo. También son los tipos de problemas que los ingenieros sénior detectan repetidamente durante la revisión manual.
El sistema ha resultado útil para identificar problemas como:
- Excepciones no gestionadas que podrían provocar fallos
- Fugas de recursos ocultas tras retornos tempranos
- Cambios de estado que se calculan pero nunca se persisten
- Código muerto dejado tras refactorizaciones
- Pasos de configuración faltantes, como escribir en directorios que podrían no existir
- Comportamiento de limpieza incoherente entre las rutas de éxito y fallo
- Suposiciones poco seguras en torno a operaciones de archivos, procesos o red
- Condiciones de carrera en escenarios concretos y acotados
Un hallazgo particularmente útil fue un problema real de tipo tiempo-de-comprobación-a-tiempo-de-uso (time-of-check to time-of-use). El código comprobaba que una condición era verdadera y luego realizaba una operación más tarde bajo la suposición de que la condición no había cambiado. Ese tipo de problema es fácil de pasar por alto en la revisión porque las líneas relevantes pueden parecer razonables individualmente. El agente fue capaz de conectar la secuencia y señalar el riesgo.
Aquí es donde la revisión con IA se siente actualmente más valiosa para nosotros: no como un arquitecto, sino como un revisor incansable de la corrección mecánica.
Ayuda a eliminar parte del trabajo repetitivo de la ruta de revisión crítica para que los revisores humanos puedan centrarse en un criterio de nivel superior.
Lo que todavía se le escapa
El sistema es mejor que la primera versión, pero está lejos de reemplazar la revisión humana.
Todavía tiene dificultades con el razonamiento arquitectónico amplio, la lógica de negocio específica del dominio y las decisiones donde el contexto más importante vive fuera del repositorio. A menudo puede entender cómo funciona el código. Entender por qué el código se escribió de esa manera es mucho más difícil.
La intención sigue siendo el problema más difícil.
El revisor puede seguir sugiriendo cambios que son técnicamente válidos pero no útiles. Puede recomendar refactorizar código que ya es aceptable. Puede sugerir una abstracción más general cuando la implementación explícita actual es más fácil de mantener. Puede proponer un manejo de excepciones más amplio incluso cuando se eligió intencionalmente un tipo de excepción más restringido.
Por ejemplo, el sistema ha sugerido reemplazar un manejo de excepciones específico como:
except RuntimeError
por un manejo más amplio como:
except Exception
En algunos contextos, eso podría ser razonable. En otros, es peor. Capturar una excepción amplia puede ocultar errores de programación, dificultar la depuración de los fallos y debilitar las garantías en las que se apoya el código circundante.
El agente puede evaluar detalles de implementación, pero no siempre entiende la intención de diseño.
Esa limitación determina cómo lo usamos. No queremos que el revisor haga recomendaciones arquitectónicas amplias a menos que tenga evidencia sólida. Queremos que se centre en problemas donde el propio código proporcione suficiente contexto para que el hallazgo sea fiable.
Cómo pensamos sobre la evaluación
Ya no evaluamos al revisor por el número de comentarios que produce.
Un recuento alto de comentarios no es un éxito. En muchos casos, es una señal de alerta.
Las métricas que nos importan se acercan más a:
- Con qué frecuencia los ingenieros están de acuerdo con el comentario
- Con qué frecuencia un comentario conduce a un cambio de código real
- Cuántos comentarios se descartan por irrelevantes
- Con qué frecuencia se reporta el mismo problema más de una vez
- Cuánto tiempo dedican los revisores a validar la retroalimentación del agente
- Si el agente detecta problemas repetitivos antes que los revisores sénior
- Si los ingenieros siguen confiando en la herramienta con el tiempo
La señal más importante es si los ingenieros tratan la retroalimentación del agente como algo que vale la pena leer.
Si los ingenieros se saltan los comentarios, el sistema ha fallado, incluso si algunos de los hallazgos son técnicamente correctos. Si los ingenieros actúan de forma constante sobre un pequeño número de comentarios precisos, el sistema está cumpliendo su función.
Por eso somos deliberadamente conservadores. Preferimos pasar por alto un problema límite antes que entrenar a los ingenieros para que ignoren al revisor.
De experimento interno a funcionalidad de la plataforma
Lo que comenzó como un experimento interno ahora está dando forma a una dirección de producto más amplia.
Estamos trabajando para incorporar capacidades de revisión de código con IA en la plataforma de Ostorlab. Antes de exponer la funcionalidad externamente, quisimos usarla en nuestras propias pull requests, observar dónde ayudaba y entender dónde necesitaba barreras de seguridad.
Ese uso interno aclaró lo que debía ser la funcionalidad.
No debería reemplazar el criterio de ingeniería. No debería convertir cada pull request en un muro de comentarios generados por IA. No debería comportarse como un revisor júnior demasiado confiado que intenta demostrar que encontró algo.
En su lugar, debería ayudar a los equipos a detectar problemas repetitivos, mecánicos y relevantes para la seguridad antes en el proceso de desarrollo.
Esto es especialmente importante para la seguridad de aplicaciones. Muchos problemas de seguridad son más baratos de corregir durante la revisión de código que después del despliegue o durante un escaneo posterior. Un revisor con IA útil puede complementar los flujos de trabajo de AppSec existentes al identificar patrones de riesgo más cerca del punto en el que se escribe el código.
Eso no lo convierte en un reemplazo de SAST, DAST, la revisión de seguridad manual o los ingenieros experimentados. Lo convierte en otra capa del flujo de trabajo: una centrada en la retroalimentación temprana, contextual y orientada al desarrollador.
Ya hemos visto interés por parte de usuarios que preguntan cuándo estará disponible esta capacidad. Esa demanda refuerza nuestra convicción de que la revisión de código se está convirtiendo en una parte importante del flujo de trabajo de seguridad de aplicaciones.
Pero la utilidad importa más que la velocidad de lanzamiento. Nuestra prioridad es hacer que la funcionalidad sea conservadora, fiable y práctica antes de que llegue a los usuarios en producción.
Lecciones aprendidas
Los revisores con IA no son ingenieros júnior
Un error común es tratar a los revisores con IA como si fueran desarrolladores júnior.
No lo son.
Los ingenieros júnior acumulan contexto con el tiempo. Hacen preguntas. Recuerdan decisiones previas. Aprenden la historia de un sistema y las preferencias de un equipo. Desarrollan criterio a través de la experiencia.
Los sistemas de IA operan de forma diferente. Son fuertes en el reconocimiento de patrones, la consistencia, el resumen y el análisis repetitivo. Pueden inspeccionar grandes cantidades de código rápidamente. Pueden identificar problemas mecánicos que los humanos podrían pasar por alto.
Pero no comprenden de forma natural la historia organizativa, la intención del producto o las concesiones arquitectónicas, a menos que se les proporcione esa información.
El mejor papel para un revisor con IA no es el reemplazo. Es la asistencia.
La confianza importa más que la cobertura
La métrica más importante no es cuántos hallazgos genera el revisor.
Es cuántos hallazgos confían los ingenieros.
Un sistema que produce diez comentarios precisos y accionables es más valioso que uno que produce cien comentarios que requieren verificación manual. La cobertura importa, pero solo después de que el sistema se haya ganado la confianza.
Para los agentes de revisión de código, la contención es una funcionalidad. El silencio a veces es el resultado correcto.
El contexto es la diferencia entre lo útil y lo ruidoso
Muchos fallos de la revisión con IA son fallos de contexto.
Un modelo que revisa un diff limitado puede identificar algo que parece sospechoso pero que ya se maneja en otro lugar. Puede recomendar una convención que entra en conflicto con el repositorio. Puede malinterpretar un entorno de pruebas, una suposición en tiempo de ejecución o un límite arquitectónico.
Los modelos mejores ayudan, pero el mejor contexto importa igual de mucho.
El revisor necesita acceso a la información que un revisor humano usaría de forma natural: código circundante, archivos relacionados, pruebas, convenciones, configuración y patrones previos.
Sin ese contexto, el sistema adivina. Y las conjeturas confiadas son peligrosas en la revisión de código.
A veces la decisión correcta es detenerse
Nuestro primer intento fracasó.
En su momento, eso fue decepcionante. En retrospectiva, fue uno de los resultados más útiles del proyecto.
Desactivarlo nos obligó a entender el problema real. El problema no era simplemente que el modelo necesitara ser mejor. El problema era que nuestro sistema estaba optimizado para producir comentarios de revisión en lugar de producir comentarios de revisión fiables.
Cuando retomamos el proyecto, no empezábamos de cero. Estábamos construyendo sobre las lecciones de la versión fallida.
No todos los proyectos de ingeniería tienen éxito en el primer intento. A veces la decisión correcta es detenerse, aprender y volver cuando tanto la tecnología como nuestra comprensión del problema hayan mejorado.
Eso es lo que ocurrió aquí.
Seguimos sin creer que la IA deba reemplazar la revisión humana de pull requests. Pero sí creemos que puede mejorar la revisión cuando es enfocada, contextual y conservadora.
El objetivo no es un revisor con IA que comente más.
El objetivo es un revisor con IA en el que los ingenieros realmente confíen.