Construire un relecteur de PR en IA auquel les ingénieurs font vraiment confiance
Nous avons construit un relecteur de pull requests propulsé par l'IA, l'avons arrêté après que des hallucinations et des faux positifs aient érodé la confiance des développeurs, puis l'avons reconstruit avec de meilleurs modèles, un contexte plus large et une architecture d'agent plus prudente. Cet article partage ce que nous avons appris sur la relecture de code automatisée, pourquoi la confiance compte plus que la couverture, et comment les relecteurs IA peuvent aider les équipes d'ingénierie à réduire le travail de relecture répétitif sans remplacer le jugement humain.
Pourquoi la relecture de PR est un bon problème pour l'IA
À un moment donné, notre relecteur de pull requests par IA a cessé de ressembler à une expérience.
Il est devenu partie intégrante du flux de relecture.
Les ingénieurs n'étaient pas toujours d'accord avec lui, l'ignoraient parfois, et le remerciaient à l'occasion. Un ingénieur a même répondu avec un emoji bisou après qu'il ait approuvé une pull request.
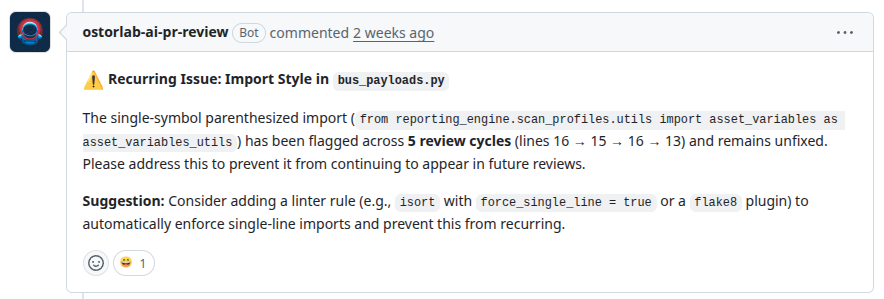
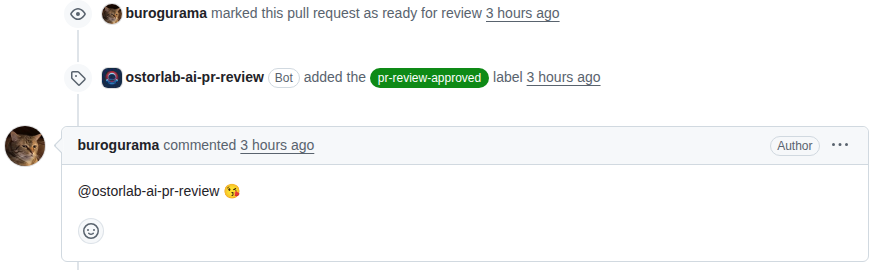
Ces interactions étaient utiles à observer, non pas parce que le relecteur avait toujours raison, mais parce qu'elles montraient ce qui se passe lorsque le retour de l'IA s'intègre à un flux d'ingénierie.
La question n'est plus seulement de savoir si le système peut trouver des problèmes.
C'est de savoir si les ingénieurs sont prêts à faire confiance à ce qu'il dit.
Notre première version a échoué.
Nous ne l'avons pas arrêtée parce qu'elle manquait des problèmes.
Nous l'avons arrêtée parce qu'elle trouvait trop de problèmes qui n'existaient pas.
Cette distinction compte. La plupart des discussions sur la relecture de code par IA se concentrent sur la couverture : combien de bugs un système peut trouver, combien de vulnérabilités il peut détecter, ou combien de commentaires il peut générer. En pratique, la métrique qui comptait le plus pour nous n'était pas la couverture. C'était la confiance.
La relecture de pull requests est un terrain naturel pour appliquer l'IA. Les ingénieurs seniors passent un temps considérable à identifier des schémas récurrents, faire respecter des conventions, repérer des hypothèses risquées, vérifier des cas limites, et se demander si un changement s'intègre bien au reste du système. Une partie de ce travail demande un jugement architectural profond. Mais une large portion est répétitive et mécanique.
Ces vérifications répétitives sont exactement là où l'IA peut aider.
Le défi est que la relecture de code ne consiste pas seulement à trouver des problèmes. Il s'agit de trouver les bons problèmes, de les expliquer clairement, et de le faire avec suffisamment de précision pour que les ingénieurs soient prêts à agir sur le retour.
Un relecteur bruyant est pire que l'absence de relecteur. Un ingénieur humain peut ignorer le silence. Il ne peut pas ignorer un commentaire plausible mais incorrect sans passer du temps à prouver qu'il a tort.
C'est la leçon que nous avons apprise à nos dépens.
Notre première tentative
Notre première version avait un objectif simple : relire les pull requests avant qu'un relecteur humain n'intervienne et détecter les problèmes courants tôt.
À l'époque, cela semblait être un cas d'usage pratique et à fort impact. Les relectures de pull requests étaient devenues un goulot d'étranglement. Les ingénieurs seniors passaient trop de temps sur des retours répétitifs, et les files d'attente de relecture ralentissaient le développement pour toute l'équipe.
L'objectif n'a jamais été de remplacer les relecteurs. C'était de réduire la partie mécanique du processus de relecture afin que les ingénieurs puissent consacrer plus de temps à l'architecture, à l'impact sur la sécurité et à la logique métier.
La première version s'exécutait automatiquement à l'ouverture ou la mise à jour d'une pull request. Elle collectait le diff, rassemblait les fichiers modifiés et un contexte environnant limité, envoyait ces informations à un modèle de langage, puis publiait des commentaires de relecture sur la pull request.
Le workflow était volontairement simple :
- Un événement de pull request déclenchait le relecteur.
- Le système extrayait le diff et les fichiers modifiés.
- Le modèle relisait le changement à l'aide d'un prompt fixe.
- Les constats générés étaient convertis en commentaires de pull request.
- Les ingénieurs examinaient ces commentaires aux côtés du retour humain.
Cette simplicité rendait le système facile à construire, mais elle est aussi devenue sa plus grande faiblesse. L'agent pouvait voir ce qui avait changé, mais il ne pouvait souvent pas voir assez du système environnant pour déterminer si un constat était réellement valide.
Sur le papier, l'hypothèse était raisonnable. Si un relecteur IA pouvait détecter les problèmes courants avant qu'une pull request n'atteigne un ingénieur senior, les relecteurs pourraient passer moins de temps à répéter le même retour et plus de temps à discuter des décisions de conception.
En pratique, le système produisait des commentaires qui semblaient utiles mais étaient souvent faux.
Le mode d'échec : un retour plausible mais incorrect
La première version n'a pas échoué de façon évidente.
Elle ne postait pas de commentaires absurdes. Elle ne se méprenait pas sur chaque pull request. Elle ne produisait pas de recommandations manifestement cassées.
Le problème était plus subtil : de nombreux commentaires étaient suffisamment plausibles pour que les ingénieurs se sentent obligés de les examiner, mais suffisamment incorrects pour que cet examen fasse souvent perdre du temps.
Certains exemples étaient mineurs mais irritants. L'agent recommandait parfois des changements de style en contradiction avec nos propres conventions, suggérant par exemple des noms de test en snake_case dans une base de code qui utilisait systématiquement le camelCase.
Certains commentaires étaient plus perturbateurs. Dans un cas, l'agent a signalé du code qui avait déjà été corrigé ailleurs dans la même pull request. Dans un autre, il a recommandé d'ajouter des tests d'intégration nécessitant un environnement navigateur, alors que notre environnement CI ne prenait pas en charge l'exécution basée sur un navigateur.
Nous avons aussi observé des commentaires en double apparaître sur la même pull request. L'agent identifiait le même problème perçu plus d'une fois et publiait plusieurs variantes du même retour. Même lorsque l'observation sous-jacente était valide, cette répétition rendait la relecture bruyante.
Les commentaires les plus frustrants étaient ceux qui semblaient raisonnables à première vue. Par exemple, l'agent pouvait suggérer une gestion d'exception plus large sans comprendre que le type d'exception plus restreint était intentionnel. Ou il pouvait recommander une refactorisation techniquement valide mais incohérente avec le code environnant.
Un mauvais commentaire de relecture par IA a un coût. Quelqu'un doit le lire, le comprendre, vérifier s'il s'applique, inspecter le code environnant, et décider s'il faut agir dessus. Si le commentaire est faux, tout ce temps est perdu.
Avec le temps, les ingénieurs ont cessé de considérer l'agent comme un relecteur utile et ont commencé à le considérer comme une autre source de bruit de relecture.
À ce stade, le projet n'aidait plus.
Nous l'avons donc désactivé.
La vraie leçon : les faux positifs sont pires que les oublis
La leçon la plus importante de la première version est que les faux positifs sont souvent plus dommageables que les constats manqués.
Un relecteur qui manque occasionnellement un problème peut rester utile. Un relecteur qui soulève à répétition des problèmes incorrects crée du travail pour tout le monde.
C'est particulièrement vrai en relecture de code, car les commentaires de relecture interrompent le flux de travail d'un ingénieur. Un commentaire n'est pas qu'un texte. C'est une demande d'attention. Il demande à l'auteur de s'arrêter, d'inspecter le code, de raisonner sur le problème et de décider si un changement est nécessaire.
Si cette demande s'avère fausse trop souvent, la confiance s'érode rapidement.
Une fois la confiance perdue, même les commentaires corrects perdent de leur valeur. Les ingénieurs commencent à tout vérifier. Ils lisent le retour de l'agent avec méfiance. Ils supposent qu'il a probablement tort jusqu'à preuve du contraire.
Cela change le rôle de l'outil. Au lieu de réduire la charge de relecture, il l'augmente.
Pour la relecture de code par IA, la précision compte plus que le volume. Dix commentaires ne valent pas mieux qu'un seul commentaire si neuf d'entre eux nécessitent un rejet manuel. Un bon agent de relecture doit être à l'aise de rester silencieux.
C'est devenu le principe directeur de la deuxième version.
Pourquoi la relecture de code a besoin de plus de contexte qu'un diff
Notre première version traitait la relecture de pull requests essentiellement comme un problème d'analyse de diff. C'était une erreur.
Les relecteurs expérimentés n'évaluent pas un changement en ne regardant que les lignes modifiées. Ils utilisent un ensemble de contexte bien plus large :
- Les schémas existants dans le code environnant
- Les conventions de nommage et de test propres au projet
- Le comportement des dépendances
- Les hypothèses d'exécution
- Les limitations du CI
- Les frontières de sécurité
- Les décisions de conception antérieures
- La logique métier et l'intention produit
- Si un problème similaire a déjà été résolu ailleurs
Un changement qui paraît suspect isolément peut être correct une fois replacé dans le système complet. L'inverse est également vrai : un changement qui paraît anodin dans un diff peut introduire un bug à cause d'un comportement dans un autre fichier, service ou chemin d'exécution.
Cet écart de contexte explique beaucoup des échecs de la première version.
Le modèle n'avait souvent pas tort par manque de capacité linguistique. Il avait tort parce qu'il manquait d'informations. Lorsque le système ne pouvait pas voir le contexte pertinent, il devinait. Et quand il devinait, il produisait parfois un retour assuré mais incorrect.
Le problème n'était pas seulement le modèle.
Le problème était l'architecture autour du modèle.
Pourquoi nous sommes revenus sur le problème
Nous avons fini par revenir sur la relecture de pull requests par IA parce que le problème initial n'avait pas disparu.
Les ingénieurs seniors continuaient de passer du temps sur des tâches de relecture répétitives. Beaucoup de ces tâches étaient importantes, mais ne nécessitaient pas toujours un jugement de niveau senior. Nous croyions toujours qu'il y avait de la valeur à détecter plus tôt les problèmes mécaniques, à condition d'éviter de créer du bruit.
Dans le même temps, la technologie avait progressé.
Les modèles plus récents étaient meilleurs pour comprendre le code, respecter des contraintes et raisonner sur les détails d'implémentation. Des fenêtres de contexte plus grandes permettaient de fournir davantage de contexte du dépôt au lieu de forcer le modèle à travailler à partir d'un diff étroit. Les patterns d'agents avaient eux aussi mûri : au lieu de s'appuyer sur un seul prompt, les systèmes pouvaient récupérer des informations, inspecter des fichiers, appeler des outils et structurer leur travail autour d'objectifs de relecture précis.
Cela a changé notre approche.
Nous n'essayions plus de construire un relecteur générique commentant tout ce qu'il remarquait. Nous essayions de construire un système de relecture prudent, concentré sur des constats à haute confiance et à fort signal.
La question est passée de :
Combien de problèmes l'agent peut-il trouver ?
à :
Sur quels problèmes l'agent devrait-il être autorisé à commenter ?
Ce changement a rendu la deuxième version bien meilleure.
Ce qui a changé dans l'architecture
Le système actuel n'est pas né d'une seule percée. Il est le fruit de plusieurs itérations autour d'une idée centrale : le relecteur a besoin de contexte avant de gagner le droit de commenter.
Nos premières expériences utilisaient CrewAI pour coordonner le comportement de relecture. Cette approche était prometteuse, mais la sortie n'était pas suffisamment fiable de façon constante pour la relecture de pull requests. Nous sommes ensuite passés à un workflow plus simple basé sur Pydantic, qui nous a apporté plus de structure et plus de contrôle sur le pipeline de relecture. Cela a amélioré la cohérence, mais le système se méprenait encore sur le code lorsque le contexte pertinent manquait.
L'itération suivante s'est orientée vers une architecture basée sur des outils.
Au lieu de demander au modèle de relire une pull request à partir d'un prompt fixe, le système peut désormais rassembler des informations supplémentaires au besoin. Il peut inspecter des fichiers liés, regarder des implémentations voisines, récupérer les conventions pertinentes, et restreindre son analyse à des tâches de relecture spécifiques.
À un niveau général, le flux ressemble à ceci :
-
Réception de l'événement de pull request
Le système démarre à l'ouverture ou la mise à jour d'une pull request. -
Analyse du diff et des fichiers modifiés
Le relecteur identifie ce qui a changé et quels fichiers sont concernés. -
Sélection des objectifs de relecture
Au lieu de réaliser une relecture ouverte, le système se concentre sur des catégories spécifiques de problèmes. -
Récupération du contexte pertinent
L'agent rassemble le code environnant, les fonctions liées, les tests, les fichiers de configuration, et les schémas du dépôt. -
Analyse ciblée
Le système vérifie des problèmes concrets tels qu'un nettoyage manquant, des exceptions non gérées, des hypothèses risquées, ou des changements d'état non persistés. -
Filtrage des constats par confiance
Les observations à faible confiance sont supprimées plutôt que publiées. -
Génération prudente des commentaires
Seuls les constats spécifiques, actionnables et liés à la pull request sont remontés.
Cette architecture a rendu le système plus utile car elle a réduit les approximations.
Le relecteur est devenu moins un chatbot réagissant à un diff, et plus un outil d'ingénierie spécialisé avec un mandat restreint.
La collecte de contexte est devenue la fonctionnalité la plus importante
La plus grande amélioration est venue du fait de donner au système un meilleur contexte.
Notre première version voyait la pull request mais manquait souvent l'implémentation environnante. La version plus récente peut récupérer des informations qui aident à répondre à des questions comme :
- Ce schéma est-il déjà utilisé ailleurs dans le dépôt ?
- Le changement suggéré est-il cohérent avec le code environnant ?
- Cette fonction a-t-elle des appelants qui dépendent du comportement actuel ?
- Y a-t-il des tests couvrant ce chemin ?
- Cette gestion d'exception est-elle intentionnelle ?
- Le code dépend-il d'une valeur de configuration ou d'une hypothèse d'exécution ?
- Le problème est-il déjà traité dans une autre partie de la même pull request ?
Cela compte car de nombreux mauvais commentaires de relecture viennent d'une visibilité incomplète.
Par exemple, si l'agent voit une écriture dans un répertoire, il peut suggérer de vérifier que le répertoire existe. Cela peut être utile. Mais si le code d'initialisation crée déjà le répertoire avant l'appel de la fonction, le commentaire devient du bruit.
La différence entre un constat utile et un faux positif tient souvent à un ou deux fichiers de contexte.
La récupération ne résout pas tous les problèmes, mais elle réduit considérablement le nombre de cas où le modèle doit déduire un comportement à partir d'une vue partielle.
Nous avons arrêté d'optimiser pour le nombre de commentaires
L'un des changements les plus importants a été de rendre le système plus prudent.
La première version récompensait implicitement le fait de trouver des choses. La seconde version récompense le fait d'être utile.
Cela demandait une philosophie de sortie différente. Le relecteur ne devrait pas commenter simplement parce que quelque chose pourrait être amélioré. Il devrait commenter lorsqu'il y a un problème concret, suffisamment de contexte à l'appui, et une action claire que l'auteur peut entreprendre.
Une suggestion stylistique n'est généralement pas suffisante. Une suggestion de refactorisation large n'est généralement pas suffisante. Un problème possible qui dépend d'une intention métier inconnue n'est généralement pas suffisant.
Le système est désormais conçu pour préférer le silence lorsque la confiance est faible.
C'était un changement difficile mais nécessaire. De nombreux systèmes d'IA paraissent plus impressionnants lorsqu'ils produisent plus de sortie. La relecture de code, c'est l'inverse. Un agent de relecture qui commente moins souvent mais a généralement raison est bien plus précieux qu'un agent qui commente sur chaque préoccupation possible.
La confiance se construit par la retenue.
Seuils de confiance et qualité des commentaires
Nous avons aussi commencé à traiter l'incertitude comme une partie à part entière du système.
Avant qu'un constat ne soit publié, le relecteur examine si le problème est spécifique, actionnable, et soutenu par le contexte disponible. Un bon commentaire doit généralement répondre à plusieurs critères :
- Il pointe vers un emplacement concret dans le changement.
- Il explique clairement le risque.
- Il évite un langage vague.
- Il ne dépend pas d'hypothèses que l'agent ne peut pas vérifier.
- Il n'entre pas en conflit avec les conventions visibles du dépôt.
- Il suggère un correctif pratique ou une prochaine étape.
- Il est suffisamment important pour interrompre l'auteur.
Ce filtrage compte car des commentaires techniquement corrects peuvent tout de même ne pas être utiles.
Par exemple, suggérer une refactorisation peut être raisonnable isolément, mais ne vaut pas la peine d'être publiée si le code est clair, cohérent avec les schémas environnants, et sans rapport avec l'objectif de la pull request. De même, recommander une gestion d'exception plus large peut sembler plus sûr, mais cela peut masquer des modes de défaillance utiles et rendre le débogage plus difficile.
Le relecteur ne devrait pas se comporter comme un linter doté d'opinions. Il devrait se comporter comme un assistant attentif qui comprend le coût de chaque commentaire qu'il publie.
Ce que la version actuelle détecte bien
La version actuelle est la plus performante sur les problèmes répétitifs et mécaniques, où le comportement attendu peut être vérifié à partir du code.
Ce sont le genre de constats qui comptent souvent mais ne nécessitent pas toujours un contexte métier profond. Ce sont aussi le type de problèmes que les ingénieurs seniors détectent à répétition lors de la relecture manuelle.
Le système s'est révélé utile pour identifier des problèmes tels que :
- Des exceptions non gérées pouvant provoquer des plantages
- Des fuites de ressources cachées derrière des retours anticipés
- Des changements d'état calculés mais jamais persistés
- Du code mort laissé après des refactorisations
- Des étapes d'initialisation manquantes, comme écrire dans des répertoires qui pourraient ne pas exister
- Un comportement de nettoyage incohérent entre les chemins de succès et d'échec
- Des hypothèses risquées autour des opérations sur les fichiers, les processus ou le réseau
- Des situations de concurrence dans des scénarios étroits et concrets
Un constat particulièrement utile a été un véritable problème de type « time-of-check to time-of-use ». Le code vérifiait qu'une condition était vraie, puis effectuait une opération plus tard en supposant que la condition n'avait pas changé. Ce type de problème est facile à manquer en relecture car les lignes concernées peuvent sembler raisonnables individuellement. L'agent a été capable de relier la séquence et de signaler le risque.
C'est là que la relecture par IA nous semble actuellement la plus précieuse : non pas en tant qu'architecte, mais en tant que relecteur infatigable pour la justesse mécanique.
Elle aide à retirer une partie du travail répétitif du chemin critique de relecture, afin que les relecteurs humains puissent se concentrer sur un jugement de plus haut niveau.
Ce qu'elle manque encore
Le système est meilleur que la première version, mais il est loin de remplacer la relecture humaine.
Il peine encore avec le raisonnement architectural large, la logique métier spécifique au domaine, et les décisions dont le contexte le plus important se trouve en dehors du dépôt. Il peut souvent comprendre comment le code fonctionne. Comprendre pourquoi le code a été écrit de cette façon est bien plus difficile.
L'intention reste le problème le plus difficile.
Le relecteur peut encore suggérer des changements techniquement valides mais peu utiles. Il peut recommander de refactoriser du code déjà acceptable. Il peut suggérer une abstraction plus générale alors que l'implémentation explicite actuelle est plus facile à maintenir. Il peut proposer une gestion d'exception plus large même lorsqu'un type d'exception plus restreint a été choisi intentionnellement.
Par exemple, le système a suggéré de remplacer une gestion d'exception spécifique telle que :
except RuntimeError
par une gestion plus large telle que :
except Exception
Dans certains contextes, cela peut être raisonnable. Dans d'autres, c'est pire. Capturer une exception large peut masquer des erreurs de programmation, rendre les défaillances plus difficiles à déboguer, et affaiblir les garanties sur lesquelles repose le code environnant.
L'agent peut évaluer des détails d'implémentation, mais il ne comprend pas toujours l'intention de conception.
Cette limite façonne la manière dont nous l'utilisons. Nous ne voulons pas que le relecteur formule de larges recommandations architecturales à moins d'avoir des preuves solides. Nous voulons qu'il se concentre sur les problèmes où le code lui-même fournit assez de contexte pour rendre le constat fiable.
Comment nous pensons l'évaluation
Nous n'évaluons plus le relecteur au nombre de commentaires qu'il produit.
Un nombre élevé de commentaires n'est pas un succès. Dans bien des cas, c'est un signal d'alerte.
Les métriques qui nous importent se rapprochent plutôt de :
- À quelle fréquence les ingénieurs sont d'accord avec le commentaire
- À quelle fréquence un commentaire mène à un véritable changement de code
- Combien de commentaires sont rejetés comme non pertinents
- À quelle fréquence le même problème est signalé plus d'une fois
- Combien de temps les relecteurs passent à valider le retour de l'agent
- Si l'agent détecte les problèmes répétitifs avant les relecteurs seniors
- Si les ingénieurs continuent de faire confiance à l'outil dans la durée
Le signal le plus important est de savoir si les ingénieurs considèrent le retour de l'agent comme digne d'être lu.
Si les ingénieurs ignorent les commentaires, le système a échoué, même si certains constats sont techniquement corrects. Si les ingénieurs agissent systématiquement sur un petit nombre de commentaires précis, le système fait son travail.
C'est pourquoi nous sommes volontairement prudents. Nous préférons manquer un problème limite plutôt que d'habituer les ingénieurs à ignorer le relecteur.
D'une expérience interne à une fonctionnalité de plateforme
Ce qui a commencé comme une expérience interne oriente désormais une direction produit plus large.
Nous travaillons à intégrer des capacités de relecture de code pilotées par l'IA dans la plateforme Ostorlab. Avant d'exposer la fonctionnalité en externe, nous avons voulu l'utiliser sur nos propres pull requests, observer où elle aidait, et comprendre où elle avait besoin de garde-fous.
Cet usage interne a clarifié ce que la fonctionnalité devait être.
Elle ne devrait pas remplacer le jugement d'ingénierie. Elle ne devrait pas transformer chaque pull request en un mur de commentaires générés par l'IA. Elle ne devrait pas se comporter comme un relecteur junior trop sûr de lui, cherchant à prouver qu'il a trouvé quelque chose.
Elle devrait plutôt aider les équipes à détecter plus tôt dans le processus de développement les problèmes répétitifs, mécaniques et pertinents pour la sécurité.
Cela est particulièrement important pour la sécurité applicative. De nombreux problèmes de sécurité coûtent moins cher à corriger pendant la relecture de code qu'après le déploiement ou lors d'un scan ultérieur. Un relecteur IA utile peut compléter les workflows AppSec existants en identifiant des schémas à risque plus près du moment où le code est écrit.
Cela n'en fait pas un remplacement du SAST, du DAST, de la relecture de sécurité manuelle, ou des ingénieurs expérimentés. Cela en fait une couche supplémentaire dans le workflow : une couche axée sur un retour précoce, contextuel, destiné au développeur.
Nous avons déjà constaté l'intérêt d'utilisateurs demandant quand cette capacité sera disponible. Cette demande renforce notre conviction que la relecture de code devient une part importante du workflow de sécurité applicative.
Mais l'utilité compte plus que la rapidité de mise en production. Notre priorité est de rendre la fonctionnalité prudente, digne de confiance et pratique avant qu'elle n'atteigne les utilisateurs en production.
Leçons apprises
Les relecteurs IA ne sont pas des ingénieurs juniors
Une erreur courante est de traiter les relecteurs IA comme s'ils étaient des développeurs juniors.
Ils ne le sont pas.
Les ingénieurs juniors accumulent du contexte au fil du temps. Ils posent des questions. Ils se souviennent des décisions passées. Ils apprennent l'histoire d'un système et les préférences d'une équipe. Ils développent leur jugement par l'expérience.
Les systèmes d'IA fonctionnent différemment. Ils excellent dans la reconnaissance de schémas, la cohérence, la synthèse et l'analyse répétitive. Ils peuvent inspecter de grandes quantités de code rapidement. Ils peuvent identifier des problèmes mécaniques que les humains peuvent négliger.
Mais ils ne comprennent pas naturellement l'histoire organisationnelle, l'intention produit, ou les compromis architecturaux, à moins que ces éléments ne leur soient fournis.
Le meilleur rôle pour un relecteur IA n'est pas le remplacement. C'est l'assistance.
La confiance compte plus que la couverture
La métrique la plus importante n'est pas le nombre de constats que produit le relecteur.
C'est le nombre de constats auxquels les ingénieurs font confiance.
Un système qui produit dix commentaires précis et actionnables a plus de valeur qu'un système qui produit cent commentaires nécessitant une vérification manuelle. La couverture compte, mais seulement une fois que le système a gagné la confiance.
Pour les agents de relecture de code, la retenue est une fonctionnalité. Le silence est parfois la bonne sortie.
Le contexte fait la différence entre utile et bruyant
De nombreux échecs de relecture par IA sont des échecs de contexte.
Un modèle relisant un diff étroit peut identifier quelque chose qui paraît suspect mais est déjà traité ailleurs. Il peut recommander une convention qui entre en conflit avec le dépôt. Il peut se méprendre sur un environnement de test, une hypothèse d'exécution, ou une frontière architecturale.
De meilleurs modèles aident, mais un meilleur contexte compte tout autant.
Le relecteur a besoin d'accéder aux informations qu'un relecteur humain utiliserait naturellement : le code environnant, les fichiers liés, les tests, les conventions, la configuration et les schémas antérieurs.
Sans ce contexte, le système devine. Et des suppositions assurées sont dangereuses en relecture de code.
Parfois, la bonne décision est de s'arrêter
Notre première tentative a échoué.
À l'époque, c'était décevant. Avec le recul, c'est l'un des résultats les plus utiles du projet.
L'arrêter nous a forcés à comprendre le vrai problème. Le problème n'était pas simplement que le modèle devait être meilleur. Le problème était que notre système était optimisé pour produire des commentaires de relecture, plutôt que pour produire des commentaires de relecture dignes de confiance.
Lorsque nous sommes revenus sur le projet, nous ne repartions pas de zéro. Nous construisions sur les leçons de la version ayant échoué.
Tous les projets d'ingénierie ne réussissent pas du premier coup. Parfois, la bonne décision est de s'arrêter, d'apprendre, et de revenir lorsque la technologie et votre compréhension du problème se sont toutes deux améliorées.
C'est ce qui s'est passé ici.
Nous ne pensons toujours pas que l'IA devrait remplacer la relecture humaine des pull requests. Mais nous pensons qu'elle peut rendre la relecture meilleure lorsqu'elle est ciblée, contextuelle et prudente.
L'objectif n'est pas un relecteur IA qui commente davantage.
L'objectif est un relecteur IA auquel les ingénieurs font vraiment confiance.