Apprentissage par renforcement et tests automatisés - partie 1
À travers une série d'articles, je partagerai nos expérimentations passées sur l'utilisation de l'apprentissage par renforcement pour les tests automatisés, afin de traquer les bugs et de trouver des vulnérabilités.
À travers une série d'articles, je partagerai nos expérimentations passées sur l'utilisation de l'apprentissage par renforcement pour les tests automatisés, afin de traquer les bugs et de trouver des vulnérabilités.
Notre objectif initial était de construire une approche intelligente générique pour identifier les vulnérabilités dans les applications mobiles, en ciblant d'abord les applications Android basées sur Java et les applications iOS basées sur le bitcode LLVM. Nos expérimentations nous ont amenés à découvrir l'apprentissage par renforcement et à l'utiliser pour ce qui semblait donner des résultats très intéressants.
Pour ceux qui ne connaissent pas l'apprentissage par renforcement, c'est une branche de l'apprentissage automatique qui repose sur une boucle d'entrée afin d'améliorer continuellement les résultats.
L'apprentissage par renforcement a par exemple été utilisé par le projet AlphaGo, qui employait une forme spécialisée d'apprentissage par renforcement appelée apprentissage par renforcement profond et qui, comme son nom l'indique, utilise l'apprentissage profond.
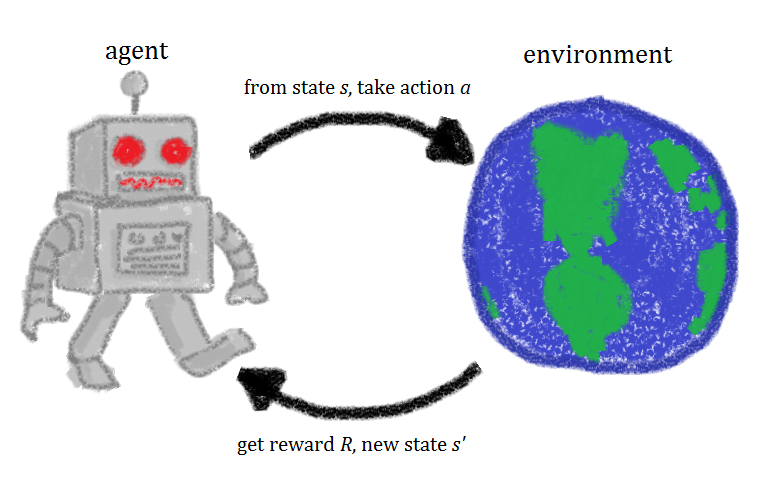
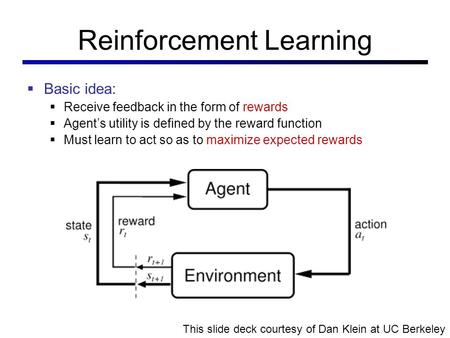
L'apprentissage par renforcement est en réalité assez simple et intuitif. Un agent effectue une action qu'il envoie à un environnement, puis il recueille des informations sur le nouvel état et sur le résultat de l'action (appelé récompense ou punition), et enfin il calcule une nouvelle action à partir de ce résultat. L'entrée est calculée à l'aide d'un algorithme appelé politique (Policy).
Bien que l'utilisation de l'apprentissage par renforcement pour les tests de sécurité n'ait, à ma connaissance, jamais été mentionnée auparavant, à l'exception de 2 articles académiques très récents qui prétendent être les premiers à le faire, l'apprentissage par renforcement existe en réalité depuis longtemps dans certains outils de test de sécurité et a déjà prouvé qu'il produisait des résultats remarquables. AFL de Michal Zalewsky en est le meilleur exemple : il a trouvé un nombre stupéfiant de vulnérabilités.
AFL est communément qualifié de fuzzer évolutionnaire. Il génère un cas de test qui est transmis à un programme instrumenté, puis il collecte la trace d'exécution et génère de nouvelles entrées visant à augmenter la couverture de code du programme testé.
Le fuzzing évolutionnaire doit en général résoudre 3 problèmes :
1- Une instrumentation rapide
2- Un algorithme intelligent de couverture de code
3- Une identification efficace des vulnérabilités
Bien que le premier (instrumentation rapide) et le dernier (identification efficace des vulnérabilités) problèmes n'aient rien à voir avec l'apprentissage par renforcement, je les trouve si intéressants que je pense qu'ils méritent quelques explications.
L'instrumentation consiste simplement à tracer l'exécution d'un programme ; le principe est simple, mais la mise en œuvre est notoirement complexe. L'instrumentation peut avoir plusieurs niveaux de granularité : par appel de fonction, par bloc ou même par instruction. Plus la granularité est élevée, plus elle est lente. Il existe différentes façons d'instrumenter un programme : - À la compilation, qui délègue simplement au compilateur la tâche d'ajouter des instructions d'instrumentation. C'était au départ l'approche la plus rapide, car le compilateur comprend mieux le programme, mais surtout il peut exécuter ses optimisations sur le code instrumenté. - À l'exécution, par logiciel : cette approche est adaptée lorsque nous n'avons pas accès au code source du programme. C'est de loin l'approche la plus lente, car elle exige des sauts constants entre le code instrumenté et le code d'instrumentation. Elle est aussi très sujette aux erreurs et difficile à réaliser correctement. - À l'exécution, par matériel : c'est mon approche préférée, car elle réunit le meilleur des deux mondes, avec un faible surcoût et sans besoin de code source. Intel et ARM ont ajouté à leurs processeurs la prise en charge du traçage de programme avec un très faible surcoût, et AFL comme HonggFuzz, par exemple, savent utiliser l'instrumentation matérielle.
L'identification efficace des vulnérabilités est un autre sujet complexe. Au départ, la plupart des fuzzers s'appuyaient sur le plantage du programme comme signe d'une vulnérabilité potentielle. Or un plantage peut ne pas se produire si, par exemple, le débordement est trop petit pour écraser quoi que ce soit d'intéressant.
Une approche plus avancée est celle des sanitizers. Les sanitizers LLVM modifient un programme à la compilation pour rendre plus visible l'élément déclencheur d'une vulnérabilité, par exemple en utilisant des gardes mémoire qui entourent chaque allocation mémoire.
Toutes ces approches sont exclusivement adaptées aux langages de bas niveau qui recherchent des vulnérabilités de bas niveau, comme les débordements ou les use-after-free.
Le 2e composant des fuzzers évolutionnaires est l'algorithme qui augmente la couverture de code, et c'est là que se joue la partie renforcement.
AFL utilise des algorithmes génétiques pour générer des entrées et s'appuie sur l'instrumentation par blocs pour déterminer si une entrée a été capable de déclencher un nouveau chemin dans le programme.
Les algorithmes génétiques visent à imiter la sélection naturelle, qui consiste à produire des entrées, à appliquer un ensemble de modifications (croisement et mutation) et à sélectionner dans la population générée un sous-ensemble qui satisfait une fonction d'aptitude .
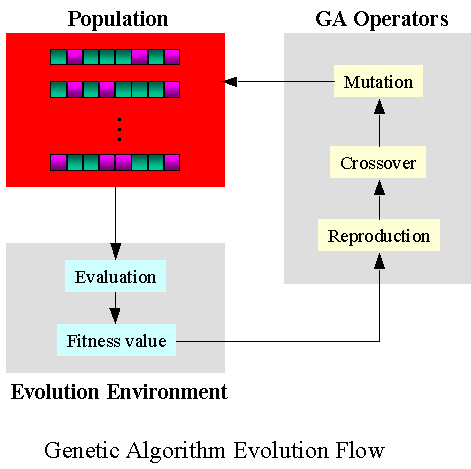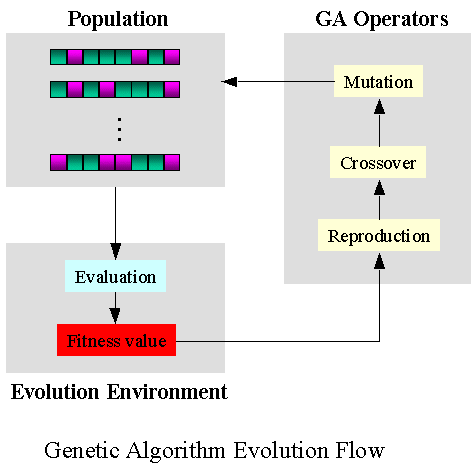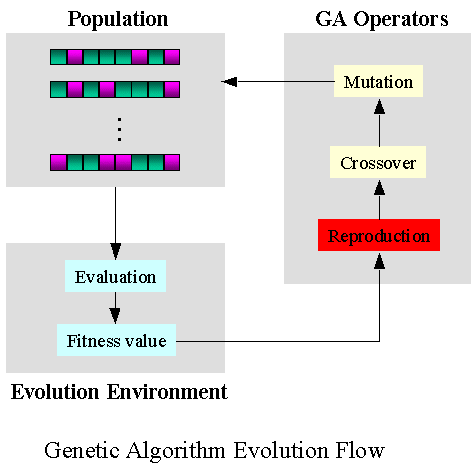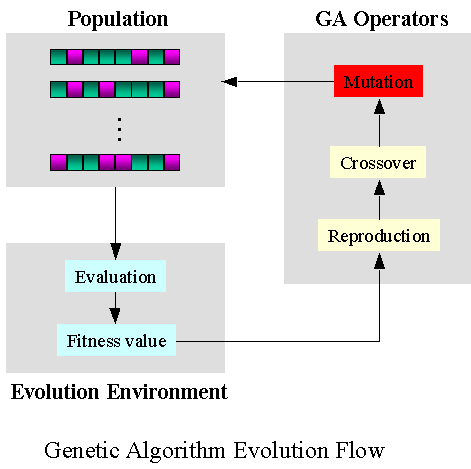
Dans le cas de l'algorithme génétique d'AFL :
- l'opération de croisement consiste par exemple à échanger des blocs entre entrées ;
- l'opération de mutation consiste par exemple à inverser des bits ;
- la fonction d'aptitude mesure la découverte d'un nouveau chemin d'exécution.
AFL ajoute aussi un élément de curiosité ou un bonus d'exploration en privilégiant les entrées qui déclenchent un nouveau chemin d'exécution. Les algorithmes génétiques et les bonus d'exploration sont couramment utilisés dans les solutions modernes d'apprentissage par renforcement.
D'autres approches, antérieures à l'algorithme génétique d'AFL, consistent à utiliser des solveurs SMT et SAT. Cette approche exige une instrumentation très granulaire et tente de résoudre des équations complexes pour découvrir une nouvelle branche d'exécution.
Les solveurs SMT ont connu d'énormes progrès ces dernières années, mais en dehors de SAGE, qui n'est pas public, aucun fuzzer n'a rapporté de bons résultats avec cette approche.
D'autres fuzzers essaient une combinaison de plusieurs techniques pour tirer parti des forces des deux approches. Driller, par exemple, qui a remporté la 2e place au DARPA Cyber Grand Challenge, utilisait à la fois AFL, un Qemu modifié et le solveur SMT Z3.
Dans les prochains articles, j'aborderai certaines limites de ces approches et je présenterai l'utilisation de l'apprentissage par renforcement pour identifier des vulnérabilités de haut niveau comme les SQLi, les injections de commandes et les XXE.
Tags :
fuzzing