Aprendizaje por refuerzo y pruebas automatizadas, parte 1
A lo largo de una serie de artículos compartiré nuestros experimentos pasados con el uso del aprendizaje por refuerzo en las pruebas automatizadas, tanto para cazar errores como para encontrar vulnerabilidades.
A lo largo de una serie de artículos compartiré nuestros experimentos pasados con el uso del aprendizaje por refuerzo en las pruebas automatizadas, tanto para cazar errores como para encontrar vulnerabilidades.
Nuestro objetivo inicial era construir un enfoque inteligente y genérico para identificar vulnerabilidades en aplicaciones móviles, dirigido en un primer momento a las aplicaciones Android basadas en Java y a las aplicaciones iOS basadas en bitcode de LLVM. Nuestra experimentación nos llevó a aprender sobre el aprendizaje por refuerzo y a utilizarlo para algo que parecía dar resultados muy interesantes.
Para quienes no estén familiarizados con el aprendizaje por refuerzo, es una rama del aprendizaje automático que se basa en un bucle de entrada para mejorar continuamente los resultados.
El aprendizaje por refuerzo se utilizó, por ejemplo, en el proyecto AlphaGo, que empleó una forma especializada de aprendizaje por refuerzo llamada aprendizaje por refuerzo profundo y que, como su nombre indica, utiliza aprendizaje profundo.
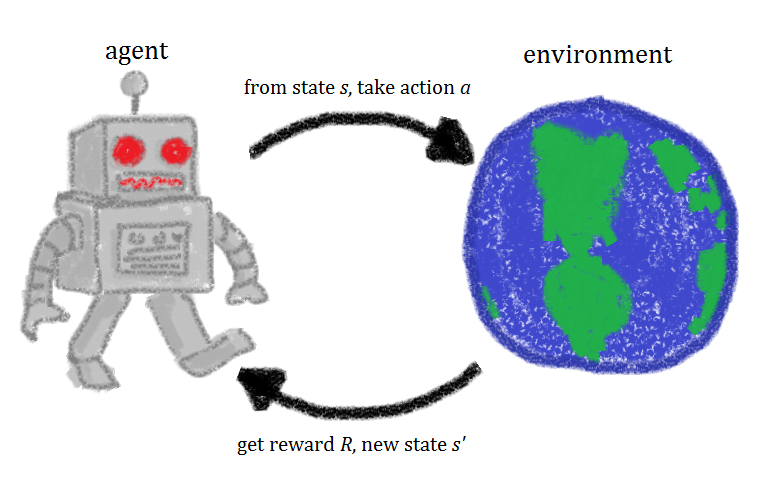
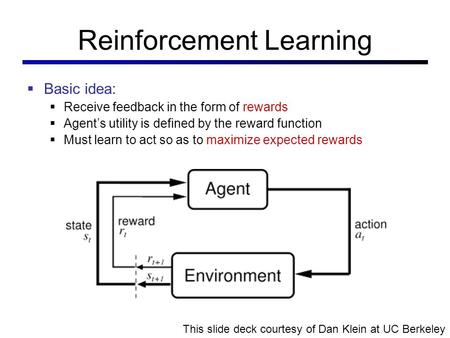
El aprendizaje por refuerzo es en realidad bastante simple e intuitivo. Un agente realiza una acción que envía a un entorno; después recoge información sobre el nuevo estado y el resultado de la acción (denominado recompensa o castigo) y, por último, calcula una nueva acción a partir de ese resultado. La entrada se calcula mediante un algoritmo al que se denomina política (Policy).
Aunque, hasta donde sé, el uso del aprendizaje por refuerzo para las pruebas de seguridad nunca se había mencionado antes, salvo por 2 artículos académicos muy recientes que afirman ser los primeros en hacerlo, en realidad el aprendizaje por refuerzo existe desde hace bastante tiempo en algunas herramientas de pruebas de seguridad y ya ha demostrado producir resultados asombrosos. AFL, de Michal Zalewsky, es el mejor ejemplo, ya que ha encontrado un número asombroso de vulnerabilidades.
AFL suele describirse como un fuzzer evolutivo. Genera un caso de prueba que se pasa a un programa instrumentado, recoge después la traza de ejecución y genera nuevas entradas cuyo objetivo es aumentar la cobertura de código dentro del programa probado.
El fuzzing evolutivo en general necesita resolver 3 problemas:
1- Instrumentación rápida
2- Algoritmo inteligente de cobertura de código
3- Identificación eficiente de vulnerabilidades
Aunque el primer problema (la instrumentación rápida) y el último (la identificación eficiente de vulnerabilidades) no tienen nada que ver con el aprendizaje por refuerzo, me parecen tan interesantes que creo que merecen una explicación.
La instrumentación consiste simplemente en trazar la ejecución de un programa; el principio es sencillo, pero la ejecución es notoriamente compleja. La instrumentación puede tener varios niveles de granularidad: por llamada a función, por bloque o incluso por instrucción. Cuanto mayor es la granularidad, más lenta resulta. Hay diferentes formas de instrumentar un programa: - En tiempo de compilación, que simplemente delega en el compilador la tarea de añadir instrucciones de instrumentación. Al principio era el enfoque más rápido, ya que el compilador comprende mejor el programa, pero sobre todo porque el compilador puede ejecutar sus optimizaciones sobre el código instrumentado. - En tiempo de ejecución basada en software, un enfoque adecuado cuando no tenemos acceso al código fuente del programa. Es con diferencia el enfoque más lento, ya que requiere saltar constantemente entre el código instrumentado y el código de instrumentación. También es muy propenso a errores y difícil de acertar. - En tiempo de ejecución basada en hardware, que es mi enfoque favorito porque combina lo mejor de ambos mundos: baja sobrecarga y no necesita código fuente. Intel y ARM añadieron a sus procesadores soporte para el trazado de programas con una sobrecarga muy baja, y tanto AFL como HonggFuzz, por ejemplo, admiten el uso de instrumentación basada en hardware.
La identificación eficiente de vulnerabilidades es otro tema complejo. Al principio, la mayoría de los fuzzers confiaban en que el programa fallara como señal de una posible vulnerabilidad. Sin embargo, puede que no se produzcan fallos si, por ejemplo, el desbordamiento es demasiado pequeño para sobrescribir algo interesante.
Un enfoque más avanzado es el que utilizan los sanitizers. Los sanitizers de LLVM realizan modificaciones en tiempo de compilación en un programa para hacer más evidente el hecho que desencadena una vulnerabilidad, como el uso de guardas de memoria que envuelven cada asignación de memoria.
Todos estos enfoques son adecuados únicamente para lenguajes de bajo nivel que buscan vulnerabilidades de bajo nivel, como los desbordamientos o el use-after-free.
El segundo componente de los fuzzers evolutivos es el algoritmo para aumentar la cobertura de código, y es aquí donde interviene el refuerzo.
AFL utiliza algoritmos genéticos para generar entradas y se apoya en la instrumentación basada en bloques para identificar si una entrada fue capaz de activar una nueva ruta en el programa.
Los algoritmos genéticos buscan imitar la selección natural, que consiste en producir entradas, aplicar un conjunto de modificaciones (cruce y mutación) y seleccionar, dentro de esa población generada, un subconjunto que supere una función de aptitud .
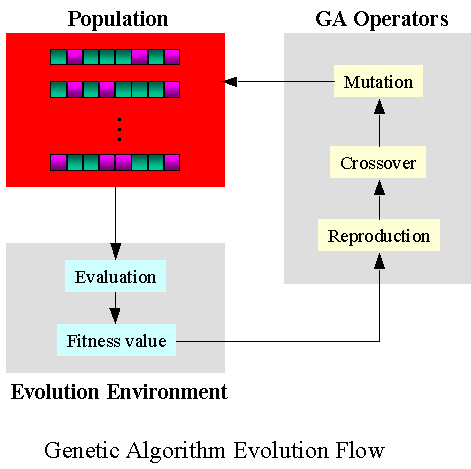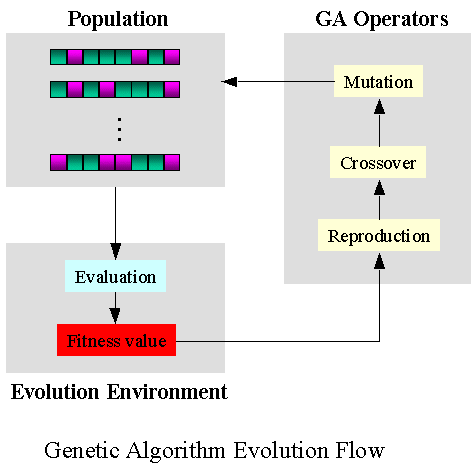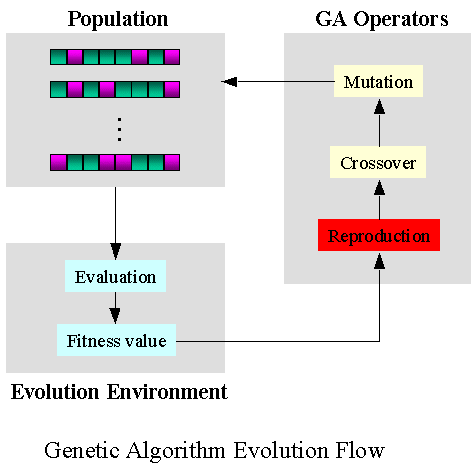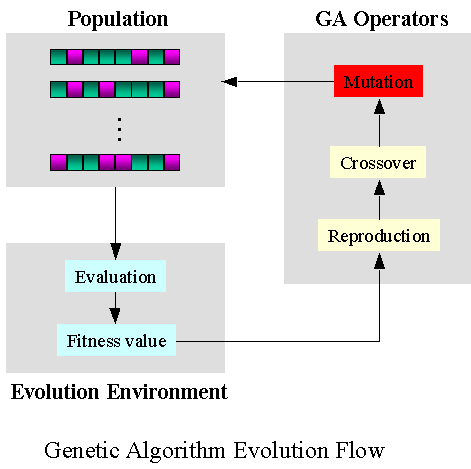
En el caso del algoritmo genético de AFL:
- la operación de cruce consiste, por ejemplo, en intercambiar bloques entre entradas;
- la operación de mutación consiste, por ejemplo, en invertir bits;
- la función de aptitud mide el descubrimiento de una nueva ruta de ejecución.
AFL añade además un elemento de curiosidad o una bonificación por exploración al privilegiar las entradas que activan una nueva ruta de ejecución. Los algoritmos genéticos y las bonificaciones por exploración se utilizan habitualmente en las soluciones modernas de aprendizaje por refuerzo.
Otros enfoques, anteriores al algoritmo genético de AFL, consisten en utilizar solucionadores SMT y SAT. Este enfoque requiere una instrumentación muy granular e intenta resolver ecuaciones complejas para descubrir una nueva rama de ejecución.
Los solucionadores SMT han avanzado enormemente en los últimos años, pero, salvo el SAGE, que no es público, ningún fuzzer ha informado de buenos resultados con este enfoque.
Otros fuzzers prueban una combinación de varias técnicas para aprovechar las fortalezas de ambos enfoques. Driller, por ejemplo, que obtuvo el segundo puesto en el DARPA Cyber Grand Challenge, utilizó AFL, un Qemu modificado y el solucionador SMT Z3.
En los próximos artículos profundizaré en algunas limitaciones de estos enfoques y presentaré el uso del aprendizaje por refuerzo para identificar vulnerabilidades de alto nivel como SQLi, Command Injection y XXE.
Etiquetas:
fuzzing