強化学習と自動テスト:パート1
一連のブログ記事を通じて、バグの追跡と脆弱性の発見の両方を目的に、強化学習を自動テストに活用した当社の過去の実験をご紹介します。
一連のブログ記事を通じて、バグの追跡と脆弱性の発見の両方を目的に、強化学習を自動テストに活用した当社の過去の実験をご紹介します。
当初の目標は、モバイルアプリケーションの脆弱性を特定するための汎用的でインテリジェントなアプローチを構築することでした。最初の対象は、AndroidのJavaベースのアプリケーションと、iOSのLLVM bitcodeベースのアプリケーションです。実験を進めるなかで強化学習について学ぶことになり、非常に興味深い結果が得られそうな用途に強化学習を活用しました。
強化学習に馴染みのない方のために説明すると、強化学習とは、入力のループに依拠して結果を継続的に改善する機械学習の一分野です。
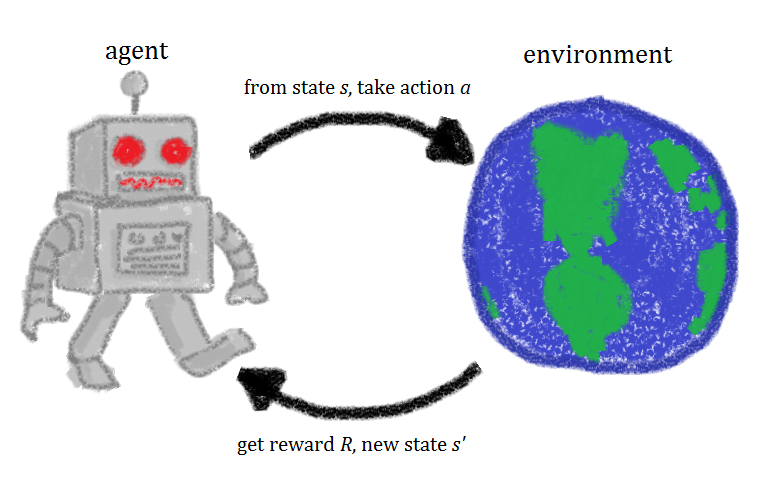
強化学習は、たとえばAlphaGoプロジェクトで使われました。このプロジェクトでは、深層強化学習と呼ばれる特殊な形態の強化学習が用いられており、その名が示すとおり深層学習を使用しています。
強化学習は、実際にはかなりシンプルで直感的です。エージェントはアクションを実行して環境に送り、新しい状態とアクションの結果(報酬または罰と呼ばれます)に関する情報を収集し、最後にその出力に基づいて新しいアクションを算出します。入力は、ポリシーと呼ばれるアルゴリズムを用いて算出されます。
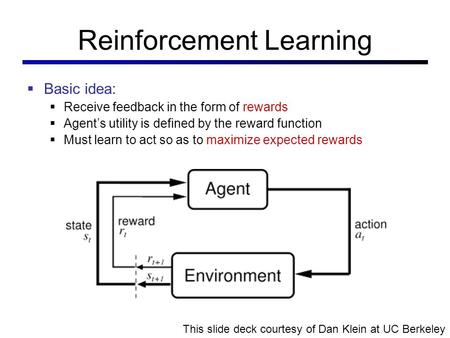
私の知る限り、セキュリティテストへの強化学習の活用は、自らが初の試みであると主張するごく最近の2本の学術論文を除けば、これまで言及されたことがありません。しかし実際には、強化学習はかなり以前から一部のセキュリティテストツールに組み込まれており、すでに驚くべき成果を上げています。Michal ZalewskyによるAFLはその最良の例であり、驚異的な数の脆弱性を発見してきました。
AFLは一般に進化型ファザーと呼ばれます。AFLは計装されたプログラムに渡すテストケースを生成し、実行トレースを収集したうえで、テスト対象プログラム内のコードカバレッジを高めることを目的とした新しい入力を生成します。
進化型ファジングは一般に、3つの問題を解決する必要があります。
1- 高速な計装
2- 賢いコードカバレッジのアルゴリズム
3- 効率的な脆弱性の特定
最初の問題(高速な計装)と最後の問題(効率的な脆弱性の特定)は強化学習とは関係ありませんが、非常に興味深いので、少し説明する価値があると考えています。
計装とは、簡単に言えばプログラムの実行をトレースすることです。原理はシンプルですが、その実装は複雑なことで知られています。計装には、関数呼び出し単位、ブロック単位、さらには命令単位など、いくつかの粒度があります。粒度が細かくなるほど、処理は遅くなります。 プログラムを計装する方法はいくつかあります。 - コンパイル時:計装用の命令を追加する作業をコンパイラーに任せるだけの方法です。コンパイラーはプログラムをより深く理解しているため、当初は最も高速なアプローチでした。しかし最も重要なのは、コンパイラーが計装されたコードに対して最適化を実行できる点です。 - ソフトウェアベースの実行時:このアプローチは、プログラムのソースコードにアクセスできない場合に適しています。計装対象のコードと計装用のコードの間を絶えず行き来する必要があるため、圧倒的に低速なアプローチです。また、非常にエラーが起きやすく、正しく実装するのが困難です。 - ハードウェアベースの実行時:オーバーヘッドが低く、ソースコードも不要という両方の利点を兼ね備えているため、私が最も気に入っているアプローチです。IntelとARMは、非常に低いオーバーヘッドでプログラムをトレースする機能をプロセッサーに追加しており、たとえばAFLとHonggFuzzはどちらもハードウェアベースの計装の利用に対応しています。
効率的な脆弱性の特定も、また別の複雑なテーマです。当初、ほとんどのファザーは、プログラムのクラッシュを潜在的な脆弱性の兆候として利用していました。しかし、たとえばオーバーフローが小さすぎて重要なものを何も上書きしない場合などには、クラッシュが発生しないことがあります。
より高度なアプローチは、サニタイザーが用いるものです。LLVMのサニタイザーは、プログラムにコンパイル時の変更を加え、すべてのメモリ割り当てを囲むメモリガードを使うなどして、脆弱性が引き起こされたという事実をより明らかにします。
これらのアプローチはいずれも、オーバーフローやuse-after-freeのような低レベルの脆弱性を探す、低レベル言語にのみ適しています。
進化型ファザーの2つ目の構成要素はコードカバレッジを高めるためのアルゴリズムであり、ここで強化の部分が登場します。
AFLは遺伝的アルゴリズムを使って入力を生成し、ブロックベースの計装に依拠して、ある入力がプログラム内の新しい経路を引き起こせたかどうかを判定します。
遺伝的アルゴリズムは自然選択を模倣することを目指すもので、入力を生成し、一連の変更(交叉と突然変異)を実行し、生成された集団から適応度関数を通過するサブセットを選択します。
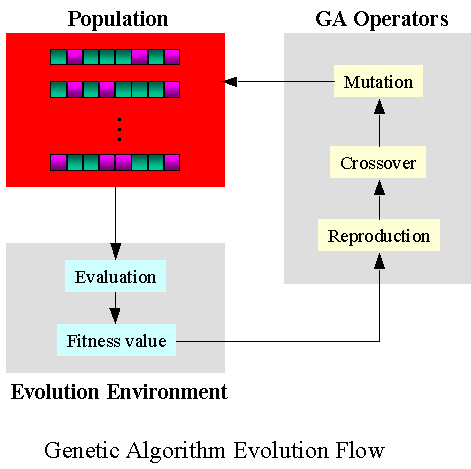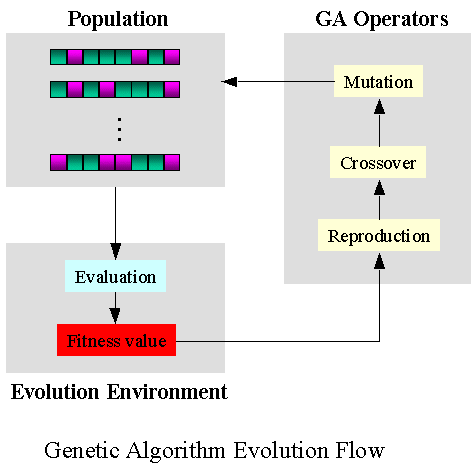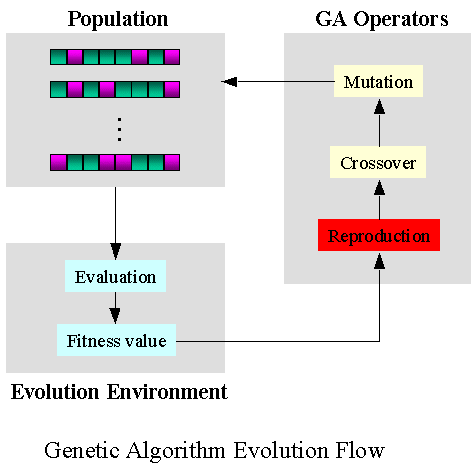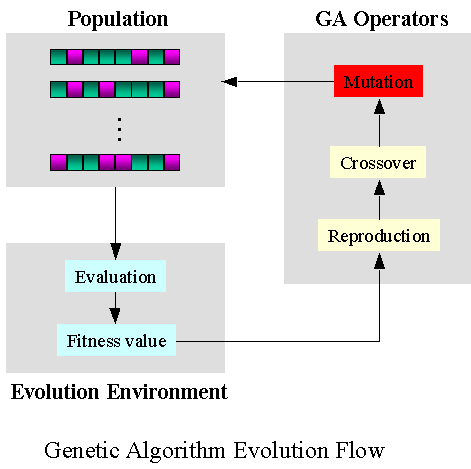
AFLの遺伝的アルゴリズムの場合:
- 交叉操作は、たとえば入力間でのブロックの入れ替えです。
- 突然変異操作は、たとえばビットの反転です。
- 適応度関数は、新しい実行経路の発見を測定します。
AFLはまた、新しい実行経路を引き起こす入力を優遇することで、好奇心の要素、つまり探索ボーナスを加えています。遺伝的アルゴリズムと探索ボーナスは、最新の強化学習ソリューションで広く用いられています。
AFLの遺伝的アルゴリズムよりも前から存在する他のアプローチとして、SMTソルバーやSATソルバーを用いるものがあります。このアプローチは非常に細かい粒度の計装を必要とし、新しい実行分岐を発見するために複雑な方程式を解こうとします。
SMTソルバーは近年大きな進歩を遂げていますが、非公開のSAGEを除いて、このアプローチで良好な結果を報告したファザーはありません。
他のファザーは、両方のアプローチの長所を生かすために複数の手法の組み合わせを試みています。たとえば、DARPA Cyber Grand challengeで2位を獲得したDrillerは、AFL、改変したQemu、Z3 SMTソルバーのすべてを使用していました。
次回以降のブログ記事では、これらのアプローチのいくつかの限界を掘り下げ、SQLi、コマンドインジェクション、XXEのような高レベルの脆弱性を特定するための強化学習の活用について紹介します。
タグ:
fuzzing