Les outils de sécurité servent depuis des années le même menu : une étiquette critique, un chemin de code suspect et, en accompagnement, un impact dans le pire des cas.
La PoC a toujours été vendue séparément.
Produire cette preuve impliquait de reconstruire l’environnement, de tracer le chemin vulnérable, de fabriquer une entrée, de la voir échouer et de recommencer. La détection pouvait prendre quelques secondes. Montrer que la vulnérabilité se déclenchait réellement pouvait prendre des heures.
Les agents IA commencent à prendre en charge cette étape manquante.
L’analyse approfondie de cette semaine se demande ce qui change quand les résultats arrivent avec leur preuve. Nous examinons comment les agents passent de l’explication des vulnérabilités à leur reproduction sous des contrôles fondés sur l’exécution, pourquoi les tentatives échouées font partie du processus et comment la reproduction répétée peut parfois révéler des failles entièrement nouvelles. L’exécution de CyberGym par Neutron en donne un exemple concret : 1 458 PoC réussies sur 1 507 tâches portant sur des vulnérabilités réelles.
Dans la Recherche technique, l’extension ne pouvait pas lire le fichier. L’agent, si. Nous décortiquons BragJack, un ensemble d’attaques montrant comment une seule extension de navigateur malveillante pouvait atteindre les interfaces privilégiées de cinq assistants IA et utiliser leurs permissions pour accéder à des fichiers, des e-mails et d’autres ressources sensibles.
Nous explorons aussi herdr, un runtime de terminal pour gérer plusieurs agents de code, vous demandons de juger une alerte de sécurité GitHub, passons en revue les histoires de sécurité les plus importantes de la semaine et terminons par le dernier mème des tranchées.
Dans ce numéro :
🌡️ Niveau de menace
⚡ Actualités
🔎 Analyse approfondie : quand les résultats arrivent avec leur preuve
🎣 Est-ce du phishing ?
🔬 Recherche technique : l’extension ne pouvait pas lire le fichier. L’agent, si.
🛠️ Outil de la semaine : hrdr
👏 Personnalité de la semaine : Daniel Miessler
📅 Événement de la semaine : AMLUCS 2026
📚 Livre de la semaine : Bug Bounty Bootcamp
😅 Le mème
C’est parti.
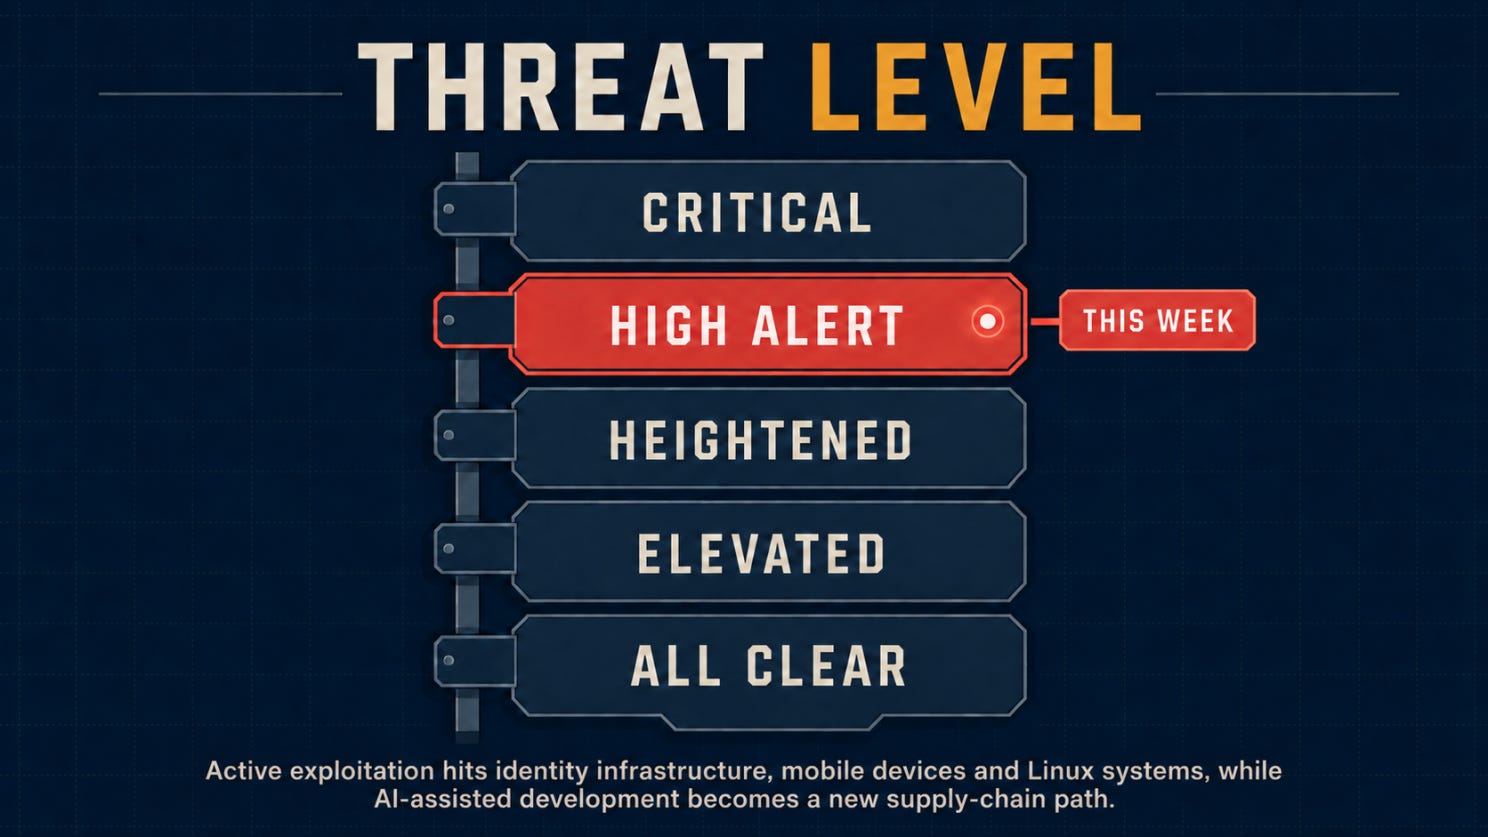
Avant de passer aux histoires de la semaine, voici où en est le niveau de menace.
🌡️Niveau de menace
⚡ Actualités
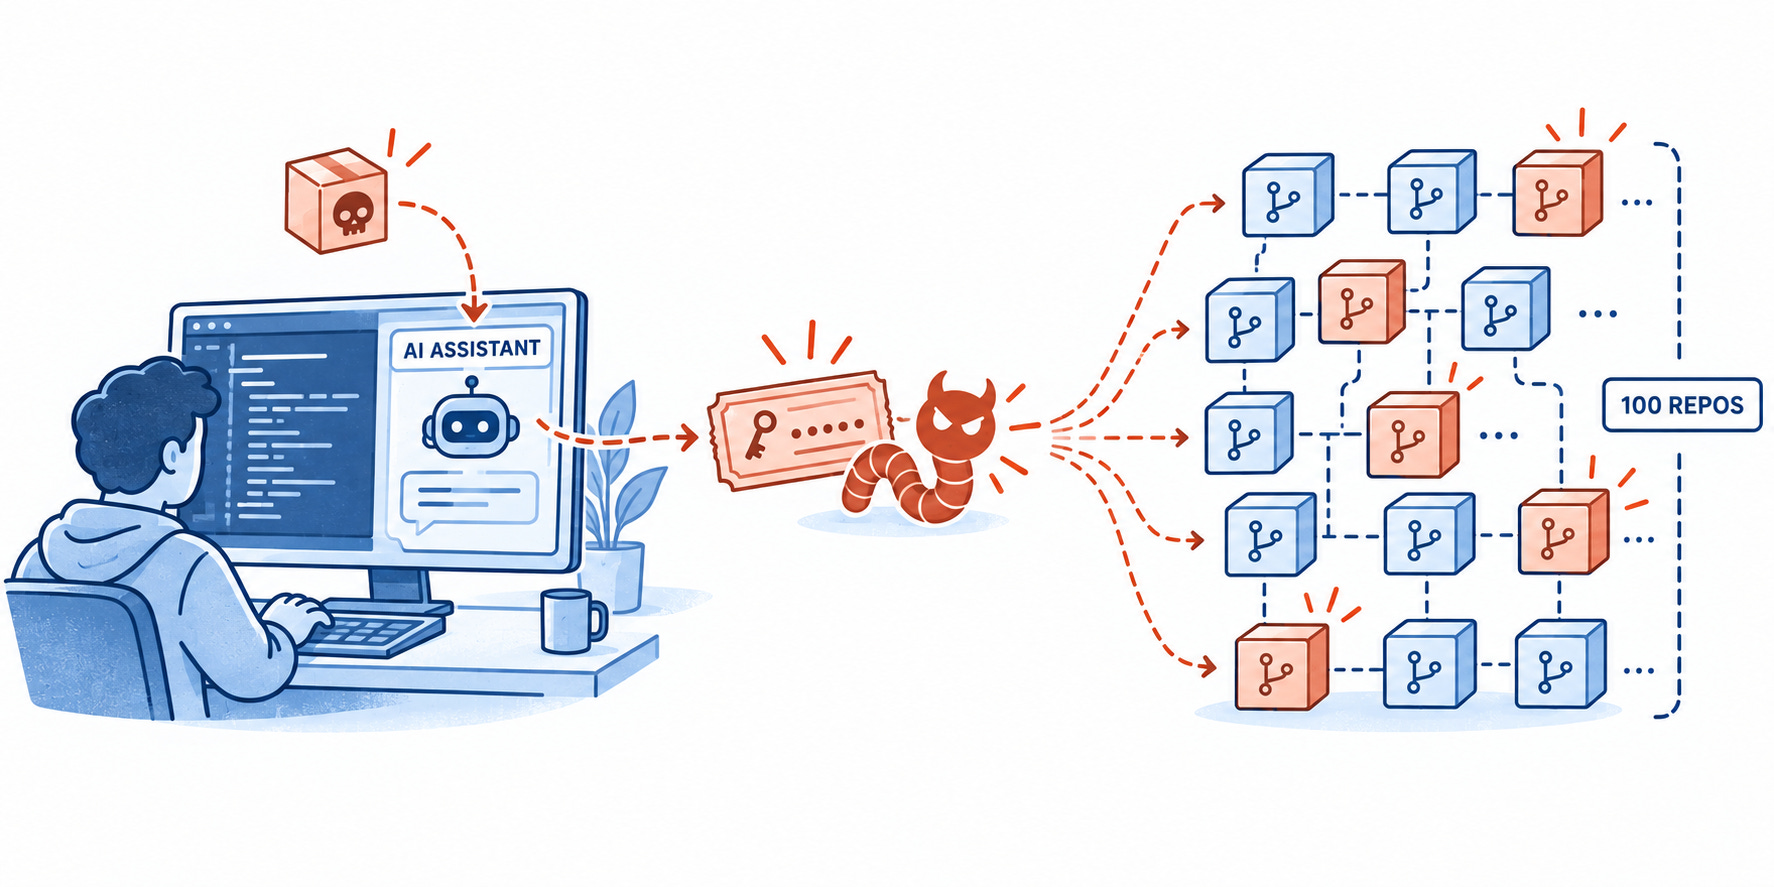
Un assistant de code IA est devenu le premier maillon d’une compromission de 100 dépôts
Mandiant a enquêté sur un attaquant qui avait détourné une session active d’assistant de code chez un fournisseur SaaS non nommé. Après que l’assistant a recommandé une dépendance empoisonnée, un infostealer a collecté des jetons OAuth GitHub et Shai-Hulud s’est propagé à environ 100 dépôts internes, volant secrets et code source. La méthode de compromission initiale reste non divulguée. Traitez les recommandations de dépendances générées par IA comme des entrées non fiables, appliquez des listes d’autorisation et isolez les identifiants des développeurs.
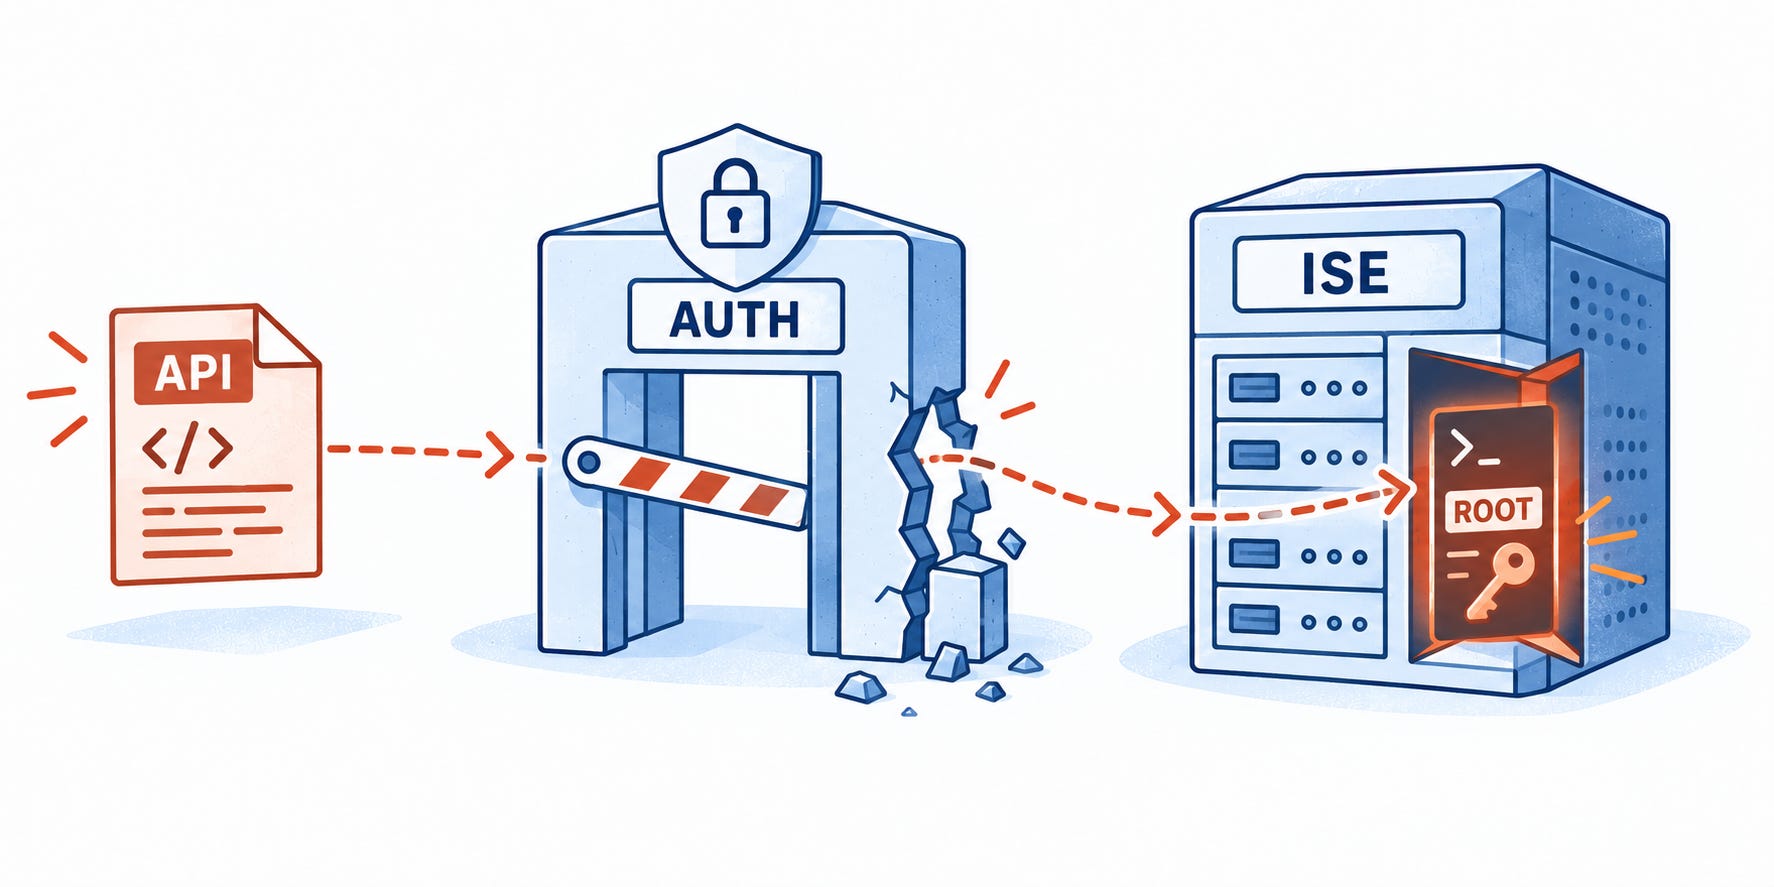
Le gardien de l’accès au réseau de Cisco a un contournement de l’authentification noté CVSS 10
Cisco CVE-2026-76460 permet à un attaquant distant non authentifié de contourner une API d’Identity Services Engine et d’exécuter potentiellement des commandes en tant que root. Cisco a confirmé une exploitation active, indiqué que toutes les configurations d’ISE et d’ISE-PIC sont concernées et n’a fourni aucune solution de contournement complète au-delà de restrictions d’accès temporaires. Corrigez immédiatement, inspectez les journaux d’accès de chaque nœud à la recherche de noms d’utilisateur suspects et réinstallez les systèmes que vous soupçonnez compromis.
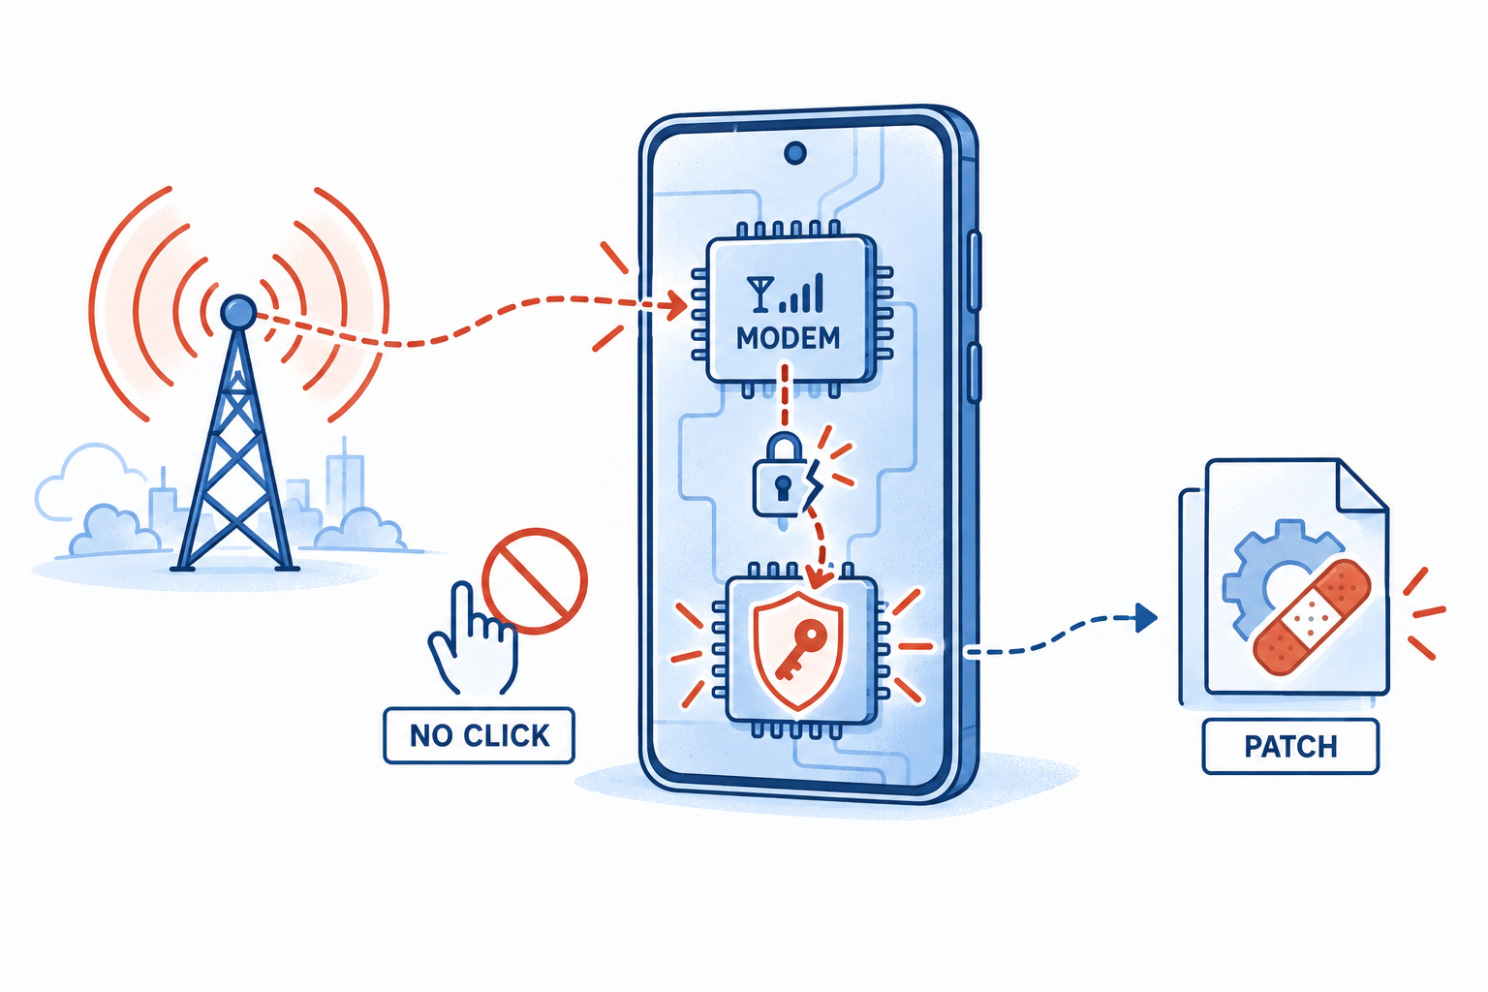
Le zero-day du modem des Pixel de Google ne demande ni toucher, ni clic, ni fichier ouvert
Google CVE-2026-58704 est une faille d’élévation de privilèges de sévérité élevée, causée par une erreur de logique dans la vérification des permissions du modem cellulaire des Pixel. Google a signalé des indices d’une exploitation limitée et ciblée, et la CISA a ajouté la vulnérabilité à son catalogue Known Exploited Vulnerabilities. Le niveau de correctifs de sécurité 2026-09-05 ou ultérieur corrige le problème. Les flottes mobiles doivent vérifier les niveaux de correctifs via le MDM plutôt que de compter sur des mises à jour volontaires des utilisateurs.
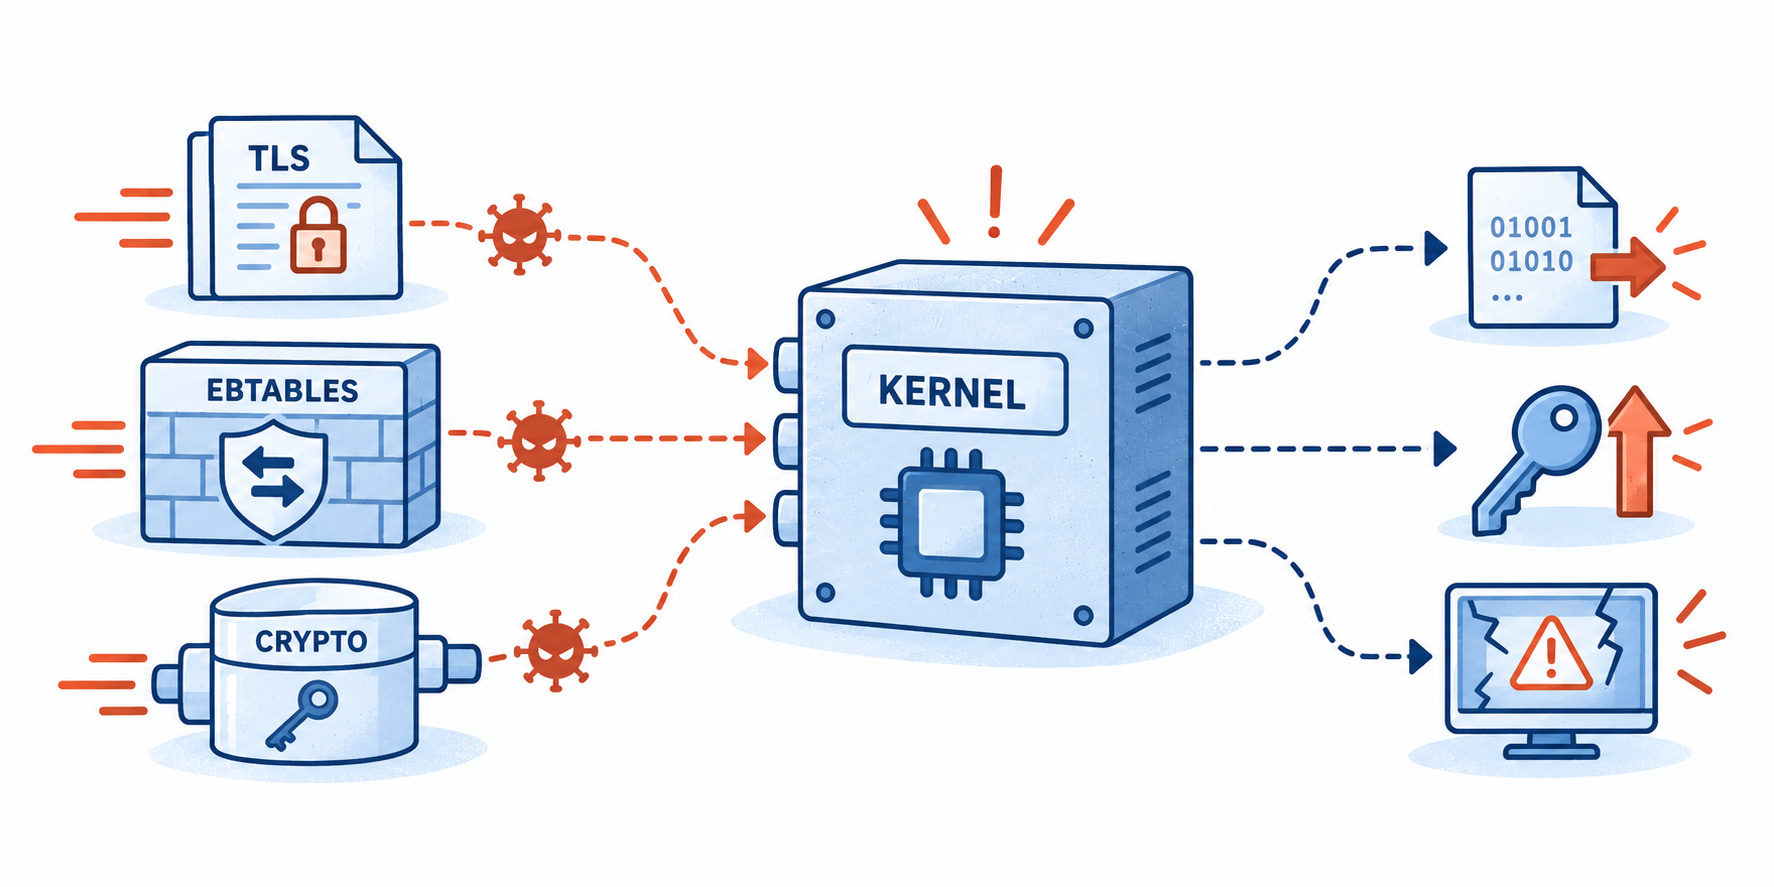
Trois failles du noyau Linux sont passées de la file des correctifs à la priorité d’exploitation active
La CISA a ajouté CVE-2025-39682, CVE-2026-53266 et CVE-2025-39964 à son catalogue des vulnérabilités exploitées. Les failles touchent le chemin de réception TLS, le traitement SNAT d’ebtables et les sockets cryptographiques AF_ALG, et permettent divulgation de mémoire, élévation de privilèges, plantages ou résultats cryptographiques corrompus. Les informations publiques n’expliquent pas comment les attaquants les utilisent. Priorisez les correctifs selon les versions du noyau et l’exposition des workloads, et non selon les seuls scores CVSS.
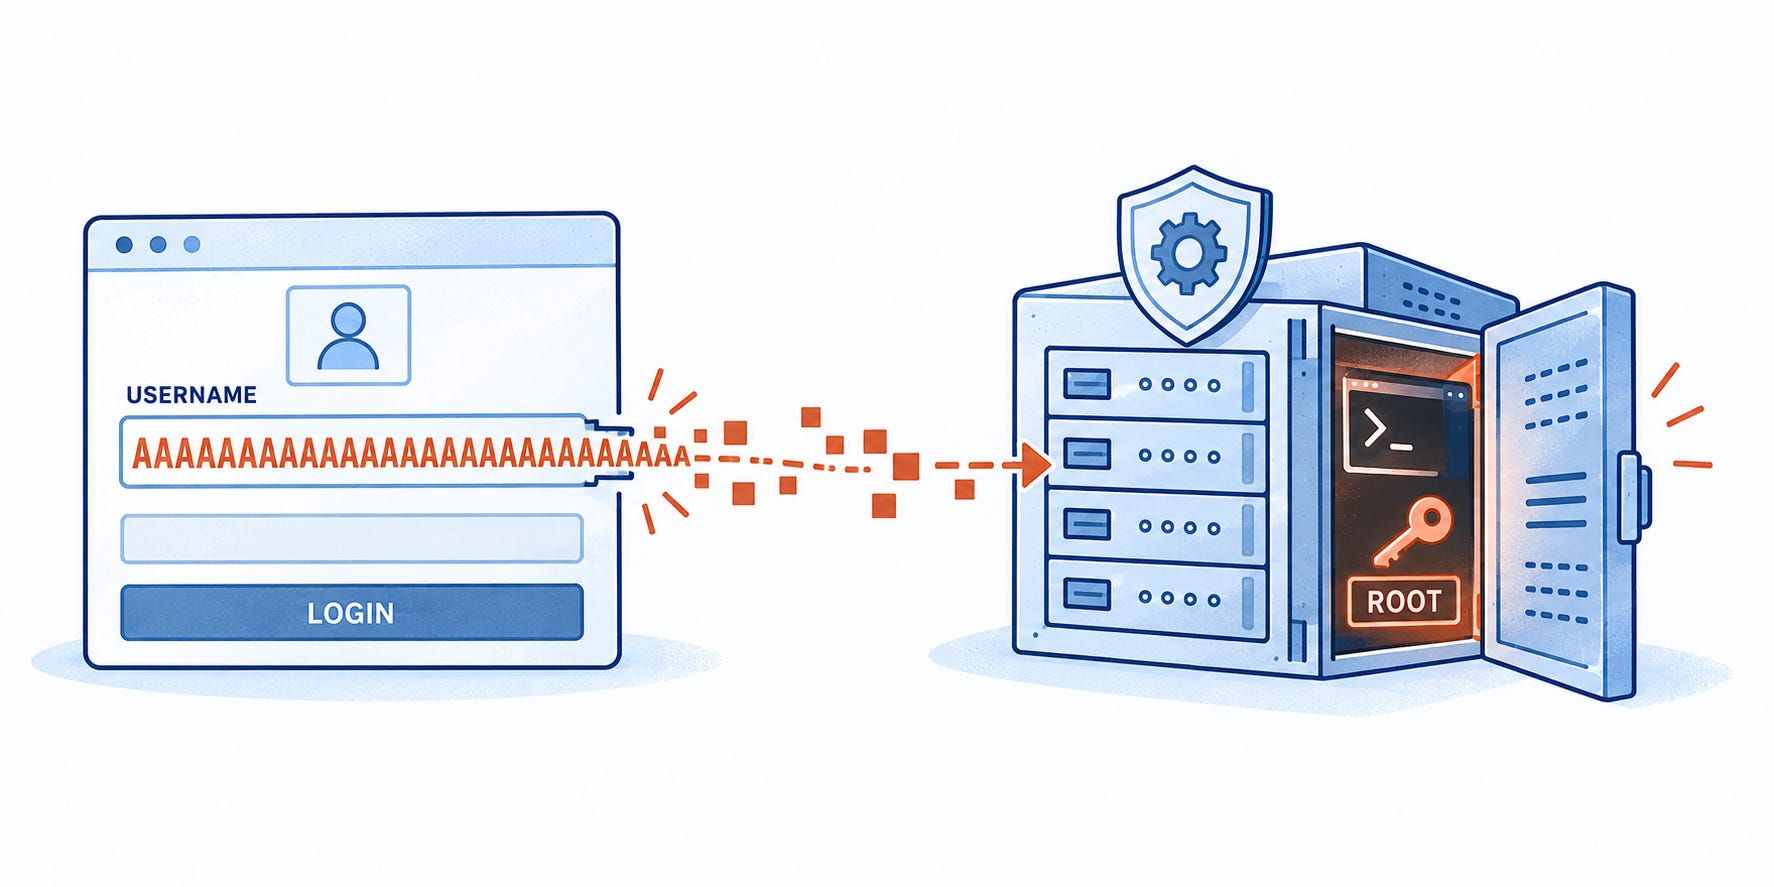
Un nom d’utilisateur surdimensionné pouvait donner le root aux attaquants sur les serveurs de gestion Check Point
Check Point CVE-2026-91843, notée 9,8, est un dépassement de tampon sur la pile dans le processus de connexion non authentifié. Une exploitation réussie pourrait exécuter du code arbitraire en tant que root sur les Security Management et Log Servers concernés. Check Point n’a signalé aucune preuve d’exploitation dans la nature lors de la publication de l’avis. Appliquez immédiatement LivePatch et limitez l’accès à la gestion à des adresses internes de confiance précises.
🔎 Analyse approfondie
Quand les résultats arrivent avec leur preuve
L’alerte dit critique.
Le code a l’air dangereux. L’explication est convaincante. Le scénario d’attaque tient la route.
Puis quelqu’un pose la seule question qui compte :
Pouvez-vous le déclencher ?
C’est là que beaucoup de résultats de sécurité commencent à vaciller.
Une fonction suspecte n’est pas automatiquement exploitable. Un chemin d’attaque plausible peut s’effondrer à l’exécution. Même une explication techniquement correcte peut exagérer l’impact réel.
Le résultat semblait terminé. L’enquête venait à peine de commencer.
Pendant des années, l’écart entre le possible et le prouvé a été comblé par des chercheurs humains. Ils recréent l’environnement, tracent le code concerné, construisent une entrée, observent ce qui se passe, la révisent et recommencent.
Parfois, la vulnérabilité se déclenche.
Parfois, trois heures d’investigation se terminent par rien de plus spectaculaire que « non exploitable dans ces conditions ».
De nombreux outils axés sur la détection s’arrêtent avant que ce travail ne commence. Ils identifient la possibilité et laissent la reproduction à quelqu’un d’autre.
Les agents IA commencent à franchir cette ligne.
L’étape coûteuse commence après la détection
Les analyseurs statiques signalent des schémas dangereux. Les scanners de dépendances font remonter des paquets vulnérables. Les modèles expliquent comment un chemin de code pourrait échouer. Les systèmes de sévérité attachent un nombre au résultat.
Ces sorties sont utiles, mais elles peuvent encore représenter des hypothèses.
Quelqu’un doit déterminer si une entrée non fiable peut atteindre le code, si la condition suspectée peut se produire et si le comportement qui en résulte a un impact de sécurité significatif.
Un logiciel se comporte rarement exactement comme il apparaît sur la page.
Une vérification de validation ailleurs peut bloquer l’attaque. La fonction vulnérable peut être inaccessible dans la configuration déployée. Un plantage peut se produire, mais pas pour la raison prédite par le scanner.
Quand l’affirmation est qu’une vulnérabilité peut être déclenchée, la preuve à l’exécution pèse davantage.
Une preuve de concept fonctionnelle donne à l’équipe quelque chose de concret à exécuter, inspecter et reproduire. Elle fait passer la discussion de ce que le code semble capable de faire à ce qui se passe dans des conditions définies.
Aucun point pour avoir l’air convaincant
CyberGym a été conçu autour de cette distinction.
Ses 1 507 tâches proviennent de vulnérabilités historiques réparties sur 188 projets open source. Pour chaque tâche, l’agent reçoit une description de la vulnérabilité et une version non corrigée du code concerné.
Il doit ensuite reproduire le bug.
L’agent peut devoir explorer un dépôt inconnu, localiser le chemin d’exécution concerné, compiler le projet, construire une entrée déclenchante, l’exécuter, inspecter le résultat et ajuster son approche.
Identifier le bon fichier ou produire une explication assurée ne rapporte aucun point.
CyberGym exécute chaque PoC soumise sur la version avant correctif et sur celle après correctif, avec les sanitizers activés. Pour réussir, l’entrée doit provoquer un plantage détecté par un sanitizer avant le correctif et aucun après.
Lors d’une évaluation CyberGym en cours, Neutron a généré des PoC réussies pour 1 458 des 1 507 tâches, atteignant 96,7 %.
Le pourcentage attire l’attention. Ce qui compte davantage, c’est ce qu’il y a dessous :
1 458 PoC qui ont reproduit la vulnérabilité visée sous des contrôles fondés sur l’exécution, et non 1 458 prédictions.
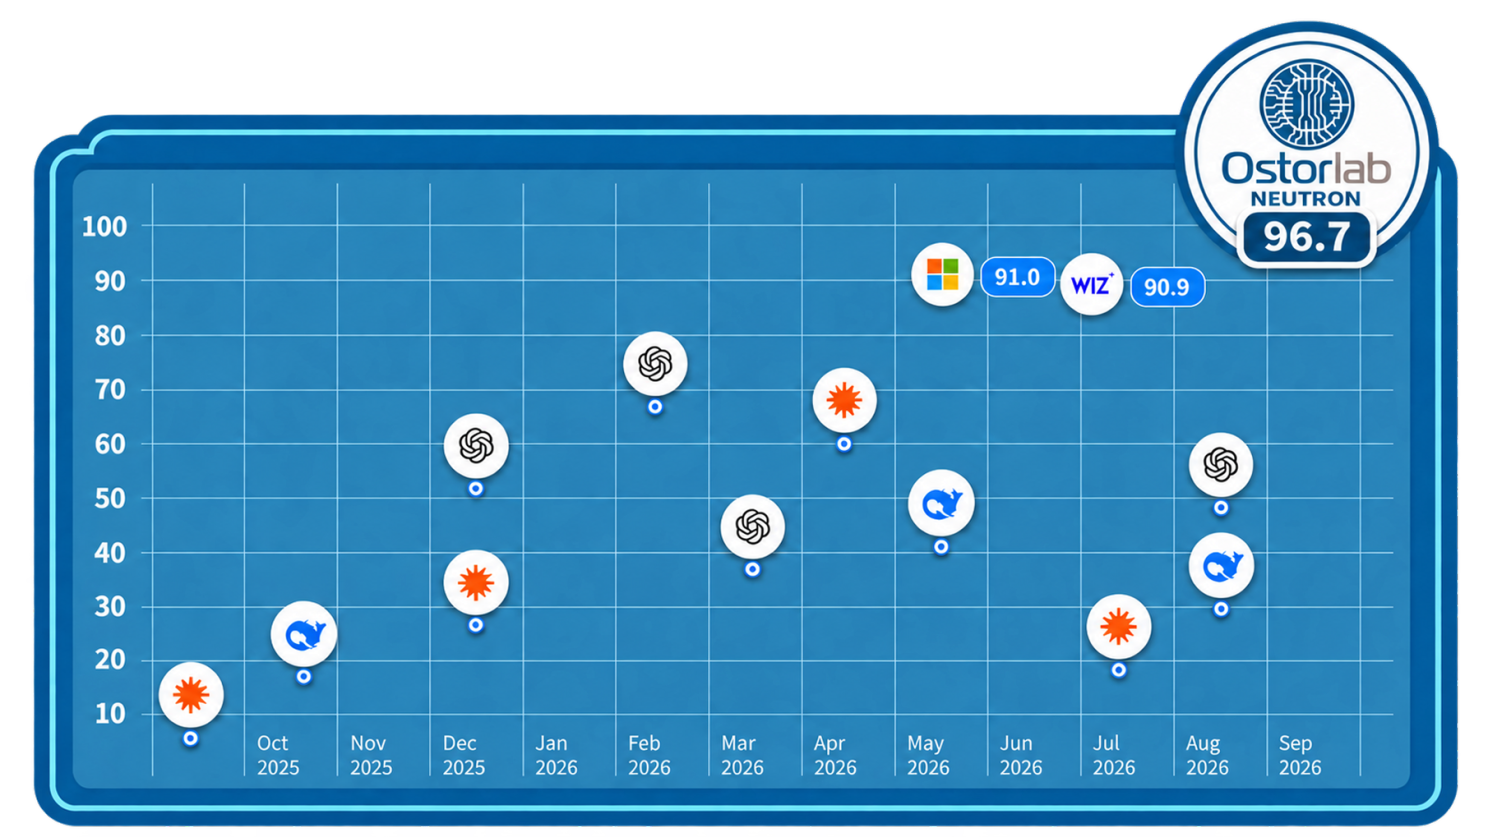
Chaque tâche réussie a exigé que le système aille au-delà de l’analyse et interagisse avec le logiciel jusqu’à produire une preuve observable.
C’est ce changement qu’il faut surveiller.
La première tentative est rarement la preuve
Un modèle de langage peut lire une fonction vulnérable et produire une excellente explication. Il peut reconnaître des schémas de faiblesse familiers, suivre les données dans le code et suggérer une entrée susceptible de déclencher la faille.
Mais la première tentative peut ne pas fonctionner.
Le projet ne compile pas. L’entrée n’atteint jamais la branche visée. Un flag manquant change le chemin d’exécution. Le programme se termine normalement.
Une réponse générée s’arrête là.
Un système agentique peut traiter l’échec comme une nouvelle information.
Il peut lire l’erreur de build, inspecter une autre partie du dépôt, modifier l’entrée, relancer le programme et comparer le résultat. Si la preuve n’étaye pas la théorie de départ, il peut changer de direction.
La valeur n’est pas de tout réussir du premier coup. C’est de rester dans la boucle d’investigation :
inspecter → tenter → exécuter → observer → réviser → vérifier
Cette boucle transforme le raisonnement du modèle en recherche de vulnérabilités concrète.
Le modèle n’en est qu’une partie. Le système qui l’entoure fournit les outils, l’environnement d’exécution, le contexte conservé, la stratégie de nouvelle tentative et les contrôles de vérification nécessaires pour faire avancer l’investigation.
Sans ces éléments, le même modèle peut expliquer comment une PoC devrait fonctionner sans jamais démontrer qu’elle fonctionne.
Quand la reproduction devient découverte
CyberGym évalue surtout des agents face à des vulnérabilités connues. Pourtant, la dernière version de la recherche montre que la reproduction peut mener ailleurs que prévu.
Pendant le travail de reproduction, les agents ont découvert 10 zero-days et 17 correctifs historiques inadéquats. Les entrées générées ont soit déclenché des vulnérabilités jusque-là inconnues, soit révélé que des correctifs antérieurs n’avaient pas totalement supprimé le comportement vulnérable.
Les chercheurs ont ensuite mené une évaluation distincte de découverte ouverte sur 431 projets open source, identifiant 25 zero-days supplémentaires. Après déduplication, l’article fait état de 34 zero-days au total.
Le code change. Un schéma vulnérable peut survivre sous une autre forme. Un correctif peut fermer un chemin tout en laissant atteignable une condition voisine. Une entrée conçue pour un ancien bug peut pousser une version plus récente vers un comportement que personne n’attendait.
Menez ce processus sur assez de projets, de versions et d’entrées, et la validation se met à déborder sur la découverte.
Une investigation n’a pas besoin de commencer par une percée. Un agent peut suivre les échecs précédents, tester des variantes et aller plus loin que le temps humain limité ne le permettrait normalement.
L’échelle devient une partie de la méthode de recherche.
La preuve déplace le goulot d’étranglement en aval
Une PoC reproductible donne aux chercheurs et aux développeurs un point de référence commun.
Le chercheur peut inspecter le comportement exact. Le développeur peut exécuter la même entrée avant et après une modification. L’équipe sécurité peut confirmer quelles versions sont concernées. Le correctif final peut être testé contre la preuve ayant servi à établir la vulnérabilité.
Sans ce point de référence, chaque équipe peut interpréter le résultat différemment.
Le chercheur voit une corruption de mémoire atteignable. Le développeur voit une entrée inhabituelle qui ne devrait jamais se produire. Le responsable voit un score critique. Le product owner voit une livraison retardée.
La preuve exécutable réduit ce désaccord.
Mais une reproduction plus rapide ne vide pas le backlog. Elle déplace la file d’attente.
Chaque PoC réussie doit encore être comprise. Les équipes doivent confirmer l’impact, identifier les systèmes concernés, prioriser la réponse, développer un correctif sûr et vérifier que le comportement d’origine ne se produit plus.
À mesure que la reproduction s’accélère, les défenseurs peuvent disposer de moins de temps pour corriger les vulnérabilités divulguées avant l’apparition d’exploits fonctionnels.
La ressource rare passe de la production de la première preuve à la capacité d’agir dessus vite et correctement.
Le résultat n’est que le début
La recherche de vulnérabilités par IA ne sera pas définie uniquement par le nombre de problèmes qu’un système peut nommer.
Le changement plus important, c’est le nombre de résultats qui arrivent avec quelque chose qui s’exécute, reproduit le comportement et résiste à l’inspection.
L’exécution de CyberGym par Neutron apporte la preuve de cette transition. La génération de preuves peut désormais être répétée sur des centaines de vraies bases de code, transformant une étape d’investigation chronophage en quelque chose qu’un agent peut effectuer à répétition et à grande échelle.
Cela change le standard d’un résultat de sécurité utile.
Un score de sévérité devient l’affirmation d’ouverture, pas la conclusion. « Le code semble vulnérable » ne suffit plus quand on peut demander à un système de démontrer exactement comment il échoue.
Les outils de sécurité de nouvelle génération ne se contentent pas de nous dire où regarder. Ils nous montrent ce qui cède.
🎣 Est-ce du phishing ?
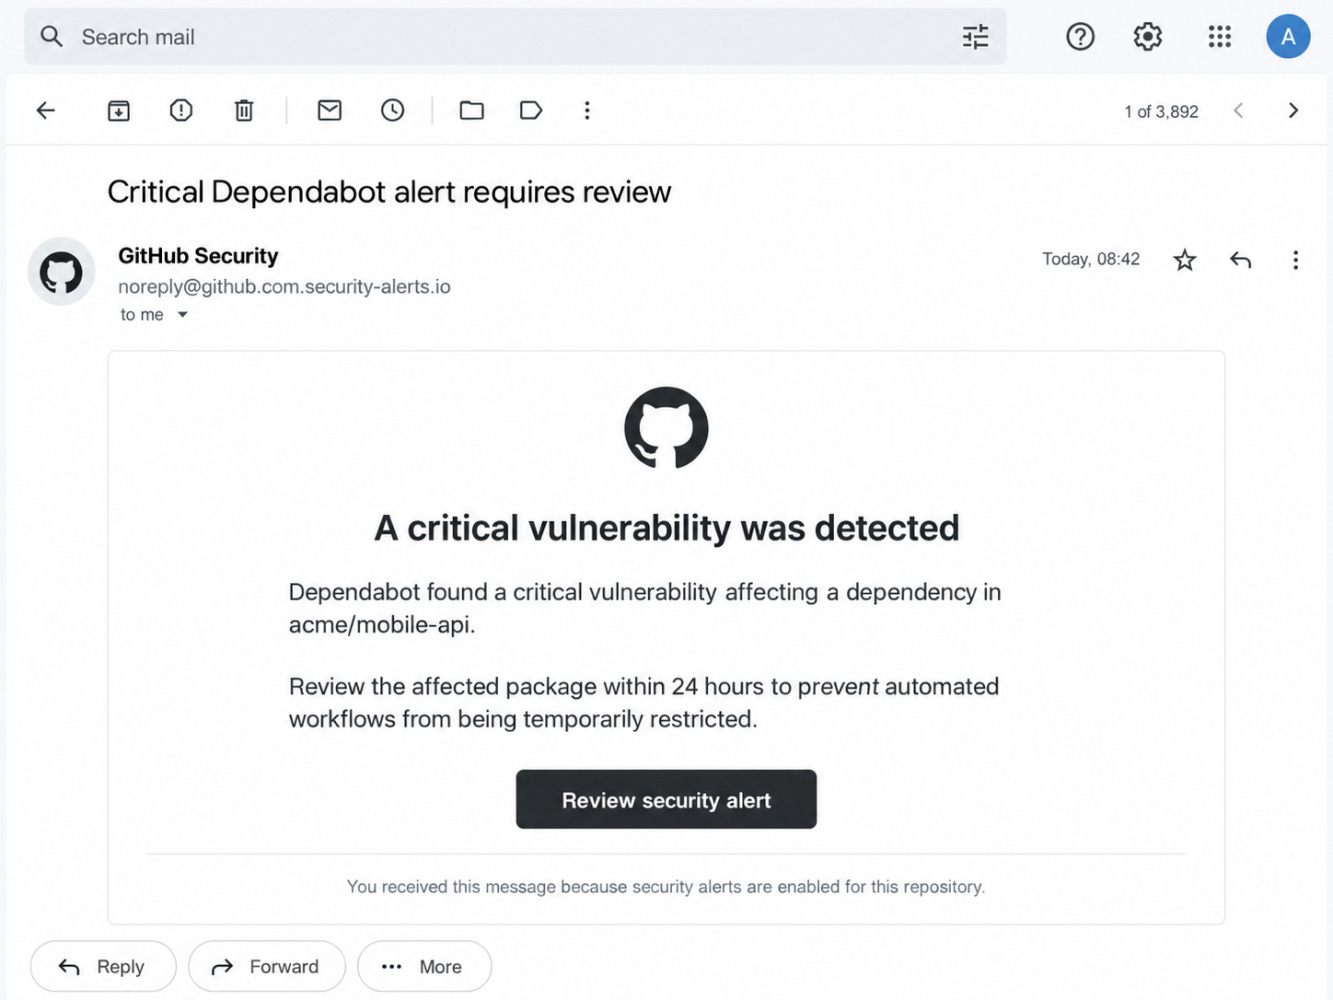
Alerte GitHub légitime ou phishing soigneusement déguisé ? Examinez-la de près avant de décider.
🔬 Recherche technique
L’extension ne pouvait pas lire le fichier. L’agent, si.
Une extension de navigateur veut lire un fichier local.
Le navigateur refuse. L’extension n’a pas la permission.
Mais l’assistant IA du navigateur, lui, l’a.
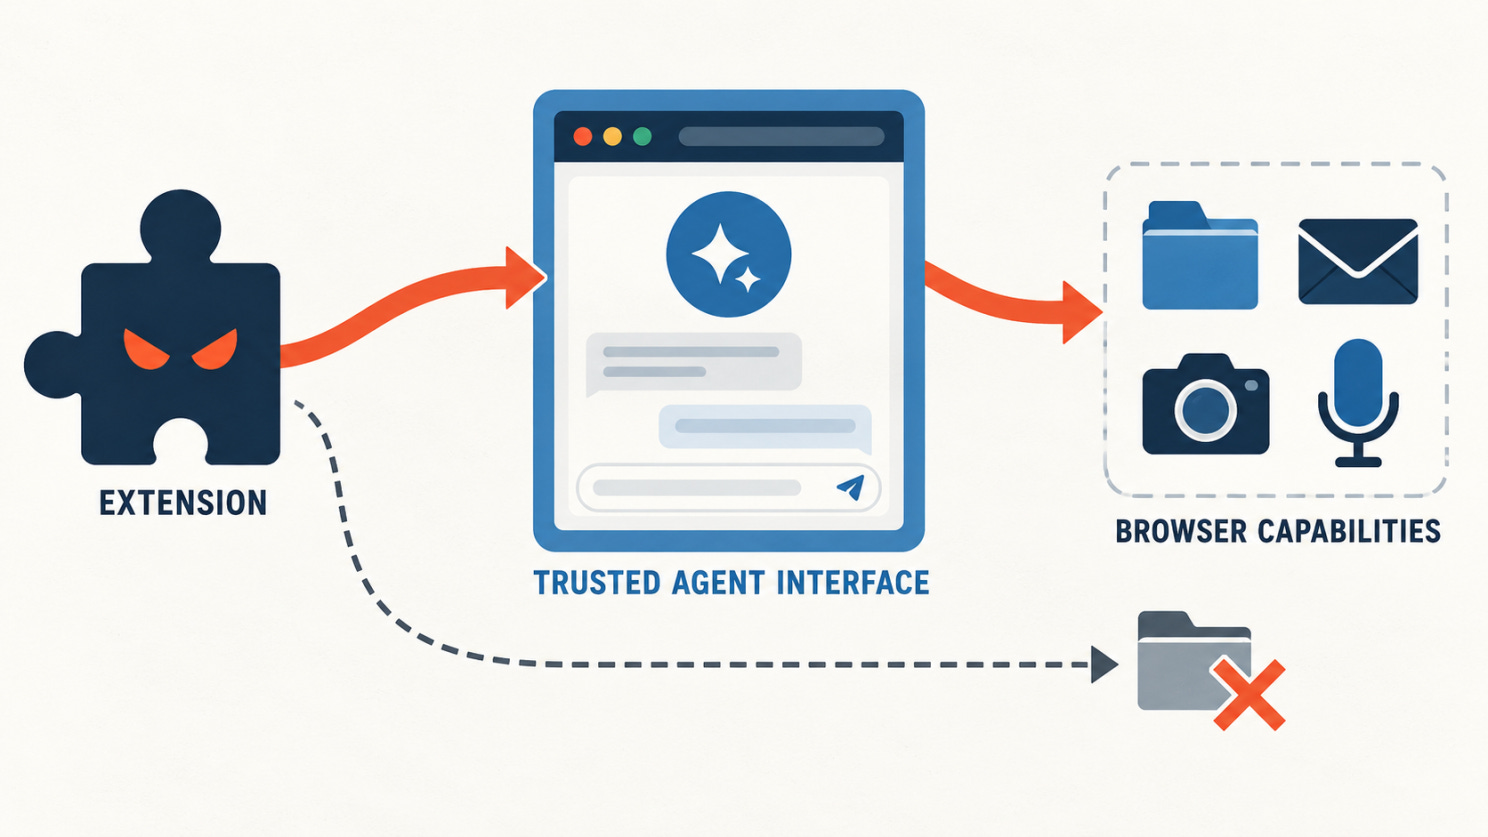
Au lieu d’accéder directement au fichier, l’extension atteint l’interface de confiance qui commande l’assistant. Le composant privilégié du navigateur récupère le fichier, en capture le contenu et renvoie le résultat.
C’était la technique centrale de BragJack, un ensemble d’attaques démontrées contre Gemini Live dans Chrome, Perplexity Comet, Microsoft Edge Actions, Opera Neon et Claude in Chrome.
Les chercheurs ont utilisé un seul framework d’extension sur les cinq implémentations, mais ils n’ont pas découvert une vulnérabilité universelle. Chaque produit exposait un chemin différent entre du code contrôlé par l’extension et une interface à laquelle son agent de navigateur fait confiance.
Une fois cette frontière franchie, les capacités de l’agent devenaient celles de l’attaquant.
L’attaque commence par une extension
BragJack exige qu’une extension malveillante ou compromise soit installée avec les permissions nécessaires. Ce n’est pas une attaque drive-by que n’importe quel site web pourrait lancer contre un navigateur non affecté.
Le framework d’extension commun reposait surtout sur un large accès aux sites HTTPS et sur la permission declarativeNetRequest, couramment abrégée en DNR. Les chemins Edge et Claude exigeaient en plus la permission debugger, plus puissante.
DNR permet à une extension de définir des règles qui modifient la façon dont le navigateur traite les requêtes réseau. Dans les démonstrations, les chercheurs l’ont utilisée à deux fins :
Supprimer ou affaiblir des en-têtes de sécurité comme la Content Security Policy.
Rediriger une requête JavaScript d’une ressource de confiance vers du code contrôlé par l’attaquant.
Les chercheurs appellent cette technique combinée DiNneR Serving.
Une page protégée demande un script légitime. L’extension intercepte cette requête, modifie les en-têtes de sécurité de la page et substitue un script malveillant. Comme le navigateur charge le remplacement à l’intérieur de la page de confiance, le code de l’attaquant hérite de l’accès à des interfaces qu’une extension ordinaire ne peut pas atteindre directement.
L’extension reste en dehors de la frontière protégée.
Son code, non.
De l’interface de Gemini aux privilèges de Chrome
L’implémentation de Gemini Live dans Chrome séparait l’assistant IA en deux composants.
Le composant privilégié, hébergé à chrome://glic, pouvait interagir avec des capacités au niveau du navigateur. L’application web Gemini à gemini.google.com gérait l’interface de l’assistant et communiquait avec ce composant.
Chrome empêchait les extensions d’attacher directement des scripts, des débogueurs ou des règles de requête à la page interne chrome://glic. Ces protections couvraient aussi la plupart des interactions avec l’application Gemini intégrée.
Mais un chemin restait ouvert : les règles DNR pouvaient encore affecter les requêtes réseau émises par la page HTTPS intégrée dans l’interface privilégiée.
Les chercheurs ont utilisé cette brèche pour intercepter une ressource JavaScript demandée par gemini.google.com. Leur extension a supprimé ou modifié les en-têtes qui auraient bloqué le remplacement, puis redirigé la requête vers un script contrôlé par l’attaquant.
Ce script s’exécutait sous l’origine de confiance de Gemini tout en étant intégré dans chrome://glic.
À partir de là, l’attaque n’avait plus besoin de manipuler le modèle par un prompt. Le code injecté pouvait communiquer directement avec le composant privilégié du navigateur et émettre les commandes que Gemini lui-même utilisait normalement.
Les chercheurs ont démontré des commandes capables d’ouvrir des URL, de demander le contenu de l’onglet actif et de renvoyer du texte, des données PDF ou des captures d’écran. Comme Chrome acceptait les URL file://, la même interface pouvait exposer des fichiers et des dossiers locaux. Une autre commande renvoyait des informations du profil de navigateur connecté.
Les chercheurs ont aussi indiqué que le processus Gemini compromis héritait de l’accès à la caméra et au microphone, car ces permissions étaient disponibles pour la prise en charge de l’entrée audio et vidéo. Cela créait la possibilité d’enregistrer sans afficher de nouvelle demande de consentement.
Google a suivi le problème sous-jacent sous la référence CVE-2026-0628, de sévérité élevée.
Une extension, cinq défaillances de confiance
Les autres attaques atteignaient des interfaces privilégiées similaires par des erreurs d’implémentation différentes.
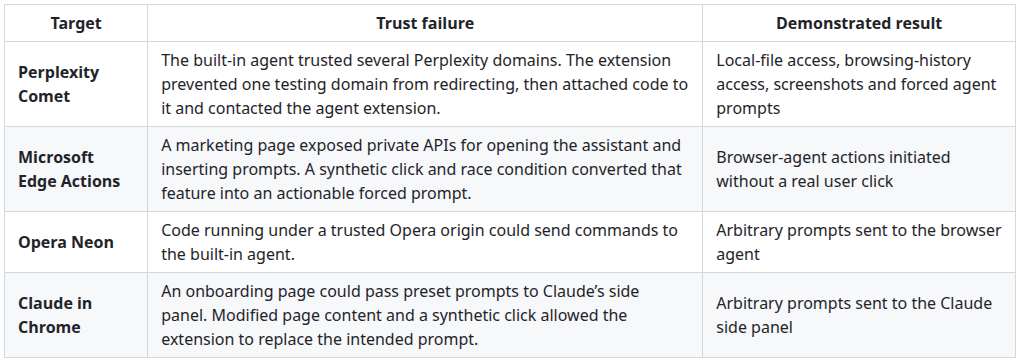
Dans la démonstration sur Comet, l’attaquant pouvait demander à l’agent de trouver des e-mails récents, de les résumer et d’envoyer le résultat ailleurs, en laissant l’agent gérer la navigation et les actions individuelles.
Les démonstrations sur Edge et Claude utilisaient la permission debugger de l’extension pour synthétiser le clic de confiance exigé par leurs interfaces. Ce prérequis compte : ces chemins dépendaient d’une permission capable d’instrumenter les onglets du navigateur, et pas seulement d’une injection de contenu ordinaire.
Microsoft a attribué CVE-2026-55945 à la race condition d’Edge.
Zero-click, après l’installation
Les démonstrations n’exigeaient aucun clic supplémentaire une fois l’extension malveillante et ses permissions requises en place.
Elles sont donc zero-click au stade de l’exploitation, mais pas sans installation. Un attaquant devrait encore publier une extension malveillante, en compromettre une existante ou persuader autrement la victime de l’installer.
Une fois cette tête de pont établie, l’extension pouvait atteindre des capacités allant au-delà de celles suggérées par son jeu de permissions direct.
C’est ce qui rendait BragJack inhabituel. L’extension ne volait pas toujours les données elle-même. Elle passait dans une interface d’agent qui avait déjà la permission de voir, de capturer ou de manipuler plus que ce que l’extension pouvait faire.
Le navigateur appliquait une frontière autour de l’extension et une autre autour de l’agent. Les attaques ont trouvé des endroits où la confiance passait de l’une à l’autre sans vérification suffisante.
Sur l’ensemble des cinq divulgations, les chercheurs ont reçu 20 000 $ de bug bounties et deux CVE ont été attribuées. Les éditeurs concernés ont été prévenus et les chemins signalés ont été corrigés.
La leçon de BragJack se lit dans la mécanique : sécuriser le modèle ne suffit pas quand du code non fiable peut atteindre le canal qui commande ses outils.
L’extension n’avait pas besoin de déjouer l’agent. Il lui suffisait d’accéder à ses permissions
🛠️ Outil de la semaine
herdr
Le centre de commande de vos agents de code
Faire tourner un agent de code est simple. En faire tourner plusieurs tourne vite à l’archéologie de terminaux : lequel travaille encore ? Lequel a échoué ? Lequel attend une réponse depuis dix minutes ?
herdr est un runtime de terminal open source conçu pour faciliter cela. Il garde les terminaux des agents actifs grâce à un serveur en arrière-plan quand vous vous détachez ou perdez une connexion SSH : fermer le client n’arrête donc pas le travail.
Chaque panneau est étiqueté working, blocked ou idle, ce qui permet de trouver plus facilement l’agent qui a vraiment besoin d’attention. Les sessions locales et les machines distantes enregistrées peuvent aussi apparaître dans une seule fenêtre, avec des reconnexions indépendantes.
Herdr fonctionne avec les agents de code que les développeurs utilisent déjà, dont Codex, Claude Code, Cursor, OpenCode et Grok. Il ne les enveloppe pas et ne les remplace pas. Il gère les terminaux dans lesquels ils tournent.
L’outil est aussi natif pour les agents. Via son CLI et son API socket, les agents peuvent créer des panneaux, se donner des prompts les uns aux autres et attendre qu’un autre agent soit réellement bloqué avant d’intervenir.
Livré sous la forme d’un seul binaire Rust, sans couche Electron, herdr est une option utile pour quiconque voit son workflow de code impliquer plus d’agents que les onglets de terminal ne peuvent en gérer confortablement.
👏 Personnalité de la semaine
Daniel Miessler
La cybersécurité va vite. L’IA va encore plus vite. Comprendre ce qui se passe quand les deux se heurtent devient une discipline à part entière.
Daniel Miessler a passé une grande partie de sa carrière à donner du sens à cette intersection.
Daniel est chercheur, auteur et fondateur en cybersécurité et en IA, et publie des travaux techniques en ligne depuis 1999. En plus de vingt ans dans la sécurité, il a travaillé en sécurité applicative, gestion des vulnérabilités et direction de la sécurité dans des entreprises comme Apple, Robinhood, IOActive et HP.
Son travail open source comprend SecLists, une collection très utilisée de payloads de test, de noms d’utilisateur, de mots de passe, de web shells et de données de fuzzing, incluse dans Kali Linux depuis 2018.
Plus récemment, il a créé Fabric, un framework open source conçu pour aider chacun à appliquer l’IA à des problèmes précis à l’aide de patterns réutilisables.
À travers Unsupervised Learning, sa newsletter, son podcast et ses recherches publiques, Daniel continue d’examiner comment l’IA change la cybersécurité, le travail et les capacités humaines, sans réduire la conversation à l’enthousiasme ou à la peur.
Pour aider les professionnels de la sécurité à comprendre ce que l’IA change, ce qu’elle ne change pas et ce qui mérite plus d’attention, Daniel Miessler est notre Personnalité de la semaine.
📅 Événement de la semaine
AMLUCS 2026
📍 Londres, Royaume-Uni · 23 et 24 septembre
Que se passe-t-il quand ce que vous défendez peut aussi raisonner, utiliser des outils et agir ?
C’est le terrain qu’explore AMLUCS 2026 . Cette conférence de deux jours se concentre sur l’intersection pratique de l’IA et de la cybersécurité, avec un programme couvrant cette année les menaces agentiques, l’IA offensive et défensive, la sécurité multi-agents, le red teaming de l’IA et la sécurisation des systèmes d’IA en production.
Une session qui a retenu notre attention : « The Agent’s Inner Monologue », un atelier pratique qui explore si la surveillance de la trace de raisonnement d’un agent peut révéler des compromissions que les contrôles classiques d’entrée/sortie manquent.
À suivre si : vous vous intéressez à la façon dont la sécurité change quand l’IA passe de la réponse aux questions à l’action réelle.
📚 Livre de la semaine
Bug Bounty Bootcamp
Trouver un bug est excitant. L’expliquer assez bien pour qu’un autre le reproduise est une autre compétence.
Dans Bug Bounty Bootcamp, Vickie Li couvre tout le processus de chasse aux bugs, de la reconnaissance et du test des vulnérabilités web courantes à l’enchaînement des résultats, en passant par l’usage de Burp Suite et la rédaction de rapports exploitables par les équipes.
C’est pratique, accessible et particulièrement utile pour qui apprend à transformer un comportement suspect en vulnérabilité claire et reproductible.
😅 Le mème
Si un modèle moins coûteux atteint le même résultat de sécurité validé, pour quoi payez-vous réellement un supplément ?
The Breach Brief, L’équipe Ostorlab