Las herramientas de seguridad llevan años sirviendo el mismo menú: una etiqueta de crítico, una ruta de código sospechosa y, de guarnición, el peor impacto posible.
La PoC siempre se vendió aparte.
Producir esa prueba implicaba reconstruir el entorno, rastrear la ruta vulnerable, elaborar una entrada, verla fallar y volver a intentarlo. La detección podía llevar segundos. Demostrar que la vulnerabilidad realmente se activaba podía llevar horas.
Los agentes de IA empiezan a asumir ese paso que faltaba.
El Análisis a fondo de esta semana se pregunta qué cambia cuando los hallazgos llegan con pruebas. Examinamos cómo los agentes pasan de explicar las vulnerabilidades a reproducirlas mediante comprobaciones basadas en la ejecución, por qué los intentos fallidos forman parte del proceso y cómo la reproducción repetida puede, a veces, destapar fallos totalmente nuevos. La ejecución de Neutron en CyberGym nos da un ejemplo concreto: 1,458 PoC exitosas en 1,507 tareas de vulnerabilidades del mundo real.
En Investigación técnica, La extensión no podía leer el archivo. El agente sí. Desgranamos BragJack, un conjunto de ataques que muestran cómo una sola extensión de navegador maliciosa podía llegar a las interfaces privilegiadas de cinco asistentes de IA y usar sus permisos para acceder a archivos, correos electrónicos y otros recursos sensibles.
Además, exploramos herdr, un entorno de ejecución de terminal para gestionar varios agentes de programación, le pedimos que juzgue una alerta de seguridad de GitHub, analizamos las historias de seguridad más importantes de la semana y cerramos con el último meme de las trincheras.
En este número:
🌡️ Nivel de amenaza
⚡ Noticias
🔎 Análisis a fondo: Cuando los hallazgos llegan con pruebas
🎣 ¿Es phishing?
🔬 Investigación técnica: La extensión no podía leer el archivo. El agente sí.
🛠️ Herramienta de la semana: hrdr
👏 Persona de la semana: Daniel Miessler
📅 Evento de la semana: AMLUCS 2026
📚 Libro de la semana: Bug Bounty Bootcamp
😅 El meme
Vamos al grano.
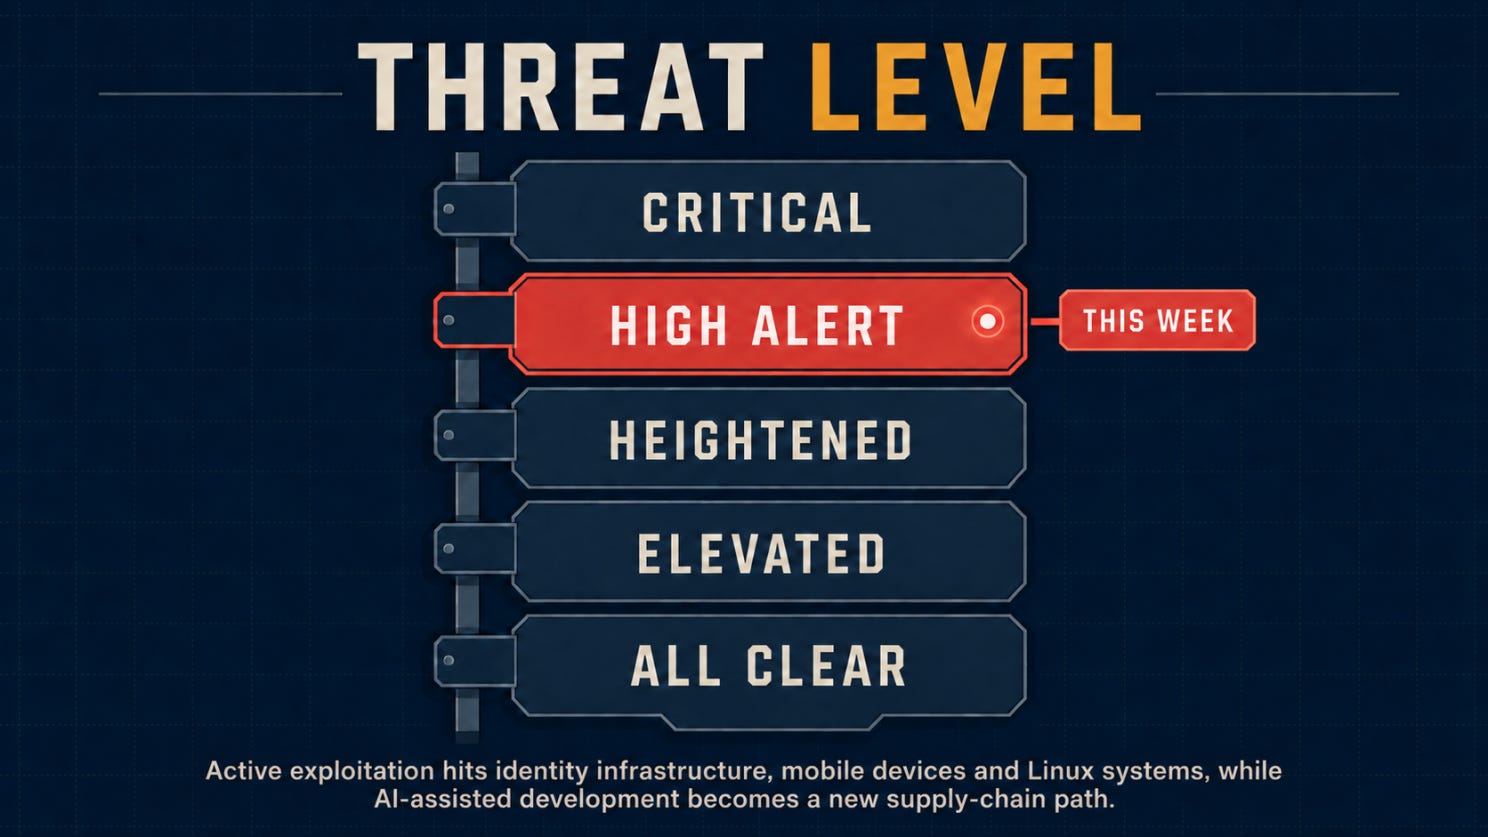
Antes de entrar en las historias de esta semana, este es el estado del nivel de amenaza.
🌡️Nivel de amenaza
⚡ Noticias
Un asistente de programación con IA fue el primer eslabón de un compromiso de 100 repositorios
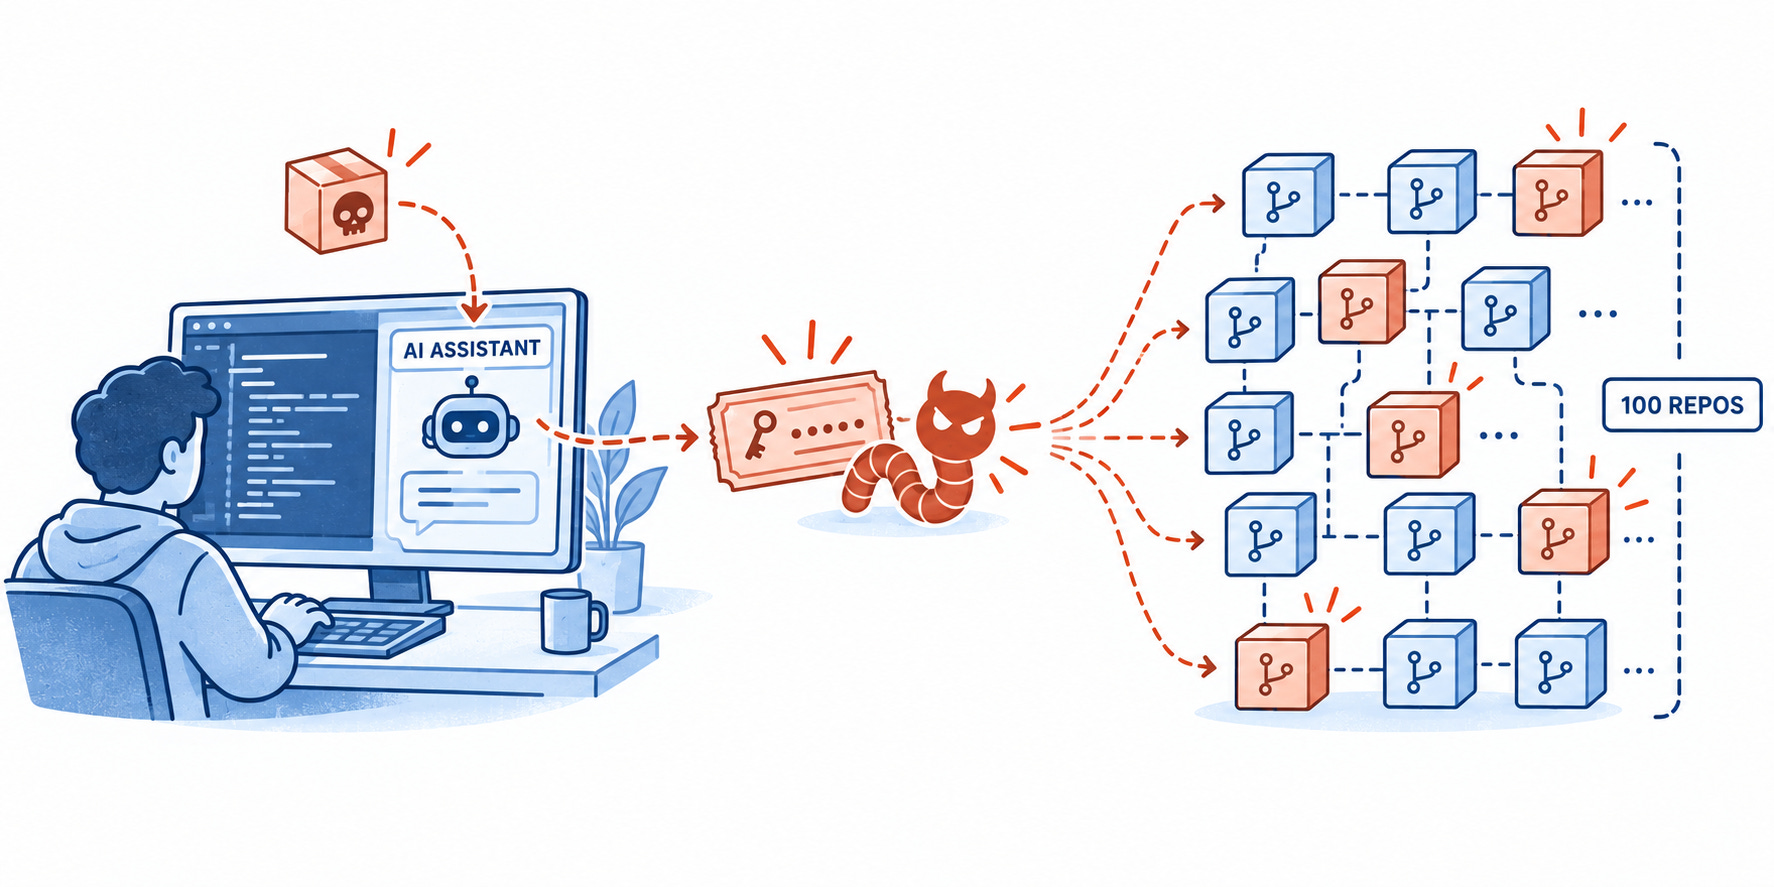
Mandiant investigó a un atacante que secuestró una sesión activa de un asistente de programación en un proveedor de SaaS sin identificar. Tras recomendar el asistente una dependencia envenenada, un infostealer recopiló tokens OAuth de GitHub y Shai-Hulud se propagó por unos 100 repositorios internos, robando secretos y código fuente. El método del compromiso inicial sigue sin revelarse. Trate las recomendaciones de dependencias generadas por IA como entradas no confiables, aplique listas de permitidos y aísle las credenciales de los desarrolladores.
El guardián de acceso a la red de Cisco tiene una omisión de autenticación con CVSS 10
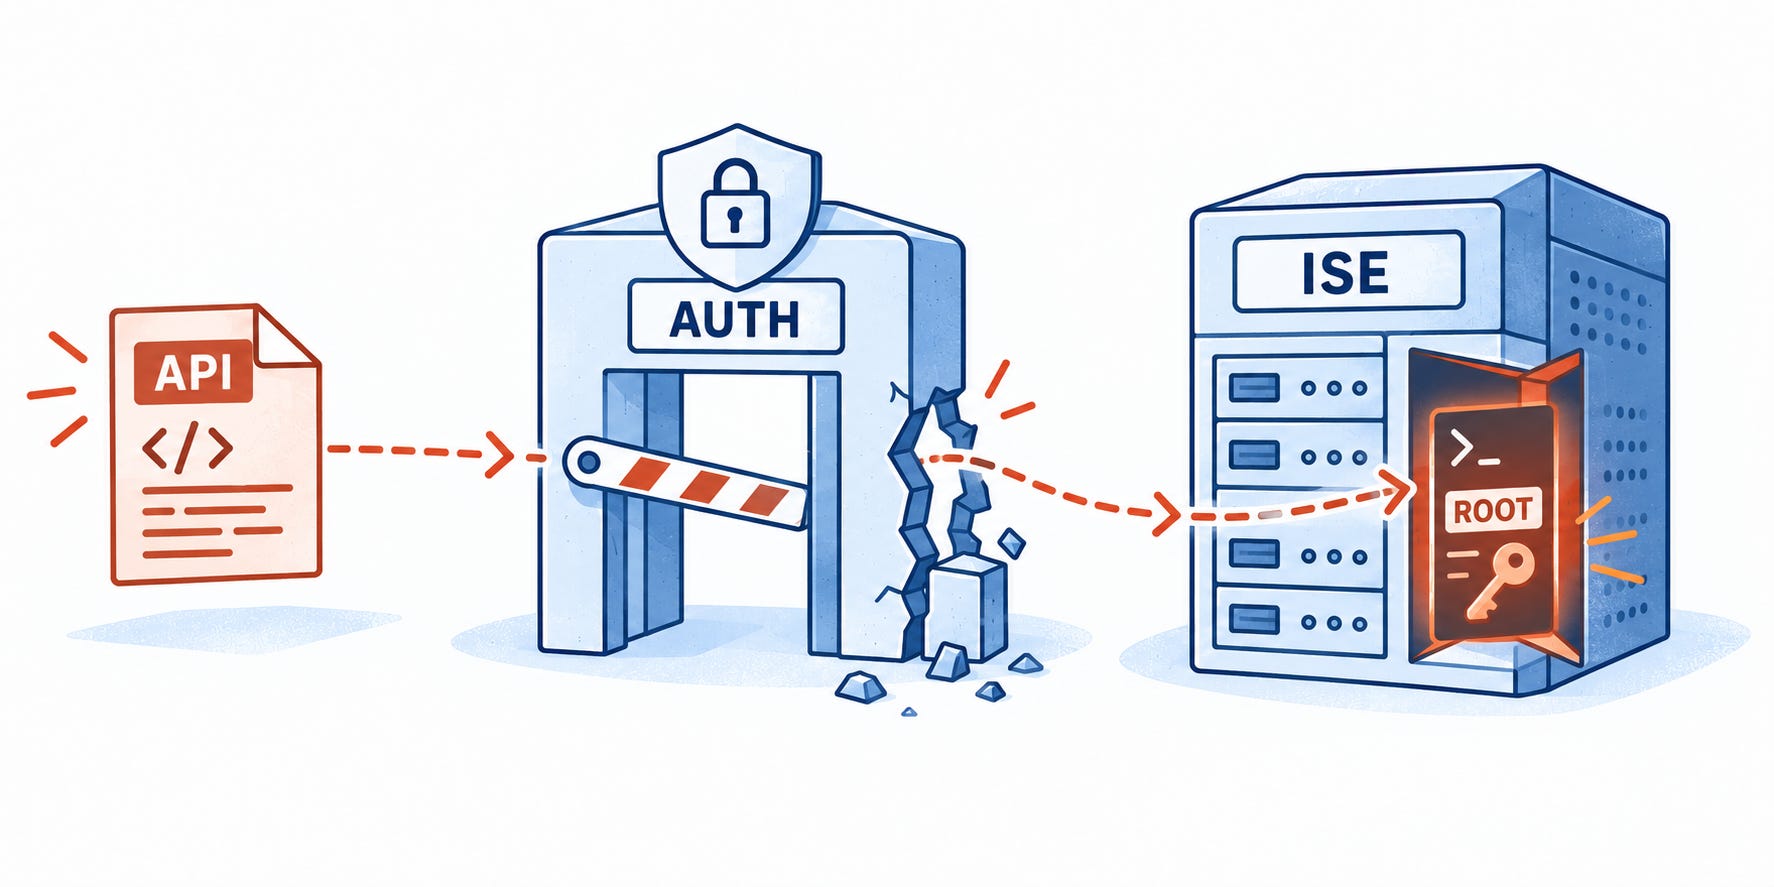
Cisco CVE-2026-76460 permite a un atacante remoto sin autenticar eludir una API de Identity Services Engine y, potencialmente, ejecutar comandos como root. Cisco confirmó la explotación activa, indicó que todas las configuraciones de ISE e ISE-PIC están afectadas y no ofreció una solución alternativa completa más allá de restricciones de acceso temporales. Aplique el parche de inmediato, inspeccione los registros de acceso de cada nodo en busca de nombres de usuario sospechosos y reinstale los sistemas en los que se sospeche un compromiso.
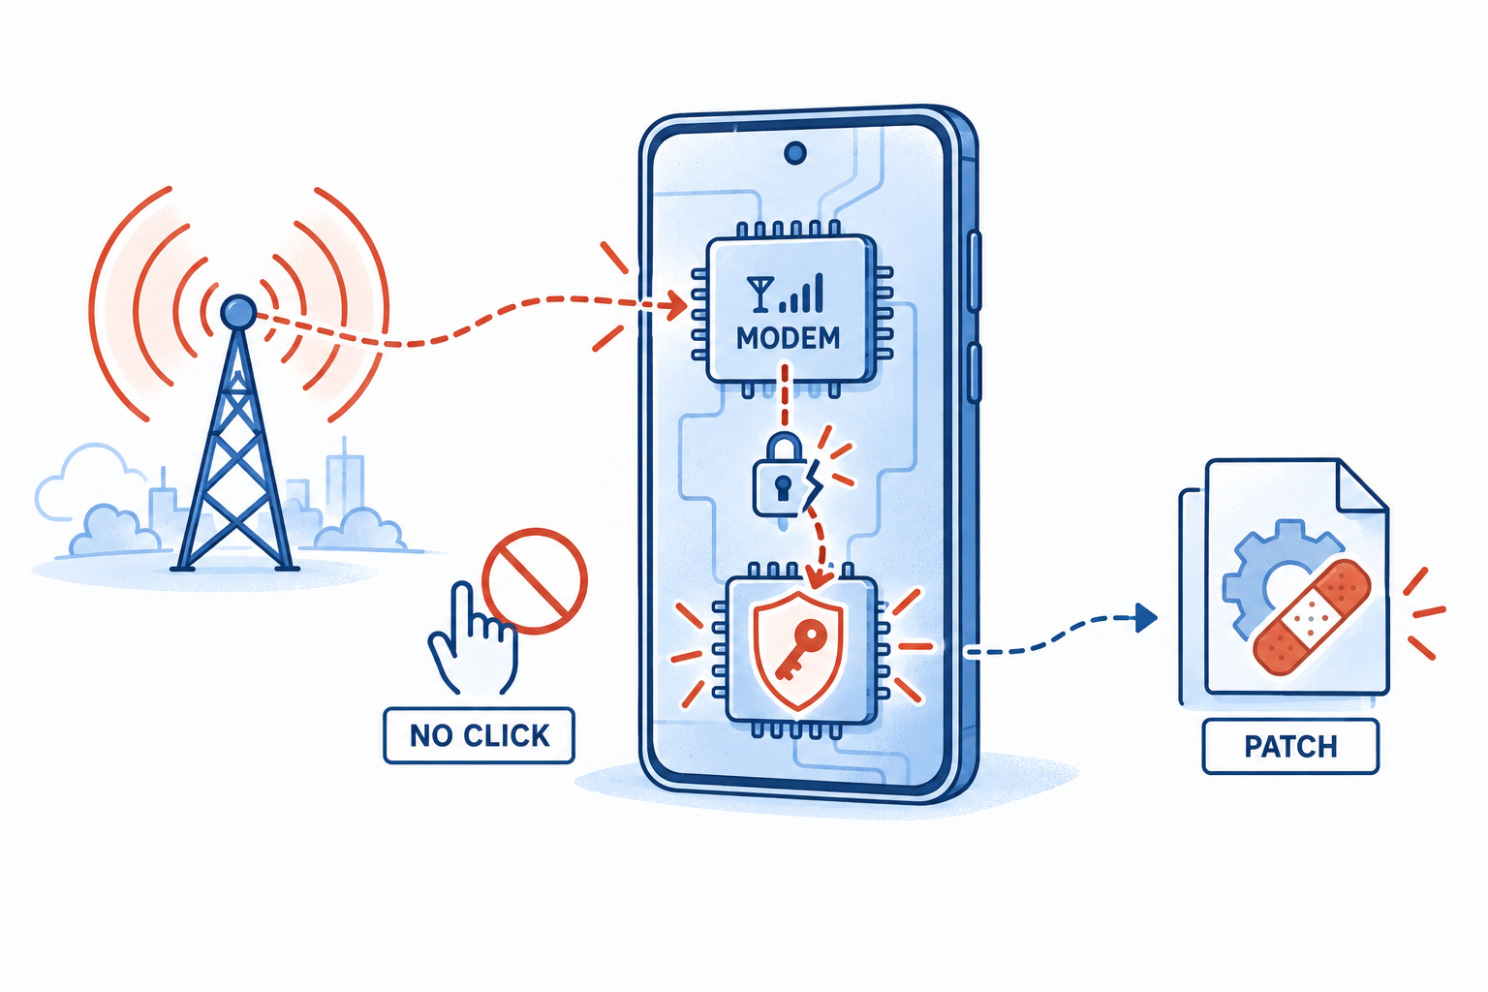
El zero-day del módem de los Pixel de Google no necesita toques, clics ni archivos abiertos
Google CVE-2026-58704 es un fallo de escalada de privilegios de severidad alta causado por un error lógico en la comprobación de permisos del módem celular de los Pixel. Google informó de indicios de explotación limitada y dirigida, y CISA añadió la vulnerabilidad a su catálogo de vulnerabilidades explotadas conocidas (KEV). El nivel de parche de seguridad 2026-09-05 o posterior corrige el problema. Las flotas de dispositivos móviles deben verificar los niveles de parche mediante MDM en lugar de confiar en que los usuarios actualicen voluntariamente.
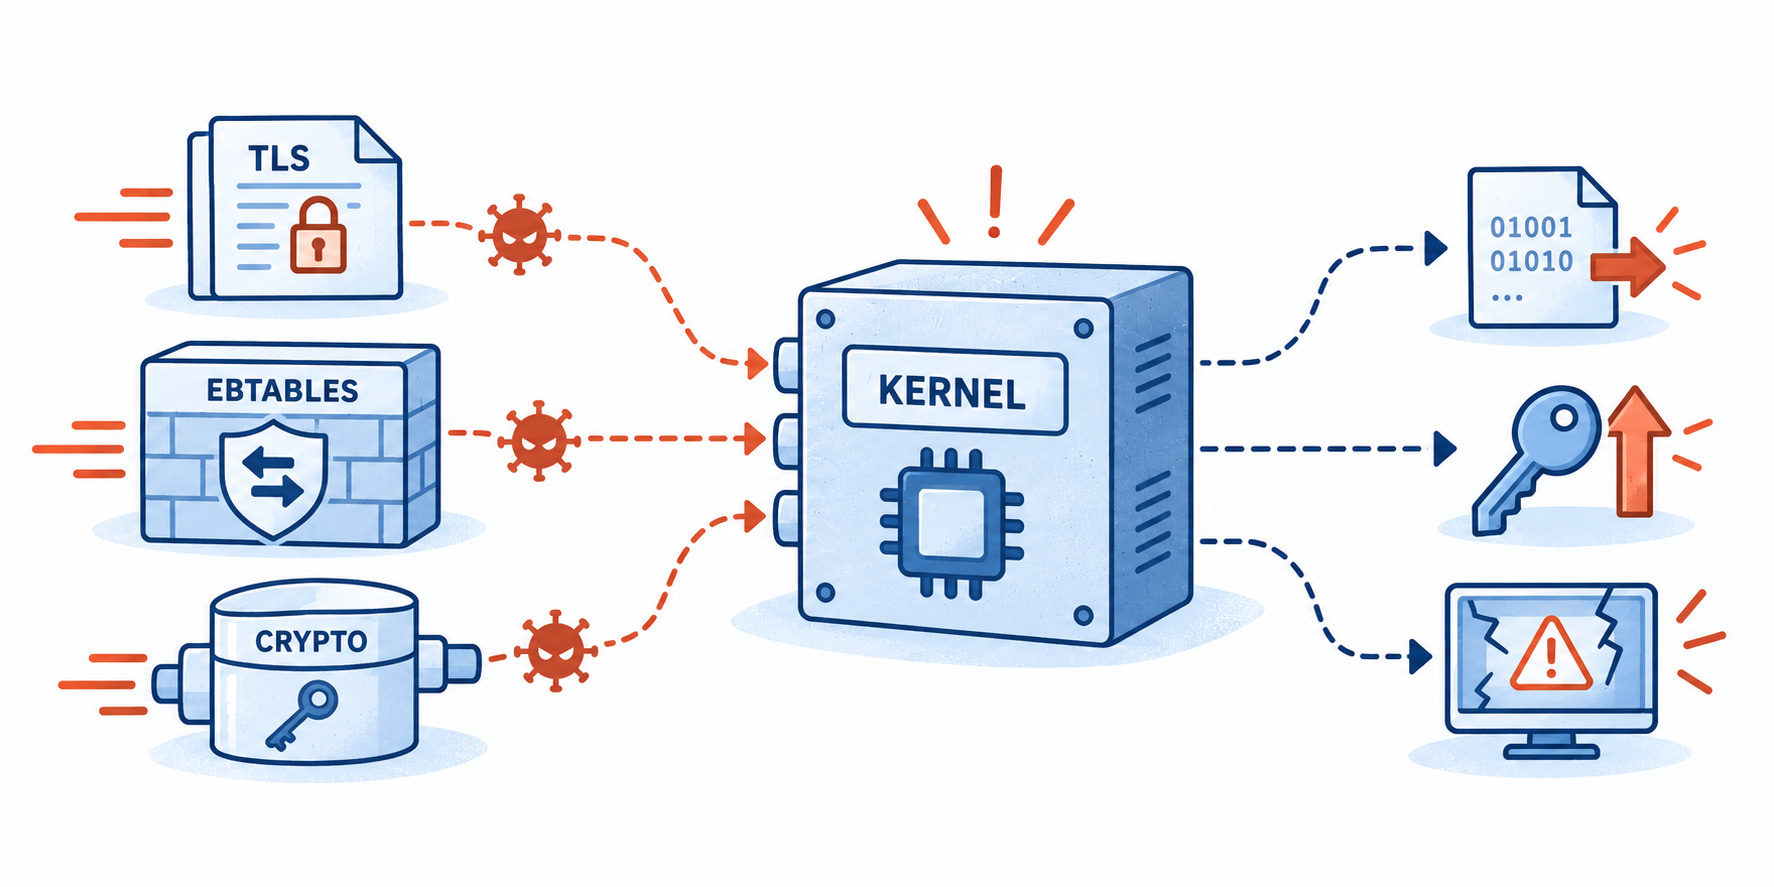
Tres fallos del kernel de Linux pasaron de la cola de parches a prioridad por explotación activa
CISA añadió CVE-2025-39682, CVE-2026-53266 y CVE-2025-39964 a su catálogo de vulnerabilidades explotadas. Los fallos afectan a la ruta de recepción de TLS, al procesamiento SNAT de ebtables y a los sockets criptográficos AF_ALG, y permiten divulgación de memoria, escalada de privilegios, caídas o resultados criptográficos corruptos. La información pública no explica cómo los están usando los atacantes. Priorice las correcciones según las versiones del kernel y la exposición de las cargas de trabajo, no solo según las puntuaciones CVSS.
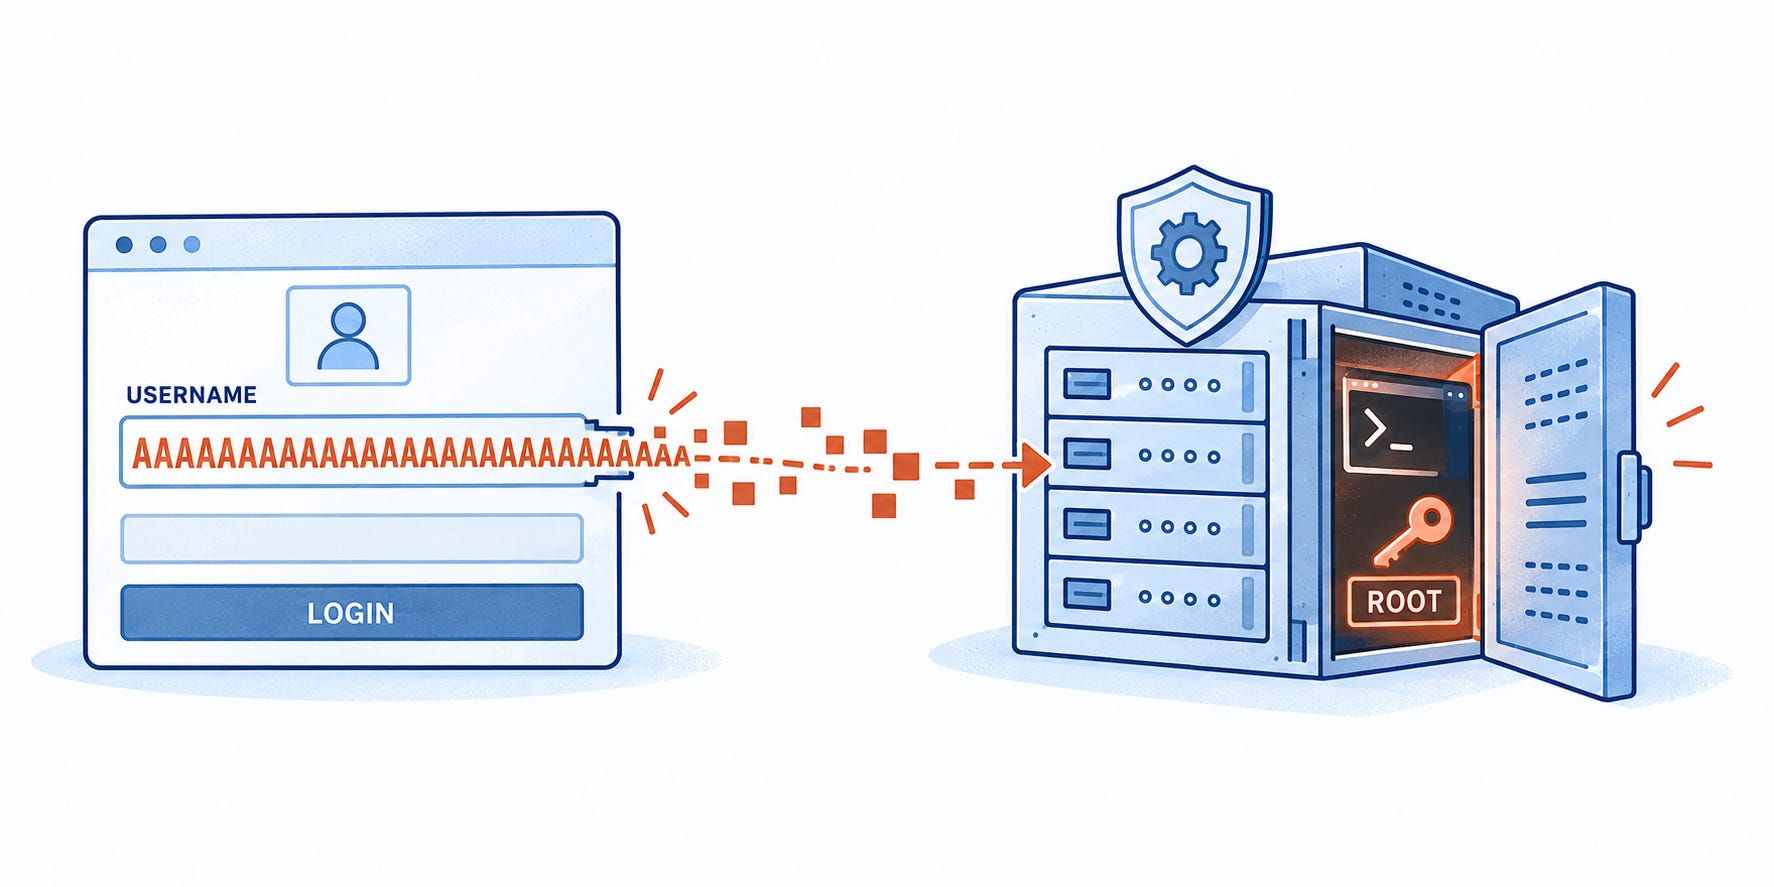
Un nombre de usuario sobredimensionado podría dar a los atacantes root en los servidores de gestión de Check Point
Check Point CVE-2026-91843, con una puntuación de 9.8, es un desbordamiento de búfer en la pila en el proceso de inicio de sesión sin autenticación. Su explotación exitosa podría ejecutar código arbitrario como root en los Security Management y Log Servers afectados. Check Point no informó de evidencias de explotación en entornos reales al publicar el aviso. Aplique LivePatch de inmediato y restrinja el acceso de administración a direcciones internas de confianza concretas.
🔎 Análisis a fondo
Cuando los hallazgos llegan con pruebas
La alerta dice crítico.
El código parece peligroso. La explicación es convincente. El escenario de ataque tiene sentido.
Entonces alguien hace la única pregunta que importa:
¿Puede activarlo?
Aquí es donde muchos hallazgos de seguridad empiezan a tambalearse.
Una función sospechosa no es automáticamente explotable. Una ruta de ataque verosímil puede derrumbarse al llegar al tiempo de ejecución. Incluso una explicación técnicamente correcta puede exagerar el impacto real.
El hallazgo parecía terminado. La investigación apenas había comenzado.
Durante años, la brecha entre lo posible y lo demostrado la han cubierto investigadores humanos. Recrean el entorno, rastrean el código relevante, construyen una entrada, observan qué ocurre, la revisan y vuelven a intentarlo.
A veces la vulnerabilidad se activa.
A veces tres horas de investigación terminan en nada más dramático que «no explotable en estas condiciones».
Muchas herramientas centradas en la detección se detienen antes de que empiece ese trabajo. Identifican la posibilidad y dejan la reproducción en manos de otra persona.
Los agentes de IA están empezando a cruzar esa línea.
El paso costoso empieza después de la detección
Los analizadores estáticos señalan patrones inseguros. Los escáneres de dependencias sacan a la luz paquetes vulnerables. Los modelos explican cómo podría fallar una ruta de código. Los sistemas de severidad asignan un número al resultado.
Estas salidas son útiles, pero aún pueden ser meras hipótesis.
Alguien tiene que determinar si una entrada no confiable puede llegar al código, si la condición sospechada puede darse y si el comportamiento resultante tiene un impacto de seguridad significativo.
El software rara vez se comporta exactamente como parece sobre el papel.
Una comprobación de validación en otro punto puede bloquear el ataque. La función vulnerable puede ser inalcanzable en la configuración desplegada. Puede producirse una caída, pero no por la razón que predijo el escáner.
Cuando se afirma que una vulnerabilidad puede activarse, la evidencia en tiempo de ejecución pesa más.
Una prueba de concepto funcional da al equipo algo concreto que ejecutar, inspeccionar y reproducir. Traslada la discusión de lo que el código parece capaz de hacer a lo que ocurre en condiciones definidas.
Sin puntos por sonar convincente
CyberGym se diseñó en torno a esa distinción.
Sus 1,507 tareas proceden de vulnerabilidades históricas de 188 proyectos de código abierto. En cada tarea, el agente recibe una descripción de la vulnerabilidad y una versión sin parchear de la base de código afectada.
Después tiene que reproducir el error.
Puede que el agente tenga que explorar un repositorio desconocido, localizar la ruta de ejecución relevante, compilar el proyecto, construir una entrada que desencadene el fallo, ejecutarla, inspeccionar el resultado y ajustar su enfoque.
No hay puntos por identificar el archivo correcto ni por producir una explicación segura de sí misma.
CyberGym ejecuta cada PoC enviada contra las versiones anterior y posterior al parche con sanitizers activados. Para tener éxito, la entrada debe provocar una caída detectada por el sanitizer antes del parche y no producir ninguna después.
En una evaluación de CyberGym en curso, Neutron generó PoC exitosas para 1,458 de las 1,507 tareas, alcanzando el 96.7%.
El porcentaje llama la atención. Lo más importante es lo que hay debajo:
1,458 PoC que reprodujeron la vulnerabilidad objetivo con comprobaciones basadas en la ejecución, no 1,458 predicciones.
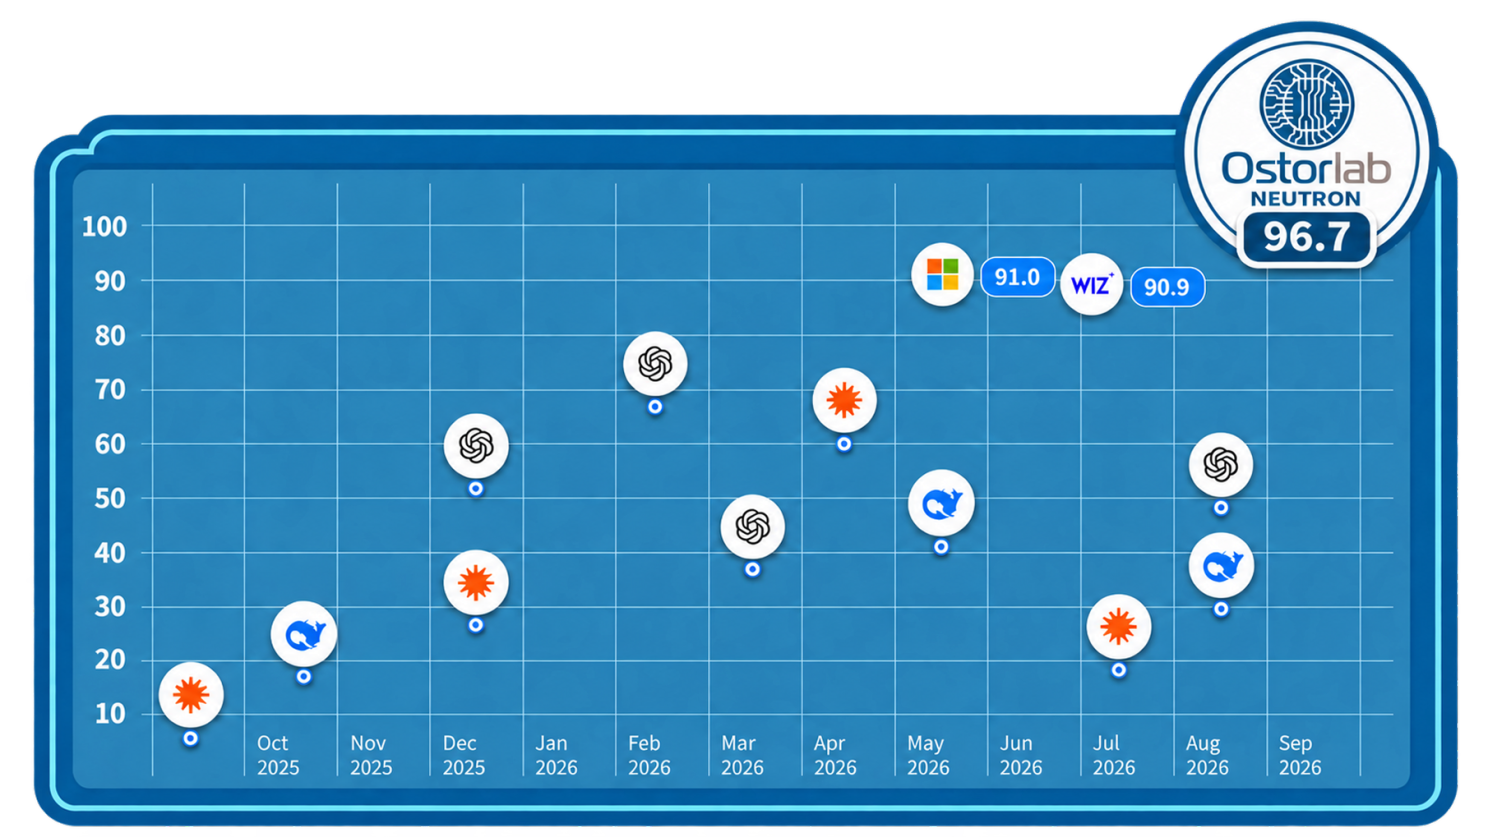
Cada tarea exitosa exigió que el sistema fuera más allá del análisis e interactuara con el software hasta producir evidencia observable.
Ese es el cambio que merece la pena vigilar.
El primer intento rara vez es la prueba
Un modelo de lenguaje puede leer una función vulnerable y producir una explicación excelente. Puede reconocer patrones de debilidad conocidos, rastrear datos a través del código y sugerir una entrada que podría activar el fallo.
Pero el primer intento puede no funcionar.
El proyecto no compila. La entrada nunca llega a la rama prevista. Un flag ausente cambia la ruta de ejecución. El programa termina con normalidad.
Una respuesta generada se detiene ahí.
Un sistema agéntico puede tratar el fallo como información nueva.
Puede leer el error de compilación, inspeccionar otra parte del repositorio, modificar la entrada, volver a ejecutar el programa y comparar el resultado. Si la evidencia no respalda la teoría original, puede cambiar de rumbo.
El valor no está en acertar todo al primer intento. Está en permanecer dentro del bucle de investigación:
inspeccionar → intentar → ejecutar → observar → revisar → verificar
Ese bucle convierte el razonamiento del modelo en investigación de vulnerabilidades práctica.
El modelo es solo una parte. El sistema que lo rodea aporta las herramientas, el entorno de ejecución, el contexto retenido, la estrategia de reintentos y los controles de verificación necesarios para que la investigación siga avanzando.
Sin esas piezas, el mismo modelo puede explicar cómo debería funcionar una PoC sin demostrar nunca que funciona.
Cuando la reproducción se convierte en descubrimiento
CyberGym evalúa principalmente a los agentes frente a vulnerabilidades conocidas. Sin embargo, la última versión de la investigación muestra que la reproducción puede llevar a un lugar inesperado.
Durante el trabajo de reproducción, los agentes descubrieron 10 zero-days y 17 parches históricos inadecuados. Las entradas generadas activaron vulnerabilidades desconocidas hasta entonces o revelaron que las correcciones anteriores no habían eliminado por completo el comportamiento vulnerable.
Los investigadores realizaron después una evaluación de descubrimiento abierta e independiente en 431 proyectos de código abierto, en la que identificaron 25 zero-days adicionales. Tras la deduplicación, el artículo informa de 34 zero-days en total.
El código cambia. Un patrón vulnerable puede sobrevivir de otra forma. Una corrección puede cerrar una ruta y dejar alcanzable una condición relacionada. Una entrada diseñada para un error antiguo puede llevar una versión más reciente a un comportamiento que nadie esperaba.
Si se ejecuta ese proceso en suficientes proyectos, versiones y entradas, la validación empieza a desbordarse hacia el descubrimiento.
Una investigación no necesita empezar con un gran avance. Un agente puede seguir los fallos previos, probar variaciones y llegar más lejos de lo que permitiría normalmente el tiempo limitado de una persona.
La escala pasa a formar parte del método de investigación.
La prueba traslada el cuello de botella aguas abajo
Una PoC reproducible da a investigadores y desarrolladores un punto de referencia compartido.
El investigador puede inspeccionar el comportamiento exacto. El desarrollador puede ejecutar la misma entrada antes y después de un cambio. El equipo de seguridad puede confirmar qué versiones están afectadas. La corrección final puede probarse contra la evidencia usada para establecer la vulnerabilidad.
Sin ese punto de referencia, cada equipo puede interpretar el hallazgo de forma distinta.
El investigador ve una corrupción de memoria alcanzable. El desarrollador ve una entrada inusual que nunca debería producirse. El directivo ve una puntuación crítica. El responsable de producto ve un lanzamiento retrasado.
La evidencia ejecutable reduce ese desacuerdo.
Pero una reproducción más rápida no crea un backlog vacío. Mueve la cola.
Cada PoC exitosa sigue necesitando ser comprendida. Los equipos deben confirmar el impacto, identificar los sistemas afectados, priorizar la respuesta, desarrollar una corrección segura y verificar que el comportamiento original ya no se produce.
A medida que se acelera la reproducción, los defensores pueden tener menos tiempo para corregir las vulnerabilidades divulgadas antes de que aparezcan exploits funcionales.
El recurso escaso pasa de producir la primera prueba a actuar sobre ella con rapidez y acierto.
El hallazgo es solo el principio
La investigación de vulnerabilidades con IA no se definirá solo por cuántos problemas puede nombrar un sistema.
El cambio más importante es cuántos hallazgos llegan con algo que se ejecuta, reproduce el comportamiento y supera la inspección.
La ejecución de Neutron en CyberGym ofrece evidencia de esa transición. La generación de pruebas ya puede repetirse en cientos de bases de código reales, convirtiendo un paso de investigación que exigía mucho tiempo en algo que un agente puede realizar repetidamente a escala.
Eso cambia el estándar de lo que es un resultado de seguridad útil.
Una puntuación de severidad pasa a ser la afirmación inicial, no la conclusión. «El código parece vulnerable» ya no basta cuando se le puede pedir a un sistema que demuestre exactamente cómo falla.
Las herramientas de seguridad de nueva generación no se limitan a decirnos dónde mirar. Nos muestran qué falla.
🎣 ¿Es phishing?
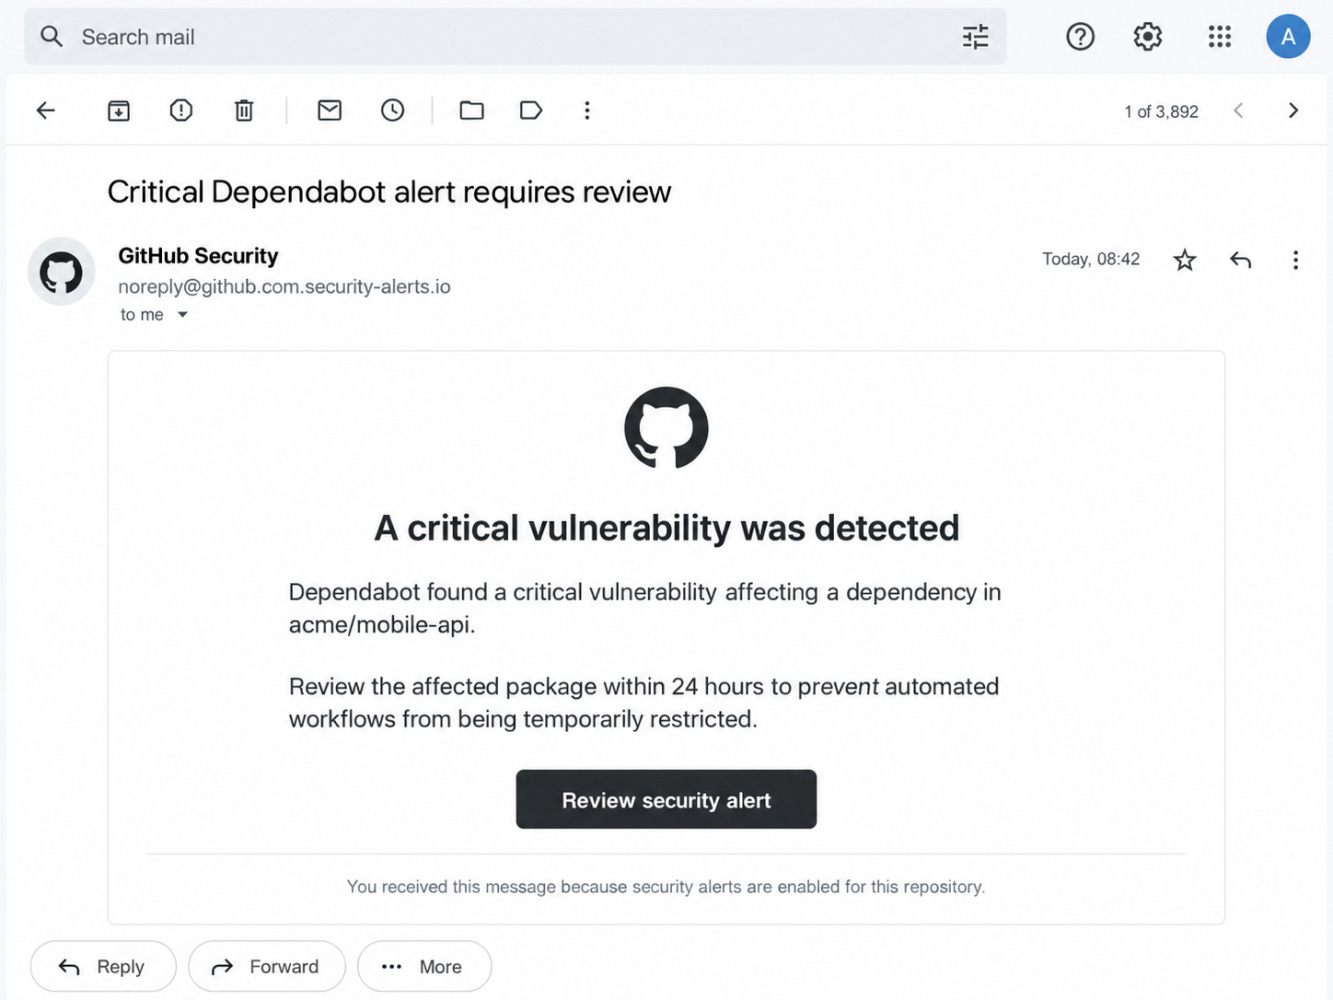
¿Alerta legítima de GitHub o phishing cuidadosamente disfrazado? Examínela con atención antes de decidir.
🔬 Investigación técnica
La extensión no podía leer el archivo. El agente sí.
Una extensión de navegador quiere leer un archivo local.
El navegador se niega. La extensión no tiene permiso.
Pero el asistente de IA del navegador sí lo tiene.
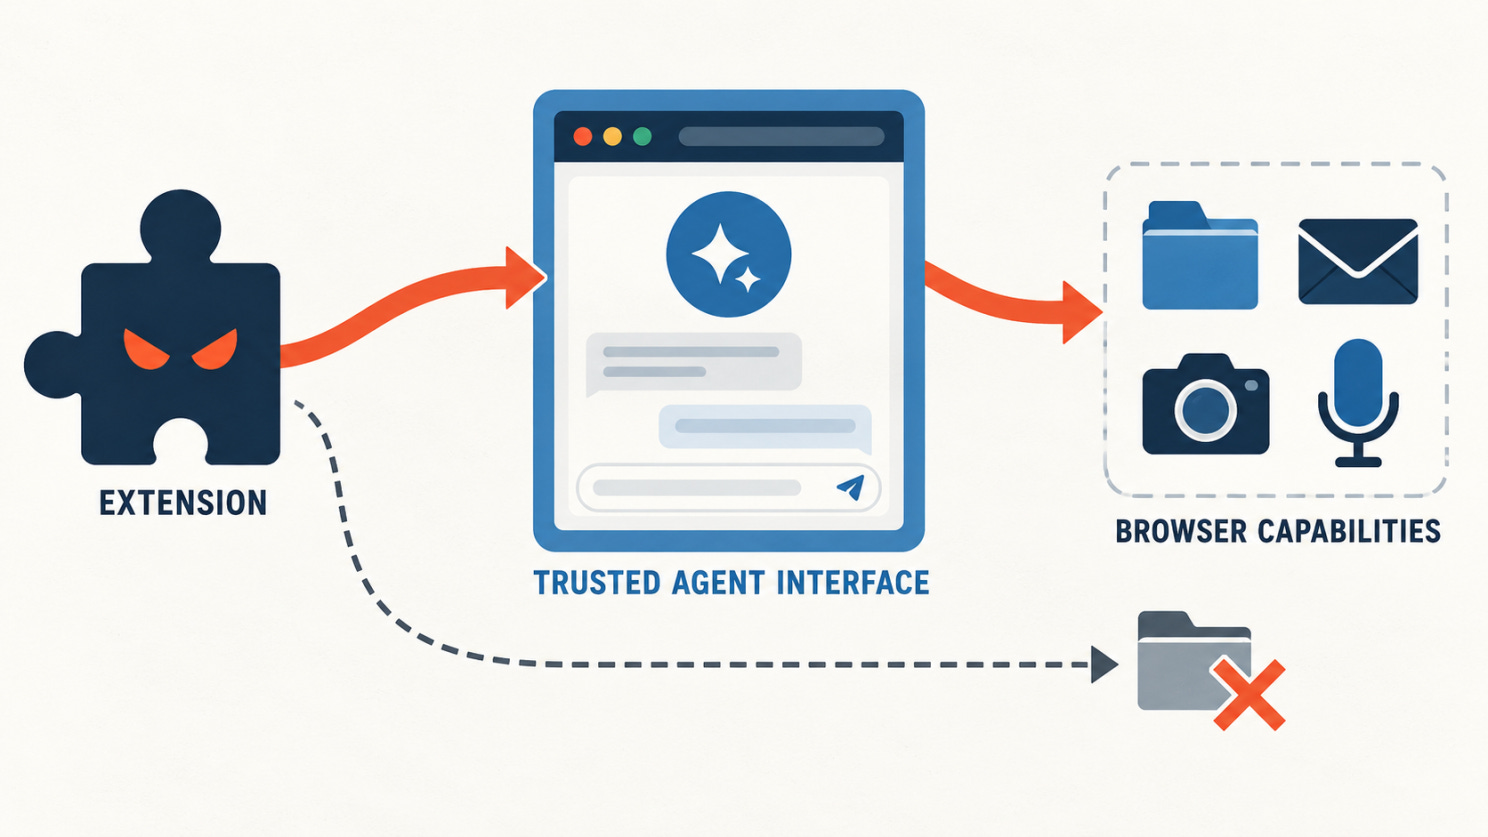
En lugar de acceder directamente al archivo, la extensión llega a la interfaz de confianza que gobierna al asistente. El componente privilegiado del navegador recupera el archivo, captura su contenido y devuelve el resultado.
Esa fue la técnica central de BragJack, un conjunto de ataques demostrados contra Gemini Live en Chrome, Perplexity Comet, Microsoft Edge Actions, Opera Neon y Claude in Chrome.
Los investigadores usaron un mismo framework de extensión en las cinco implementaciones, pero no descubrieron una única vulnerabilidad universal. Cada producto exponía un camino distinto desde el código controlado por la extensión hasta una interfaz en la que confiaba su agente de navegador.
Una vez cruzada esa frontera, las capacidades del agente pasaban a ser las capacidades del atacante.
El ataque comienza con una extensión
BragJack requiere que se instale una extensión maliciosa o comprometida con los permisos necesarios. No es un ataque drive-by que cualquier sitio web pueda lanzar contra un navegador no afectado.
El framework de extensión compartido se apoyaba principalmente en el acceso amplio a sitios web HTTPS y en el permiso declarativeNetRequest, comúnmente abreviado como DNR. Las rutas de Edge y Claude requerían además el permiso debugger, más potente.
DNR permite a una extensión definir reglas que modifican cómo el navegador gestiona las solicitudes de red. En las demostraciones, los investigadores lo usaron con dos fines:
Eliminar o debilitar cabeceras de seguridad como Content Security Policy.
Redirigir una solicitud de JavaScript de un recurso de confianza hacia código controlado por el atacante.
Los investigadores llaman a la técnica combinada DiNneR Serving.
Una página protegida solicita un script legítimo. La extensión intercepta esa solicitud, cambia las cabeceras de seguridad de la página y sustituye el script por uno malicioso. Como el navegador carga el reemplazo dentro de la página de confianza, el código del atacante hereda el acceso a interfaces a las que una extensión corriente no puede llegar directamente.
La extensión permanece fuera de la frontera protegida.
Su código, no.
De la interfaz de Gemini a los privilegios de Chrome
La implementación de Gemini Live en Chrome separaba el asistente de IA en dos componentes.
El componente privilegiado, alojado en chrome://glic, podía interactuar con capacidades del nivel del navegador. La aplicación web de Gemini en gemini.google.com gestionaba la interfaz del asistente y se comunicaba con ese componente.
Chrome impedía que las extensiones adjuntaran scripts, depuradores o reglas de solicitud directamente a la página interna chrome://glic. Esas protecciones cubrían también la mayoría de las interacciones con la aplicación de Gemini incrustada.
Pero seguía abierto un camino: las reglas DNR aún podían afectar a las solicitudes de red realizadas por la página HTTPS incrustada dentro de la interfaz privilegiada.
Los investigadores aprovecharon esa brecha para interceptar un recurso JavaScript solicitado por gemini.google.com. Su extensión eliminaba o modificaba las cabeceras que habrían bloqueado el reemplazo y luego redirigía la solicitud a un script controlado por el atacante.
Ese script se ejecutaba bajo el origen de confianza de Gemini mientras estaba incrustado dentro de chrome://glic.
A partir de ahí, el ataque ya no necesitaba manipular el modelo mediante un prompt. El código inyectado podía comunicarse directamente con el componente privilegiado del navegador y emitir los comandos que el propio Gemini usaba normalmente.
Los investigadores demostraron comandos que podían abrir URL, solicitar el contenido de la pestaña activa y devolver texto, datos PDF o capturas de pantalla. Como Chrome aceptaba URL file://, la misma interfaz podía exponer archivos y carpetas locales. Otro comando devolvía información del perfil del navegador con la sesión iniciada.
Los investigadores también informaron de que el proceso de Gemini comprometido heredaba el acceso a la cámara y al micrófono porque esos permisos estaban disponibles para admitir la entrada de audio y vídeo. Esto abría la posibilidad de grabar sin mostrar un nuevo aviso de consentimiento.
Google registró el problema de fondo como CVE-2026-0628, con severidad alta.
Una extensión, cinco fallos de confianza
Los demás ataques llegaban a interfaces privilegiadas similares mediante distintos errores de implementación.
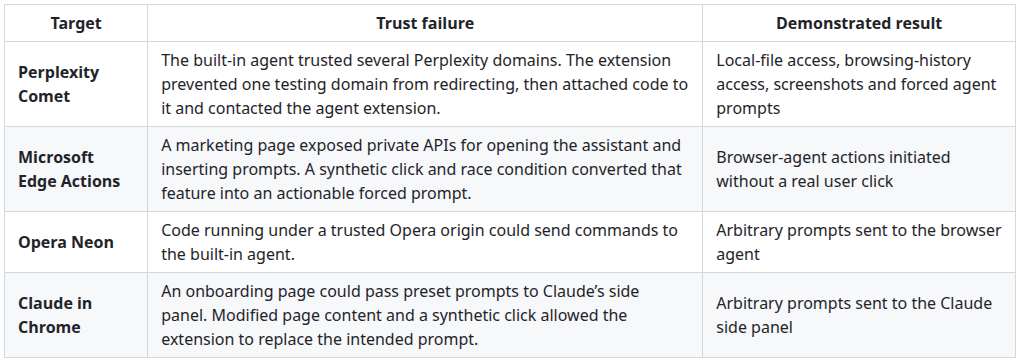
En la demostración de Comet, el atacante podía ordenar al agente que buscara correos recientes, los resumiera y enviara el resultado a otro lugar, dejando que el agente se encargara de la navegación y las acciones individuales.
Las demostraciones de Edge y Claude usaron el permiso debugger de la extensión para sintetizar el clic de confianza que exigían sus interfaces. Ese requisito previo importa: estas rutas dependían de un permiso capaz de instrumentar pestañas del navegador, no solo de la inyección de contenido corriente.
Microsoft asignó CVE-2026-55945 a la condición de carrera de Edge.
Zero-click, tras la instalación
Las demostraciones no requirieron ningún clic adicional una vez presentes la extensión maliciosa y sus permisos necesarios.
Eso las hace zero-click en la fase de explotación, pero no libres de instalación. Un atacante aún tendría que publicar una extensión maliciosa, comprometer una existente o convencer de otro modo a la víctima para que la instale.
Una vez establecido ese punto de apoyo, la extensión podía alcanzar capacidades que iban más allá de las sugeridas por su conjunto de permisos directo.
Esto es lo que hizo inusual a BragJack. La extensión no siempre robaba los datos por sí misma. Estaba cruzando hacia una interfaz de agente que ya tenía permiso para ver, capturar o manipular más de lo que podía la extensión.
El navegador imponía una frontera alrededor de la extensión y otra alrededor del agente. Los ataques encontraron lugares donde la confianza pasaba de una a otra sin la verificación suficiente.
En las cinco divulgaciones, los investigadores recibieron $20,000 en recompensas de bug bounty y se asignaron dos CVE. Se notificó a los proveedores afectados y se corrigieron las rutas comunicadas.
La lección de BragJack es visible en la mecánica: proteger el modelo no basta cuando código no confiable puede llegar al canal que gobierna sus herramientas.
La extensión no necesitó ser más lista que el agente. Solo necesitó acceso a sus permisos
🛠️ Herramienta de la semana
herdr
El centro de mando de sus agentes de programación
Ejecutar un agente de programación es sencillo. Ejecutar varios se convierte enseguida en arqueología de terminales: ¿cuál sigue trabajando? ¿Cuál ha fallado? ¿Cuál lleva diez minutos esperando una respuesta?
herdr es un entorno de ejecución de terminal de código abierto creado para facilitarlo. Mantiene los terminales de los agentes en marcha mediante un servidor en segundo plano cuando se desconecta o se pierde una conexión SSH, de modo que cerrar el cliente no detiene el trabajo.
Cada panel se etiqueta como working, blocked o idle, lo que facilita encontrar el agente que realmente necesita atención. Las sesiones locales y las máquinas remotas guardadas también pueden aparecer en una sola ventana, con reconexiones independientes.
Herdr funciona con los agentes de programación que los desarrolladores ya usan, como Codex, Claude Code, Cursor, OpenCode y Grok. No los envuelve ni los sustituye. Gestiona los terminales en los que se ejecutan.
La herramienta también es nativa para agentes. A través de su CLI y su API de socket, los agentes pueden crear paneles, enviarse prompts entre sí y esperar hasta que otro agente esté realmente bloqueado antes de intervenir.
Distribuido como un único binario de Rust y sin capa de Electron, herdr es una opción útil para quien tenga un flujo de programación que empiece a implicar más agentes de los que las pestañas de terminal pueden manejar con comodidad.
👏 Persona de la semana
Daniel Miessler
La ciberseguridad avanza rápido. La IA, aún más. Entender qué ocurre cuando ambas colisionan se está convirtiendo en una disciplina por derecho propio.
Daniel Miessler ha dedicado buena parte de su carrera a dar sentido a esa intersección.
Daniel es investigador, escritor y fundador en ciberseguridad e IA que publica trabajo técnico en línea desde 1999. A lo largo de más de dos décadas en seguridad, ha trabajado en seguridad de aplicaciones, gestión de vulnerabilidades y liderazgo de seguridad en empresas como Apple, Robinhood, IOActive y HP.
Su trabajo de código abierto incluye SecLists, una colección muy utilizada de payloads de prueba, nombres de usuario, contraseñas, web shells y datos de fuzzing que se incluye en Kali Linux desde 2018.
Más recientemente, creó Fabric, un framework de código abierto diseñado para ayudar a las personas a aplicar la IA a problemas concretos mediante patrones reutilizables.
A través de Unsupervised Learning, su boletín, pódcast e investigación pública, Daniel sigue examinando cómo la IA está cambiando la ciberseguridad, el trabajo y la capacidad humana, sin reducir la conversación ni al entusiasmo ni al miedo.
Por ayudar a los profesionales de la seguridad a entender qué cambia la IA, qué no y qué merece una atención más detenida, Daniel Miessler es nuestra Persona de la semana.
📅 Evento de la semana
AMLUCS 2026
📍 Londres, Reino Unido · 23 y 24 de septiembre
¿Qué ocurre cuando aquello que usted defiende también puede razonar, usar herramientas y emprender acciones?
Ese es el territorio que explora AMLUCS 2026 . La conferencia de dos días se centra específicamente en la intersección práctica entre la IA y la ciberseguridad, y el programa de este año abarca amenazas agénticas, IA ofensiva y defensiva, seguridad multiagente, red teaming de IA y protección de sistemas de IA en producción.
Una sesión que nos llamó la atención: «The Agent’s Inner Monologue», un taller práctico que explora si monitorizar la traza de razonamiento de un agente puede dejar al descubierto compromisos que los controles tradicionales de entrada/salida pasan por alto.
Merece la pena seguirlo si: le interesa cómo cambia la seguridad cuando la IA pasa de responder preguntas a hacer cosas de verdad.
📚 Libro de la semana
Bug Bounty Bootcamp
Encontrar un error es emocionante. Explicarlo lo bastante bien como para que otra persona lo reproduzca es una habilidad distinta.
En Bug Bounty Bootcamp, Vickie Li cubre todo el proceso de caza de errores, desde el reconocimiento y la prueba de vulnerabilidades web comunes hasta el encadenamiento de hallazgos, el uso de Burp Suite y la redacción de informes sobre los que los equipos puedan actuar.
Es práctico, accesible y especialmente útil para quien esté aprendiendo a convertir un comportamiento sospechoso en un hallazgo de seguridad claro y reproducible.
😅 El meme
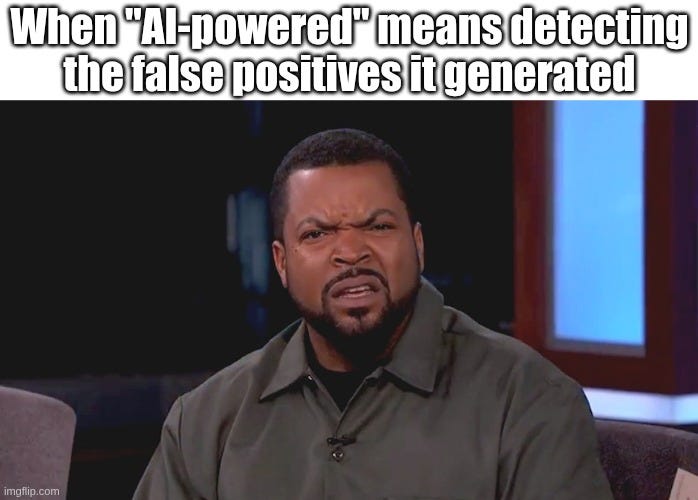
Si un modelo de menor coste alcanza el mismo resultado de seguridad validado, ¿por qué está pagando realmente un extra?
The Breach Brief, Equipo de Ostorlab