セキュリティツールは長年、同じセットメニューを出し続けてきました。クリティカルのラベル、疑わしいコードパス、そしてサイドメニューに最悪の場合の影響です。
概念実証(PoC)は、いつも別売りでした。
その実証を作るには、環境を再構築し、脆弱な経路をたどり、入力を作り、失敗するのを見届けて、もう一度試す必要がありました。検出は数秒で済むこともあります。しかし、脆弱性が実際にトリガーされることを示すには、何時間もかかることがありました。
AIエージェントが、その欠けていたステップを担い始めています。
今週のディープダイブでは、検出結果が実証とともに届くときに何が変わるのかを問います。エージェントが脆弱性の説明から、実行ベースのチェックのもとでの再現へとどう進むのか、なぜ失敗した試行もプロセスの一部なのか、そして再現を繰り返すことでまったく新しい欠陥が見つかることがあるのはなぜかを検証します。NeutronのCyberGymでの実行結果が具体例です。実世界の脆弱性に基づく1,507件のタスクで、1,458件のPoCに成功しました。
技術研究では、拡張機能はファイルを読めなかった。エージェントは読めた。と題して、BragJackを解き明かします。BragJackは、悪意のあるブラウザー拡張機能1つが5つのAIアシスタントの背後にある特権インターフェースに到達し、その権限を使ってファイル、メール、その他の機密リソースにアクセスできることを示した一連の攻撃です。
さらに、複数のコーディングエージェントを管理するターミナルランタイムherdrを紹介し、GitHubのセキュリティアラートを判定していただき、今週の最も重要なセキュリティニュースを解説し、最後に現場から届いた最新のミームで締めくくります。
この号の内容:
🌡️ 脅威レベル
⚡ ニュース
🔎 ディープダイブ:検出結果が実証とともに届くとき
🎣 これはフィッシング?
🔬 技術研究:拡張機能はファイルを読めなかった。エージェントは読めた。
🛠️ 今週のツール:hrdr
👏 今週の人物:Daniel Miessler
📅 今週のイベント:AMLUCS 2026
📚 今週の本:Bug Bounty Bootcamp
😅 今週のミーム
では、始めましょう。
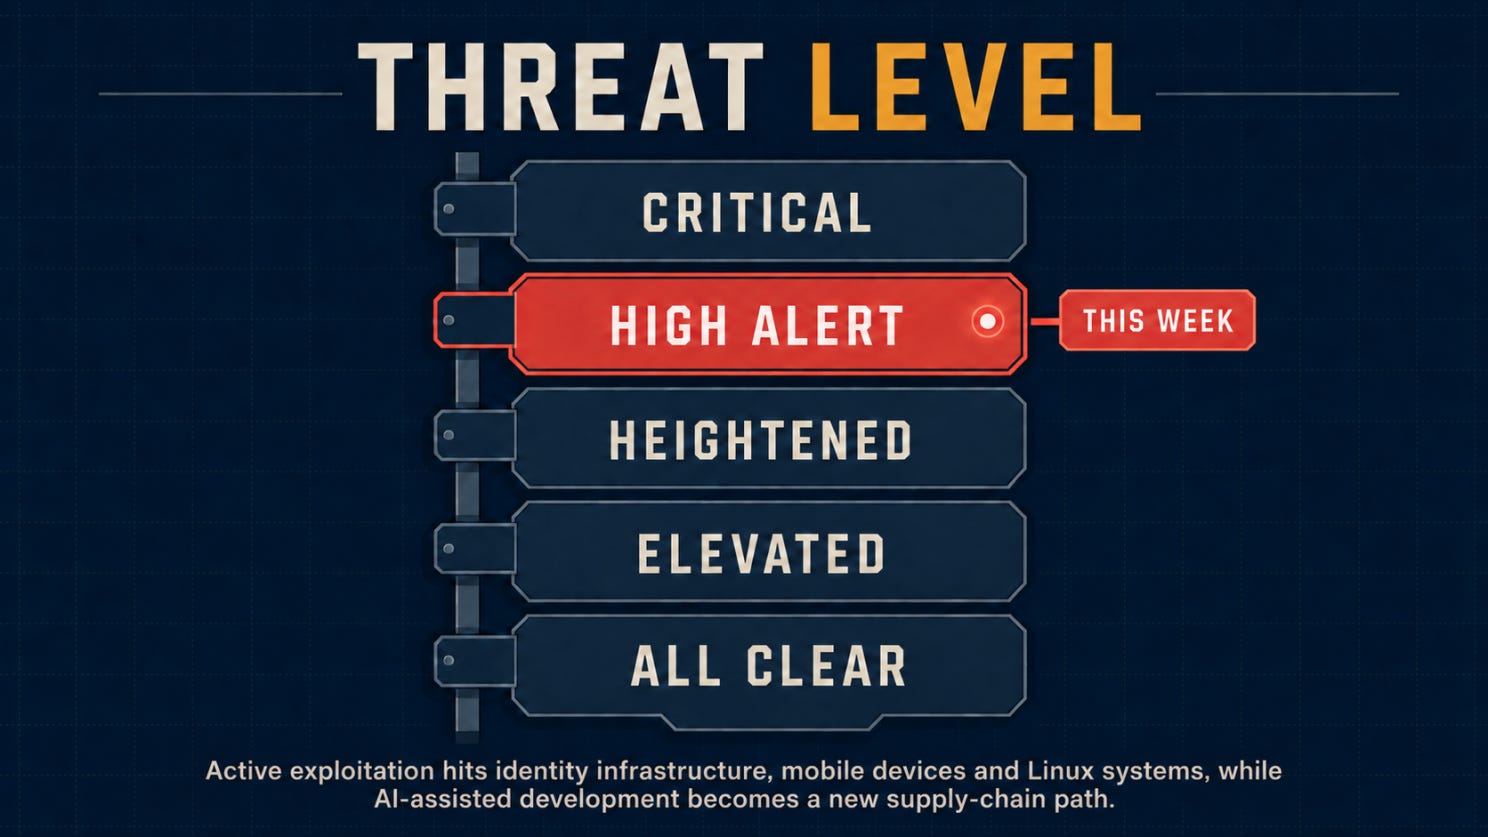
今週の話題に入る前に、現在の脅威レベルを確認しておきます。
🌡️脅威レベル
⚡ ニュース
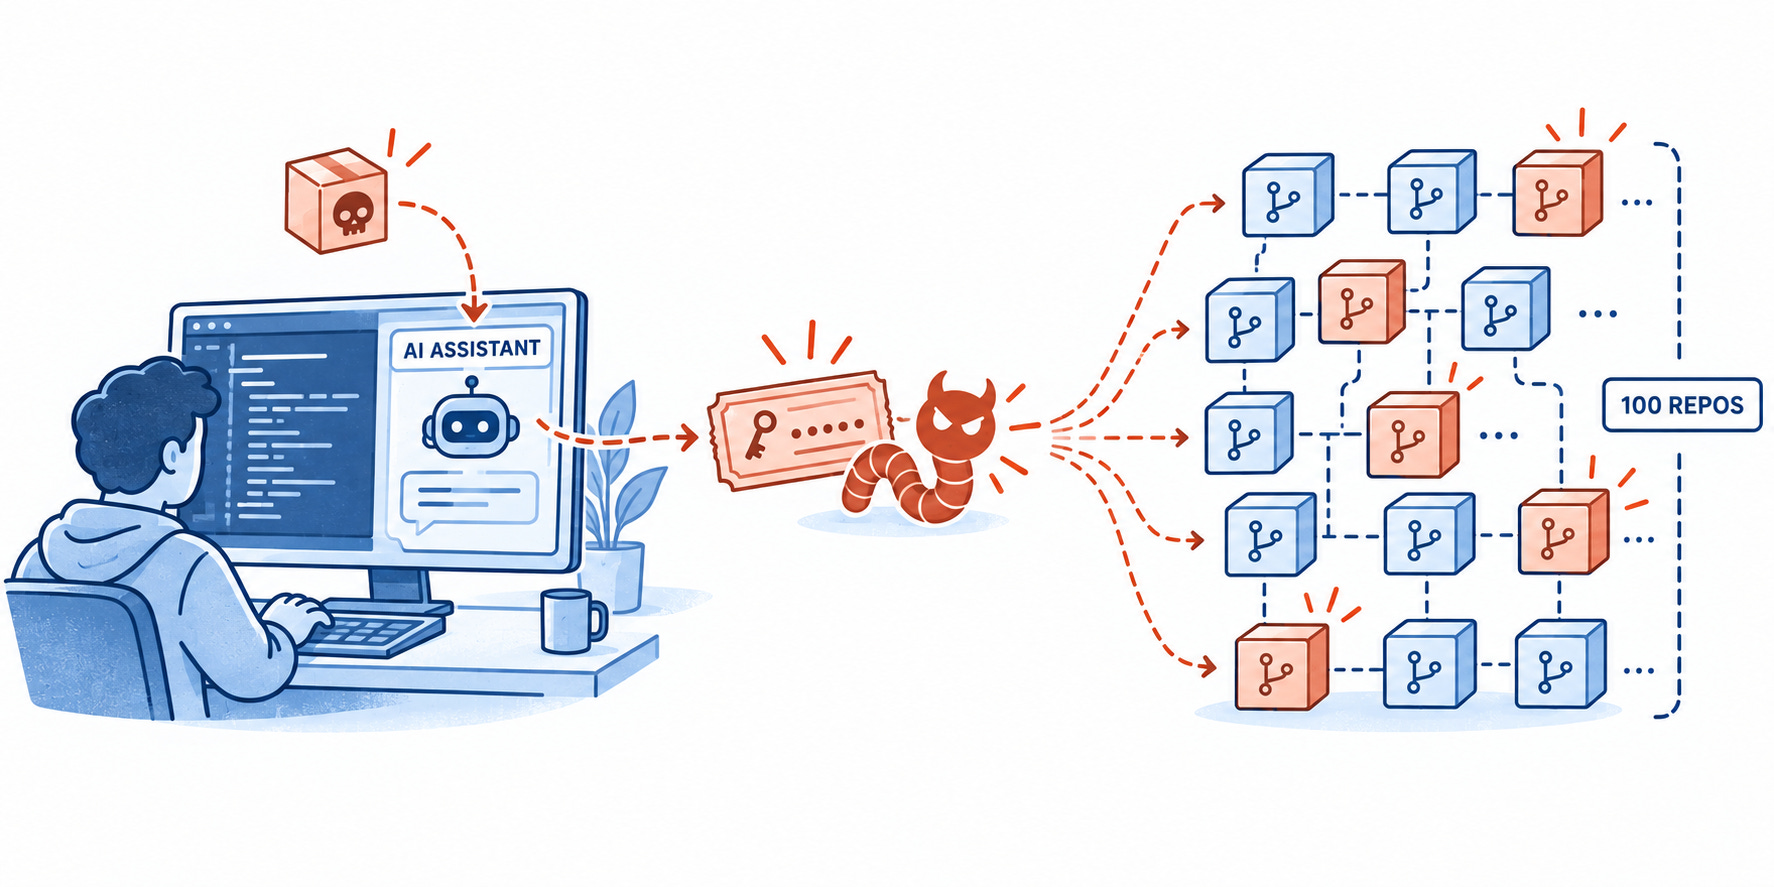
AIコーディングアシスタントが、100リポジトリに及ぶ侵害の最初の一歩に
Mandiantは、名前の明かされていないSaaSプロバイダーで、稼働中のコーディングアシスタントのセッションを乗っ取った攻撃者を調査しました。アシスタントが汚染された依存関係を推奨した後、インフォスティーラーがGitHubのOAuthトークンを収集し、Shai-Huludが約100の社内リポジトリに拡散して、シークレットとソースコードを盗み出しました。最初の侵害手法は明らかにされていません。AIが生成した依存関係の推奨は信頼できない入力として扱い、許可リストを強制し、開発者の認証情報を隔離してください。
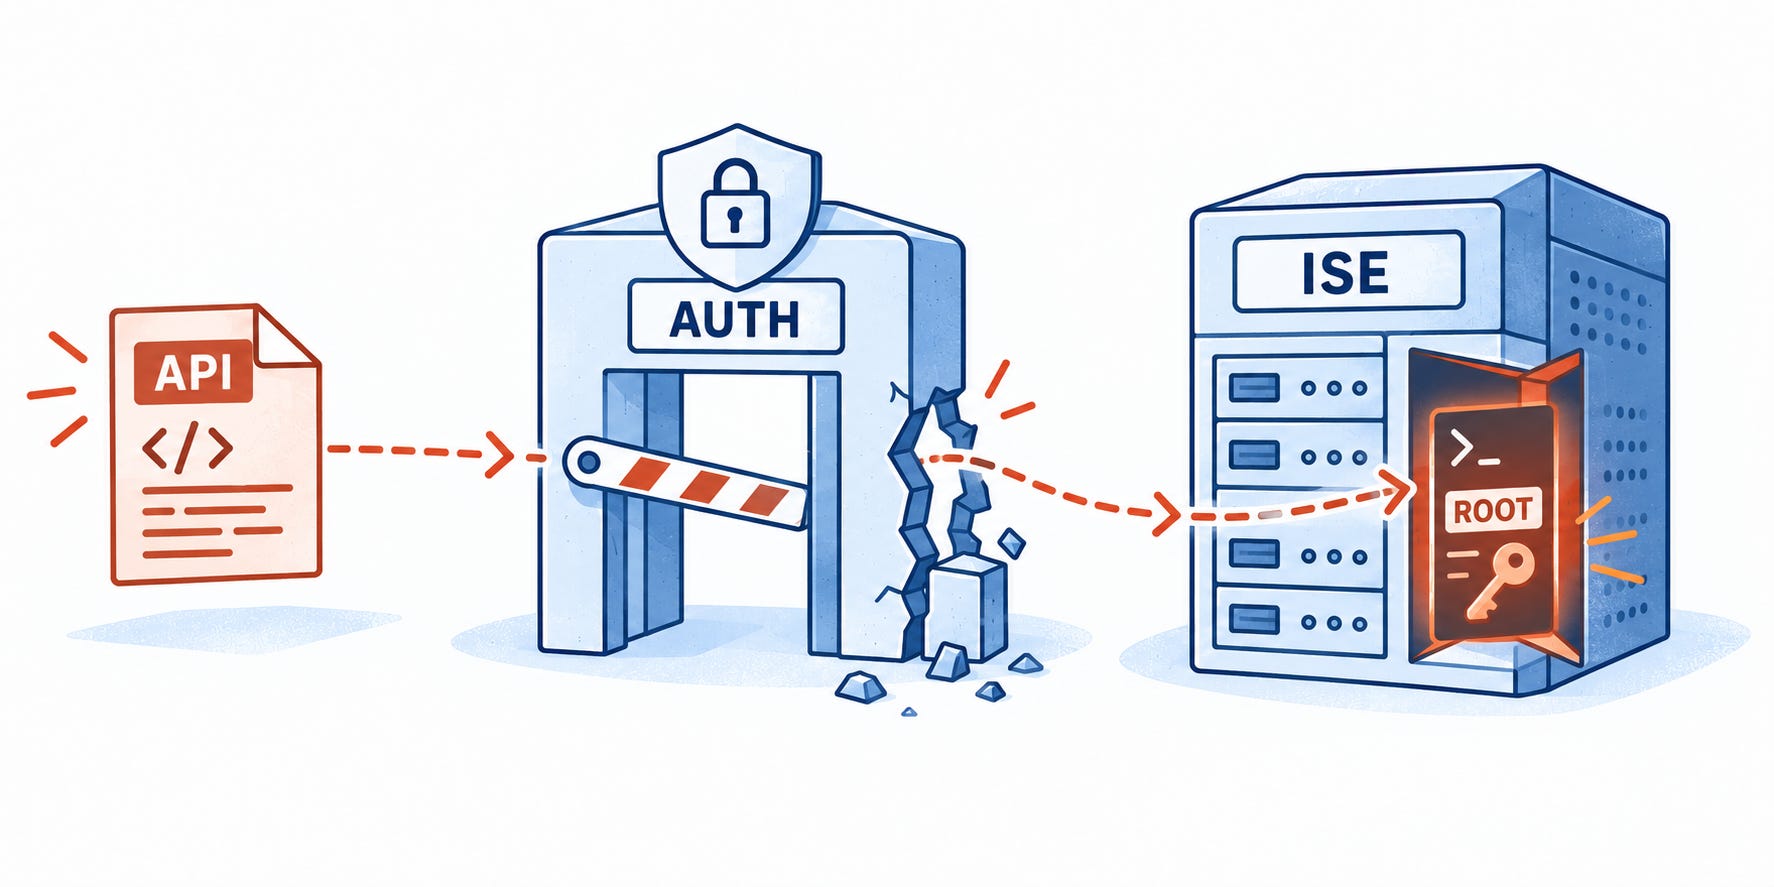
Ciscoのネットワークアクセスのゲートキーパーに、CVSS 10の認証バイパス
Cisco CVE-2026-76460により、認証されていないリモートの攻撃者がIdentity Services EngineのAPIをバイパスし、rootとしてコマンドを実行できる可能性があります。Ciscoは活発な悪用を確認し、ISEとISE-PICのすべての構成が影響を受けるとしたうえで、一時的なアクセス制限以外に完全な回避策は提供していません。直ちにパッチを適用し、すべてのノードのアクセスログに不審なユーザー名がないか調べ、侵害が疑われるシステムは再イメージ化してください。
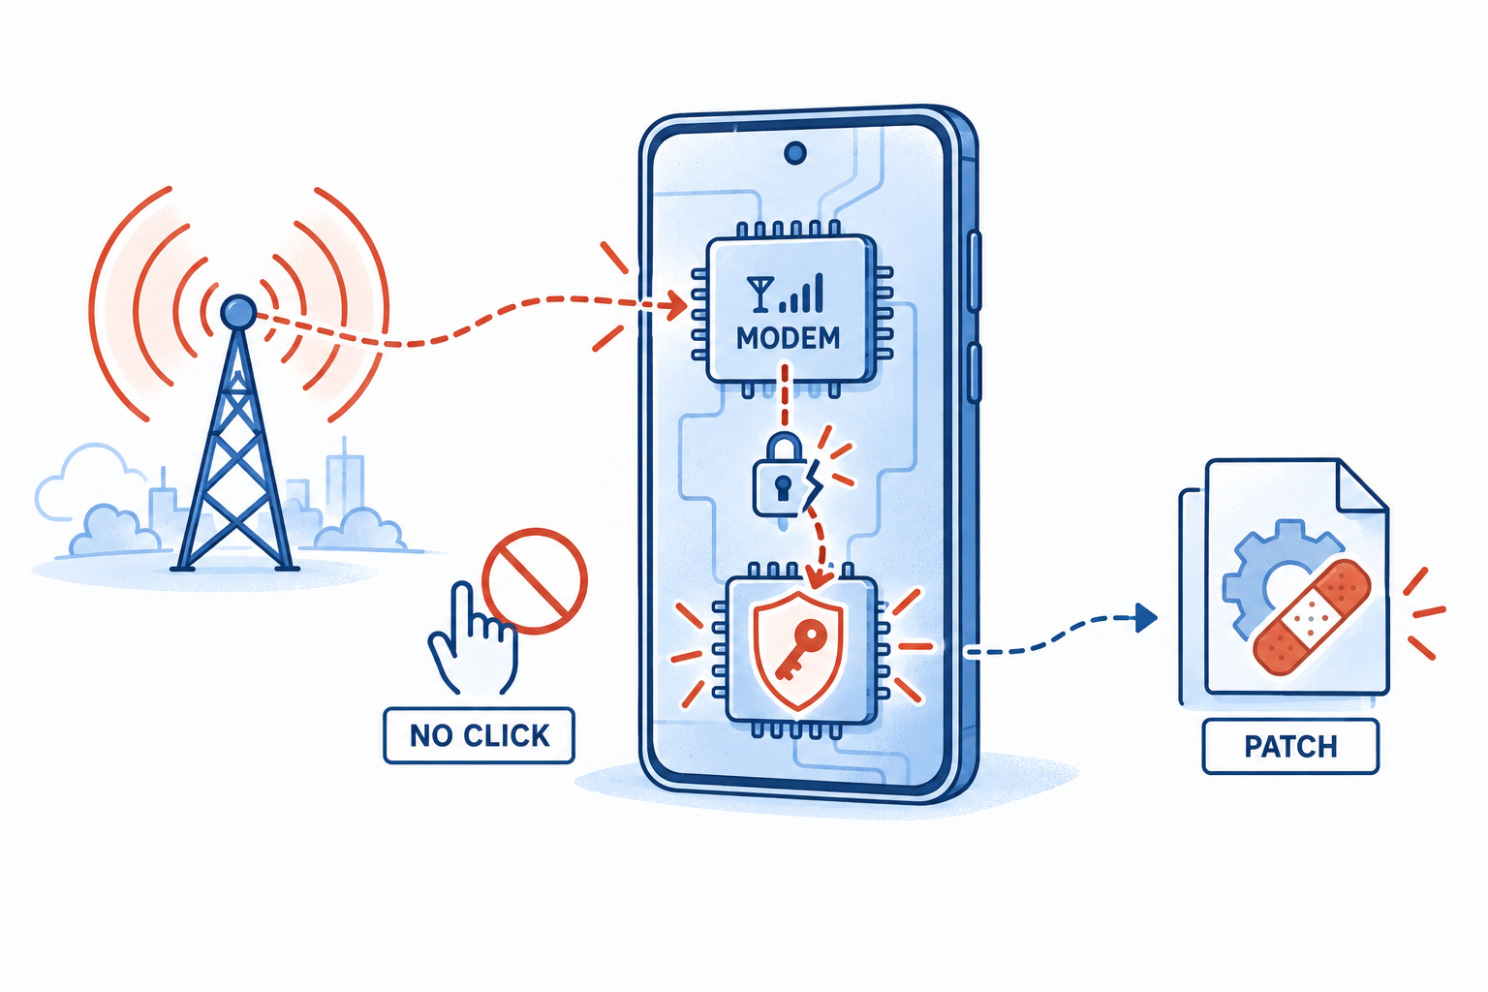
GoogleのPixelモデムのゼロデイは、タップもクリックもファイルを開く必要もない
Google CVE-2026-58704は、Pixelのセルラーモデムにおける権限チェックのロジックエラーに起因する、重大度の高い権限昇格の欠陥です。Googleは限定的かつ標的型の悪用の兆候を報告し、CISAはこの脆弱性をKnown Exploited Vulnerabilitiesカタログに追加しました。セキュリティパッチレベル2026-09-05以降でこの問題に対処しています。モバイル端末を管理する組織は、ユーザーが自発的に更新するのを当てにせず、MDMでパッチレベルを確認してください。
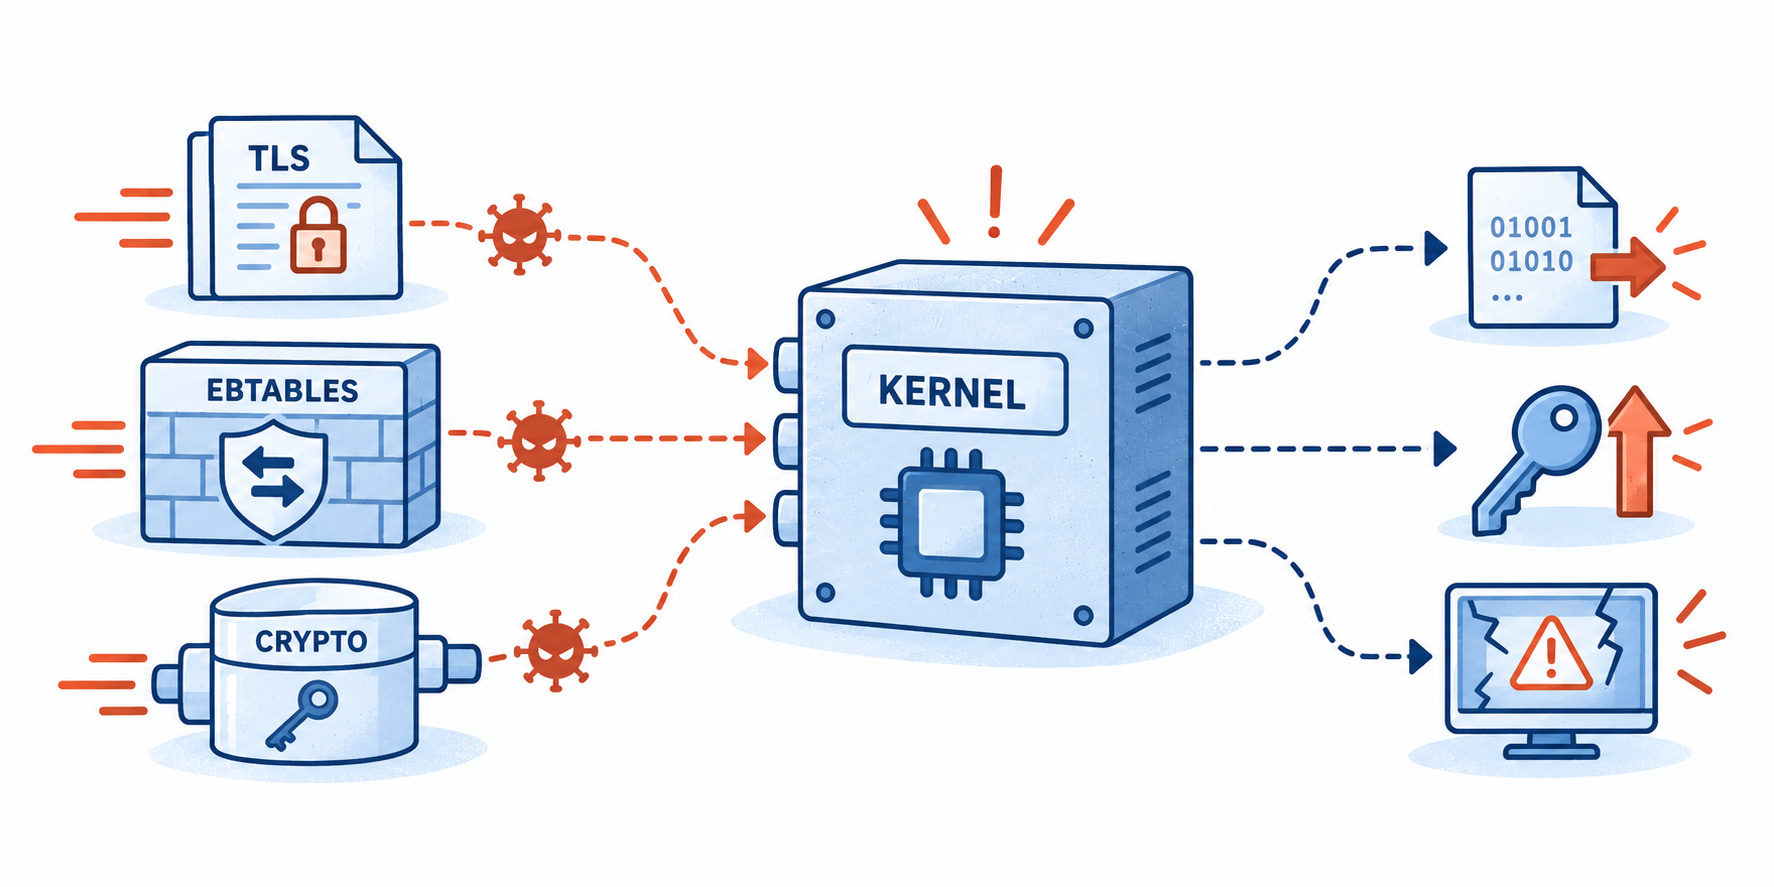
Linuxカーネルの3つの欠陥が、パッチ待ちから活発な悪用への対応優先へ
CISAはCVE-2025-39682、CVE-2026-53266、CVE-2025-39964を悪用された脆弱性のカタログに追加しました。これらの欠陥はTLSの受信経路、ebtablesのSNAT処理、AF_ALGの暗号ソケットに影響し、メモリの露出、権限昇格、クラッシュ、暗号処理結果の破損を引き起こします。攻撃者がどのように悪用しているかは、公開されている報道では説明されていません。CVSSスコアだけでなく、カーネルのバージョンとワークロードの露出度に基づいて修正の優先順位を付けてください。
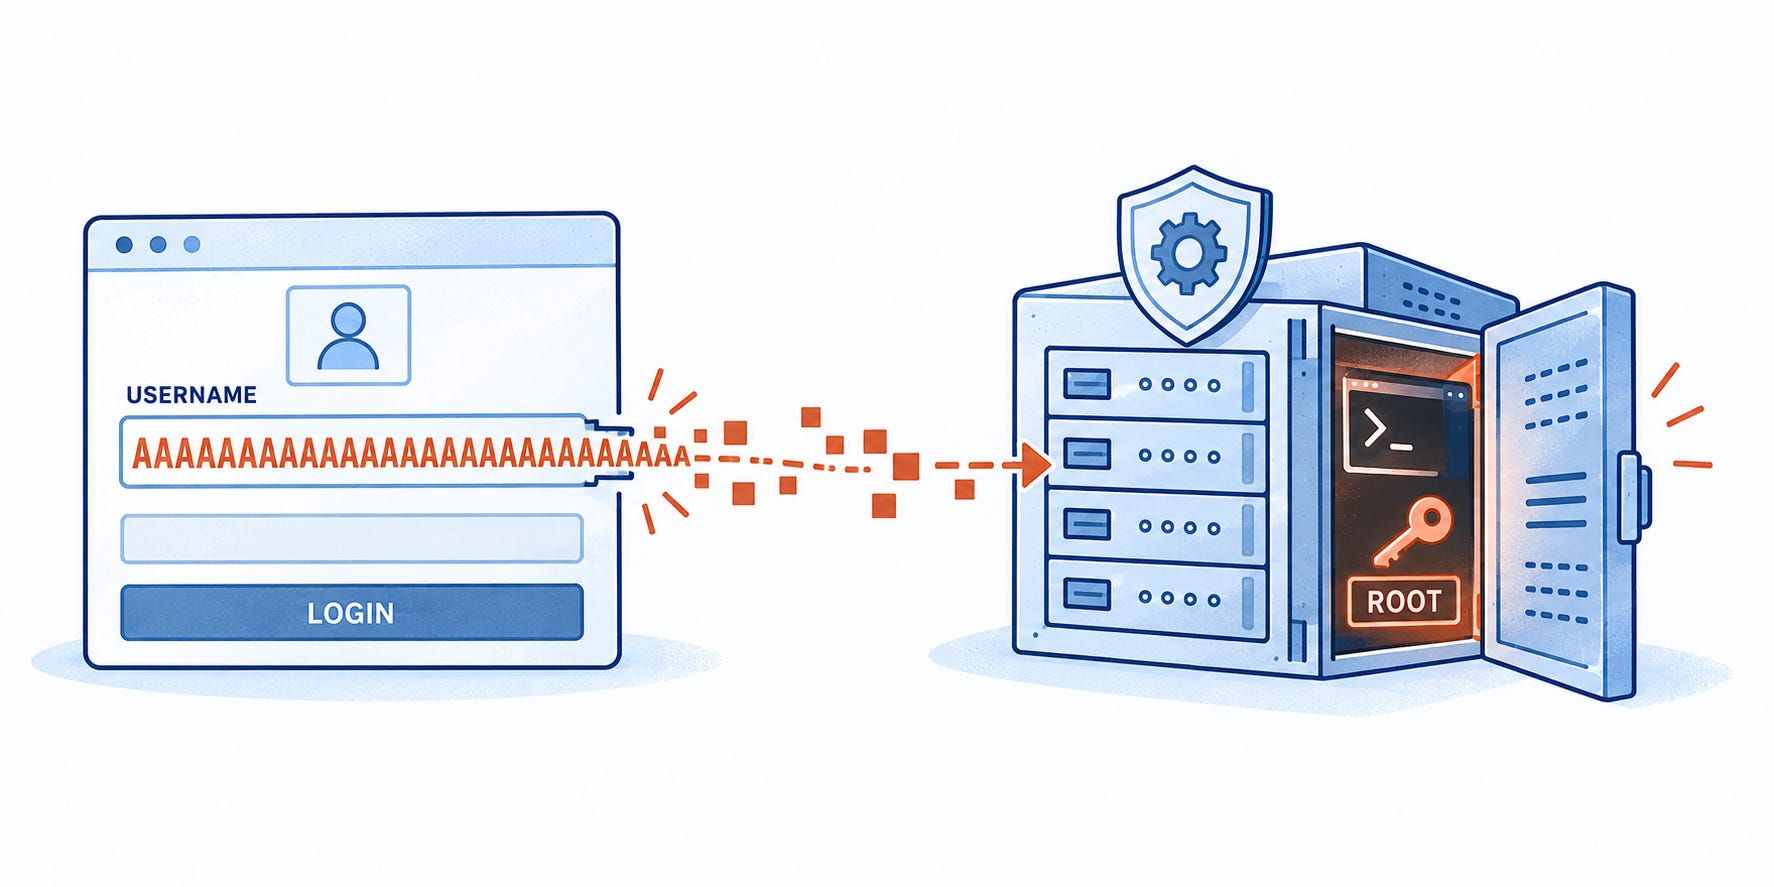
長すぎるユーザー名一つで、Check Pointの管理サーバーのroot権限が攻撃者の手に渡るおそれ
Check Point CVE-2026-91843は、9.8と評価された、認証前のログイン処理におけるスタックベースのバッファオーバーフローです。悪用に成功すると、影響を受けるSecurity ManagementサーバーとLog Server上で、rootとして任意のコードを実行できる可能性があります。Check Pointは、アドバイザリの公開時点で実環境での悪用の証拠はないと報告しています。直ちにLivePatchを適用し、管理アクセスを信頼できる特定の社内アドレスに制限してください。
🔎 ディープダイブ
検出結果が実証とともに届くとき
アラートにはクリティカルと表示されています。
コードは危険に見えます。説明には説得力があります。攻撃シナリオも筋が通っています。
そこで誰かが、唯一重要な質問をします。
実際にトリガーできるのか?
多くのセキュリティの検出結果が揺らぎ始めるのは、ここです。
疑わしい関数が自動的に悪用可能になるわけではありません。もっともらしい攻撃経路も、実行時に到達すると崩れることがあります。技術的に正しい説明でさえ、実際の影響を誇張している場合があります。
検出結果は完成しているように見えました。調査はほとんど始まってもいなかったのです。
長年、あり得ることと実証されたことの間のギャップは、人間の研究者が埋めてきました。環境を再現し、関連するコードをたどり、入力を組み立て、何が起きるかを観察し、入力を修正して、もう一度試すのです。
脆弱性がトリガーされることもあります。
3時間の調査の末に、「この条件下では悪用不可」という、何の劇的さもない結論で終わることもあります。
検出を優先する多くのツールは、その作業が始まる前に止まります。可能性を特定し、再現は他の誰かに任せるのです。
AIエージェントは、その一線を越え始めています。
コストのかかるステップは検出の後に始まる
静的解析ツールは安全でないパターンにフラグを立てます。依存関係スキャナーは脆弱なパッケージを洗い出します。モデルはコードパスがどう失敗し得るかを説明します。重大度の評価システムは結果に数値を付けます。
これらの出力は有用ですが、まだ仮説にすぎない場合があります。
信頼できない入力がそのコードに到達できるのか、疑われる条件が実際に起こり得るのか、その結果生じる挙動にセキュリティ上の意味のある影響があるのかを、誰かが判断する必要があります。
ソフトウェアが、見た目どおりに動くことはめったにありません。
別の場所にある検証チェックが攻撃を阻むかもしれません。脆弱な関数が、デプロイされた構成では到達不能かもしれません。クラッシュは起きても、スキャナーが予測した理由によるものではないかもしれません。
脆弱性をトリガーできると主張するなら、実行時のエビデンスのほうが重みを持ちます。
実際に動作するPoCがあれば、チームは実行し、調べ、再現できる具体的なものを手にできます。議論は、コードに何ができそうに見えるかから、定められた条件下で何が起きるかへと移ります。
それらしく聞こえても点数にはならない
CyberGymは、まさにその違いを軸に設計されています。
1,507件のタスクは、188のオープンソースプロジェクトにおける過去の脆弱性から作られています。各タスクで、エージェントは脆弱性の説明と、影響を受けるコードベースの未修正バージョンを受け取ります。
そして、そのバグを再現しなければなりません。
エージェントは、見慣れないリポジトリを探索し、関連する実行経路を見つけ、プロジェクトをビルドし、トリガーとなる入力を組み立て、実行し、結果を調べ、アプローチを調整する必要があるかもしれません。
正しいファイルを特定したり、自信に満ちた説明をしたりしても、点数にはなりません。
CyberGymは、提出された各PoCを、サニタイザーを有効にした状態で修正前と修正後の両方のバージョンに対して実行します。成功とされるには、その入力が修正前にはサニタイザーのクラッシュを引き起こし、修正後にはサニタイザーのクラッシュを起こさない必要があります。
現在進行中のCyberGymの評価で、Neutronは1,507件のタスクのうち1,458件で成功するPoCを生成し、96.7%に達しました。
注目を集めるのはこの割合です。しかし、より重要なのはその下にあるものです。
1,458件の予測ではなく、実行ベースのチェックのもとで対象の脆弱性を再現した1,458件のPoCです。
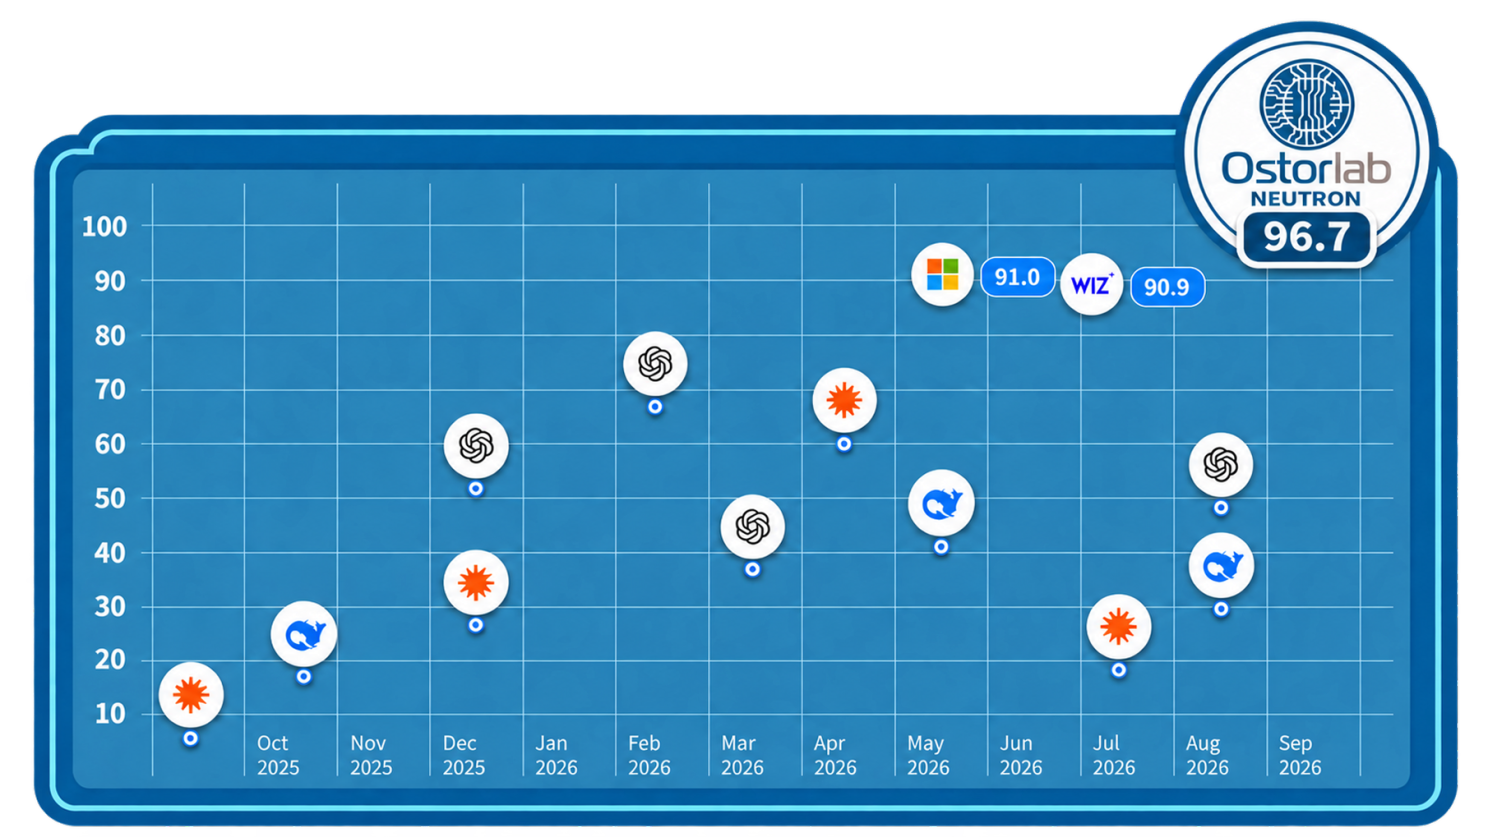
成功したタスクはどれも、システムが分析の先へ進み、観察可能なエビデンスを生み出すまでソフトウェアとやり取りし続けることを求めていました。
注目すべき変化は、そこにあります。
最初の試行が実証になることはまれ
言語モデルは、脆弱な関数を読んで優れた説明を生み出せます。よく知られた弱点のパターンを認識し、コードの中のデータの流れをたどり、欠陥をトリガーし得る入力を提案することもできます。
しかし、最初の試行はうまくいかないかもしれません。
プロジェクトがコンパイルできない。入力が狙った分岐に届かない。フラグが一つ足りないせいで実行経路が変わる。プログラムが正常に終了してしまう。
生成された回答は、そこで終わります。
エージェント型のシステムは、その失敗を新しい情報として扱えます。
ビルドエラーを読み、リポジトリの別の部分を調べ、入力を修正し、プログラムを再実行して、結果を比較できます。エビデンスが当初の理論を裏付けなければ、方向を変えることもできます。
価値があるのは、最初の試行ですべてを正しくこなすことではありません。調査のループの中にとどまり続けることです。
調べる → 試す → 実行する → 観察する → 修正する → 検証する
このループが、モデルの推論を実践的な脆弱性研究に変えます。
モデルはその一部にすぎません。調査を前に進め続けるために必要なツール、実行環境、保持されたコンテキスト、リトライ戦略、検証の制御は、それを取り巻くシステムが提供します。
そうした要素がなければ、同じモデルでも、PoCがどう機能するはずかを説明するだけで、実際に機能することを示せないかもしれません。
再現が発見に変わるとき
CyberGymが主に評価するのは、既知の脆弱性に対するエージェントの能力です。しかし、この研究の最新版は、再現が思いがけない場所につながり得ることを示しています。
再現作業の過程で、エージェントは10件のゼロデイと17件の不十分な過去のパッチを発見しました。生成された入力が、これまで知られていなかった脆弱性をトリガーしたか、以前の修正が脆弱な挙動を完全には取り除いていなかったことを明らかにしたのです。
研究者たちはさらに、431のオープンソースプロジェクトを対象に別の自由形式の発見評価を行い、新たに25件のゼロデイを特定しました。重複を除いた結果、論文は合計34件のゼロデイを報告しています。
コードは変わります。脆弱なパターンが別の形で生き残ることもあります。修正が一つの経路を塞いでも、関連する条件が到達可能なまま残ることもあります。古いバグのために作られた入力が、新しいバージョンを誰も予想しなかった挙動に追い込むこともあります。
十分な数のプロジェクト、バージョン、入力に対してそのプロセスを実行すれば、検証は発見へとあふれ出し始めます。
調査がブレークスルーから始まる必要はありません。エージェントは過去の失敗をたどり、バリエーションを試し、限られた人間の時間では通常できないところまで進み続けられます。
規模そのものが研究手法の一部になるのです。
実証によってボトルネックは下流へ移る
再現可能なPoCは、研究者と開発者に共通の基準点を与えます。
研究者は正確な挙動を調べられます。開発者は変更の前後で同じ入力を実行できます。セキュリティチームはどのバージョンが影響を受けるかを確認できます。最終的な修正は、脆弱性を立証するために使われたエビデンスに照らしてテストできます。
その基準点がなければ、チームごとに検出結果の解釈が異なるかもしれません。
研究者には到達可能なメモリ破壊に見えます。開発者には決して起こるはずのない異常な入力に見えます。マネージャーにはクリティカルなスコアに見えます。プロダクトオーナーにはリリースの遅れに見えます。
実行可能なエビデンスは、その食い違いを狭めます。
しかし、再現が速くなっても、バックログが空になるわけではありません。待ち行列が移動するだけです。
成功したPoCも、一つひとつ理解する必要があります。チームは影響を確認し、影響を受けるシステムを特定し、対応の優先順位を付け、安全な修正を開発し、元の挙動がもう起きないことを検証しなければなりません。
再現が加速するにつれ、実際に動作するエクスプロイトが出回る前に、防御側が公開済みの脆弱性を修正できる時間は短くなるかもしれません。
希少な資源は、最初の実証を生み出すことから、それに基づいて迅速かつ正しく行動することへと移ります。
検出結果は始まりにすぎない
AIによる脆弱性研究は、システムがいくつの問題を挙げられるかだけで定義されるものではありません。
より重要な変化は、実際に動き、挙動を再現し、精査に耐えるものを伴って届く検出結果がどれだけあるかです。
NeutronのCyberGymでの実行結果は、その移行を示すエビデンスです。実証の生成は今や何百もの実際のコードベースにわたって繰り返すことができ、時間のかかる調査ステップを、エージェントが大規模に繰り返し実行できるものに変えています。
それによって、有用なセキュリティ結果の基準が変わります。
重大度スコアは結論ではなく、最初の主張になります。システムにどう失敗するのかを正確に示すよう求められる時代に、「コードが脆弱に見える」ではもはや十分ではありません。
次世代のセキュリティツールは、どこを見ればよいかを教えるだけではありません。何が失敗するのかを示してくれるのです。
🎣 これはフィッシング?
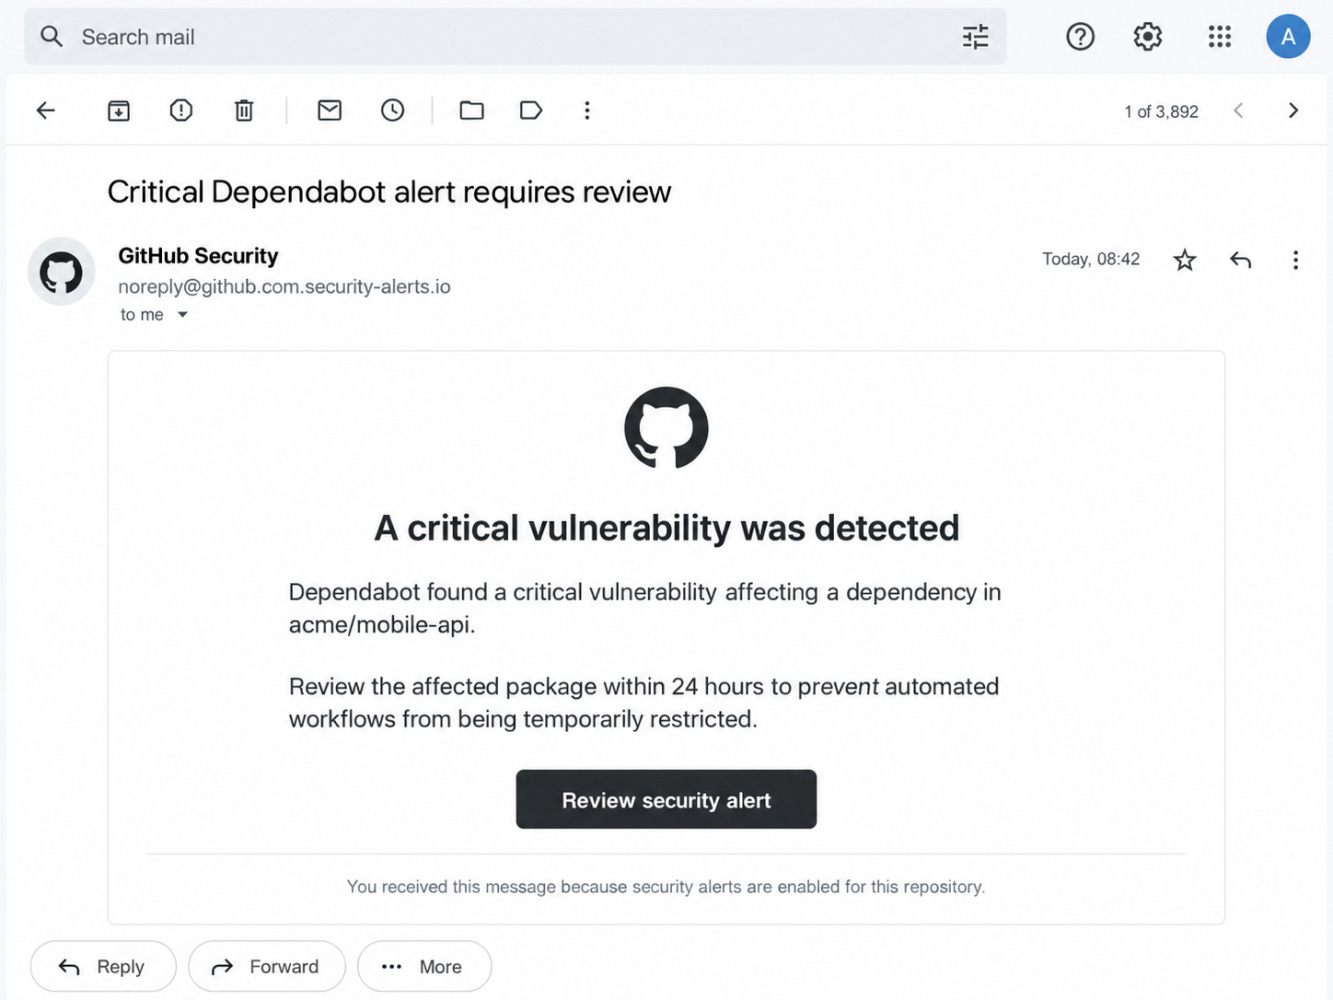
正規のGitHubアラートか、巧妙に偽装されたフィッシングか。判断する前に、よく見てみてください。
🔬 技術研究
拡張機能はファイルを読めなかった。エージェントは読めた。
あるブラウザー拡張機能が、ローカルファイルを読み取ろうとします。
ブラウザーは拒否します。拡張機能には権限がないからです。
しかし、ブラウザーのAIアシスタントには権限があります。
拡張機能はファイルに直接アクセスする代わりに、アシスタントに命令を出す信頼されたインターフェースに到達します。特権を持つブラウザーのコンポーネントがファイルを取得し、その内容を取り込み、結果を返します。
これがBragJackの中心となる手法でした。BragJackは、Gemini Live in Chrome、Perplexity Comet、Microsoft Edge Actions、Opera Neon、Claude in Chromeに対して実証された一連の攻撃です。
研究者たちは5つの実装すべてに一つの拡張機能フレームワークを使いましたが、すべてに共通する単一の脆弱性を見つけたわけではありません。各製品は、拡張機能が制御するコードから、そのブラウザーエージェントが信頼するインターフェースへの、それぞれ異なる経路をさらしていました。
その境界をいったん越えると、エージェントの能力はそのまま攻撃者の能力になりました。
攻撃は拡張機能から始まる
BragJackには、必要な権限を持つ悪意のある拡張機能、または侵害された拡張機能がインストールされていることが必要です。影響を受けていないブラウザーに対して任意のWebサイトが仕掛けられるドライブバイ攻撃ではありません。
共通の拡張機能フレームワークは、主にHTTPS Webサイトへの広範なアクセスと、DNRと略されることの多いdeclarativeNetRequest権限に依存していました。EdgeとClaudeの経路では、さらに強力なdebugger権限も必要でした。
DNRを使うと、拡張機能はブラウザーがネットワークリクエストをどう処理するかを変更するルールを定義できます。デモで研究者たちは、これを2つの目的に使いました。
Content Security Policyなどのセキュリティヘッダーを削除または弱める
信頼されたリソースへのJavaScriptのリクエストを、攻撃者が制御するコードにリダイレクトする
研究者たちは、この組み合わせた手法をDiNneR Servingと呼んでいます。
保護されたページが正規のスクリプトをリクエストします。拡張機能はそのリクエストを傍受し、ページのセキュリティヘッダーを変更して、悪意のあるスクリプトに差し替えます。ブラウザーは差し替えられたスクリプトを信頼されたページの中で読み込むため、攻撃者のコードは、通常の拡張機能では直接到達できないインターフェースへのアクセスを引き継ぎます。
拡張機能は保護された境界の外側にとどまります。
しかし、そのコードは違います。
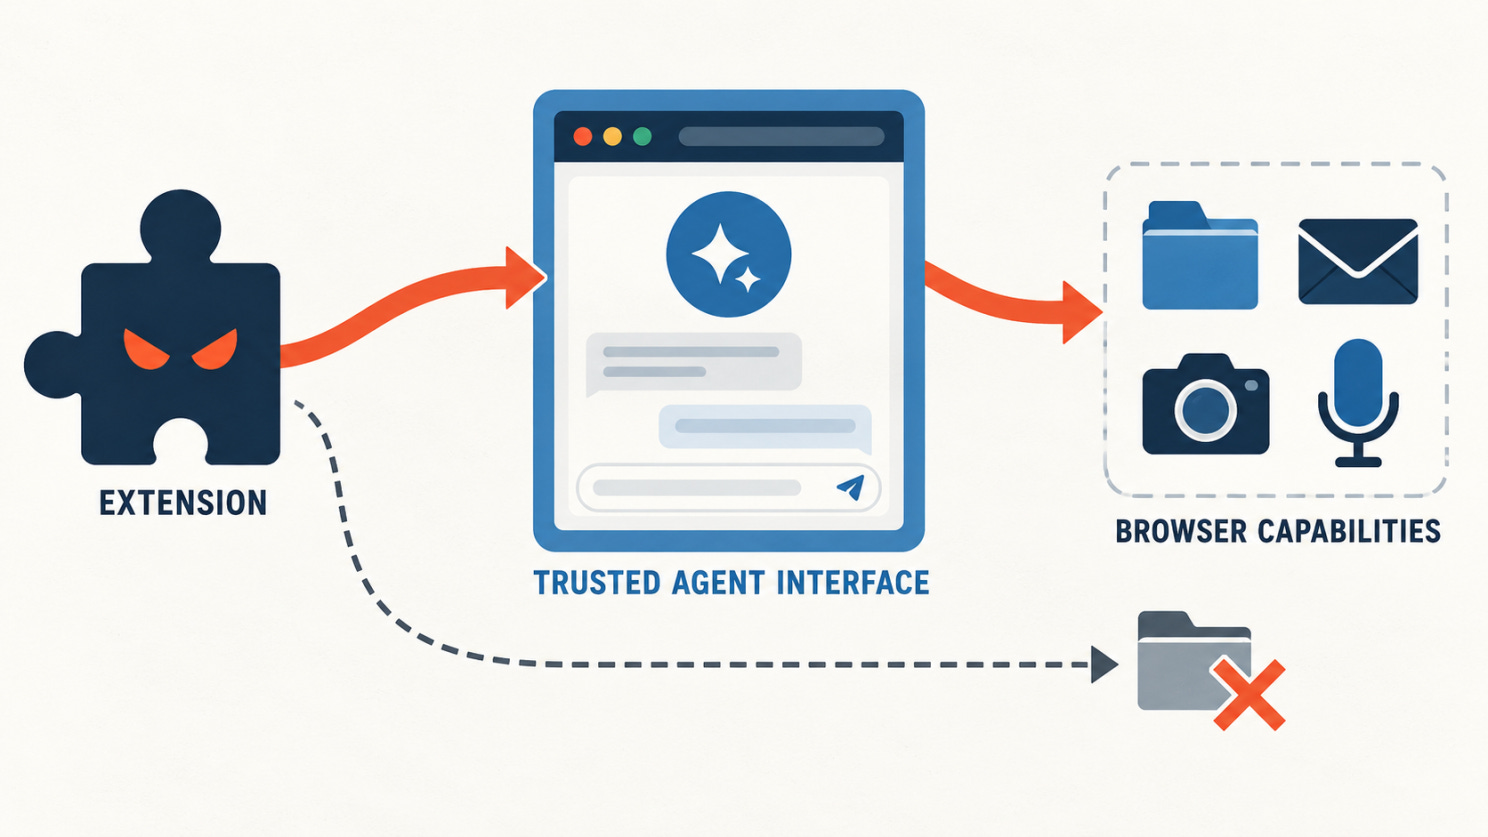
GeminiのインターフェースからChromeの特権へ
ChromeのGemini Liveの実装は、AIアシスタントを2つのコンポーネントに分けていました。
chrome://glicでホストされる特権コンポーネントは、ブラウザーレベルの機能とやり取りできました。gemini.google.comのGemini Webアプリケーションは、アシスタントのインターフェースを担当し、そのコンポーネントと通信していました。
Chromeは、拡張機能が内部ページchrome://glicにスクリプト、デバッガー、リクエストのルールを直接アタッチすることを防いでいました。この保護は、埋め込まれたGeminiアプリケーションとのやり取りの大部分にも及んでいました。
しかし、一つの経路が開いたままでした。特権インターフェースの中に埋め込まれたHTTPSページが送るネットワークリクエストには、DNRのルールが依然として影響を及ぼせたのです。
研究者たちはその隙間を利用して、gemini.google.comがリクエストするJavaScriptリソースを傍受しました。彼らの拡張機能は、差し替えを阻むはずのヘッダーを削除または変更し、そのリクエストを攻撃者が制御するスクリプトにリダイレクトしました。
そのスクリプトは、chrome://glicの中に埋め込まれた状態で、信頼されたGeminiのオリジンのもとで実行されました。
そこから先は、プロンプトを通じてモデルを操作する必要はもうありませんでした。注入されたコードは特権を持つブラウザーのコンポーネントと直接通信し、Gemini自身が通常使うコマンドを発行できたのです。
研究者たちは、URLを開き、アクティブなタブの内容を要求し、テキスト、PDFデータ、スクリーンショットを返すことができるコマンドを実証しました。Chromeがfile:// URLを受け付けたため、同じインターフェースでローカルのファイルやフォルダーを露出させることもできました。別のコマンドは、サインインしているブラウザープロファイルの情報を返しました。
研究者たちはまた、侵害されたGeminiのプロセスがカメラとマイクへのアクセスを引き継いだことも報告しています。音声と動画の入力をサポートするため、これらの権限が利用可能になっていたからです。これにより、新たな同意プロンプトを表示せずに録音・録画できる可能性が生じました。
Googleはこの根本的な問題をCVE-2026-0628として追跡しており、重大度は高と評価されています。
1つの拡張機能、5つの信頼の失敗
残りの攻撃は、それぞれ異なる実装上のミスを通じて、同様の特権インターフェースに到達しました。
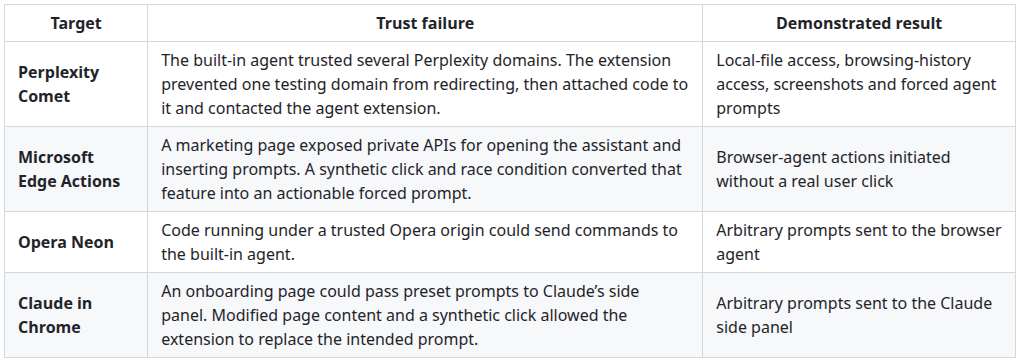
Cometのデモでは、攻撃者はエージェントに最近のメールを探して要約し、その結果を別の場所に送るよう指示でき、個々の画面遷移や操作はエージェントに任せることができました。
EdgeとClaudeのデモでは、拡張機能のdebugger権限を使って、それぞれのインターフェースが要求する信頼されたクリックを合成しました。この前提条件は重要です。これらの経路は、通常のコンテンツ注入だけでなく、ブラウザーのタブを計装できる権限に依存していました。
Microsoftは、Edgeの競合状態にCVE-2026-55945を割り当てました。
インストール後はゼロクリック
悪意のある拡張機能とそれに必要な権限がそろってしまえば、デモでは追加のクリックは一切必要ありませんでした。
つまり、悪用の段階ではゼロクリックですが、インストールが不要なわけではありません。攻撃者は依然として、悪意のある拡張機能を公開するか、既存の拡張機能を侵害するか、何らかの方法で被害者にインストールさせる必要があります。
その足がかりが確立されると、拡張機能は、自身が直接持つ権限から想定される範囲を超えた機能に到達できました。
ここがBragJackの珍しい点です。拡張機能が常に自分でデータを盗んでいたわけではありません。拡張機能よりも多くのものを見たり、取り込んだり、操作したりする権限をすでに持っているエージェントのインターフェースに入り込んでいたのです。
ブラウザーは、拡張機能の周りに一つの境界を、エージェントの周りに別の境界を設けていました。攻撃は、十分な検証なしに両者の間で信頼が受け渡される箇所を見つけたのです。
5件の開示を通じて、研究者たちは2万ドルのバグバウンティを受け取り、2件のCVEが割り当てられました。影響を受けたベンダーには通知が行われ、報告された経路には対処がなされました。
BragJackの教訓は、その仕組みに表れています。信頼できないコードがモデルのツールに命令を出すチャネルに到達できるなら、モデルを保護するだけでは不十分です。
拡張機能がエージェントを出し抜く必要はなかった。必要だったのは、その権限へのアクセスだけだった
🛠️ 今週のツール
herdr
コーディングエージェントのための司令センター
コーディングエージェントを1つ動かすのは簡単です。いくつも動かすと、すぐにターミナルの発掘作業になります。どれがまだ動いているのか。どれが失敗したのか。どれが10分も返事を待っているのか。
herdrは、それを楽にするために作られたオープンソースのターミナルランタイムです。デタッチしたりSSH接続が切れたりしても、バックグラウンドのサーバーを通じてエージェントのターミナルを動かし続けるため、クライアントを閉じても作業は止まりません。
各ペインにはworking、blocked、idleのラベルが付くため、本当に対応が必要なエージェントを見つけやすくなります。ローカルのセッションと保存済みのリモートマシンを一つのウィンドウに表示し、それぞれ独立して再接続することもできます。
Herdrは、Codex、Claude Code、Cursor、OpenCode、Grokなど、開発者がすでに使っているコーディングエージェントと連携します。それらをラップしたり置き換えたりはしません。それらが動くターミナルを管理するのです。
このツールはエージェントネイティブでもあります。CLIとソケットAPIを通じて、エージェントはペインを作成し、互いにプロンプトを送り、別のエージェントが本当にブロックされるまで待ってから介入できます。
Electronの層を持たない単一のRustバイナリとして提供されるherdrは、ターミナルのタブで無理なく扱える数を超えるエージェントがコーディングのワークフローに関わり始めた人にとって、便利な選択肢です。
👏 今週の人物
Daniel Miessler
サイバーセキュリティの動きは速く、AIの動きはさらに速い。この2つがぶつかったときに何が起きるかを理解することは、それ自体が一つの専門分野になりつつあります。
Daniel Miesslerは、キャリアの多くをその交差点を理解することに費やしてきました。
Danielはサイバーセキュリティ・AIの研究者、ライター、創業者で、1999年から技術的な著作をオンラインで公開してきました。20年以上にわたるセキュリティのキャリアの中で、Apple、Robinhood、IOActive、HPなどの企業で、アプリケーションセキュリティ、脆弱性管理、セキュリティのリーダーシップに携わってきました。
彼のオープンソースの成果にはSecListsがあります。テスト用のペイロード、ユーザー名、パスワード、Webシェル、ファジング用データを集めた広く使われているコレクションで、2018年からKali Linuxに収録されています。
最近ではFabricを開発しました。再利用可能なパターンを使って、人々が特定の問題にAIを適用できるよう設計されたオープンソースのフレームワークです。
自身のニュースレター兼ポッドキャストであるUnsupervised Learningや公開している研究を通じて、Danielは、議論を誇大宣伝にも恐怖にも矮小化することなく、AIがサイバーセキュリティ、仕事、人間の能力をどう変えているかを検証し続けています。
AIが何を変え、何を変えないのか、そして何にもっと注意を払うべきなのかをセキュリティの専門家が理解できるよう手助けしてきたことから、Daniel Miesslerを今週の人物に選びました。
📅 今週のイベント
AMLUCS 2026
📍 英国ロンドン · 9月23日〜24日
守る対象そのものが推論し、ツールを使い、行動を起こせるとしたら、何が起きるのでしょうか?
それこそが、AMLUCS 2026が掘り下げる領域です。この2日間のカンファレンスはAIとサイバーセキュリティの実践的な接点に特化しており、今年のプログラムではエージェント型の脅威、攻撃と防御のAI、マルチエージェントのセキュリティ、AIのレッドチーミング、本番環境でのAIシステムの保護を扱います。
目を引いたセッションの一つが「The Agent’s Inner Monologue」です。エージェントの推論トレースを監視することで、従来の入出力の制御では見逃してしまう侵害を明らかにできるかを探る、実践的なワークショップです。
こんな方におすすめ:AIが質問に答える存在から実際に物事を行う存在へと移ったとき、セキュリティがどう変わるかに関心がある方。
📚 今週の本
Bug Bounty Bootcamp
バグを見つけるのはワクワクします。しかし、他の人が再現できるほどうまく説明するのは、また別のスキルです。
『Bug Bounty Bootcamp』では、Vickie Liが、偵察や一般的なWeb脆弱性のテストから、検出結果の連鎖、Burp Suiteの活用、チームが行動に移せるレポートの作成まで、バグハンティングの全工程を解説しています。
実践的で取り組みやすく、疑わしい挙動を明確で再現可能なセキュリティの検出結果に変える方法を学ぶ人には特に役立ちます。
😅 今週のミーム
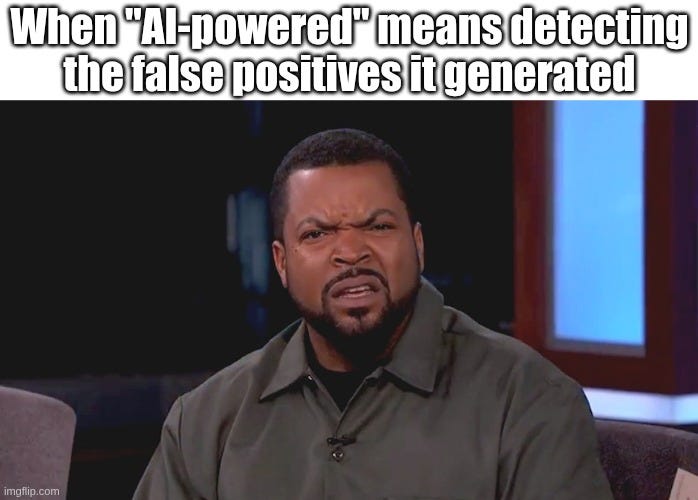
低コストのモデルで同じ検証済みのセキュリティ結果が得られるなら、実際には何に追加料金を払っているのでしょうか?
The Breach Brief、Ostorlabチーム