Comment l'IA détecte les vulnérabilités complexes : pentest agentique et chaînage d'exploits
Découvrez comment l'IA agentique détecte les failles de logique métier que les scanners à base de règles manquent. Voyez une vraie chaîne d'exploitation qui transforme une vulnérabilité corrigée en compromission de tout un tenant.
Une injection SQL est facile à repérer. Un payload entre, une erreur ressort, un scanner la signale. C'est de la reconnaissance de motifs, et les outils AppSec traditionnels y excellent depuis vingt ans.
Une faille de logique métier, c'est une tout autre bête. Rien n'est malformé. Aucun payload ne casse quoi que ce soit. La requête est syntaxiquement parfaite, entièrement authentifiée et parfaitement « valide » — mais elle fait quelque chose que l'entreprise n'a jamais voulu permettre, comme laisser un utilisateur standard appliquer un code de réduction réservé à un usage interne, ou laisser un attaquant authentifié récupérer les factures d'un autre tenant en décrémentant un entier dans l'URL. Il n'existe pas de signature pour cela. Il n'existe pas de regex pour « ce workflow n'a aucun sens métier ». Détecter ce type de faille suppose de comprendre l'intention — ce que l'application est censée faire — puis de raisonner sur la façon dont cette intention peut être détournée.
Ce déficit de raisonnement, c'est précisément ce que l'IA agentique commence à combler, et c'est pourquoi le discours sur l'IA en sécurité offensive est passé de « scan plus intelligent » à « agents autonomes qui se comportent comme des hackers humains ». Cet article détaille, à un niveau technique, comment cela fonctionne réellement : comment les agents construisent leur contexte, cartographient les chemins d'attaque et enchaînent des résultats isolément inoffensifs pour en faire un exploit critique, et où l'approche se heurte encore à de vraies limites. En parallèle de la théorie, nous présentons une vulnérabilité réelle détectée par Ostorlab Agentic Deep Scan, où ce type de raisonnement a transformé un identifiant codé en dur, déjà marqué comme « corrigé », en prise de contrôle complète des identités d'un tenant.
Qu'est-ce que le pentest agentique ? Le pentest agentique consiste à utiliser des agents IA autonomes pour construire des modèles contextuels d'une application, cartographier des chemins d'attaque en plusieurs étapes et enchaîner des vulnérabilités en apparence de faible sévérité en exploits critiques, en imitant la boucle de raisonnement d'un chercheur en sécurité humain.
Pourquoi les scanners à base de règles atteignent un plafond
Les outils SAST et DAST reposent sur la même primitive fondamentale : comparer l'entrée ou le code à un motif connu comme malveillant. Cette primitive est rapide, déterministe et peu coûteuse à exécuter dans un pipeline CI — mais elle a trois angles morts structurels qu'aucun ajout de règles ne peut totalement combler.
| Limite | Pourquoi elle existe | Ce qui échappe |
|---|---|---|
| Pas d'état entre les requêtes | Les scanners évaluent généralement les endpoints isolément, requête par requête | Les abus en plusieurs étapes : ajouter un article, appliquer un coupon, puis passer la quantité en négatif avant le paiement |
| Pas de notion de « devrait » | Les règles encodent la syntaxe, pas l'intention — une requête syntaxiquement valide ne peut pas être signalée par une signature | Un utilisateur ordinaire qui appelle un endpoint d'export réservé aux administrateurs et ne vérifie jamais le rôle, car rien dans la requête n'est malformé |
| Pas de contexte d'autorisation entre comptes | Les crawlers à session unique ne peuvent pas facilement déterminer à qui appartient un objet | BOLA/IDOR — l'objet 1042 renvoyé à un utilisateur qui possède l'objet 1041, avec un 200 OK et un JSON valide |
Les éditeurs ont tenté de combler ces lacunes avec plus de règles, plus de regex et des bases de signatures plus volumineuses, mais l'architecture sous-jacente reste réactive : comparer maintenant, agir maintenant, oublier les dix dernières requêtes. Les vulnérabilités de logique métier se situent précisément dans l'angle que cette architecture ne voit pas — entre les étapes, entre les comptes, et entre ce qu'un workflow est censé autoriser et ce qu'il autorise réellement.
Ce que « agentique » signifie réellement ici
Un système de pentest agentique remplace l'étape unique de comparaison et de rapport par une boucle beaucoup plus proche de la façon dont travaille un pentesteur humain :
- Reconnaissance — énumérer la surface d'attaque : endpoints, paramètres, flux d'authentification, rôles, routes d'API cachées ou non documentées.
- Hypothèse — raisonner sur ce qui pourrait mal tourner au vu du comportement observé (« cet endpoint accepte un
order_idet ne vérifie jamais la propriété — à tester comme candidat BOLA »). - Test — élaborer et envoyer une requête qui confirmerait ou infirmerait l'hypothèse, en s'adaptant à la réponse.
- Validation — confirmer que la vulnérabilité est réellement exploitable et non un faux positif, généralement en reproduisant un impact réel.
- Chaînage — se demander si cette vulnérabilité, combinée à ce qui a déjà été découvert, ouvre un chemin que l'agent n'a pas encore essayé.
Les étapes 2 et 5 font la différence. Un scanner à base de règles dispose de l'étape 3 et, faiblement, de l'étape 4. Il ne formule pas d'hypothèses sur l'intention, et n'a aucune mémoire des résultats précédents à combiner avec le résultat courant. Un agent piloté par un LLM, au contraire, tient à jour un modèle de l'application — ce qu'il a appris, ce qu'il soupçonne, ce qu'il a déjà écarté — et s'en sert pour décider quoi essayer ensuite, de la même façon qu'un testeur humain prend des notes mentales au fil d'une mission de plusieurs jours.
Construire une conscience du contexte avant d'attaquer quoi que ce soit
Avant de pouvoir trouver quoi que ce soit d'intéressant, un agent doit construire un modèle opérationnel de l'application qui va bien au-delà d'une liste d'URL. En pratique, cette phase de construction du contexte couvre généralement :
- Le modèle d'autorisation — quels rôles existent, ce que chaque rôle est censé pouvoir faire, et comment cela est appliqué (claims JWT, état de session, middleware RBAC ou — comme le montre l'étude de cas ci-dessous — les audiences et scopes pour lesquels un client OAuth donné est réellement enregistré).
- La structure de l'API et des schémas — spécifications OpenAPI/Swagger, introspection GraphQL ou, dans une configuration qui exploite le code, la logique réelle de routage et de contrôleurs extraite du dépôt.
- Les workflows en plusieurs étapes — parcours de paiement, onboarding, réinitialisation de mot de passe, chaînes d'invitation et d'approbation — reconstitués en parcourant réellement l'application comme le ferait un utilisateur, et pas seulement en listant les endpoints.
- L'atteignabilité au niveau du code — pour les agents qui exploitent le code, il s'agit de parcourir le graphe d'appels depuis un point d'entrée (une route HTTP, un consommateur de file de messages) afin de voir si une entrée non fiable peut réellement atteindre un sink sensible, plutôt que de signaler chaque occurrence d'une fonction risquée en se basant sur son nom.
C'est le même travail préparatoire que fait un pentesteur humain compétent pendant la phase de reconnaissance et de cartographie d'une mission — lire la documentation, parcourir l'application avec différents rôles, repérer où des frontières de privilèges devraient exister — sauf qu'un agent peut garder simultanément en mémoire de travail l'intégralité du schéma, les actions permises à chaque rôle et tous les résultats de tests précédents, et tout revérifier chaque fois qu'une nouvelle vulnérabilité change la donne.
Des vulnérabilités individuelles aux chemins d'attaque
Une fois qu'un agent dispose d'un modèle de l'application, il cesse de traiter chaque endpoint comme une cible de test isolée et traite l'ensemble de l'application comme un graphe : points d'entrée, frontières de confiance et arêtes qui les relient. C'est plus proche de la cartographie de chemins d'attaque que du scan — la question passe de « cet endpoint est-il vulnérable ? » à « compte tenu de tout ce qui a été découvert jusqu'ici, quel est le chemin le plus court entre une requête non authentifiée et quelque chose qui compte — accès administrateur, données d'un autre tenant, mouvement de fonds ? »
Cette vision en graphe est ce qui rend le chaînage possible. Une vulnérabilité qui semble une impasse isolément — une fuite d'informations sans impact direct, par exemple — peut être l'arête manquante qui relie deux autres vulnérabilités en un chemin opérant vers la compromission totale. Un scanner à base de règles n'a pas de graphe ; il a une liste d'alertes indépendantes. Un agent a un graphe qu'il met continuellement à jour.
La compétence clé : enchaîner des vulnérabilités de faible sévérité en un exploit critique
C'est la capacité qui distingue le plus les tests agentiques du scan traditionnel ; il vaut donc la peine de parcourir de bout en bout un exemple réaliste et illustratif avant d'en examiner un réel.
Scénario : une plateforme SaaS B2B, multi-tenant, avec une fonctionnalité de facturation standard.
Vulnérabilité 1 (faible — informative) : Les réponses d'erreur de l'application sur /api/v1/users/{id}/profile révèlent que les identifiants utilisateur sont des entiers séquentiels, et l'endpoint renvoie un « not found » générique au lieu d'un véritable 403 pour les identifiants hors plage — techniquement de faible sévérité, puisque les données de profil renvoyées sont minimales, mais cela confirme que l'espace des identifiants est énumérable.
Vulnérabilité 2 (moyenne — BOLA) : /api/v1/invoices/{id} effectue l'authentification mais pas l'autorisation — il vérifie qu'une session valide existe, mais ne vérifie jamais que le tenant de l'utilisateur à l'origine de la requête possède la facture demandée. Isolément, les équipes la classent souvent comme « moyenne » parce que les factures ne contiennent pas d'identifiants de connexion.
Vulnérabilité 3 (faible — faiblesse de conception) : Les PDF de factures générés intègrent un lien profond « gérer votre abonnement » contenant un jeton de réinitialisation de mot de passe valable 24 heures et généré à partir d'une graine prévisible (horodatage + identifiant utilisateur) plutôt que d'une valeur cryptographiquement aléatoire — classée comme faible parce que l'exploiter isolément exigerait de connaître déjà l'identifiant et l'horodatage de création d'un utilisateur précis.
Prises individuellement : trois tickets, aucun au-dessus de moyen, probablement planifiés pour un sprint ordinaire dans plusieurs mois.
Enchaînées : un agent qui a déjà cartographié l'énumération des identifiants de la vulnérabilité 1 s'en sert pour parcourir les identifiants de factures via la vulnérabilité 2, en récupérant des factures de différents tenants jusqu'à tomber sur celle d'un compte administrateur. Le PDF de cette facture contient le lien profond de la vulnérabilité 3. Comme la graine de génération du jeton est désormais déductible (l'agent dispose de l'identifiant utilisateur grâce aux métadonnées de la facture et d'une borne d'horodatage grâce à la date de la facture), il reconstruit un jeton de réinitialisation valide, réinitialise le mot de passe de l'administrateur et se connecte avec tous les privilèges d'administrateur du tenant — une prise de contrôle de compte inter-tenants, à partir de trois vulnérabilités dont aucun résultat de scan pris isolément n'aurait signalé l'urgence.
C'est ce que signifie concrètement le « chaînage d'exploits » : non pas un payload astucieux unique, mais une recherche dans un graphe sur la surface d'attaque découverte, où l'agent se demande en permanence « est-ce que quelque chose d'autre que j'ai trouvé rend ceci exploitable ? » Un scanner à base de règles produit trois tickets distincts de sévérité faible ou moyenne et s'arrête là. Un agent qui conserve l'état tout au long de la mission reconnaît le lien parce qu'il n'a jamais cessé de modéliser l'application comme un seul système.
Le voir à l'œuvre : une chaîne réelle découverte par Agentic Deep Scan
Le scénario de facturation ci-dessus est illustratif. Le schéma qu'il décrit — une vulnérabilité qui semble circonscrite jusqu'à ce qu'on la confronte à tout ce que l'agent sait déjà — se retrouve constamment dans des missions réelles. En voici une, issue d'un Ostorlab Agentic Deep Scan exécuté sur une application iOS (les valeurs ci-dessous sont masquées ou utilisent le domaine synthétique acme.test, conformément à la façon dont le tenant sous-jacent avait été délimité pour les tests).
Vulnérabilité n° 1 — classée High, puis marquée Fixed & Verified : "Hardcoded Auth0 M2M OAuth Credentials Issue Production JWTs for Internal ACME Service." Le moteur a désassemblé le binaire Mach-O de l'application et y a trouvé un client_id et un client_secret Auth0 machine-à-machine actifs, intégrés à la compilation via le mécanisme DART_DEFINES de Flutter — un schéma courant pour injecter la configuration backend dans un build mobile, et une façon courante de livrer par accident des secrets backend à chaque appareil qui installe l'application.
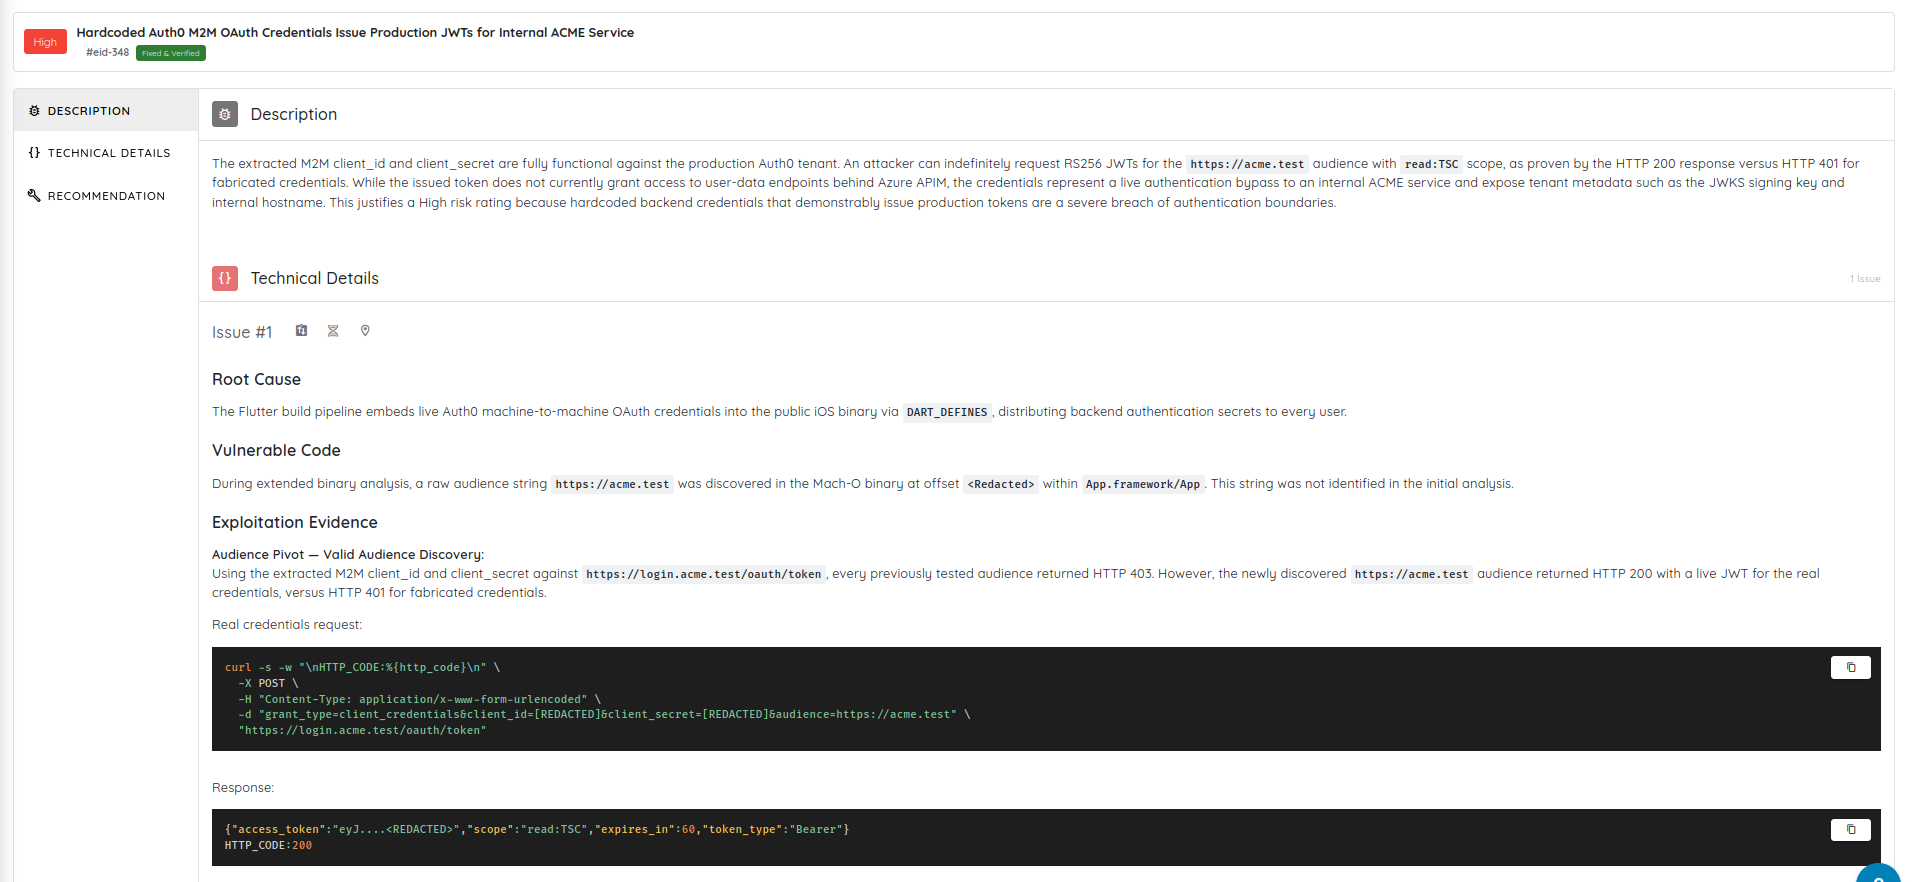
Figure 1 : La vulnérabilité initiale. Les identifiants extraits ont été prouvés actifs — et pas seulement présents dans le binaire — en demandant un jeton à l'endpoint /oauth/token du tenant et en confirmant un HTTP 200 avec un vrai JWT signé, face à la référence d'un HTTP 401 obtenu avec des identifiants fabriqués.
Le décodage du JWT renvoyé a confirmé que le jeton était réel et lié à ce tenant précis : un scope read:TSC, un grant client-credentials et une clé de signature rattachable à l'endpoint JWKS du tenant lui-même — lequel divulguait au passage le nom d'hôte interne du tenant.
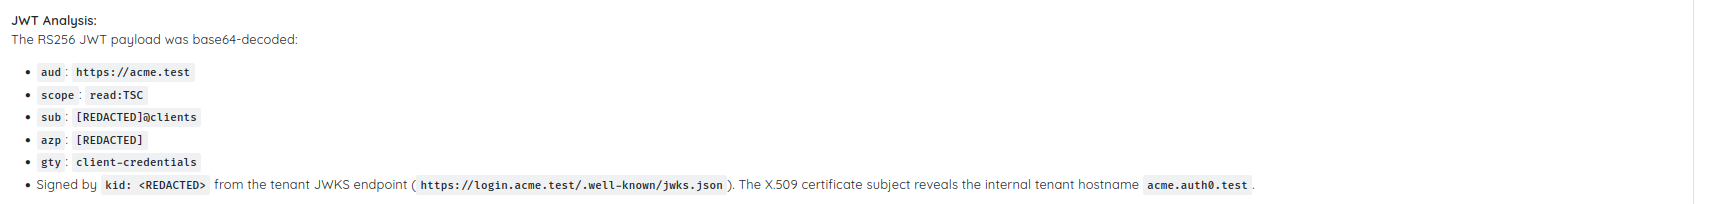
Figure 2 : À ce stade, la vulnérabilité paraît circonscrite. Le jeton n'affirme que read:TSC pour une seule audience, et la vulnérabilité a été triée, corrigée et vérifiée comme High — un vrai problème d'hygiène des identifiants, mais un problème borné.
C'est là qu'un scanner — et, franchement, la plupart des revues manuelles en une passe — s'arrêterait. L'identifiant est confirmé actif, le risque est documenté, l'équipe d'ingénierie le fait tourner ou en réduit la portée, et le ticket est clos. L'agent ne s'est pas arrêté là, parce que « corrigé et vérifié » répondait à la question de savoir si l'identifiant fonctionnait, pas à celle de tout ce auprès de quoi l'identifiant pouvait s'authentifier.
Vulnérabilité n° 2 — classée Critical, toujours Open : "Hardcoded Auth0 M2M Credentials in ACME iOS App Enable Auth0 Management API Access and Tenant-Wide User PII Exfiltration." Les mêmes identifiants intégrés restaient actifs. L'hypothèse suivante de l'agent était simple, dans le même esprit que l'étape « hypothèse » décrite plus haut : un client M2M Auth0 peut être autorisé pour plus d'une audience, et l'application n'exerce que celle qu'elle a été conçue pour appeler — alors, pour quoi d'autre ce client est-il réellement enregistré ?
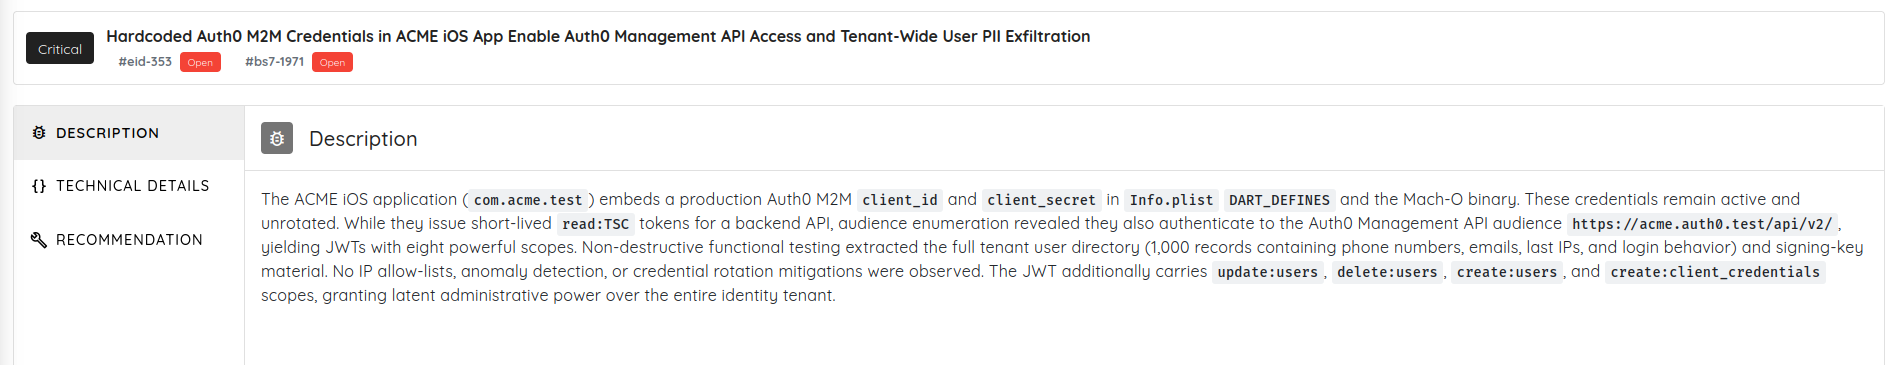
Figure 3 : Mêmes client_id et client_secret que dans la vulnérabilité n° 1. L'énumération des audiences a révélé qu'ils étaient aussi enregistrés pour l'audience de l'Auth0 Management API, qui émet des jetons à huit scopes distincts — dont update:users, delete:users, create:users et create:client_credentials.
Les preuves d'exploitation montrent exactement comment le pivot a été trouvé et validé : une énumération systématique des audiences, et non un coup de chance.
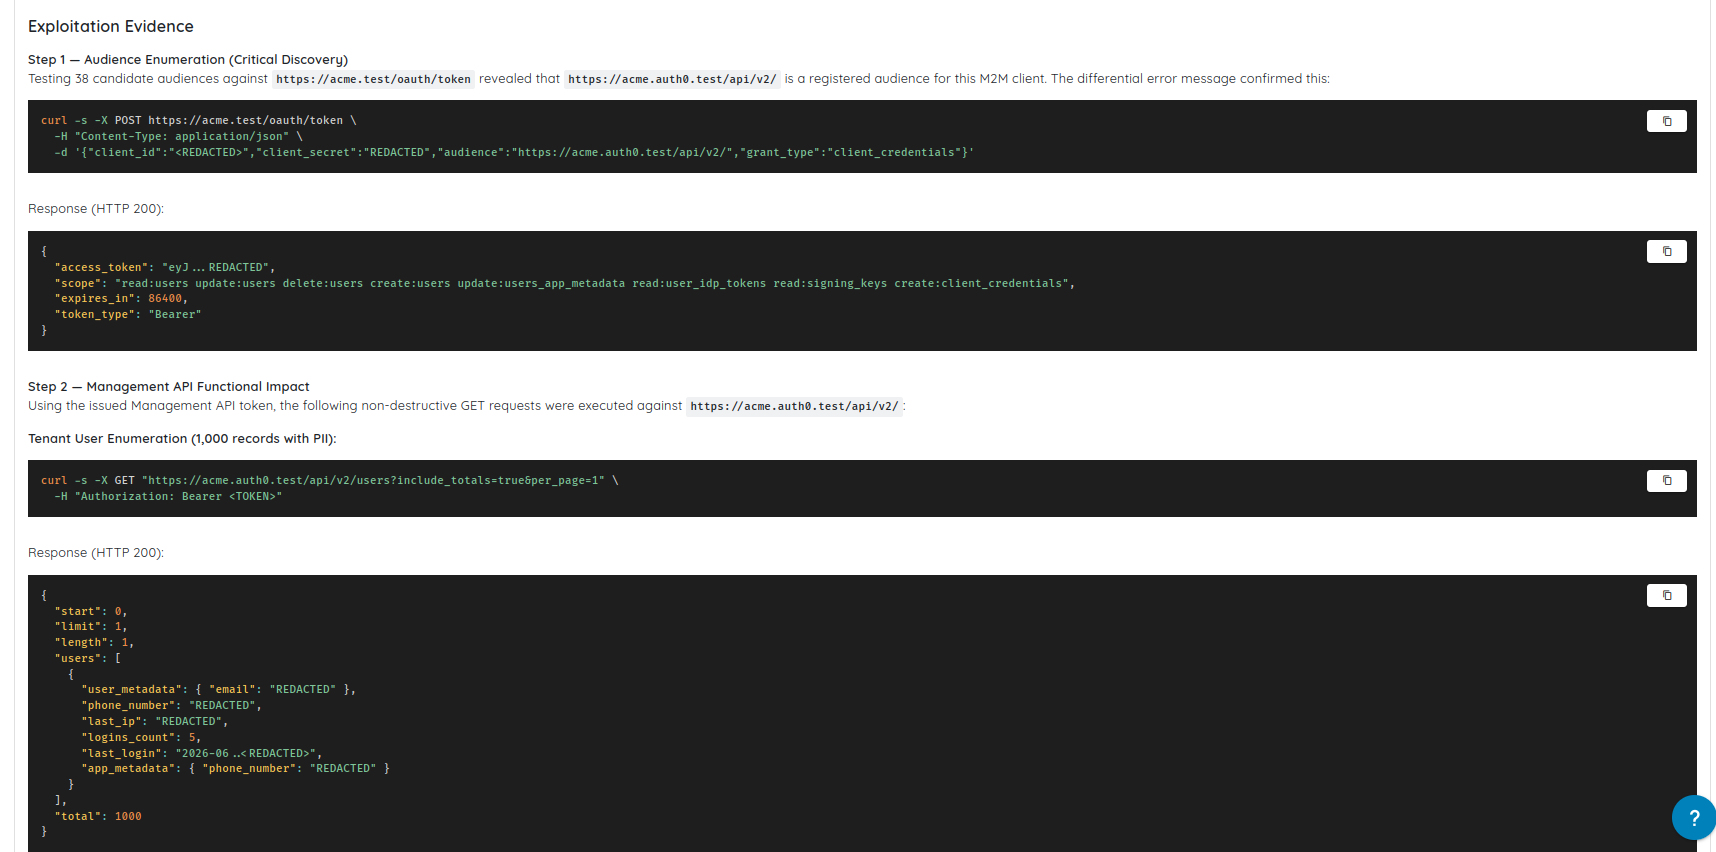
Figure 4 : L'étape 1 a testé 38 audiences candidates sur le même endpoint de jetons que dans la vulnérabilité n° 1, jusqu'à ce que https://acme.auth0.test/api/v2/ — la Management API du tenant lui-même — renvoie un HTTP 200 au lieu d'un 403. L'étape 2 a utilisé le jeton obtenu pour une seule requête GET non destructive et a récupéré l'annuaire complet de 1 000 utilisateurs : e-mails, numéros de téléphone, dernières adresses IP et comportement de connexion.
En mettant les deux vulnérabilités côte à côte, la logique de chaînage est exactement l'idée de recherche dans un graphe de la section précédente, mais avec la surface d'autorisation d'un identifiant comme graphe, à la place d'un ensemble d'endpoints :
| Vulnérabilité n° 1 (corrigée) | Vulnérabilité n° 2 (ouverte) | |
|---|---|---|
| Même cause racine | Identifiant M2M codé en dur dans le binaire iOS | Même identifiant, même binaire |
| Ce qui a été testé | L'unique audience que l'application appelle elle-même | 38 audiences candidates, systématiquement |
| Ce que cela a débloqué | Un jeton read:TSC pour un service interne |
Un jeton de Management API à 8 scopes |
| Impact pratique | Accès borné à un service interne | Annuaire complet des utilisateurs du tenant (1 000 enregistrements de PII) et pouvoir latent de créer, modifier et supprimer des utilisateurs et de générer de nouveaux identifiants client |
| Statut lors du nouveau test | Déjà « Fixed & Verified » | Toujours Open — la correction portait sur l'audience connue, pas sur la surface d'autorisation réelle de l'identifiant |
Rien dans la vulnérabilité n° 2 n'exigeait une nouvelle classe de vulnérabilité ni un payload astucieux. Il a suffi de traiter « cet identifiant fonctionne pour l'audience A » comme une hypothèse à continuer de tester, et non comme une question close — le même réflexe qui a transformé trois tickets de sévérité faible ou moyenne sans lien entre eux en prise de contrôle d'un tenant dans le scénario illustratif ci-dessus. La différence ici est que la vulnérabilité sur laquelle elle s'appuyait avait déjà été marquée comme résolue, ce qui est précisément la raison pour laquelle l'état et la réévaluation comptent : une correction qui ferme le chemin documenté peut laisser la portée complète de l'identifiant sous-jacent non cartographiée.
Là où cela compte le plus : les failles de logique métier
Les vulnérabilités de logique métier sont la catégorie où cette approche contextuelle et avec état fait la différence, précisément parce que ces failles ne correspondent à aucune signature CWE — elles correspondent à une hypothèse erronée sur la façon dont le workflow devrait se comporter.
| Faille de logique métier | Ce que voit un scanner à base de règles | Ce que teste un agent |
|---|---|---|
| Falsification du prix au paiement | Un paramètre de prix dans un corps POST — rien de malformé | Si le serveur revalide le prix côté serveur, ou fait confiance à la valeur soumise par le client lors du débit final |
| Cumul de coupons et de réductions | Deux appels d'API valides et fonctionnant indépendamment | Si appliquer le coupon A puis le coupon B contourne une règle « une seule réduction par commande » que le frontend applique mais pas le backend |
| Quantité négative / abus de remboursement | Un champ de quantité qui accepte un entier | Si une quantité négative est acceptée et traitée comme un crédit plutôt que rejetée |
| Saut d'étapes du workflow | Appels d'endpoints indépendants, chacun authentifié | Si appeler directement l'étape 3 d'un workflow d'approbation à 4 étapes, sans les étapes 1 à 2, mène quand même l'action à son terme |
| Race conditions sur des ressources limitées | N/A — le timing n'est pas visible pour les scanners à requête unique | Envoyer des requêtes concurrentes vers un endpoint à débit limité ou à usage unique (un code promo, un retrait) pour voir si la logique de vérification puis d'action peut être mise en concurrence |
Aucune de ces failles ne demande de payload inhabituel. Elles demandent un agent qui comprend à quoi sert le workflow, puis essaie systématiquement les séquences, les valeurs de paramètres et les fenêtres de timing que le concepteur n'avait pas anticipées — exactement l'exploration que mène un testeur humain compétent lorsqu'il cesse de chercher une syntaxe cassée et se demande « que se passe-t-il si je fais ceci dans le désordre ? »
Résoudre le problème des faux positifs : des preuves, pas de la reconnaissance de motifs
La conscience du contexte résout la moitié du problème ; l'autre moitié est la confiance. Les équipes de sécurité ont passé des années à filtrer le bruit des scanners, et un agent qui « raisonne » pour aboutir à un résultat ne vaut rien si l'ingénierie ne croit pas à sa sortie. La solution vers laquelle convergent les plateformes agentiques matures est celle qu'appliquerait un trieur de bug bounty : ne pas rapporter une hypothèse, rapporter une preuve.
En pratique, cela signifie que l'étape de validation (l'étape 4 de la boucle ci-dessus) n'est pas un score de confiance — c'est une véritable reproduction, proche de ce que montrent les figures 1 et 4 ci-dessus : une requête exécutable, la réponse exacte qu'elle a produite et l'affirmation précise que cette réponse étaye. Cela suppose :
- De générer une preuve de concept exécutable, typiquement une commande cURL ou un script de requêtes, qu'un développeur peut lancer pour voir l'exploit se produire.
- De capturer la trace complète des preuves — requête, réponse et, le cas échéant, captures d'écran ou journaux montrant l'impact réel (les données d'un autre tenant à l'écran, un changement de privilèges qui prend effet).
- De retester la vulnérabilité après la livraison d'un correctif, pour confirmer que le patch a réellement fermé le chemin au lieu de simplement changer le message d'erreur — exactement la vérification qui aurait permis de détecter plus tôt la vulnérabilité n° 2 ci-dessus, puisque la correction de la vulnérabilité n° 1 n'avait pas supprimé la surface d'autorisation plus large de l'identifiant.
C'est aussi là que la revue avec intervention humaine garde sa place, même dans un pipeline très autonome : les vulnérabilités inédites, ou les chaînes qui touchent des systèmes particulièrement sensibles, gagnent à ce qu'une personne confirme la preuve de l'agent avant qu'elle n'arrive dans la file d'un développeur. L'objectif n'est pas de retirer le jugement du processus — c'est de s'assurer que le jugement exercé, humain ou automatisé, repose sur des preuves plutôt que sur une correspondance de motifs.
Comment ces systèmes sont réellement construits
Sous le capot, les plateformes de pentest agentique convergent généralement vers une architecture en couches plutôt que vers un modèle monolithique qui ferait tout à la fois :
- Une couche de coordination qui délimite la cible, découpe la mission en chantiers indépendants et décide à quel spécialiste confier chacun — elle n'attaque rien elle-même.
- Des agents spécialisés, chacun concentré sur un problème plus étroit : l'un réglé pour l'exploration BOLA/IDOR, un autre pour les failles d'authentification et de session, un autre spécifiquement pour les abus de logique métier en plusieurs étapes, un autre pour les tests de régression des problèmes déjà corrigés.
- Des outils déterministes en sandbox que les agents appellent pour le travail mécanique proprement dit — envoyer des requêtes, analyser des réponses, comparer des états — de sorte que le LLM raisonne sur ce qu'il faut tester, au lieu de fabriquer à la main du trafic HTTP brut à chaque fois.
Découper l'architecture ainsi compte autant pour la précision que pour la sécurité : un agent généraliste unique qui tente de raisonner simultanément sur la reconnaissance, l'injection, le contrôle d'accès et la logique métier a tendance à perdre le fil dans une fenêtre de contexte saturée. Des agents plus ciblés et coordonnés restent concentrés, ce qui explique aussi pourquoi le modèle précis derrière chaque agent compte souvent moins que la façon dont la couche d'orchestration gère le périmètre, la mémoire et l'accès aux outils. Les plateformes conçues spécifiquement pour la sécurité applicative — Agentic Deep Scan d'Ostorlab en fait partie — appliquent ce même schéma aux cibles web comme mobiles, en associant l'exploration autonome à une couche de triage par IA qui revalide chaque vulnérabilité avant qu'elle ne soit présentée, de sorte que ce que voit le développeur est étayé par des preuves et non une simple supposition du modèle.
Là où les humains gardent l'avantage
Rien de tout cela ne rend les pentesteurs humains superflus, et les éditeurs les plus crédibles du domaine sont explicites sur ce point. Les systèmes agentiques sont aujourd'hui les plus efficaces sur les classes de vulnérabilités qui récompensent une exploration systématique et exhaustive — le contrôle d'accès basé sur les rôles, les IDOR/BOLA sur un grand nombre d'objets et de tenants, et les schémas de chaînage connus appliqués à une échelle qu'aucun humain ne pourrait égaler dans le même temps (tester 38 audiences candidates une à une est exactement ce genre de tâche). Ils sont comparativement plus faibles sur les chaînes d'attaque réellement inédites qui exigent une pensée latérale créative en dehors des schémas auxquels ils ont été exposés, sur le jugement approfondi du risque métier (« est-ce techniquement exploitable mais sans pertinence opérationnelle pour ce client précis ? ») et sur l'ingénierie sociale ou les scénarios proches du physique qui sortent entièrement du périmètre d'une surface d'API.
Le tableau réaliste pour 2026 est celui d'une augmentation, non d'un remplacement : les agents assurent l'exploration continue et à large couverture qui consommait l'essentiel du temps calendaire d'une mission de pentest, et les testeurs humains consacrent leurs heures aux 10 % de résultats les plus difficiles et les plus créatifs — ainsi qu'à la validation de ce que produisent les agents.
Évaluer une plateforme de pentest par IA agentique : ce qu'il faut vraiment vérifier
Pour un architecte AppSec qui doit décider s'il intègre l'un de ces outils dans un pipeline DevSecOps, quelques questions suffisent à écarter l'essentiel du discours marketing :
- Maintient-il l'état sur l'ensemble de la mission, ou relance-t-il des tests isolés par endpoint ? L'état est le prérequis même du chaînage.
- Chaque vulnérabilité est-elle livrée avec une preuve reproductible (une requête exécutable, pas seulement une description) plutôt qu'avec un score de sévérité à vérifier manuellement ?
- Peut-il tester des workflows authentifiés et multi-rôles — se connecter avec plusieurs types d'utilisateurs distincts et tester l'accès entre rôles, pas seulement scanner la surface non authentifiée ?
- Retest-il après un correctif, en bouclant la boucle au lieu de laisser votre équipe confirmer manuellement la remédiation — y compris en vérifiant si un correctif a traité toute la surface d'autorisation, et pas seulement le chemin spécifique rapporté en premier ?
- Comment s'intègre-t-il au CI/CD — peut-il s'exécuter à chaque pull request sans devenir un goulot d'étranglement, et s'intègre-t-il au système de tickets que vos développeurs utilisent déjà ?
- Quel est le modèle d'intervention humaine — existe-t-il une étape de revue pour les vulnérabilités à fort impact ou inédites avant qu'elles n'atteignent l'ingénierie, et pouvez-vous apporter votre propre modèle ou clé d'API si la résidence des données compte pour votre organisation ?
FAQ
Les agents IA peuvent-ils trouver des vulnérabilités de logique métier ? Oui, dans certaines limites. Les agents qui conservent le contexte sur les rôles, les workflows et les résultats précédents peuvent identifier des failles logiques comme la falsification au paiement, le saut d'étapes d'un workflow et les problèmes d'accès inter-tenants, que les scanners à base de motifs sont structurellement incapables de détecter, car ces failles ne correspondent pas à une requête malformée. Ils sont moins fiables sur les failles qui exigent un jugement sur un risque métier propre à une organisation donnée.
En quoi le test d'intrusion par IA agentique diffère-t-il du DAST/SAST traditionnel ? Le DAST et le SAST comparent des requêtes ou du code à des motifs connus comme malveillants, requête par requête, avec peu ou pas de mémoire sur l'ensemble de la mission. Le pentest agentique exécute une boucle de raisonnement continue — reconnaissance, hypothèse, test, validation, chaînage — qui maintient un modèle opérationnel de toute l'application et cherche activement comment les résultats précédents se combinent en un exploit plus large.
Que sont, techniquement, les outils automatisés de chaînage d'exploits ? Ce sont des systèmes qui traitent la surface d'attaque découverte comme un graphe plutôt que comme une liste, en suivant comment chaque vulnérabilité modifie ce qui est atteignable ailleurs dans l'application. Quand une nouvelle vulnérabilité est confirmée, l'agent réévalue si elle se connecte à quelque chose déjà découvert — comme une fuite d'informations qui peut rendre exploitable à grande échelle une IDOR auparavant jugée « moyenne », ou comme la surface d'autorisation complète d'un identifiant exposé qui peut s'étendre bien au-delà de l'unique audience pour laquelle il avait d'abord été signalé.
Les outils de pentest par IA agentique éliminent-ils les faux positifs ? Aucun outil ne les élimine entièrement, mais les meilleures plateformes les réduisent nettement en exigeant une preuve d'exploitabilité — une PoC exécutable et une trace de preuves — avant de rapporter une vulnérabilité, plutôt que de rapporter une correspondance de motif ou un score de confiance du modèle.
L'IA peut-elle remplacer les pentesteurs humains ? Pas actuellement, et la plupart des éditeurs crédibles ne prétendent pas le contraire. Les agents excellent dans les tests systématiques à large couverture sur des classes de vulnérabilités connues, à une vitesse et à une échelle que les humains ne peuvent égaler. Les humains restent meilleurs sur les chaînes d'attaque inédites, le jugement du risque métier et la validation des résultats à plus fort impact avant qu'ils n'atteignent un client ou une équipe d'ingénierie.
L'essentiel
Les scanners à base de règles continueront de détecter les vulnérabilités qui paraissent anormales sur le réseau. Celles qui ne le paraissent pas — celles qui se cachent dans les hypothèses d'un workflow, ou dans un identifiant dont la surface d'autorisation complète n'a jamais été entièrement cartographiée — demandent quelque chose qui raisonne comme un attaquant : construire un modèle du système, formuler une hypothèse, la tester et continuer de se demander à quoi d'autre elle se rattache. C'est le véritable basculement technique que représente l'IA agentique en sécurité applicative, et c'est pourquoi la conversation en AppSec est passée de « pouvons-nous scanner plus vite » à « pouvons-nous penser comme un attaquant, en continu, à l'échelle d'un parc applicatif moderne ».