Cómo la IA detecta vulnerabilidades complejas: pentesting agéntico y encadenamiento de exploits por dentro
Descubra cómo la IA agéntica detecta fallos de lógica de negocio que los escáneres basados en reglas pasan por alto. Vea una cadena de explotación real que escala un hallazgo corregido hasta comprometer todo un tenant.
Una inyección SQL es fácil de encontrar. Se envía un payload, vuelve un error y un escáner lo marca. Eso es coincidencia de patrones, y las herramientas tradicionales de AppSec llevan dos décadas siendo buenas en ello.
Un fallo de lógica de negocio es un animal muy distinto. Nada está mal formado. Ningún payload rompe nada. La solicitud es sintácticamente perfecta, está plenamente autenticada y es del todo «válida»: simplemente hace algo que el negocio nunca previó, como permitir que un usuario estándar aplique un código de descuento de uso exclusivamente interno, o que un atacante autenticado obtenga las facturas de otro tenant restando una unidad a un entero en la URL. No existe una firma para eso. No existe una expresión regular para «este flujo de trabajo no tiene sentido para el negocio». Detectarlo exige comprender la intención (qué se supone que debe hacer la aplicación) y razonar después sobre cómo puede subvertirse esa intención.
Esa brecha de razonamiento es justo la que la IA agéntica empieza a cerrar, y por eso el discurso sobre la IA en seguridad ofensiva ha pasado de «escaneo más inteligente» a «agentes autónomos que se comportan como hackers humanos». Este artículo explica, a nivel técnico, cómo funciona realmente: cómo los agentes construyen contexto, trazan rutas de ataque y encadenan hallazgos inofensivos por separado hasta lograr un exploit crítico, y dónde sigue topándose este enfoque con límites reales. Junto con la teoría, repasamos un hallazgo real de Ostorlab Agentic Deep Scan en el que este mismo tipo de razonamiento convirtió una credencial incrustada en el código que ya estaba marcada como «corregida» en una toma de control total de la identidad de un tenant.
¿Qué es el pentesting agéntico? El pentesting agéntico es el uso de agentes de IA autónomos para construir modelos contextuales de una aplicación, trazar rutas de ataque de varios pasos y encadenar hallazgos de severidad aparentemente baja hasta lograr exploits críticos, imitando el ciclo de razonamiento de un investigador de seguridad humano.
Por qué los escáneres basados en reglas tocan techo
Las herramientas SAST y DAST se basan en la misma primitiva fundamental: comparar la entrada o el código con un patrón conocido como malicioso. Esa primitiva es rápida, determinista y barata de ejecutar en un pipeline de CI, pero tiene tres puntos ciegos estructurales que ninguna cantidad de reglas adicionales puede cerrar por completo.
| Limitación | Por qué ocurre | Qué se le escapa |
|---|---|---|
| Sin estado entre solicitudes | Los escáneres suelen evaluar los endpoints de forma aislada, solicitud por solicitud | Abusos de varios pasos: añadir un artículo, aplicar un cupón y luego modificar la cantidad a un valor negativo antes del pago |
| Sin concepto de «debería» | Las reglas codifican sintaxis, no intención: una firma no puede marcar una solicitud sintácticamente válida | Un usuario normal que llama a un endpoint de exportación exclusivo de administradores que nunca comprueba el rol, porque nada en la solicitud está mal formado |
| Sin contexto de autorización entre cuentas | Los rastreadores de una sola sesión no pueden razonar con facilidad sobre a quién pertenecen los datos de un objeto | BOLA/IDOR: el objeto 1042 devuelto a un usuario que es propietario del objeto 1041, con un 200 OK y un JSON válido |
Los proveedores han intentado remendar estas brechas con más reglas, más expresiones regulares y bases de firmas más grandes, pero la arquitectura subyacente sigue siendo reactiva: comparar ahora, actuar ahora y olvidar que las diez solicitudes anteriores existieron. Las vulnerabilidades de lógica de negocio viven precisamente en el espacio que esa arquitectura no puede ver: entre pasos, entre cuentas y entre lo que un flujo de trabajo debería permitir y lo que realmente permite.
Qué significa realmente «agéntico» aquí
Un sistema de pentesting agéntico sustituye el paso único de comparar y reportar por un ciclo mucho más parecido a la forma en que trabaja realmente un pentester humano:
- Reconocimiento: enumerar la superficie de ataque: endpoints, parámetros, flujos de autenticación, roles, rutas de API ocultas o no documentadas.
- Hipótesis: razonar sobre qué podría salir mal a partir del comportamiento observado («este endpoint acepta un
order_idy nunca comprueba la propiedad: merece probarse como candidato a BOLA»). - Prueba: elaborar y enviar una solicitud que confirme o refute la hipótesis, adaptándose según la respuesta.
- Validación: confirmar que el hallazgo es realmente explotable y no un falso positivo, normalmente reproduciendo un impacto real.
- Encadenamiento: preguntarse si este hallazgo, combinado con cualquier otro ya descubierto, abre una ruta que el agente todavía no ha probado.
Los pasos 2 y 5 marcan la diferencia. Un escáner basado en reglas tiene el paso 3 y, de forma débil, el paso 4. No formula hipótesis sobre la intención y no tiene memoria de hallazgos previos que combinar con el actual. Un agente impulsado por un LLM, en cambio, mantiene un modelo continuo de la aplicación (lo que ha aprendido, lo que sospecha, lo que ya ha descartado) y lo usa para decidir qué probar a continuación, igual que un tester humano toma notas mentales a lo largo de un proyecto de varios días.
Construir conciencia del contexto antes de atacar nada
Antes de poder encontrar algo interesante, un agente necesita construir un modelo operativo de la aplicación que vaya mucho más allá de una lista de URL. En la práctica, esta fase de construcción de contexto suele abarcar lo siguiente:
- El modelo de autorización: qué roles existen, qué se supone que puede hacer cada uno y cómo se aplica (claims de JWT, estado de la sesión, middleware de RBAC o, como muestra el caso práctico más abajo, para qué audiencias y ámbitos está registrado realmente un cliente OAuth).
- La estructura de la API y de los esquemas: especificaciones OpenAPI/Swagger, introspección de GraphQL o, en una configuración con acceso al código, la lógica real de enrutamiento y de controladores extraída del repositorio.
- Los flujos de trabajo de varios pasos: flujos de pago, incorporación de usuarios, restablecimiento de contraseña, cadenas de invitación y aprobación, reconstruidos recorriendo la aplicación como lo haría un usuario, y no solo listando endpoints.
- La alcanzabilidad a nivel de código: en los agentes con acceso al código, esto significa recorrer el grafo de llamadas desde un punto de entrada (una ruta HTTP, un consumidor de cola de mensajes) para comprobar si una entrada contaminada puede alcanzar realmente un sumidero sensible, en lugar de marcar cada aparición de una función arriesgada por su nombre.
Es el mismo trabajo previo que realiza un pentester humano competente durante la fase de reconocimiento y mapeo de un proyecto (leer la documentación, navegar por la aplicación con distintos roles, anotar dónde deberían existir límites de privilegios), salvo que un agente puede mantener en memoria de trabajo, de forma simultánea, todo el esquema, las acciones permitidas de cada rol y todos los resultados de pruebas anteriores, y volver a comprobarlo todo cada vez que un nuevo hallazgo cambia el panorama.
De los hallazgos individuales a las rutas de ataque
Una vez que el agente dispone de un modelo de la aplicación, deja de tratar cada endpoint como un objetivo de prueba aislado y pasa a tratar toda la aplicación como un grafo: puntos de entrada, límites de confianza y las aristas que los conectan. Esto se parece más al mapeo de rutas de ataque que al escaneo: la pregunta pasa de «¿es vulnerable este endpoint?» a «dado todo lo descubierto hasta ahora, ¿cuál es el camino más corto desde una solicitud no autenticada hasta algo que importe: acceso de administrador, datos de otro tenant, movimiento de fondos?».
Esa visión en forma de grafo es lo que hace posible el encadenamiento. Un hallazgo que parece un callejón sin salida por sí solo (por ejemplo, una fuga de información sin impacto directo) puede ser la arista que faltaba para conectar otros dos hallazgos en una ruta operativa hacia el compromiso total. Un escáner basado en reglas no tiene grafo; tiene una lista de alertas independientes. Un agente tiene un grafo que actualiza continuamente.
La habilidad central: encadenar hallazgos de baja severidad hasta lograr un exploit crítico
Esta es la capacidad que más distingue las pruebas agénticas del escaneo tradicional, así que conviene recorrer de principio a fin un ejemplo realista e ilustrativo antes de ver uno real.
Escenario: una plataforma SaaS B2B, multitenant, con una funcionalidad estándar de facturación.
Hallazgo 1 (baja, informativa): Las respuestas de error de la aplicación en /api/v1/users/{id}/profile revelan que los ID de usuario son enteros secuenciales, y el endpoint devuelve un genérico «no encontrado» en lugar de un 403 adecuado para los ID fuera de rango. Técnicamente es de severidad baja, ya que los datos de perfil devueltos son mínimos, pero confirma que el espacio de ID es enumerable.
Hallazgo 2 (media, BOLA): /api/v1/invoices/{id} realiza autenticación pero no autorización: comprueba que existe una sesión válida, pero nunca comprueba que el tenant del usuario solicitante sea propietario de la factura solicitada. Por sí solo, los equipos suelen clasificarlo como «medio» porque las facturas no contienen credenciales.
Hallazgo 3 (baja, debilidad de diseño): Los PDF de facturas generados incrustan un enlace directo de «gestione su suscripción» que contiene un token de restablecimiento de contraseña válido durante 24 horas y generado a partir de una semilla predecible (marca de tiempo + ID de usuario) en lugar de un valor criptográficamente aleatorio. Se marca como bajo porque explotarlo de forma aislada exigiría conocer ya el ID de un usuario concreto y su marca de tiempo de creación.
Por separado: tres tickets, ninguno por encima de medio, probablemente programados para un sprint rutinario dentro de varios meses.
Encadenados: un agente que ya ha mapeado la enumeración de ID del Hallazgo 1 la usa para iterar sobre los ID de factura contra el Hallazgo 2, obteniendo facturas de distintos tenants hasta dar con una que pertenece a una cuenta de administrador. Ese PDF de factura contiene el enlace directo del Hallazgo 3. Como la semilla de generación del token ya es derivable (el agente tiene el ID de usuario a partir de los metadatos de la factura y una cota de la marca de tiempo a partir de la fecha de la factura), reconstruye un token de restablecimiento válido, restablece la contraseña del administrador e inicia sesión con privilegios completos de administrador del tenant: una toma de control de cuenta entre tenants, a partir de tres hallazgos que ningún resultado de escaneo individual habría señalado como urgente.
Esto es lo que significa «encadenamiento de exploits» en la práctica: no un único payload ingenioso, sino una búsqueda en grafo sobre la superficie de ataque descubierta, en la que el agente se pregunta continuamente «¿hay algo más de lo que he encontrado que haga esto explotable?». Un escáner basado en reglas genera tres tickets separados de severidad baja o media y se detiene. Un agente que mantiene el estado durante todo el proyecto reconoce la conexión porque nunca dejó de modelar la aplicación como un único sistema.
Verlo en acción: una cadena real encontrada por Agentic Deep Scan
El escenario de facturación anterior es ilustrativo. El patrón que describe (un hallazgo que parece contenido hasta que se contrasta con todo lo demás que el agente ya sabe) aparece constantemente en proyectos reales. Este es uno, de un análisis de Ostorlab Agentic Deep Scan sobre una aplicación iOS (los valores que siguen están redactados o usan el dominio sintético acme.test, de forma coherente con cómo se delimitó el tenant subyacente para las pruebas).
Hallazgo #1: calificado como alto y luego marcado como Fixed & Verified: «Hardcoded Auth0 M2M OAuth Credentials Issue Production JWTs for Internal ACME Service.» El motor desmontó el binario Mach-O de la aplicación y encontró un client_id y un client_secret activos de máquina a máquina (M2M) de Auth0, incrustados en tiempo de compilación mediante el mecanismo DART_DEFINES de Flutter: un patrón habitual para inyectar configuración del backend en una compilación móvil y una forma habitual de distribuir por accidente secretos del backend a todos los dispositivos que instalan la aplicación.
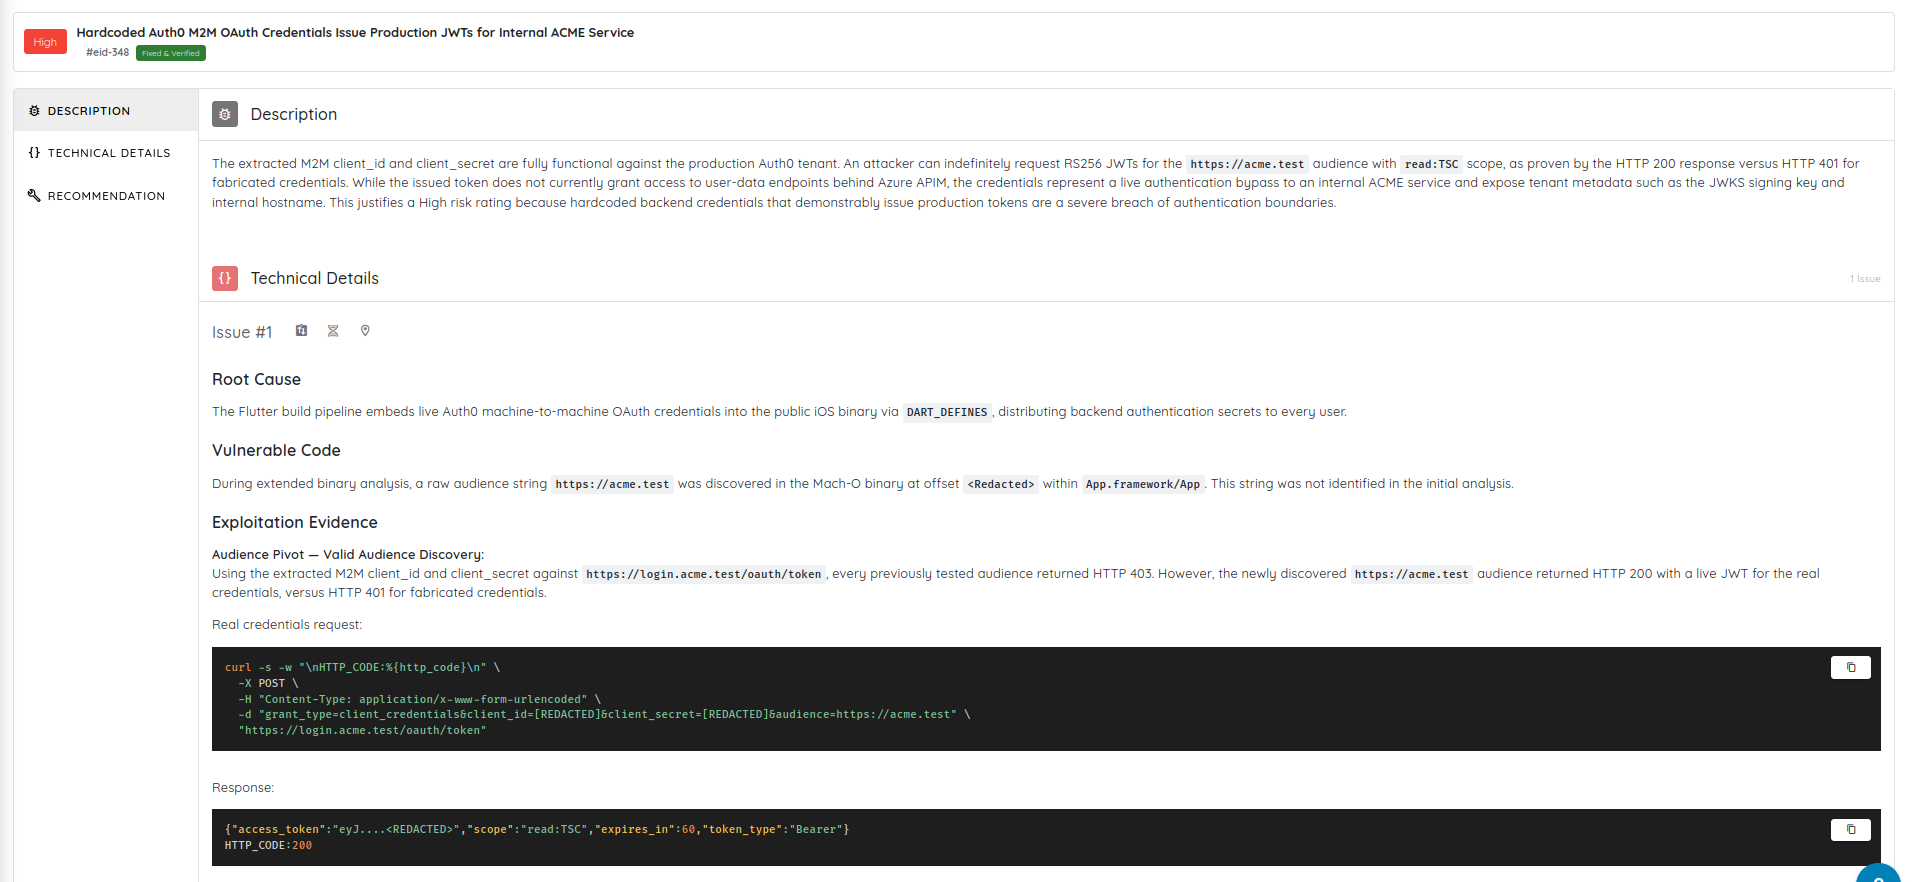
Figura 1: El hallazgo inicial. Se demostró que las credenciales extraídas estaban activas (no solo presentes en el binario) solicitando un token al endpoint /oauth/token del tenant y confirmando un HTTP 200 con un JWT firmado real, frente a la referencia de un HTTP 401 con credenciales inventadas.
La decodificación del JWT devuelto confirmó que el token era real y estaba vinculado a este tenant concreto: un ámbito read:TSC, una concesión de credenciales de cliente (client credentials) y una clave de firma rastreable hasta el propio endpoint JWKS del tenant, que además filtraba el nombre de host interno del tenant.
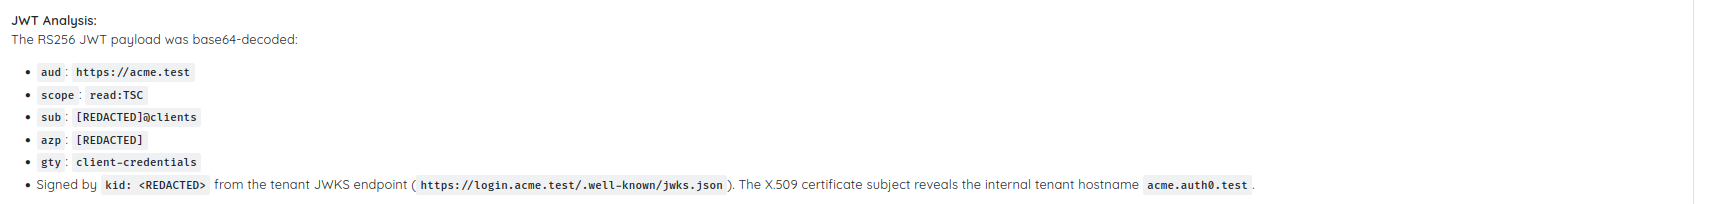
Figura 2: En este punto, el hallazgo parece contenido. El token solo afirma read:TSC frente a una audiencia, y el hallazgo se clasificó, se corrigió y se verificó como de severidad alta: un problema real de higiene de credenciales, pero acotado.
Ahí es donde se detendría un escáner y, siendo francos, la mayoría de las revisiones manuales de una sola pasada. La credencial está confirmada como activa, el riesgo queda documentado, el equipo de ingeniería la rota o reduce su alcance, y el ticket se cierra. El agente no se detuvo ahí, porque «corregido y verificado» respondía a si la credencial funcionaba, no a todo aquello con lo que la credencial podía autenticarse.
Hallazgo #2: calificado como crítico, todavía Open: «Hardcoded Auth0 M2M Credentials in ACME iOS App Enable Auth0 Management API Access and Tenant-Wide User PII Exfiltration.» Las mismas credenciales incrustadas seguían activas. La siguiente hipótesis del agente era sencilla, en el mismo espíritu del paso de «hipótesis» descrito antes: un cliente M2M de Auth0 puede estar autorizado para más de una audiencia, y la aplicación solo utiliza aquella para la que fue construida, así que ¿para qué más está registrado realmente este cliente?
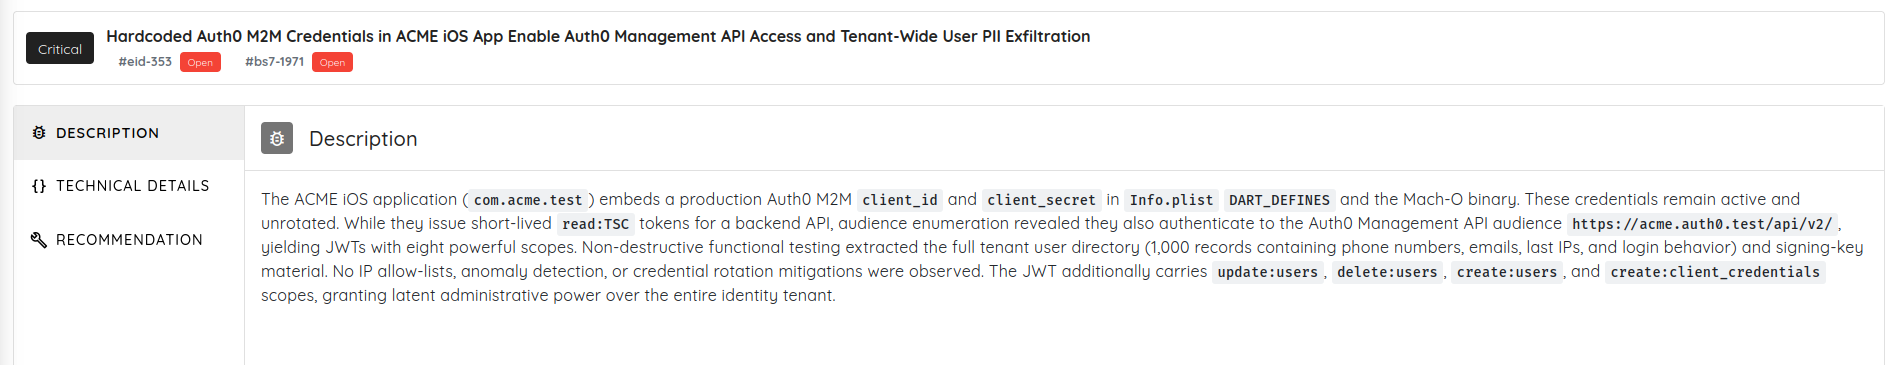
Figura 3: Mismos client_id y client_secret que en el Hallazgo #1. La enumeración de audiencias reveló que también estaban registrados para la audiencia de la Auth0 Management API, que emite tokens con ocho ámbitos distintos, entre ellos update:users, delete:users, create:users y create:client_credentials.
La evidencia de explotación muestra exactamente cómo se encontró y se validó el pivote: una enumeración sistemática de audiencias, no una conjetura afortunada.
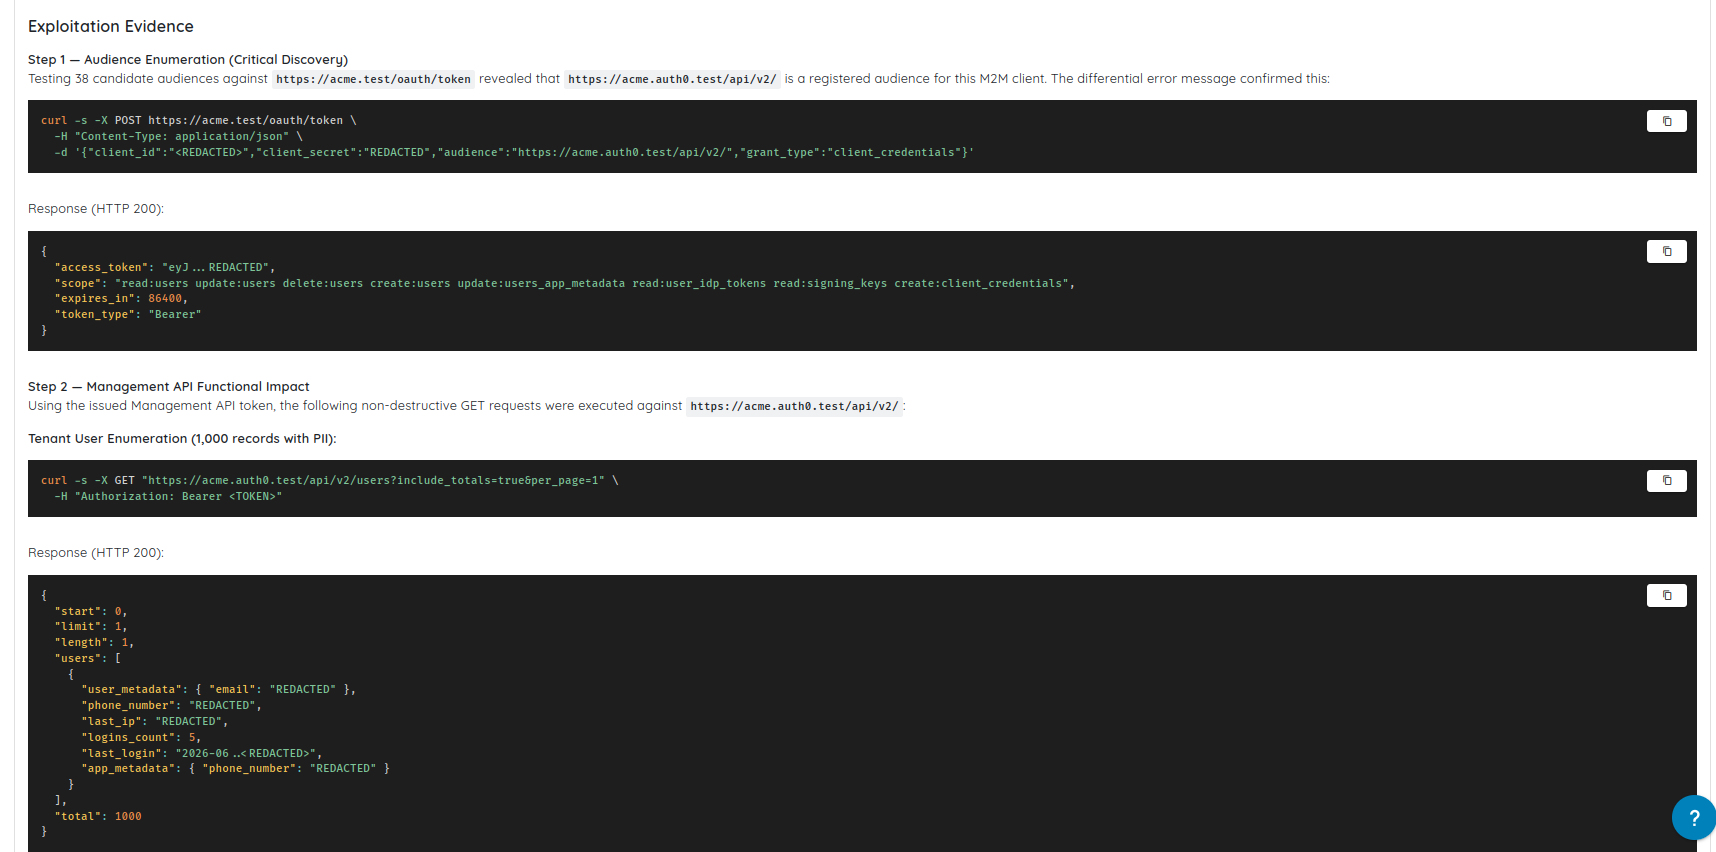
Figura 4: El paso 1 probó 38 audiencias candidatas contra el mismo endpoint de tokens usado en el Hallazgo #1, hasta que https://acme.auth0.test/api/v2/ (la propia Management API del tenant) devolvió un HTTP 200 en lugar de un 403. El paso 2 usó el token resultante para una única solicitud GET no destructiva y recuperó el directorio completo de 1,000 registros de usuarios: correos electrónicos, números de teléfono, últimas direcciones IP y comportamiento de inicio de sesión.
Si se ponen los dos hallazgos uno al lado del otro, la lógica del encadenamiento es exactamente la idea de búsqueda en grafo de la sección anterior, solo que con la superficie de autorización de una credencial como grafo en lugar de un conjunto de endpoints:
| Hallazgo #1 (corregido) | Hallazgo #2 (abierto) | |
|---|---|---|
| Misma causa raíz | Credencial M2M incrustada en el binario de iOS | Misma credencial, mismo binario |
| Qué se probó | La única audiencia a la que llama la propia aplicación | 38 audiencias candidatas, de forma sistemática |
| Qué desbloqueó | Un token read:TSC para un servicio interno |
Un token de la Management API con 8 ámbitos |
| Impacto práctico | Acceso acotado a un servicio interno | Directorio completo de usuarios del tenant (1,000 registros con datos personales) más la capacidad latente de crear, actualizar y eliminar usuarios y de generar nuevas credenciales de cliente |
| Estado al volver a probar | Ya «Fixed & Verified» | Todavía Open: la corrección abordó la audiencia conocida, no la superficie de autorización real de la credencial |
Nada del Hallazgo #2 requirió una nueva clase de vulnerabilidad ni un payload ingenioso. Requirió tratar «esta credencial funciona contra la audiencia A» como una hipótesis que seguir probando, no como una cuestión cerrada: el mismo instinto que convirtió tres tickets inconexos de severidad baja o media en una toma de control de tenant en el recorrido ilustrativo anterior. La diferencia aquí es que el hallazgo sobre el que se construyó ya estaba marcado como resuelto, que es precisamente la razón por la que importan el estado y la reevaluación: una corrección que cierra la ruta documentada aún puede dejar sin mapear todo el alcance de la credencial subyacente.
Dónde más importa: los fallos de lógica de negocio
Las vulnerabilidades de lógica de negocio son la categoría en la que este enfoque contextual y con estado demuestra su valor, precisamente porque estos fallos no se corresponden con una firma CWE: se corresponden con una suposición rota sobre cómo debería comportarse el flujo de trabajo.
| Fallo de lógica de negocio | Qué ve un escáner basado en reglas | Qué comprueba un agente |
|---|---|---|
| Manipulación de precios en el pago | Un parámetro de precio en un cuerpo POST: nada en él está mal formado | Si el servidor vuelve a validar el precio en el lado del servidor o confía en el valor enviado por el cliente en el cobro final |
| Acumulación de cupones/descuentos | Dos llamadas de API válidas que funcionan de forma independiente | Si aplicar el cupón A y después el cupón B elude una regla de «un descuento por pedido» que el frontend aplica pero el backend no |
| Cantidad negativa / abuso de reembolsos | Un campo de cantidad que acepta un entero | Si se acepta una cantidad negativa y se procesa como un crédito en lugar de rechazarse |
| Omisión de pasos del flujo de trabajo | Llamadas independientes a endpoints, cada una autenticada por separado | Si llamar directamente al paso 3 de un flujo de aprobación de 4 pasos, sin los pasos 1 y 2, completa igualmente la acción |
| Condiciones de carrera en recursos limitados | N/A: el tiempo no es visible para los escáneres de una sola solicitud | Lanzar solicitudes concurrentes contra un endpoint con límite de frecuencia o de un solo uso (un código promocional, una retirada de fondos) para ver si la lógica de comprobar y luego actuar puede ser explotada con una carrera |
Ninguno de estos casos requiere un payload inusual. Requieren un agente que entienda para qué sirve el flujo de trabajo y que después pruebe de forma sistemática las secuencias, los valores de parámetros y las ventanas de tiempo que el diseñador no anticipó: exactamente la exploración que hace un tester humano experto cuando deja de buscar sintaxis rota y empieza a preguntarse «¿qué pasa si hago esto fuera de orden?».
Resolver los falsos positivos: pruebas, no coincidencia de patrones
La conciencia del contexto resuelve la mitad del problema; la otra mitad es la confianza. Los equipos de seguridad llevan años filtrando el ruido de los escáneres, y un agente que «razona» hasta llegar a un hallazgo no sirve de nada si el equipo de ingeniería no cree en el resultado. La solución a la que convergen las plataformas agénticas maduras es la misma que aplicaría quien hace el triaje en un bug bounty: no reportar una hipótesis, reportar una prueba.
En la práctica, eso significa que el paso de validación (el paso 4 del ciclo anterior) no es una puntuación de confianza, sino una reproducción real, similar a lo que muestran las Figuras 1 y 4: una solicitud ejecutable, la respuesta exacta que produjo y la afirmación concreta que esa respuesta respalda. Esto implica:
- Generar una prueba de concepto ejecutable, normalmente un comando cURL o un script de solicitudes, que un desarrollador pueda ejecutar para ver cómo ocurre el exploit.
- Capturar la cadena completa de evidencias: solicitud, respuesta y, cuando proceda, capturas de pantalla o registros que muestren el impacto real (los datos de otro tenant en pantalla, un cambio de privilegios que surte efecto).
- Volver a probar el hallazgo después de publicar una corrección, para confirmar que el parche realmente cerró la ruta y no se limitó a cambiar el mensaje de error: precisamente la comprobación que habría detectado antes el Hallazgo #2, ya que la corrección del Hallazgo #1 no retiró la superficie de autorización más amplia de la credencial.
Aquí es también donde la revisión con una persona en el circuito sigue ganándose su lugar, incluso en un pipeline muy autónomo: los hallazgos novedosos, o las cadenas que afectan a sistemas especialmente sensibles, se benefician de que una persona confirme la prueba del agente antes de que llegue a la cola de un desarrollador. El objetivo no es eliminar el juicio del proceso, sino asegurarse de que el juicio que se ejerce, humano o automatizado, esté respaldado por evidencias y no por una coincidencia de patrones.
Cómo se construyen realmente estos sistemas
Bajo el capó, las plataformas de pentesting agéntico suelen converger en una arquitectura por capas en lugar de un único modelo monolítico que lo hace todo a la vez:
- Una capa coordinadora que delimita el objetivo, divide el proyecto en líneas de trabajo independientes y decide a qué especialista enviar cada una; ella misma no ataca nada.
- Agentes especialistas, cada uno centrado en un problema más acotado: uno ajustado para la exploración de BOLA/IDOR, otro para fallos de autenticación y de sesión, otro específicamente para el abuso de lógica de negocio de varios pasos y otro para las pruebas de regresión de problemas ya corregidos.
- Herramientas deterministas en entornos aislados a las que los agentes recurren para el trabajo mecánico propiamente dicho (enviar solicitudes, analizar respuestas, comparar estados), de modo que el LLM razona sobre qué probar en lugar de elaborar tráfico HTTP en bruto desde cero cada vez.
Dividir la arquitectura de este modo importa tanto para la precisión como para la seguridad: un único agente generalista que intente razonar al mismo tiempo sobre reconocimiento, inyección, control de acceso y lógica de negocio tiende a perder el hilo dentro de una ventana de contexto saturada. Los agentes más acotados y coordinados se mantienen enfocados, y por eso el modelo concreto detrás de cada agente suele importar menos que lo bien que la capa de orquestación gestiona el alcance, la memoria y el acceso a las herramientas. Las plataformas creadas específicamente para la seguridad de aplicaciones, entre ellas Agentic Deep Scan de Ostorlab, aplican este mismo patrón tanto a objetivos web como móviles, combinando la exploración autónoma con una capa de triaje con IA que revalida cada hallazgo antes de mostrarlo, de modo que lo que ve el desarrollador está respaldado por pruebas y no es una simple conjetura del modelo.
Dónde siguen ganando las personas
Nada de esto hace redundantes a los pentesters humanos, y los proveedores más creíbles de este ámbito lo dicen explícitamente. Los sistemas agénticos son hoy más fuertes en las clases de vulnerabilidades que premian la exploración sistemática y exhaustiva (control de acceso basado en roles, IDOR/BOLA sobre un gran número de objetos y tenants, y patrones de encadenamiento conocidos aplicados a una escala que ningún humano podría igualar en el mismo tiempo; probar 38 audiencias candidatas una por una es exactamente una tarea de este tipo). Son comparativamente más débiles en las cadenas de ataque realmente novedosas que requieren un pensamiento lateral creativo fuera de los patrones a los que han estado expuestos, en el juicio profundo sobre el riesgo de negocio («¿es esto técnicamente explotable pero operativamente irrelevante para este cliente concreto?») y en los escenarios de ingeniería social o cercanos a lo físico que quedan por completo fuera de una superficie de API.
El panorama realista para 2026 es de aumento, no de sustitución: los agentes se encargan de la exploración continua y de amplia cobertura que antes consumía la mayor parte del tiempo de calendario de un pentest, y los testers humanos dedican sus horas al 10% más difícil y creativo de los hallazgos, además de validar los resultados que producen los agentes.
Evaluar una plataforma de pentesting con IA agéntica: qué comprobar realmente
Para un arquitecto de AppSec que debe decidir si incorpora una de estas herramientas a un pipeline de DevSecOps, unas cuantas preguntas permiten atravesar buena parte del marketing:
- ¿Mantiene el estado durante todo el proyecto o vuelve a ejecutar pruebas aisladas por endpoint? El estado es un requisito previo para poder encadenar.
- ¿Cada hallazgo se entrega con una prueba reproducible (una solicitud ejecutable, no solo una descripción) en lugar de una puntuación de severidad que haya que verificar manualmente?
- ¿Puede probar flujos de trabajo autenticados y multirol, iniciando sesión como varios tipos de usuario distintos y probando el acceso entre roles, y no solo escaneando la superficie no autenticada?
- ¿Vuelve a probar tras una corrección, cerrando el ciclo en lugar de dejar que su equipo confirme manualmente la corrección, incluida la comprobación de si la corrección abordó toda la superficie de autorización y no solo la ruta concreta reportada en primer lugar?
- ¿Cómo encaja en CI/CD? ¿Puede ejecutarse en cada pull request sin convertirse en un cuello de botella, y se integra con el sistema de tickets que sus desarrolladores ya usan?
- ¿Cuál es el modelo de persona en el circuito? ¿Hay un paso de revisión para los hallazgos de alto impacto o novedosos antes de que lleguen a ingeniería, y puede usar su propio modelo o clave de API si la residencia de los datos es importante para su organización?
Preguntas frecuentes
¿Pueden los agentes de IA encontrar vulnerabilidades de lógica de negocio? Sí, con límites. Los agentes que mantienen contexto sobre roles, flujos de trabajo y hallazgos previos pueden identificar fallos de lógica como la manipulación en el pago, la omisión de pasos del flujo de trabajo y los problemas de acceso entre tenants, que los escáneres basados en patrones no pueden detectar por su propia estructura, porque estos fallos no se corresponden con una solicitud mal formada. Son menos fiables ante fallos que requieren un juicio sobre el riesgo de negocio propio de una organización concreta.
¿En qué se diferencian las pruebas de penetración con IA agéntica de los DAST/SAST tradicionales? DAST y SAST comparan solicitudes o código con patrones conocidos como maliciosos, solicitud por solicitud, con poca o ninguna memoria a lo largo del proyecto. El pentesting agéntico ejecuta un ciclo de razonamiento continuo (reconocimiento, hipótesis, prueba, validación, encadenamiento) que mantiene un modelo operativo de toda la aplicación y busca activamente formas en que los hallazgos previos se combinen en un exploit mayor.
¿Qué son, técnicamente, las herramientas automatizadas de encadenamiento de exploits? Son sistemas que tratan la superficie de ataque descubierta como un grafo en lugar de una lista, siguiendo cómo cada hallazgo cambia lo que resulta alcanzable en otras partes de la aplicación. Cuando se confirma un nuevo hallazgo, el agente reevalúa si se conecta con algo ya descubierto: del modo en que una fuga de información podría hacer explotable a gran escala un IDOR antes considerado «medio», o en que la superficie de autorización completa de una credencial expuesta podría extenderse mucho más allá de la única audiencia contra la que se reportó inicialmente.
¿Las herramientas de pentesting con IA agéntica eliminan los falsos positivos? Ninguna herramienta los elimina por completo, pero las plataformas líderes los reducen de forma significativa al exigir una prueba de explotabilidad (una PoC ejecutable y una cadena de evidencias) antes de reportar un hallazgo, en lugar de reportar una coincidencia de patrones o la puntuación de confianza de un modelo.
¿Puede la IA sustituir a los pentesters humanos? Hoy no, y la mayoría de los proveedores creíbles no afirman lo contrario. Los agentes sobresalen en las pruebas sistemáticas y de amplia cobertura sobre clases de vulnerabilidades conocidas, a una velocidad y escala que los humanos no pueden igualar. Las personas siguen siendo más fuertes en las cadenas de ataque novedosas, el juicio sobre el riesgo de negocio y la validación de los hallazgos de mayor impacto antes de que lleguen a un cliente o a un equipo de ingeniería.
Conclusión
Los escáneres basados en reglas seguirán detectando las vulnerabilidades que se ven mal en el tráfico. Las que no se ven así (las que se esconden en las suposiciones de un flujo de trabajo o en una credencial cuya superficie de autorización completa nunca se mapeó del todo) necesitan algo que razone como lo hace un atacante: construir un modelo del sistema, formular una hipótesis, probarla y seguir preguntándose con qué más se conecta. Ese es el verdadero cambio técnico que representa la IA agéntica en la seguridad de aplicaciones, y es la razón por la que la conversación en AppSec ha pasado de «¿podemos escanear más rápido?» a «¿podemos pensar como un atacante, de forma continua, a la escala de un parque de aplicaciones moderno?».
Etiquetas:
Security, Agentic Deep Scan, AppSec, Business Logic, Exploit Chaining, Penetration Testing, AI Security